У AMD Instinct MI300X — 192 GB HBM3. У NVIDIA H200 SXM — 141 GB HBM3e.
Если большая языковая модель подходит близко к пределу памяти H200, дополнительные 51 GB на одной MI300X выглядят очень серьёзным аргументом. На восьми ускорителях разница номинальной HBM достигает уже 408 GB.
Но этого недостаточно, чтобы выбрать сервер.
Допустим, модель идеально помещается в MI300X, но production использует конкретный quantized checkpoint, attention backend или CUDA-extension, который не проходит на выбранной ROCm-конфигурации. В таком случае дополнительные 51 GB памяти пока ничего не решают.
Возможен и обратный сценарий: весь стек штатно работает на ROCm, обе платформы выполняют требуемый SLA, но H200 уже ограничивает model placement или KV-cache. Тогда 192 GB MI300X превращаются из красивой цифры в настоящее архитектурное преимущество.
Поэтому вопрос «MI300X или H200 быстрее?» поставлен слишком широко.
Для закупки полезнее другой:
И это стоит проверить до заказа оборудования.
MI300X или H200: короткий ответ
Ситуация | Что это означает |
Обе платформы полностью поддерживают production stack | Сравниваем performance, количество GPU и стоимость |
Workload подходит близко к 141 GB H200 | 192 GB MI300X становятся сильным аргументом |
Критичный software component проходит только на CUDA | H200 получает практическое преимущество |
В проекте много CUDA-only custom code | Сначала оцениваем переносимость, потом сравниваем GPU |
Используются поддерживаемые PyTorch/vLLM/SGLang без vendor-specific зависимостей | MI300X нельзя исключать только потому, что это ROCm |
Модель запустилась на одной GPU, а production будет TP=8 | Проверка ещё не завершена |
Одна GPU победила в публичном benchmark | Нужна проверка совпадения workload |
Обе платформы выполняют одинаковый SLA | Тогда уже имеет смысл считать экономику сервера |
Главное здесь — не пытаться получить универсального победителя.
Для конкретного проекта нам нужны PASS или FAIL.
Что действительно отличается в железе
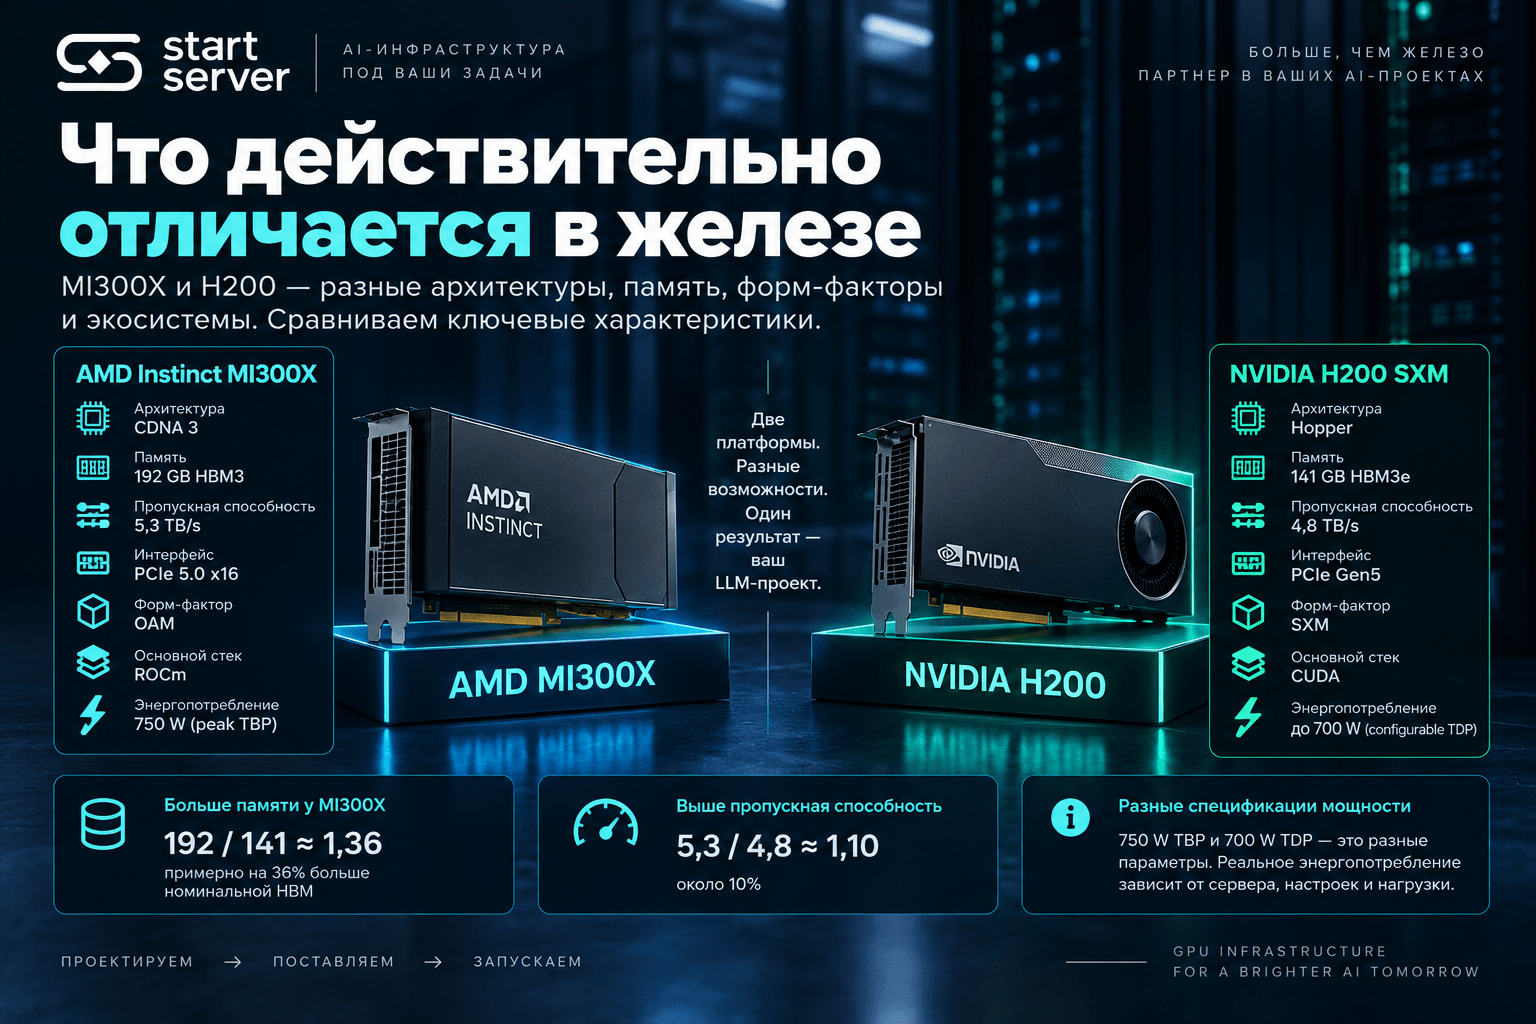
AMD указывает для Instinct MI300X 192 GB HBM3, 5,3 TB/s peak memory bandwidth, архитектуру CDNA 3, OAM form factor, PCIe 5.0 x16 и 750 W peak Typical Board Power.
NVIDIA указывает для H200 SXM 141 GB HBM3e, 4,8 TB/s memory bandwidth и настраиваемый TDP до 700 W. H200 относится к архитектуре Hopper.
Параметр | AMD Instinct MI300X | NVIDIA H200 SXM |
Архитектура | CDNA 3 | Hopper |
GPU memory | 192 GB HBM3 | 141 GB HBM3e |
Peak memory bandwidth | 5,3 TB/s | 4,8 TB/s |
Host interface | PCIe 5.0 x16 | PCIe Gen5 |
Form factor | OAM | SXM |
Основной GPU stack | ROCm | CUDA |
Power specification | 750 W peak TBP | до 700 W configurable TDP |
По объёму локальной памяти разница составляет:
192 − 141 = 51 GB
То есть MI300X имеет примерно на 36% больше номинальной HBM относительно H200.
По peak memory bandwidth:
5,3 / 4,8 ≈ 1,10
— около 10%.
Но ни один из этих процентов нельзя превращать в процент прироста LLM throughput.
И отдельно не стоит делать вывод об энергоэффективности из 750 W TBP против 700 W TDP: это разные vendor specifications, а реальное энергопотребление определяется сервером, настройками мощности и workload.
Когда дополнительные 51 GB действительно важны
Если рабочая модель вместе с KV-cache занимает небольшую часть памяти обеих GPU, разница между 141 и 192 GB может не изменить архитектуру системы.
Совсем другое начинается около границы H200.
Предположим, конкретная комбинация весов, runtime и KV-cache уже подходит к 141 GB. В таком случае дополнительная память MI300X может дать больше headroom для cache и concurrency либо позволить иначе распределить модель между ускорителями.
В восьми-GPU узле номинальная память выглядит так:
8 × 192 = 1536 GB
против:
8 × 141 = 1128 GB.
Разница — 408 GB HBM.
Но даже это не означает автоматически:
MI300X позволит убрать одну GPU.
Чтобы сделать такой вывод, необходимо знать реальный footprint checkpoint и способ parallelism.
Правильнее сформулировать так:
Преимущество 192 GB становится особенно ценным, когда конкретный workload пересекает memory ceiling 141 GB H200.
Если же обе GPU имеют достаточный запас, память перестаёт быть главным критерием.
ROCm на MI300X уже нельзя считать экзотическим стеком
Отбрасывать MI300X словами «у нас LLM, значит нужна CUDA» сегодня слишком просто.
Актуальная документация AMD включает vLLM и SGLang в ROCm AI ecosystem. Текущая ROCm compatibility matrix публикует конкретные проверенные комбинации версий framework, Python и ROCm, а MI300X относится к gfx942.
У upstream vLLM есть официальный ROCm deployment path и официальные ROCm Docker images. Старые AMD-specific rocm/vllm images уже помечены как deprecated в пользу upstream vllm/vllm-openai-rocm, появившихся в 2026 году.
Поэтому вопрос:
Работает ли vLLM на MI300X?
сам по себе почти бесполезен.
Да, поддержка есть.
Нам нужен следующий уровень:
Работают ли именно наша модель, наши функции и наша конфигурация vLLM?
Поддержка framework ещё не означает поддержку workload
Текущая vLLM Feature × Hardware matrix хорошо это показывает.
Большая часть основных функций доступна и на Hopper, и на AMD: например, LoRA, speculative decoding, multimodal и ряд других возможностей.
Но полного feature parity нет. На момент проверки в матрице encoder-decoder models отмечены для Hopper и не отмечены для AMD; async output processing также доступен на Hopper и отсутствует у AMD.
Такие детали быстро меняются, поэтому запоминать конкретные красные и зелёные клетки бессмысленно.
Полезнее запомнить принцип:
Фраза:
«У нас vLLM»
недостаточна для выбора MI300X или H200.
Нужны exact version, model, quantization, serving features, attention backend и parallelism.
Quantization может решить выбор раньше benchmark
Особенно осторожно нужно относиться к фразам вроде:
У нас 4-bit модель.
Как именно она квантована?
AWQ? GPTQ? Другой формат? Какая реализация runtime должна её обслуживать?
На момент подготовки материала официальная stable-матрица upstream vLLM отмечает AWQ и GPTQ как доступные на Hopper, но не на AMD GPU. Marlin-based варианты там также относятся к NVIDIA-стороне.
Однако актуальная AMD ROCm documentation для vLLM отдельно описывает использование AWQ на MI300X через ROCm-specific path.
На первый взгляд документация противоречит сама себе.
На практике из этого следует гораздо более важный вывод:
Нельзя принимать решение по слову AWQ. Нужно зафиксировать конкретный vLLM build, ROCm version, container image и checkpoint и реально запустить эту комбинацию.
В быстро меняющемся AI stack поддержка конкретной функции может появиться в vendor-optimized path раньше, позже или иначе, чем она отражена в общей upstream matrix.
Именно поэтому compatibility test важнее общей таблицы.
FP8 — хороший противоположный пример
Для FP8 картина может быть совсем другой.
Актуальная документация vLLM по W8A8 FP8 прямо называет аппаратно ускоренными платформами как NVIDIA H100, так и AMD MI300X.
В такой ситуации фраза:
У нас ROCm, поэтому лучше сразу H200
уже ничего не доказывает.
Если нужный checkpoint и runtime path поддержаны на обеих платформах, нужно переходить к нормальному сравнению:
качество → latency → throughput → memory → stability.
То есть даже внутри одной темы quantization нельзя дать универсальный ответ о преимуществе CUDA или ROCm.
Версия ПО — часть конфигурации сервера
Описание:
MI300X + ROCm
слишком широкое.
Так же как:
H200 + CUDA.
Реальная конфигурация больше похожа на:
GPU + driver/runtime + PyTorch + inference engine + exact container image.
AMD compatibility matrix именно так и подходит к software support: версии ROCm, framework и других компонентов фиксируются как совместимые комбинации. В актуальной ROCm 10.0.0 matrix отдельно перечисляются валидированные версии vLLM и SGLang.
vLLM со своей стороны предупреждает, что ROCm binaries и kernels привязаны к software environment и при отличающемся ROCm/PyTorch stack может понадобиться другая сборка.
Поэтому версия — это не мелочь для DevOps.
Она является частью воспроизводимой серверной конфигурации.
Если benchmark делался на одном image, а production будет развёрнут на другом, результат уже нужно перепроверять.
Одинаковая задача важнее одинакового kernel
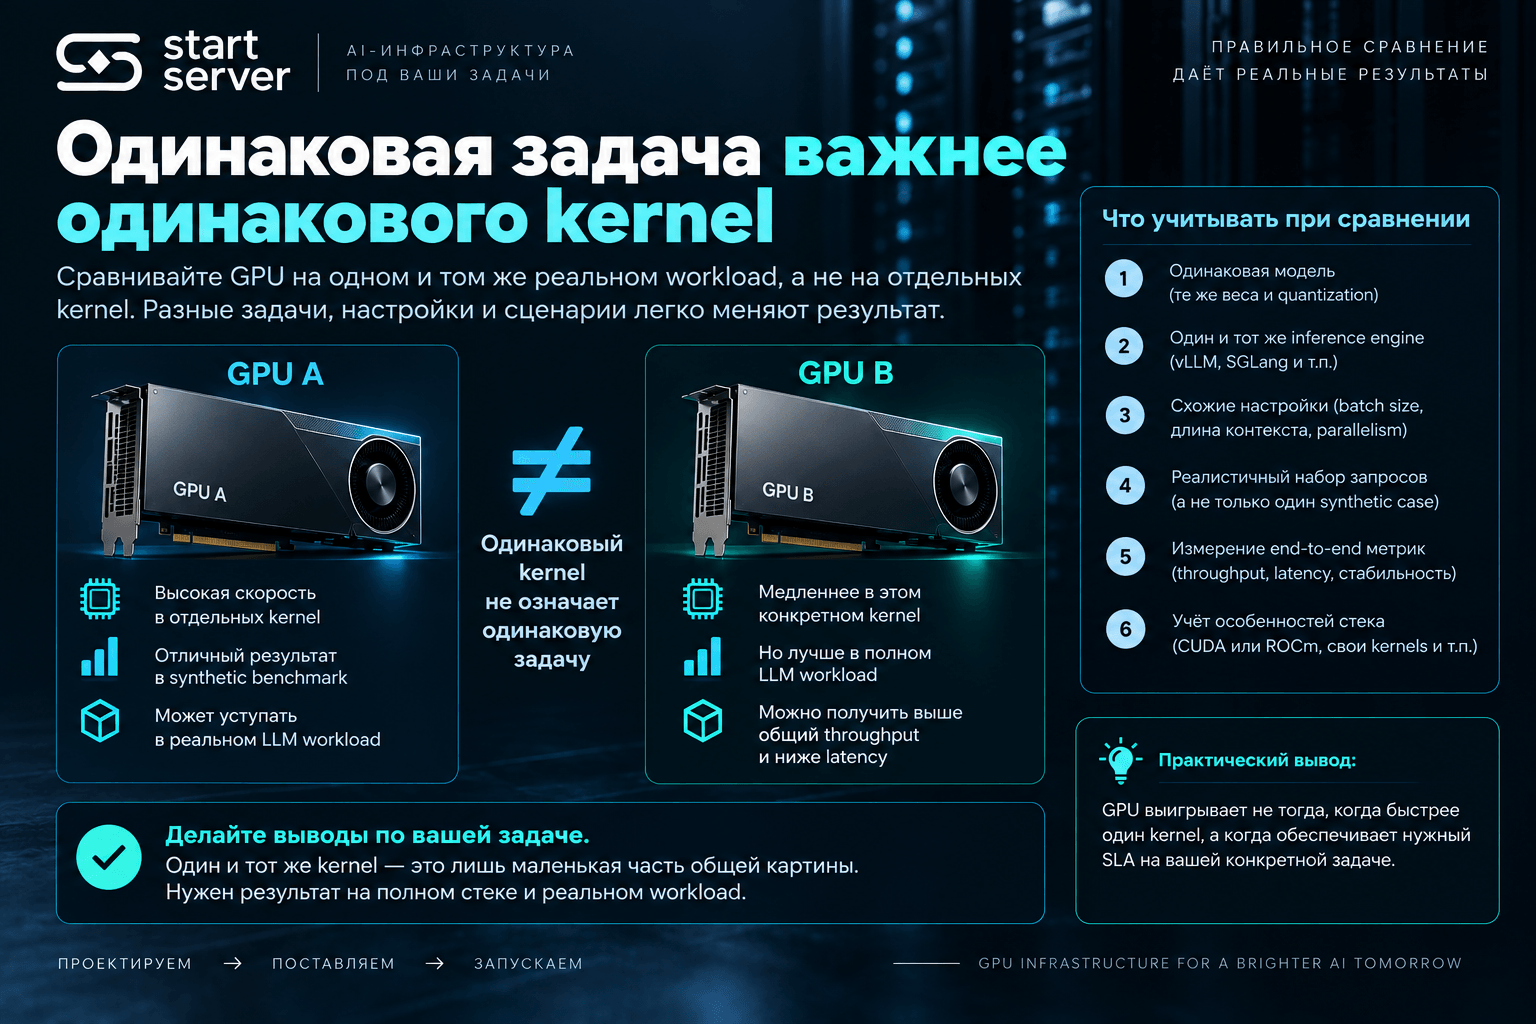
При сравнении платформ легко сделать ошибку в другую сторону: попытаться создать настолько «одинаковые условия», что одна из GPU будет работать через нехарактерный для неё backend.
На NVIDIA оптимальный kernel path может быть одним.
На AMD — другим.
Например, актуальная AMD documentation рекомендует использовать ROCm-specific AITER optimizations и выбирать attention backend в зависимости от типа модели и workload. Для MI300X доступны отдельные ROCm kernel paths, в том числе AITER и Triton-варианты.
Заставить обе системы использовать один generic fallback может выглядеть научно честно, но для закупки сервера такой тест не очень полезен.
Нам нужно зафиксировать одинаковыми:
модель, checkpoint, precision, пользовательские запросы, context, output, concurrency, требуемые функции и SLA.
А каждой платформе разрешить использовать нормальный production-рекомендуемый backend.
Иначе мы сравниваем не два лучших решения задачи, а два искусственно ограниченных эксперимента.
Есть CUDA-only код? Это отдельная проверка
Теперь более сложный случай.
Если production состоит из актуальных mainstream-компонентов — PyTorch, Transformers, поддерживаемого inference engine — один уровень риска.
Если внутри есть собственные CUDA extensions, .cu kernels или библиотека, существующая только в NVIDIA-specific варианте, — совсем другой.
Общая поддержка Llama или vLLM на MI300X здесь ничего не гарантирует.
До выбора AMD нужно понять, существует ли используемый компонент для HIP/ROCm или требуется перенос.
Это не обязательно означает, что переход невозможен.
Но до такой проверки MI300X ещё не получила production PASS.
Подробную миграцию CUDA → ROCm здесь сознательно не разбираем — это отдельная тема из нашего плана. Для выбора между MI300X и H200 достаточно сначала обнаружить эту зависимость.
Single-GPU PASS не означает, что восьми-GPU сервер готов
Допустим, checkpoint успешно загрузился на одной MI300X.
Inference работает.
Это хороший результат.
Но если реальный сервер покупается под:
TP=8
он пока проверяет не ту систему.
Multi-GPU добавляет distributed communication, коллективные операции, распределение памяти и другой performance profile.
AMD для MI300X публикует отдельные рекомендации по RCCL, parallelism и настройке vLLM именно для multi-GPU workload. Более того, некоторые оптимизации имеют смысл только при нескольких ускорителях.
Поэтому правило простое:
Тестируйте ту topology, которую собираетесь эксплуатировать.
Если production — одна GPU, single-GPU test достаточен для этого слоя.
Если production — TP=4, нужен TP=4.
Если проектируется TP=8 — финальный PASS должен включать восемь GPU.
Pre-purchase protocol: что проверить до закупки
Это главный практический блок статьи.
Gate | Что фиксируем | Что считаем PASS |
Model | Exact model ID + revision | Один checkpoint работает |
Weights | BF16, FP8 и т. п. | Требуемый формат поддержан |
Quantization | Exact implementation | Не нужно менять production checkpoint ради платформы |
Engine | vLLM/SGLang + exact version | Нужная версия штатно работает |
Features | LoRA, multimodal, prefix cache и др. | Необходимый feature set сохранён |
Backend | Production attention/GEMM path | Нет критичного fallback |
Custom code | CUDA/HIP/native extensions | Нет непроверенной vendor-specific зависимости |
Container | Exact image и tag/digest | Environment воспроизводим |
Single GPU | Correctness + memory | Базовая функциональность пройдена |
Multi-GPU | Реальный TP/PP/EP | Production topology работает |
Quality | Один и тот же test set | Качество в допустимых пределах |
TTFT | p50/p95 | Выполняется SLA |
ITL | p50/p95 | Выполняется SLA |
Throughput | req/s или tok/s | Есть требуемая capacity |
Memory | Peak usage | Есть необходимый headroom |
Stability | Продолжительный test | Нет ошибок и деградации |
Operations | Deploy, restart, monitoring | Систему реально можно сопровождать |
Первые строки отвечают на вопрос:
Можно ли вообще запустить production stack?
Последние — на более важный:
Стоит ли на этой платформе строить production?
До теста составьте паспорт workload
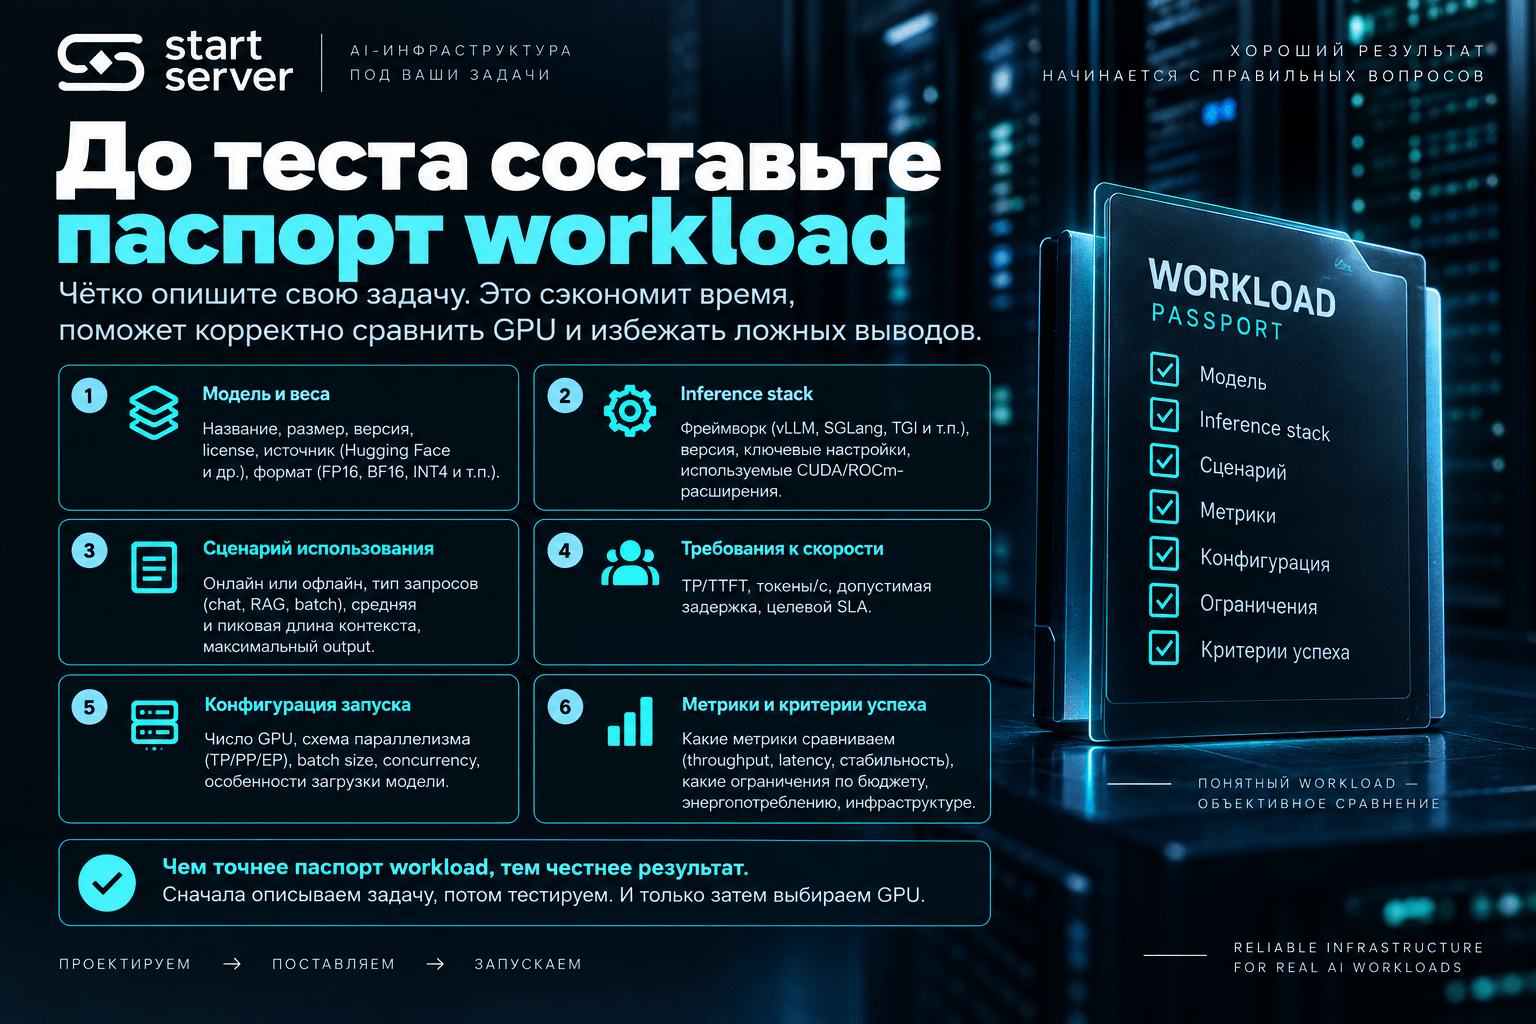
Результат вида:
MI300X показала 12 000 tokens/s
почти бесполезен без условий.
Минимальный паспорт сравнения может выглядеть так:
Model: org/model@revision
Weights: FP8
KV-cache: BF16
Engine: vLLM <exact version>
Container: <exact tag/digest>
Typical input: 8K
Typical output: 1K
Concurrency: 16
Tensor parallel: 8
Required features: prefix caching, tool calling
Quality test: <dataset / internal test set>
TTFT target: p95 < ...
ITL target: p95 < ...
Throughput target: ...
Это не benchmark Start Server и не готовый набор универсальных значений.
Это шаблон того, что нужно зафиксировать до первого запуска.
«Модель запустилась» — это только первый PASS
Для закупки удобно разделить результат на три уровня.
Первый — functional compatibility. Модель загружается, запрос проходит, результат корректный.
Второй — production compatibility. Работают нужная quantization, serving features, multi-GPU, custom extensions и API behavior.
Третий — SLA и эксплуатация. Система выдерживает необходимые latency, throughput и длительную нагрузку, имеет достаточный memory headroom, нормально перезапускается и мониторится.
И только третий уровень даёт основание сказать:
эта платформа подходит для нашего production.
GPU может прекрасно пройти первый уровень и провалиться на втором или третьем.
Почему одного tokens/s недостаточно
Aggregate throughput важен, но не отвечает на все вопросы LLM serving.
Представим две системы.
Первая показывает больше tokens/s, но при рабочей concurrency у неё слишком высокий p95 TTFT.
Для offline inference это может быть приемлемо.
Для интерактивного ассистента — нет.
Или наоборот: throughput близкий, но у MI300X остаётся значительно больше памяти после размещения модели, что позволяет обслуживать больше активного KV-cache без изменения tensor parallelism.
Поэтому перед закупкой полезно смотреть минимум на:
качество результата, TTFT, ITL, throughput, memory headroom и стабильность.
И сравнивать их при одном workload.
Публичный benchmark — ориентир, а не ответ
Публичные тесты MI300X/H200 полезны.
По ним можно увидеть, что конкретная модель вообще работает, какой runtime использовался и какие оптимизации дают результат.
Но переносить коэффициент производительности на свою инфраструктуру нельзя.
Поменялись model revision, quantization, context, concurrency, engine version или tensor parallel degree — это уже другой тест.
Поэтому публичный benchmark отвечает на вопрос:
Что произошло в этих опубликованных условиях?
А закупочный benchmark должен отвечать:
Выполняет ли эта платформа нашу задачу дешевле или лучше альтернативы?
Это разные вопросы.
Когда MI300X становится особенно сильным вариантом
Предположим, весь compatibility protocol пройден.
Точный checkpoint работает.
Quantization работает.
Нужные функции inference engine сохранены.
Custom CUDA blocker отсутствует или закрыт.
Multi-GPU deployment стабилен.
Quality и SLA выполняются.
Теперь разница в hardware начинает действительно решать.
Если workload уже упирается в 141 GB H200, 192 GB MI300X становятся сильным техническим преимуществом.
Дополнительная память может дать больший KV-cache, более удобное размещение модели или другой уровень concurrency.
И если весь ROCm stack прошёл проверку, нет технической причины обесценивать этот результат только аргументом:
CUDA привычнее.
Привычность стека имеет стоимость, но она не отменяет результатов теста.
Когда H200 оказывается практичнее
Теперь обратный сценарий.
Модель без проблем помещается в 141 GB.
При этом production использует software path, который на H200/CUDA уже стабилен и поддержан.
А на MI300X для той же задачи необходимо изменить обязательный checkpoint, перейти на другой runtime, портировать критичный CUDA-компонент или использовать неподтверждённое сочетание версий.
Тогда лишние 51 GB HBM могут не давать никакой бизнес-выгоды.
Но правильный вывод здесь тоже не:
CUDA лучше ROCm.
Он выглядит иначе:
У другого заказчика ответ может оказаться противоположным.
Что делать, когда официальные матрицы расходятся
С AI software это происходит и будет происходить.
Хороший пример — уже рассмотренный AWQ: upstream vLLM hardware matrix и актуальная AMD ROCm documentation сегодня описывают support surface не одинаково.
В такой ситуации не стоит выбирать ту страницу документации, которая удобнее подтверждает желаемую закупку.
Нужно зафиксировать:
GPU → runtime build → version → container → checkpoint.
И запустить именно эту комбинацию.
Это особенно важно потому, что ROCm и inference engines развиваются быстро. Например, актуальная ROCm 10.0.0 matrix уже валидирует конкретные современные версии vLLM и SGLang как часть AI ecosystem.
То, что не работало год назад, сегодня может работать штатно.
И наоборот: старый internal container может не получить поддержку автоматически только потому, что она появилась в новой ветке.
Итоговая схема выбора MI300X или H200
Результат проверки | Решение |
Обе платформы проходят весь production protocol | Сравнивать performance, GPU count и экономику |
Обе проходят, но H200 упирается в 141 GB | У MI300X появляется сильное преимущество по memory capacity |
MI300X требует менять критичный production component | Оценивать стоимость изменений против H200 |
Есть большой CUDA-only dependency | MI300X ещё не получила PASS |
Single-GPU прошёл, TP=8 не тестировался | Покупать 8-GPU узел по этому результату рано |
Throughput высокий, но latency SLA провален | Платформа пока не решила задачу |
H200 проще программно, но из-за 141 GB требует больше GPU | Считать уже весь сервер, а не цену одного ускорителя |
Ни один вариант не выполняет SLA | Пересматривать workload/configuration |
MI300X или H200: что выбрать
Если судить только по локальной памяти, преимущество у MI300X: 192 GB против 141 GB H200. Для больших моделей, которые приближаются к пределу H200, это может иметь очень серьёзное практическое значение.
Но покупать AI-сервер только по количеству HBM нельзя.
Перед решением нужно последовательно проверить:
model → quantization → runtime/version → необходимые features → kernels → custom code → production topology → quality → SLA → stability.
ROCm сегодня имеет полноценные современные LLM paths для MI300X, включая upstream vLLM deployment и ROCm-specific optimizations. Поэтому исключать AMD автоматически неправильно.
Но и общее слово «поддерживается» не является доказательством совместимости конкретного production stack.
Отсюда получается довольно простой критерий:
Такой тест гораздо дешевле провести до закупки, чем обнаруживать ограничения после поставки восьми ускорителей.
Обсудить проверку модели на выбранной платформе
Для первичной оценки нужны точный model ID/checkpoint и revision, формат весов или quantization, inference engine и его версия, container image, рабочий context и concurrency, предполагаемое число GPU и информация о собственных CUDA-компонентах.
По этим данным можно сформировать одинаковый workload для MI300X/ROCm и H200/CUDA и определить, какие compatibility и performance gates необходимо закрыть до выбора серверной платформы.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


