NVIDIA RTX PRO 6000 Blackwell представляет собой семейство профессиональных GPU с 96 ГБ памяти GDDR7 с ECC. Эти видеокарты используют для локальных языковых моделей, инференса, дообучения, компьютерного зрения, рендеринга и других задач, которым одновременно нужны большой объем видеопамяти и вычисления на GPU.
Главное практическое преимущество 96 ГБ состоит в возможности разместить на одном ускорителе более крупную модель или оставить больше памяти под контекст и параллельные запросы. Но объем VRAM не определяет скорость ответа сам по себе. Влияют формат весов, вычислительные ядра программного стека, длина запроса, пакетная обработка и установленный лимит мощности.
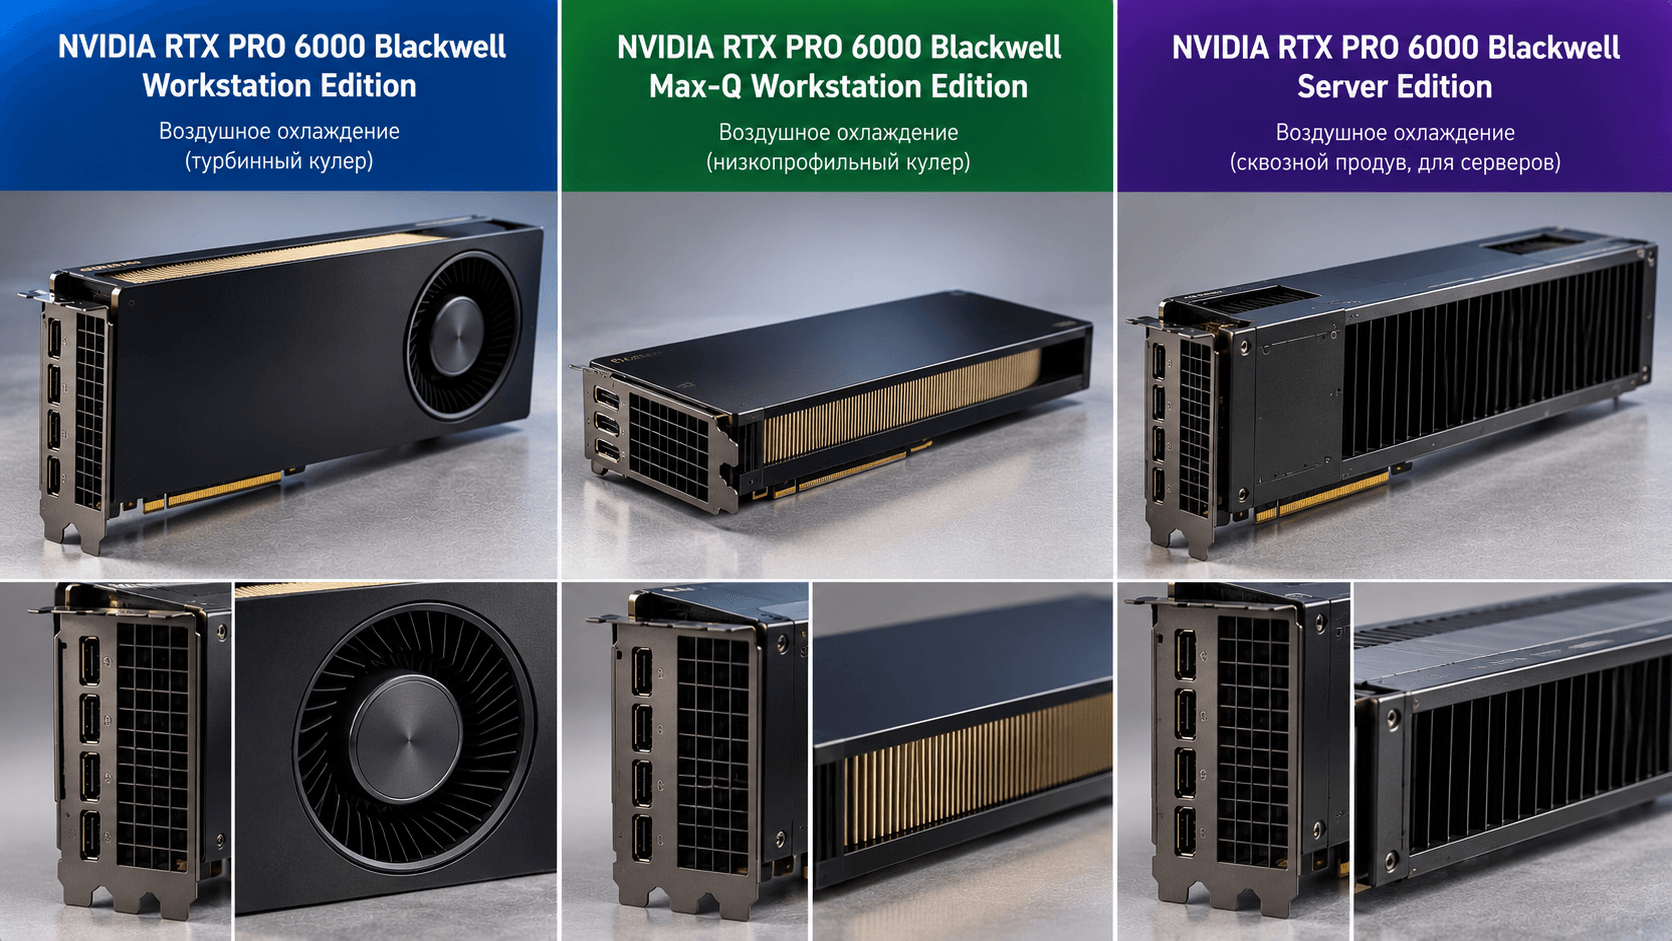
Что такое RTX PRO 6000 Blackwell и с какими картами ее путают
Семейство RTX PRO Blackwell было анонсировано 18 марта 2025 года. Это дата представления линейки, а не единая дата начала поставок всех моделей во всех странах.
RTX PRO 6000 Blackwell не следует путать с RTX 6000 Ada Generation. У модели Ada 48 ГБ GDDR6, у рассматриваемой Blackwell 96 ГБ GDDR7. Еще одно отдельное поколение, RTX A6000, относится к архитектуре Ampere. Сходство числового индекса не делает эти платы взаимозаменяемыми.
Названия «GeForce RTX PRO 6000» и «RTX PRO 6000 Ada» смешивают разные семейства. Для спецификации используйте полное обозначение с архитектурой и исполнением. Историческое слово Quadro также недостаточно для идентификации актуального изделия.
Blackwell здесь означает профессиональную RTX-линейку. Это не та же конфигурация GPU и памяти, что у B200 или B300 в системах HGX. Наличие одного архитектурного названия не дает оснований переносить характеристики серверного ускорителя с HBM и NVLink на PCIe-видеокарту с GDDR7.
Характеристики NVIDIA RTX PRO 6000 Blackwell
Ниже приведены параметры Workstation Edition. Отличия Max-Q и Server Edition вынесены в следующую таблицу, чтобы не смешивать спецификации.
Характеристика Workstation Edition | Значение | Что это меняет на практике |
|---|---|---|
Архитектура | NVIDIA Blackwell | Требуется совместимый драйвер и программный стек |
CUDA-ядра | 24 064 | Ресурс параллельных вычислений, не прямая оценка tokens/s |
Tensor Cores | Пятое поколение | Ускорение поддерживаемых матричных операций и низких точностей |
RT Cores | Четвертое поколение | Аппаратная трассировка лучей для графических задач |
Видеопамять | 96 ГБ GDDR7 с ECC | Вместимость моделей, кэшей, сцен и промежуточных данных |
Шина памяти | 512 бит | Один из параметров подсистемы памяти |
Пропускная способность памяти | 1792 ГБ/с | Передача данных внутри GPU, не скорость PCIe |
Интерфейс | PCIe 5.0 x16 | Связь GPU с платформой |
Пиковая FP32-производительность | 126 TFLOPS | Пиковая оценка для соответствующих операций |
Заявленная AI-производительность | 4000 AI TOPS | Эффективный пик FP4 со sparsity, не универсальная скорость модели |
Потребление платы | До 600 Вт | Нагрузка только GPU, без CPU, памяти и других компонентов |
Видеовыходы | 4 × DisplayPort 2.1b | Подключение дисплеев в поддерживаемом графическом режиме |
Видеоблоки | 4 NVENC девятого поколения и 4 NVDEC шестого поколения | Кодирование и декодирование поддерживаемых форматов видео |
Числа пиковой производительности приведены по спецификации NVIDIA. Для AI TOPS производитель указывает FP4 с разреженностью и частоты GPU Boost. Сравнивать этот показатель с FP16 или BF16 другой карты без приведения условий некорректно.
Workstation, Max-Q и Server Edition: какую версию выбрать
Параметр | Workstation Edition | Max-Q Workstation Edition | Server Edition |
|---|---|---|---|
Основной сценарий | Производительная рабочая станция | Рабочая станция с ограничениями по мощности или несколькими GPU | Серверная платформа |
Память | 96 ГБ GDDR7 ECC | 96 ГБ GDDR7 ECC | 96 ГБ GDDR7 ECC |
Пропускная способность памяти | 1792 ГБ/с | 1792 ГБ/с | 1597 ГБ/с |
Заявленный предел мощности | 600 Вт | 300 Вт | До 600 Вт, зависит от конфигурации |
Охлаждение | Активное, double flow-through | Активное | Воздушное серверное или жидкостное исполнение |
Базовый интерфейс | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 |
Что проверить первым | Габариты, питание и движение воздуха в корпусе | Размещение нескольких карт и общий тепловой бюджет | Поддержку точной платы сервером, лимит мощности и охлаждение |
Workstation Edition: одна мощная карта в рабочей станции
Workstation Edition рассчитана на задачи, которым нужна высокая производительность одного GPU: разработку AI-приложений, локальный инференс, работу с большими сценами и совмещение вычислений с профессиональной графикой.
У платы увеличенная высота и двухслотовое исполнение. Достаточного числа свободных слотов на материнской плате недостаточно: нужно проверить место в корпусе, подвод питания и отсутствие препятствий воздушному потоку.
В каталоге есть RTX PRO 6000 Blackwell Workstation Edition 96GB. Ее стоит рассматривать как компонент проверенной рабочей станции, а не как универсальную замену любой установленной видеокарты.
Max-Q: тот же объем VRAM при лимите 300 Вт
Max-Q сохраняет 96 ГБ памяти, но имеет другой режим мощности и активную систему охлаждения. NVIDIA позиционирует это исполнение в том числе для плотных рабочих станций с несколькими GPU.
При этом 300 Вт вместо 600 Вт не означают ровно половину скорости. Разница зависит от вычислительной нагрузки, частот, обращения к памяти и настроек. Модель, ограниченная пропускной способностью памяти, и задача с интенсивными матричными вычислениями могут реагировать на лимит мощности по-разному.
Вариант RTX PRO 6000 Blackwell Max-Q Workstation Edition имеет смысл проверять, когда критичны энергопотребление, тепловой режим или размещение нескольких карт. Его нельзя выбирать только по слову Max-Q без проверки возможностей всей станции.
Server Edition: для платформы с рассчитанным охлаждением
В спецификациях поставщиков встречаются сокращения SE и BSE, относящиеся к Server Edition и Blackwell Server Edition. Они не заменяют полный артикул.
Воздушная серверная плата использует пассивный радиатор и рассчитывает на направленный поток от вентиляторов шасси. «Пассивная» здесь не означает, что охлаждение не нужно. Установка такой карты в обычный корпус без подходящего воздушного тракта может привести к перегреву и снижению частот.
NVIDIA также указывает жидкостные серверные исполнения. Для них требуется соответствующая интеграция в систему охлаждения, а не только наличие свободного PCIe-слота.
Что дают 96 ГБ VRAM для LLM
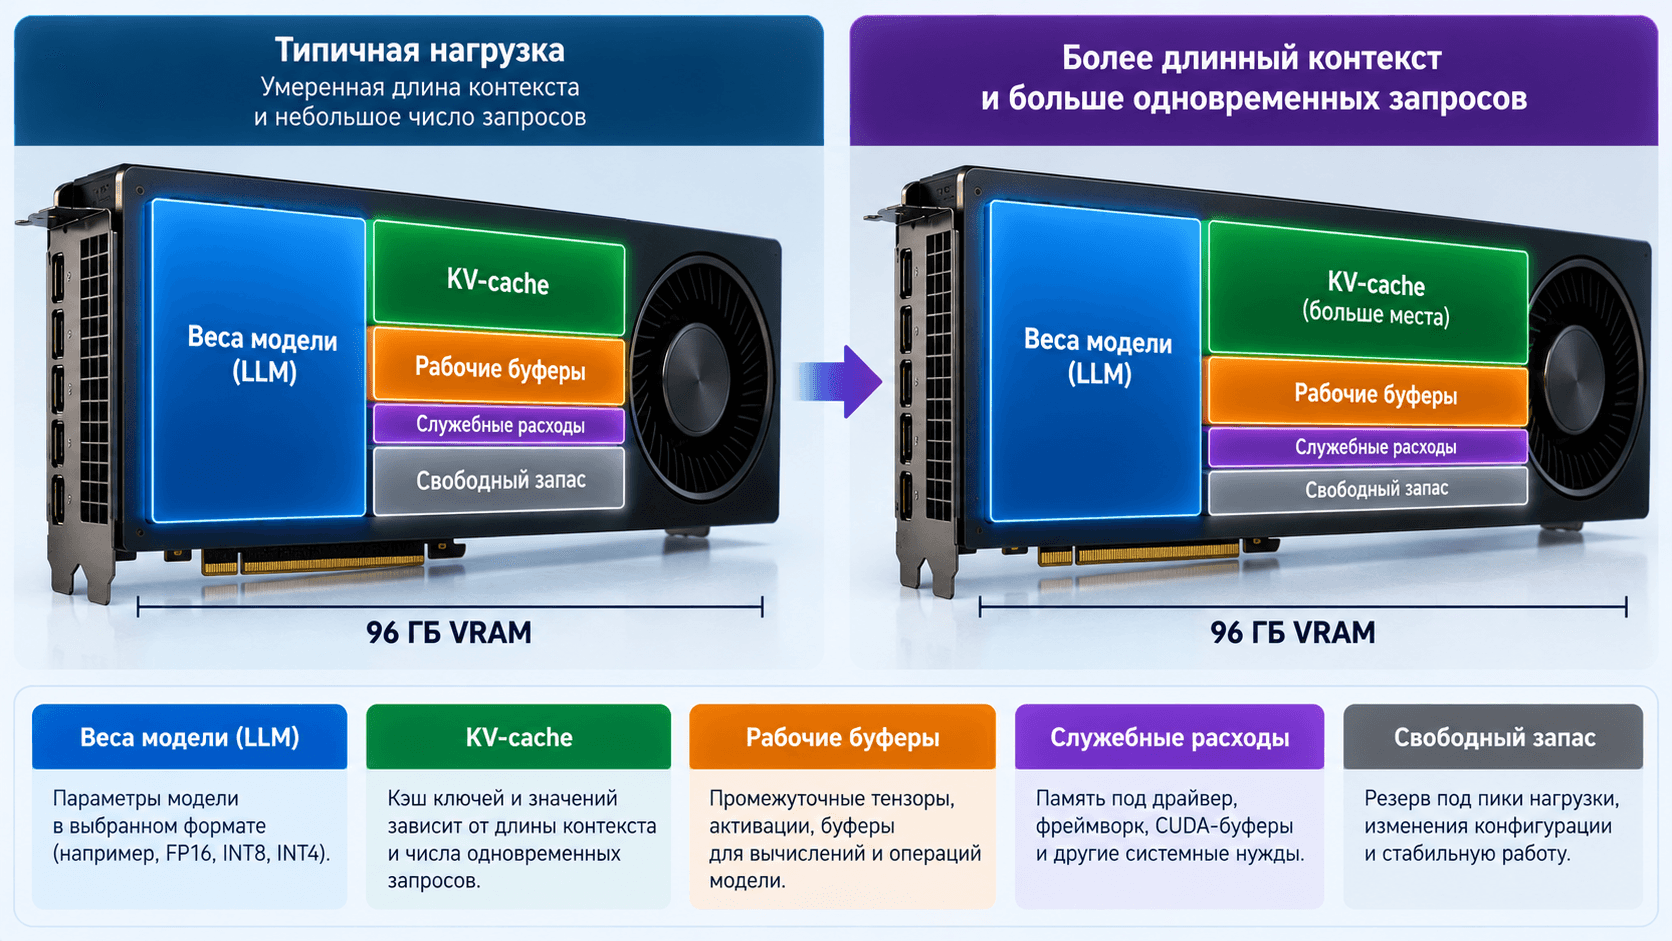
Видеопамять расходуется не только на файл модели. В ней находятся веса, KV-cache, рабочие буферы вычислительных операций, служебные структуры движка и иногда другие модели.
KV-cache хранит данные внимания для уже обработанных токенов. Его объем зависит от архитектуры LLM, длины сохраняемого контекста, числа одновременно обрабатываемых последовательностей и формата кэша. Поэтому одна модель может помещаться при коротком одиночном запросе и переставать помещаться при нескольких длинных диалогах.
Какие веса теоретически помещаются
Для предварительной оценки используют число параметров и объем данных на параметр. Ниже приведен только расчет хранения весов, без кэша и дополнительных расходов. ГБ здесь десятичные, 1 ГБ равен миллиарду байт.
Размер плотной модели | FP16/BF16, 2 байта на параметр | 8 бит, 1 байт на параметр | 4 бита, 0,5 байта на параметр |
|---|---|---|---|
8 млрд параметров | 16 ГБ | 8 ГБ | 4 ГБ |
32 млрд параметров | 64 ГБ | 32 ГБ | 16 ГБ |
70 млрд параметров | 140 ГБ | 70 ГБ | 35 ГБ |
Практический квантованный checkpoint обычно отличается от идеальной оценки. Нужны коэффициенты масштабирования, метаданные; часть тензоров может храниться с другой точностью. Потребление после загрузки также зависит от реализации.
Из таблицы следует ограниченный, но полезный вывод: все веса плотной 70B-модели в BF16 не помещаются целиком в 96 ГБ VRAM. Для одной карты рассматривают квантование, меньшую модель либо выгрузку части данных в оперативную память с отдельной оценкой скорости.
Квантованная 70B-модель может быть кандидатом для запуска на одной RTX PRO 6000. Это не гарантия любого контекста, числа пользователей или качества ответа. Проверяют конкретный checkpoint и движок.
Применение RTX PRO 6000 Blackwell для AI
Локальная LLM, RAG и AI-агенты
Большая память полезна для корпоративного ассистента, которому нужно обрабатывать длинные документы, работать с крупной моделью или обслуживать несколько запросов. Но число сотрудников не равно числу одновременно генерируемых ответов. Нагрузку рассчитывают по реальным сценариям и пикам активности.
В RAG-системе GPU не заменяет весь остальной контур. Поиск, хранение документов, подготовка текста, эмбеддинги и reranker могут иметь разные требования к ресурсам. Если все модели размещены на одном ускорителе, их потребление памяти учитывают совместно. Часть компонентов иногда рациональнее вынести на CPU или другой GPU.
Работа без внешнего облака также не обеспечивается одним названием карты. Нужно локально разместить модели, зависимости и данные, проверить настройки приложений, сетевые обращения и управление доступом.
Дообучение LoRA и QLoRA
LoRA обновляет сравнительно небольшой набор дополнительных параметров. QLoRA сочетает такой подход с квантованной базовой моделью. Это может снизить требования к памяти, но не убирает расходы на активации, буферы и состояние оптимизатора для обучаемых параметров.
Объем VRAM проверяют при выбранных длине последовательности, micro-batch, настройках gradient checkpointing и адаптера. Успешный инференс модели не доказывает, что ее дообучение пройдет с теми же настройками памяти.
Компьютерное зрение, генерация изображений и видео
Большой буфер памяти помогает работать с объемными входными данными, несколькими моделями и сложными пайплайнами. Однако скорость видеоаналитики зависит не только от нейросети. В нее входят декодирование, изменение размера кадров, передача данных, инференс и обработка результата.
NVDEC и NVENC разгружают соответствующие этапы работы с поддерживаемыми видеоформатами. Они не ускоряют любую операцию обработки изображения автоматически. При расчете сервера фиксируют кодек, разрешение, частоту кадров и то, какие блоки действительно использует приложение.
Графика, симуляции и научные приложения
RTX PRO 6000 может быть полезна там, где AI сочетается с визуализацией, трассировкой лучей и созданием синтетических данных. Это отличает ее профиль применения от выбора ускорителя исключительно под одну языковую модель.
Для научных вычислений нужно отдельно проверить точность. Высокие показатели FP32 или FP4 не означают такую же производительность FP64. Если приложение требует двойной точности, итоговое решение принимают по поддержке кода и измерениям именно этого режима.
FP4 и Blackwell: почему 4000 TOPS не равны скорости чат-бота
Tensor Cores пятого поколения поддерживают новые низкоточные вычисления. Это дает программным разработчикам дополнительные способы уменьшать объем данных и ускорять поддерживаемые операции.
Но выражения «4-битная модель» и «модель эффективно работает на аппаратном FP4» не равнозначны. Форматы NVFP4, NF4 и разные варианты целочисленного квантования отличаются представлением значений, масштабированием и необходимыми вычислительными ядрами. Поддержка одного формата не означает такую же скорость другого.
Чтобы использовать преимущество GPU, должны совпасть формат checkpoint, возможности движка и поддержка конкретной архитектуры в библиотеках. Простая загрузка любого файла с пометкой Q4 не гарантирует достижение заявленных AI TOPS.
Квантование также проверяют по качеству на рабочих задачах. Экономия памяти бесполезна, если модель перестает корректно извлекать факты, выполнять инструкции или вызывать инструменты. Сравнение должно включать не только скорость, но и сохранение нужного качества ответа.
Сколько токенов в секунду дает RTX PRO 6000
У карты нет одного универсального значения tokens/s. Результат меняется вместе с моделью, форматом весов, контекстом, движком и числом активных запросов. Даже для одного checkpoint обработка входного текста и генерация новых токенов имеют разный профиль нагрузки.
Для приемки полезны несколько метрик:
TTFT, время до первого токена: важно для интерактивного ответа и длинных документов.
Скорость генерации одного запроса после первого токена: показывает темп ответа конкретному пользователю.
Суммарный output throughput: сколько выходных токенов сервис выдает в секунду при заданном параллелизме.
Задержки p95/p99 и доля ошибок: показывают поведение под нагрузкой, а не только лучший запуск.
Пиковое потребление VRAM, температура и признаки ограничения частот: помогают выявить ресурсный предел.
При сравнении Workstation и Max-Q фиксируют одинаковую модель и программную среду. При сравнении серверов дополнительно учитывают PCIe-топологию, лимиты мощности и охлаждение. Нельзя переносить скорость одиночного короткого запроса на десятки длинных диалогов.
MIG: можно ли разделить 96 ГБ между несколькими задачами
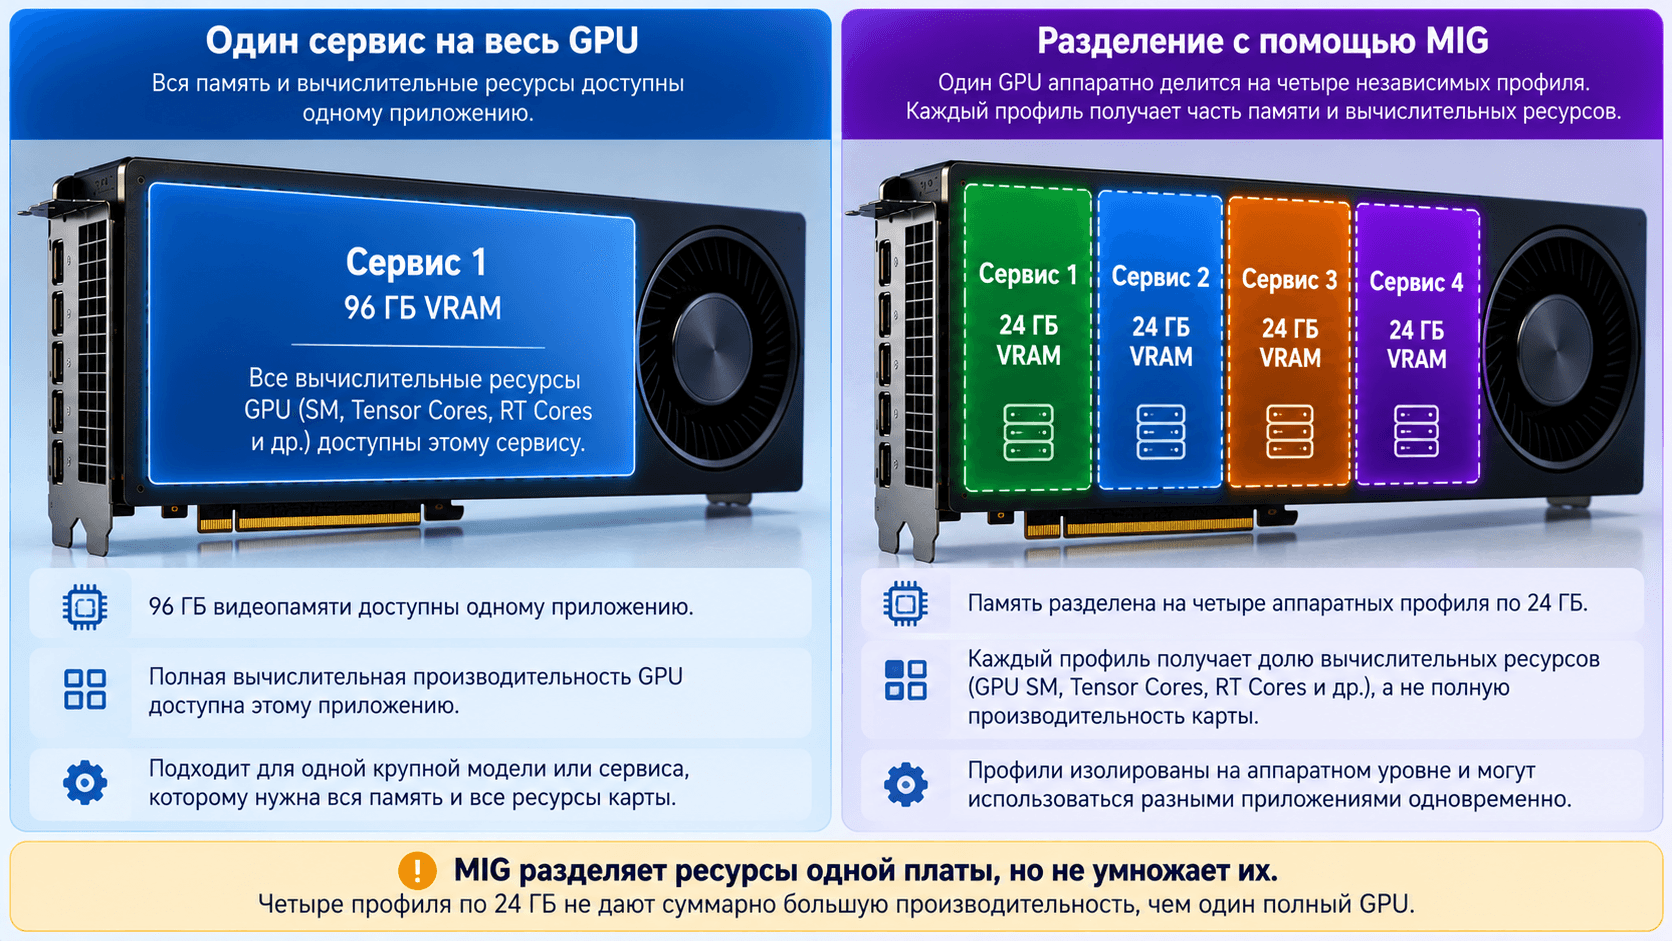
RTX PRO 6000 Blackwell поддерживает Multi-Instance GPU. MIG позволяет выделить аппаратно изолированные части GPU с собственными ресурсами памяти и вычислений. Для семейства NVIDIA указывает до четырех экземпляров; среди профилей есть варианты на 24, 48 и 96 ГБ.
Например, четыре профиля по 24 ГБ могут быть полезны для нескольких небольших независимых сервисов. Это не четыре полноценные RTX PRO 6000: между экземплярами распределяются также вычислительные ресурсы и части подсистемы памяти. Модель, которой требуется больше памяти, чем доступно в профиле, в него не поместится.
MIG нужен не в каждой системе. Если один движок обслуживает много запросов к одной модели, эффективная пакетная обработка на целом GPU может быть предпочтительнее. Деление стоит рассматривать, когда нужна предсказуемая изоляция независимых нагрузок, а не просто потому, что функция существует.
Есть и программные ограничения. В руководстве NVIDIA описано использование MIG на поддерживаемых Linux-системах, с требованиями к драйверу и vBIOS. Для Workstation и Max-Q перед включением MIG требуется соответствующий compute-режим. Переключение режима отключает физический вывод изображения с этой карты, что особенно важно для станции с единственным GPU и подключенным к нему монитором.
Несколько RTX PRO 6000: NVLink и объединение памяти
У рассматриваемых исполнений RTX PRO 6000 Blackwell нет поддержки NVLink. Для Server Edition это прямо указано в NVIDIA Product Brief; для настольных исполнений отсутствие NVLink Bridge отмечено в документации партнера PNY.
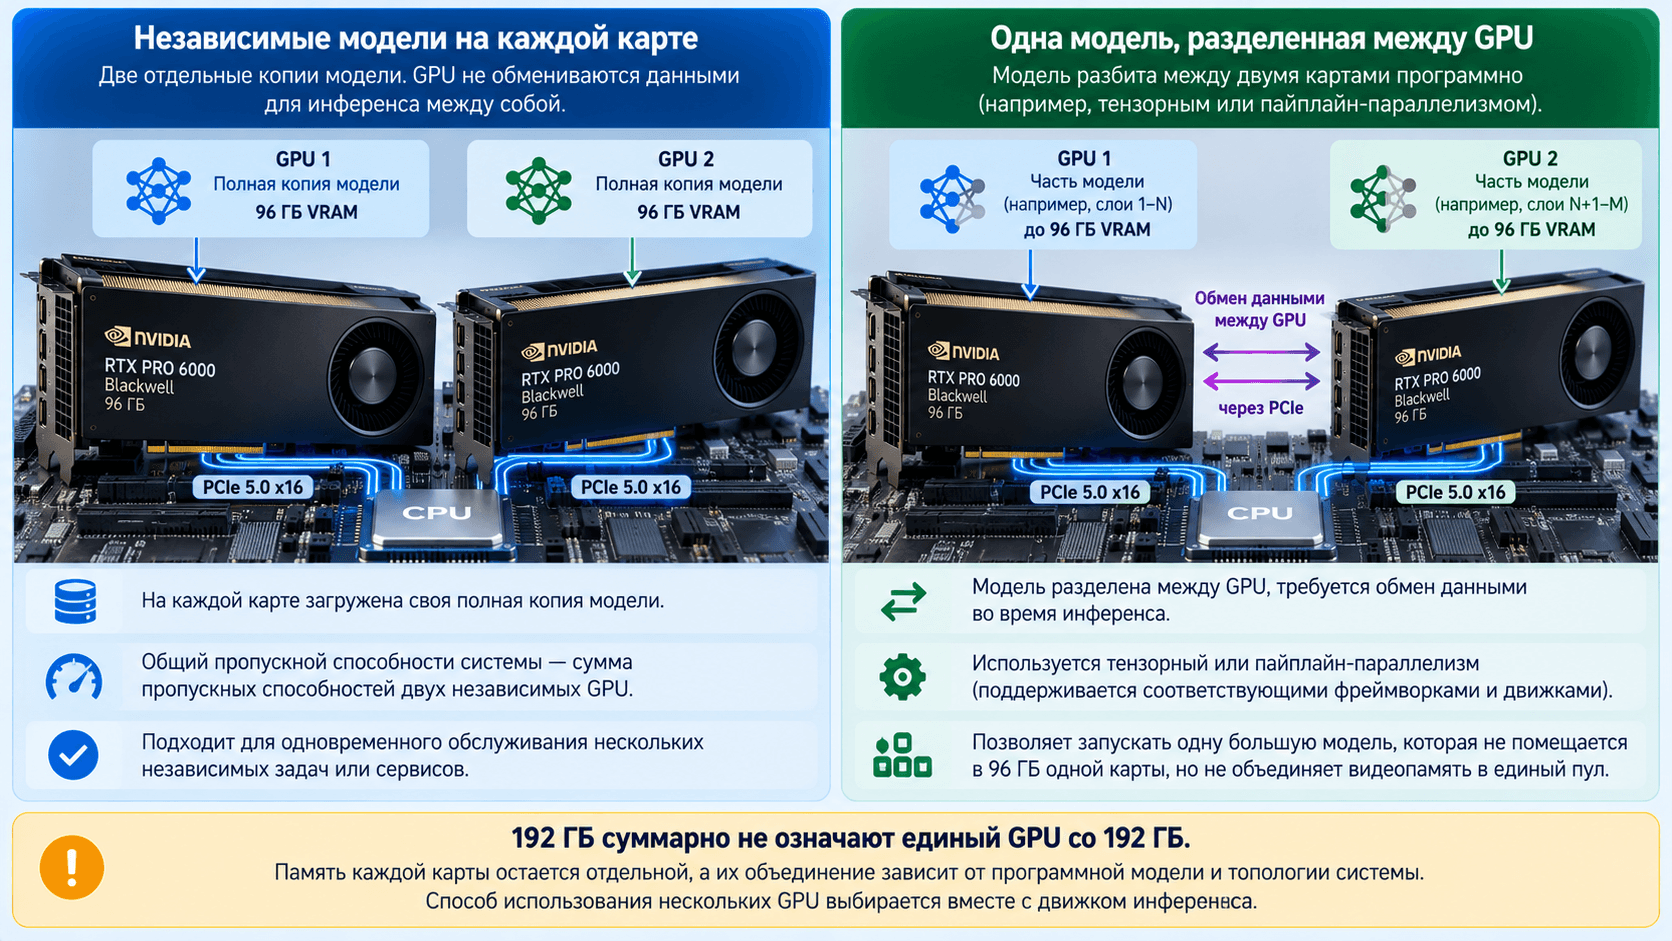
Две карты по 96 ГБ не превращаются автоматически в один GPU со 192 ГБ. Можно использовать их независимо или распределить модель с помощью поддерживаемого программного механизма. Во втором случае нужно учитывать, как данные передаются между ускорителями и сколько стоит такое взаимодействие по времени.
Для распределенной модели важны поддержка peer-to-peer, PCIe-коммутаторы, подключение к CPU и NUMA-топология. Нельзя гарантировать прямой обмен с одинаковой скоростью на любой материнской плате только по наличию двух слотов x16.
Возможны разные схемы:
Независимая копия модели на каждой GPU. Подходит для увеличения числа обслуживаемых запросов, если модель помещается на одной карте.
Разные модели или этапы обработки на разных GPU. Например, генерация отдельно от ресурсоемкой мультимодальной обработки.
Распределение одной модели между GPU. Требует поддержки движка и проверки накладных расходов обмена.
Драйвер, CUDA и совместимость AI-приложений
Для RTX PRO 6000 Blackwell NVIDIA указывает CUDA Compute Capability 12.0. Это характеристика архитектуры, а не номер устанавливаемого CUDA Toolkit. Она также отличается от характеристик вычислительных Blackwell B200 и B300.
Перед переносом приложения проверяют не только то, что карта отображается в системе. Нужны совместимые драйвер, среда выполнения, фреймворк и дополнительные CUDA-расширения. Контейнер, который работал с A100 или RTX 6000 Ada, не обязательно содержит подходящие реализации для новой карты.
Практический порядок проверки:
Выбрать поддерживаемую производителем системы комбинацию ОС, драйвера и firmware.
Проверить поддержку RTX Blackwell в выбранной сборке фреймворка и движка: PyTorch, vLLM, TensorRT-LLM или другом используемом ПО.
Сверить поддержку именно нужной модели, типа attention и формата квантования.
Запустить короткую функциональную проверку, затем нагрузку с рабочими контекстом и параллелизмом.
Для multi-GPU проверить обмен и распределение модели, а не ограничиваться успешным запуском на одной карте.
Сохранить версии драйвера, контейнера, библиотек, checkpoint и параметры теста в протоколе.
Ollama или другой локальный интерфейс может упростить первый запуск, но не отменяет проверку совместимости и требований к памяти. Успешная загрузка небольшой модели не доказывает готовность промышленного сервиса.
RTX PRO 6000, RTX 5090, Ada, L40S или H100
RTX PRO 6000 Blackwell или GeForce RTX 5090
У стандартной GeForce RTX 5090 32 ГБ GDDR7, у RTX PRO 6000 Blackwell 96 ГБ. Разница в объеме составляет три раза, но это не означает трехкратного ускорения любого приложения.
Если модель со всеми рабочими расходами помещается в 32 ГБ, выбор определяется измеренной скоростью, условиями эксплуатации и стоимостью системы. При нехватке памяти одной RTX 5090 сравнение меняется: понадобятся квантование, offload или несколько GPU, что влияет на сложность и задержки.
Профессиональная RTX PRO дополнительно рассматривается по требованиям к ECC, MIG, поддержке приложений и конкретной платформы. Покупать ее только ради индекса 6000 без потребности в этих возможностях не всегда рационально. Игровые FPS также не являются подходящей метрикой для выбора корпоративного LLM-сервера.
RTX PRO 6000 Blackwell или RTX 6000 Ada
Разница не ограничивается памятью. Это разные поколения архитектуры и Tensor Cores, GDDR7 вместо GDDR6, PCIe 5.0 вместо PCIe 4.0. Но перенос проекта все равно требует проверки программных компонентов и результата на своей модели.
Увеличение памяти с 48 до 96 ГБ может позволить отказаться от распределения модели между двумя картами. Возможность такого упрощения проверяют по фактическому потреблению, а не по размеру файла на диске.
RTX PRO 6000 Blackwell или L40S
Если задача уже укладывается в существующую 48-гигабайтную конфигурацию и выполняет требования по скорости, замена оборудования должна иметь измеримую пользу. Для другой нагрузки дополнительные 48 ГБ могут изменить архитектуру решения.
Подробный разбор этого выбора есть в статье «L40S или RTX PRO 6000 для LLM: когда нужны 96 ГБ». Он дополняет обзор линейки, но не заменяет проверку конкретной конфигурации.
RTX PRO 6000 Blackwell или H100
Для H100 имеют значение точное исполнение, HBM-память, поддерживаемые межсоединения и характеристики нужной точности. Одного сравнения объема VRAM недостаточно. H100 NVL, например, имеет другую организацию памяти и поддерживает NVLink, тогда как RTX PRO 6000 является PCIe-решением без NVLink.
Какой компьютер или сервер нужен для RTX PRO 6000
Питание и охлаждение
600 Вт в спецификации GPU не означают, что всей системе достаточно блока питания на 600 Вт. Добавляются CPU, оперативная память, накопители, вентиляторы, сетевые адаптеры и запас, предусмотренный проектом платформы.
Для четырех карт с лимитом 600 Вт арифметический бюджет только GPU составляет 2,4 кВт, для восьми 4,8 кВт. Это расчет по заданным лимитам, а не измерение потребления конкретного сервера. Электрическую инфраструктуру, охлаждение и резервирование считают по полной конфигурации.
Проверяют штатные силовые кабели и разъемы, допустимый лимит платы, способ фиксации и требования производителя к монтажу. Универсальный переходник не заменяет подтверждение совместимости системы питания.
CPU, оперативная память и накопители
CPU нужен для подготовки данных, токенизации, обслуживания запросов и работы остальных приложений. Число его ядер не выбирают пропорционально числу CUDA-ядер. Важнее профиль нагрузки и доступные PCIe-линии.
RAM рассчитывают по загрузке моделей, датасетам, процессам подготовки и возможному offload. Размер checkpoint на диске не всегда совпадает с пиковым расходом оперативной памяти при загрузке. Достаточность памяти проверяют также во время переинициализации сервиса или обновления модели.
NVMe-накопители влияют на загрузку весов, работу с данными и сохранение результатов. Но быстрый SSD не заменяет VRAM и не гарантирует ускорения генерации после того, как модель уже загружена на GPU.
Сценарии выбора
Сценарий | Что рассматривать в первую очередь | Что подтвердить до заказа |
|---|---|---|
Разработчик работает с одной крупной локальной LLM и графическими приложениями | Workstation Edition | Вместимость модели, питание, габариты, охлаждение |
Нужны 96 ГБ при более низком лимите мощности платы | Max-Q Workstation Edition | Реальную скорость в своем приложении, конфигурацию корпуса |
Несколько независимых AI-сервисов используют один сервер | Server Edition, при необходимости MIG | Ресурсы каждого сервиса, ОС, режимы изоляции и лицензии |
Нужна большая пропускная способность для одной помещающейся модели | Несколько GPU с независимыми копиями модели | Балансировку, ограничения CPU и сети, поведение при отказе |
Одна модель не помещается на GPU | Квантование или поддерживаемую multi-GPU-схему | Качество, память, обмен, задержки и альтернативные платформы |
Распределенное обучение интенсивно обменивается данными | Сравнение целых серверных архитектур | Межсоединения, точность, масштабирование, время обучения |
Цена RTX PRO 6000 Blackwell и проверка комплектации
Единой корректной цены «RTX PRO 6000 96 ГБ» без исполнения и условий поставки нет. Workstation, Max-Q и Server Edition нужно сравнивать как разные позиции. Для партнерских вариантов, в том числе PNY, проверяют артикул, комплектность и условия поддержки, а не только название GPU.
В запросе на покупку укажите:
полное название исполнения и точный артикул;
количество карт и модель рабочей станции или сервера;
допустимую мощность и способ охлаждения;
кабели, крепления и прочие необходимые компоненты;
требования к драйверам, ОС и программному обеспечению;
гарантийные условия, порядок замены и программу приемки.
Стоимость готового решения включает не только видеокарты. В нее могут входить серверная платформа, RAM, накопители, сеть, лицензии, установка, настройка и проверка нагрузки. Сравнивать цену одной платы с ценой введенного в эксплуатацию сервера некорректно.
В разделе NVIDIA RTX PRO 6000 Blackwell можно выбрать исполнение карты. Если требуется готовая система, используйте категорию серверов с NVIDIA RTX PRO 6000 и RTX A5000, проверяя модель GPU в конкретной карточке.
Частые вопросы
Для чего нужна NVIDIA RTX PRO 6000 Blackwell?
Для профессиональных вычислений и графики: локальных LLM, инференса, поддерживаемых сценариев дообучения, компьютерного зрения, видеообработки и рендеринга. Пригодность определяется конкретным приложением и исполнением платы.
Сколько видеопамяти у RTX PRO 6000 Blackwell?
У трех рассматриваемых исполнений заявлено 96 ГБ GDDR7 с ECC. Это емкость подсистемы памяти, а не гарантированный размер помещающейся модели. Нужно оставить место под кэши, буферы и служебные расходы.
Можно ли запустить LLM на 70 млрд параметров на одной карте?
Квантованная модель такого размера может быть кандидатом для запуска, но итог зависит от формата, контекста, движка и параллелизма. Все веса плотной 70B-модели в BF16 требуют около 140 ГБ по теоретическому расчету и целиком в 96 ГБ не помещаются.
Чем Max-Q отличается от обычной Workstation Edition?
У Max-Q лимит мощности 300 Вт против 600 Вт у Workstation Edition, другое исполнение платы и охлаждения. Объем памяти одинаковый. Разницу скорости нужно измерять: она не обязана совпадать с отношением пределов мощности.
Поддерживает ли RTX PRO 6000 Blackwell NVLink?
Нет, рассматриваемые исполнения не поддерживают NVLink. Несколько GPU можно использовать программно, но их память не становится единым пулом автоматически. Для распределенной модели проверяют возможности движка и PCIe-топологию.
Сколько токенов в секунду выдает карта?
Без указания модели и условий это число не определено. Нужны checkpoint, квантование, длины входа и ответа, число активных запросов, движок и лимит мощности. Оценивают TTFT, скорость генерации, суммарную производительность и задержки под нагрузкой.
RTX PRO 6000 Blackwell и RTX 6000 Ada являются одной моделью?
Нет. Это разные поколения. У RTX 6000 Ada Generation 48 ГБ GDDR6, у RTX PRO 6000 Blackwell 96 ГБ GDDR7. Для заказа нужно полное название, а не только число 6000.
Сколько стоит RTX PRO 6000 Blackwell?
Стоимость уточняют для выбранного исполнения, количества, комплектации и условий поставки. Для серверного проекта отдельно считают платформу, охлаждение, питание, ПО и проверку нагрузки. Сравнение только цены GPU не показывает бюджет готового решения.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


