Ollama позволяет скачать языковую модель и запустить ее на своем компьютере или сервере. Программа управляет файлами моделей, загружает их в память, принимает запросы через приложение, командную строку или API и возвращает ответы. С ее помощью собирают локального текстового помощника, проверяют модели для программирования и подключают генерацию ответов к корпоративным приложениям.
Для первого знакомства можно использовать имеющийся ПК. Небольшая модель способна работать на CPU, а совместимый GPU обычно делает диалог заметно комфортнее. Покупку оборудования лучше начинать после выбора модели: требования определяют ее размер, квантование, длина контекста и число одновременно выполняемых запросов.
У Ollama есть облачные функции. Если задача требует локальной обработки, нужно выбрать скачиваемую модель и проверить весь путь запроса. Само наличие программы на компьютере еще не определяет, где выполняются вычисления.
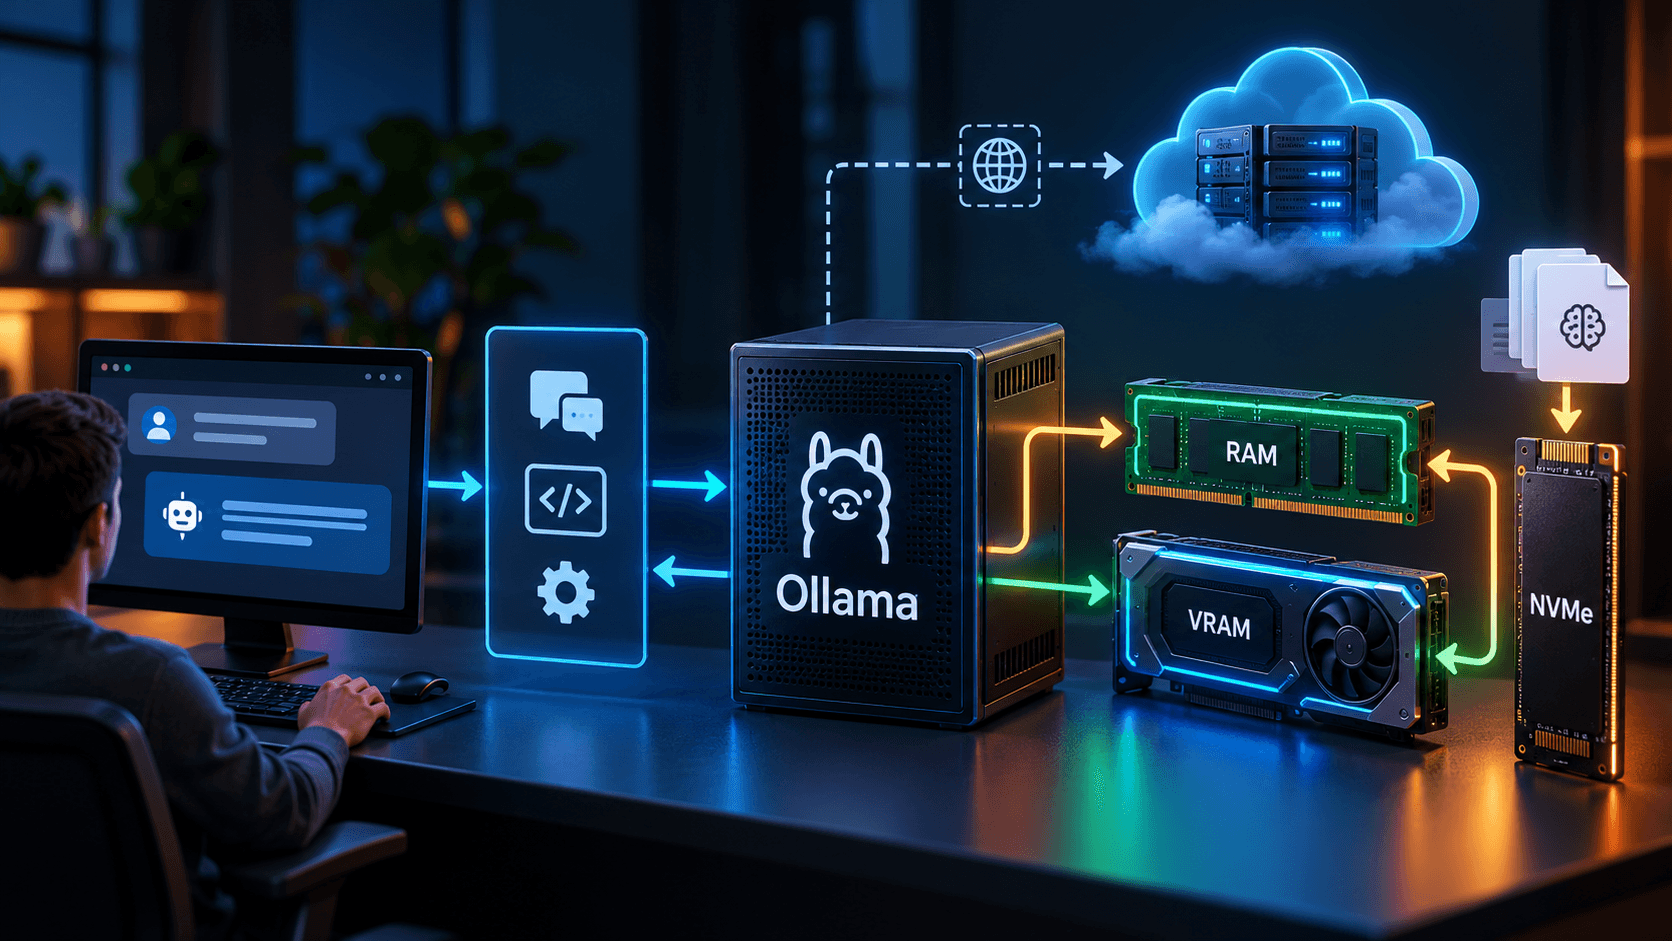
Что такое Ollama и чем она отличается от Llama
Ollama является программой запуска и обслуживания моделей. Llama, Qwen, Gemma и Mistral обозначают семейства моделей. Одну программу Ollama можно использовать с разными совместимыми моделями, каждая из которых имеет собственные возможности, размер и лицензию.
Большая языковая модель, или LLM, получает текст в виде токенов и вычисляет продолжение. Ollama организует выполнение этого процесса на доступном оборудовании. Пользователь выбирает модель, задает параметры и отправляет запрос, а программа управляет загрузкой и вычислениями.
Для обычного текстового чата достаточно готовых весов модели. Доступ к внутренним документам компании потребует дополнительных компонентов поиска. Для обучения понадобится отдельный процесс подготовки данных и изменения весов. Установка Ollama сама по себе этих задач не решает.
Какую модель выбрать для Ollama
Каталог Ollama Library содержит варианты разных размеров и назначений. Запись вида qwen2.5:7b состоит из имени и тега. Тег помогает выбрать вариант, но для воспроизводимого серверного развертывания дополнительно сохраняют идентификатор модели, параметры и версию Ollama.
При выборе проверьте:
Задачу. Диалог, написание кода, извлечение данных и создание эмбеддингов требуют разных моделей.
Качество на русском языке. Используйте свои документы и вопросы, включая профессиональные термины.
Размер и квантование. Обозначение
7Bили32Bотносится к масштабу модели, аQ4_K_Mописывает один из способов уменьшить размер весов.Поддержку нужных функций. Изображения, инструменты и структурированный ответ доступны не у каждой модели.
Лицензию. Проверяют условия конкретного варианта, а не только название семейства.
Работу на своем оборудовании. Длинный документ и несколько запросов одновременно могут изменить требования сильнее, чем короткий пробный диалог.
Для примера запуска ниже используется qwen2.5:7b. На момент проверки карточка указывает 7,62 млрд параметров, квантование Q4_K_M и размер загрузки около 4,7 ГБ. Это конкретный пример для инструкции, без утверждения, что он превосходит более новые модели. Параметры приведены в официальной карточке Qwen2.5:7B.
Как установить Ollama на Windows, Linux и macOS
Установочные файлы берут с официальной страницы загрузки Ollama. Выберите пакет для своей ОС и архитектуры процессора. Для первого запуска понадобятся место под программу и файлы модели, а также интернет для загрузки. После подготовки локальная модель может работать офлайн.
Windows
Скачайте официальный установщик для Windows, выполните установку и запустите приложение. Затем откройте новое окно PowerShell или командной строки и проверьте CLI:
ollama --versionЕсли команда не найдена, сначала перезапустите терминал и проверьте завершение установки. Для нативной установки Ollama на Windows отдельная Linux-машина не требуется. Поддержку конкретного GPU и драйвера проверяют отдельно: присутствие NVIDIA или AMD в названии карты еще не подтверждает совместимость всей конфигурации. Порядок установки и требования приведены в документации Ollama для Windows.
Linux
Официальный способ установки использует скрипт. Для сервера его удобно сначала сохранить и просмотреть, затем запустить:
curl -fsSL https://ollama.com/install.sh -o ollama-install.sh
less ollama-install.sh
sh ollama-install.sh
Выйти из less можно клавишей q. Установщик может запросить административные права. На системе с systemd после установки проверьте службу:
systemctl status ollama --no-pager
ollama --version
При ручной установке сервер запускают командой ollama serve. Если служба уже работает, запускать второй экземпляр на том же порту не нужно. Варианты ручной установки, архитектуры пакетов и управление службой описаны в официальной инструкции для Linux.
macOS
Установите приложение из официального пакета и откройте его. На Mac с Apple Silicon ускорение использует GPU и общую память системы; доступный объем памяти делится с macOS и другими приложениями. Он не равен объему отдельной видеокарты в ПК.
Как скачать модель и получить первый ответ
После установки выполните:
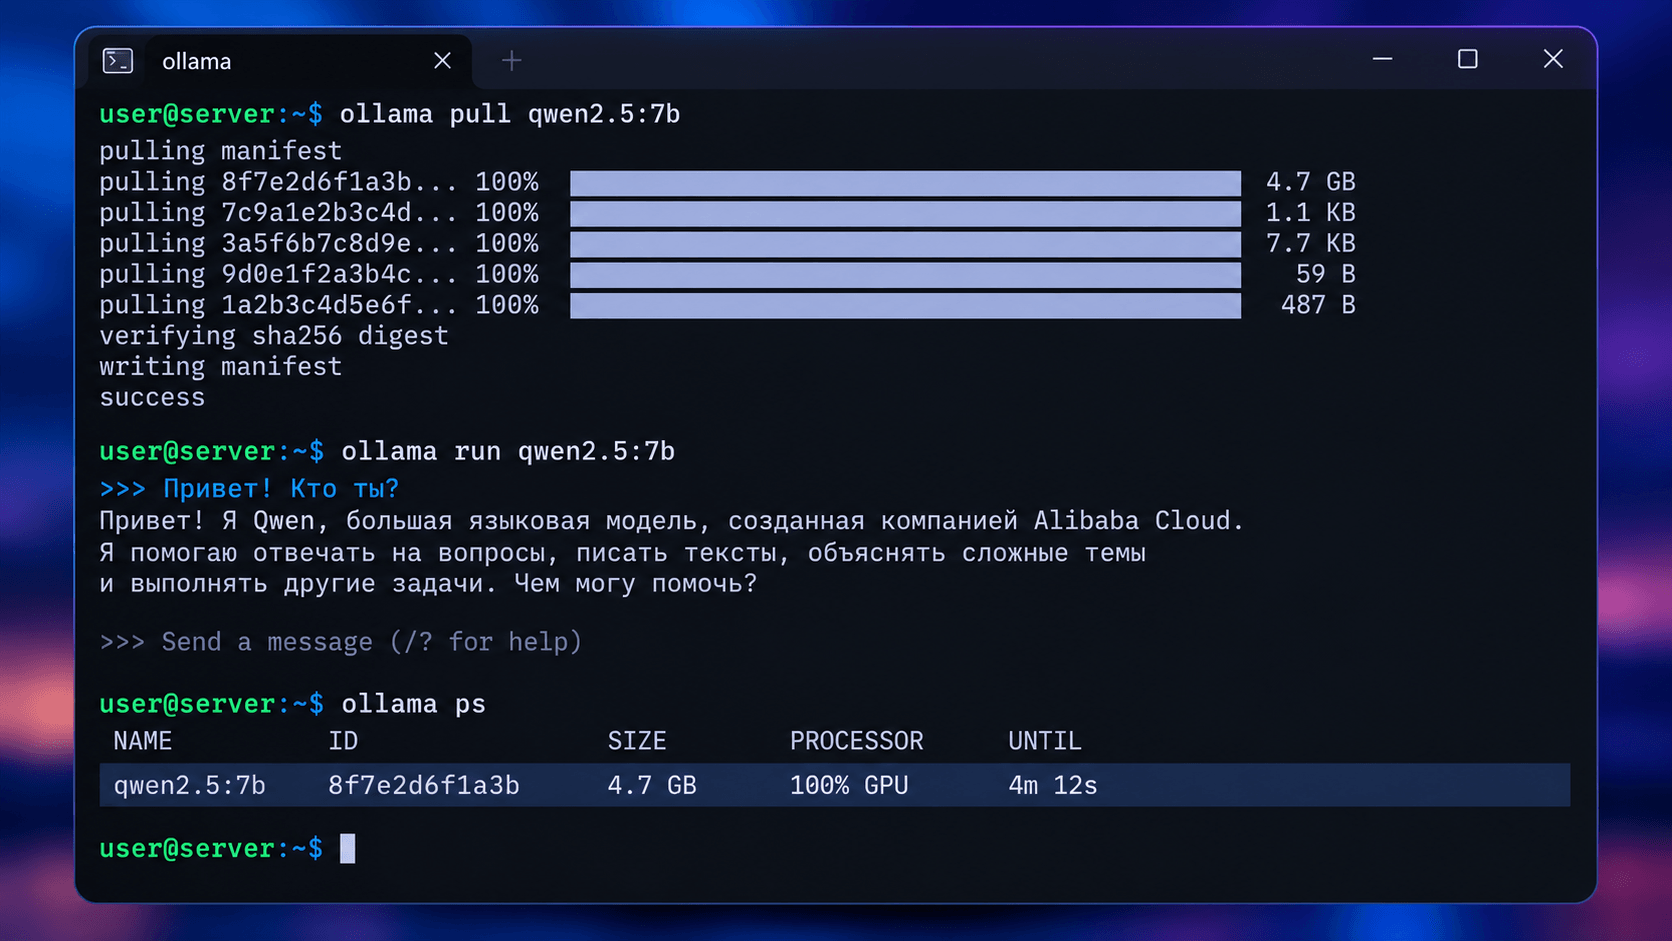
ollama pull qwen2.5:7b
ollama run qwen2.5:7b
Первая команда загружает модель, вторая открывает диалог. Если модель отсутствует локально, run также может инициировать загрузку. Для проверки задайте простой запрос: «Объясни разницу между оперативной памятью и SSD в четырех предложениях».
Затем попробуйте задачу, ради которой нужен локальный AI: краткое резюме документа, извлечение полей из текста или разбор небольшой функции. Проверьте точность ответа, язык и время ожидания. Успешная загрузка модели подтверждает работу программы, но качество нужно оценивать отдельно.
В интерактивном диалоге можно явно ограничить контекст:
/set parameter num_ctx 4096Значение 4096 здесь выбрано для первого теста. Оно не объявляется универсальным размером контекста по умолчанию. При переходе к длинным документам контекст увеличивают и повторно измеряют память и скорость.
Основные команды Ollama
Команда | Что делает |
|---|---|
| Показывает скачанные модели |
| Выводит сведения о выбранной модели |
| Показывает модели, загруженные в память |
| Выгружает модель из памяти, сохраняя файлы |
| Удаляет локальную модель; при следующем использовании понадобится загрузка |
| Запускает серверный процесс |
Как проверить, использует ли Ollama GPU
Во время генерации или сразу после ответа откройте второй терминал и выполните ollama ps. Поле PROCESSOR показывает размещение модели: полностью на GPU, на CPU либо частично на обоих. Это характеристика размещения, а не процент текущей загрузки вычислительных ядер.
На системе с NVIDIA дополнительно запустите:
nvidia-smiСопоставьте использование видеопамяти, процессы и активность GPU с моментом выполнения запроса. У короткого ответа нагрузка может закончиться до обновления показателей. Запущенный графический рабочий стол тоже занимает VRAM, поэтому смотреть нужно на свободную память, а не только на паспортный объем.
Если модель работает на CPU, сначала проверьте поддержку карты, версию драйвера, доступность GPU из выбранной среды и свободную память. В Docker добавляется проверка доступа контейнера к ускорителю. Установка еще одной копии CUDA Toolkit сама по себе не устраняет любую ошибку обнаружения GPU.
Какой GPU нужен для Ollama и сколько требуется VRAM
Системные требования Ollama состоят из двух частей: совместимость программы с устройством и ресурсы выбранной модели. GPU может поддерживаться, но иметь недостаточно памяти или работать слишком медленно для вашего сервиса. А небольшая модель может оказаться полезной даже без дискретной видеокарты.
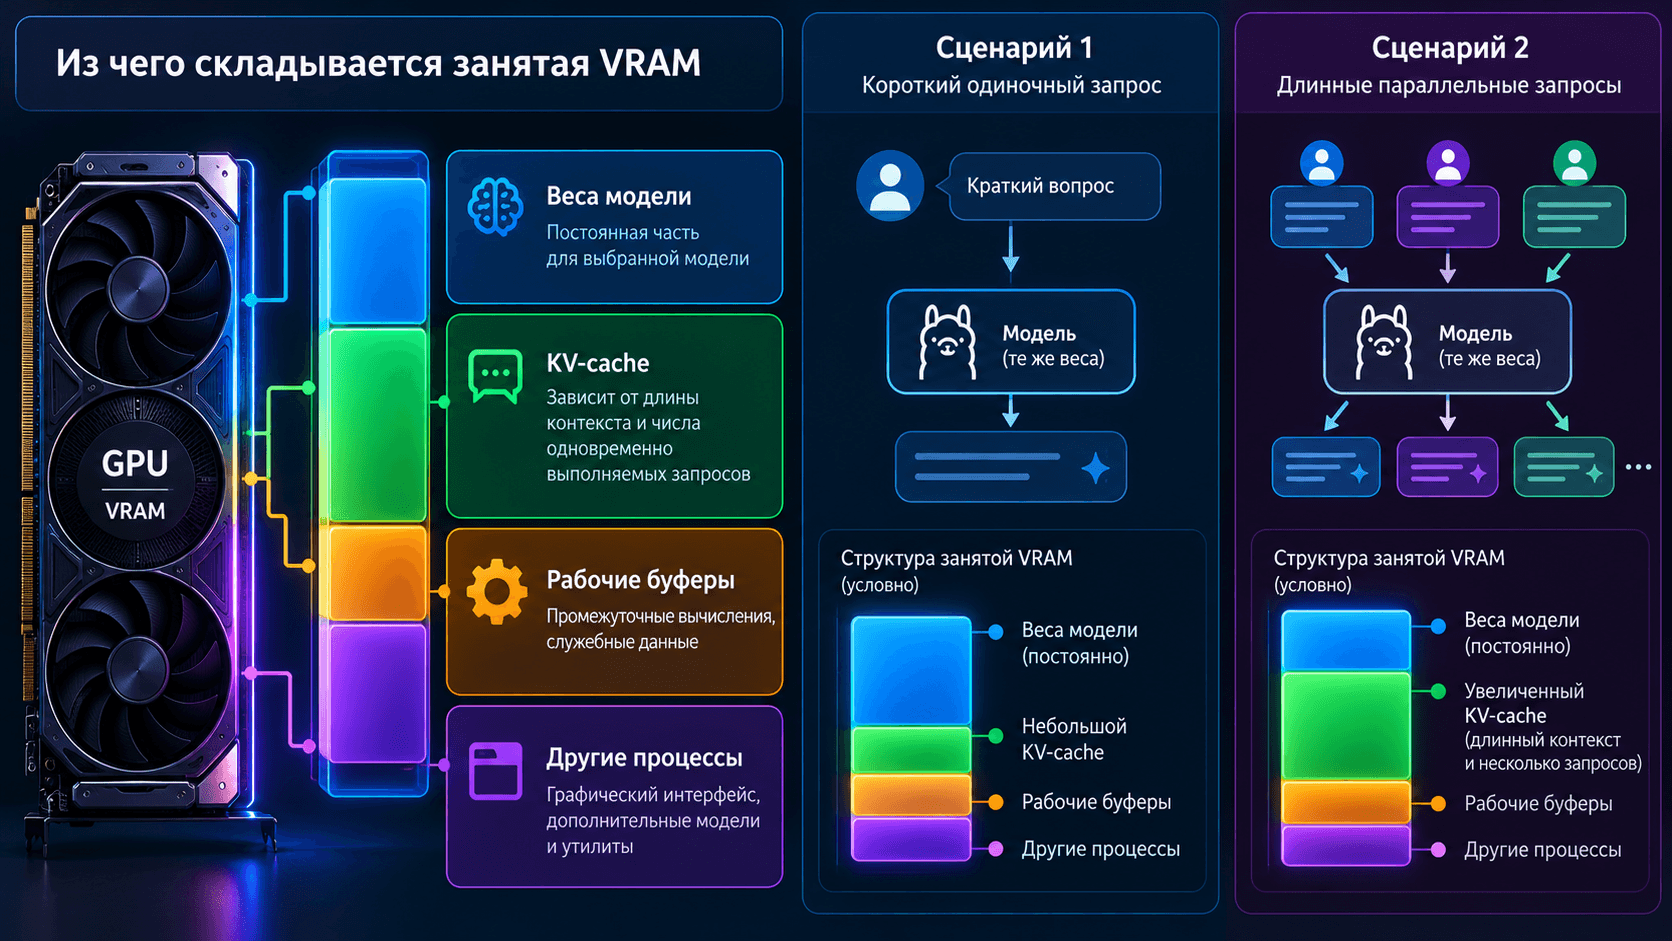
Видеопамять расходуется на веса, состояние контекста, рабочие буферы и другие процессы. Для обычной трансформерной LLM значительную часть переменных затрат составляет KV-cache, кеш промежуточных данных внимания.
Приближенная формула для оценки весов:
Память весов в байтах ≈ число параметров × бит на параметр / 8

Рабочая память ≈ веса + KV-cache + буферы исполнения + резервОриентиры для первого подбора
Таблица ниже относится к плотным текстовым моделям, квантованию примерно Q4, одному запросу и контексту порядка 4 тыс. токенов. Это инженерные ориентиры для отбора конфигураций, а не измеренный тест и не гарантия размещения любой модели указанного размера.
Масштаб модели | Отправная точка по VRAM | Что проверить |
|---|---|---|
3-4B | 6-8 ГБ | Качество на вашей задаче и память остальных приложений |
7-8B | 8-12 ГБ | Точное квантование, длину диалога и использование GPU рабочим столом |
12-14B | 12-16 ГБ | Запас для контекста и буферов |
30-32B | 24-32 ГБ | Полное размещение на GPU при нужном контексте |
70-72B | 48-80 ГБ | На нижней границе запас может быть небольшим; длинный контекст и параллельность меняют расчет |
У MoE-моделей число активных параметров за один шаг может быть намного меньше полного числа параметров. Для предварительной оценки памяти нельзя учитывать только активную часть: веса остальных экспертов тоже нужно где-то разместить. Для мультимодальных моделей добавляются компоненты обработки изображений и другой входной информации.
NVIDIA, AMD и Apple Silicon
Ollama поддерживает разные аппаратные пути ускорения. У NVIDIA проверяют архитектуру и драйвер, у AMD совместимость зависит также от ОС и используемого вычислительного бэкенда. Для Apple Silicon предусмотрено ускорение через Metal. Перечни меняются, поэтому перед закупкой сверяют точный GPU с официальной таблицей аппаратной поддержки Ollama.
На ПК для одного пользователя имеет смысл сначала проверить имеющуюся совместимую видеокарту. Если модель занимает лишь часть VRAM и отвечает достаточно быстро, серверный ускоритель может не дать полезного для задачи выигрыша. Отдельная серверная платформа становится оправданной при общем доступе, постоянной нагрузке и требованиях к обслуживанию.
Какие серверные ускорители рассмотреть
Для компактного серверного узла кандидатом может быть NVIDIA L4 с 24 ГБ памяти. По спецификации NVIDIA у нее TDP 72 Вт и низкопрофильное однослотовое исполнение. Такой формат удобен при ограничениях по питанию и месту. Возможность разместить нужную LLM проверяют вместе с контекстом.
Если необходим больший объем на одном устройстве, рассматривают NVIDIA L40S с 48 ГБ памяти. Это двухслотовый ускоритель с максимальным потреблением 350 Вт и пассивным охлаждением. Его установка требует подходящего корпуса, питания и организованного воздушного потока. Характеристики подтверждаются спецификациями L4 и L40S.
Разница между этими GPU включает не только объем памяти. Нельзя переносить скорость одной модели на другую по соотношению гигабайт или пиковых FLOPS. Если задача требует 80 ГБ и больше, сначала сравнивают размещение на одном ускорителе и разбиение между несколькими, затем оценивают стоимость всей платформы.
Помогут ли две видеокарты
Ollama может распределять поддерживаемую модель между несколькими GPU. Однако две карты по 24 ГБ не превращаются в единое устройство с характеристиками 48-гигабайтной карты. Влияют распределение слоев, соединение PCIe, служебные затраты и возможности выбранного бэкенда.
Как настроить контекст и избежать нехватки памяти
Контекст включает системную инструкцию, историю диалога, приложенные фрагменты документов и место для ответа. Его измеряют в токенах. Длинный контекст увеличивает расход памяти, а обработка большого входного текста добавляет время до начала ответа. Поэтому максимальное значение из карточки модели не обязательно подходит для вашего оборудования. Принцип подсчета объясняется в статье «Токены в нейросетях и LLM».
Для приложения размер контекста задают параметром num_ctx в запросе. На уровне сервера применяют OLLAMA_CONTEXT_LENGTH. Изменение переменной в случайном терминале не перенастраивает уже работающую службу: значение должно получить именно серверное приложение при следующем запуске. Способ настройки и проверка текущего контекста описаны в документации Ollama.
При нехватке памяти сначала уменьшите контекст до действительно необходимого, проверьте другие загруженные модели и закройте приложения, занимающие VRAM. Затем сравните меньшую модель или другое квантование на том же наборе задач. Агрессивное уменьшение точности может повлиять на качество, особенно в сложных задачах и при длинных документах.
Локальный Ollama API: пример запроса
По умолчанию локальный сервер использует порт 11434. Для скачанной локальной модели API-ключ не нужен. Это отличается от прямого обращения к облачному API Ollama, где применяется авторизация. Различие адресов и способов подключения описано в официальной документации API.
В Linux или macOS отправьте запрос после загрузки модели:
curl --fail-with-body http://localhost:11434/api/chat \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "qwen2.5:7b",
    "messages": [
      {"role": "user", "content": "Объясни назначение ECC-памяти в трех предложениях."}
    ],
    "stream": false,
    "options": {
      "num_ctx": 4096,
      "num_predict": 256,
      "temperature": 0.2
    }
  }'
Пример для PowerShell использует его собственный HTTP-клиент:
$ollamaRequest = @{
    model = 'qwen2.5:7b'
    messages = @(
        @{ role = 'user'; content = 'Объясни назначение ECC-памяти в трех предложениях.' }
    )
    stream = $false
    options = @{ num_ctx = 4096; num_predict = 256; temperature = 0.2 }
} | ConvertTo-Json -Depth 5

$ollamaReply = Invoke-RestMethod `
    -Uri 'http://localhost:11434/api/chat' `
    -Method Post `
    -ContentType 'application/json; charset=utf-8' `
    -Body ([System.Text.Encoding]::UTF8.GetBytes($ollamaRequest))

$ollamaReply.message.content
Поле message.content содержит текст ответа. Значение stream: false выбрано для удобства первого теста, чтобы получить один JSON-документ. Для пользовательского чата часто удобнее потоковая выдача, когда текст появляется постепенно. Формат запроса и полей результата приведен в описании /api/chat.
Как измерить скорость
В ответе API доступны счетчики токенов и длительности этапов. Для оценки скорости генерации используют:
Скорость генерации, токенов/с = eval_count / eval_duration × 1 000 000 000Множитель переводит наносекунды в секунды. Это скорость этапа генерации, она не включает все ожидание пользователя. Отдельно измеряют загрузку модели, обработку входного текста, очередь и время до первого токена в потоковом режиме.
Первый запрос после выгрузки модели и следующий запрос могут существенно отличаться. В протоколе теста фиксируют оба режима, точную модель, контекст, длину ответа, драйвер и оборудование. Для сервиса дополнительно проверяют несколько одновременных запросов и процент ошибок. Сравнивать чужие показатели помогает материал «Как читать бенчмарки GPU для LLM».
Ollama в Docker
Для Linux-сервера контейнер удобен тем, что упрощает воспроизведение окружения и отделяет процесс от остальных приложений. При работе с NVIDIA сначала устанавливают совместимый драйвер и NVIDIA Container Toolkit. Контейнер не заменяет драйвер на хосте.
Минимальный пример для локального теста с NVIDIA:
docker run -d \
  --name ollama-local \
  --gpus all \
  -p 127.0.0.1:11434:11434 \
  -e OLLAMA_NO_CLOUD=1 \
  -v ollama-local-models:/root/.ollama \
  ollama/ollama

docker exec -it ollama-local ollama run qwen2.5:7b
Именованный том сохраняет модели, а привязка порта к 127.0.0.1 оставляет доступ с этого хоста. Если локальная служба Ollama уже занимает порт, сначала выберите один способ запуска либо назначьте контейнеру другой порт хоста.
Как добавить GGUF, WebUI и работу с документами
Импорт готовой модели
Если нужного варианта нет в каталоге, Ollama позволяет импортировать совместимые локальные веса. Для одиночного GGUF-файла создайте текстовый Modelfile рядом с моделью:
FROM ./model.gguf
PARAMETER num_ctx 4096
Затем выполните в этом каталоге:
ollama create local-assistant -f Modelfile
ollama run local-assistant
Файл model.gguf должен существовать, а его архитектура и формат должны поддерживаться вашей версией Ollama. Команда create в этом примере регистрирует подготовленную модель. Добавление системной инструкции через Modelfile также не является обучением. Поддерживаемые способы загрузки описаны в руководстве по импорту моделей.
Интерфейс в браузере
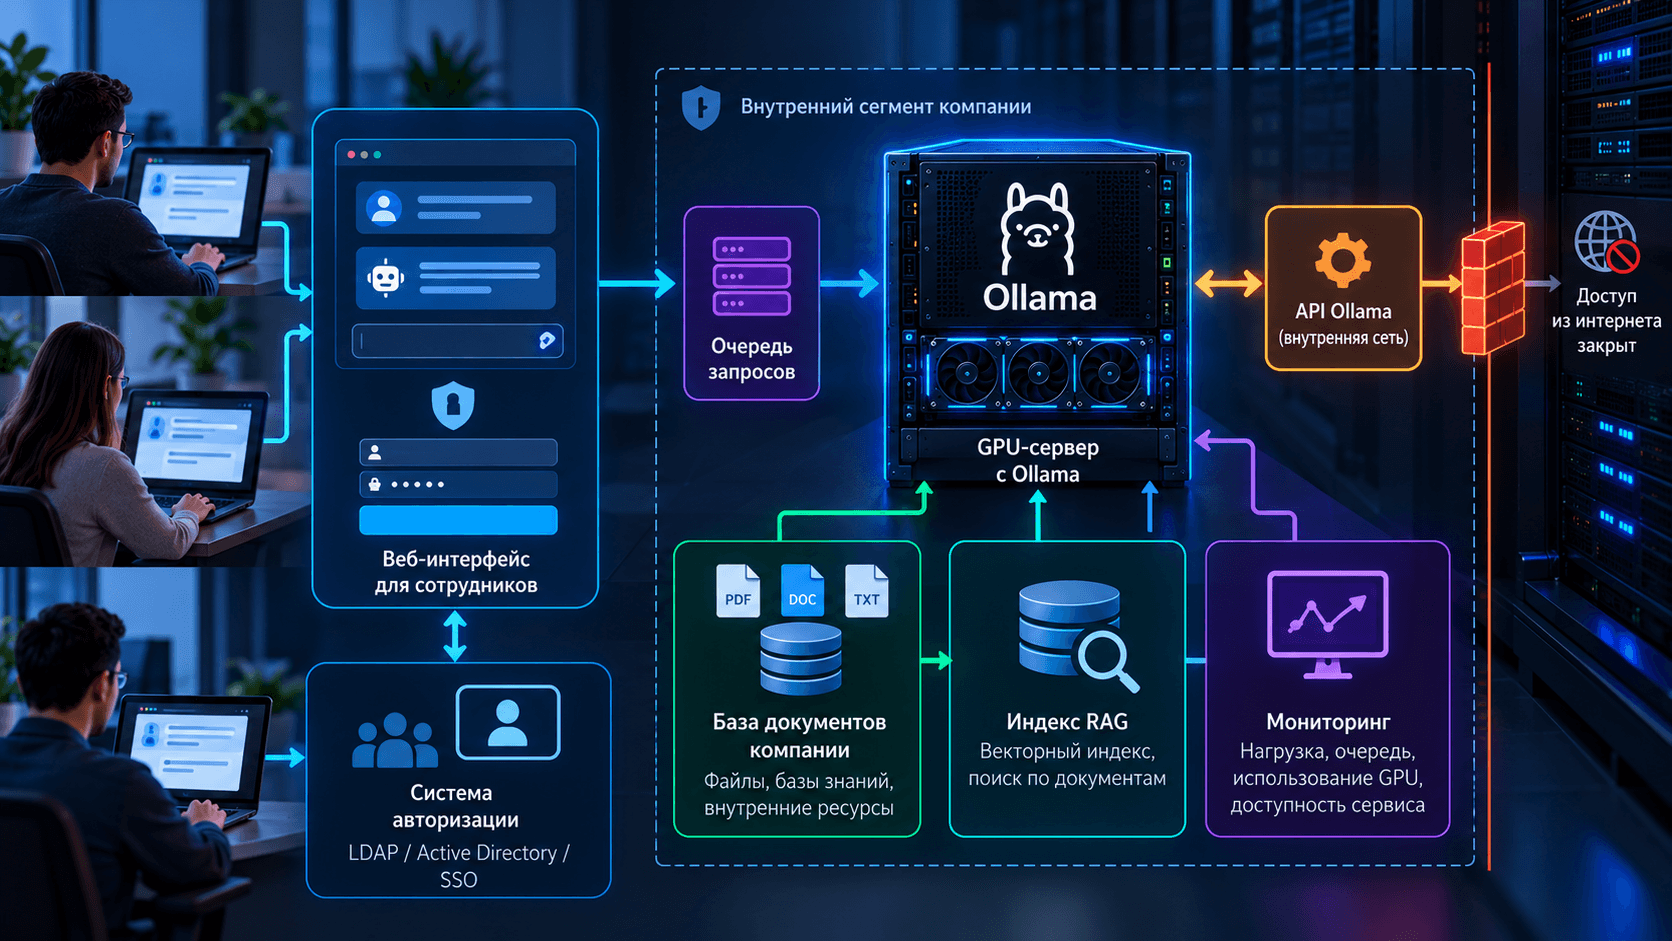
Если сотрудникам нужен общий чат, к Ollama можно подключить отдельный веб-интерфейс. Например, Open WebUI поддерживает работу с Ollama и локальными моделями. Это самостоятельное приложение со своими настройками, хранилищем данных и учетными записями. Его возможности описаны в документации Open WebUI.
При подключении из другого контейнера localhost обозначает сам этот контейнер. Используйте адрес сервиса Ollama в общей контейнерной сети. Указание неверного адреса часто выглядит как проблема модели, хотя запрос вообще не достигает сервера.
Ответы по внутренним документам
Для RAG отдельно организуют извлечение текста, разбиение документов, вычисление эмбеддингов и поиск. Ollama может выполнять генерацию или обслуживать совместимую embedding-модель, а приложение передает найденные фрагменты в запрос к LLM. Подключение файла к чату не меняет веса модели.
Качество ответа зависит и от поиска, и от генерации. Для корпоративных документов добавляются права доступа к исходным материалам и индексу. Полная схема разобрана в статье «RAG-система: архитектура, компоненты и этапы внедрения».
Как запустить Ollama без интернета
Подготовьте установщик, драйверы, модели и зависимости на этапе, когда загрузка доступна. Для контейнерного развертывания потребуется также локально доступный образ. Затем отключите облачные функции Ollama переменной OLLAMA_NO_CLOUD=1 в окружении серверного процесса и перезапустите его. Этот режим описан в официальном FAQ Ollama.
Практическая проверка состоит в запуске всего сценария после перезагрузки с недоступным интернетом. Нужно проверить не только чат, но и обработку документов, эмбеддинги и интерфейс. Плагин веб-поиска или внешний сервис распознавания может создавать зависимость от сети даже при локальной LLM.
Как выбрать сервер для Ollama
Сервер рассчитывают по одновременной нагрузке. Двадцать зарегистрированных сотрудников и двадцать одновременно генерируемых ответов предъявляют разные требования. Длинные документы, несколько загруженных моделей и повторные обращения увеличивают нагрузку на память и очередь.
Ниже приведены примеры стартовых спецификаций для обсуждения. Это не результаты тестирования и не гарантированная емкость сервиса.
Сценарий | Конфигурация-кандидат | Что подтверждают тестом |
|---|---|---|
Личный помощник, модель 7-8B примерно Q4 | Совместимый GPU 8-12 ГБ, RAM 32 ГБ, SSD | Качество, размещение модели и время ответа при выбранном контексте |
Общий пилот, модель 12-14B примерно Q4 | GPU 24 ГБ, RAM 64 ГБ, NVMe | Скорость при реальной очереди и запас памяти под документы |
Модель 30-32B, RAG и увеличенный контекст | GPU 48 ГБ, RAM от 128 ГБ, NVMe под модели и индекс | Пиковая память, задержка первого токена и одновременные обращения |
Крупная модель или интенсивный общий сервис | Один GPU большей емкости либо несколько GPU, RAM и сеть по расчету | Способ распределения, качество обслуживания и целесообразность выбранного движка |
Объем RAM в таблице является ориентиром для конфигурации целиком. Потребности RAG, парсинга документов и других приложений считают дополнительно. Количество и емкость NVMe зависят от числа версий моделей, индексов, журналов и резервных копий.
У CPU оценивают подготовку запросов, обработку документов и работу вспомогательных сервисов. Максимальное число ядер не гарантирует ускорения генерации, если она ограничена GPU. На сервере с несколькими ускорителями проверяют линии PCIe, размещение устройств по сокетам, блоки питания и охлаждение. Для стоечного оборудования также нужны удаленное управление и контроль аппаратных ошибок.
Подходящие платформы можно рассматривать в разделе серверов с NVIDIA L40S и L4. Название категории не подтверждает готовность конкретной конфигурации к вашей нагрузке: перед заказом сверяют состав, версии ПО и программу приемочного теста.
Доступ сотрудников и эксплуатация
Локальный API не следует считать готовой системой доступа пользователей. Для общего сервиса нужен вход через авторизованный интерфейс или шлюз, шифрование соединения, ограничения нагрузки и журналирование без лишнего сохранения чувствительных данных. Переменная OLLAMA_HOST управляет адресом прослушивания, но сама по себе не добавляет аутентификацию.
Если сервис критичен для бизнеса, один GPU-сервер оставляет риск простоя при отказе или обслуживании. Способ резервирования выбирают по допустимому времени восстановления. Отдельно сохраняют конфигурацию, версии моделей и прикладные данные. В бюджет включают питание, охлаждение, поддержку и время специалистов.
Что делать, если Ollama не запускается или отвечает медленно
Симптом | Что проверить сначала | Следующее действие |
|---|---|---|
Команда | Установку, PATH и новое окно терминала | Восстановить доступ к установленному CLI |
Ошибка подключения к API | Работает ли приложение или служба, правильный ли адрес | Проверить локальный запуск и сетевой маршрут |
Порт уже занят | Другой экземпляр приложения, службу или контейнер | Оставить нужный экземпляр либо назначить другой порт |
Модель не найдена | Точное имя, тег и список загруженных моделей | Скачать существующий вариант или исправить имя в запросе |
Не хватает памяти | Контекст, другие модели, процессы GPU и RAM | Снизить нагрузку, выбрать другой вариант модели или конфигурацию |
Используется только CPU | Совместимость GPU, драйвер и доступ из контейнера | Проверить аппаратное обнаружение, затем повторить тест |
Первый ответ заметно медленнее | Загрузку модели с диска | Разделить холодный запуск и последующие запросы в измерениях |
Скорость падает при нескольких пользователях | Очередь, параллельность, контекст, температуру и память | Ограничить одновременную нагрузку и пересчитать ресурсы |
Ответы неточны | Саму модель, инструкции и найденные документы | Улучшить данные и проверить альтернативную модель |
Частые вопросы об Ollama
Ollama бесплатная?
Локальные запросы к своей модели не тарифицируются как вызовы облачного API Ollama. Остаются расходы на оборудование, электроэнергию и сопровождение. У моделей есть отдельные лицензии, а у облачного режима свои условия использования.
Можно ли пользоваться Ollama на русском языке?
Да, если выбранная модель достаточно хорошо поддерживает русский. Проверьте ее на ваших терминах, документах и формулировках. Русский запрос не требует отдельной программы запуска, но качество заметно различается между моделями.
Нужна ли видеокарта для Ollama?
Некоторые модели можно запускать на CPU при достаточной RAM. Это подходит для знакомства или задач, где допустимо долгое ожидание. GPU выбирают, когда требуется более быстрый ответ, большая модель или обслуживание нескольких запросов.
Где Ollama хранит модели и как сменить папку?
При обычной установке в Windows модели находятся в каталоге .ollama\models профиля пользователя, на macOS в ~/.ollama/models. Смена расположения выполняется через OLLAMA_MODELS с перезапуском приложения. У службы Linux и контейнера другой рабочий пользователь и свои пути. Перед переносом проверьте права доступа и наличие всех файлов.
Нужен ли API key для локальной модели?
Для стандартного локального API Ollama ключ не требуется. Если приложение просит ключ, уточните, к какому адресу оно подключено и какую авторизацию использует промежуточный шлюз. Облачный API и локальный сервер имеют разные условия доступа.
Ollama или LM Studio: что выбрать?
Сравните удобство интерфейса, поддержку вашей модели, управление сервером и нужные интеграции. У обоих продуктов есть возможности локального запуска и API. Для Ollama удобно воспроизводить сценарии через CLI и контейнер; LM Studio предлагает развитую работу с моделями через приложение и собственные инструменты. Автоматически считать один вариант быстрее другого нельзя. Возможности альтернативы описаны в документации LM Studio.
Можно ли обучить модель через Ollama?
Изменение Modelfile и системной инструкции не обучает веса. Для дообучения нужен отдельный совместимый инструмент, данные и проверка качества; готовый результат затем импортируют, если формат и архитектура поддерживаются. Для ответов по документам сначала имеет смысл проверить RAG.
Как обновить или удалить Ollama?
Используйте официальный способ для вашей ОС: обновление приложения или установщика, а для Linux инструкции соответствующего релиза. На сервере сначала сохраните текущую версию и настройки, затем повторите контрольные запросы. Удаление отдельной модели через ollama rm и удаление самой программы являются разными действиями. В Windows приложение удаляется через системный раздел установленных программ; файлы в отдельно настроенном каталоге моделей могут остаться.
С чего начать выбор оборудования
Запустите небольшую модель, выполните несколько рабочих задач и зафиксируйте недостатки: качество, время ответа, размер контекста или число одновременных обращений. Этот список поможет понять, нужен ли другой вариант модели, дополнительная память или отдельный сервер.
Для расчета конфигурации подготовьте точное название и квантование модели, объем контекста, типичную длину ответа, ожидаемую параллельность и требования к локальному хранению данных. Если используется RAG, добавьте размер базы документов и частоту ее обновления.
Start Server поможет сопоставить требования с GPU, RAM, NVMe, питанием и охлаждением. Для предварительного выбора доступны AI-серверы, а для подготовки спецификации можно передать задачу специалистам Start Server.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


