HPC расшифровывается как High Performance Computing, или высокопроизводительные вычисления. Это подход к решению ресурсоемких задач с помощью параллельной работы процессоров, ускорителей и вычислительных узлов. Его применяют, когда расчет на обычной рабочей станции занимает слишком много времени, не помещается в память или не позволяет обработать необходимое количество вариантов.
HPC не обязательно начинается с нескольких стоек и сотен GPU. Для одной организации достаточно мощного сервера с большой оперативной памятью, другой требуется CPU-кластер, третьей нужна система с ускорителями и высокоскоростной сетью. Выбор определяется тем, как работает приложение, а не только количеством ядер в коммерческом предложении.
Главный вопрос перед покупкой: какую задачу система должна закончить, за какое время и при какой одновременной нагрузке? Ответ на него помогает отличить полезное увеличение вычислительных ресурсов от оборудования, которое будет простаивать.
Что такое HPC простыми словами
Представим расчет обтекания детали воздушным потоком. Программа разбивает расчетную область на множество ячеек. Одни операции можно выполнять одновременно, но соседним участкам приходится обмениваться промежуточными результатами. Чем больше модель, тем больше требуется вычислений, памяти и обменов.
В HPC работу распределяют между доступными ресурсами: ядрами одного CPU, несколькими процессорами, GPU или серверами. Чтобы это дало ускорение, приложение должно поддерживать соответствующий способ параллельного выполнения. Подключение дополнительных серверов к сети само по себе не ускоряет последовательную программу.
HPC, вычислительный кластер и суперкомпьютер: в чем отличие
Эти понятия описывают разные стороны системы.
Понятие | Что оно обозначает | Что важно для выбора |
|---|---|---|
HPC | Подход и технологии для ресурсоемких вычислений | Приложение, объем задачи, допустимое время |
Вычислительный кластер | Группу соединенных узлов, работающих как общий вычислительный ресурс | Распределение заданий, обмены между узлами, хранение |
Суперкомпьютер | Высокопроизводительную вычислительную систему; часто построенную как крупный кластер | Архитектура и производительность на определенных задачах |
Кластер высокой доступности | Систему, ориентированную прежде всего на сохранение доступности сервиса | Переключение при отказе и восстановление обслуживания |
Для каких задач нужны высокопроизводительные вычисления
Высокопроизводительные вычисления в физике используют для моделирования взаимодействий частиц, свойств материалов, плазмы и других процессов. В инженерной практике они помогают считать прочность, теплопередачу, движение жидкостей и газов. В молекулярной динамике исследуют поведение систем атомов; в метеорологии рассчитывают состояние атмосферы.
Однако название отрасли еще не определяет архитектуру. Даже в одном исследовательском отделе могут соседствовать три разных профиля нагрузки.
Профиль | Пример | Что определяет подходящую систему |
|---|---|---|
Один большой связанный расчет | Модель, части которой регулярно обмениваются данными | Масштабирование приложения, память, задержки и пропускная способность сети |
Много независимых заданий | Перебор параметров, независимые реализации моделирования | Число завершенных заданий за сутки, загрузка узлов, лицензии и скорость выдачи данных |
Задача внутри одного узла | Приложение с общей памятью или ограниченным распределенным параллелизмом | Производительность CPU, RAM, локальные накопители, поддерживаемые GPU |
В первом случае важно сократить время одного расчета. Во втором выгоднее увеличить число одновременно обрабатываемых задач. В третьем добавление серверов может не помочь вообще. Для большого потока независимых работ также используют термин HTC, High Throughput Computing: акцент сделан на количестве выполненной работы, а не на максимальном ускорении одного задания.
Как устроен HPC-кластер
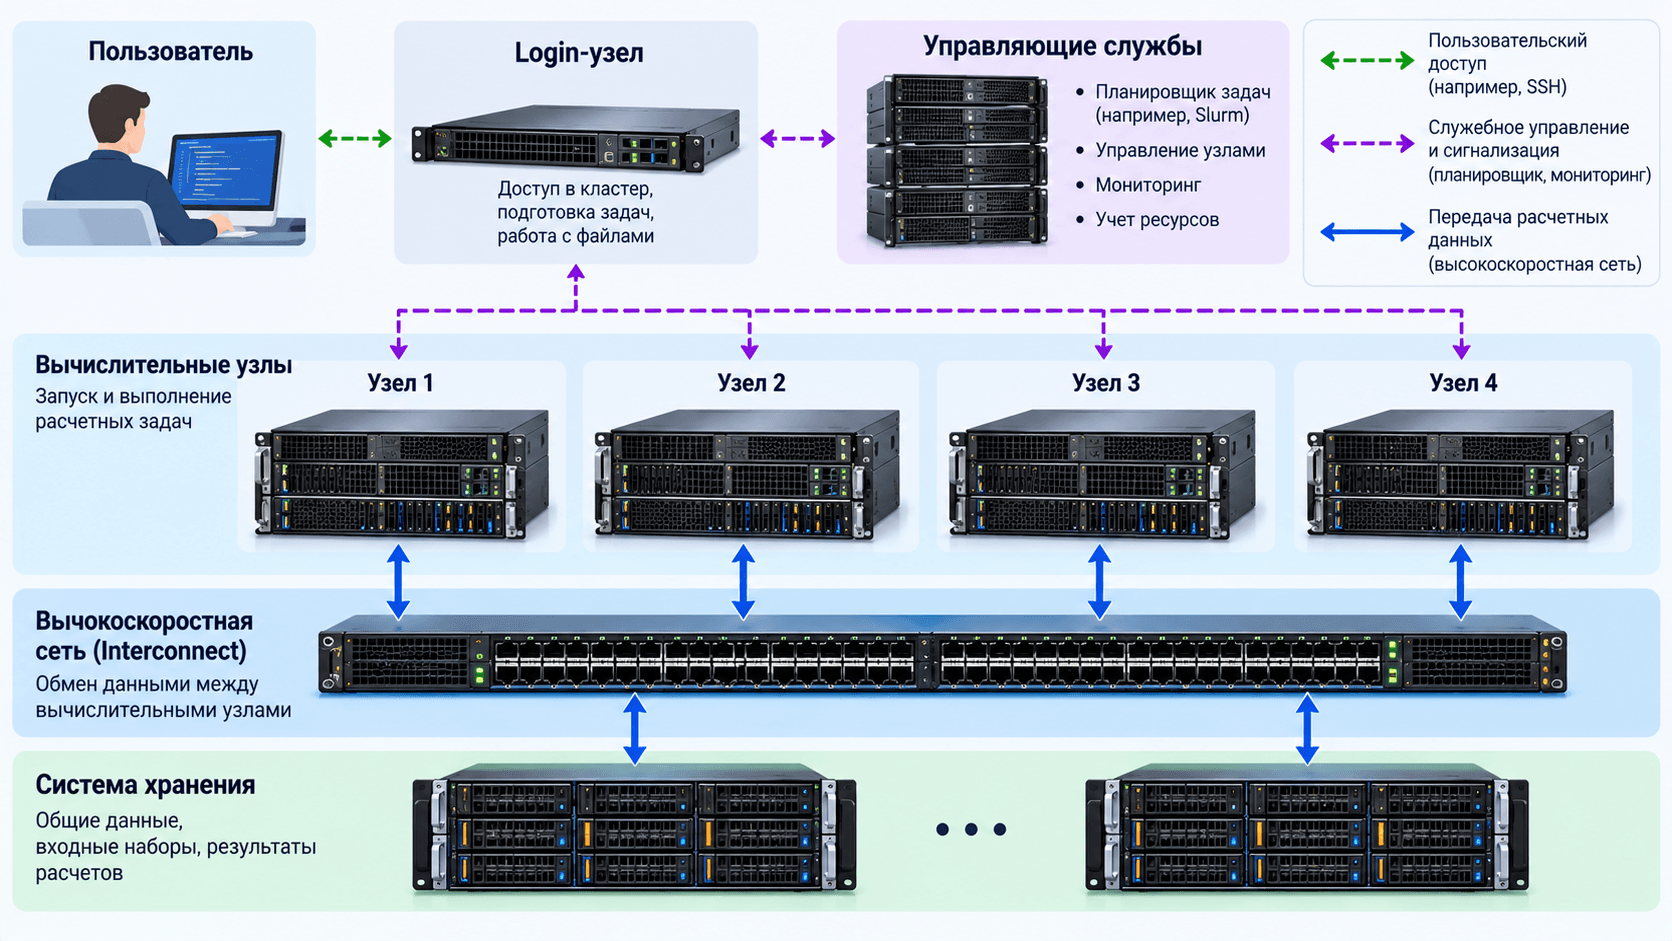
Вычислительный кластер состоит не только из серверов, на которых выполняется расчет. Пользователям нужны доступ и очереди, приложениям требуется согласованное программное окружение, результатам нужно место хранения, а администраторам необходима информация о состоянии системы.
Компонент | Назначение | Ошибка при проектировании |
|---|---|---|
Узел входа, login node | Подключение пользователей, подготовка и отправка заданий | Запуск тяжелых расчетов на общем узле входа |
Управляющие службы | Очереди, распределение ресурсов, учет заданий | Отсутствие правил приоритетов и восстановления управления |
Вычислительные узлы | Выполнение CPU- и GPU-задач | Выбор по числу ядер без теста приложения |
Межузловая сеть, interconnect | Обмен данными между участниками распределенного расчета | Оценка только скорости порта без учета топологии и задержек |
Хранилище | Исходные данные, рабочие файлы, контрольные точки и результаты | Один общий ресурс без разграничения временных и важных данных |
Сеть управления | Администрирование, мониторинг и служебный доступ | Неограниченный доступ пользователей к управлению оборудованием |
Инженерная инфраструктура | Электропитание, охлаждение, размещение и обслуживание | Расчет площадки по средней, а не допустимой максимальной нагрузке |
Это логические роли, а не требование выделять отдельный физический сервер на каждую строку. В небольшом пилоте часть служб можно совместить. В рабочей системе решение зависит от нагрузки, требований к доступности и того, сколько простоя допустимо.
Как запускается расчет: Slurm, MPI и OpenMP
В многопользовательском кластере ресурсы обычно выдает планировщик. Например, Slurm принимает задания, учитывает доступные ресурсы и организует запуск на выделенных узлах. Пользователь описывает потребность в CPU, памяти, GPU и времени выполнения. Задание может ждать, пока появятся подходящие ресурсы и подойдет его очередь.
Планировщик не превращает обычную программу в распределенную. За параллельное выполнение отвечают приложение и используемые им технологии:
MPI организует обмен сообщениями между процессами, в том числе на разных серверах.
OpenMP позволяет приложению использовать потоки и общую память; в типичном CPU-сценарии работа идет внутри узла.
GPU-реализация переносит поддерживаемые операции на ускорители. Применимый программный стек зависит от приложения и производителя GPU.
В одном расчете эти механизмы могут сочетаться. Например, MPI распределяет работу между узлами, потоки обрабатывают часть данных на CPU, а отдельные операции выполняются на GPU.
С чего начать выбор HPC-кластера
Сначала нужен профиль задачи. Формулировка «нужен сервер для моделирования» не дает возможности обоснованно выбрать ни процессоры, ни количество узлов.
Для первичного обследования соберите следующие сведения:
Название приложения, точную версию, необходимые модули и решатели.
Типовой набор входных данных и самый тяжелый ожидаемый расчет.
Время выполнения на текущем оборудовании и его конфигурацию.
Пиковое потребление RAM; для GPU-задач также VRAM на каждом ускорителе.
Долю времени вычислений, ожидания памяти, обменов и операций с файлами, если такие измерения доступны.
Число одновременных пользователей и ожидаемый поток заданий.
Требуемый срок: завершить одну задачу к утру или обработать определенное число вариантов за неделю.
Условия лицензирования и ограничения площадки.
Особенно полезен небольшой воспроизводимый тест, который сохраняет важные особенности рабочей модели. Слишком маленький пример может целиком помещаться в кэш, почти не обмениваться данными и показать масштабирование, которого не будет на реальной задаче. Слишком большой пример сложно повторять при сравнении конфигураций.
В техническом задании стоит отдельно зафиксировать критерий правильности результата. Быстрый расчет не имеет ценности, если измененная точность или другой режим решателя дают неприемлемую погрешность.
Что выбрать: CPU-кластер или GPU-кластер
Когда нужен CPU-кластер
CPU-кластер имеет смысл, если приложение эффективно выполняет нужный расчет на процессорах, поддерживает распределенный запуск или позволяет распараллелить поток независимых заданий.
Выбирать CPU только по числу ядер рискованно. Важны скорость конкретного решателя, пропускная способность памяти, поддерживаемые инструкции и стоимость лицензирования. Если лицензия зависит от числа ядер или дополнительных вычислительных пакетов, более высокая производительность на ядро может оказаться полезнее максимального количества ядер.
Проверяют и организацию памяти. На многопроцессорном сервере доступ к памяти соседнего NUMA-узла может отличаться по задержке и пропускной способности от локального доступа. Расположение процессов, потоков и данных влияет на результат. Ошибки привязки способны испортить сравнение двух платформ даже при одинаковом числе выделенных ядер.
Когда оправданы GPU
GPU полезен тогда, когда ускоряемая часть приложения поддерживает выбранный ускоритель и составляет значимую долю всей работы. Недостаточно того, что производитель программы упоминает GPU в списке возможностей. Поддержка может зависеть от решателя, физической модели, версии, сборки и режима вычислений.
В GROMACS, например, распределение работы между CPU и GPU зависит от настроек моделирования и возможностей оборудования. Сам факт переноса большего числа операций на GPU не заменяет измерение итоговой производительности. Это прямо следует из документации GROMACS по производительности.
Для научных расчетов важно проверить требуемую точность. Пиковые показатели AI в FP4 или FP8 не описывают скорость обычного FP64-кода. Даже наличие высокой производительности матричных блоков в нужном формате не означает, что приложение сможет ее использовать. Сначала проверяют алгоритм, библиотеки и фактический режим работы, затем сравнивают ускорители.
Полный список вопросов к разработчику ПО и тестовой сборке приведен в статье о совместимости GPU-сервера с научными приложениями.
Зачем выбирать серверную платформу целиком
Для многопроцессорной GPU-задачи важны не только сами карты, но и их связность, доступные PCIe-пути, сетевые адаптеры и охлаждение. Разные схемы размещения устройств могут по-разному обслуживать один и тот же алгоритм обменов.
В каталоге есть, например, Dell PowerEdge XE9680 с восемью H200 SXM по 141 ГБ. Это пример многопроцессорного GPU-узла, а не универсальная рекомендация для любой HPC-задачи. Перед выбором такой системы нужно подтвердить поддержку приложения, полезное масштабирование на несколько GPU, объем памяти на устройство и возможность размещения на площадке. Комплектацию и условия поставки уточняют отдельно.
Сколько памяти нужно вычислительному узлу
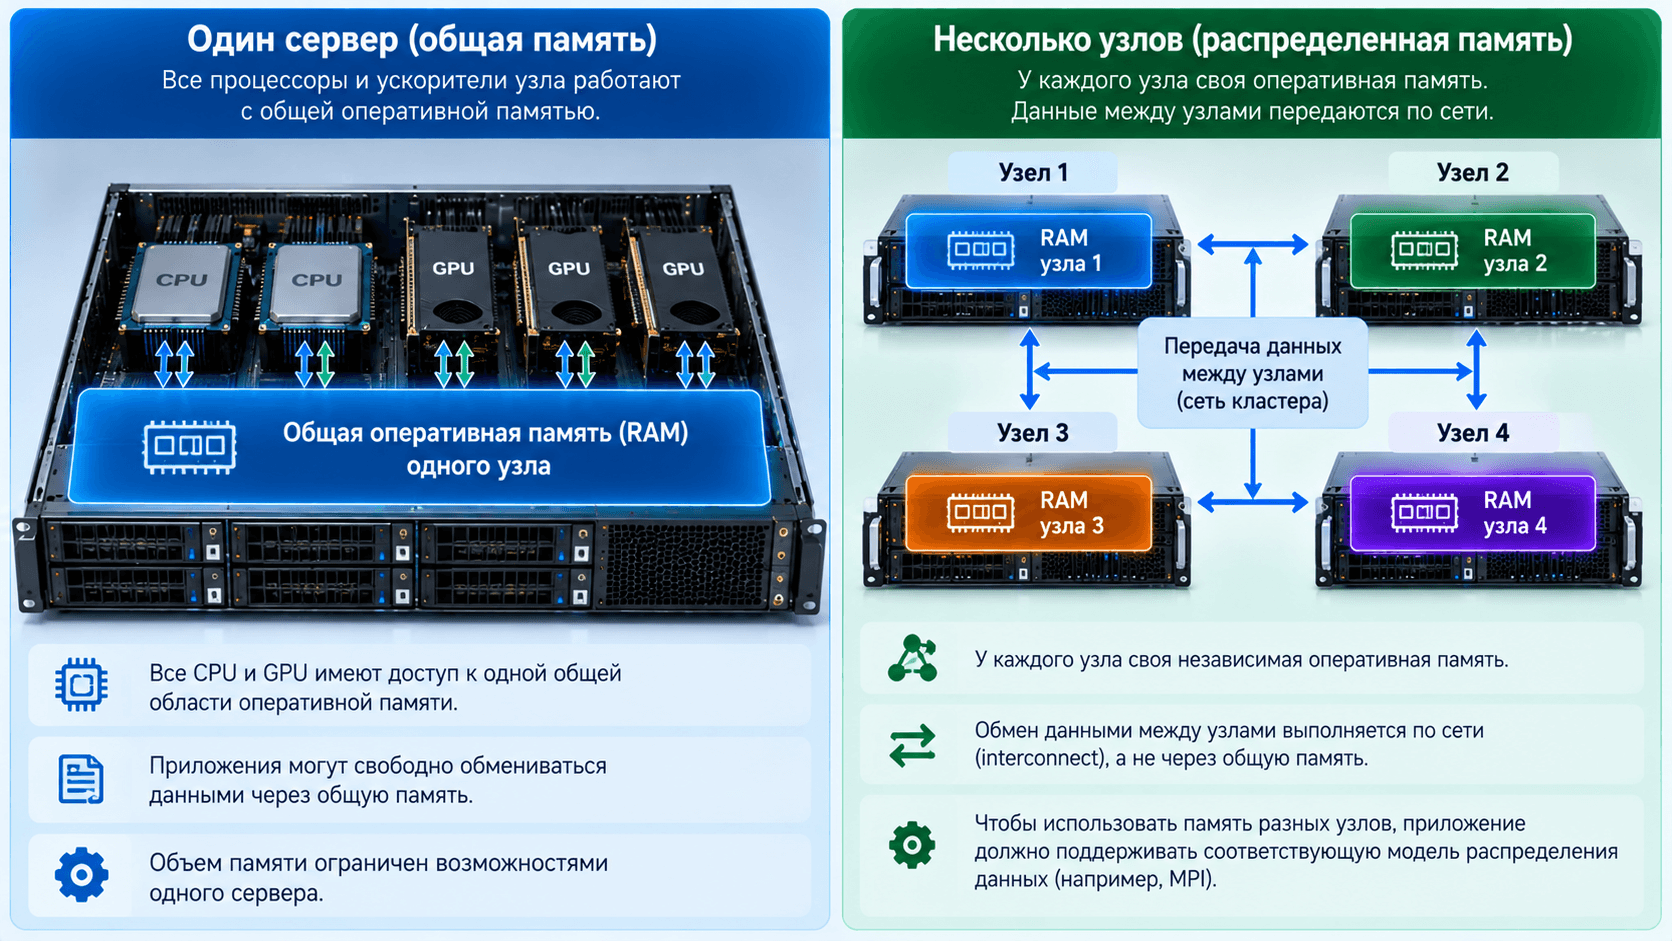
В распределенной системе важно не только суммарное количество RAM, но и то, как она доступна программе. Четыре сервера с 256 ГБ RAM каждый не становятся автоматически одним компьютером с общим адресным пространством на 1 ТБ.
Если один процесс требует 400 ГБ, он не поместится на узел с 256 ГБ только потому, что в кластере есть свободная память соседних серверов. Приложение должно уметь распределять данные либо работать в специально поддерживаемом режиме, например с выгрузкой части данных на накопители. У такого режима будут собственные ограничения по скорости.
При оценке памяти учитывают:
максимальное потребление отдельного процесса и всех процессов на узле;
данные, которые дублируются у каждого участника расчета;
временные массивы, буферы обмена и пиковые этапы обработки;
резерв для операционной системы и служебных процессов;
неравномерность распределения данных и предполагаемый рост задачи.
Для GPU действует похожее правило. Сумма VRAM всех ускорителей не равна автоматически доступной памяти одной операции. Приложение должно поддерживать разделение данных и вычислений. Возможность обмена между GPU сама по себе этого не гарантирует.
Какая сеть нужна HPC-кластеру
Сеть выбирают по характеру обменов. Если каждый сервер независимо считает свой набор вариантов, требования к задержкам между вычислительными узлами могут быть умеренными. Но чтение общих исходных данных и запись результатов все равно способны нагрузить сеть хранения.
При тесно связанном MPI-расчете процессы постоянно обмениваются промежуточными данными и синхронизируются. Тогда важны задержка, скорость передачи сообщений разных размеров, коллективные операции и конкуренция за общие сетевые ресурсы.
Ethernet, InfiniBand или RoCE
Обычный Ethernet может быть достаточен для независимых заданий и части небольших распределенных задач. InfiniBand и Ethernet с RoCE рассматривают, когда приложение и программный стек получают пользу от низких задержек и RDMA.
При этом RoCE не включается одной покупкой подходящего адаптера. Нужны согласованные настройки конечных устройств и сети, контроль перегрузки и проверка поведения под нагрузкой. Конкретное применение ECN и PFC зависит от выбранного оборудования и режима. Универсальное требование «включить PFC везде» не заменяет проектирование.
Разбор технологий и критериев выбора вынесен в отдельную статью InfiniBand или RoCE для GPU-кластера.
Почему недостаточно посмотреть скорость порта
Порт на 200 или 400 Гбит/с ничего не говорит о том, какую долю этой полосы получит конкретное приложение. Возможны ограничения в топологии PCIe, межкоммутаторных соединениях, программной реализации и доступе к памяти.
Отдельно оценивают oversubscription: ситуация, когда суммарный трафик подключенных узлов может превышать доступную полосу общих соединений. Для независимых задач такой компромисс иногда приемлем. Для синхронного расчета с интенсивными обменами он может заметно снизить эффект от добавления серверов.
Как организовать хранение данных
У HPC-системы обычно есть несколько классов данных: окружение пользователя и программы, исходные наборы, временные рабочие файлы, контрольные точки и результаты, которые нужно сохранить надолго. У них различаются требования к скорости, сроку хранения и восстановлению.
В небольшом кластере с умеренной файловой нагрузкой может быть достаточно общего файлового сервиса. При интенсивном параллельном вводе-выводе рассматривают специализированную файловую систему, например Lustre или BeeGFS. Само слово «параллельная» не гарантирует нужную скорость: она зависит от конфигурации и поведения приложения.
Для выбора СХД полезно знать, что именно происходит с файлами. Последовательная запись крупных результатов требует пропускной способности. Создание большого количества мелких файлов нагружает обработку метаданных. Одновременное сохранение контрольных точек множеством заданий создает кратковременный пик нагрузки, который может не проявиться в одиночном тесте накопителя.
Локальные NVMe могут использоваться для временных данных и предварительного размещения файлов, если это поддерживает рабочий процесс. Но необходимо заранее решить, как результаты вернутся в постоянное хранилище и что произойдет при отказе узла.
Как определить количество узлов
Есть два разных расчета: сколько ресурсов нужно одному заданию и сколько ресурсов нужно всей очереди. Сначала проверяют время выполнения и память отдельной задачи. Затем оценивают, сколько таких задач должно работать одновременно.
Проверка масштабирования одного расчета
При сильном масштабировании размер задачи сохраняют, а число ресурсов увеличивают. При слабом масштабировании вместе с ресурсами увеличивают объем задачи, сохраняя примерно одинаковую работу на ресурс. Хорошее слабое масштабирование не доказывает, что маленький расчет будет быстро выполняться на большом числе узлов.
Для сильного масштабирования удобно считать:
Ускорение S(N) = время на одном узле / время на N узлах
Эффективность E(N) = S(N) / N × 100%
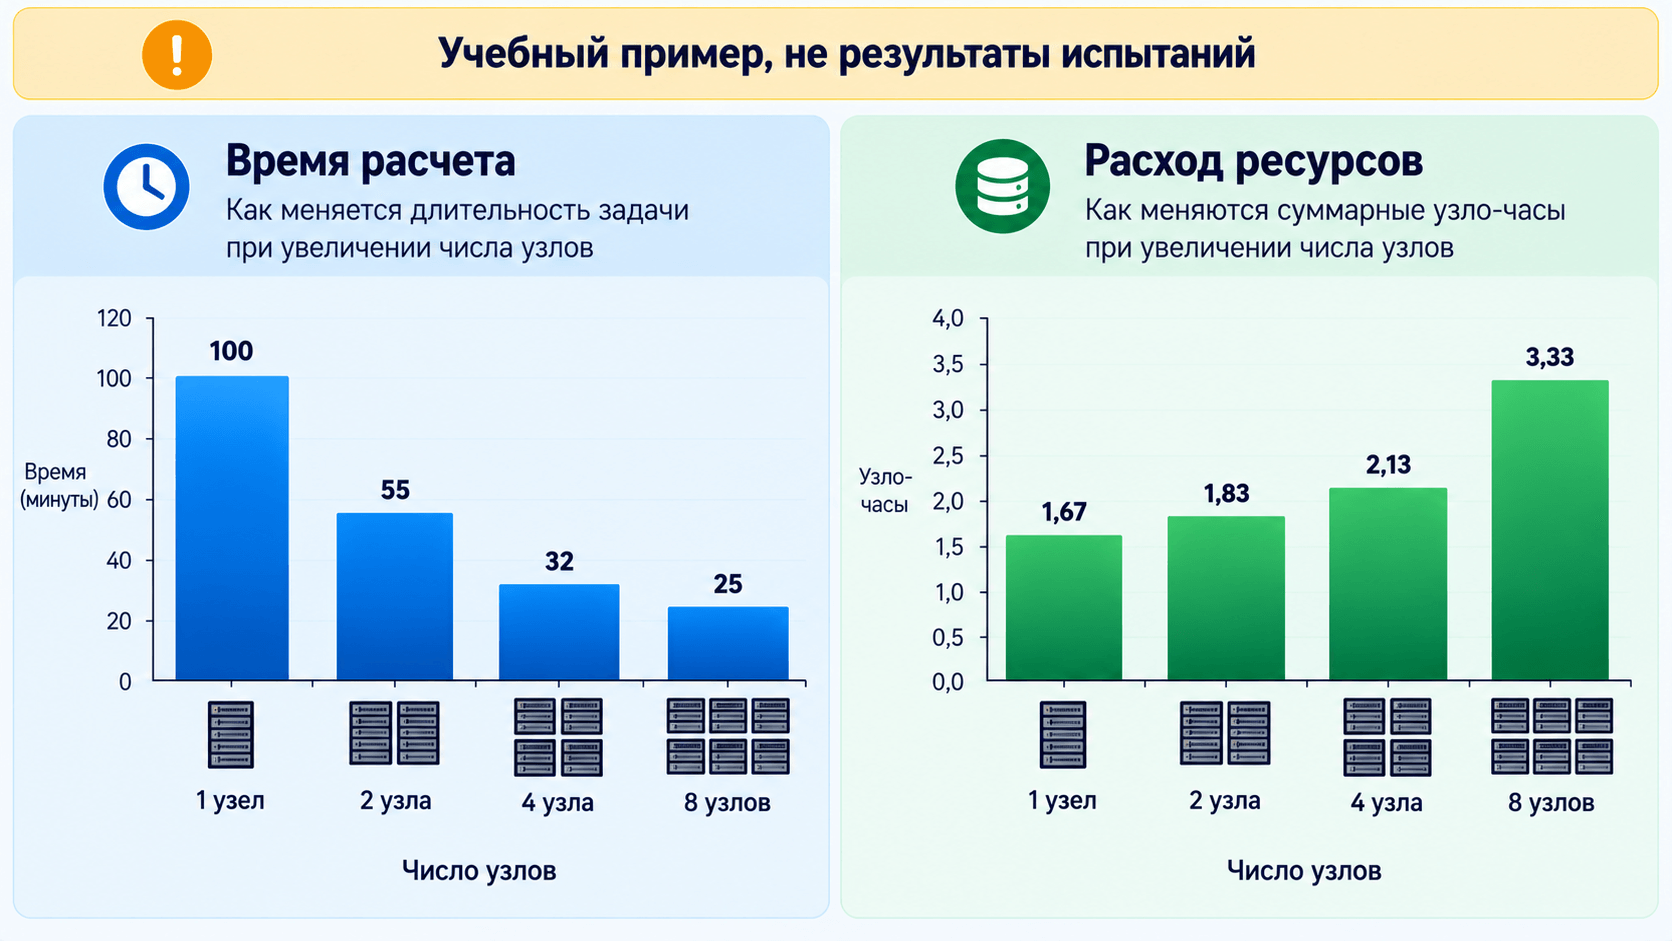
Ниже приведен учебный пример, а не результат испытаний оборудования. Предполагаются одинаковые узлы, одна и та же задача, одинаковое окружение и выделение каждого узла целиком.
Число узлов | Время расчета, мин | Ускорение | Эффективность | Расход узло-часов |
|---|---|---|---|---|
1 | 100 | 1,00 | 100% | 1,67 |
2 | 55 | 1,82 | 90,9% | 1,83 |
4 | 32 | 3,13 | 78,1% | 2,13 |
8 | 25 | 4,00 | 50,0% | 3,33 |
Расход узло-часов здесь равен числу выделенных узлов, умноженному на время в часах. Он показывает занятость вычислительных ресурсов, но не является точной стоимостью или расходом электроэнергии.
Переход с четырех узлов на восемь сокращает время с 32 до 25 минут, но требует вдвое больше узлов и примерно на 56% больше узло-часов. Если предельное время самого расчета составляет 40 минут, четырех узлов достаточно. Если нужно уложиться в 30 минут, среди проверенных вариантов подходит восемь. При ограничении полного срока получения результата нужно дополнительно учесть очередь и операции с данными.
Планирование потока заданий
Если задачи независимы, считают суммарный объем работы за нужный период. Для первого приближения можно разделить требуемые узло-часы на доступное время и плановую долю полезной загрузки. Такое приближение подходит только после приведения заданий к понятному профилю ресурсов.
Окончательное число узлов проверяют на реальной очереди. Важны пики поступления работ, разная длительность задач, нехватка памяти отдельных узлов, обслуживание и доступность лицензий. Нельзя рассчитывать на непрерывную 100-процентную загрузку и одновременно обещать пользователям отсутствие ожидания.
Если одни задания требуют GPU, другие большого объема RAM, а третьи только CPU, полезнее несколько групп узлов с разными характеристиками, чем одинаковая дорогая конфигурация для всех. При этом для одного тесно связанного распределенного задания предпочтительна предсказуемая производительность выделенных ему узлов.
Какой кластер нужен: четыре практических сценария
Следующие сценарии показывают логику выбора. Это не выполненные проекты и не готовые спецификации с гарантированной производительностью.
1. Расчет не помещается в память рабочей станции
Если приложение работает только в общей памяти одного узла, сначала рассматривают сервер с подходящим объемом RAM и сбалансированным заполнением каналов памяти. Покупка нескольких малых серверов не решит проблему одного слишком большого процесса.
Кластер становится вариантом после подтверждения распределенного режима приложения или при необходимости одновременно выполнять несколько независимых расчетов. Первый тест должен проверить пиковую память, правильность результата и время на одном подходящем сервере.
2. Нужно просчитать множество вариантов конструкции
Когда варианты независимы, можно распределять их по нескольким CPU- или GPU-узлам. Начальная архитектура включает очередь, контроль доступа, общее хранение и вычислительные узлы под подтвержденные требования приложения.
Критерий выбора здесь: сколько корректных вариантов система обрабатывает за смену или сутки. Важны не только серверы, но и количество доступных лицензий. Если одновременно могут работать лишь несколько лицензированных процессов, дополнительное оборудование будет ждать разрешения на запуск.
3. Один расчет слишком долгий и поддерживает MPI
Нужен пилот распределенного запуска: сначала базовый узел, затем несколько одинаковых узлов с выбранной сетью. В тесте сохраняют входные данные, точность, версии ПО и правила размещения процессов.
Расширение оправдано, если дополнительный узел заметно сокращает время или позволяет решить более крупную задачу. Если основное время уходит на обмены, нужно проверить сеть, декомпозицию и размещение процессов. Простое увеличение количества серверов может усилить проблему.
4. Научное приложение эффективно использует GPU
Сначала сравнивают поддерживаемые конфигурации внутри одного GPU-сервера. Это позволяет понять, дает ли приложению пользу дополнительный ускоритель и хватает ли VRAM. Затем проверяют многосерверный режим, если одного узла недостаточно.
Для масштабирования между GPU-серверами отдельно испытывают коммуникационный стек и путь передачи данных. Наличие быстрого соединения между GPU внутри сервера не гарантирует столь же эффективного обмена между серверами. Результаты этих двух тестов нельзя смешивать.
Что часто забывают при расчете бюджета
Цена вычислительных серверов составляет только часть проекта. В смету также входят сеть с кабелями или оптикой, хранилище, стойка и распределение питания, программные лицензии, поддержка, установка и проверка системы.
Отдельно оценивают эксплуатацию: электроэнергию, охлаждение, резервные компоненты, обновления, работу администратора и восстановление после отказов. Это технические статьи затрат, а не универсальная формула окупаемости. Без профиля загрузки и коммерческих условий корректную итоговую стоимость назвать нельзя.
Площадку проверяют по документации выбранной конфигурации: потребление и схемы питания, допустимая нагрузка на стойку, масса, глубина, воздушные потоки, рабочие температуры и сервисное пространство. Если платформа требует жидкостного охлаждения, нужны подтвержденные требования к контуру и его обслуживанию. Сам термин HPC не означает обязательного жидкостного охлаждения.
Как проверить кластер перед приемкой
Сначала согласуют правильность результата и ожидаемое время на конкретной задаче. Затем проводят испытания с зафиксированными версиями ПО, входными данными и настройками. Иначе отличия в результатах невозможно уверенно связать с оборудованием.
Минимальная программа проверки включает:
Инвентаризацию поставки: CPU, RAM, GPU, накопители, адаптеры, версии прошивок и согласованную схему подключения.
Запуск эталонной задачи и проверку допустимой погрешности относительно согласованного результата.
Измерение времени на выбранном числе ядер, GPU и узлов; память фиксируют на процесс, узел и ускоритель.
Проверку реального ввода-вывода, включая параллельное сохранение результатов несколькими заданиями.
Повторные прогоны под характерной одновременной нагрузкой для оценки разброса времени.
Продолжительную работу с контролем ошибок, частот, температуры и ограничений по питанию.
Проверку очередей, лимитов, прав доступа и учета использования ресурсов.
Проверку согласованных сценариев восстановления, включая перезапуск расчетов из контрольных точек там, где приложение это поддерживает.
Синтетические тесты помогают найти проблемы отдельных компонентов, но не заменяют прикладной результат. HPL, используемый в TOP500, измеряет определенную задачу плотной линейной алгебры в двойной точности. Его результат нельзя напрямую переводить в скорость CFD, молекулярной динамики или обработки файлов. Это ограничение отдельно отмечает описание теста LINPACK на сайте TOP500.
Отказоустойчивый управляющий узел также не делает любой MPI-расчет неуязвимым к отказу вычислительного сервера. Возможность продолжить работу зависит от приложения, способа сохранения состояния и доступности контрольной точки. Прозрачное восстановление нельзя обещать без проверки.
Частые вопросы об HPC
Как расшифровывается HPC?
В вычислительной технике HPC означает High Performance Computing, высокопроизводительные вычисления. В других областях у аббревиатуры могут быть иные значения, поэтому ее нужно читать в контексте.
HPC-кластер обязательно состоит из сотен серверов?
Нет. Размер определяется задачами, эффективностью масштабирования и требуемым потоком расчетов. Небольшая группа узлов тоже может быть вычислительным кластером. А для части HPC-задач достаточно одного мощного сервера.
Можно ли построить HPC без GPU?
Да. CPU-кластер подходит приложениям, которые эффективно используют процессоры и не получают полезного ускорения от GPU. Ускоритель выбирают по совместимости и измеренному эффекту, а не потому, что он присутствует в других вычислительных системах.
Обязательны ли Linux и Slurm?
Нет, это не часть определения HPC. Linux и Slurm часто применяются в вычислительных кластерах, но выбор операционной системы и управления заданиями зависит от поддерживаемого приложения и требований эксплуатации. Нельзя сначала выбрать стек, а потом предположить, что нужное ПО с ним совместимо.
Зачем нужна быстрая сеть, если серверы считают самостоятельно?
Для независимых задач сеть обслуживает прежде всего исходные данные, результаты и управление. Для распределенного расчета она дополнительно передает промежуточные данные между участниками. Во втором случае задержки и конкуренция за полосу могут ограничить ускорение всей задачи.
Суммируется ли память серверов в кластере?
Суммарная емкость увеличивается, но единое адресное пространство для обычной программы автоматически не появляется. Возможность использовать память нескольких узлов зависит от способа распределения данных в приложении.
Можно ли собрать кластер из разных серверов?
Да, особенно для очереди независимых работ с разными требованиями. Но внутри одного синхронного расчета медленный участник или недостаток памяти отдельного узла может задерживать остальные. Разнородное оборудование требует соответствующих правил размещения заданий.
С чего начать, если нет измерений и непонятно, сколько узлов покупать?
Собрать тестовый набор данных, зафиксировать версию ПО и провести базовый запуск на доступной подходящей платформе. Затем проверить несколько вариантов ресурсов и сравнить время, память, правильность результата и занятость оборудования. По этим данным формируют спецификацию.
Что передать для подбора HPC-системы
Для предметного подбора подготовьте название и версию приложения, пример задачи, измерения текущего расчета, требования к памяти, числу одновременных заданий и сроку выполнения. Добавьте условия лицензирования и ограничения площадки: питание, охлаждение, место в стойке и доступную сеть.
Эти данные позволят сравнить один сервер и несколько узлов, выбрать CPU или GPU, определить требования к interconnect и хранилищу. В разделе оборудования для HPC и научных расчетов можно посмотреть платформы для обсуждения конфигурации. Окончательный выбор стоит закреплять не обещанием максимальных FLOPS, а согласованным результатом на вашей задаче.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


