NVIDIA A100 представляет собой серверный GPU-ускоритель архитектуры Ampere для машинного обучения, инференса, аналитики и научных расчетов. У него есть версии с 40 и 80 ГБ памяти, а также два принципиально разных исполнения: плата PCIe и модуль SXM4 для специализированной серверной платформы.
При выборе A100 нельзя ограничиться названием и объемом VRAM. Две системы с одинаковым количеством GPU могут отличаться связностью ускорителей, пропускной способностью памяти, потреблением, возможностями расширения и скоростью одной и той же модели. Даже сумма памяти всех карт не означает, что приложение автоматически получит один большой общий буфер.
Что такое NVIDIA A100 и для каких задач она нужна
A100 рассчитана на вычисления в сервере. В отличие от обычной игровой видеокарты, при ее выборе оценивают работу CUDA-приложений, Tensor Cores, память HBM, аппаратное разделение ресурсов и межпроцессорные соединения. Видеовыходы и игровая производительность здесь не являются критерием.
Архитектура Ampere использует Tensor Cores третьего поколения. Они ускоряют поддерживаемые матричные операции, в том числе в форматах TF32, FP16 и BF16. Польза зависит от библиотеки и алгоритма: установка ускорителя не превращает любое приложение в Tensor Core-приложение. Если термин незнаком, сначала полезно понять как работает CUDA и какие GPU ее поддерживают.
Типичные нагрузки A100:
обучение и дообучение поддерживаемых нейросетей;
инференс LLM, компьютерного зрения и других ML-моделей;
научные приложения с GPU-реализацией, включая задачи с FP64;
обработка данных, если используемый стек переносит необходимые операции на GPU;
совместная работа нескольких пользователей через поддерживаемые профили разделения ресурсов.
Характеристики NVIDIA A100: четыре основных варианта
В таблице приведены базовые распространенные исполнения. Параметры специальной OEM-конфигурации сверяют с документацией конкретного сервера.
Параметр | A100 40GB PCIe | A100 80GB PCIe | A100 40GB SXM4 | A100 80GB SXM4 |
|---|---|---|---|---|
Архитектура | Ampere | Ampere | Ampere | Ampere |
Память на GPU | 40 ГБ HBM2 | 80 ГБ HBM2e | 40 ГБ HBM2 | 80 ГБ HBM2e |
Полоса памяти | 1 555 ГБ/с | 1 935 ГБ/с | 1 555 ГБ/с | 2 039 ГБ/с |
Базовый максимальный TDP | 250 Вт | 300 Вт | 400 Вт | 400 Вт |
Подключение к платформе | PCIe 4.0 x16 | PCIe 4.0 x16 | Специализированная SXM4-плата | Специализированная SXM4-плата |
Разделение MIG | До 7 экземпляров | До 7 экземпляров | До 7 экземпляров | До 7 экземпляров |
Источники: спецификации A100 80 ГБ и datasheet с вариантами 40 ГБ. Для отдельных HGX A100 80GB CTS-конфигураций NVIDIA указывает возможность TDP до 500 Вт. Это не характеристика каждой SXM4-платы и не разрешение самостоятельно менять ее тепловой режим.
Полоса HBM описывает обмен GPU с собственной памятью. Она не равна скорости чтения датасета с SSD, передачи через Ethernet или обмена с CPU. В коммерческом предложении эти значения должны быть разделены.
Для базовых A100 NVIDIA приводит пик FP32 19,5 TFLOPS и FP64 9,7 TFLOPS. У FP64 Tensor Core показатель 19,5 TFLOPS, но он относится к подходящим матричным операциям. Для FP16/BF16 Tensor Core заявлены 312 TFLOPS без структурной разреженности и 624 TFLOPS при ее использовании. Сравнивать последнее число с плотными вычислениями другой карты некорректно.
A100 40 или 80 ГБ: что меняется на практике
Когда достаточно 40 ГБ
Версия 40 ГБ подходит, если модель и ее рабочие структуры помещаются в память с запасом, а выбранный режим обеспечивает требуемую задержку и производительность. Это может быть отдельная модель компьютерного зрения, ограниченный по размеру LLM-сервис или задача дообучения с подходящими методами экономии памяти.
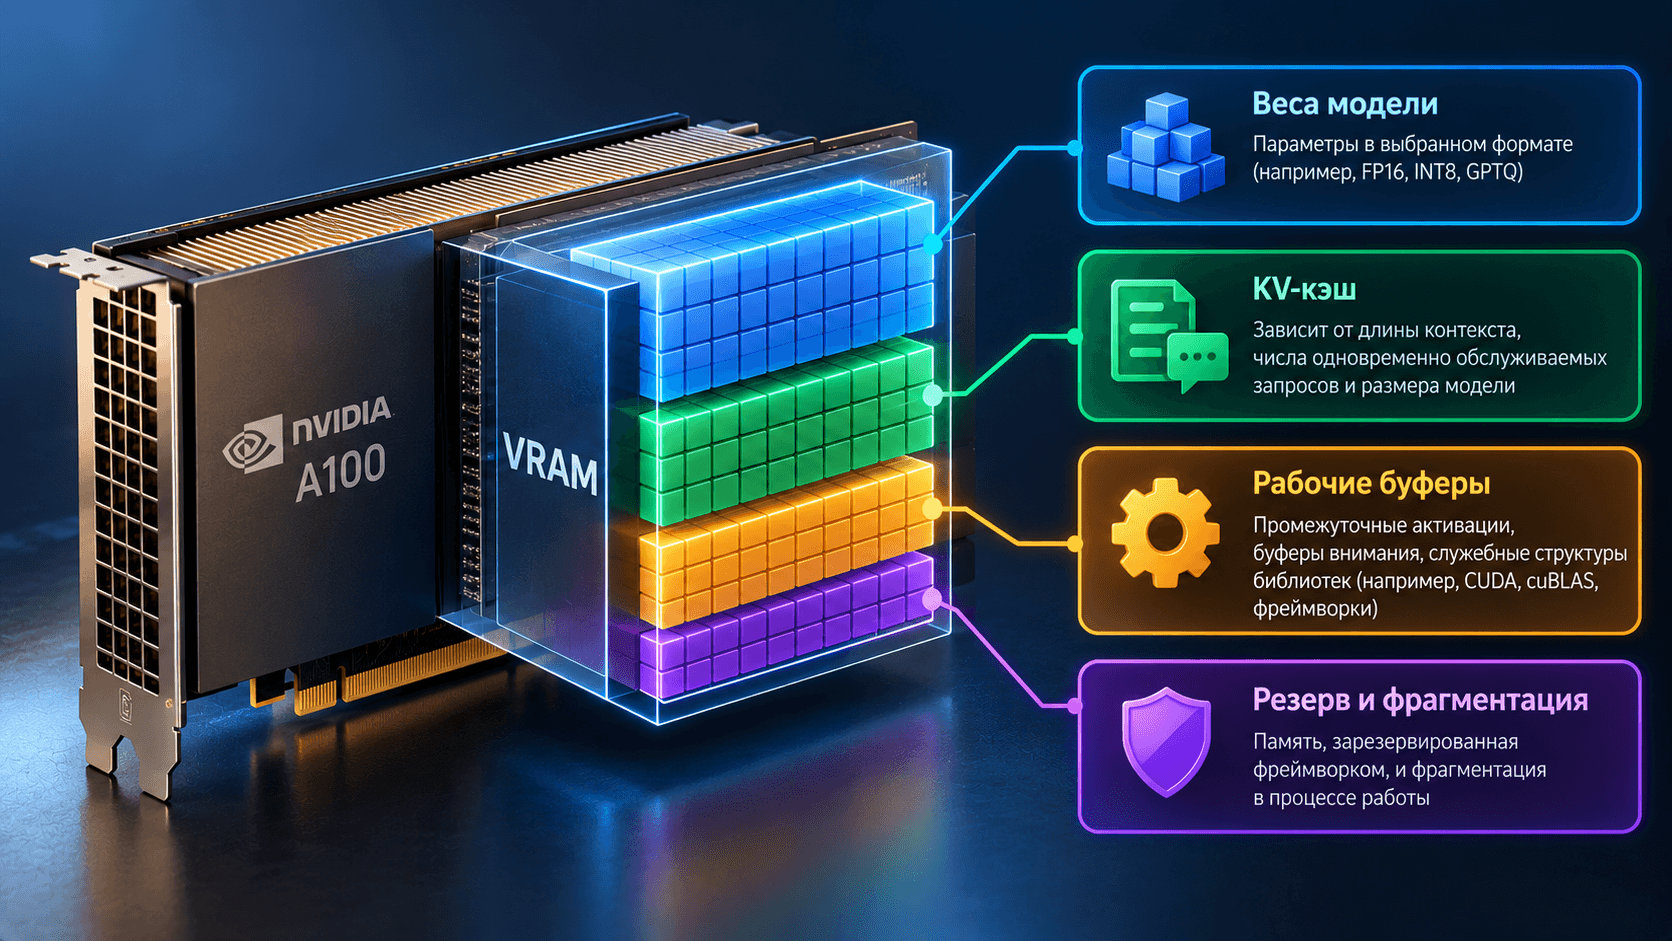
Проверять нужно максимальную рабочую конфигурацию. Запуск одной короткой реплики не доказывает, что сервис выдержит длинные документы и несколько параллельных пользователей. Увеличение batch size, длины контекста или числа запросов может привести к нехватке VRAM даже при неизменных весах модели.
Когда полезны 80 ГБ
Больший объем позволяет разместить более крупную модель или оставить больше памяти под KV-кэш, активации и временные буферы. Иногда переход на 80 ГБ позволяет отказаться от разделения модели между несколькими GPU. Это упрощает размещение, но фактическую скорость все равно нужно измерить.
Версия 80 ГБ не обязана работать вдвое быстрее версии 40 ГБ. Выигрыш особенно заметен, когда более емкая память устраняет выгрузку данных, уменьшает число необходимых GPU или позволяет использовать полезный для задачи размер пакета. Если задача ограничена вычислениями и давно помещается в 40 ГБ, результат может быть другим.
Как предварительно оценить память LLM
Нижняя оценка объема весов:
Память весов = количество параметров × число бит на параметр / 8
Например, для условной модели с 13 млрд параметров веса FP16 займут около 26 млрд байт. При INT8 теоретическая оценка составит 13 млрд байт, при четырехбитном представлении 6,5 млрд байт. Это расчет только весов в десятичных единицах, а не обещание фактического потребления готового движка.
A100 PCIe и SXM4: какую версию выбрать
PCIe для совместимой серверной платформы
A100 PCIe устанавливается как плата расширения, но наличие разъема x16 еще не означает совместимость. Проверяют поддерживаемый GPU, электрическую ширину слота, райзеры, питание, габариты и воздушный поток. Для пассивно охлаждаемой карты поток воздуха создает сервер, а не собственный вентилятор ускорителя.
PCIe-вариант удобен, когда нужны отдельные ускорители для независимых задач либо серверная платформа рассчитана на постепенное изменение конфигурации. Возможность доустановки должна быть подтверждена изготовителем конкретной системы, включая необходимые кабели и комплект охлаждения.
SXM4 для интегрированной GPU-системы
SXM4 устанавливается на специальную базовую плату. Это другой механический и электрический интерфейс. Такой модуль нельзя вставить в обычный PCIe-слот, а замену поколения GPU нельзя планировать как обычную перестановку карты.
HGX A100 является платформой, на которой производители строят серверы с несколькими GPU. DGX A100 представляет собой готовую систему NVIDIA. Упоминание HGX или DGX не заменяет проверку объема памяти и состава поставки.
NVLink, NVSwitch и суммарная память
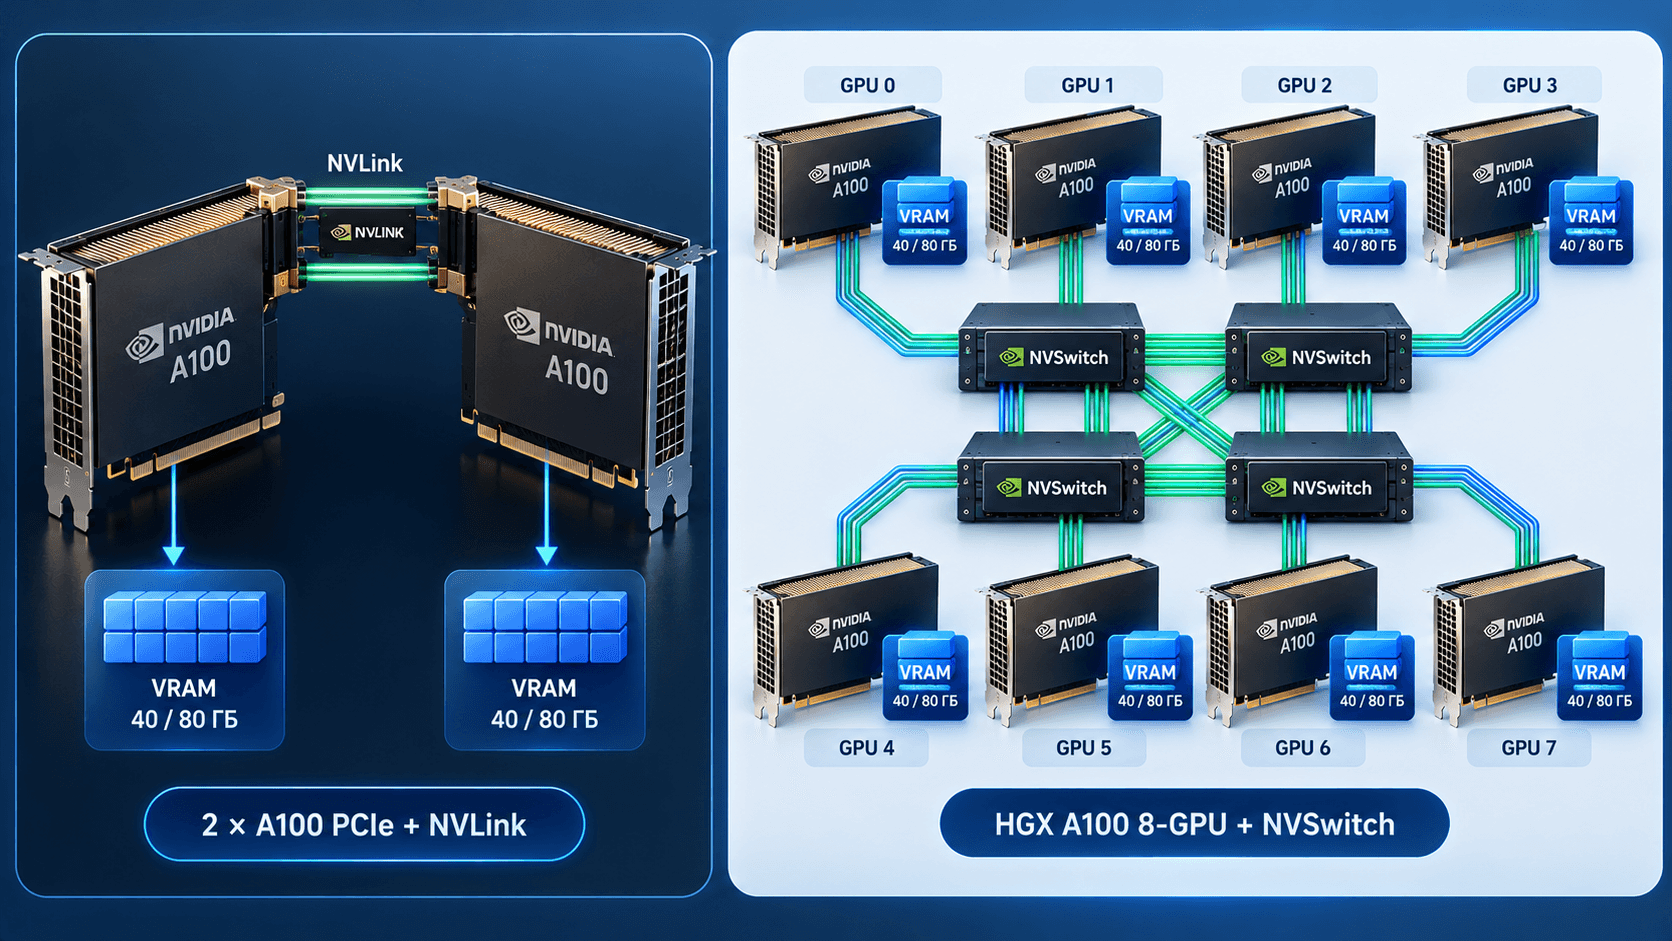
Для A100 NVIDIA указывает NVLink с агрегированной полосой до 600 ГБ/с на GPU. В PCIe-исполнении соединение пары карт требует подходящих мостов и поддерживаемого размещения. В HGX-системах используется своя схема связности; наличие NVSwitch проверяют по конкретной платформе.
Четыре карты A100 PCIe не становятся автоматически системой с такой же сетью обменов, как HGX A100. Число GPU одинаковое, а пути передачи данных могут быть разными. Для model parallelism и синхронизации при обучении это принципиально.
Две A100 по 80 ГБ дают 160 ГБ суммарной физической памяти. Но программа не получает прозрачный единый буфер на 160 ГБ только благодаря NVLink. Движок должен распределить модель и данные между GPU. При data parallelism веса, напротив, могут дублироваться на каждом ускорителе. Устройство этих соединений подробнее раскрыто в материале о NVLink и NVSwitch.
Что дает MIG и кому это полезно
Multi-Instance GPU позволяет разделить A100 на аппаратно изолированные экземпляры с выделенными долями вычислительных ресурсов и памяти. Максимум составляет семь экземпляров, но их размеры задаются допустимыми профилями, а не произвольным делением карты.
Такой режим полезен для нескольких небольших сервисов, учебных задач и пользователей, которым не требуется весь GPU. При этом семь экземпляров не означают семь полноценных A100. У каждого профиля есть ограничения, а допустимые сочетания определяются конфигурацией.
MIG и виртуальная машина также не являются синонимами. Возможность передать ресурсы гипервизору, поддержка vGPU и требования к лицензиям проверяются отдельно. Не стоит обещать совместимость любой VM только на основании наличия MIG.
Как выбрать сервер с NVIDIA A100
Хорошая спецификация отвечает не только на вопрос «сколько GPU», но и объясняет, как данные попадают на ускорители и как система работает под длительной нагрузкой.
Узел системы | Что проверить | Почему это влияет на результат |
|---|---|---|
GPU | 40/80 ГБ, PCIe/SXM4, артикулы, состояние | Определяет память и совместимость |
CPU | Подготовку данных, NUMA, доступные PCIe-пути | Недостаточная подача данных оставляет GPU без работы |
RAM | Пиковую потребность загрузчика, датасетов и CPU-offload | Системная память не равна VRAM и не заменяет ее без потерь |
Накопители | Чтение датасетов, рабочие файлы, запись checkpoint | Средняя скорость SSD не описывает все режимы I/O |
Сеть | Обмены между узлами и доступ к СХД | Межсерверная связь может ограничить масштабирование |
Питание и охлаждение | Допустимую длительную нагрузку всей системы | TDP одной карты не равен потреблению сервера |
ПО | Драйвер, CUDA, фреймворк, модель и точность | Поддержка GPU должна существовать во всем рабочем стеке |
Для одной модели, помещающейся на GPU, начинают с проверки одного ускорителя. Для нескольких независимых сервисов оценивают размещение по картам или MIG-профилям. Для распределенного обучения измеряют скорость на нескольких GPU и сравнивают ее с увеличением количества занятых ресурсов.
A100 или H100: когда менять поколение
H100 относится к архитектуре Hopper и добавляет возможности, которых нет у A100, включая Transformer Engine с FP8. Однако преимущество нового формата проявляется в поддерживающем его программном стеке, при подходящей задаче и приемлемом качестве результата.
Сравнение стоит проводить по времени обучения, задержке инференса, пропускной способности при заданной задержке и полной стоимости владения. Более дешевая карта может оказаться менее выгодной по результату на единицу затрат; более новая тоже не окупает свою стоимость автоматически.
Для уже установленной A100-системы сначала выясняют, можно ли использовать H100 в этой платформе. SXM4 и SXM5 не взаимозаменяемы, а для PCIe необходимо проверить питание, охлаждение и поддержку. Детальный порядок вынесен в статью о замене A100 на H100 в существующем сервере.
С игровыми GPU сравнивают не только вычислительные показатели, но и доступную память, серверную совместимость, обслуживание, режим длительной нагрузки и поддержку приложения. Универсального победителя без этих условий нет.
Как проверять A100 перед покупкой
Если рассматривается бывшее в эксплуатации оборудование, фотография и факт определения карты в системе недостаточны. Проверка должна охватывать весь сервер и точную комплектацию.
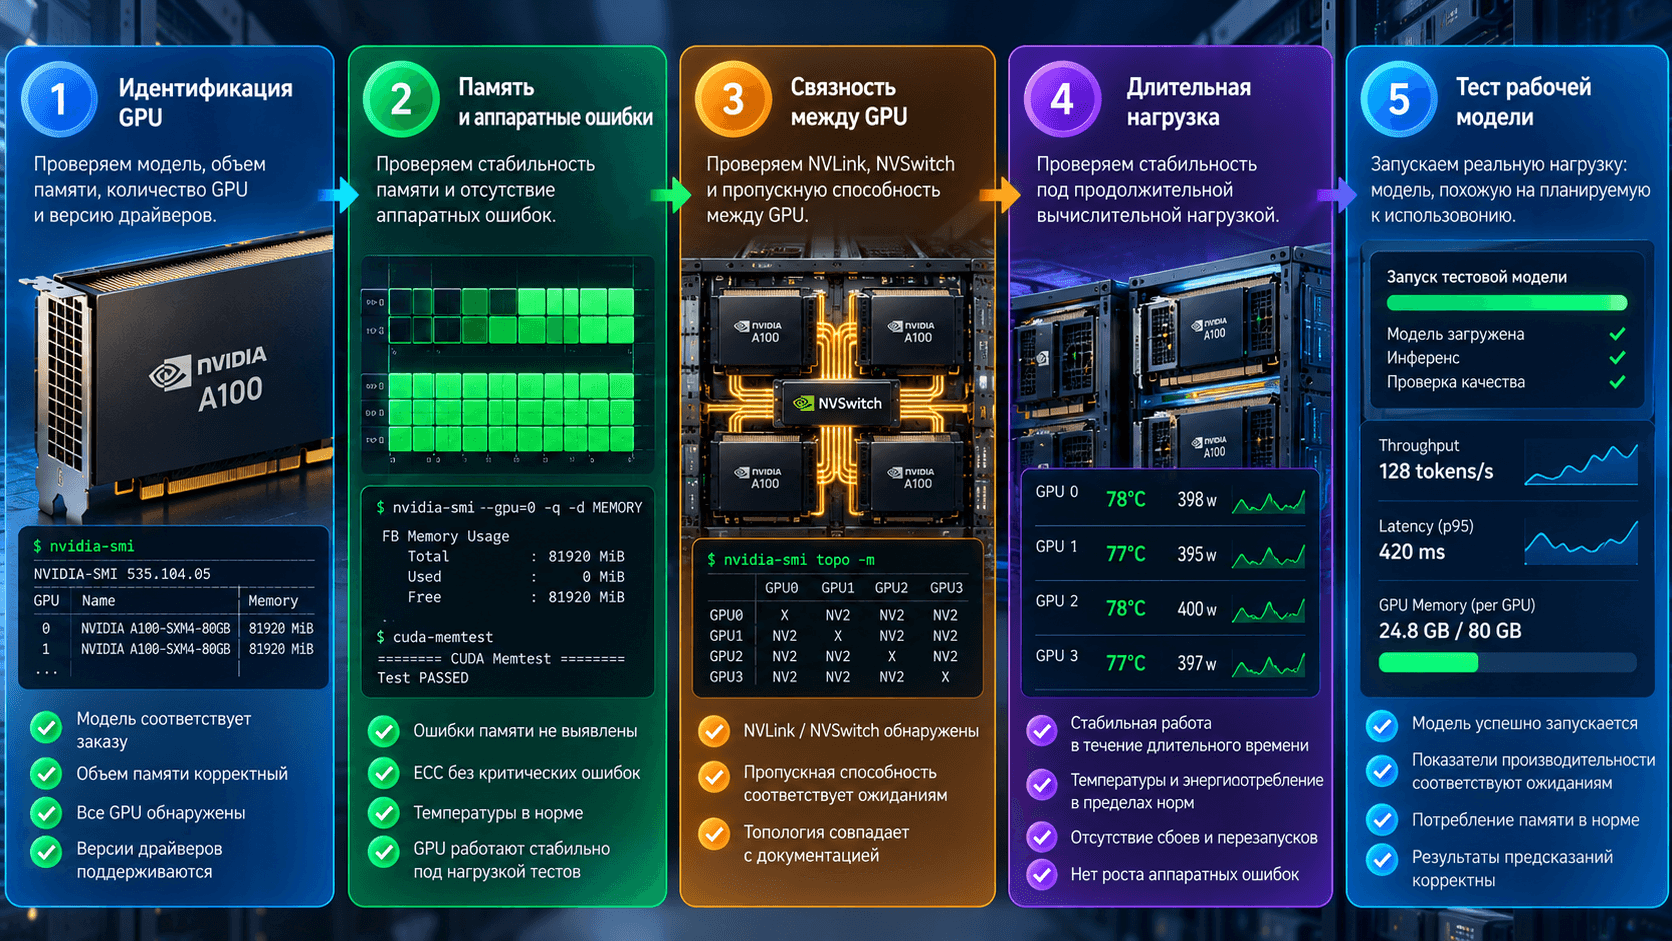
Запросите идентификацию GPU и памяти, состояние ECC, сведения о переназначении строк памяти, журнал аппаратных ошибок и результаты длительного теста. Одно ненулевое значение счетчика не следует интерпретировать без контекста: различаются исправленные, неисправимые, текущие и накопленные события. Критерии приемки лучше согласовать заранее.
Затем проверяют доступность всех GPU, межпроцессорные соединения, пропускную способность нужных путей и рабочую модель. Фиксируют версии ПО, температуру, частоты, ограничения питания, скорость и правильность результата. Для сервиса LLM тестируют не только один запрос, но и требуемую одновременную нагрузку.
Частые вопросы о NVIDIA A100
Чем A100 80GB отличается от 40GB?
Объемом и типом памяти, ее пропускной способностью, а у PCIe-вариантов также базовым TDP. Практическая разница зависит от того, ограничивает ли задачу память и требуется ли делить модель между GPU.
A100 40GB использует HBM2e?
В базовых спецификациях NVIDIA у A100 40GB указана HBM2, у 80GB указана HBM2e. Поисковая формулировка или описание продавца не заменяют проверку точного изделия.
Можно ли установить A100 SXM4 в PCIe-слот?
Нет. Нужна совместимая SXM4-платформа. PCIe и SXM4 отличаются механикой, питанием и организацией связей, а не только внешним видом.
Есть ли обычная NVIDIA A100 на 32 ГБ?
В рассматриваемой стандартной линейке NVIDIA документирует варианты 40 и 80 ГБ. Предложение «A100 32GB» требует проверки артикула, происхождения и фактической идентификации устройства. По одной такой надписи нельзя оформлять заказ.
Подходит ли A100 для локальной LLM?
Да, если модель и выбранный движок поддерживают GPU, хватает памяти и достигаются нужные показатели скорости. Сначала оценивают веса, KV-кэш, контекст и параллельные запросы, затем выбирают 40 или 80 ГБ и количество ускорителей.
Почему цена A100 у поставщиков различается?
На нее влияют исполнение, память, состояние оборудования, состав поставки и договорные условия. Сравнивать цену отдельного SXM-модуля с готовым PCIe-сервером некорректно. Актуальную стоимость запрашивают по полной спецификации.
Купить сервер или арендовать A100?
Для нерегулярного эксперимента полезно сначала проверить задачу на арендуемой конфигурации. Для постоянной нагрузки сравнивают стоимость владения, доступность ресурсов, безопасность данных и поддержку. Решение не следует из одного количества часов без учета остальных затрат.
Что передать для подбора сервера с A100
Укажите название и версию модели или приложения, обучение или инференс, точность, длину контекста, число пользователей и допустимую задержку. Добавьте измеренное потребление VRAM, данные о текущем сервере и ограничения площадки.
В разделе серверов с NVIDIA A100 можно выбрать платформы для сравнения. В итоговой спецификации должны быть зафиксированы версия GPU, память, связность, комплект поставки и тест, по которому подтверждается пригодность решения.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


