Deep Learning, или глубокое обучение, представляет направление машинного обучения, в котором нейронные сети с несколькими вычислительными слоями изучают многоуровневые представления данных. Ранние слои могут находить простые признаки, следующие объединяют их в более сложные структуры, а выходные слои решают прикладную задачу.
Глубокое обучение особенно полезно для изображений, речи, текста, видео и других данных, где ручное описание всех признаков трудно или невыгодно. Оно не отменяет классическое Machine Learning. Для небольшой табличной выборки линейная модель или градиентный бустинг часто дешевле, быстрее и понятнее.
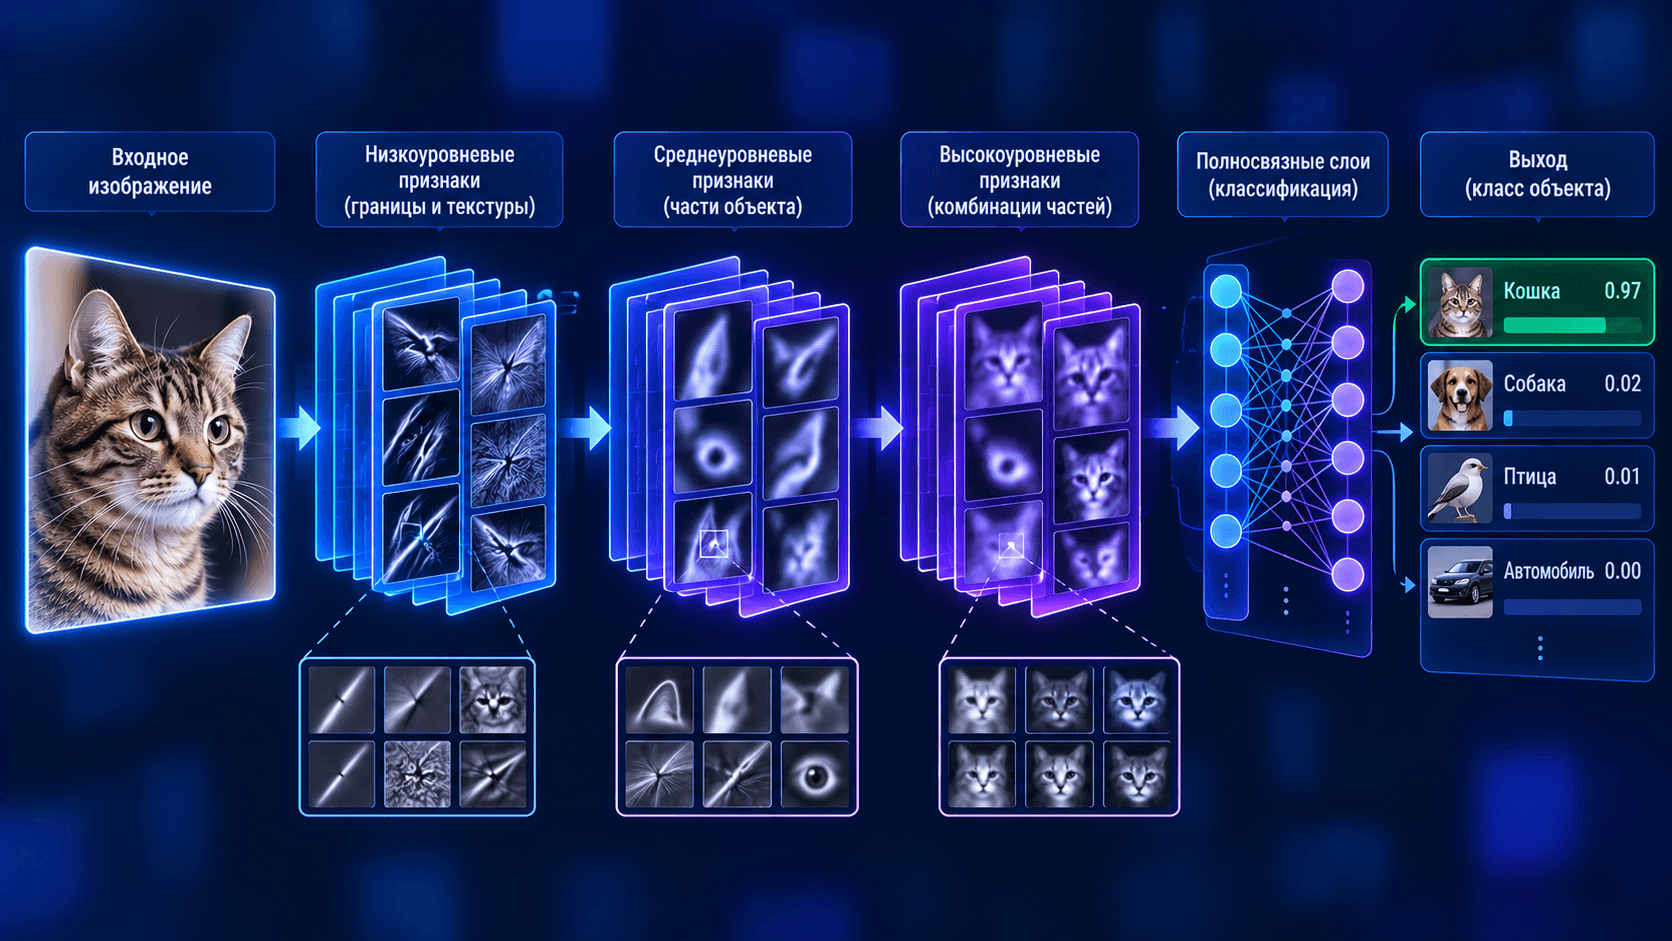
Что такое Deep Learning
В широком смысле искусственный интеллект объединяет методы создания систем, выполняющих интеллектуальные задачи. Machine Learning является его направлением и учит модели на данных. Deep Learning входит в машинное обучение и использует глубокие нейронные сети.
Слово «глубокое» относится к числу последовательных преобразований, а не к человеческой глубине понимания. Точная граница по количеству слоев не установлена. Практический признак состоит в том, что модель сама учит несколько уровней представлений и оптимизируется end-to-end под целевую функцию.
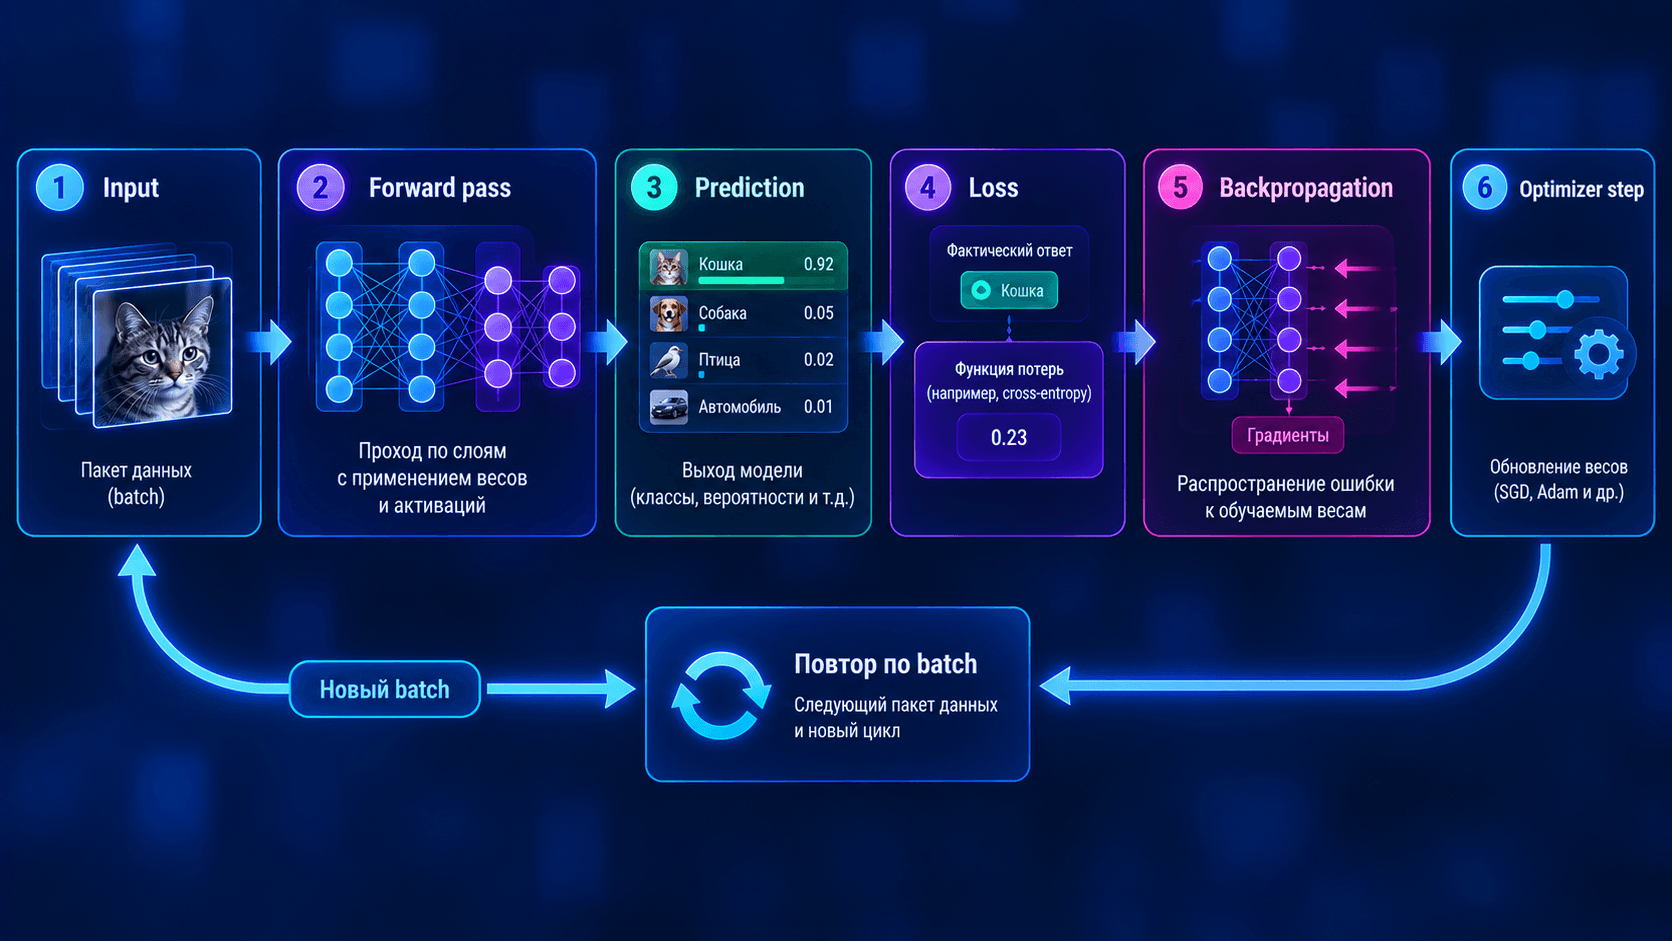
Как работает глубокое обучение
Прямой проход
Вход преобразуется слоем за слоем. Каждый слой выполняет операции над тензорами, применяет обучаемые веса, смещения и нелинейность. На выходе появляются logits, вероятности, координаты, embeddings, следующий токен или другой результат.
Функция потерь
Loss сравнивает результат модели с целевым ответом. Для классификации применяют cross-entropy, для регрессии подходят MAE или MSE, а генеративные задачи используют свои функции. Loss является сигналом оптимизации, но не всегда совпадает с бизнес-метрикой.
Backpropagation
Обратное распространение вычисляет, как изменение каждого веса повлияет на loss. Optimizer, например SGD или Adam, обновляет параметры по gradients. Один проход по всей обучающей выборке называется epoch.
Batch и итерации
Данные подаются пакетами. Большой batch лучше загружает GPU, но занимает больше памяти и способен изменить динамику оптимизации. Малый batch экономит память, однако создает более шумную оценку gradient и может хуже использовать параллелизм.
Валидация
После обновлений модель проверяют на данных, которые не использовались для поиска весов. Validation помогает выбирать гиперпараметры и момент остановки. Test оставляют для финальной независимой оценки.
Чем Deep Learning отличается от Machine Learning
Deep Learning является частью Machine Learning, поэтому корректнее сравнивать глубокие сети с классическими алгоритмами ML.
Критерий | Классическое Machine Learning | Deep Learning |
|---|---|---|
Типичные данные | таблицы и подготовленные признаки | текст, изображения, речь, видео, мультимодальные данные |
Признаки | часто проектируются человеком | во многом изучаются моделью |
Объем данных | может работать на малых и средних выборках | обычно сильнее зависит от масштаба и разнообразия данных |
Вычисления | CPU часто достаточно | обучение обычно ускоряется на GPU или другом accelerator |
Интерпретация | линейные коэффициенты и деревья проще объяснять | внутренние представления сложнее |
Время эксперимента | минуты или часы для многих табличных задач | от часов до продолжительных распределенных запусков |
Transfer learning | применяется, но не всегда центрально | часто позволяет начать с pretrained-модели |
Инференс | может быть очень легким | зависит от параметров, precision и архитектуры |
Различие не означает, что один подход всегда точнее. Глубокая сеть оправдана, если она дает измеримый выигрыш на независимом тесте и укладывается в требования по задержке, памяти и стоимости.
Какие методы относятся к глубокому обучению
Полносвязные сети
Dense-слои связывают каждый выход с каждым входом. Такие сети применяют для компактных признаковых представлений и как части более сложных моделей. На больших изображениях полносвязная обработка быстро становится дорогой.
Сверточные нейронные сети
CNN используют локальные фильтры и разделение весов. Они хорошо извлекают пространственные признаки и широко применяются в классификации, detection, segmentation и анализе медицинских изображений. Современные vision transformers дополняют и в части задач заменяют CNN.
Рекуррентные сети
RNN, LSTM и GRU обрабатывают последовательность с состоянием, которое переносится между шагами. Они остаются полезными для некоторых временных рядов и потоковых задач, хотя в NLP многие сценарии перешли к Transformer.
Transformer
Transformer строит взаимодействие элементов через attention. Архитектура позволяет параллельно обрабатывать последовательность при обучении и масштабируется до больших языковых и мультимодальных моделей. Вычислительная цена attention зависит от длины последовательности, а autoregressive-инференс генерирует выход последовательно.
Autoencoder
Encoder сжимает вход в latent-представление, decoder восстанавливает данные. Autoencoder применяют для снижения размерности, поиска аномалий, denoising и изучения признаков.
GAN и diffusion models
В GAN генератор конкурирует с discriminator. Diffusion model учится обращать процесс добавления шума и постепенно восстанавливать объект. Оба семейства применяются в генерации, но различаются стабильностью обучения, скоростью инференса и управляемостью.
Graph Neural Networks
GNN работают с узлами и ребрами графа. Они подходят для молекул, транзакционных связей, рекомендательных систем и сетевых данных, где структура связей несет существенный сигнал.
Что позволяет делать глубокое обучение
Область | Задачи | Типичные архитектуры |
|---|---|---|
Компьютерное зрение | классификация, detection, segmentation, OCR | CNN, vision transformer |
NLP | поиск, извлечение фактов, перевод, генерация | Transformer |
Речь | ASR, синтез, diarization | Transformer, Conformer, CNN |
Рекомендации | embeddings, ranking, последовательное поведение | deep ranking, Transformer |
Генерация | текст, изображение, аудио, видео | autoregressive Transformer, diffusion |
Наука и инженерия | прогноз структур, surrogate models, simulation | GNN, Transformer, operator networks |
Данные для глубокого обучения
Объем не заменяет качество. Нужны корректные права на данные, репрезентативность, очистка дублей, понятная схема разметки и независимый test. Ошибка разметки создает потолок качества, а leakage дает красивую, но ложную метрику.
Практический pipeline включает:
Инвентаризацию источников и ограничений доступа.
Отбор и дедупликацию.
Разметку с инструкцией и контролем согласия.
Train, validation и test split с учетом времени и групп.
Preprocessing и augmentation.
Версионирование датасета.
Мониторинг drift после запуска.
Pretrained-модель снижает объем данных для старта, но не отменяет доменную проверку. Модель, обученная на общих изображениях или текстах, может систематически ошибаться на специализированной терминологии и оборудовании.
Почему для Deep Learning используют GPU
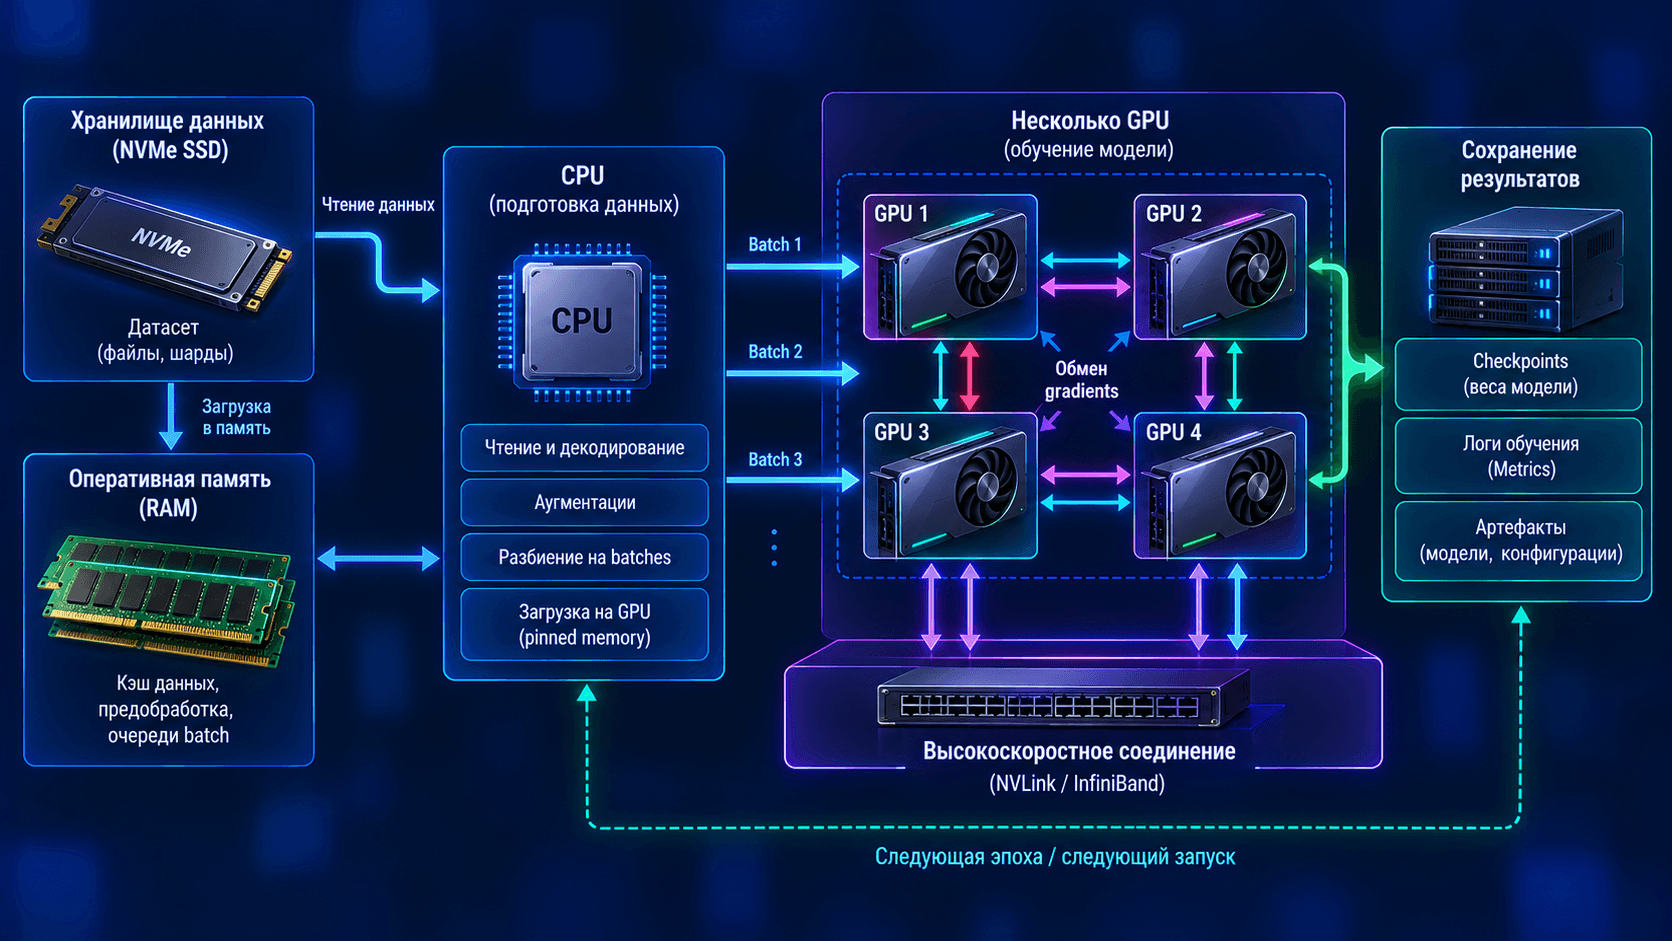
Обучение состоит из крупных операций над матрицами и тензорами. GPU выполняет множество таких операций параллельно и имеет высокую пропускную способность памяти. CPU остается нужен для оркестрации, подготовки данных, декодирования, логики и работы сервисов.
Производительность определяет вся система:
GPU и поддерживаемые форматы вычислений;
объем и bandwidth VRAM;
CPU, RAM и NUMA;
PCIe или высокоскоростной GPU interconnect;
локальные NVMe и удаленная СХД;
сеть между узлами;
охлаждение и power limit;
framework, kernels и distributed runtime.
Инструменты: Python, PyTorch, TensorFlow и Keras
Глубокое обучение на Python обычно строится поверх tensor framework. PyTorch предоставляет modules, autograd и distributed-инструменты. TensorFlow и Keras дают слои, модели, обучение, сохранение и deployment-инструменты. Выбор зависит от существующего кода, поддерживаемых моделей, runtime, команды и требований к production.
Проверять нужно не популярность фреймворка вообще, а конкретный стек:
поддерживается ли архитектура и нужные operators;
есть ли kernels для целевого accelerator;
как выполняется distributed training;
можно ли экспортировать модель;
какие runtime доступны для инференса;
как версионируются данные, веса и окружение.
Обучение с нуля, fine-tuning или готовая модель
Подход | Когда подходит | Главный риск |
|---|---|---|
Готовая модель без изменения весов | быстрый пилот и универсальная задача | доменное качество может быть недостаточным |
Feature extraction | мало размеченных данных | признаки могут не отражать специфику домена |
Fine-tuning части слоев | доменная адаптация при умеренном бюджете | переобучение и забывание исходных навыков |
Полное дообучение | нужно глубоко изменить поведение | память, время и сложность контроля |
Обучение с нуля | уникальная архитектура или большой собственный корпус | максимальные требования к данным и вычислениям |
Для LLM отдельно применяют LoRA и QLoRA. Они уменьшают число обучаемых параметров, но все равно требуют расчета VRAM, подготовки датасета и проверки итогового поведения. Класс систем собран в разделе AI-серверов для fine-tuning и дообучения моделей.
Как понять, нужен ли проекту Deep Learning
Выбирайте глубокое обучение, если выполняется несколько условий:
Данные неструктурированные или мультимодальные.
Есть достаточная выборка либо подходящая pretrained-модель.
Классический baseline не достигает нужного качества.
Команда способна поддерживать data и model pipeline.
Доступны вычисления для экспериментов и инференса.
Выигрыш оправдывает дополнительные затраты и риски.
Оставьте классический ML, если данные табличные, выборка мала, правила должны быть прозрачными, latency жестко ограничена или глубокая сеть не дает подтвержденного прироста.
Как подобрать сервер для глубокого обучения
Сначала запускают representative workload и измеряют peak VRAM, время шага, скорость dataloader, GPU utilization и обмен между ускорителями. Затем добавляют запас на рост модели, batch, checkpoints и параллельные эксперименты.
Для локальной разработки и прототипов подходит компактный класс систем. NVIDIA DGX Spark GB10 имеет unified memory и готовый программный контур, но выбор подтверждают на нужной модели и ARM64-совместимости зависимостей.
Типичные ошибки
Считать Deep Learning универсальной заменой классическому ML.
Начинать с большой сети без baseline.
Смешивать похожие объекты между train и test.
Оценивать модель на данных из того же временного периода.
Игнорировать права, происхождение и смещения датасета.
Увеличивать модель при проблеме в разметке.
Покупать GPU только по числу FLOPS.
Не учитывать VRAM, bandwidth памяти и topology.
Оптимизировать training loss вместо целевой метрики.
Переносить benchmark чужой модели на свой pipeline.
Не измерять инференс и стоимость результата.
Не планировать мониторинг drift, rollback и обновление модели.
FAQ
Что такое глубокое обучение простыми словами?
Это способ обучения многослойной нейронной сети, при котором модель сама строит несколько уровней представления данных и настраивает веса по ошибке.
Deep Learning и Machine Learning это одно и то же?
Нет. Deep Learning является частью Machine Learning. Машинное обучение также включает линейные модели, деревья, бустинг, SVM, кластеризацию и другие методы.
Чем отличается машинное обучение от глубокого обучения?
Классический ML чаще опирается на подготовленные признаки и хорошо работает с таблицами. Deep Learning изучает представления внутри нейросети, особенно полезен для текста, изображений и речи, но обычно требует больше данных и вычислений.
Глубокое обучение и нейронные сети это синонимы?
Не полностью. Глубокое обучение использует нейронные сети с несколькими уровнями преобразований. Нейросеть может быть небольшой и не относиться к современным глубоким архитектурам.
Какие методы относятся к глубокому обучению?
CNN, RNN, LSTM, Transformer, autoencoder, GAN, diffusion models и GNN. Многие production-модели сочетают несколько блоков.
Что позволяет делать глубокое обучение?
Распознавать и генерировать текст, изображения, речь и видео, строить embeddings, выявлять объекты, прогнозировать последовательности и извлекать сложные признаки.
Можно ли изучать Deep Learning без Python?
Понять концепции можно без языка программирования. Для разработки Python остается основным инструментом из-за экосистемы PyTorch, TensorFlow, JAX и библиотек данных.
Обязательно ли нужен GPU?
Для маленького примера нет. Для практического обучения крупных сетей GPU обычно резко сокращает время. При выборе учитывают не только compute, но и память, bandwidth и программную поддержку.
Сколько данных нужно для глубокого обучения?
Единого числа нет. Оно зависит от разнообразия задачи, качества разметки, размера модели, transfer learning и допустимой ошибки. Representative validation важнее произвольного порога количества строк.
Можно ли обучить глубокую модель без интернета?
Да, если локально доступны данные, веса, зависимости и вычислительная инфраструктура. Варианты развертывания описаны в статье локальная нейросеть без интернета.
Что передать для расчета DL-инфраструктуры
Укажите модель или архитектуру, формат и объем данных, precision, размер batch, частоту экспериментов, целевое время обучения, требования к инференсу и план масштабирования. Start Server поможет проверить расчет GPU, VRAM, CPU, RAM, NVMe, сети, питания и охлаждения. Отправить вводные можно через контакты Start Server.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


