Эмбеддинг, или embedding, это числовое представление объекта в виде вектора фиксированной размерности. Для текста объектом может быть токен, предложение, абзац или документ. Модель строит векторы так, чтобы близкие по смыслу объекты обычно располагались ближе друг к другу в выбранном пространстве.
В RAG эмбеддинги нужны для поиска контекста. Система заранее преобразует фрагменты документов в векторы, затем тем же совместимым преобразованием кодирует вопрос пользователя и находит ближайшие фрагменты. Найденный текст добавляется в контекст большой языковой модели. LLM отвечает по переданным материалам, а не читает всю базу при каждом запросе.
Эмбеддинг не является кратким пересказом или архивом, из которого можно восстановить исходный текст. Это набор чисел, полезный для сравнения объектов внутри конкретной модели и версии.
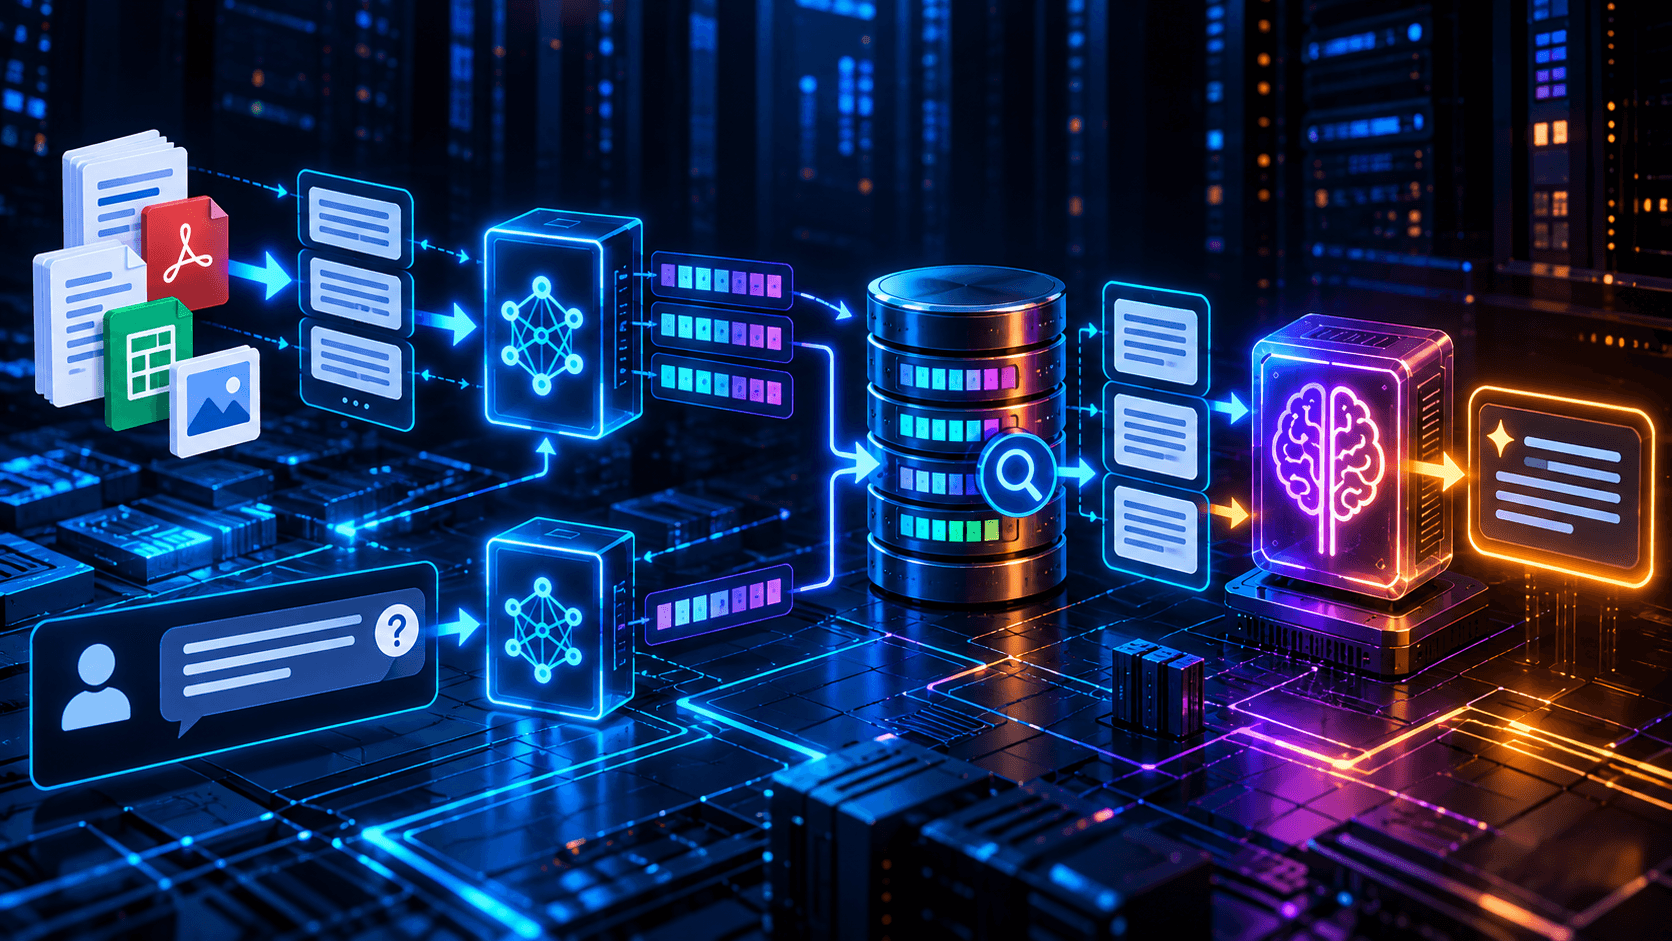
Что такое эмбеддинг простыми словами
Представьте каталог технических документов. По точному совпадению слов запрос «перегревается ускоритель» может не найти инструкцию с формулировкой «температура GPU превышает допустимый предел». Текстовый эмбеддинг помогает сопоставить близкий смысл, даже если слова различаются.
После обработки фразы модель может вернуть, например, вектор из сотен чисел:
[0.021, -0.184, 0.407, ...]
Отдельное число обычно нельзя надежно трактовать как конкретное понятие. Значение имеет положение всего вектора относительно других векторов. Чем лучше модель научилась представлять нужный язык и предметную область, тем полезнее эта геометрия для поиска.
Как нейросеть создает эмбеддинги
Текст сначала делится на токены. Затем нейронная сеть обрабатывает токены с учетом архитектуры и контекста, после чего формируется один или несколько векторов.
Нужно различать несколько понятий:
Понятие | Что кодирует | Где используется |
|---|---|---|
Эмбеддинг токена | элемент токенизированной последовательности | внутри языковой модели |
Позиционный эмбеддинг | положение токена в последовательности | помогает модели учитывать порядок |
Эмбеддинг предложения или фрагмента | общий смысл текстового блока | semantic search, RAG, кластеризация |
Эмбеддинг изображения | визуальные признаки | поиск похожих изображений, мультимодальный поиск |
Токенный вектор внутри LLM нельзя автоматически подставить вместо документного embedding model. Для retrieval обычно применяют модель, обученную сопоставлять запросы и тексты. В некоторых архитектурах запрос и документ получают разные инструкции или проходят через разные ветви. Их выходы все равно должны принадлежать совместимому пространству.
Подробнее устройство языковых моделей раскрыто в материале что такое LLM и как работает большая языковая модель.
Как измеряется близость векторов
После создания векторов система рассчитывает similarity или distance. Распространенные варианты:
cosine similarity сравнивает направление векторов;
dot product учитывает скалярное произведение;
Euclidean distance измеряет расстояние между точками.
Метрику нельзя выбирать отдельно от модели. Документация embedding model обычно указывает, как сравнивать ее выходы и нужна ли нормализация. Если смешать разные модели, версии, размерности или правила нормализации, оценки потеряют смысл.
Близость также не равна истинности. Поиск может вернуть фрагмент, похожий по теме, но не содержащий ответа. Поэтому production RAG часто использует фильтры по метаданным, гибридный поиск и reranker, а затем проверяет, подтверждается ли ответ источником.
Зачем эмбеддинги нужны в RAG
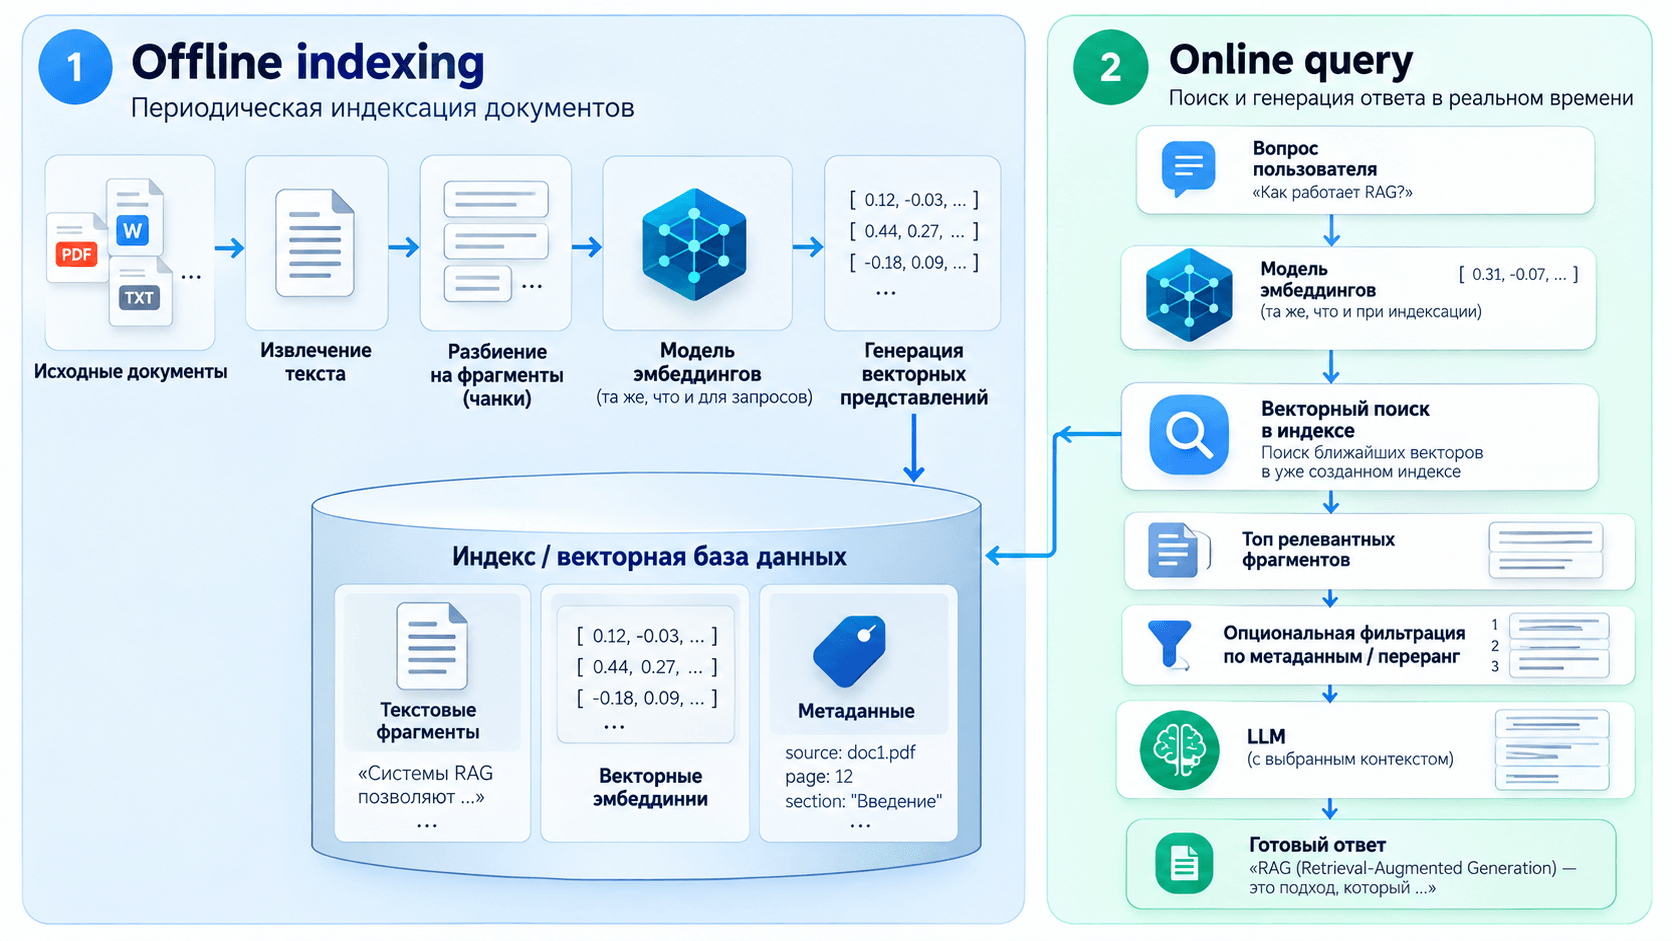
RAG расшифровывается как retrieval-augmented generation. Его задача состоит в том, чтобы перед генерацией найти внешние материалы и передать их модели. Базовый контур состоит из двух частей.
Индексация документов
Система получает файлы и извлекает текст.
Текст очищается и разбивается на chunks.
Для каждого фрагмента создается embedding.
Вектор, исходный текст, ссылка на документ и метаданные сохраняются в индексе.
Обработка запроса
Вопрос преобразуется в query embedding.
Индекс возвращает top-k близких кандидатов.
Фильтры исключают документы без нужных прав, версии или типа.
При необходимости reranker меняет порядок кандидатов.
Выбранные фрагменты добавляются в prompt LLM.
Модель генерирует ответ, желательно с цитатами и ссылками на источники.
Проверка всей цепочки описана в руководстве как проверить спецификацию RAG-сервера. Готовые аппаратные классы собраны в категории серверов для RAG-систем.
Chunking влияет на поиск не меньше модели
Если поместить в один chunk десятки разнородных страниц, его вектор усреднит несколько тем. Если разрезать текст слишком мелко, найденный кусок потеряет условия, обозначения и связь с таблицей. Универсального количества символов нет.
Chunking проверяют на реальных вопросах. Для регламентов полезно сохранять заголовки и иерархию разделов. Для карточек оборудования лучше не отрывать характеристику от названия модели и единицы измерения. Для договоров нужны номера пунктов и версия документа. Overlap помогает удержать контекст на границе, но увеличивает индекс и число почти одинаковых результатов.
Как выбрать embedding model
Запрос «лучшая эмбеддинг модель» не имеет универсального ответа. Выбор зависит от корпуса и критериев приемки.
Проверьте:
русский язык и смешанные русско-английские тексты;
максимальную длину входа и фактическое усечение;
качество на коротких запросах и длинных фрагментах;
поддержку asymmetric retrieval, если запрос и документ кодируются по-разному;
размерность вектора, объем индекса и скорость поиска;
лицензию, режим локального запуска и требования к данным;
latency, throughput и возможность пакетной индексации;
совместимость с выбранной векторной базой и метрикой.
Как оценить качество эмбеддингов в RAG
Случайные демонстрационные вопросы создают ложное чувство готовности. Нужен тестовый набор, в котором для каждого запроса известны релевантные документы или фрагменты.
На retrieval-этапе полезны:
Recall@k, попал ли нужный фрагмент в первые k результатов;
Precision@k, какая доля выбранных фрагментов действительно полезна;
MRR, насколько высоко расположен первый релевантный результат;
nDCG, насколько корректно упорядочены результаты разной релевантности.
После этого отдельно оценивают итоговый ответ: опирается ли он на найденные источники, не смешивает ли версии, правильно ли цитирует и отказывается ли отвечать при отсутствии данных. Хороший генератор не исправит retrieval, который не нашел основание ответа.
Типичные ошибки при создании эмбеддингов
Документы и запросы кодируются разными несовместимыми моделями.
После смены модели старые векторы не пересчитываются.
Текст обрезается по лимиту, но система не фиксирует факт усечения.
В индекс попадают дубли, устаревшие версии и документы без ACL.
Поиск настроен только на семантику и теряет точные артикулы, коды ошибок и обозначения.
Порог similarity выбирают по одному примеру.
Качество оценивают по красивому ответу LLM, не проверяя Recall@k.
Векторный индекс считают резервной копией исходных документов.
Для артикулов, фамилий, номеров и редких терминов часто полезен гибридный поиск, который объединяет dense embeddings с лексическим ранжированием. Метаданные должны ограничивать область поиска до расчета или сразу после него, особенно при разграничении доступа.
Какие ресурсы нужны для эмбеддингов
Создание эмбеддингов является инференсом отдельной модели. Небольшой объем можно обработать на CPU, а массовую индексацию и строгий SLA часто ускоряют на GPU. Итоговая конфигурация зависит от числа документов, частоты обновления, batch size, длины chunks и требуемого времени переиндексации.
Векторный индекс нагружает CPU, RAM и накопители. LLM generation обычно предъявляет более высокие требования к VRAM. Поэтому RAG нельзя корректно рассчитать только по размеру генеративной модели. Методика расчета полного контура приведена в статье о сервере для корпоративного RAG.
FAQ
Что такое эмбеддинг в нейросети?
Это вектор чисел, который нейросеть создает для представления признаков объекта. Для текста вектор может описывать токен, предложение или документ.
Эмбеддинг хранит весь исходный текст?
Нет. Он не заменяет документ и не позволяет надежно восстановить его целиком. В RAG исходный текст и метаданные хранят рядом с вектором.
Что такое пространство эмбеддингов?
Это многомерное пространство, в котором каждый объект представлен точкой. Расстояние или similarity между точками используется как оценка близости.
Зачем RAG векторная база?
Она хранит векторы и выполняет поиск ближайших кандидатов. Конкретная архитектура может использовать специализированную vector database или расширение существующей СУБД.
Можно ли заменить embedding model без переиндексации?
Обычно нет. Новая модель создает другое пространство. Документы и запросы нужно заново закодировать совместимой версией.
Чем эмбеддинги отличаются от токенов?
Токен является элементом разбиения текста. Эмбеддинг является числовым представлением токена или более крупного объекта.
Нужна ли GPU для эмбеддингов?
Не всегда. CPU может быть достаточен для небольшого корпуса и невысокой нагрузки. GPU полезна при массовой индексации, высокой параллельности или строгом времени ответа.
Как перейти от демонстрации к рабочему RAG
Сначала соберите реальные вопросы, эталонные документы и ограничения доступа. Затем сравните embedding models, chunking, hybrid search и reranking по одним и тем же метрикам. После фиксации pipeline можно рассчитывать CPU, GPU, RAM, NVMe и резервирование.
Start Server может помочь спроектировать и проверить RAG-контур на вашем корпусе. Для первичной оценки подготовьте объем документов, частоту обновления, число одновременных запросов, целевую задержку и используемую LLM. Отправить исходные данные можно через контакты Start Server.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


