GPU, или Graphics Processing Unit, это графический процессор. Он создан для быстрого выполнения большого числа похожих операций над множеством данных. Именно такая работа возникает при рендеринге миллионов пикселей, умножении матриц нейросети, обработке кадров видео и научном моделировании.
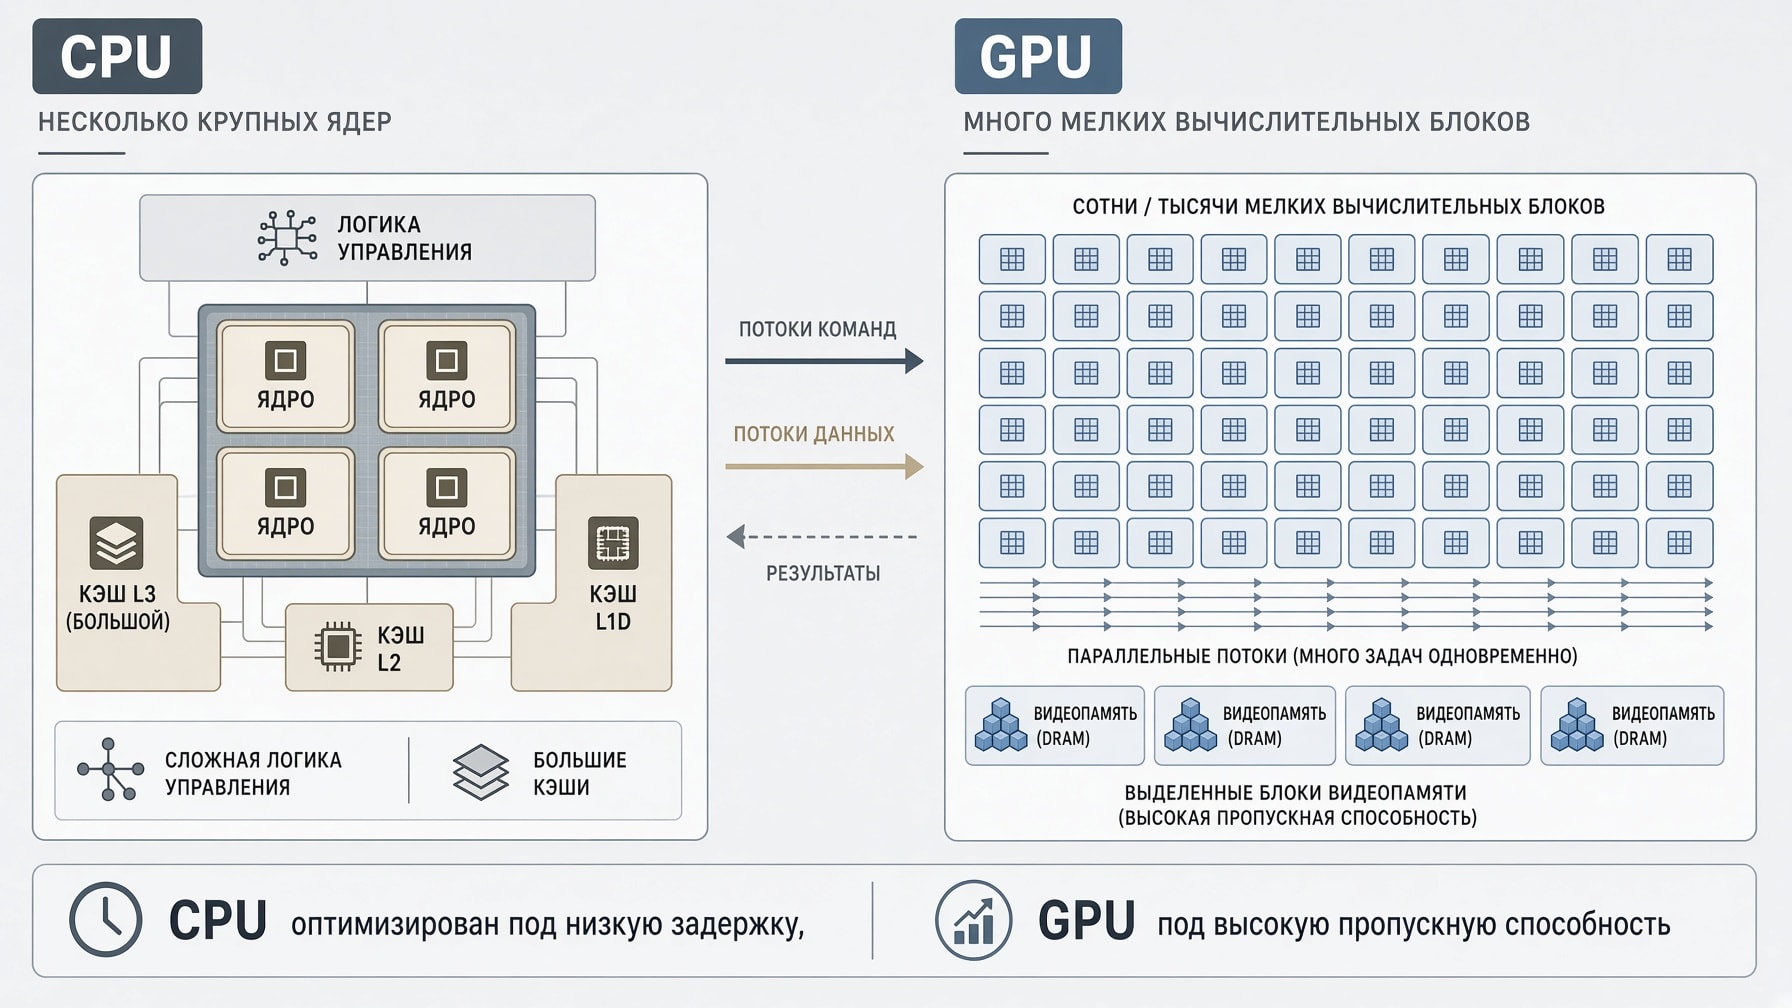
CPU, или центральный процессор, управляет операционной системой, запускает программы и хорошо справляется с разной логикой, ветвлениями и последовательными этапами. GPU жертвует частью этой универсальности ради высокой пропускной способности в параллельных задачах.
Содержание
Что такое GPU простыми словами
GPU это видеокарта или процессор
Из чего состоит GPU
Как работает GPU
Чем GPU отличается от CPU
Когда GPU быстрее CPU
Какие бывают GPU
Зачем GPU нужен для нейросетей
Как выбрать GPU
Частые вопросы
Что такое GPU простыми словами
Расшифровка GPU звучит как Graphics Processing Unit. На русском это графическое процессорное устройство, или проще, графический процессор.
Изначально GPU развивались как ускорители графики. Для одного кадра нужно обработать вершины объектов, собрать из них примитивы, определить пиксели, рассчитать цвет, текстуры, освещение и записать результат. Многие эти операции можно выполнять параллельно.
GPU это видеокарта или процессор
GPU это процессор, а не вся видеокарта. В разговорной речи эти термины часто используют как синонимы, но для выбора и монтажа оборудования разница важна.
Термин | Что означает | Где встречается |
|---|---|---|
GPU | кремниевый процессор с вычислительными и специализированными блоками | внутри видеокарты, ускорителя, процессора или SoC |
Видеокарта | готовое устройство с GPU, памятью, подсистемой питания, печатной платой и охлаждением | настольный ПК, рабочая станция, часть сервов |
Встроенный GPU | GPU внутри процессора или одного корпуса с CPU, обычно с общим доступом к системной памяти | ноутбук, офисный ПК, мобильный SoC, встраиваемая система |
GPU-ускоритель | устройство для вычислений; видеовыходы и активный кулер могут отсутствовать | сервер, ЦОД, научный кластер, AI-платформа |
Важный практический вывод: слово GPU не сообщает форм-фактор. Один GPU может быть частью обычной карты PCIe, модуля для специализированной платформы, кристалла в составе SoC или логики внутри CPU.
Из чего состоит GPU
Точное устройство GPU зависит от архитектуры. Названия NVIDIA, AMD и Intel различаются, но у современных графических процессоров есть общие классы блоков.
Вычислительные блоки
Группы арифметических устройств исполняют целочисленные операции и расчеты с плавающей точкой. NVIDIA объединяет их в Streaming Multiprocessor, или SM. У AMD базовый исполнительный блок называется Compute Unit, или CU. Каждый SM или CU содержит не одно полноценное CPU-ядро, а набор планировщиков, регистров, кэша, локальной памяти и множества исполнительных линий.
Специализированные ускорители
В разных GPU могут быть матричные блоки для AI, блоки трассировки лучей, текстурные модули, медиадвижки для кодирования и декодирования видео. Термин Tensor Core относится к архитектуре NVIDIA. У других производителей есть свои названия и организация матричных вычислений.
Память и кэши
Поток имеет доступ к регистрам и частным данным. Потоки одной рабочей группы могут обмениваться данными через быструю локальную память. Кэши снижают число обращений к более медленной памяти. Глобальная память GPU обычно размещается в VRAM на карте или модуле. У встроенной графики физическая организация памяти может быть общей с CPU.
Контроллеры и интерфейсы
Командные процессоры принимают очереди работы, планировщики распределяют группы по свободным блокам, а контроллеры памяти связывают вычислительную часть с VRAM. Дискретный GPU обменивается данными с CPU и системной RAM через шину, обычно PCIe. В системах с общей памятью или когерентными интерфейсами детали обмена отличаются.
Как работает GPU
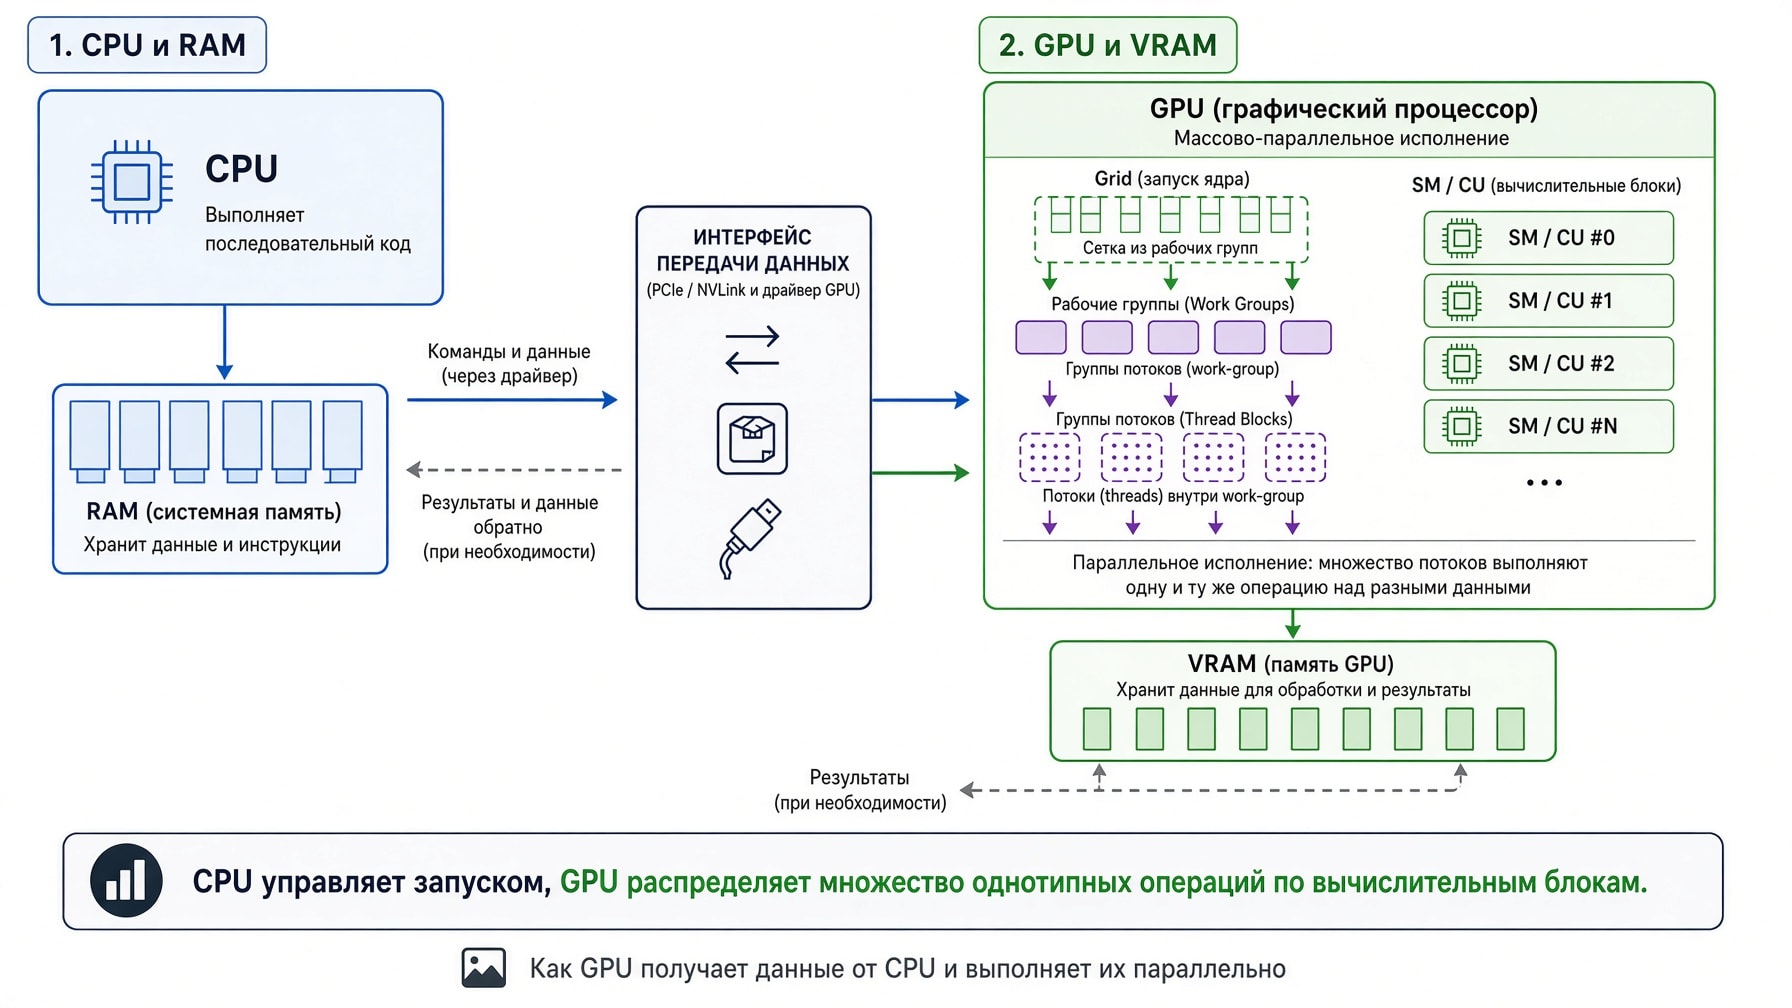
Вычисление GPU можно разложить на семь этапов.
Программа на CPU определяет, какую часть работы передать GPU.
Драйвер и runtime формируют команды, очереди, адреса памяти и параметры запуска.
Исходные данные попадают в память, доступную GPU. Для дискретной карты это часто означает копирование из RAM в VRAM.
Параллельная функция, или kernel, запускается как множество логических потоков. Они объединены в блоки или рабочие группы.
Планировщик GPU распределяет группы по SM или CU. Внутри них потоки исполняются пакетами, которые NVIDIA называет warps, а AMD wavefronts.
Потоки читают данные, выполняют арифметику, синхронизируются в допустимых границах и записывают результат.
Результат остается в памяти GPU для следующего этапа, передается в другой GPU, выводится на экран или копируется в RAM.
Это общая модель, а не описание одного API. CUDA, HIP, OpenCL, Vulkan Compute, DirectCompute и графические API используют разные термины и дают разный уровень контроля.
Как GPU рисует кадр
Графический конвейер превращает описание сцены в изображение. На вход поступают вершины, текстуры, материалы, источники света и команды. После обработки геометрии растеризатор определяет, какие пиксели покрывает примитив. Пиксельные шейдеры рассчитывают цвет, освещение и другие атрибуты. Финальный этап объединяет результат с буферами глубины и трафарета.
GPU-рендеринг выигрывает от того, что многие вершины и пиксели можно обрабатывать одинаковыми или похожими программами.
Как GPU выполняет общие вычисления
Для general-purpose computing графический конвейер не обязателен. Программа описывает kernel и пространство задач. Один поток может рассчитывать один элемент вектора, фрагмент матрицы, один пиксель или частицу физической модели.
Чем GPU отличается от CPU
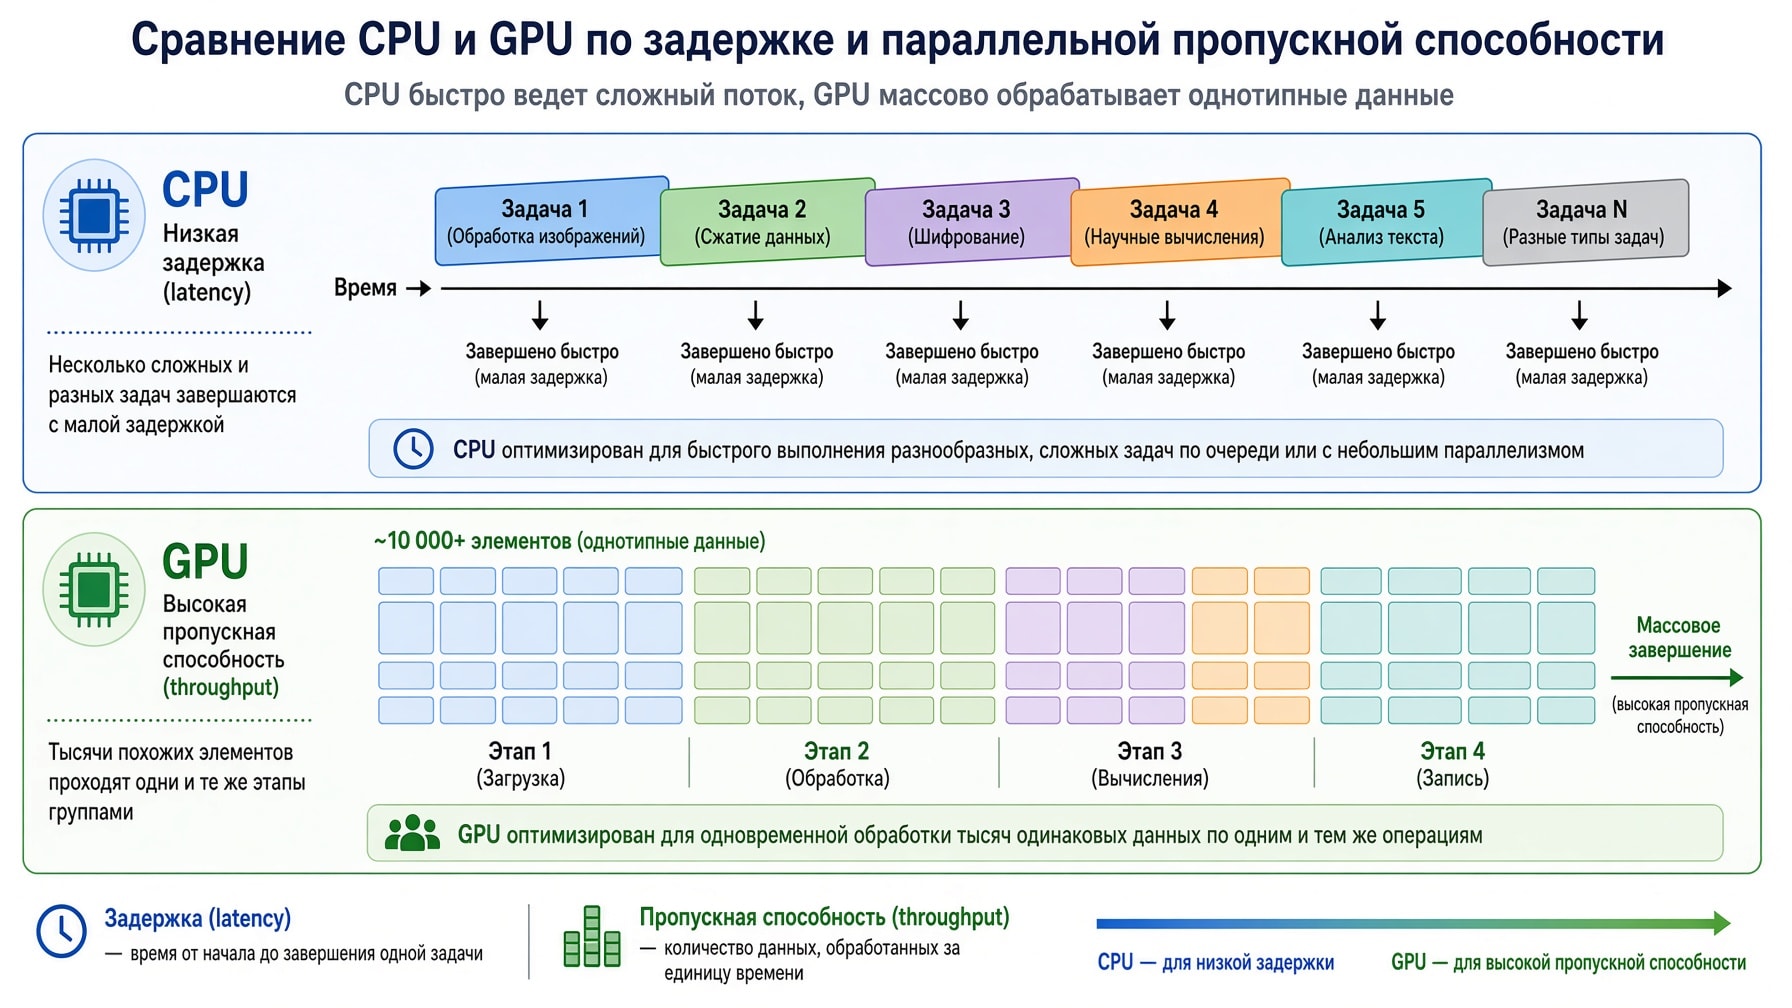
Краткое сравнение CPU vs GPU: CPU стремится быстро завершить отдельный сложный поток с минимальной задержкой. GPU стремится за единицу времени завершить очень много похожих операций.
Критерий | CPU | GPU |
|---|---|---|
Главная цель | низкая задержка и универсальность | высокая суммарная пропускная способность |
Потоки | относительно немного тяжелых потоков | очень много легких аппаратных потоков |
Ветвления | большие ресурсы на прогноз переходов и спекулятивное исполнение | расхождение потоков в группе снижает эффективность |
Кэш | крупные кэши помогают снижать задержку одного потока | иерархия памяти оптимизирована под общий поток данных многих потоков |
Память | системная RAM | отдельная VRAM или общая память в зависимости от платформы |
Сильные задачи | ОС, бизнес-логика, базы данных, последовательный код, управление | графика, матричные расчеты, AI, видео, моделирование |
Метрика | latency отдельной операции и производительность ядра | throughput, bandwidth и загрузка вычислительных блоков |
Почему ядра CPU и GPU нельзя сравнивать по количеству
Фраза «в GPU тысячи ядер, а в CPU десятки» технически неполна. Слово core в спецификациях GPU может означать арифметическую линию или специализированный блок. CPU core представляет собой гораздо более сложное устройство, способное независимо выполнять широкий набор инструкций.
Даже CUDA cores NVIDIA и stream processors AMD нельзя напрямую сравнивать между брендами и поколениями. Производительность зависит от архитектуры, частоты, инструкций, типа данных, памяти, компилятора и кода.
Когда GPU быстрее CPU
GPU может сильно ускорить задачу, если одновременно выполняются четыре условия:
работу можно разделить на много независимых элементов;
над этими элементами выполняется похожая арифметика;
на каждый загруженный байт приходится достаточно вычислений;
объем работы достаточен, чтобы окупить запуск kernel и передачу данных.
Когда CPU может быть быстрее
GPU не ускоряет любую программу автоматически. CPU часто лучше для:
короткой задачи с малым объемом данных;
последовательного алгоритма, где следующий шаг зависит от предыдущего;
логики с частыми и непредсказуемыми ветвлениями;
кода с нерегулярными обращениями к памяти и малой локальностью;
случая, когда копирование между RAM и VRAM дороже самого расчета;
операций ОС, сетевого стека, бизнес-логики и управления процессами.
На практике сравнивают не паспортные ядра, а время, throughput, latency, энергопотребление и стоимость на один результат. Один и тот же GPU может быть очень быстрым в одном kernel и неэффективным в другом.
Какие бывают GPU
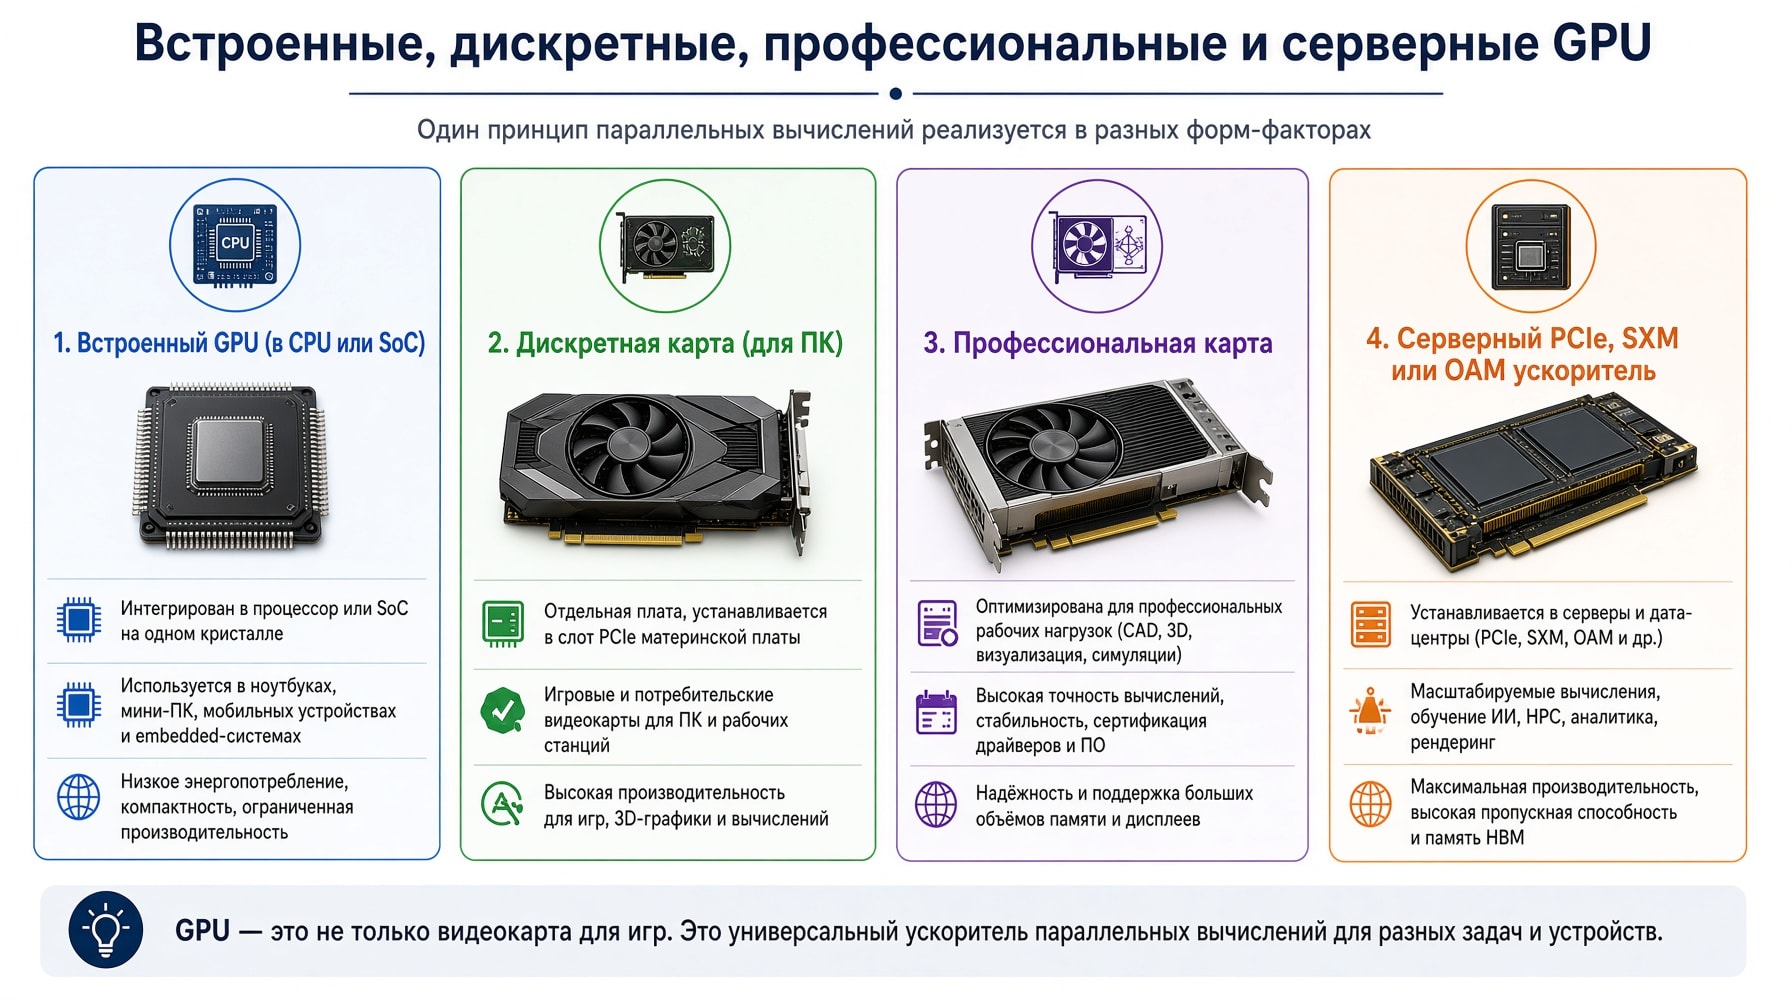
Встроенный GPU
Встроенная графика размещена вместе с CPU в одном корпусе или SoC. Она обычно использует системную память и хорошо подходит для интерфейса, офисных задач, видео и нетяжелой графики. Ее сильные стороны: компактность, цена системы и энергоэффективность.
Дискретная видеокарта
Дискретный GPU установлен на отдельной карте со своей VRAM, питанием и охлаждением. Такие карты используют в игровых ПК, рабочих станциях и части сервов. Отдельная карта дает больше вычислительных ресурсов и локальной памяти, но требует совместимой платформы.
Профессиональный GPU
Профессиональные карты ориентированы на CAD, DCC, медиа, визуализацию, локальный AI и сертифицированные приложения. Они могут отличаться большим объемом памяти, ECC, драйверным циклом и функциями виртуализации. Наличие этих возможностей проверяют по точному SKU.
Серверный GPU-ускоритель
Серверные GPU рассчитаны на инференс, обучение, HPC, видеоаналитику, виртуальные рабочие станции и другие дата-центровые нагрузки. Карта с пассивным радиатором не охлаждает себя сама: нужен рассчитанный воздушный поток шасси. Модули SXM и OAM требуют специальной базовой платы и системы.
Например, NVIDIA L4 24GB представляет собой низкопрофильный пассивный PCIe-ускоритель для инференса и обработки видео. Это не обычная игровая видеокарта с собственными вентиляторами. Такой форм-фактор нужно выбирать вместе с сервером.
Для чего нужен GPU
Игры и визуализация
GPU обрабатывает геометрию, шейдеры, текстуры, освещение, тени, постобработку и трассировку лучей. Скорость зависит от архитектуры, памяти, драйвера, игрового движка, разрешения и настроек. Число TFLOPS без этого контекста не предсказывает FPS.
Монтаж, транскодирование и стриминг
Видеоредактор может выполнять эффекты, цветокоррекцию и обработку кадров на вычислительных блоках, а кодировать или декодировать поток на специализированном медиадвижке. Поддержка кодека, профиля, цветовой глубины и числа параллельных сессий зависит от конкретной модели.
3D, CAD и рендеринг
В рабочей станции GPU ускоряет viewport, финальный рендер, физику, денойзинг и отдельные AI-инструменты. Выбор определяет не только скорость, но и сертификация приложения, точность вычислений, объем VRAM и стабильность драйвера.
Компьютерное зрение
Декодирование видео, предобработка изображений, инференс модели и постобработка могут идти на GPU. CPU при этом читает потоки, управляет бизнес-логикой и передает результат дальше. Полный конвейер и типы моделей разобраны в статье как работает компьютерное зрение.
HPC и анализ данных
Моделирование молекул, климата, потоков жидкости, физических процессов и численных методов может использовать параллельные вычисления GPU. Критически важны нужные форматы точности, пропускная способность памяти и скорость обмена между узлами.
Зачем GPU нужен для нейросетей
Обучение и инференс нейросети состоят из большого числа матричных операций, сверток, нормализаций и поэлементных функций. Многие эти операции естественно разбиваются на параллельные фрагменты. Матричные блоки современных GPU ускоряют операции в таких форматах, как FP32, TF32, BF16, FP16, FP8 и целочисленные режимы. Точный набор зависит от модели и стека.
При этом GPU для нейросетей не выбирают по одной цифре TOPS или TFLOPS. Нужны хотя бы следующие данные:
модель и режим: training, fine-tuning или inference;
точность весов и вычислений;
размер batch, контекст и число одновременных запросов;
объем весов, активаций, KV-cache и рабочих буферов;
поддержка GPU в framework, runtime, драйвере и библиотеках;
целевые latency, throughput и качество;
число GPU и тип обмена между ними.
Пошаговая методика подбора модели, памяти, форм-фактора и сервера вынесена в статью как выбрать видеокарту для ИИ, нейросетей и LLM.
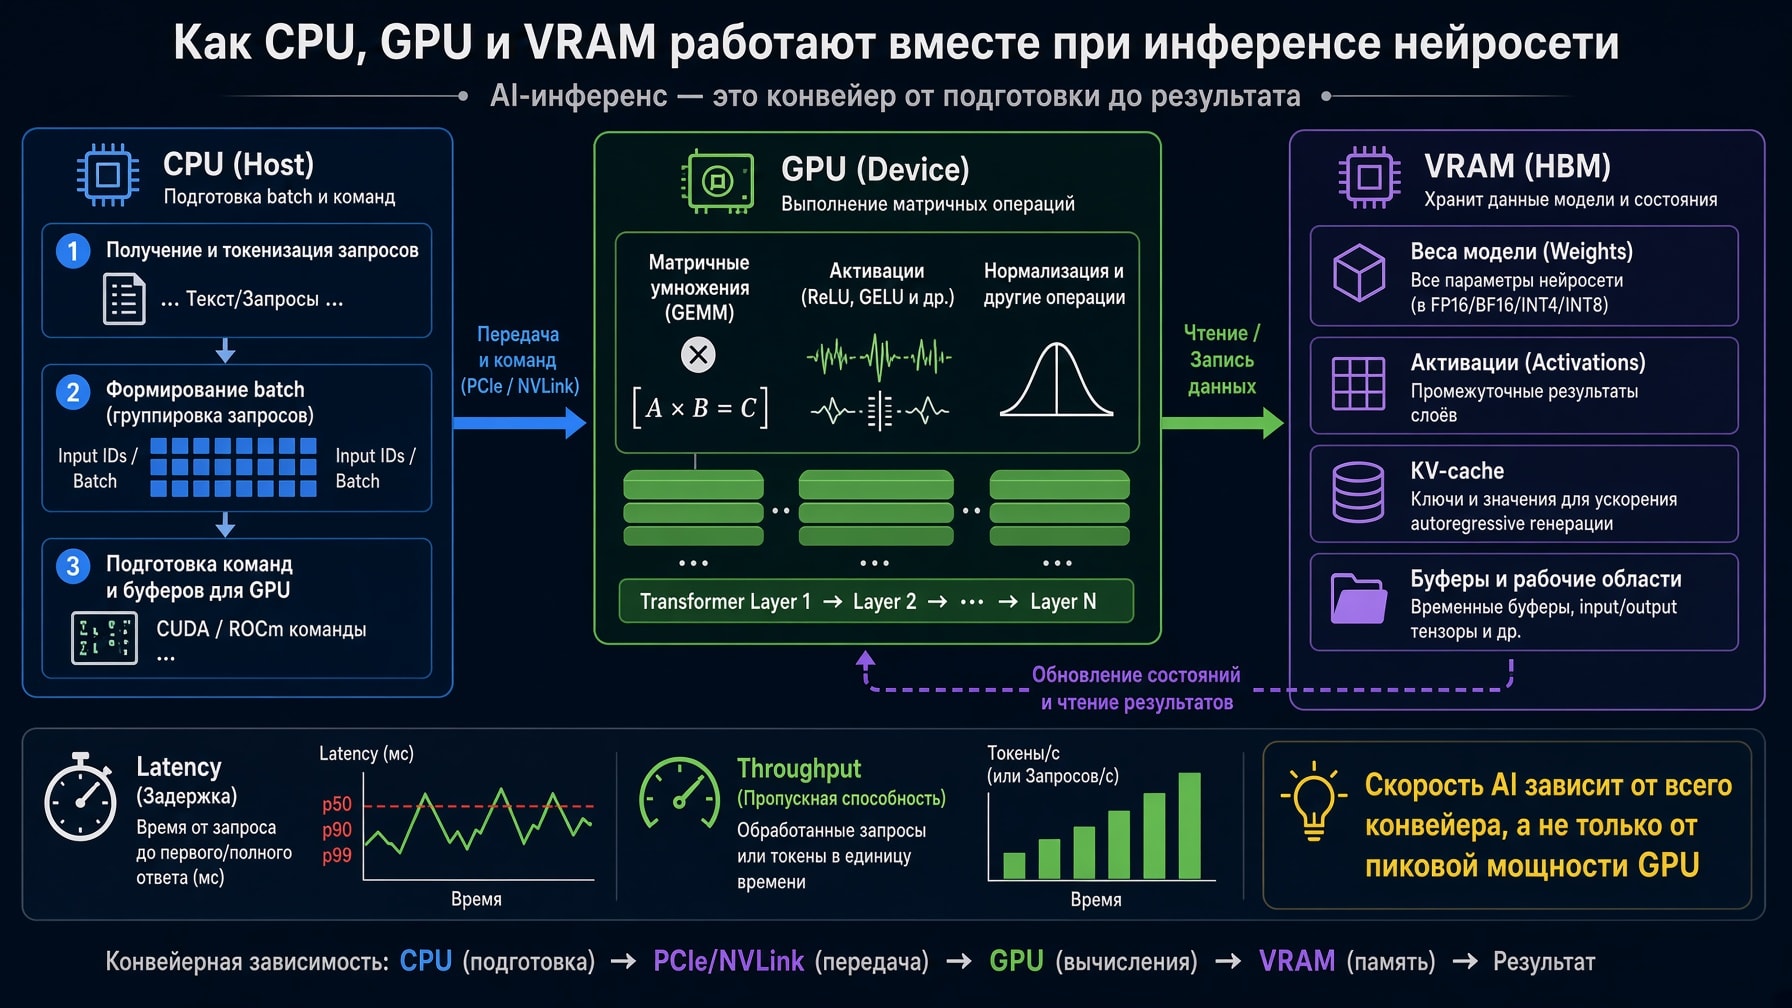
Почему GPU не заменяет CPU
Даже в насыщенном GPU-сервере центральные процессоры остаются обязательной частью системы. CPU:
загружает операционную систему и драйвер;
ведет сетевые сессии и бизнес-логику;
читает данные с накопителей и готовит batch;
управляет памятью и запусками kernels;
выполняет последовательную предобработку и постобработку;
реагирует на ошибки и координирует остальные компоненты.
Слабый CPU может не успевать подавать данные на GPU. Медленная RAM, неудачная NUMA-привязка, узкий PCIe или медленное хранилище тоже ограничивают загрузку ускорителя. Поэтому для AI подбирают всю систему, а не только карту. Основные балансы собраны в руководстве как выбрать сервер для ИИ.
Как выбрать GPU под задачу
Выбор начинается не с бренда и не с количества cores. Нужно последовательно ответить на десять вопросов.
Какая программа, модель или workload будет работать?
Какой вычислительный API, framework, runtime и driver поддерживаются?
Какой рабочий набор должен помещаться в памяти и с каким запасом?
Какие форматы точности и специализированные блоки нужны?
Какие latency, throughput, FPS или время расчета нужны?
Сколько GPU должно работать вместе и как они будут обмениваться данными?
Подходит ли форм-фактор к корпусу, плате и топологии PCIe?
Хватит ли питания, воздушного потока или жидкостного контура?
Какие CPU, RAM, storage и сеть не дадут простаивать GPU?
Какой тест на реальной нагрузке подтвердит выбор?
Типичные ошибки при оценке GPU
Считать любую видеокарту ускорителем для AI
Видеокарта может отлично запускать игры, но не иметь достаточной VRAM, нужного software stack или подходящего форм-фактора для сервера.
Сравнивать только TFLOPS или TOPS
Эти метрики всегда связаны с типом операции, форматом чисел и условиями вроде sparsity. Пиковая арифметика не показывает простои из-за памяти, расхождения потоков и обмена данными.
Думать, что больше VRAM всегда означает больше скорости
Емкость отвечает на вопрос, помещается ли нагрузка. Скорость зависит от всего конвейера. Два GPU с одинаковым объемом памяти могут сильно различаться по throughput и latency.
Складывать память двух GPU автоматически
Две карты не образуют один прозрачный пул VRAM без поддержки программы. Модель и данные нужно разделить, а часть буферов может дублироваться. Скорость такой схемы зависит от алгоритма параллелизма и interconnect.
Покупать пассивную серверную карту без проверки шасси
Пассивный радиатор рассчитан на поток воздуха сервера. Физическая установка карты в PCIe еще не доказывает, что система отводит тепло и что firmware корректно распределяет ресурсы.
Частые вопросы о GPU
Что означает GPU
GPU расшифровывается как Graphics Processing Unit. Это графический процессор для массового параллельного выполнения графических и общих вычислений.
GPU это видеокарта или процессор
GPU это процессор. Видеокарта представляет собой готовое устройство, в которое входят GPU, VRAM, питание, плата и охлаждение. Встроенный GPU может работать без отдельной видеокарты.
В чем главное отличие CPU от GPU
CPU оптимизирован для быстрого выполнения небольшого числа сложных потоков. GPU оптимизирован для одновременной обработки множества элементов. CPU дает низкую latency, GPU дает высокий throughput.
Может ли GPU работать без CPU
Обычный дискретный GPU работает как ускоритель под управлением host-системы с CPU. Существуют SoC и специальные модули, где CPU и GPU объединены, но управляющие CPU-ядра все равно присутствуют.
Какой GPU в ноутбуке или компьютере
В системе может быть встроенный GPU, дискретная видеокарта или оба варианта. Точную модель смотрят в диспетчере устройств, системном профайле, панели драйвера или через штатные инструменты ОС.
Что такое GPU cores
GPU cores обычно называют вычислительные линии внутри графического процессора. Их нельзя приравнивать к CPU cores. Количество таких линий сравнивают только вместе с архитектурой, частотой, типом операций, памятью и тестом нужной задачи.
Что такое встроенный и дискретный GPU
Встроенный GPU размещается в процессоре или SoC и обычно использует системную память. Дискретный GPU стоит на отдельной карте с VRAM, системой питания и охлаждения.
Что важнее для GPU: ядра, частота или VRAM
Единого ответа нет. VRAM ограничивает размер рабочего набора, bandwidth влияет на подачу данных, а вычислительные блоки определяют арифметический потенциал. Производительность дает их сочетание с программой и драйвером.
Нормально ли, если GPU загружен на 100%
Полная загрузка в игре, рендере или compute-задаче сама по себе не означает неисправность. Нужно одновременно смотреть температуру, частоты, питание, ошибки, throttling, стабильность и производительность. Допустимые температуры зависят от точной модели и условий производителя.
Итог
GPU это графический процессор, оптимизированный под массовые параллельные вычисления. Он входит в состав видеокарты, сервного ускорителя, CPU или SoC, но не равен всему устройству.
Главное отличие GPU от CPU состоит в целевой оптимизации. CPU сокращает задержку сложного потока. GPU увеличивает число однотипных операций, выполняемых за единицу времени. Лучший результат обычно дает гетерогенная система, где каждый процессор выполняет подходящую часть работы.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


