GPU-сервер представляет собой серверную платформу с одним или несколькими графическими или специализированными вычислительными ускорителями. В отличие от рабочей станции, он рассчитан на продолжительную нагрузку, удаленное управление, серверное охлаждение, резервирование питания и интеграцию в стойку или кластер.
Выбор GPU-сервера начинается с workload. Для video inference на десятках потоков, fine-tuning LLM и распределенного обучения нужны разные ускорители, объем VRAM, topology, CPU, сеть и storage. Простое умножение количества видеокарт не гарантирует пропорционального ускорения.
Что такое GPU-сервер и чем он отличается от обычного
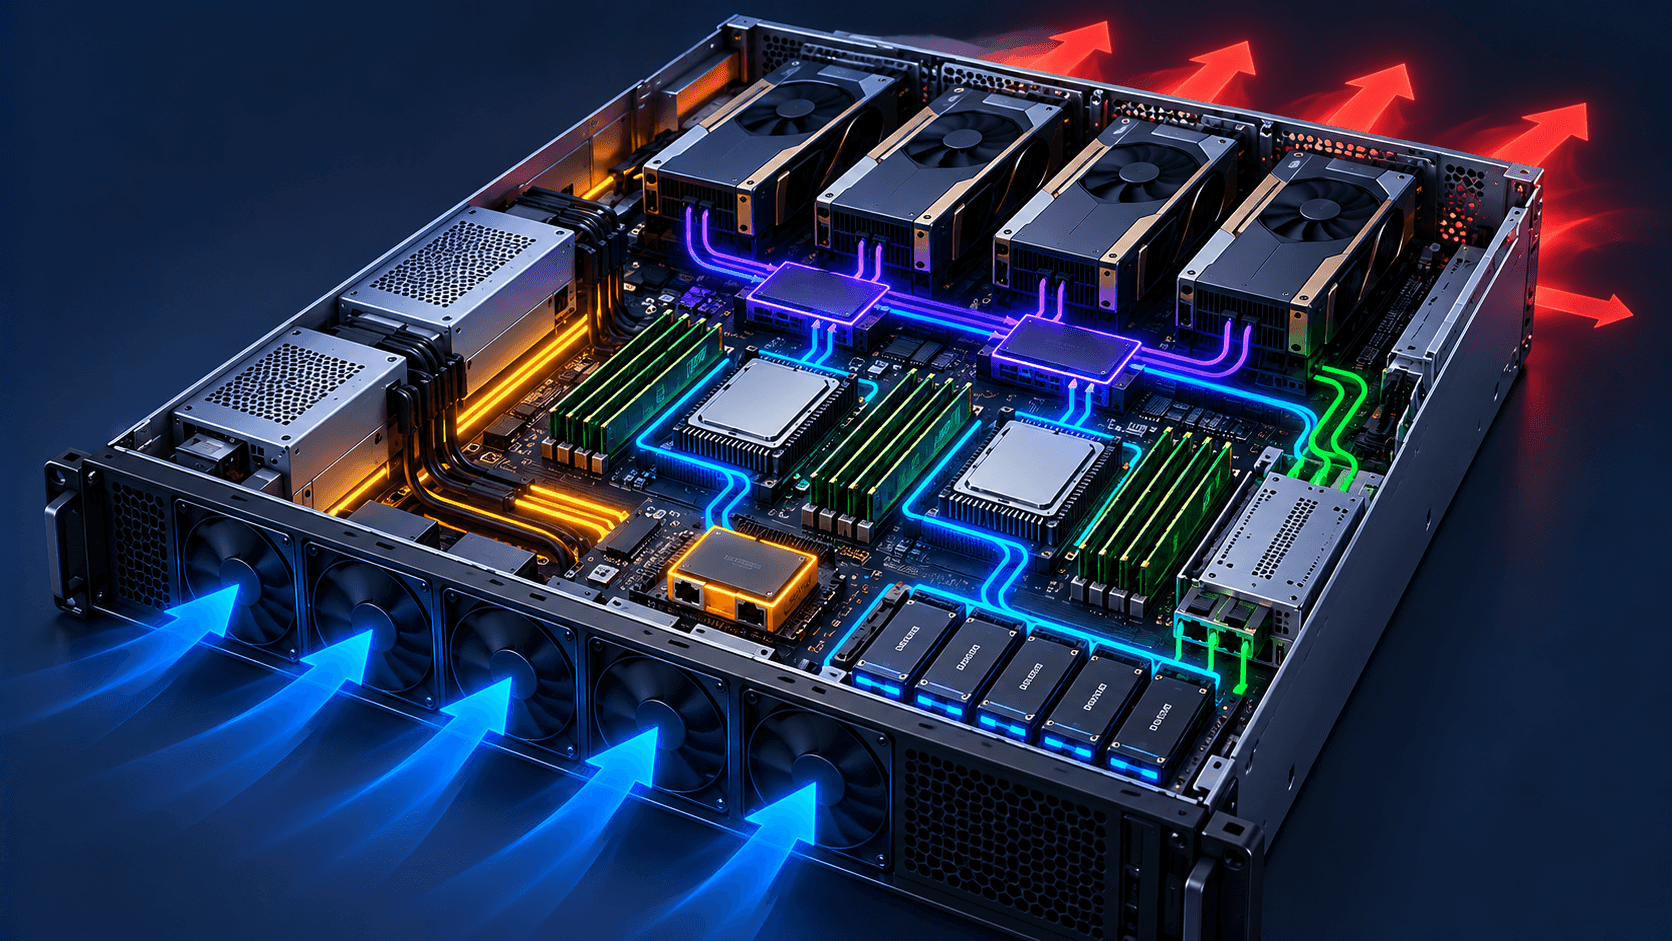
Обычный сервер оптимизирован под CPU-задачи, память, storage или виртуализацию. GPU-сервер добавляет питание, посадочные места, airflow и topology для ускорителей высокой мощности. В плотных системах используются PCIe switches, NVLink, NVSwitch и специальные baseboard.
Ключевые отличия:
больше доступной электрической мощности;
рассчитанный поток воздуха или жидкостное охлаждение;
пространство для полноразмерных двухслотовых карт либо SXM-модулей;
достаточное число PCIe-линий;
быстрый обмен между GPU;
локальные NVMe для датасетов и cache;
высокоскоростные NIC для multi-node работы;
BMC, telemetry и удаленное обслуживание;
серверные драйверы, containers и orchestration.
Для каких задач нужен GPU-сервер
Обучение нейросетей
Training хранит веса, gradients, activations и состояния optimizer. Требования к памяти выше, чем при обычном инференсе. Несколько GPU обмениваются gradients и частями модели, поэтому topology и network fabric могут определять масштабирование.
Инференс
Production-сервис оптимизируют по latency, throughput, concurrency и стоимости результата. Иногда один энергоэффективный GPU полезнее нескольких максимальных ускорителей. Для большой LLM главным ограничением часто становится VRAM и bandwidth памяти.
Fine-tuning LLM
Полное дообучение и parameter-efficient методы имеют разный профиль памяти. LoRA или QLoRA уменьшают объем обучаемых состояний, но не отменяют веса, activations и данные.
RAG и embeddings
В RAG GPU может обслуживать LLM, embedding-модель и reranker. Vector database, parsing и orchestration часто остаются на CPU. Размещать все компоненты на одном ускорителе удобно для пилота, но в production они конкурируют за память и compute.
Компьютерное зрение и видеоаналитика
Нужно учитывать разрешение, FPS, codec decode, batch, число моделей и postprocessing. Карта с аппаратными video engines может дать лучший системный результат, чем ускоритель с более высокими пиковыми FLOPS.
HPC, simulation и рендеринг
Научные расчеты зависят от FP64, bandwidth памяти и поддержки конкретного приложения. Рендеринг использует свой software stack и требования к graphics. Совместимость приложения проверяют до выбора GPU.
Из чего состоит конфигурация GPU-сервера
GPU и VRAM
Выбирают архитектуру, тип памяти, объем VRAM, bandwidth, precision, TDP, form factor и software support. Для LLM сначала считают размещение весов, KV cache, batch и служебных buffers. Методика приведена в статье как рассчитать VRAM для LLM.
CPU
CPU готовит данные, обслуживает сеть и storage, выполняет preprocessing и управляет GPU. Важны число PCIe-линий, memory channels, NUMA и производительность нужных CPU-операций. Слишком слабый CPU оставляет GPU без данных, а избыточный увеличивает стоимость без выигрыша.
Оперативная память
RAM используется для dataloader, page cache, preprocessing, индекса, контейнеров и staging данных. В качестве стартового ориентира NVIDIA для сертифицированных систем указывает объем system memory не меньше удвоенной суммарной GPU memory для training и inference, но конкретный workload может требовать другое соотношение.
PCI Express и topology
Нужно проверить поколение PCIe, ширину x16, распределение карт по root complex и близость NIC или NVMe к GPU. Путь через межсокетное соединение добавляет traffic и способен снизить throughput. Различия шин раскрыты в материале PCI Express: версии, линии и скорость.
Межсоединение GPU
PCIe подходит для независимых задач и умеренного обмена. NVLink дает высокоскоростной peer-to-peer путь на поддерживаемых платформах. NVSwitch строит коммутируемую fabric между несколькими GPU. Приложение и distributed library должны уметь использовать topology.
NVMe и СХД
Локальные NVMe хранят active dataset, cache и checkpoints. Удаленная СХД нужна для общего корпуса и нескольких узлов. Сравнивать нужно не только последовательную скорость, но IOPS, metadata operations, число параллельных readers и время восстановления.
Сеть
Для одного узла достаточно management и клиентской сети. Multi-node training и distributed inference требуют отдельной высокоскоростной fabric. Скорость выбирают по объему обмена и профилю collective operations, а не по количеству GPU само по себе.
Питание и охлаждение
Суммируют максимальное потребление компонентов, учитывают power cap, резервирование, PDU, кабели, тепловую нагрузку и допустимый входной воздух. Плотная 8-GPU система может не подходить существующей стойке даже при свободных rack units.
Конфигурации на 1, 2, 4 и 8 GPU
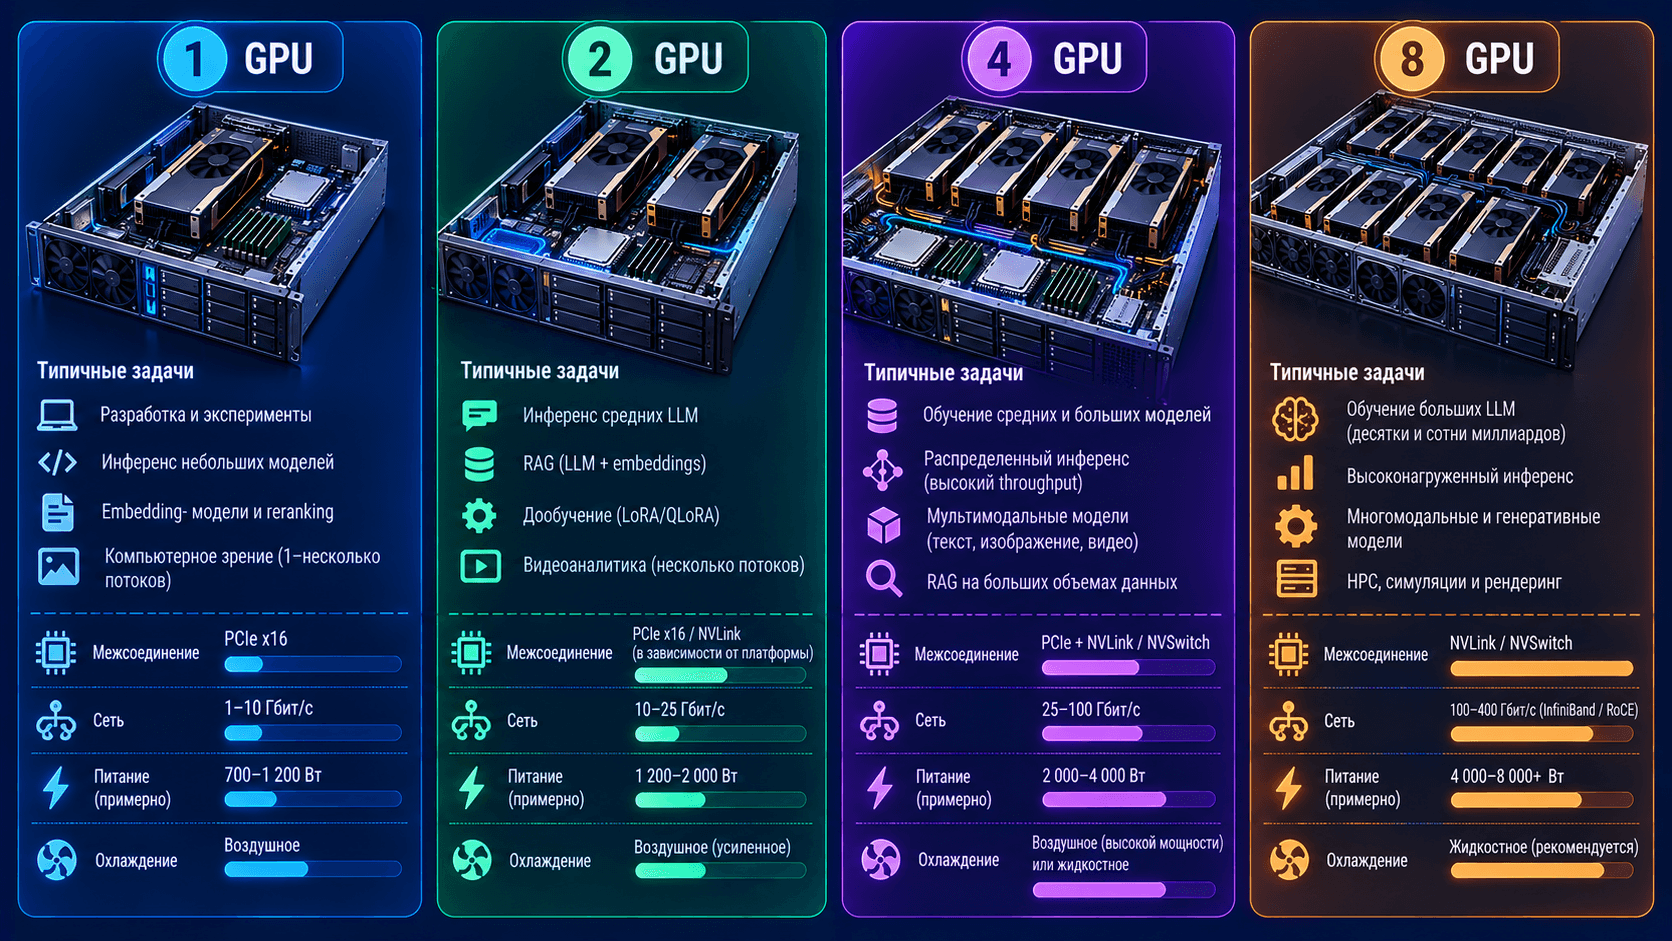
Конфигурация | Подходящие сценарии | Что проверить |
|---|---|---|
1 GPU | разработка, небольшой inference, отдельная модель | VRAM, питание, airflow, возможность расширения |
2 GPU | fine-tuning, несколько сервисов, модельный parallelism | P2P, расстояние слотов, bridge или NVLink support |
4 GPU | командный сервер, training, video analytics | баланс по CPU sockets, PCIe switches, RAM и NVMe |
8 GPU | крупное обучение, большие LLM, плотный inference | SXM или PCIe topology, NVSwitch, сеть, стойка и питание |
Более 8 GPU | multi-node cluster или специализированная rack-scale система | scale-out fabric, scheduler, storage, failure domain |
PCIe или SXM
PCIe-ускорители устанавливаются как карты расширения. Они дают гибкость, широкий выбор шасси и более простую замену. Плотность, мощность и межсоединение зависят от модели карты и сервера.
SXM-модули устанавливаются на специальную baseboard, обычно в HGX или DGX системах. Такой дизайн обеспечивает плотное размещение, высокую мощность и NVLink или NVSwitch fabric. Отдельный SXM-модуль нельзя установить в обычный PCIe slot.
Как выбрать GPU-сервер
1. Зафиксировать workload
Укажите модель и revision, training или inference, precision, input shapes, context, batch, concurrency и датасет. Формулировка «сервер для нейросетей» недостаточна.
2. Рассчитать память
Определите peak VRAM и RAM на representative run. Добавьте запас на framework, служебные buffers, fragmentation, рост context и параллельные задачи.
3. Определить SLA
Для training важны время эпохи и срок завершения эксперимента. Для inference нужны TTFT, tokens per second, p95 latency, throughput и goodput при целевой concurrency.
4. Проверить topology
Сопоставьте GPU, CPU sockets, PCIe switches, NIC и NVMe. Запросите вывод nvidia-smi topo -m или схему производителя для точной конфигурации.
5. Проверить software stack
Нужны совместимые driver, CUDA или другой runtime, framework, containers, libraries и версия приложения. Новая карта без поддержки используемого ПО может оказаться медленнее старой рабочей конфигурации.
6. Проверить площадку
Зафиксируйте rack depth, массу, питание, тип разъемов, PDU, airflow, температурный режим, шум, сеть и возможность обслуживания.
7. Провести тест
Используйте целевую модель и данные. Снимайте utilization, power, temperature, VRAM, CPU, RAM, storage throughput, network и end-to-end метрики.
Примеры классов платформ
Для компактного inference, media и нескольких небольших моделей подходит класс PCIe-систем с ускорителями наподобие NVIDIA L4 24 ГБ. Пассивная карта требует серверного airflow.
Для memory-intensive LLM и плотного multi-GPU контура примером служит Dell PowerEdge XE9680 с восемью NVIDIA H200. Это класс решения, а не автоматическая рекомендация для каждой задачи.
GPU-серверы B300 ориентированы на современные крупные AI-workloads. NVIDIA DGX B300 на восьми B300 имеет 2,3 ТБ суммарной GPU memory, но перед закупкой требуется отдельная проверка ЦОД, software stack и экономической целесообразности.
Покупка или аренда GPU-сервера
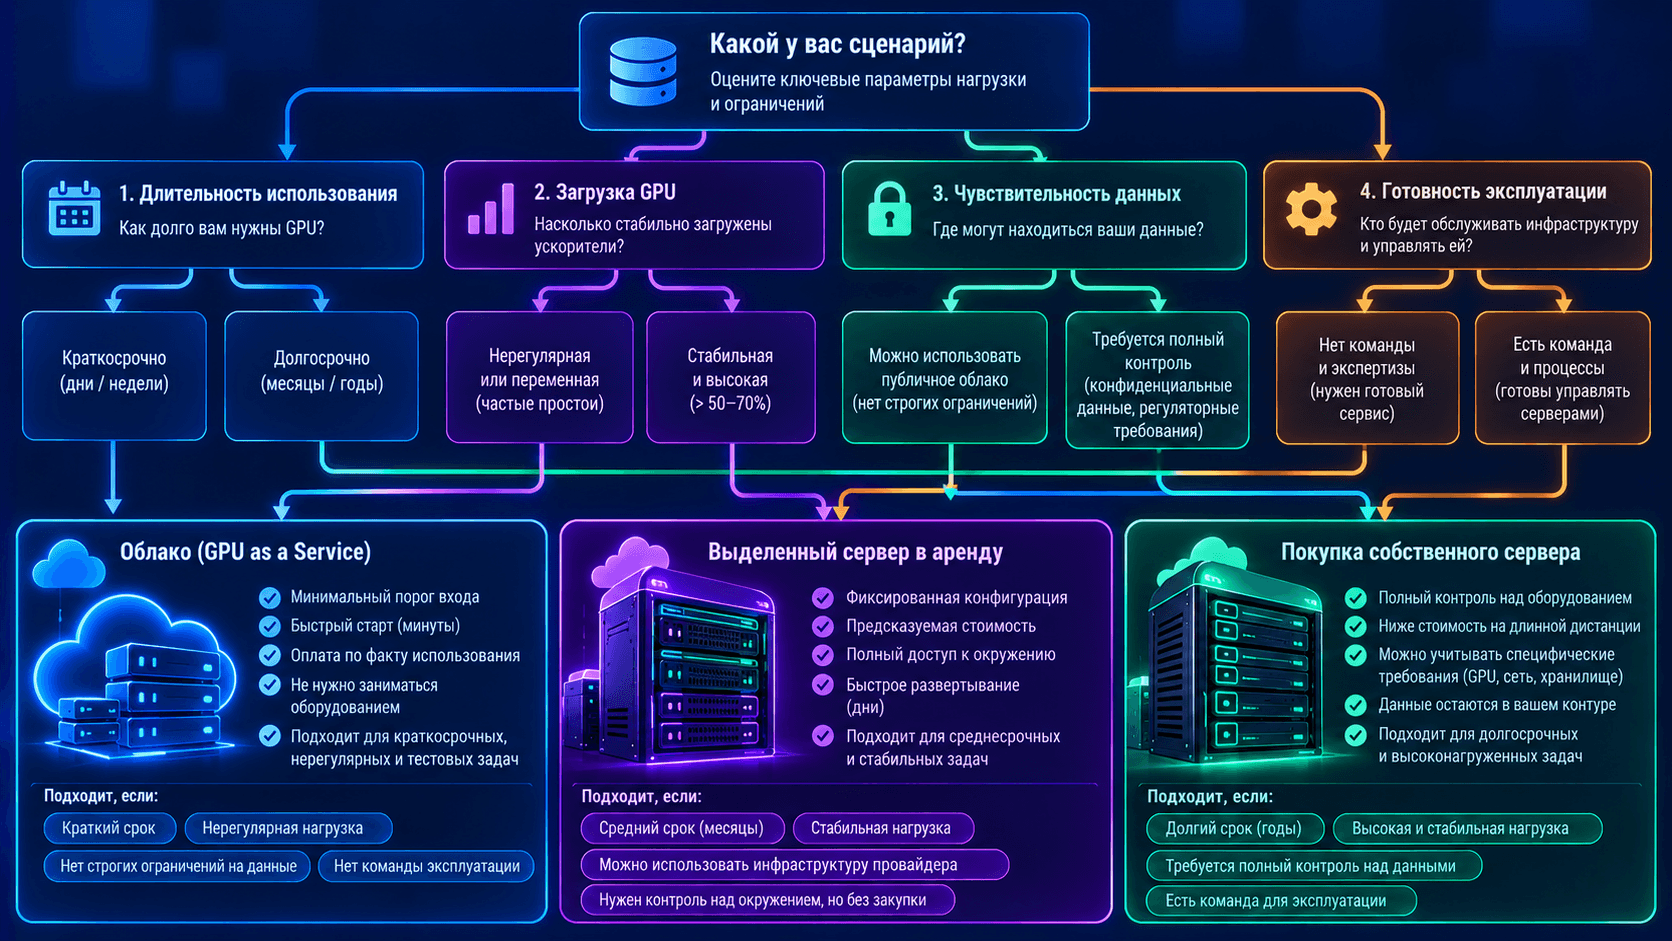
Когда оправдана покупка
нагрузка постоянная и прогнозируемая;
данные должны оставаться в контролируемом контуре;
нужен свой software stack и низкоуровневая настройка;
оборудование используется достаточно долго;
есть площадка, эксплуатация и план обновления.
Покупка фиксирует доступ к ресурсу, но требует капитальных затрат, внедрения, поддержки и учета срока поставки.
Когда подходит аренда
нужен короткий эксперимент или временный пик;
неизвестен будущий профиль нагрузки;
требуется быстро проверить несколько GPU;
команда пока не готова эксплуатировать сервер;
workload допускает размещение у провайдера.
Аренда сервера с GPU бывает почасовой, месячной, выделенной и виртуальной. Облачный сервер с GPU удобен эластичностью. Выделенный сервер дает предсказуемую физическую конфигурацию. Виртуальный сервер может использовать passthrough, vGPU или fractional allocation, поэтому нужно уточнить гарантированный ресурс.
Что проверить в аренде
Точную модель и объем памяти GPU.
Доступность P2P, NVLink и topology.
Выделенный или разделяемый accelerator.
CPU, RAM, NVMe и network limits.
Egress и стоимость хранения.
Region и правила обработки данных.
Доступные driver и containers.
SLA, maintenance и компенсации.
Возможность secure erase.
Как считается остановленный instance.
Как купить GPU-сервер без ошибки
Коммерческое предложение должно фиксировать не только модель GPU. Запросите производителя и точный part number, form factor, память, CPU, DIMM layout, NVMe, NIC, topology, блоки питания, rails, кабели, firmware, software licenses, гарантию и условия пусконаладки.
Полезная последовательность:
Подготовить workload-профиль и SLA.
Составить единое ТЗ для всех поставщиков.
Получить topology и power specification.
Сравнить предложения построчно.
Проверить площадку.
Согласовать программу приемки.
Провести burn-in и тест целевой нагрузки.
Зафиксировать baseline для эксплуатации.
Готовый шаблон вопросов находится в статье как составить ТЗ на GPU-сервер.
Типичные ошибки
Выбирать сервер по названию GPU без теста модели.
Считать суммарную VRAM единым автоматически доступным пулом.
Игнорировать topology между GPU.
Недооценивать CPU, RAM и dataloader.
Устанавливать пассивные карты в неподходящее шасси.
Не проверять power cap и охлаждение.
Считать peak FLOPS прогнозом application performance.
Покупать восемь GPU для задачи, которая не масштабируется.
Сравнивать аренду и покупку без egress, storage и эксплуатации.
Не фиксировать точную конфигурацию в договоре.
Не проводить приемочный нагрузочный тест.
Не планировать мониторинг и запасные части.
FAQ
Что такое GPU-сервер?
Это сервер, рассчитанный на работу одного или нескольких вычислительных GPU с необходимыми PCIe-линиями, питанием, охлаждением, управлением и программным стеком.
Чем GPU-сервер отличается от обычного сервера?
Он имеет специальное шасси, airflow, питание, topology и часто межсоединение для ускорителей высокой мощности. Обычный сервер может физически не поддерживать нужные карты.
Для каких задач нужен GPU-сервер для ИИ?
Для обучения и инференса нейросетей, LLM, RAG, компьютерного зрения, речи, генерации, рекомендаций и части HPC-задач.
Сколько GPU нужно серверу?
Число определяется памятью модели, parallelism, сроком обучения, throughput и масштабированием на тесте. Подробнее это разобрано в материале сколько GPU нужно для LLM.
Можно ли объединить память нескольких GPU?
Не автоматически. Приложение должно разделять модель или данные между устройствами. Interconnect ускоряет обмен, но не превращает VRAM в универсальный общий массив для любого ПО.
Что лучше, GPU-сервер купить или арендовать?
Покупка подходит для постоянной контролируемой нагрузки. Аренда удобна для пилота, пика и неопределенного спроса. Сравнивают полный TCO и риски, а не только месячный платеж.
Чем облачный GPU-сервер отличается от выделенного?
Облачный instance обычно быстро создается и тарифицируется по времени. Выделенный сервер закрепляет физический узел. В обоих случаях нужно проверить, делится ли GPU и какие topology или network доступны.
Подходит ли H100 GPU-сервер для любой нейросети?
Нет. H100 полезен для требовательных AI и HPC workloads, но может быть избыточным для компактного inference. Выбор подтверждают по памяти, производительности и стоимости результата.
Когда выбирать GPU-сервер B300?
Когда крупная современная модель, большой context или плотный training и inference используют его память и вычисления, а площадка готова к требованиям системы. Для малой задачи B300 может быть экономически неоправдан.
Как проверить GPU-сервер при приемке?
Сверить комплектность и topology, обновить согласованные firmware и driver, провести health checks, burn-in и тест целевой модели с записью температур, ошибок и производительности.
Что передать для расчета
Укажите модель и revision, режим training или inference, precision, peak VRAM, размер входа и выхода, batch, concurrency, данные, целевой SLA, число пользователей, требования к безопасности и параметры площадки. Start Server поможет сопоставить задачу с платформой, провести проверку спецификации и подготовить приемочные испытания. Передать вводные можно через контакты Start Server.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


