У H100 SXM — 80 GB памяти. У H200 SXM — 141 GB. Если сервер нужен для большой языковой модели с длинным контекстом, выбор будто бы очевиден: больше VRAM — значит H200.
Но для нормального sizing этого ответа мало.
H100 и H200 относятся к одной архитектуре NVIDIA Hopper. В рассматриваемых SXM-исполнениях NVIDIA указывает одинаковую пиковую Tensor Core производительность в BF16 и FP8. Главное аппаратное отличие H200 — более ёмкая и более быстрая память: 141 GB HBM3e с пропускной способностью 4,8 TB/s против 80 GB HBM3 и 3,35 TB/s у H100.
Поэтому при выборе для LLM полезнее спрашивать не:
Какая GPU мощнее, а:
Во что упирается наша модель — в вычисления или в память?
Если веса, KV-cache и рабочий запас нормально помещаются в H100, переход на H200 ещё нужно обосновать. Но когда модель уже занимает значительную часть 80 GB, дополнительные 61 GB начинают влиять на допустимый контекст, параллельность запросов, batch size и иногда даже на необходимое количество GPU.
Вот здесь разница становится действительно интересной.
H100 или H200: короткий ответ
Ситуация | Что логично рассматривать |
Модель и KV-cache имеют хороший запас в 80 GB | H100 остаётся полноценным вариантом |
Веса модели подходят близко к пределу H100 | H200 становится значительно интереснее |
Нужен длинный контекст и высокая параллельность | Преимущество 141 GB заметно растёт |
Batch или concurrency приходится уменьшать из-за VRAM | H200 может снять ограничение |
Нужно несколько GPU только ради capacity | Проверить, позволит ли H200 изменить размещение модели |
Workload ограничен пропускной способностью HBM | У H200 есть преимущество |
Памяти хватает, ограничение именно вычислительное | Дополнительные 61 GB сами проблему не решат |
H100 уже обеспечивает требуемый SLA | H200 не нужна просто потому, что новее |
То есть универсального правила «для long context всегда H200» нет.
H100 SXM и H200 SXM: что изменилось на самом деле
В расчётах ниже мы сравниваем именно H100 SXM 80 GB и H200 SXM 141 GB. H100 NVL и H200 NVL — отдельные исполнения с другими характеристиками.
Параметр | H100 SXM | H200 SXM |
Архитектура | Hopper | Hopper |
GPU memory | 80 GB HBM3 | 141 GB HBM3e |
Memory bandwidth | 3,35 TB/s | 4,8 TB/s |
BF16 Tensor Core* | 1 979 TFLOPS | 1 979 TFLOPS |
FP8 Tensor Core* | 3 958 TFLOPS | 3 958 TFLOPS |
NVLink | 900 GB/s | 900 GB/s |
Max TDP | до 700 W | до 700 W |
* показатели NVIDIA с sparsity.
По объёму памяти прирост составляет примерно:
141 / 80 ≈ 1,76
то есть около 76%.
По пропускной способности:
4,8 / 3,35 ≈ 1,43
то есть около 43%.
Но у H200 не появилось в 1,76 раза больше заявленного BF16/FP8 compute.
Именно поэтому сравнение этих GPU особенно хорошо показывает разницу между memory bottleneck и compute bottleneck.
Почему 141 GB не означают просто на 76% больше контекста
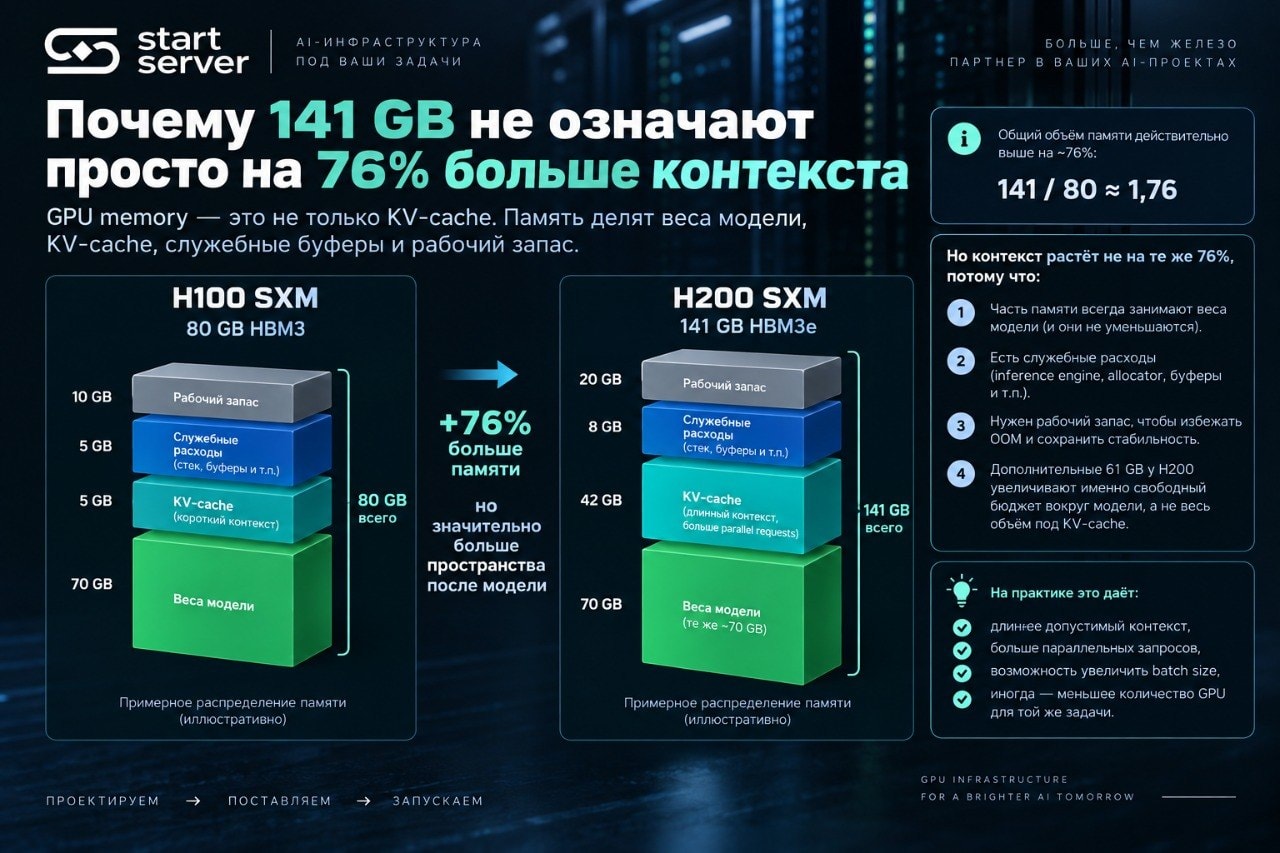
GPU memory во время инференса занята не только KV-cache.
Сильно упрощённо бюджет можно представить так:
веса модели + KV-cache + runtime/buffers + рабочий запас.
И это меняет смысл сравнения 80 и 141 GB.
Представим чисто иллюстративную ситуацию: весовая часть занимает около 70 GB.
Если ради объяснения принципа временно игнорировать служебные расходы и разницу GB/GiB, у H100 остаётся около 10 условных GB до её номинальной ёмкости.
У H200 — около 71.
Общий объём памяти увеличился примерно на 76%.
А арифметическое пространство после одной и той же модели — больше чем в семь раз.
Это не значит, что в реальном запуске будет ровно 10 и 71 GB свободной VRAM. Не будет: память потребуется inference engine, allocator, буферам и другим структурам.
Но сам эффект важен.
Модель на H200 не становится меньше. Дополнительные 61 GB практически целиком увеличивают бюджет вокруг неё.
Именно оттуда берётся место для большего KV-cache и более высокой параллельности.
Что длинный контекст делает с VRAM
При autoregressive inference модель снова и снова работает с предыдущими токенами последовательности.
Чтобы не пересчитывать всю attention-историю на каждом новом токене, inference engine сохраняет Key и Value для уже обработанных позиций в KV-cache.
Чем больше активных токенов, тем больше памяти требуется cache.
Поэтому заявленный в model card контекст, например 128K, ещё ничего не говорит о необходимом сервере.
Есть большая разница между:
одним запросом на 128K и восемью одновременно активными запросами на 128K.
Лучше всего это видно на конкретной модели.
Пример: Llama 3.1 70B
У Llama 3.1 70B Meta указывает контекст до 128K и Grouped-Query Attention. Архитектурные параметры модели включают 80 слоёв, hidden dimension 8192, 64 attention heads и 8 KV-heads.
Размер одной attention head:
8192 / 64 = 128
Получаем:
Параметр | Llama 3.1 70B |
Hidden dimension | 8192 |
Layers | 80 |
Attention heads | 64 |
KV heads | 8 |
Head dimension | 128 |
Context | до 128K |
Attention | GQA |
Теперь можно посчитать базовую ёмкость KV-cache без чужих готовых таблиц.
Сколько KV-cache приходится на один токен
Для обычного K/V-хранения:
2 × layers × KV heads × head dimension × bytes per element
Двойка — это отдельно Key и Value.
При BF16, то есть двух байтах на элемент:
2 × 80 × 8 × 128 × 2 = 327 680 bytes
Это:
320 KiB на один токен.
Теперь становится возможно нормально посчитать контекст.
8K, 32K и 128K: сколько занимает KV-cache
Для таблицы ниже под 8K, 32K и 128K подразумеваются соответственно 8192, 32 768 и 131 072 токена.
Llama 3.1 70B, BF16 KV-cache
Рабочий контекст | 1 активная sequence | 4 одновременно | 8 одновременно |
8K | ~2,5 GiB | ~10 GiB | ~20 GiB |
32K | ~10 GiB | ~40 GiB | ~80 GiB |
128K | ~40 GiB | ~160 GiB | ~320 GiB |
Здесь появляется очень практичный вывод.
Фраза:
Нам нужен контекст 32K.
недостаточна для подбора GPU.
Для одной активной последовательности расчётный BF16 KV-cache Llama 3.1 70B составляет около 10 GiB.
Для восьми одновременно активных последовательностей той же длины — около 80 GiB.
И это только KV-cache. Веса модели сюда ещё не входят.
Поэтому context length всегда нужно рассматривать вместе с concurrency.
Один 128K или четыре 32K?
Есть простой способ думать о capacity.
Для одной модели и одного dtype память KV-cache в первом приближении зависит от общего числа токенов, которые необходимо держать активными.
Например:
1 × 128K = 128K и: 4 × 32K = 128K.
Для нашей Llama 3.1 70B базовая оценка BF16 KV-cache в обоих случаях получается примерно одинаковой — около 40 GiB.
Конечно, production-система сложнее этой арифметики. Запросы имеют разную длину, scheduler динамически размещает последовательности, используется prefix caching и другие оптимизации.
Но для первичного sizing это гораздо полезнее, чем смотреть только на максимальное значение context window в карточке модели.
Нужно знать context × concurrency.
Что меняет FP8 KV-cache
KV-cache не обязан использовать тот же dtype, что и веса.
Например, vLLM позволяет отдельно задавать cache_dtype и поддерживает FP8 KV-cache на совместимом оборудовании.
Если в базовом расчёте перейти с двух байт на элемент к одному, объём cache примерно уменьшается вдвое.
Для того же примера:
Контекст, 1 sequence | BF16 KV-cache | FP8 KV-cache, базовая оценка |
8K | ~2,5 GiB | ~1,25 GiB |
32K | ~10 GiB | ~5 GiB |
128K | ~40 GiB | ~20 GiB |
Но здесь важно не смешивать две вещи:
FP8-веса и FP8 KV-cache — это разные параметры конфигурации.
Можно хранить веса в одном формате, а cache — в другом. И сокращение объёма cache ещё нужно проверить с точки зрения точности и производительности конкретного workload.
Поэтому таблица показывает capacity, а не обещает результат готового сервиса.
Почему 141 GB H200 всё равно мало для простого вывода «70B BF16 помещается»
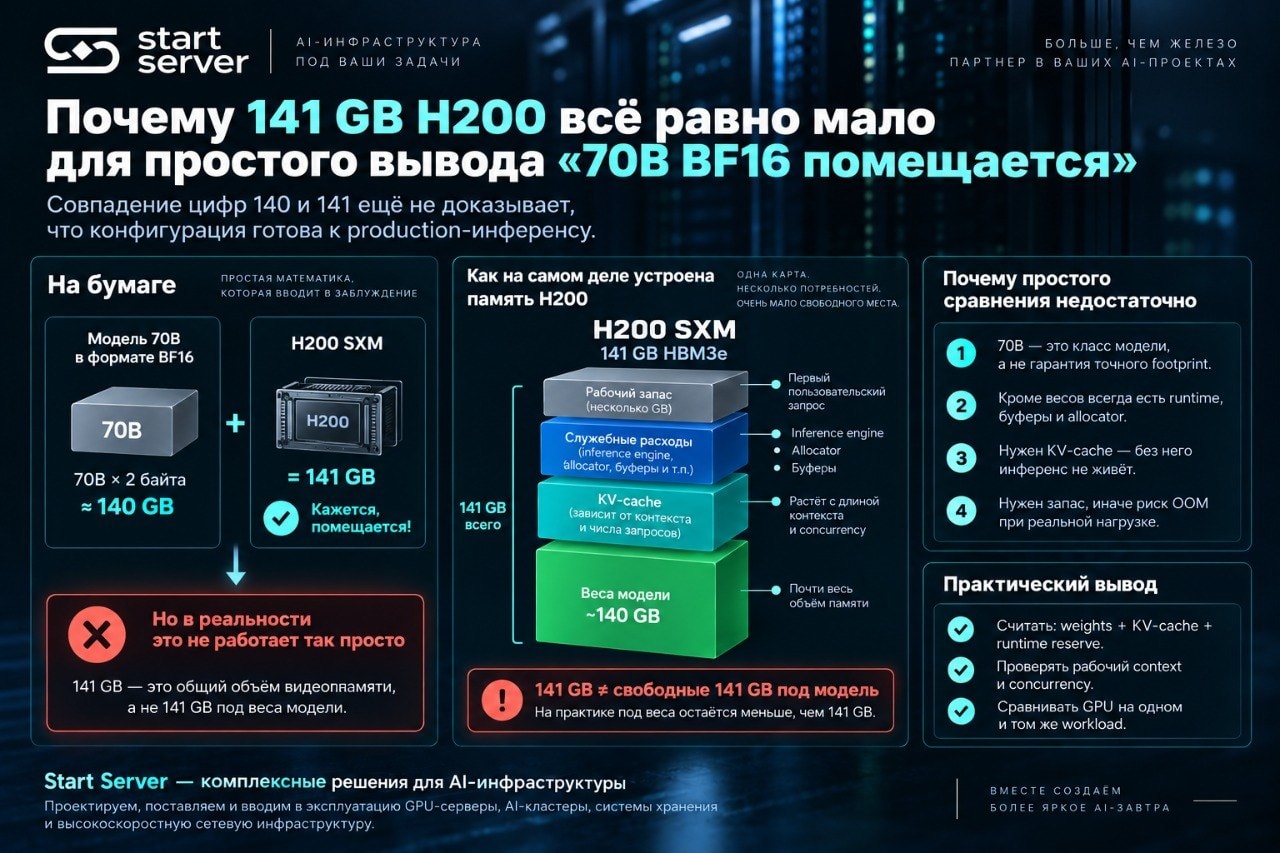
Для 70B-класса можно сделать быстрый weight-only расчёт:
70 млрд × 2 байта ≈ 140 млрд байт.
На соседней строке спецификации H200 написано 141 GB.
На бумаге выглядит красиво.
Но готовая production-конфигурация так не проектируется.
Во-первых, «70B» — класс модели, а не гарантированно ровно 70 миллиардов параметров.
Во-вторых, кроме самих значений весов присутствуют другие расходы runtime.
И, главное, нужно ещё куда-то разместить KV-cache.
Мы только что посчитали, что для конкретной Llama 3.1 70B один 32K BF16 cache — это около 10 GiB.
Поэтому правило простое:
если весовая часть практически заполняет GPU до появления первого пользовательского запроса, одного совпадения цифр «140 и 141» недостаточно.
Сумма VRAM сама по себе не доказывает работоспособность конфигурации — именно этот принцип предусмотрен и первоначальным редакционным регламентом Start Server.
А вот с 8-битными весами ситуация меняется
Для предварительного sizing 70B-класса можно взять идеализированную оценку:
70 млрд × 1 байт ≈ 70 GB.
Это всё ещё не точный memory footprint конкретного checkpoint.
Но разница между GPU уже видна.
На H100 80 GB весовая часть подходит очень близко к номинальной ёмкости. Большой KV-cache рядом с ней разместить трудно.
На H200 после той же весовой части появляется принципиально больший memory budget.
И вот здесь 61 дополнительный GB начинает работать не на «модель побольше», а на реальную эксплуатацию той же самой модели:
длиннее рабочий context;
больше одновременно активных sequences;
больше batch;
больше запас до OOM;
иной способ распределения модели между GPU.
Это намного важнее простой таблицы характеристик.
Порог памяти: когда H100 и H200 начинают вести себя совершенно по-разному
Пока модель занимает небольшую часть H100, обе GPU могут иметь достаточный запас.
Допустим, выбранный workload использует 25–30 GB вместе с основными расходами. В таком случае ещё 61 GB H200 могут быть полезны для роста нагрузки, но архитектура сервиса необязательно изменится сегодня.
А теперь модель подходит вплотную к 80 GB.
На H100 каждый дополнительный гигабайт KV-cache уже приходится экономить: уменьшать контекст, снижать concurrency или переходить к нескольким GPU.
На H200 появляется ещё десятки гигабайт.
Получается своего рода порог памяти.
До него обе GPU позволяют построить систему примерно одинаковым способом.
После него H100 начинает диктовать компромиссы, которых на H200 может не быть.
Именно поэтому один процент вроде «H200 имеет на 76% больше памяти» плохо описывает практическую разницу.
Как понять, что ограничивает вашу LLM
Это главный decision block статьи.
Что происходит | Вероятное ограничение | Что может изменить H200 |
Модель не помещается на H100 | Memory capacity | +61 GB могут изменить число GPU |
Веса помещаются, KV-cache — уже нет | Memory capacity | больше места под context/concurrency |
Нужно уменьшать длину контекста | Memory capacity | часто помогает |
Приходится ограничивать число активных запросов | Memory capacity | часто помогает |
Batch упирается в VRAM | Memory capacity | можно рассматривать больший batch |
Workload чувствителен к HBM bandwidth | Memory bandwidth | 4,8 против 3,35 TB/s |
Памяти достаточно, bottleneck находится в compute | Compute | больший VRAM сам по себе не решает проблему |
H100 уже выполняет SLA с запасом | явного bottleneck нет | H200 нужно подтверждать benchmark и экономикой |
Это важное различие.
У H200 нет более высокого заявленного FP8/BF16 Tensor Core peak в рассматриваемом SXM-сравнении. Поэтому нельзя вывести реальное ускорение просто из разницы VRAM.
Почему NVIDIA показывает до 1,9× throughput
NVIDIA указывает для H200 до 1,9× throughput относительно H100 в тесте Llama 2 70B. Если посмотреть только на эту цифру, легко сделать вывод, что H200 почти вдвое мощнее.
Но у теста есть важные условия.
Для Llama 2 70B NVIDIA указывает:
1 × H100 SXM против 1 × H200 SXM;
input sequence length — 2K;
output sequence length — 128;
batch size H100 — 8;
batch size H200 — 32.
И это намного интереснее самого «1,9×».
H200 не получила вдвое более высокий FP8 Tensor Core peak.
Зато более крупная память позволила использовать существенно больший batch.
То есть memory capacity помогла лучше использовать имеющийся compute.
Поэтому корректная формулировка выглядит так:
NVIDIA получила до 1,9× throughput H200 против H100 в конкретном Llama 2 70B тесте, где H200 работала с batch 32 против batch 8 у H100.
А не:
H200 всегда в 1,9 раза быстрее.
При другой модели, context, batch или inference engine результат изменится.
Когда H100 остаётся нормальным выбором
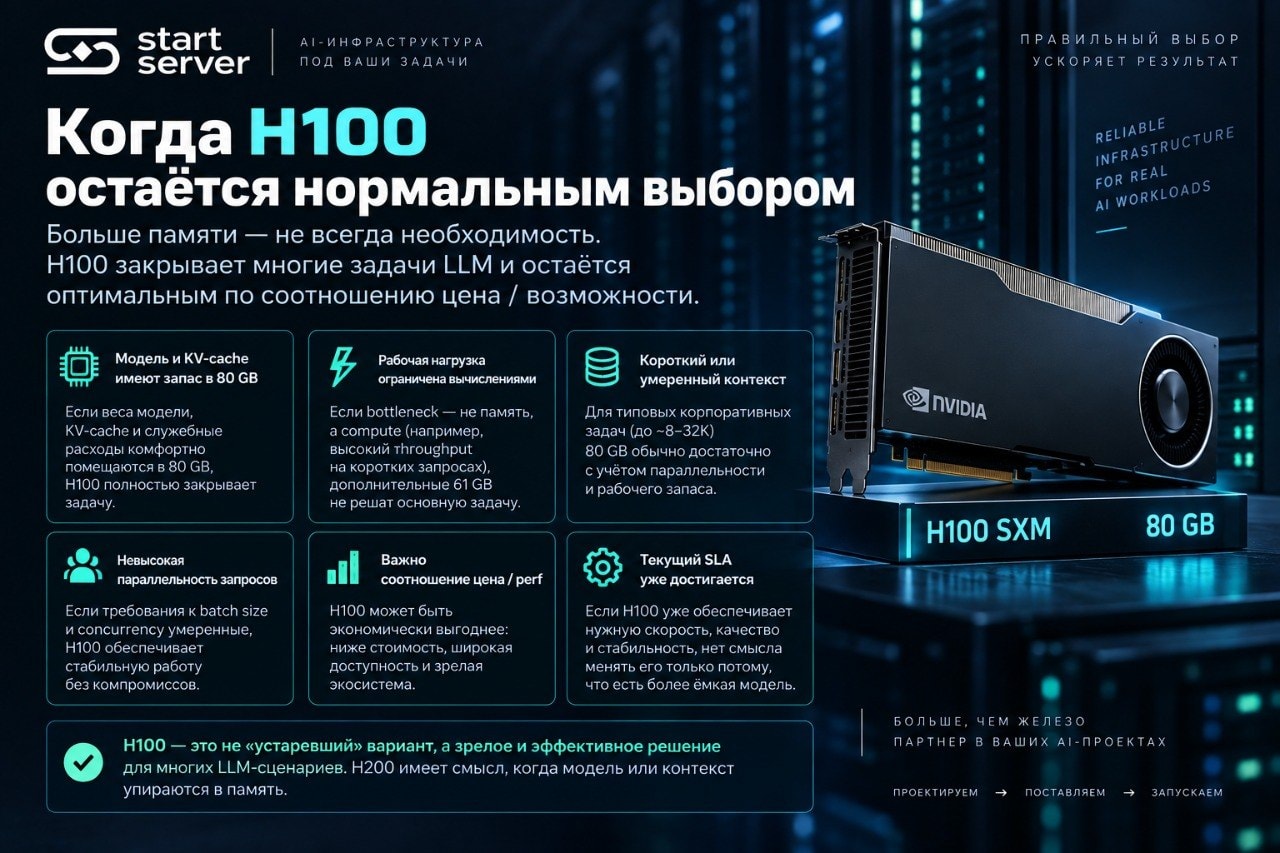
Большая память H200 действительно полезна для long-context workloads. Но отсюда не следует, что H100 нужно автоматически исключать.
Если модель вместе с рабочим KV-cache имеет хороший запас в 80 GB, H100 может полностью закрывать задачу.
Предположим:
рабочий контекст невелик;
параллельных запросов немного;
модель не подходит близко к пределу памяти;
нужные latency и throughput уже достигаются.
В этой ситуации H200 даёт больше headroom и bandwidth, но пока не обязательно снимает реальное ограничение.
Особенно это важно для уже существующей инфраструктуры H100.
Сначала стоит сформулировать проблему:
Не хватает памяти на 32K при восьми активных запросах.
Это проблема.
Появилась H200.
Это ещё не проблема и не основание для замены.
Когда H200 действительно меняет архитектуру
Самый понятный сценарий — memory pressure.
Например, H100 заставляет:
уменьшать context;
снижать concurrency;
использовать более агрессивное квантование;
добавлять GPU только ради capacity;
уменьшать batch.
В таком случае H200 может изменить сам способ размещения workload.
Особенно интересен вариант, когда H100 требует несколько GPU только потому, что одной 80 GB карты недостаточно, а на 141 GB выбранная конфигурация уже имеет рабочий запас.
Тогда потенциально меняются:
число GPU на модель;
схема tensor parallelism;
объём меж-GPU коммуникации;
плотность экземпляров сервиса на сервере.
Но из этого нельзя сразу сделать вывод «H200 дешевле».
Для этого уже нужно сравнивать готовые серверные конфигурации под одинаковый SLA.
Технический sizing отвечает на вопрос «что возможно».
Коммерческий расчёт — «что выгоднее».
Как выбирать H100 или H200 на практике
Для решения нужны не двадцать характеристик GPU.
Нужно четыре входных параметра.
1. Точный model ID или checkpoint.
Не просто «70B». Нужна конкретная архитектура.
2. Precision или quantization.
От неё напрямую зависит память весов.
3. Реальный рабочий context.
Не обязательно максимальные 128K из model card. Если пользователи обычно работают на 8–16K, проектировать весь сервис только под теоретический максимум может быть неразумно.
4. Concurrency.
Сколько последовательностей сервер должен держать активными одновременно.
После этого уже можно идти дальше:
model → weights → KV-cache → runtime reserve → количество GPU → benchmark → сервер.
Если после этого H100 имеет хороший запас — у неё есть техническое обоснование.
Если всё решение приходится подстраивать под потолок 80 GB — появляется конкретное обоснование H200.
Такой выбор гораздо надёжнее сравнения двух datasheet.
Итог: H100 или H200 для длинного контекста
Для long-context LLM H200 получает сильное преимущество там, где система действительно ограничена памятью.
У неё 141 GB HBM3e против 80 GB HBM3 у H100 и 4,8 против 3,35 TB/s memory bandwidth. При этом рассматриваемые SXM-версии относятся к Hopper и имеют одинаковые заявленные пиковые BF16/FP8 Tensor Core показатели.
Поэтому правильный вопрос выглядит так:
Сколько памяти останется после размещения нашей модели и сколько активных токенов нужно обслуживать одновременно?
Если H100 имеет хороший запас и уже выполняет требуемый SLA, H200 не становится обязательной автоматически.
Если же 80 GB заставляют урезать context, concurrency или batch либо добавлять GPU только ради memory capacity, дополнительные 61 GB H200 могут изменить серверную конфигурацию очень существенно.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


