Локального AI-агента нельзя корректно рассчитать как один запрос к LLM.
Пользователь отправляет одну бизнес-задачу, но внутри неё агент может несколько раз обратиться к модели, вызвать инструменты, выполнить поиск, запустить код, обработать ошибку и снова вернуться к LLM.
Поэтому две системы на одной и той же модели могут создавать совершенно разную нагрузку на инфраструктуру.
Практическая цепочка sizing выглядит так:
Главный вопрос не:
Сколько GPU нужно одному AI-агенту?
А:
Сколько вычислительных операций создаёт одна успешно завершённая задача и как эти операции накладываются друг на друга при production-нагрузке?
Почему AI-агента нельзя считать как один prompt
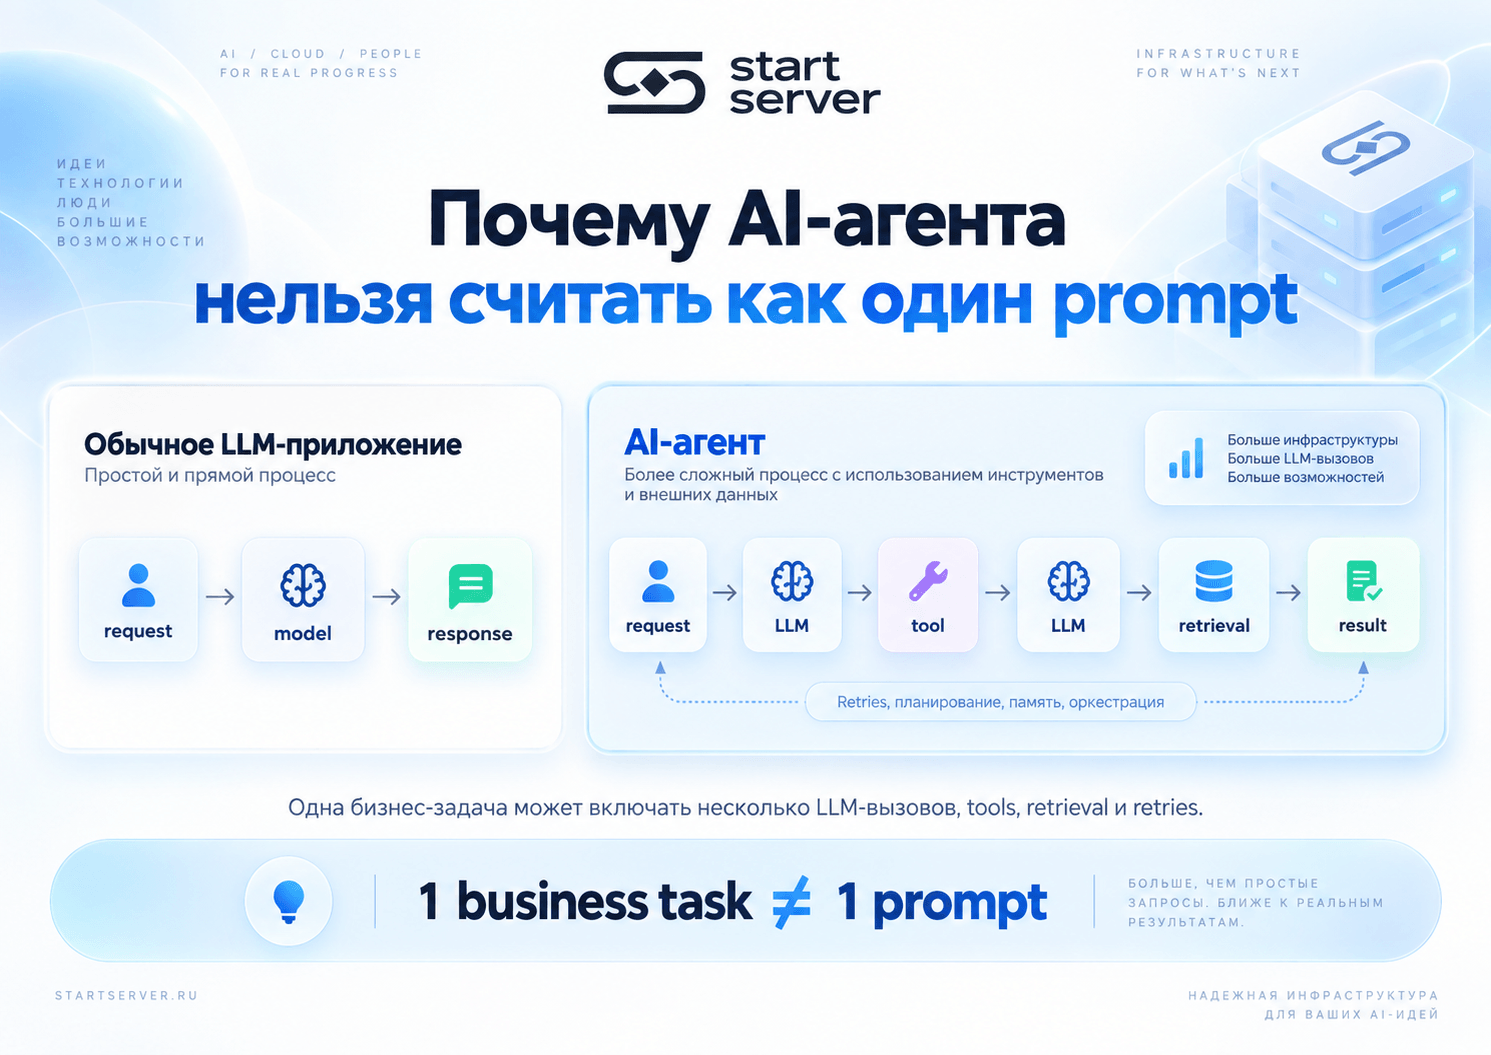
Для простого LLM-приложения схема может выглядеть так:
request → model → response.
У agentic-приложения она часто сложнее:
request → LLM → tool → LLM → retrieval → LLM → action → result.
Количество таких шагов заранее не обязательно фиксировано. Оно может зависеть от:
сложности задачи;
результата предыдущего tool call;
ошибки внешней системы;
retry logic;
completion condition;
поведения модели.
Поэтому первое правило infrastructure sizing:
Главная единица sizing — завершённая business task
Сначала нужно определить границу задачи.
Например:
обработать заявку клиента;
проанализировать договор;
провести исследование;
исправить issue;
подготовить документ;
выполнить последовательность действий в корпоративных системах.
Task начинается, когда приложение принимает бизнес-запрос, и заканчивается, когда результат считается готовым по правилам сервиса.
Это важнее абстрактного количества prompts.
Одна задача может потребовать два обращения к модели, другая — значительно больше. Поэтому верхнеуровневые показатели production-сервиса полезнее связывать с:
successful tasks/hour;
p50/p95 task latency;
success rate.
А model calls и tokens рассматривать как составляющие каждой task.
Сначала снимите representative trace
Прежде чем выбирать CPU или GPU, нужно понять, что реально происходит внутри задачи.
В статье под agent trajectory мы будем понимать полный trace одной business task — от входного запроса до готового результата, включая LLM-вызовы и non-model stages.
В trace могут входить:
model calls;
tool calls;
retrieval;
sandbox или code execution;
sub-agent calls;
retries;
ожидание внешних сервисов;
итоговый результат.
Именно такой trace превращает абстрактного «AI-агента» в измеримый workload.
Agent Trace Card
Для representative task полезно сохранять:
Параметр | Значение |
Task class | |
Agent framework/version | |
Model | |
Inference engine/version | |
LLM calls/task | |
Input tokens/task | |
Output tokens/task | |
Peak model input context | |
Tool calls/task | |
Retrieval calls/task | |
Sandbox runs/task | |
Sub-agent calls | |
Retries | |
End-to-end task latency | |
Success / failure |
Сколько LLM-вызовов приходится на задачу
Одна из ключевых agentic-метрик:
LLM calls/task.
Не существует универсального:
каждый агент делает N вызовов модели.
Даже один и тот же workflow может иметь разную глубину loop на разных задачах.
Поэтому лучше хранить:
mean calls/task;
p50 calls/task;
p95 calls/task.
Если большинство задач завершается быстро, а небольшая часть уходит в длинные loops, одно среднее значение скроет tail-нагрузку.
А именно tail может создавать неожиданные пики model-call traffic.
Считать нужно tokens/task, а не только tokens/request
Для каждого model call обычно можно получить:
input tokens;
output tokens.
Для полной задачи полезны агрегаты:
Input tokens/task = сумма input tokens всех model calls
Output tokens/task = сумма output tokens всех model calls
Но желательно также хранить token usage по отдельным rounds:
Round | Input tokens | Output tokens | Следующий шаг |
1 | Tool | ||
2 | Retrieval | ||
3 | Tool | ||
4 | Final |
Context может накапливаться между rounds
Следующий model call может получить:
исходный запрос;
предыдущие model messages;
tool results;
retrieval context;
промежуточное состояние.
Из-за этого model input нередко увеличивается по мере выполнения задачи.
Но это не универсальное правило.
Конкретный framework или application может:
сокращать history;
summarise старые сообщения;
перестраивать context на каждой итерации;
хранить часть state вне prompt.
Поэтому для sizing нужно измерять фактическую динамику конкретного workflow.
Полезные показатели:
p50 input tokens/model call;
p95 input tokens/model call;
peak representative input tokens/model call.
Максимальное context window модели — не workload
Фраза:
модель поддерживает 128K context
описывает capability модели.
Она не означает:
production-agent использует 128K при каждой задаче.
Для sizing важен фактический context distribution из traces.
Это влияет на:
prefill;
latency;
KV-cache;
VRAM;
concurrency.
Почему KV-cache становится частью agent sizing
Несколько одновременно активных trajectories могут поддерживать разные model contexts.
При этом часть prefixes между последовательными model calls может повторяться и переиспользоваться inference engine.
Следовательно, на производительность могут влиять:
длина context;
число active sequences;
prefix caching;
KV-cache policy;
memory pressure.
Это не значит, что для AI-агента существует универсальная формула дополнительной VRAM.
Практический вывод другой:
при benchmark нужно фиксировать фактический context и cache configuration выбранного inference engine.
Tokens/task не равны фактически заново вычисленному prefill
Даже если telemetry показывает одинаковый объём input tokens, inference engine может по-разному обрабатывать их в зависимости от cache state.
При prefix reuse часть уже обработанного контекста может не требовать полного повторного prefill.
Поэтому:
tokens/hour — полезная метрика объёма workload.
Но не:
точная мера GPU compute.
Почему публичный tokens/s не предсказывает скорость агента
Публичный inference benchmark может быть получен на:
другом context;
другой output length;
другой concurrency;
независимых requests;
другой cache configuration.
Agentic workflow состоит из зависимых rounds с собственным timing.
Поэтому:
Она важна для model server, но не является конечной бизнес-метрикой.
Tool calls создают отдельную нагрузку
После ответа модели агент может выполнять:
HTTP/API request;
database operation;
search;
filesystem action;
MCP tool;
browser automation;
shell;
code execution;
вызов другого agent.
Это означает, что полная task не является чистым GPU workload.
Каждый существенный tool желательно описывать минимум через:
count/task;
latency;
resource class.
Tool latency и CPU load — не одно и то же
Допустим, внешний API отвечает пять секунд.
Это не означает:
локальный CPU пять секунд занят вычислениями.
Tool может большую часть времени ждать:
сеть;
database;
внешний backend;
удалённую систему.
Поэтому необходимо различать:
wall-clock latency
и:
local compute demand.
Это особенно важно при sizing CPU.
Retrieval также считается отдельно
Если agent выполняет retrieval, полезно знать:
retrieval calls/task;
latency;
объём возвращённого context;
используемый resource pool.
Retrieval может задействовать:
CPU;
RAM;
storage;
vector database;
embedding model.
Кроме того, большой retrieval result способен увеличить следующий model input.
Получается цепочка:
Но sizing agent infrastructure не требует превращать эту статью в отдельное руководство по RAG.
Retrieval здесь — один компонент полной trajectory.
Sandbox и code execution — ещё один resource pool
Если agent запускает код или shell-команды, нагрузка выходит за пределы inference backend.
Sandbox может требовать:
CPU;
RAM;
storage;
отдельные workers;
ограничения concurrency.
Для одного application это может быть небольшой компонент.
Для другого именно sandbox окажется главным bottleneck.
Поэтому hardware requirement определяется trace, а не самим фактом использования AI-агента.
Active task не означает активный model call
Представим условную trajectory:
LLM — 2 секунды
→ tool/API — 8 секунд
→ LLM — 3 секунды
→ sandbox — 5 секунд
→ LLM — 2 секунды
Полная task занимает 20 секунд.
Но model server обслуживает её только на отдельных участках timeline.
Между ними inference capacity может работать с другими задачами.
Поэтому:
Это одно из главных отличий agentic capacity planning.
Нужно различать несколько видов concurrency
Active task concurrency
Сколько business tasks ещё не завершено.
Model-call concurrency
Сколько inference requests одновременно находятся в model-serving layer.
Tool concurrency
Сколько tool executions активно.
Sandbox concurrency
Сколько isolated workloads выполняется.
Эти показатели нельзя выводить один из другого.
Например:
100 active tasks
не означают:
100 одновременно выполняющихся model calls.
Часть задач может в этот момент ждать внешние systems или выполнять non-model stages.
Число сотрудников тоже не определяет GPU
Формулировка:
системой пользуются 500 сотрудников
недостаточна для sizing.
Пятьсот пользователей могут создавать:
несколько десятков задач в час;
тысячи задач в час;
один сильный утренний burst;
равномерный поток весь день.
Поэтому нужны:
tasks/hour;
peak task starts;
active tasks;
model-call arrivals;
model-call concurrency.
Как перейти от tasks/hour к model calls/hour
Для одного task class:
Model calls/hour = Tasks/hour × Mean LLM calls/task
Допустим, сервис получает:
100 tasks/hour
и representative traces показывают в среднем:
4 model calls/task.
Тогда средний объём:
400 model calls/hour.
Это только пример расчёта, а не норматив для AI-агентов.
Для нескольких task classes:
Model calls/hour = Σ(Tasks/hourᵢ × Mean calls/taskᵢ)
Эта формула переводит business workload в первый model-serving volume estimate.
Как считать token volume
Аналогично:
Input tokens/hour = Σ Tasks/hourᵢ × Mean input tokens/taskᵢ
Output tokens/hour = Σ Tasks/hourᵢ × Mean output tokens/taskᵢ
Это полезно для сравнения workload classes и оценки среднего объёма model traffic.
Но tokens/hour не определяют число GPU напрямую.
Дополнительно важны:
context distribution;
concurrency;
batching;
inference engine;
KV-cache;
latency SLA.
Service volume inference pool
Можно получить ещё один ориентир:
Он показывает суммарный объём model-call service time для выбранного workload.
Но здесь есть важное ограничение.
Современный inference server может обслуживать несколько sequences совместно с помощью batching и других scheduling mechanisms. Поэтому сумму wall-clock model-call durations нельзя напрямую разделить на 3600 и объявить:
требуется N GPU.
Эта метрика — первый volume layer.
Фактическую capacity выбранного inference deployment подтверждает benchmark.
Почему volume model ещё не является SLA
Два сервиса могут создавать одинаковые:
400 model calls/hour.
Но arrival pattern будет разным.
В одном calls распределены равномерно.
В другом десятки tasks одновременно заканчивают tools и почти синхронно возвращаются к LLM.
Средний объём один.
Model queue — разная.
Поэтому infrastructure sizing должен учитывать trajectory timing, а не только суммарные объёмы.
Task latency нельзя получить умножением
Соблазнительная формула:
p95 model latency × p95 calls/task
не даёт p95 task latency.
Причины:
variable loop count;
tools;
retrieval;
sandbox;
retries;
очереди;
параллельные стадии.
Поэтому p95 task latency измеряется из distribution полностью завершённых business tasks.
Почему нельзя просто сложить p95 отдельных стадий
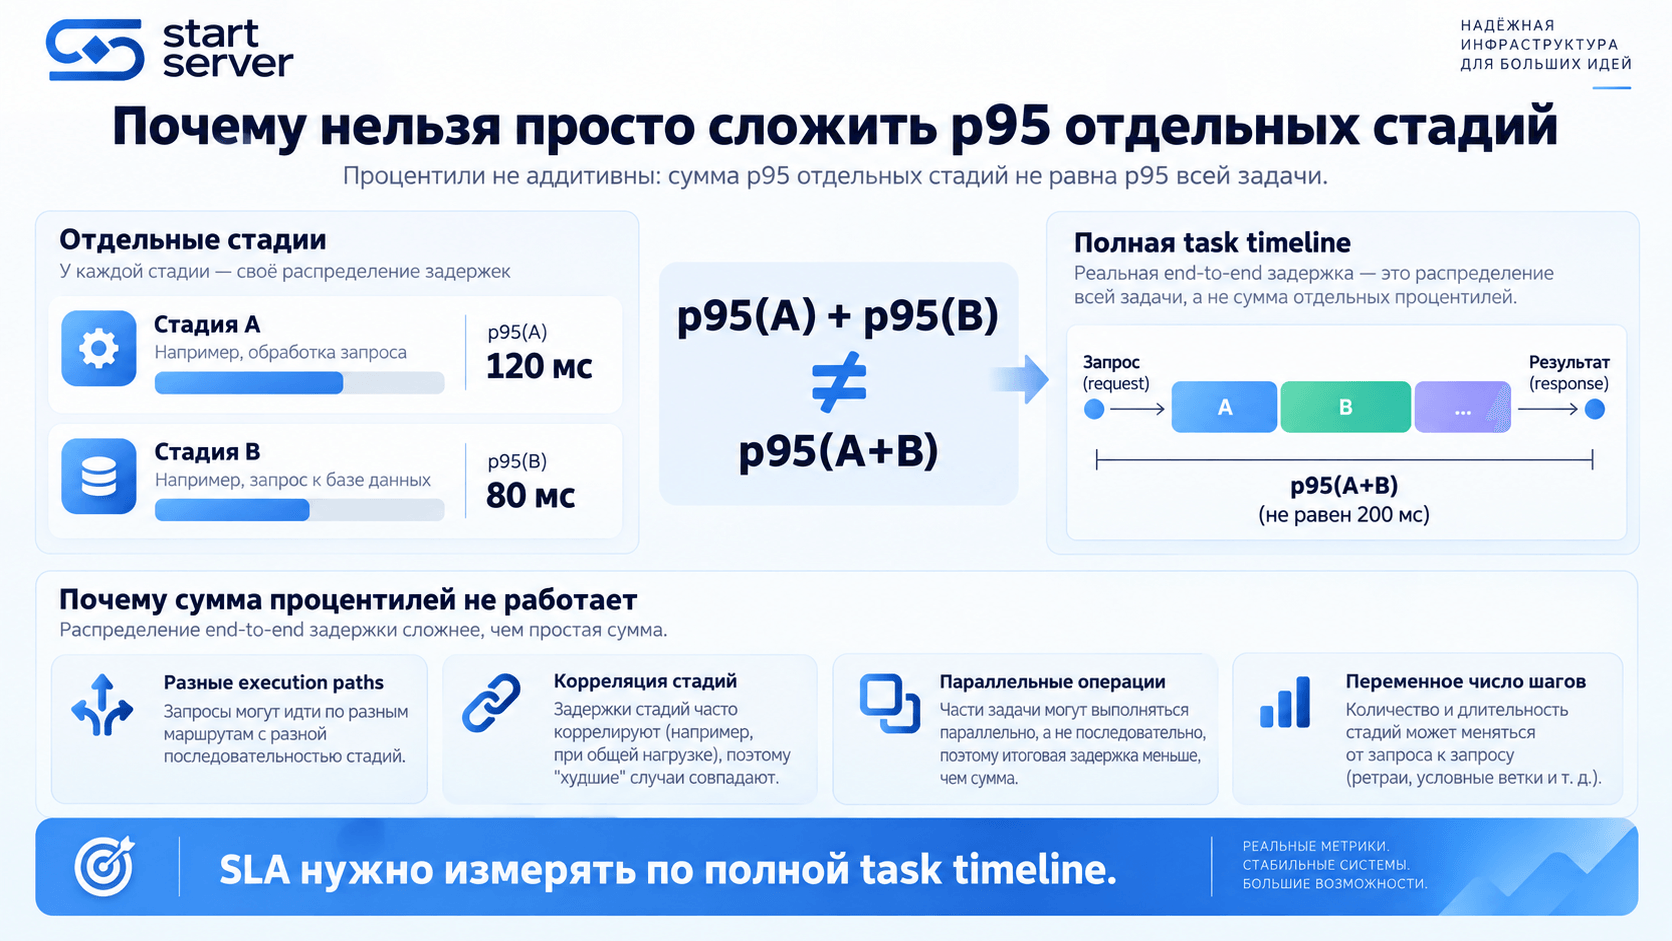
В общем случае:
p95(A) + p95(B) ≠ p95(A+B).
Особенно если:
число стадий меняется;
execution paths различаются;
есть корреляция;
некоторые operations выполняются параллельно.
Parallel tool calls тоже меняют workload
Некоторые agent implementations позволяют запускать несколько tools параллельно.
В таком случае:
пять tool calls
не обязательно означают:
пять последовательных tool latencies.
Но нельзя автоматически предполагать parallel execution для любого framework.
В benchmark нужно фиксировать фактический pattern:
sequential;
parallel;
степень реального overlap.
Сумма span durations не всегда равна task latency
Если два tools выполнялись одновременно по пять секунд каждый:
сумма tool spans = 10 секунд
но соответствующая часть wall-clock может составить около пяти секунд.
Поэтому Agent Resource Ledger и Timeline отвечают на разные вопросы.
Resource Ledger
Сколько operations произошло.
Timeline
Что находилось на critical path task.
Оба нужны для sizing.
Retries являются частью production workload
Happy path может выглядеть:
LLM → tool → LLM → result.
Но production execution:
LLM → tool → error → LLM → другой tool → retry → LLM → result.
Каждый дополнительный loop увеличивает:
model calls;
tokens;
tool activity;
latency.
Success rate нужно измерять рядом с performance
Быстрый agent workflow бесполезен, если он не достигает требуемого результата.
Поэтому инфраструктурный тест должен сохранять:
successful tasks/hour;
task success rate;
p95 task latency.
Это также не позволяет искусственно «ускорить» benchmark простым снижением числа iterations, если от этого страдает качество результата.
Human approval и внешнее ожидание лучше учитывать отдельно
Некоторые agent workflows могут ждать:
решения человека;
длительного внешнего процесса;
asynchronous business event.
Такое ожидание может входить в business end-to-end latency, но почти не иметь отношения к hardware capacity.
Поэтому для инфраструктурного анализа такие интервалы лучше маркировать отдельно.
Multi-agent system тоже нужно считать через parent trace
Слово:
multi-agent
само по себе ничего не говорит о числе GPU.
Один parent agent может вызвать несколько sub-agents, а они:
обращаться к той же модели;
использовать тот же inference pool;
выполнять tools;
работать последовательно или параллельно.
Поэтому parent trace должен показывать:
sub-agent calls;
model calls;
tokens;
tools;
overlap;
latency.
Нельзя считать:
пять agents = пять GPU.
Agent Task Classes
Production-система обычно имеет несколько типов задач.
Например:
Task class | Доля | LLM calls/task | Tokens/task | Tools/task | p95 task |
Simple | |||||
Document | |||||
Research | |||||
Code/action |
Названия условны.
Главная задача таблицы — отказаться от понятия:
средний AI-агент.
У разных task classes может быть принципиально разный resource profile.
Agent Resource Ledger
После сбора traces stages удобно разнести по resource pools.
Component | Count/task | Mean latency | p95 latency | Resource |
LLM inference | inference/GPU | |||
Retrieval | CPU/RAM/storage | |||
Tool/API | зависит от tool | |||
Sandbox | CPU/RAM | |||
Embedding | CPU/GPU | |||
Reranker | CPU/GPU | |||
Sub-agent | mixed |
Ключевая оговорка:
Agent Infrastructure Capacity Worksheet
1. Business workload
Параметр | Значение |
Task class | |
Tasks/hour | |
Peak task starts | |
Active tasks | |
Target p95 task latency | |
Required success rate |
2. Agent trace
Параметр | Значение |
Mean LLM calls/task | |
p50 LLM calls/task | |
p95 LLM calls/task | |
Input tokens/task | |
Output tokens/task | |
p50 input context/call | |
p95 input context/call | |
Peak representative input context | |
Tool calls/task | |
Retrieval calls/task | |
Sandbox runs/task | |
Retry rate | |
Sub-agent calls |
3. Inference
Параметр | Значение |
Model | |
Inference engine/version | |
GPU count | |
VRAM | |
Model-call concurrency | |
Model queue p95 | |
Model service p50/p95 | |
TTFT | |
Cache policy |
4. Host и tools
Параметр | Значение |
CPU | |
RAM | |
Sandbox workers | |
Retrieval capacity | |
Local tool workers | |
External dependencies |
5. Результат
Метрика | Значение |
Successful tasks/hour | |
Model calls/hour | |
Input tokens/hour | |
Output tokens/hour | |
Tool calls/hour | |
p95 active tasks | |
p95 task latency | |
Success rate | |
Model queue | |
Tool/sandbox queue | |
PASS / FAIL |
Как провести capacity test
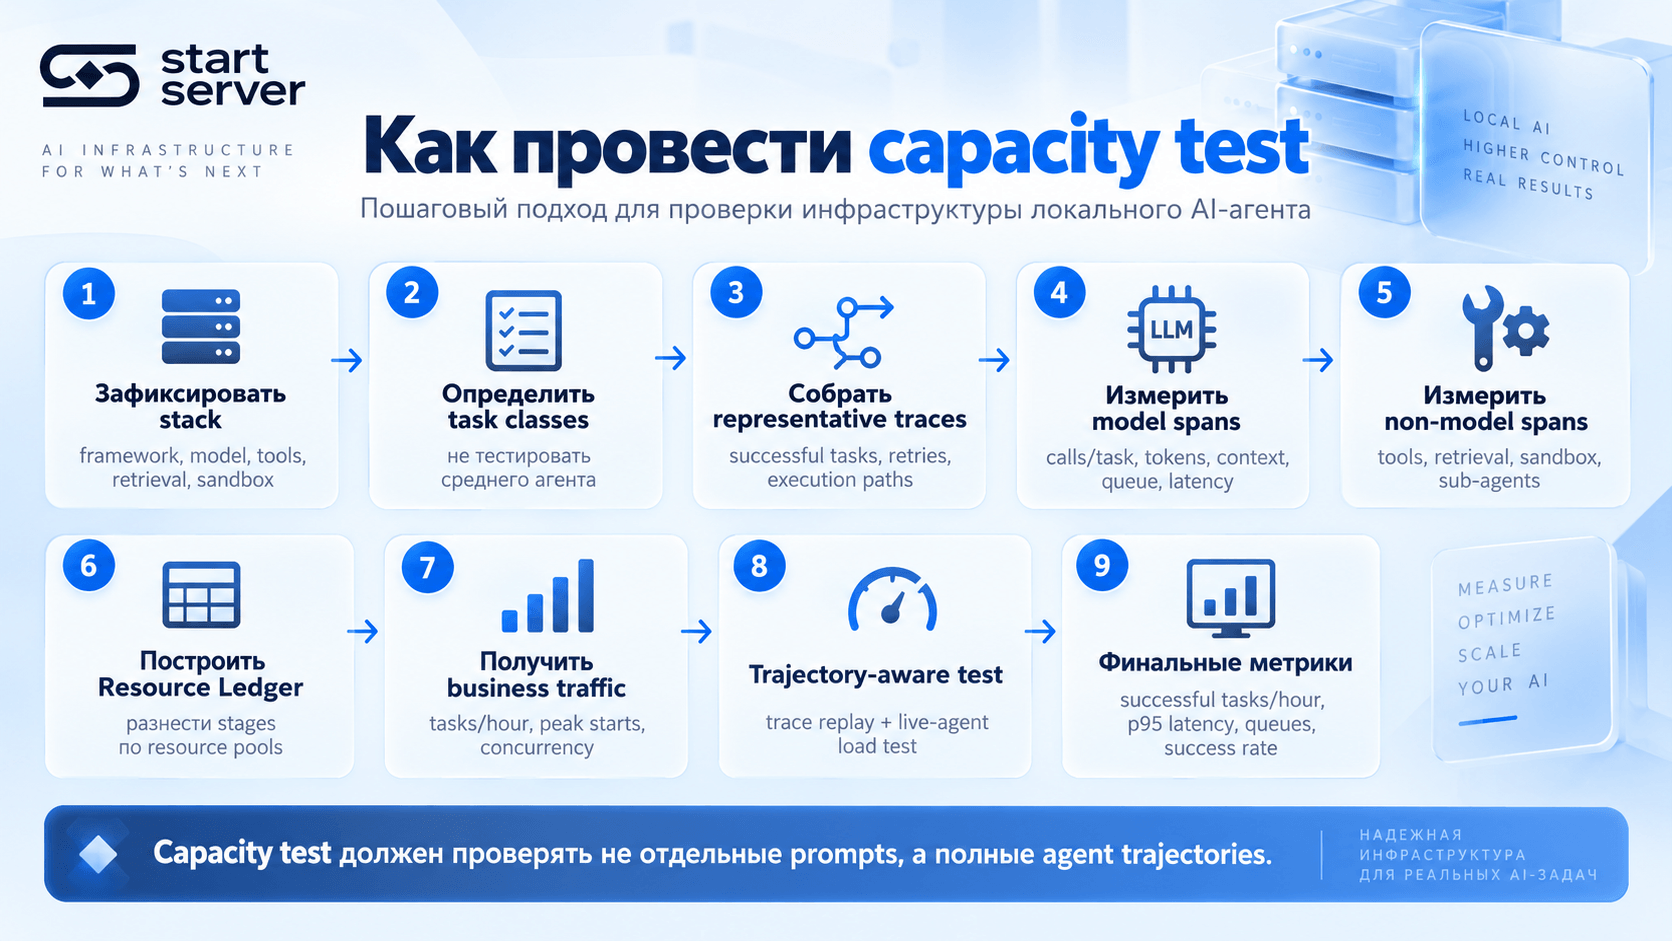
1. Зафиксировать stack
Сохранить:
agent framework/version;
workflow version;
model;
inference engine;
tools;
retrieval;
sandbox configuration.
2. Определить task classes
Не тестировать абстрактного «среднего агента».
3. Собрать representative traces
Нужны:
successful tasks;
realistic retries;
характерные execution paths.
4. Измерить model spans
Сохранить:
calls/task;
token usage;
context;
model queue;
service latency.
5. Измерить non-model spans
Сохранить:
tools;
retrieval;
sandbox;
sub-agents;
внешние waits.
6. Построить Resource Ledger
Разнести stages по resource pools.
7. Получить business traffic
Измерить:
tasks/hour;
peak starts;
task class mix;
active task concurrency.
8. Выполнить trajectory-aware test
Есть два полезных режима.
Reproducible trace replay
Использовать зафиксированные representative trajectories.
Он удобен для чистого сравнения candidate infrastructure.
Live-agent load test
Позволить agent принимать реальные решения под нагрузкой.
Он показывает:
вариативность loop depth;
retries;
success rate;
реальные task tails.
Для procurement полезно использовать оба подхода.
9. Измерить финальные метрики
Главные результаты:
successful tasks/hour;
p95 task latency;
model queue;
tool/sandbox queues;
success rate.
Почему обычный prompt benchmark недостаточен
Обычный inference benchmark может отправить тысячу независимых prompts.
Agentic workload устроен иначе.
Следующий model call внутри task появляется только после результата предыдущей стадии.
То есть model-call arrival pattern формируется самими trajectories.
Task-start traffic и model-call traffic могут различаться
Допустим, одновременно стартуют 100 business tasks.
После первого model round:
часть ждёт API;
часть работает в retrieval;
часть выполняет sandbox;
часть уже возвращается к модели.
Следовательно:
task starts/time
и:
model call arrivals/time
могут иметь совершенно разный профиль.
Для inference sizing второй показатель часто значительно полезнее.
Когда действительно может не хватать inference capacity
Возможные признаки:
model queue устойчиво растёт;
p95 model wait выходит за target;
inference backend не выдерживает representative call stream;
увеличение inference capacity уменьшает очередь на том же trace mix.
Но окончательный вывод подтверждается benchmark и load test.
Одна высокая GPU utilisation недостаточна.
Когда bottleneck может быть не в inference GPU
Симптом | Что проверить |
Tasks медленные при низкой model concurrency | tools / retrieval / sandbox |
Model calls быстрые, task медленная | non-model spans |
Поздние rounds становятся тяжелее | context / prefill / cache |
Calls/task растут | loop logic / retries |
Tool timeline доминирует | tool backend |
Sandbox queue растёт | CPU/RAM/workers |
Много active tasks, мало model calls | non-model waits |
Public tokens/s выше production | context/concurrency/cache mismatch |
p50 хороший, p95 плохой | variable loop depth / retries / heavy task classes |
Таблица показывает направления проверки, а не автоматически устанавливает причину.
Что считать PASS
Одного условия:
модель помещается на GPU
недостаточно.
Task Success PASS
Agent достигает согласованного business criterion.
Memory PASS
Representative model-call concurrency и context/cache state помещаются в выбранной конфигурации.
Inference PASS
Model pool выдерживает representative model-call stream.
Tool/Sandbox PASS
Non-model pools не создают неприемлемую очередь.
Task Latency PASS
p95 completed-task latency соответствует target.
Throughput PASS
Система обеспечивает необходимое количество successful tasks/hour.
Только совокупность этих gates позволяет считать инфраструктуру квалифицированной для production agent workload.
Какие данные нужны для подбора сервера
Перед выбором аппаратной конфигурации полезно подготовить:
Данные проекта | Значение |
Agent framework/version | |
Model | |
Inference engine | |
Task classes | |
Tasks/hour | |
Peak task starts | |
Mean/p95 LLM calls/task | |
Input/output tokens/task | |
p95 model input context | |
Tool calls/task | |
Retrieval calls/task | |
Sandbox executions/task | |
Active task concurrency | |
Model-call concurrency | |
Target p95 task latency | |
Required success rate |
После этого вопрос:
Сколько GPU нужно AI-агенту?
можно заменить на измеримое требование:
Нужно обслуживать такой набор business trajectories с таким потоком model и non-model operations, обеспечивая требуемые successful tasks/hour, success rate и p95 end-to-end task latency.
Главное
Локального AI-агента нельзя рассчитывать как один prompt, одного пользователя или одну постоянно занятую GPU.
Единицей sizing становится:
завершённая business task и её полный trace.
Сначала измеряют:
LLM calls → tokens → model input context → tools → retrieval → sandbox → retries.
Затем отдельно определяют:
active task concurrency
и
model-call concurrency.
Volume-метрики вроде:
model calls/hour;
input/output tokens/hour;
model service volume
дают первый слой capacity planning.
Но напрямую переводить их в количество GPU нельзя.
Финальную инфраструктуру подтверждают benchmark выбранного inference engine и trajectory-aware load test по:
successful tasks/hour + p95 end-to-end task latency + success rate + очередям отдельных resource pools.
Именно поэтому ответ на вопрос:
сколько GPU нужно локальным AI-агентам?
начинается не с GPU, а с trace реальной бизнес-задачи.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


