GPU загружена не полностью, DataLoader не всегда успевает подготовить следующий batch, а host→device transfers занимают заметную часть pipeline.
Возникает гипотеза:
«Процесс работает не на том NUMA node — нужно привязать его к CPU рядом с GPU».
Иногда NUMA-aware placement действительно улучшает data path.
Но сама topology ещё не доказывает bottleneck.
NVIDIA DCGM прямо указывает, что topology report показывает CPU cores и interconnect relationships, но не bind'ит process, не тестирует bandwidth и не предсказывает application performance.
Поэтому NUMA нужно проверять как controlled experiment:
Capture Topology → Check Allowed CPUs / Memory Nodes → Set Controlled CPU / Memory Policy → Start Fresh Workload → Verify Actual CPU / Worker Affinity → Verify Actual Page Placement → Freeze Dataset / Batch / Workers / Pinning → Baseline → Local → Remote Diagnostic → Measure Data Prep + H2D + End-to-End → Repeat → Compare Variance → Decide Whether NUMA Matters.
Главный принцип:
Topology показывает потенциальную locality. Только воспроизводимое измерение показывает, влияет ли она на целевую workload.
Что такое NUMA в GPU-сервере
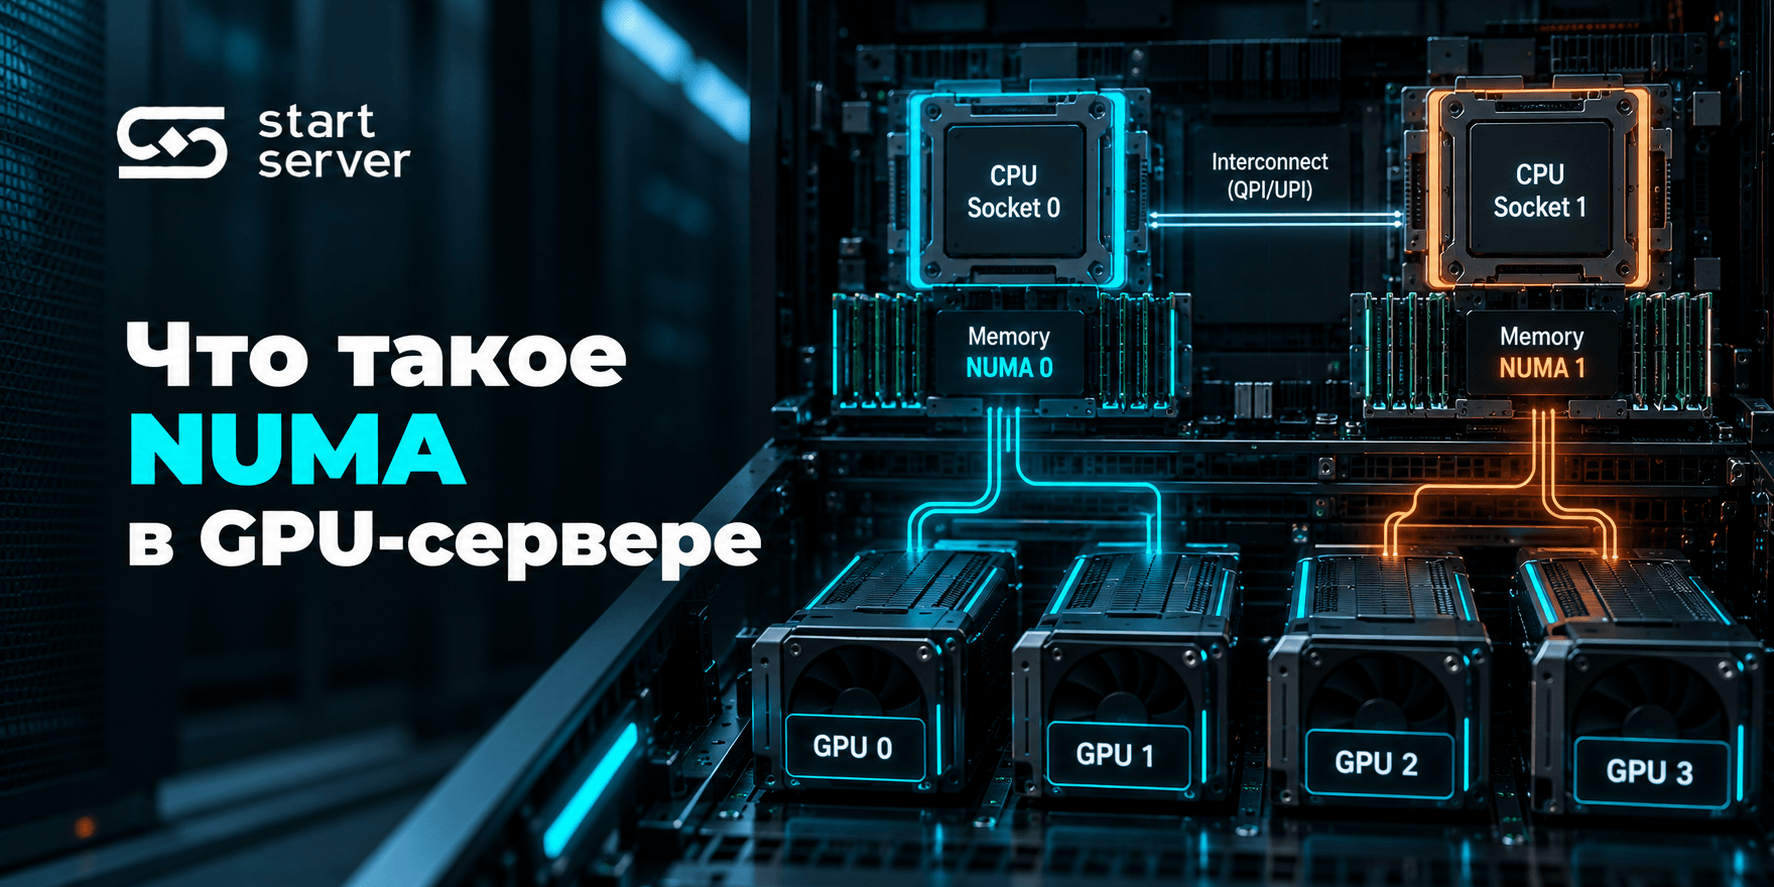
В multi-socket server процессоры и память организованы в NUMA nodes.
Для CPU доступ к:
local memory;
памяти другого NUMA node
может иметь разную стоимость.
Linux использует отдельные mechanisms для:
CPU scheduling;
NUMA memory allocation.
По умолчанию local allocation предпочитает node, локальный для CPU, выполняющего allocation, но при нехватке памяти возможен fallback на другие nodes.
GPU при этом физически подключается через определённую PCIe hierarchy.
Поэтому host-side data path может включать:
CPU thread → host memory → PCIe root / switches → GPU.
И locality каждого участка способна иметь значение.
CPU affinity и memory locality — не одно и то же
Это центральная граница NUMA experiment.
Можно запустить process на CPUs node 0.
Но его working set может физически находиться:
на node 0;
на node 1;
на нескольких nodes;
в пределах ограничений cpuset/cgroup.
Linux memory policy управляется отдельно от CPU affinity.
Поэтому:
CPU Affinity ≠ Memory Locality.
И:
CPU Binding Only ≠ Full NUMA Experiment.
Три уровня evidence
Для сильного NUMA experiment нужно различать:
1. Hardware Topology
Что физически близко к GPU?
Например:
CPU cores;
NUMA node;
NIC;
NVMe;
другие GPU.
2. Requested Runtime Policy
Что вы попросили OS сделать?
Например:
CPU bind;
--membind;--preferred;cpuset restrictions.
3. Actual Runtime Placement
Где process действительно исполняется и где реально находятся memory pages?
Поэтому ключевая формула:
Requested NUMA Policy ≠ Verified Page Placement.
Сначала снимите hardware topology
Для NVIDIA полезны:
nvidia-smi topo -m;dcgmi topo --gpuid;dcgmi topo --group;lstopo.
Current DCGM dcgmi topo --gpuid показывает CPU Core Affinity и PCIe/NVLink relationships конкретной GPU.
При этом documentation отдельно подчёркивает, что report не bind'ит process к указанным cores.
Поэтому:
Reported CPU Affinity ≠ Actual Process Affinity.
nvidia-smi topo -m показывает topology, а не performance
Topology matrix помогает увидеть классы paths между devices.
В NVIDIA examples встречаются:
PIX;PXB;PHB;NODE;SYS;NV#.
Например, SYS означает путь через PCIe и system/SMP interconnect между NUMA nodes.
Но отсюда нельзя вывести:
SYSснижает нашу workload на X%.
Поэтому:
Topology Distance ≠ Quantified Performance Penalty.
И:
Close Topology ≠ Measured Fast Path.
GPU index и NUMA node index независимы
Нельзя предполагать:
GPU0 → NUMA0
GPU1 → NUMA1.
GPU numbering и NUMA numbering — разные namespaces.
Relationship нужно смотреть по actual topology.
Поэтому:
GPU Index ≠ NUMA Node Index.
GPU NUMA ID N/A тоже не означает отсутствия locality
У discrete GPU отдельное поле GPU NUMA ID может быть N/A, хотя topology всё равно показывает CPU/NUMA affinity устройства.
Такие примеры есть и в NVIDIA documentation.
Поэтому:
GPU NUMA ID = N/A ≠ No CPU/Memory Locality.
Что означает NUMA Optimal в DCGM
Для GPU group DCGM показывает:
NUMA Optimal.
Current documentation уточняет: False означает, что одна или несколько GPUs имеют различающуюся CPU affinity, что может быть suboptimal для algorithms, предполагающих locality.
Но DCGM не знает:
где работает application;
где запущены workers;
где находятся host pages;
откуда приходят данные.
Поэтому:
NUMA-Optimal Topology ≠ NUMA-Optimal Runtime Automatically.
И ещё точнее:
Topology-Optimal ≠ Application-Optimal.
Используйте lstopo для полной картины host
GPU редко существует в изоляции.
Pipeline может быть:
NVMe → CPU → host RAM → GPU
или:
NIC → CPU → host RAM → GPU.
Поэтому topology inventory желательно строить для:
CPU sockets;
NUMA nodes;
GPU;
NIC;
NVMe/storage;
PCIe hierarchy.
Если storage или NIC находится на другой стороне системы, его locality может смешаться с NUMA effect GPU.
Главная формула:
Storage or NIC Locality Can Confound GPU NUMA Locality.
Когда NUMA особенно стоит проверять
NUMA sensitivity вероятнее, если workload активно использует host-side processing:
parsing;
decoding;
tokenization;
preprocessing;
DataLoader workers;
frequent H2D transfers;
большие pinned buffers;
high input throughput.
В такой pipeline GPU регулярно зависит от скорости подготовки данных на CPU.
Когда NUMA effect может быть небольшим
Разница может оказаться минимальной, если:
workload почти полностью GPU-compute-bound;
данные копируются редко;
dataset уже находится на accelerator;
H2D — малая доля E2E runtime;
server single-socket;
scheduler уже обеспечивает подходящую locality.
И это тоже полезный результат.
Цель experiment — не доказать, что NUMA всегда важна.
Цель:
определить, material ли NUMA для конкретной workload.
Potential Locality Issue ≠ Required Optimization
Если topology выглядит неидеально, но:
SLO выполняется;
local и remote runs практически одинаковы;
разница не выходит за run-to-run variation,
сложная ручная affinity policy может не иметь operational смысла.
Поэтому:
Potential Locality Issue ≠ Required Optimization.
Что делает numactl
numactl позволяет отдельно управлять CPU execution и memory policy.
Например:
--cpunodebind— ограничивает execution CPUs выбранных NUMA nodes;--physcpubind— конкретные CPUs;--membind— разрешает allocation только из выбранных memory nodes;--localalloc— предпочитает current local node;--preferred/--preferred-many— задаёт preferred nodes.
Это удобный инструмент controlled experiment.
Но semantics разных policies отличаются.
Local preference и strict memory binding — разные режимы
--localalloc пытается выделять memory на текущем local node, но при невозможности может использовать другие nodes.
--preferred также допускает fallback.
--membind, напротив, разрешает allocations только из выбранных nodes; если там не хватает memory, allocation может fail.
Поэтому:
Local Preference ≠ Strict Node Binding.
И:
Strict membind ≠ Universal Production Recommendation.
Почему strict --membind полезен в experiment
Для диагностики он позволяет создать более жёсткое условие:
host allocations должны идти только из конкретного NUMA node.
Это помогает отделить:
local;
remote
memory placement.
Но перед run нужно проверить:
достаточно ли RAM на node;
разрешён ли этот node cpuset'ом;
не разрушит ли strict policy application.
cpuset/cgroup может ограничить experiment
Особенно в:
Kubernetes;
Slurm;
containers;
managed platforms.
Linux kernel documentation показывает, что cpuset задаёт allowed CPU и memory nodes, а NUMA memory policy действует внутри этих restrictions.
Поэтому команда:
--membind=0
ещё не доказывает, что workload реально может использовать node 0.
Проверяйте allowed CPU и memory set
У running process в /proc/<pid>/status доступны:
Cpus_allowed_list;Mems_allowed_list.
Linux cpuset documentation прямо использует эти поля для отображения разрешённых CPUs и memory nodes процесса.
Это полезная часть Runtime Placement Evidence.
Но:
Allowed NUMA Nodes ≠ Allocated NUMA Nodes.
Mems_allowed_list показывает, где process может получать память.
Не где pages уже находятся.
Проверяйте actual page placement
Для серьёзного experiment недостаточно:
launch command говорит
--membind=0.
Linux предоставляет /proc/<pid>/numa_maps, где видны:
effective NUMA policy ranges;
node distribution resident pages.
Кроме того, numastat -p <PID> показывает per-node memory allocation running process и использует /proc/*/numa_maps как источник данных.
Поэтому:
Configured Memory Policy ≠ Verified Page Placement.
Почему это важно
Представим:
Local Run
requested:
NUMA node 0.
Но фактический working set:
часть node 0;
часть node 1.
Если просто назвать такой run:
local,
интерпретация становится слишком сильной.
Лучше сохранять:
Requested Policy
Verified Page Distribution.
NUMA policy лучше задавать до allocations
Linux task policy применяется к pages, выделенным после установки policy.
Уже faulted pages остаются там, где были размещены при предыдущей policy.
Поэтому clean experiment обычно лучше строить:
Set Policy
→ Start Fresh Process
→ Create / Fault Working Set
→ Run Workload.
Смена affinity не гарантирует миграцию existing pages
Важная формулировка:
Changing Affinity or Memory Policy Does Not by Itself Guarantee Migration of Existing Pages.
Linux поддерживает explicit page migration через отдельные mechanisms, включая возможности mbind() и cpuset memory migration.
То есть existing pages можно переносить.
Но обычная смена affinity или task policy сама по себе не означает:
все pages автоматически стали local.
Почему fresh process обычно проще
Если long-running application:
уже создала threads;
загрузила dataset;
faulted большой working set;
после этого получила новую affinity,
result трудно интерпретировать.
Clean NUMA benchmark проще запускать отдельными fresh processes:
Baseline
default policy.
Local
local controlled policy.
Remote
remote diagnostic policy.
NUMA task policy наследуется, но есть нюанс с threads
Linux task memory policy наследуется через fork() и exec().
Это делает запуск workload через numactl удобным.
Однако в multithreaded process policy устанавливается на конкретную kernel task/thread.
Threads, созданные после установки policy, наследуют её, но уже существующие sibling threads сохраняют прежнюю policy.
Поэтому:
Process-Level Intent ≠ Identical Policy on Pre-existing Threads.
PyTorch DataLoader: проверяйте workers отдельно
При num_workers > 0 PyTorch DataLoader использует worker subprocesses.
Поэтому bind только parent process может оказаться недостаточным.
Experiment Card должен отдельно содержать:
main process affinity;
worker affinity;
requested memory policy;
actual placement evidence.
Worker inheritance нельзя просто предполагать
Linux policy может наследоваться child processes.
Но фактическая PyTorch configuration зависит от:
multiprocessing start method;
момента создания workers;
cgroup/cpuset;
application code;
affinity changes после startup.
Поэтому:
«parent local → workers автоматически local»
не должно быть assumption.
Проверяйте actual worker PIDs и их state.
DataLoader workers создаются в конкретный момент lifecycle
PyTorch создаёт worker processes при multi-process loading в соответствии с DataLoader lifecycle.
Практический вывод:
если experiment рассчитывает на inherited locality, задавайте policy до создания relevant worker population и всё равно проверяйте actual placement.
pin_memory=True не означает NUMA-local memory
Current PyTorch documentation говорит:
pinned/page-locked host memory ускоряет host→GPU copies, а
DataLoader(pin_memory=True)помещает fetched tensors в pinned memory.
Но documentation не обещает:
pinned pages обязательно выделяются на NUMA node, local target GPU.
Поэтому:
Pinned Memory ≠ NUMA-Local Memory.
И ещё сильнее:
Pinned Memory NUMA Placement Must Be Verified, Not Assumed.
Worker affinity тоже не определяет pinned-buffer locality автоматически
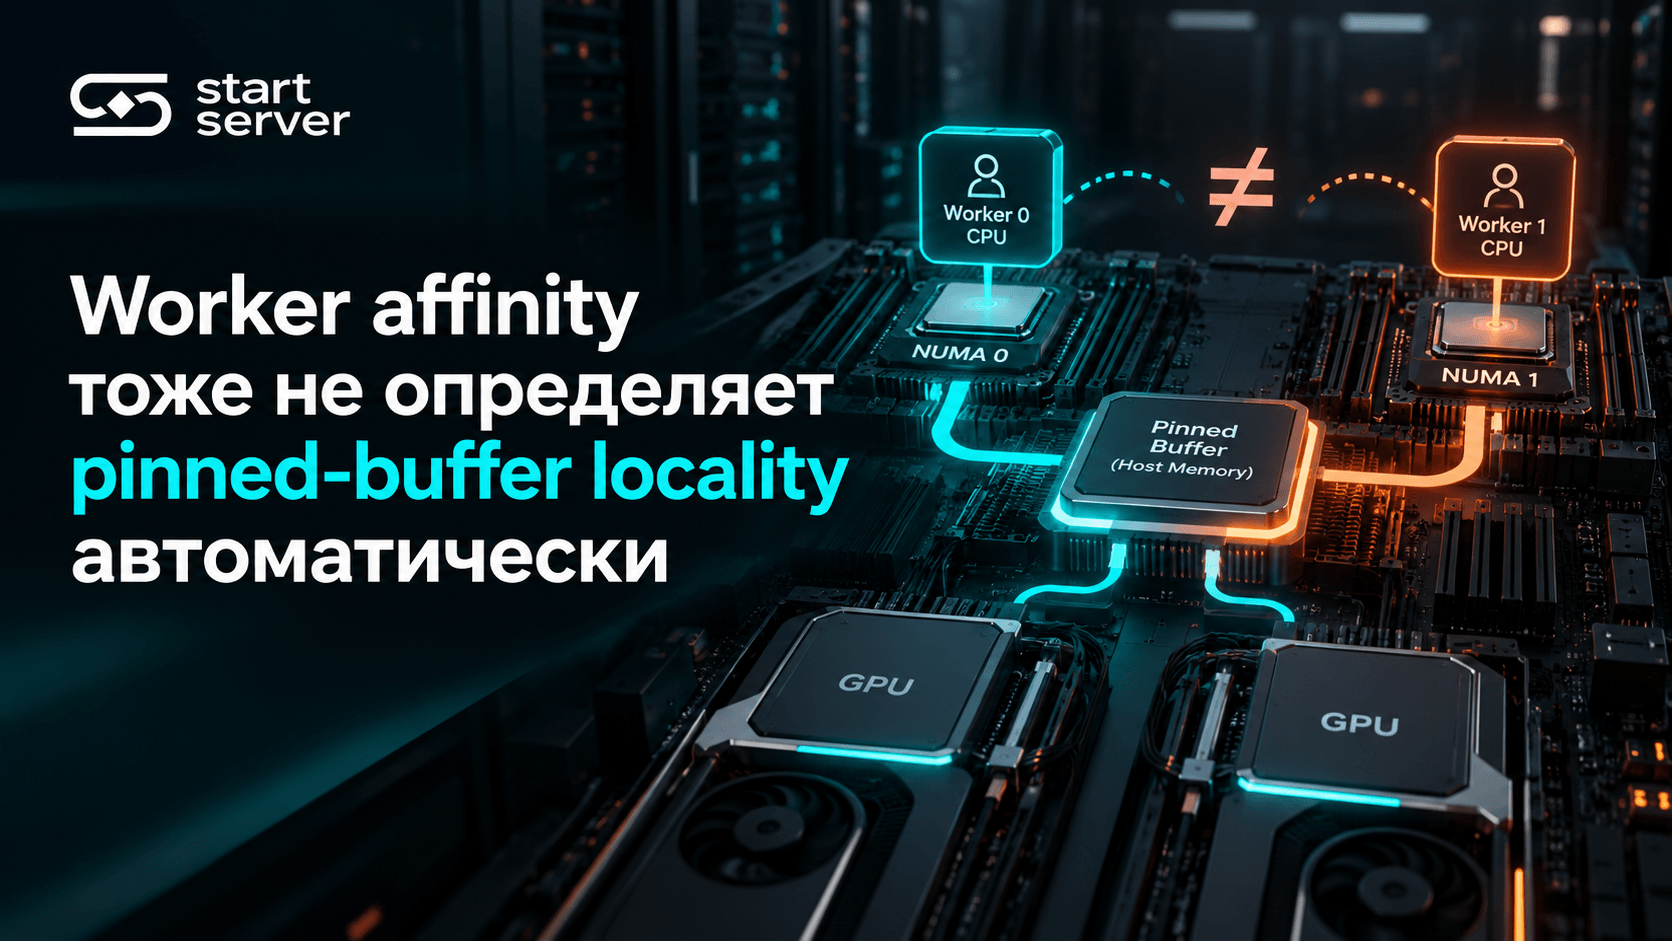
Не делайте вывод:
worker выполняется на NUMA0 → pinned buffer точно находится на NUMA0.
Actual placement зависит от:
allocation context;
memory policy;
pinning implementation;
process/thread placement;
cpuset restrictions.
Поэтому:
Worker Affinity ≠ Pinned-Buffer NUMA Locality.
pin_memory нужно держать фиксированным
Baseline:
pin_memory=False
Local:
pin_memory=True
— это уже не NUMA-only experiment.
Вы одновременно меняете:
NUMA locality;
page locking.
Поэтому фиксируйте:
pin_memory;num_workers;prefetch;
persistent workers;
batch size;
preprocessing.
Batch size тоже не меняется
В NUMA experiment batch size должен оставаться фиксированным.
Иначе:
affinity + batch
изменяются одновременно и NUMA effect теряется.
Batch-size tuning нужно проводить как отдельный experiment.
Dataset должен быть одинаковым
Сохраните:
dataset ID/version;
hash;
sample count;
order;
shuffle seed;
preprocessing.
Поэтому:
Different Dataset ≠ NUMA Comparison.
Cache state тоже контролируйте
Baseline не должен читать dataset с cold storage, а Local — из прогретого page cache.
Выберите заранее:
Cold-cache
или:
Warm / steady-state.
И применяйте одинаково.
Page cache создаёт дополнительный NUMA confounder
В storage-fed workloads memory behaviour сложнее, чем у чистых anonymous buffers.
Поэтому для изоляции NUMA→GPU effect полезно разделить:
Test A
Memory-resident dataset.
Test B
Real storage-fed pipeline.
Так легче понять:
проблема в host memory/GPU path или ещё и в storage/page cache.
Основной comparison: Baseline → Local → Remote
Scenario A — Baseline
Current/default runtime placement.
Это operational reality.
Scenario B — Local
CPU execution и requested memory placement согласованы с NUMA domain target GPU.
Actual placement затем проверяется.
Scenario C — Remote
CPU/memory deliberately размещены на другом domain.
Это diagnostic contrast.
Remote scenario — не production recommendation
Его цель:
создать заведомо менее local condition и проверить sensitivity workload.
Не нужно рекомендовать remote placement в эксплуатации.
Если нужен более строгий experiment — разделите CPU и memory
Advanced matrix:
CPU execution | Requested memory policy | Verified page placement |
|---|---|---|
Local | Local | |
Local | Remote | |
Remote | Local | |
Remote | Remote |
Так можно разделить:
effect CPU-side execution;
effect host-memory placement.
Не доверяйте только requested policy в 2×2 matrix
Для каждой строки нужно проверять actual page distribution.
Иначе:
Remote Memory
может оказаться только названием command line.
Поэтому advanced matrix обязательно имеет:
Verified Page Placement.
Что измерять
NUMA experiment полезно разбить на layers.
Layer 1 — Data Preparation
batches/s;
preprocessing throughput;
batch wait.
Layer 2 — Host→GPU Transfer
H2D transfer time;
effective transfer rate;
copy duration.
Layer 3 — GPU Feeding
GPU utilization;
idle gaps;
waiting.
Layer 4 — End-to-End
documents/s;
samples/s;
training steps/s;
job completion time.
H2D speedup ещё не означает application speedup
Если transfer занимал малую часть runtime, даже сильное улучшение copy layer может почти не изменить end-to-end throughput.
Поэтому:
H2D Speedup ≠ Application Speedup.
Один copy benchmark тоже не описывает application
Microbenchmark хорошо отвечает:
влияет ли locality на конкретный transfer?
Но application ещё включает:
parsing;
preprocessing;
workers;
batching;
synchronization;
GPU compute.
Поэтому:
One Copy Benchmark ≠ Full Data Pipeline.
End-to-End metric — основной operational result
Если задача — production processing, финальный verdict должен опираться на:
samples/s;
documents/s;
steps/s;
wall-clock completion.
А не только на synthetic copy bandwidth.
GPU utilization — вспомогательный signal
Если после NUMA-local placement GPU idle gaps уменьшились, это полезное evidence.
Но:
Higher GPU Utilization ≠ Guaranteed Higher Useful Throughput.
Итоговая application metric важнее.
Repeated runs обязательны
Один local run быстрее baseline — ещё не доказательство.
Нужны:
несколько runs;
одинаковая methodology;
representative statistic;
variance/spread.
Поэтому:
Single Run Difference ≠ Proven NUMA Effect.
Difference должна быть больше noise
Если:
Baseline = примерно один throughput;
Local = немного выше;
но natural run-to-run variation такого же масштаба, правильный вывод:
подтверждённого effect нет.
Не нужно превращать noise в benchmark claim.
Контролируйте run order
Последовательность:
Baseline → Local → Remote
может сама внести bias:
caches становятся warm;
CPU thermal state меняется;
application прогревается.
Для stricter experiment используйте:
repeated cycles;
balanced order;
randomized order.
CPU state тоже должен быть сопоставим
Если local node одновременно занят другим process, а remote свободен, comparison загрязнён.
Сохраняйте:
CPU power/performance policy;
system load;
relevant background activity.
Multi-GPU platform требует per-GPU locality model
Dual-socket platform может иметь, например:
часть GPU ближе к socket A;
часть к socket B.
Нельзя bind'ить весь multi-GPU process к одному socket только потому, что он local для GPU0.
Нужно знать:
process model;
GPU ownership;
worker placement;
locality каждой GPU.
NUMA-Optimal group ещё не решает multi-GPU runtime placement
DCGM group summary описывает topology CPU affinity группы.
Он не знает:
process-to-GPU mapping;
workers;
memory policy;
data source.
Поэтому runtime experiment остаётся необходимым.
NIC и NVMe тоже могут менять картину
Если данные приходят по network:
NIC → CPU / memory → GPU.
Если с NVMe:
NVMe → CPU / memory → GPU.
NVIDIA topology tooling используется и для анализа device locality, включая NIC relationships.
Поэтому сначала определите:
какой path на самом деле тестируется?
GPUDirect/RDMA — отдельная ветка
Если data path обходит обычное CPU staging, CPU NUMA locality может перестать быть главным фактором.
Тогда нужно отдельно исследовать:
GPU↔NIC topology;
GPUDirect configuration;
PCIe path.
Этот branch не стоит смешивать с обычным host-memory experiment.
Runtime Placement Evidence Pack
Самая важная практическая часть.
Hardware Topology
exact server;
CPU sockets;
NUMA nodes;
target GPU PCI ID;
NIC/NVMe topology.
Requested Runtime Policy
process CPU binding;
requested memory policy;
cpuset configuration.
Actual CPU Placement
main process affinity;
worker affinities;
Cpus_allowed_list.
Actual Memory Constraints
Mems_allowed_list.
Actual Page Placement
/proc/<pid>/numa_maps;numastat -p.
Workload
dataset/hash;
batch;
workers;
pinning;
cache state.
NUMA→GPU Experiment Card
Поле | Значение |
|---|---|
Server/SKU | |
CPU model/count | |
NUMA nodes | |
Target GPU / PCI ID | |
GPU CPU affinity | |
GPU NUMA/memory affinity | |
GPU/NIC/NVMe topology | |
Dataset/hash | |
Workload/version | |
Framework/version | |
Batch size | |
DataLoader start/context | |
num_workers | |
pin_memory | |
Prefetch | |
Main CPU affinity | |
Worker affinities | |
Requested NUMA policy | |
Cpus_allowed_list | |
Mems_allowed_list | |
| |
| |
Cache state | |
Repetitions | |
E2E metric |
Run Matrix
Scenario | CPU placement | Requested memory policy | Verified page placement | Data prep | H2D | GPU util | E2E | Variance |
|---|---|---|---|---|---|---|---|---|
Baseline | default | default | ||||||
Local | local | local/preferred/bind | ||||||
Remote | remote | remote diagnostic |
Никакие реальные значения сюда нельзя добавлять до стендового run.
Result Summary
Scenario | Representative E2E | Δ vs baseline | H2D | GPU waiting | Interpretation |
|---|---|---|---|---|---|
Baseline | |||||
Local | |||||
Remote |
Relative change:
ΔThroughput = Throughput_variant / Throughput_baseline − 1
Percentage публикуется только по реальным repeated measurements.
Когда можно сказать «NUMA влияет»
Нужны одновременно:
identical dataset;
fixed workload;
fixed batch/workers/pinning;
controlled CPU/memory placement;
verified page placement;
repeated runs;
effect больше noise;
supporting path metrics;
meaningful E2E difference.
Только тогда вывод:
workload NUMA-sensitive
имеет достаточное evidence.
Supporting metrics должны согласовываться с hypothesis
Например:
Local run
data preparation ускорилась;
H2D stalls уменьшились;
GPU idle gaps стали меньше;
E2E throughput выросла.
Такой набор signals поддерживает NUMA explanation.
Если:
H2D стал быстрее;
E2E не изменился,
правильный вывод:
NUMA влияет на transfer layer, но не является material application bottleneck.
Когда правильный вывод — «эффект мал»
Если:
workload GPU-compute-bound;
host data path мала;
Local/Remote difference находится в пределах variation,
не нужно внедрять сложный manual pinning.
Инженерный negative result тоже ценен:
для tested workload operationally significant NUMA effect не подтверждён.
Topology problem и performance problem — разные вещи
Даже remote-looking topology может полностью удовлетворять application requirement.
Поэтому:
Remote Topology ≠ Measured Performance Problem Automatically.
NUMA — только одна bottleneck hypothesis
GPU starvation также может быть вызвана:
storage;
parsing;
Python overhead;
DataLoader;
synchronization;
insufficient workers;
network;
CPU saturation.
Правильная последовательность:
Observe Bottleneck
→ Map Topology
→ Controlled NUMA Test
→ Accept or Reject NUMA Hypothesis.
NUMA Decision Tree
Platform multi-NUMA?
Нет
→ NUMA branch, вероятно, не главный.
Да ↓
GPU topology известна?
Нет
→ снять topology.
Да ↓
Allowed CPUs / memory nodes известны?
Нет
→ проверить runtime restrictions.
Да ↓
Actual parent/worker affinity известна?
Нет
→ проверить process state.
Да ↓
Requested memory policy известна?
Нет
→ зафиксировать.
Да ↓
Actual page placement проверено?
Нет
→ numa_maps / numastat.
Да ↓
Baseline воспроизводим?
Нет
→ исправить benchmark.
Да ↓
Locality изменена при неизменной workload?
Нет
→ experiment invalid.
Да ↓
Local/remote difference повторяется и больше noise?
Нет
→ NUMA effect не подтверждён.
Да ↓
Data/H2D metrics поддерживают hypothesis?
Нет
→ искать другой bottleneck.
Да ↓
E2E workload materially improves?
Да
→ NUMA-aware placement operationally useful.
Нет
→ NUMA effect существует, но application benefit мал.
Что нельзя публиковать без реального стенда
Не писать:
NUMA pinning дало +20%.
Не придумывать:
CPU ranges;
node layout;
GPU placement;
H2D bandwidth;
page distribution;
GPU utilization;
E2E improvement.
Не выдавать topology другой машины за test Start Server.
Текущая статья — protocol controlled NUMA experiment, а не отчёт о реальных измерениях стенда.
Когда можно перейти к result-driven статье
Заголовок:
«Разбор влияния NUMA на подачу данных к GPU по измерениям стенда»
можно использовать после появления:
Evidence | Ready? |
|---|---|
Exact server | |
CPU/socket topology | |
GPU placement | |
lstopo | |
nvidia-smi topo -m | |
Actual parent affinity | |
Actual worker affinity | |
Requested NUMA policy | |
Cpus_allowed_list | |
Mems_allowed_list | |
numa_maps | |
numastat -p | |
Dataset/hash | |
Fixed batch/workers/pinning | |
Cache state | |
Baseline repeats | |
Local repeats | |
Remote repeats | |
H2D/data metrics | |
E2E throughput | |
Variance | |
Raw logs |
Связь с публичными бенчмарками
Публичные benchmark numbers отвечают на вопрос:
можно ли сравнивать результаты, полученные в разных условиях?
NUMA experiment отвечает на другой:
как провести controlled locality experiment на собственной platform?
То есть сначала нужно обеспечить сопоставимость условий, а затем проверять NUMA effect внутри одного контролируемого стенда.
Связь с общей приёмкой GPU-сервера
В общей программе приёмки могут проверяться:
topology;
PCIe;
diagnostics;
application workload.
Но topology PASS ещё не отвечает:
где runtime разместил CPU threads и host pages?
Поэтому:
Topology / PCIe PASS ≠ NUMA Runtime Optimization PASS.
Связь с batch-size tuning
Batch-size experiment меняет:
batch size.
NUMA experiment, наоборот, должен держать batch size фиксированным.
Если одновременно меняются:
batch;
workers;
pin_memory;affinity,
вы уже не измеряете только NUMA.
Когда NUMA result влияет на выбор server platform
Если реальный experiment показывает заметную sensitivity к:
GPU↔CPU locality;
PCIe root placement;
NIC/GPU relation;
NUMA split,
это можно превратить в requirement к platform.
Например, проверить:
распределение GPU по sockets;
PCIe roots;
NIC/storage placement;
возможность размещения workers по NUMA domains.
Но exact requirement должен относиться к конкретному SKU/configuration.
Что подготовить для проверки GPU topology
Полезные данные:
server/platform SKU;
CPU model/count;
GPU SKU/count;
NIC/storage configuration;
framework;
workload;
batch size;
num_workers;data source;
current throughput;
признаки GPU starvation;
scheduler/container environment.
CTA: Проверить топологию GPU платформы.
Главное
NUMA tuning начинается не с:
numactl --membind=...
А с доказательств.
Сначала:
Hardware Topology.
Затем:
Allowed CPU / Memory Nodes.
Потом:
Actual Process and Worker Placement.
После этого:
Requested Memory Policy.
И отдельно:
Verified Page Placement.
DCGM прямо показывает, почему topology недостаточно: его CPU affinity — это proximity information, а не runtime binding, и сам topology view не измеряет bandwidth или application performance.
Linux также чётко разделяет task policy и фактическое размещение memory: task policy наследуется через fork()/exec(), но новая policy относится главным образом к последующим allocations; existing pages без отдельной migration operation не обязаны переехать.
При этом cpuset дополнительно ограничивает доступные CPUs и memory nodes, а реальное распределение resident pages можно проверять через /proc/<pid>/numa_maps или numastat -p.
PyTorch pin_memory=True решает другую задачу: создаёт page-locked host memory для более эффективных transfers, но documentation не обещает определённого NUMA placement этой памяти.
Поэтому корректная последовательность:
Topology
→ Allowed Nodes
→ Requested CPU / Memory Policy
→ Actual CPU / Worker Placement
→ Verified Page Placement
→ Fixed Dataset / Batch / Workers / Pinning
→ Baseline
→ Local
→ Remote Diagnostic
→ Data Prep
→ H2D
→ GPU Feeding
→ End-to-End Throughput
→ Repeated Runs / Variance
→ Operational Decision.
Ключевые правила:
Topology Map ≠ Performance Result.
Reported CPU Affinity ≠ Actual Process Affinity.
Topology Distance ≠ Quantified Performance Penalty.
Close Topology ≠ Measured Fast Path.
NUMA-Optimal Topology ≠ NUMA-Optimal Runtime Automatically.
Topology-Optimal ≠ Application-Optimal.
CPU Affinity ≠ Memory Locality.
CPU Binding Only ≠ Full NUMA Experiment.
Requested NUMA Policy ≠ Verified Page Placement.
Allowed NUMA Nodes ≠ Allocated NUMA Nodes.
Changing Affinity or Memory Policy Does Not by Itself Guarantee Migration of Existing Pages.
Pinned Memory ≠ NUMA-Local Memory.
Pinned Memory NUMA Placement Must Be Verified, Not Assumed.
Worker Affinity ≠ Pinned-Buffer NUMA Locality.
Different Dataset ≠ NUMA Comparison.
Storage or NIC Locality Can Confound GPU NUMA Locality.
H2D Speedup ≠ Application Speedup.
One Copy Benchmark ≠ Full Data Pipeline.
Higher GPU Utilization ≠ Guaranteed Higher Useful Throughput.
Single Run Difference ≠ Proven NUMA Effect.
Potential Locality Issue ≠ Required Optimization.
GPU Index ≠ NUMA Node Index.
Основной вывод:
NUMA-aware placement стоит внедрять не потому, что topology выглядит remote, а когда controlled experiment на одной и той же workload показывает воспроизводимый end-to-end эффект, а фактическое CPU и memory placement подтверждено runtime evidence. Если разница остаётся внутри noise или не меняет application throughput, NUMA tuning не должна становиться самоцелью.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


