Модель может помещаться в GPU memory по весам и всё равно получать OOM, когда несколько пользователей одновременно начинают работать с длинным контекстом.
Причина в том, что weights — только одна часть памяти, необходимой LLM-инференсу. Во время работы VRAM занимает KV-cache, а inference engine дополнительно использует память под activations, backend buffers, communication и другие runtime allocations.
Но считать другую крайность — например, 128K context × количество пользователей — тоже неправильно. Максимальное окно модели не означает, что каждый активный запрос всё время держит заполненный cache максимальной длины.
Практический расчёт лучше строить в три слоя:
Exact checkpoint
↓
Weights
↓
Attention/cache architecture
↓
KV bytes per token
↓
Production active tokens
↓
KV-cache budget
↓
Runtime profiling
↓
Production VRAM budget
Главный принцип простой:
Из чего складывается VRAM для LLM-инференса
Для sizing полезно разделить память на три части.
Компонент | От чего зависит | Как получить |
Weights | checkpoint, dtype, quantization | рассчитать приблизительно и проверить exact checkpoint |
KV-cache | attention architecture, KV dtype, active tokens | рассчитать для поддерживаемой архитектуры |
Non-KV/runtime memory | engine, activations, kernels, buffers, parallelism, backend | измерить на выбранном runtime |
Такое разделение хорошо соответствует тому, как сам vLLM профилирует память. В его текущем memory profiler отдельно присутствуют weights_memory, peak Torch memory increase, non-Torch allocations и итоговый non_kv_cache_memory; документация приводит NCCL и buffers attention backend как примеры памяти вне самих весов.
Поэтому выражение:
VRAM = parameters × bytes_per_parameter
показывает только порядок размера weights.
Оно не является формулой production VRAM.
Как оценить память весов
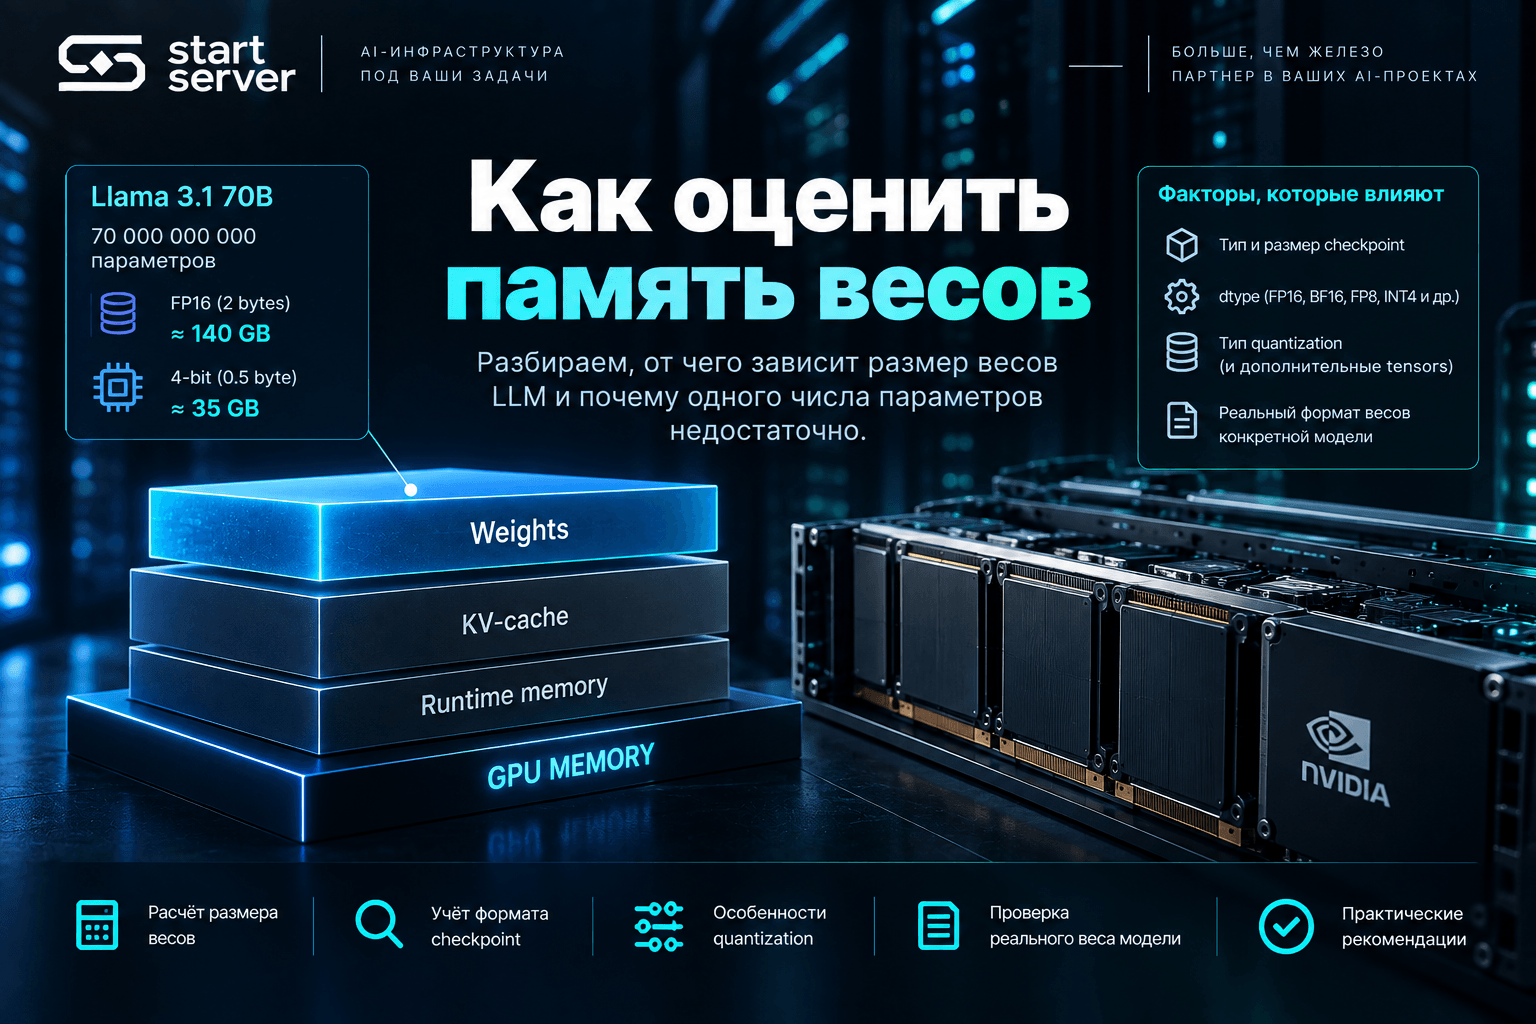
Для незаквантованных весов арифметика простая.
Если взять условную модель с ровно 70 млрд параметров и двухбайтовые weights:
70 000 000 000 × 2 bytes
= 140 000 000 000 bytes
≈ 140 GB
≈ 130,4 GiB
Здесь важно различать GB и GiB. 140 GB и 130,4 GiB — один и тот же объём байт, записанный в десятичных и двоичных единицах.
Для грубой 4-bit оценки:
70 000 000 000 × 0,5 byte
≈ 35 GB
Но это теоретический weight payload, а не обещание, что любой checkpoint, обозначенный как 70B 4-bit, займёт ровно 35 GB.
Конкретный quantized checkpoint может содержать scales, metadata и дополнительные tensors другого dtype. Поэтому для реальной конфигурации нужны exact model ID, revision и фактический формат весов.
И главное: quantization weights сама по себе не определяет размер KV-cache.
Почему для KV-cache нужно смотреть config модели
Количество параметров — 8B, 32B, 70B — не определяет память KV-cache.
Для standard decoder attention нужны параметры самой attention architecture.
Возьмём Llama 3.1 70B. Официальная конфигурация Meta содержит:
dim = 8192
n_layers = 80
n_heads = 64
n_kv_heads = 8
То есть модель использует 64 query heads, но только восемь KV heads. Meta также указывает GQA и context length 128K для семейства Llama 3.1.
Размер одного head:
head_dim = 8192 / 64
= 128
Теперь можно перейти от названия «70B» к нормальному расчёту cache.
Формула KV-cache на один токен
Для standard full-attention decoder с обычным Key/Value cache базовый payload можно записать так:
KV bytes/token =
2 × L × H_KV × D_head × B
Где L — число attention layers, H_KV — число KV heads, D_head — размер head, B — bytes per cache element. Множитель 2 нужен потому, что хранятся и Key, и Value.
Transformers описывает cache как набор key/value tensors по слоям с измерениями, включающими batch, heads, sequence length и head dimension; у Dynamic Cache sequence dimension растёт по мере обработки новых токенов.
Эта формула не универсальна для любой современной LLM. Она применима, когда cache architecture действительно соответствует такой модели. Sliding-window, chunked, hybrid attention, MLA и attention-free компоненты нужно проверять отдельно.
Llama 3.1 70B: BF16 KV-cache на один токен
Для рассматриваемой модели:
layers = 80
KV heads = 8
head_dim = 128
BF16 = 2 bytes
Получаем:
2 × 80 × 8 × 128 × 2
= 327 680 bytes/token
= 320 KiB/token
То есть basic BF16 K/V payload для одного дополнительного token position составляет 320 KiB.
Из этого получаем:
Active tokens одной sequence | Basic BF16 KV payload |
8 192 | 2,5 GiB |
32 768 | 10 GiB |
65 536 | 20 GiB |
131 072 | 40 GiB |
Исходные architecture parameters здесь взяты из официальной конфигурации Meta; объёмы памяти — расчётные.
Особенно важно правильно читать последнюю строку.
Weights и runtime memory сюда не входят.
Почему GQA радикально меняет расчёт
У Llama 3.1 70B:
query heads = 64
KV heads = 8
Если ошибочно использовать все 64 query heads:
2 × 80 × 64 × 128 × 2
= 2 621 440 bytes/token
Полученный результат будет в восемь раз больше нашего расчёта:
64 / 8 = 8
Именно поэтому формулы, которые используют только hidden size или общее число attention heads, могут давать очень плохую оценку для GQA-моделей.
При GQA для basic KV-cache нужно смотреть число KV heads конкретной архитектуры, а не автоматически использовать все query heads.
Meta явно фиксирует для Llama 3.1 70B n_heads=64 и n_kv_heads=8.
128K context не означает постоянно занятые 128K
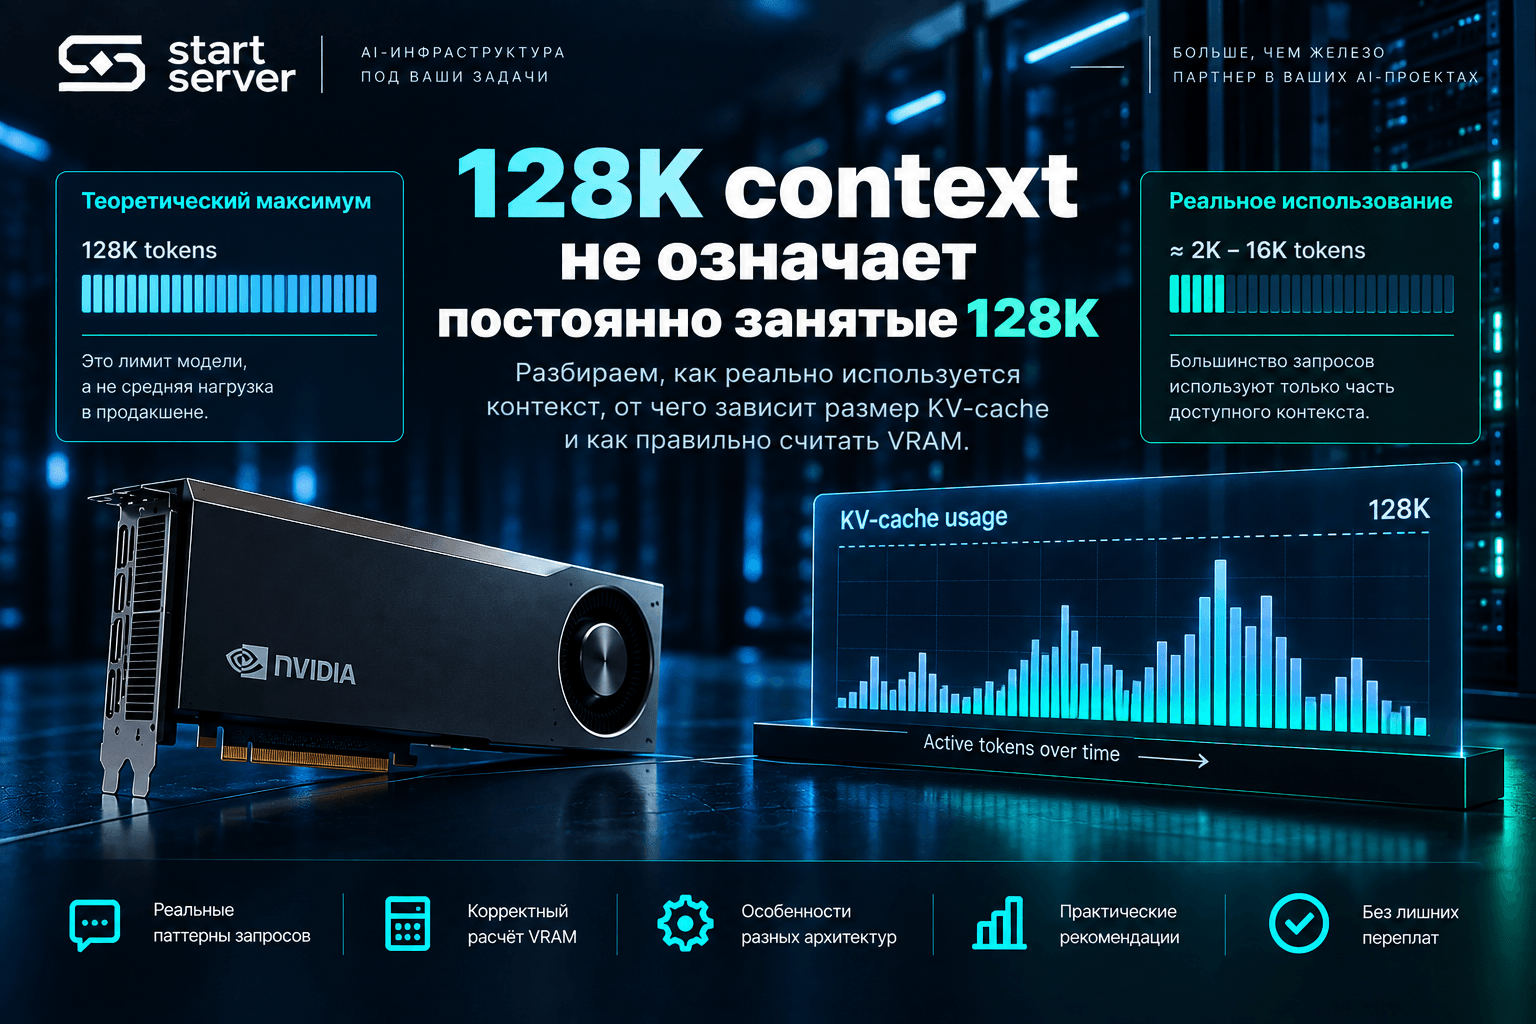
Для Llama 3.1 Meta указывает context length 128K.
Но это максимальное окно модели, а не утверждение о том, что каждая sequence постоянно содержит 131 072 обработанных token positions.
У Transformers DynamicCache растёт по мере поступления новых Key/Value states. Поэтому при обычном full attention cache для короткой активной sequence меньше, чем для той же sequence после десятков тысяч обработанных токенов.
Нужно разделять:
Maximum supported context
≠
Actual active sequence length
Если приложение разрешает 128K, но большинство запросов работает в диапазоне нескольких тысяч токенов, считать 128K как типичное потребление каждой sequence будет слишком консервативно.
Если же длинные запросы действительно регулярно доходят до 80–120K, ориентироваться только на среднее тоже опасно.
Поэтому production sizing требует нескольких workload-сценариев.
KV-cache растёт и во время генерации ответа
Допустим, prompt содержит:
20 000 tokens
а модель уже сгенерировала:
2 000 tokens
Для обычного causal Dynamic Cache дальнейший decode использует состояния уже обработанных token positions, поэтому active sequence стала примерно:
20 000 + 2 000 = 22 000 tokens
Transformers показывает именно такую механику: новые keys и values добавляются в cache по мере генерации.
Поэтому поле:
average input = 20K
недостаточно.
Для sizing нужно знать ещё и ожидаемую длину output.
Для production полезно считать aggregate active tokens
Представим четыре активные sequences:
A → 3 000 tokens
B → 7 000 tokens
C → 12 000 tokens
D → 18 000 tokens
Их суммарная активная длина:
T_active =
3 000 + 7 000 + 12 000 + 18 000
= 40 000 tokens
Для standard raw KV estimate:
KV_logical ≈
KV_bytes_per_token × T_active
Для нашего примера Llama 3.1 70B:
40 000 × 320 KiB
≈ 12,2 GiB
Это гораздо полезнее, чем автоматически считать:
4 × 128K
если ни одна из четырёх sequences фактически не приблизилась к maximum context.
vLLM тоже выражает cache capacity через токены: в актуальном CacheConfig есть kv_cache_size_tokens — group-aware ёмкость KV-cache в tokens на DP engine — и kv_cache_max_concurrency для max_model_len.
Но есть важная оговорка:
Runtime может управлять cache блоками, переиспользовать данные и иметь model-specific layouts.
Когда context × concurrency всё-таки правильная формула
Она вполне подходит для явно заданного worst-case.
Например, приложение должно допускать одновременно:
16 active sequences
×
32 768 tokens
Тогда:
T_active = 524 288 tokens
Для Llama 3.1 70B с BF16 KV:
524 288 × 320 KiB
= 160 GiB
Это корректный Limit scenario, если действительно требуется выдержать 16 одновременно полностью разросшихся до 32K sequences.
Ошибка начинается тогда, когда подобный worst-case без анализа workload объявляют типичным режимом работы.
Typical, Heavy и Limit вместо одного «нужно X GB»
Возьмём три учебных режима. Это не результаты измерений Start Server — параметры нагрузки здесь выбраны только для демонстрации расчёта.
Сценарий | Active sequences | Active tokens/sequence | Aggregate active tokens | Basic BF16 KV |
Typical | 8 | 6 144 | 49 152 | 15 GiB |
Heavy | 16 | 12 288 | 196 608 | 60 GiB |
Limit | 16 | 32 768 | 524 288 | 160 GiB |
Один checkpoint. Одна attention architecture. Один KV dtype.
А basic K/V payload меняется:
15 GiB → 60 GiB → 160 GiB
Только за счёт workload.
Поэтому вопрос:
«Сколько VRAM нужно Llama 70B?»
не имеет одного production-ответа без продолжения:
Prefix caching может изменить физическую картину
Есть сценарии, где простое суммирование всех sequence lengths сознательно переоценивает физически уникальный cache.
Представим большое количество запросов с одинаковым длинным system prompt или общим документом.
vLLM Automatic Prefix Caching позволяет новым requests переиспользовать ранее вычисленные KV blocks совпадающего prefix вместо повторного вычисления тех же частей. Текущая реализация работает с cache blocks и reference counts.
Поэтому два утверждения нужно разделять.
Σ active sequence lengths
даёт понятную workload-side оценку без учёта reuse.
А фактическое количество физических KV blocks определяет уже engine.
Для первичного sizing первая оценка полезна и воспроизводима. Для закупочной конфигурации нужно измерить вторую.
Quantization weights и KV-cache — разные параметры
Представим конфигурацию:
Weights: 4-bit AWQ
KV-cache: BF16
Уменьшение памяти weights не превращает BF16 KV-cache в 4-bit cache.
В vLLM KV-cache dtype задаётся отдельно; в актуальной документации auto означает использование default model dtype, а FP8 и другие quantized cache formats задаются отдельной настройкой.
Поэтому в любом воспроизводимом расчёте должны быть две отдельные строки:
Weight dtype / quantization:
KV-cache dtype:
Фраза «у нас 4-bit модель» не отвечает на вопрос о памяти длинного контекста.
Сколько даёт FP8 KV-cache
Для нашего примера BF16 занимает два байта на K/V element:
2 × 80 × 8 × 128 × 2
= 320 KiB/token
Для однобайтового FP8 raw payload:
2 × 80 × 8 × 128 × 1
= 160 KiB/token
Получаем:
Active tokens | Basic BF16 KV | Basic FP8 KV |
8 192 | 2,5 GiB | 1,25 GiB |
32 768 | 10 GiB | 5 GiB |
65 536 | 20 GiB | 10 GiB |
131 072 | 40 GiB | 20 GiB |
То есть базовый K/V tensor payload примерно вдвое меньше.
Но:
FP8 KV
≠
в 2 раза меньше вся VRAM
Weights не меняются из-за одного только переключения KV-cache.
Runtime allocations не исчезают.
Кроме того, vLLM поддерживает несколько вариантов FP8 KV quantization, включая per-tensor и per-attention-head scaling, а для наиболее точной настройки документация рекомендует calibration с dataset.
Поэтому FP8 KV нужно проверять не только по памяти, но и по качеству и performance конкретной модели.
Почему фиксированные «+15% на overhead» ненадёжны
Иногда VRAM оценивают так:
(weights + KV) × 1.15
Для грубого pre-sizing это может быть сознательным допущением.
Для закупочной спецификации фиксированный процент слаб.
vLLM показывает почему: его non_kv_cache_memory включает weights, peak activation memory и non-Torch memory. В документации приведён пример, где non-Torch component включает NCCL и buffers attention backend.
Размер этой части зависит от конкретного:
checkpoint
runtime + version
backend
parallelism
kernels
workload
Как правильно собрать финальный memory budget
Здесь важна точность терминов.
Если мы используем vLLM non_kv_cache_memory, weights туда уже входят. Поэтому корректная структура выглядит так:
Production VRAM budget
≈
measured non-KV footprint
+
required KV-cache allocation
+
operational headroom
Где в measured non-KV footprint уже находятся weights и другие non-KV allocations.
Если же собственный profiler отдельно показывает только runtime memory без весов, формула может выглядеть иначе:
weights
+
runtime memory excluding weights
+
KV-cache
+
operational headroom
Главное — не прибавить веса дважды.
vLLM прямо определяет non_kv_cache_memory как сумму weights, peak activation memory и non-Torch increase.
Это один из тех случаев, где термин из конкретного runtime важнее красивой универсальной формулы.
Что посмотреть после запуска vLLM
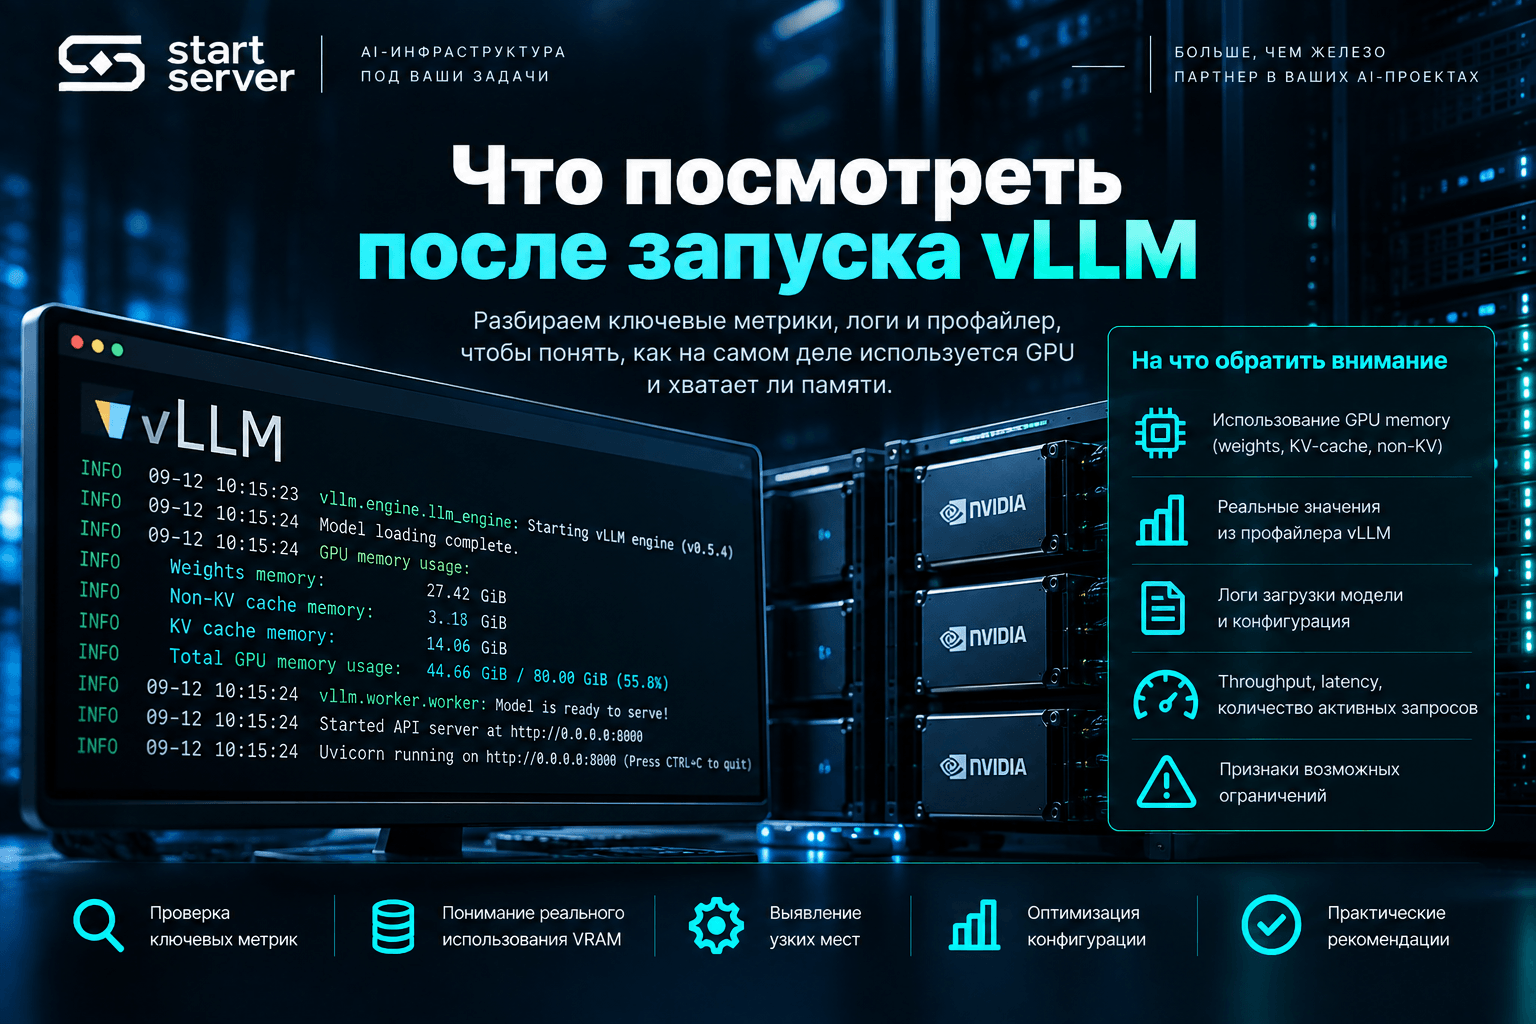
Расчёт по architecture config нужен не вместо запуска, а до запуска, чтобы знать ожидаемый порядок величин.
После старта полезно сверить теоретический расчёт с тем, что runtime реально выделил.
Актуальный vLLM имеет отдельные значения kv_cache_memory_bytes, kv_cache_size_tokens и kv_cache_max_concurrency. Если размер KV-cache не задан вручную, engine может определить его из доступной GPU memory и gpu_memory_utilization.
Нас интересуют как минимум такие данные:
Runtime result | Что проверяем |
weights / non-KV footprint | сколько памяти осталось вне cache |
KV memory allocation | сколько GPU memory реально отдано cache |
KV capacity in tokens | сколько token positions способен разместить engine |
max concurrency at max_model_len | memory-side теоретический предел |
peak memory под workload | что происходит уже под рабочей нагрузкой |
Если расчёт ожидал один порядок cache capacity, а runtime показывает заметно другой, расхождение нужно объяснить до выбора железа.
Maximum concurrency в runtime — не SLA
Допустим, engine сообщает, что cache позволяет держать условно 20× sequences максимальной длины.
Это не означает:
сервер выдерживает 20 одновременных пользователей с нужной latency.
kv_cache_max_concurrency в текущем vLLM определяется именно как per-DP-engine maximum concurrency при max_model_len. Это memory-side характеристика cache capacity.
Production capacity дополнительно зависит от compute, batching, prompt/output distribution и требований к latency.
Поэтому после memory validation всё равно нужен workload test с целевыми TTFT, ITL и throughput.
Memory capacity ≠ performance capacity.
Dynamic и Static Cache нельзя считать одинаково
До сих пор основная арифметика описывала логический KV payload, растущий с token positions.
Но конкретный cache implementation тоже важен.
Transformers DynamicCache увеличивает cache по мере генерации. StaticCache, наоборот, заранее выделяет cache до заданного maximum size, что позволяет использовать определённые compile optimizations ценой более высокого расхода памяти и потенциально неиспользованного пространства для коротких sequences.
Следовательно:
Именно поэтому worksheet должен фиксировать inference engine и cache implementation.
Когда стандартная KV-формула перестаёт работать
Даже правильная формула:
2 × layers × KV_heads × head_dim × bytes × tokens
не должна механически применяться к любой LLM.
Архитектура/cache | Что происходит |
Full attention + standard KV | базовая линейная формула применима |
Sliding-window attention | cache соответствующих layers ограничивается window |
Chunked attention | cache соответствующих layers ограничивается chunk size |
Hybrid attention | разные groups/layers могут иметь разную структуру cache |
MLA и специализированные attention | representation состояния отличается от обычного MHA/GQA |
Attention-free / state-space layers | стандартный Key/Value tensor вообще не описывает всю state memory |
Static Cache | физическая память может резервироваться заранее |
Transformers прямо указывает, что Dynamic Cache для sliding-window и chunked attention перестаёт расти на соответствующих layers после достижения размера окна/chunk.
Это означает, что правильный первый вопрос звучит не:
«Сколько параметров у модели?»
а:
«Какой attention/cache architecture у exact checkpoint?»
Почему parameter count почти ничего не говорит о KV-cache
Количество параметров хорошо помогает оценить weight footprint.
KV-cache для нашей standard GQA-схемы определяется другим набором величин:
attention layers
×
KV heads
×
head dimension
×
active token positions
×
KV dtype
Поэтому две модели с похожим parameter count могут заметно различаться по KV-cache.
И наоборот, нельзя строить универсальную линейку:
8B → X cache
70B → Y cache
400B → Z cache
только из числа параметров.
Для MoE и новых attention architectures такая таблица становится ещё менее надёжной.
Полный порядок расчёта VRAM
Практически sizing можно свести к следующей последовательности:
1. Зафиксировать exact model ID и revision
↓
2. Определить фактический weight format
↓
3. Оценить weight footprint
↓
4. Проверить attention/cache architecture
↓
5. Найти layers, KV heads и head dimension
↓
6. Рассчитать raw KV bytes/token
↓
7. Зафиксировать KV-cache dtype
↓
8. Описать Typical / Heavy / Limit workload
↓
9. Получить aggregate active tokens
↓
10. Рассчитать logical/raw KV requirement
↓
11. Запустить exact runtime/version
↓
12. Измерить non-KV footprint
↓
13. Проверить выделенную KV-cache capacity
↓
14. Запустить Heavy/Limit workload
↓
15. Зафиксировать production memory budget
Такой расчёт сложнее таблицы «70B = столько-то GB», но его можно воспроизвести и проверить.
Worksheet для расчёта VRAM
Перед подбором GPU полезно заполнить один паспорт:
MODEL
Exact model ID:
Revision:
Architecture:
WEIGHTS
Parameter count:
Weight dtype / quantization:
Estimated weight payload:
Actual checkpoint format:
KV ARCHITECTURE
Attention/cache type:
Attention layers:
Attention heads:
KV heads:
Head dimension:
KV-cache dtype:
Calculated raw KV bytes/token:
TYPICAL WORKLOAD
Input tokens:
Expected generated tokens:
Concurrent active sequences:
Aggregate active tokens:
Calculated raw KV:
HEAVY WORKLOAD
Input tokens:
Expected generated tokens:
Concurrent active sequences:
Aggregate active tokens:
Calculated raw KV:
LIMIT WORKLOAD
Maximum active sequence:
Maximum simultaneous sequences:
Aggregate active tokens:
Calculated raw KV:
RUNTIME
Inference engine:
Version:
Cache implementation:
Parallelism:
VALIDATION
Measured non-KV footprint:
Allocated KV memory:
KV capacity in tokens:
Measured peak VRAM:
Preemption/OOM boundary:
Operational headroom:
RESULT
Production memory budget per replica:
Последняя строка — результат SS-007.
Не «размер модели».
Не «сумма файлов checkpoint».
Как перейти от VRAM к количеству GPU
Предположим, расчёт и runtime validation показали, сколько памяти требуется одной рабочей replica.
Теперь появляется следующий вопрос:
Помещается ли этот budget на одной GPU, а если нет — как правильно распределить модель?
Простое:
150 GiB / 48 GB
не отвечает на него.
Multi-GPU deployment требует проверить Tensor/Pipeline Parallelism, фактическое распределение weights и KV-cache между ranks, topology, а затем уже определить число replicas под нагрузку.
Поэтому расчёт удобно разделять на два этапа:
SS-007
Сколько памяти требует одна production replica?
↓
SS-006
Как разместить эту replica по GPU
и сколько replicas требуется?
Так не смешиваются memory sizing и server sizing.
Как правильно рассчитать VRAM для LLM
Для standard decoder LLM расчёт начинается с exact checkpoint, а не с числа вроде 70B.
Сначала определяется weight footprint.
Затем из architecture config берутся attention layers, KV heads и head dimension. По ним считается raw KV-cache на token position.
После этого cache/token умножается не автоматически на maximum context всех пользователей, а на workload: сколько token positions одновременно активно в Typical, Heavy и Limit scenarios.
Но полученное число остаётся расчётным.
Inference engine дополнительно использует non-KV memory, а physical cache allocation зависит от его реализации, parallelism и cache management. Поэтому финальную конфигурацию нужно подтвердить тем же checkpoint и runtime, которые планируются в production.
Если используется vLLM, особенно важно не считать weights дважды. Его non_kv_cache_memory уже включает weights вместе с peak activation и non-Torch allocations.
Итоговую логику можно записать так:
Measured non-KV footprint
+
Required KV-cache allocation
+
Operational headroom
=
Production VRAM budget
Для другого profiler состав его метрик сначала нужно проверить по документации.
Самое короткое правило остаётся тем же:
И только после этого имеет смысл выбирать 48, 80, 96, 141 GB на GPU или переходить к multi-GPU конфигурации.
Рассчитать память под вашу LLM
Для первичного расчёта нужны exact model ID/checkpoint и revision, precision или quantization weights, inference engine и его версия, KV-cache dtype, типичная и тяжёлая длина input/output, ожидаемое число одновременно активных sequences и выбранный класс GPU.
По этим данным можно получить weight/KV estimate, сформировать Typical/Heavy/Limit memory scenarios и определить, что необходимо подтвердить нагрузочным запуском перед выбором серверной конфигурации.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


