Две replicas LLM-сервиса ещё не означают, что система действительно переживёт отказ одного узла.
Во время аварии важно не только:
поднялся ли replacement;
перестал ли router выбирать неисправный backend.
Нужно понять, что произошло с реальными запросами:
какие уже выполнялись на отказавшем узле;
какие пришли после отказа;
какие завершились ошибкой;
какие были повторены;
что произошло со streaming responses;
выдержали ли оставшиеся replicas перераспределённую нагрузку;
когда сервис вернулся сначала в допустимый degraded state, а затем — в normal SLO;
восстановилась ли полная planned capacity, если этого требует архитектура.
Поэтому корректный тест строится так:
Availability Requirement → Exact Failure Scenario → Failure Domain Map → Healthy Baseline → Probe Contract → Representative Fixed Load → Cache-State Policy → Request-Level Evidence → Failure Injection → Detection → Routing Reaction → In-Flight Request Outcomes → Degraded Capacity → Replacement Readiness → Normal SLO Recovery → Full Capacity Recovery if Required → Repeat → Acceptance against Predefined Criteria.
Главный принцип:
Отказоустойчивость LLM-инференса доказывается поведением сервиса и запросов при конкретном отказе, а не количеством replicas в конфигурации.
Сначала определите конкретный отказ
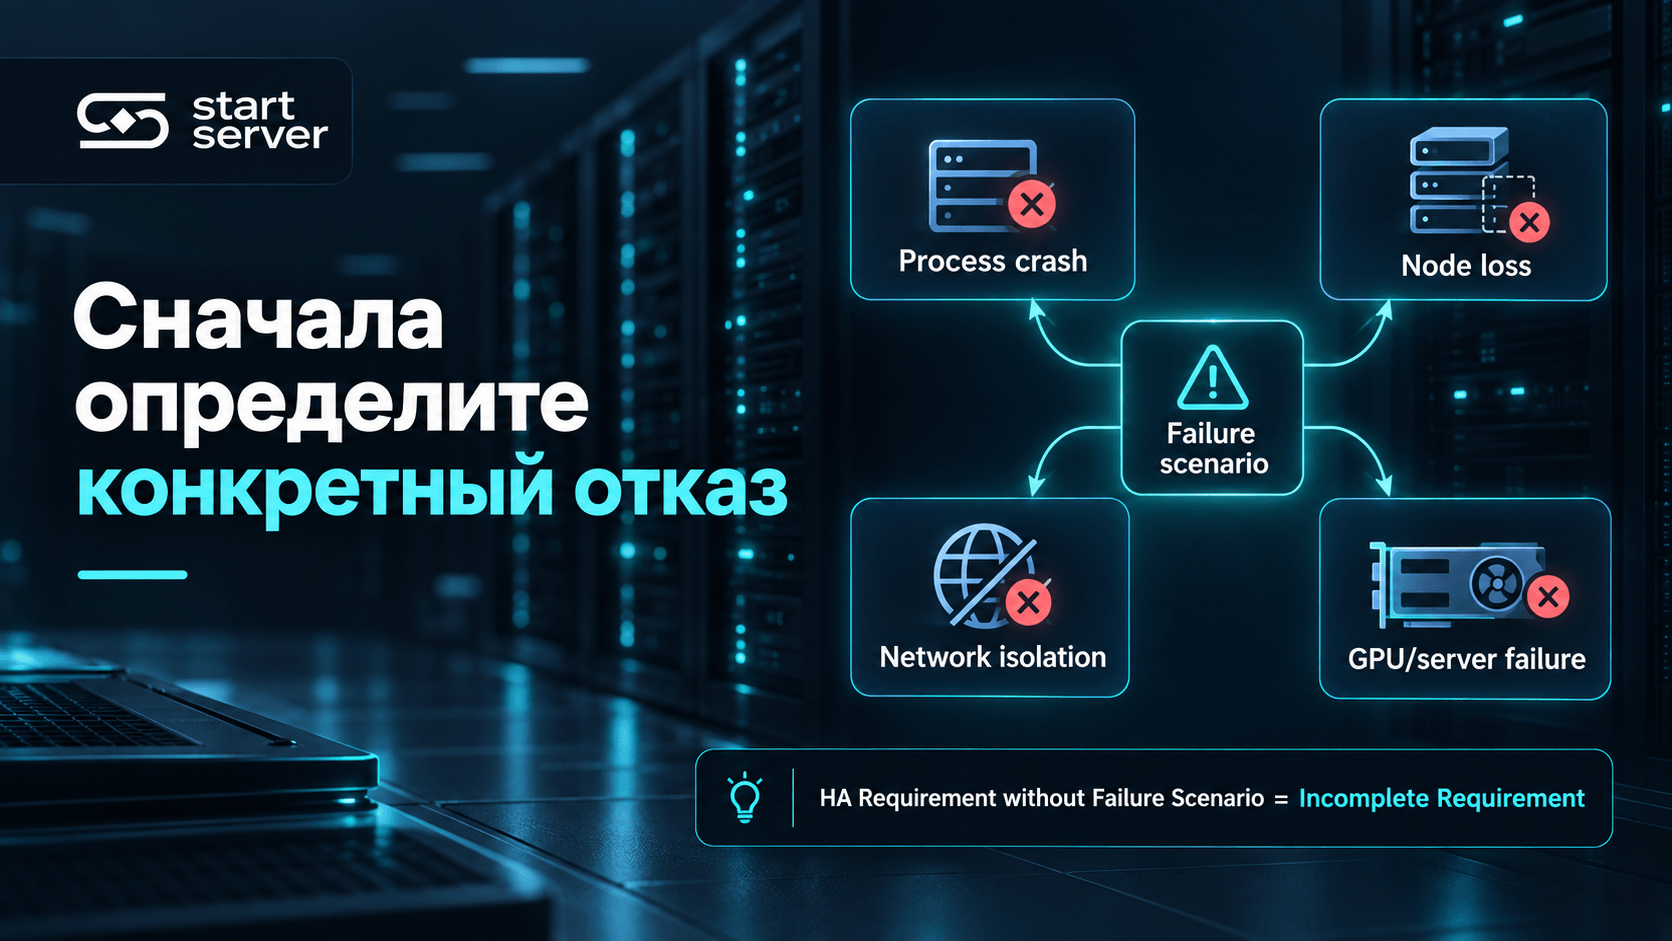
Требование:
«Нужна высокая доступность»
слишком общее для испытания.
Failure scenario может быть:
graceful termination serving process;
abrupt process crash;
container loss;
complete VM/node loss;
kernel failure;
network isolation node;
отказ GPU/server;
потеря backend connectivity;
planned maintenance/drain.
У этих сценариев разные:
detection mechanisms;
routing reactions;
возможности graceful drain;
последствия для in-flight requests.
Поэтому:
HA Requirement without Failure Scenario = Incomplete Requirement.
До стенда нужно сформулировать:
Какой failure domain должен стать недоступен и какое поведение обязан сохранить сервис после этого?
Graceful shutdown и hard failure — разные испытания
Graceful termination
Система получает возможность:
перестать принимать new traffic;
изменить readiness;
завершить часть in-flight work;
drain connections;
затем остановить process.
Hard failure
Например:
power loss;
kernel panic;
network partition;
abrupt process disappearance.
Здесь orderly drain может отсутствовать полностью.
В Kubernetes terminating endpoints остаются в EndpointSlice на время завершения, получают terminating=true, а их обычное ready становится false.
Отдельный serving condition позволяет consumers учитывать состояние endpoint во время draining.
Поэтому:
Graceful Drain PASS ≠ Hard Node-Failure PASS.
Не проверяйте node failure только graceful Pod deletion
Если requirement:
пережить физический отказ inference node,
а experiment:
аккуратно удалить Pod с grace period,
тестируется другой failure mode.
Graceful deletion полезен как:
planned drain test.
Но не заменяет:
hard node-loss test.
Что на самом деле гарантирует PDB
Kubernetes PodDisruptionBudget ограничивает поддерживаемые voluntary disruptions, выполняемые через Eviction API, например при kubectl drain.
Involuntary disruptions вроде hardware failure или node disappearance PDB предотвратить не может.
Кроме того, Kubernetes отдельно предупреждает, что не все voluntary actions ограничиваются PDB: прямое удаление Pod или Deployment может его обойти.
Поэтому:
PDB Configured ≠ Involuntary Node Failure Protected.
И точнее:
PDB Protection ≠ Protection from Every Voluntary Pod Removal.
Шаг 1. Постройте карту failure domains
Допустим, настроены две replicas.
Они могут оказаться:
на одном physical server;
на двух VM одного host;
в одном rack;
за общей network dependency;
зависеть от одного model storage;
использовать один routing component.
Тогда:
replica count > 1
ещё не означает независимую отказоустойчивость.
Формула:
Replica Count ≠ Independent Failure Domains.
Failure Domain Map
Компонент | Placement / Dependency |
|---|---|
Replica A | |
Replica B | |
Physical/VM node | |
GPU | |
Rack / zone | |
Router / load balancer | |
Model artifact source | |
Shared cache/storage | |
Network path | |
Scheduler/orchestrator | |
Recovery control dependency |
Цель:
определить, что именно исчезнет при потере выбранного failure domain.
Shared dependencies тоже входят в HA
Например:
inference replicas находятся на разных servers;
обе загружают weights из одного storage endpoint.
Active traffic может пережить потерю одного server.
Но replacement может не восстановить capacity при недоступном model source.
Поэтому HA map должна включать не только GPU workers.
Шаг 2. Подтвердите healthy baseline
Fault injection имеет смысл только после того, как healthy deployment стабильно выполняет workload requirement.
Зафиксируйте:
request rate;
concurrency;
input-token distribution;
output-token distribution;
streaming share;
success/error rate;
TTFT;
end-to-end latency;
throughput.
Если baseline уже нестабилен, нельзя надёжно отделить:
эффект отказа
от:
обычной перегрузки.
Healthy Endpoint ≠ Production-Capacity Baseline
Ответ:
/health = 200
не доказывает способность системы выдержать target inference traffic.
Baseline должен идти под representative load.
Шаг 3. Определите Probe Contract
Kubernetes различает:
startup probe;
readiness probe;
liveness probe.
Startup probe используется для initial startup и при её наличии блокирует liveness/readiness до успешного завершения.
Readiness определяет, должен ли Pod получать traffic.
Liveness — должен ли container быть перезапущен.
Поэтому:
Startup Probe ≠ Readiness Probe ≠ Liveness Probe.
Probe Contract Card
Mechanism | Что реально доказывает |
|---|---|
Startup probe | |
Readiness probe | |
Liveness probe | |
EndpointSlice | |
EndpointSlice | |
Application model-ready state | |
Representative inference check | |
SLO measurement |
Kubernetes Ready не означает автоматически «LLM готова»
Kubernetes исполняет probe, которую определило приложение.
Если readiness проверяет только:
TCP connection;
простой HTTP endpoint;
Kubernetes знает только результат этой проверки.
Он самостоятельно не доказывает:
что weights полностью загружены;
что GPU runtime инициализирован;
что target context работает;
что p95 соответствует requirement.
Поэтому:
Kubernetes Ready ≠ Application SLO Proven.
Transport Ready ≠ Inference Ready
TCP probe может быть корректной, если приложение само открывает port только после полной initialization.
Но TCP connection как таковое доказывает только transport-level contract.
Поэтому:
Transport Ready ≠ Inference Ready.
Probe должна соответствовать semantics конкретного serving stack.
Process Started ≠ Inference Ready
Replacement может пройти этапы:
Scheduled
→ Container Started
→ Server Process Started
→ Model Loading
→ Runtime Initialization
→ Ready for Traffic
→ Useful Inference Stable
→ Normal SLO Restored.
Эти события нельзя считать одним timestamp.
Replica Ready ≠ Service SLO Recovered Automatically
Даже backend, которому уже разрешено принимать traffic, может:
прогревать runtime/cache;
обслуживать backlog;
работать с повышенным TTFT;
находиться в состоянии общей перегрузки surviving service.
Поэтому readiness и normal SLO recovery измеряются отдельно.
EndpointSlice termination: важный нюанс
Current EndpointSlice API имеет conditions:
serving;terminating;ready.
Для Pod-backed endpoint serving связан с Pod Ready, а ready в общем случае соответствует serving && !terminating.
Но terminating endpoint — не абсолютная гарантия нулевого traffic.
Kubernetes указывает, что service proxies обычно игнорируют terminating endpoints, но могут использовать endpoint, который одновременно serving=true и terminating=true, если все доступные endpoints terminating.
Поэтому:
Terminating Endpoint ≠ Guaranteed Zero Traffic under Every Consumer Policy.
Не универсализируйте router behaviour
Фактическая маршрутизация зависит от:
kube-proxy/service implementation;
ingress;
Envoy;
NGINX;
HAProxy;
service mesh;
cloud/private load balancer.
Для real test зафиксируйте:
product;
version;
health configuration;
draining;
retry policy.
Особенно для:
HTTP/2;
streaming;
existing connections.
Шаг 4. Зафиксируйте workload
Request Load Card:
Поле | Значение |
|---|---|
Model/revision | |
Serving stack/version | |
Input-token distribution | |
Output-token distribution | |
Streaming share | |
Request rate | |
Peak concurrency | |
Client timeout | |
Retry policy | |
Prefix/cache-state policy | |
Warm-up policy | |
Normal SLO | |
Degraded-state requirement | |
Test duration |
Не тестируйте failover одним коротким prompt
Production workload может содержать:
длинный prefill;
RAG prompts;
long decode;
streaming;
burst concurrency.
Fault test должен отражать target workload достаточно хорошо, чтобы surviving-capacity result был meaningful.
Не меняйте load вместе с fault
Правильная последовательность:
Same Load
→ Fault Injection
→ Same Load Continues.
Если одновременно увеличился QPS, нельзя понять, какая часть degradation вызвана отказом.
Контролируйте cache state между runs
Repeated benchmarks могут перестать быть сопоставимыми, если второй run получает уже прогретый prefix cache.
vLLM предупреждает об этом в benchmark documentation и рекомендует контролировать cache reuse либо сбрасывать/перезапускать server, когда reuse не является частью experiment.
Поэтому:
Repeated Run ≠ Comparable Run if Cache State Changes.
Cache policy должна быть задана заранее
Например:
Cold / reset policy
Каждый test начинается без reuse нужного cache state.
Warm / reuse policy
Cache reuse является частью production scenario и сохраняется одинаково между runs.
Главное — не смешивать эти режимы.
Шаг 5. Разделите new и in-flight requests
New requests
Поступили после fault.
Они должны направляться в surviving path согласно routing policy.
In-flight requests
Уже выполнялись на failed backend.
Для них outcomes могут быть другими.
In-Flight Request ≠ Automatically Recoverable Request
Если inference node исчез во время generation:
execution state на нём потерян;
connection может оборваться;
retry может создать новую generation.
Нельзя универсально предполагать прозрачное продолжение с того же decode state.
Поэтому:
Request Retry ≠ Transparent Generation Continuation.
Если конкретный stack имеет state migration/recovery — это отдельное утверждение, которое нужно доказать его документацией и experiment.
Streaming нужно учитывать отдельно
Streaming client мог уже получить часть ответа до failure.
Нужно фиксировать:
сколько output было доставлено;
как stream завершился;
был ли retry;
что увидело приложение.
Possible outcome:
interrupted stream;
successful retry;
duplicate/ambiguous application output.
Это возможные классы, а не заранее известное поведение.
Request Outcome Ledger
Request ID | Backend | Start | Fault relation | Output delivered before fault | Retry | Client-visible outcome | Final latency |
|---|---|---|---|---|---|---|---|
before / in-flight / after |
Request ID должен позволять связать:
client → router → backend → final outcome.
Retry policy — часть тестируемой системы
Нужно знать:
кто retry'ит;
после какой ошибки;
сколько попыток;
timeout;
backoff;
допустим ли retry после partial streaming response.
Поэтому:
Failover Result without Retry Policy = Incomplete Result.
Retry не является универсально безопасным default
Окружающий workflow может иметь:
audit events;
tool calls;
billing;
side effects.
Даже чистая generation после retry может дать другой ответ.
Поэтому retry policy должна быть application-specific.
Шаг 6. Синхронизируйте evidence
Нужны timestamps от:
load generator;
client/API;
router/LB;
serving replicas;
orchestrator;
node monitoring.
Поэтому:
Unsynchronized Logs → Weak Failure Timeline.
Failure Timeline
Marker | Meaning |
|---|---|
T0 | stable healthy baseline |
T_fault | fault occurs |
T_detect | chosen mechanism detects fault |
T_route | failed backend stops being selected for regular new traffic according to policy |
T_degraded | surviving service stabilizes inside degraded requirement |
T_replacement_ready | replacement admitted to useful service, if applicable |
T_normal_slo | normal latency/error target restored |
T_full_capacity | full planned capacity restored, if applicable |
T_route не означает «на backend больше не пришёл ни один packet»
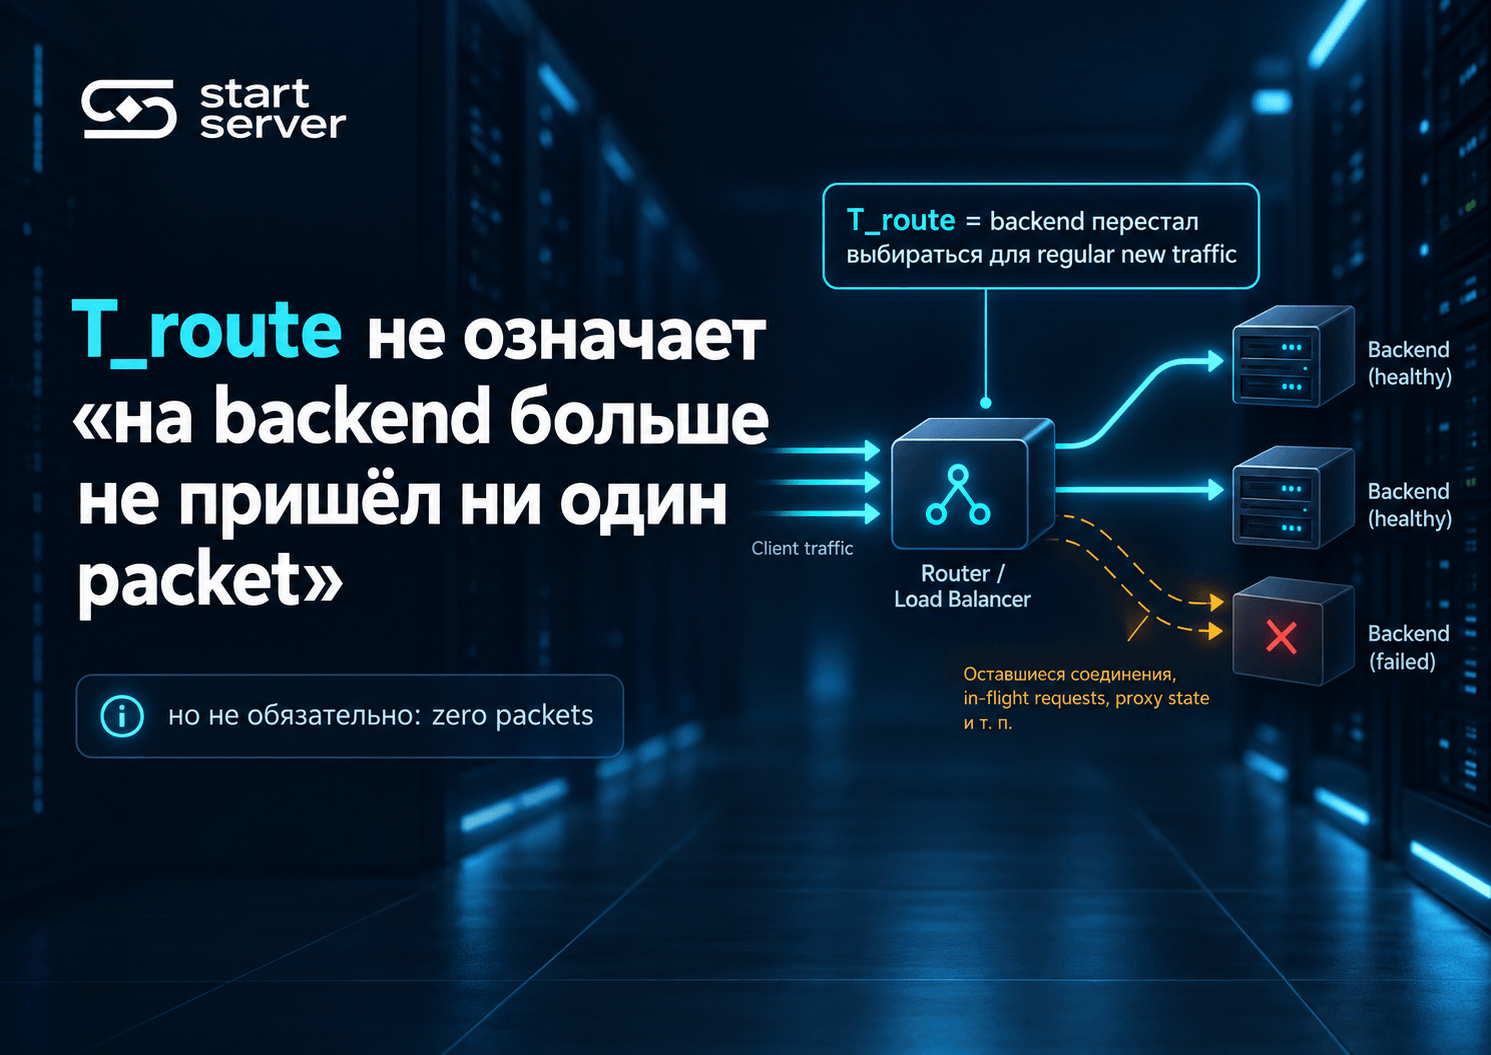
Существовать могут:
existing connections;
in-flight requests;
proxy state;
special handling terminating endpoints.
Поэтому определение должно быть точным:
failed backend перестал выбираться для regular new traffic согласно routing policy.
Failure Detection ≠ Traffic Recovery
Monitoring может обнаружить проблему быстрее router.
Или router может перестать использовать backend раньше, чем central alert появится.
Поэтому:
T_detect;
T_route
измеряются отдельно.
Backend Removal ≠ Full Service Recovery
Router может успешно исключить backend, а system всё равно нарушить requirement из-за:
queue growth;
retries;
surviving-replica overload;
повышенного TTFT.
Поэтому:
routing recovery ≠ service recovery.
Четыре уровня восстановления
1. Routing Recovery
Failed backend больше не получает regular new traffic согласно policy.
2. Degraded-Service Recovery
Surviving capacity стабилизировалась внутри допустимого degraded requirement.
3. Normal SLO Recovery
Latency/error показатели вернулись в normal target.
4. Full-Capacity Recovery
Полный planned capacity восстановлен, если это требуется architecture/test plan.
Эти timestamps могут быть совершенно разными.
Full capacity recovery не всегда обязательна
Некоторые architectures должны автоматически восстановить replacement.
Другие могут работать degraded до:
scheduled repair;
operator intervention.
Поэтому T_full_capacity включается только если это действительно acceptance requirement.
Шаг 7. Проверьте surviving capacity
Допустим, healthy deployment имеет N replicas.
После потери failure domain остаётся меньше capacity.
Эта capacity должна выдержать:
new traffic;
redistributed workload;
retries;
queue growth.
Поэтому:
Replica Redundancy without Surviving Capacity ≠ High Availability.
Не задавайте универсальный spare percentage
Нет универсального:
«для HA всегда нужен 50% reserve».
Headroom зависит от:
replica layout;
target failure domain;
workload;
replacement speed;
degraded SLO.
Его нужно выводить из target scenario.
Normal SLO и degraded-state requirement могут различаться
Например, проект может разрешать после single-node failure:
более высокий p95;
меньший throughput;
в течение ограниченного интервала.
В другом проекте degradation недопустима.
Поэтому Test Card должна иметь два разных поля:
Normal SLO
и:
Degraded-State Requirement.
Degraded Capacity Table
Metric | Healthy | Degraded | Requirement |
|---|---|---|---|
Throughput | |||
Request queue | |||
TTFT | |||
E2E latency | |||
Error rate | |||
Running requests | |||
KV-cache pressure |
Retry storm тоже входит в degraded test
После failure часть requests может повториться.
Surviving replicas тогда получают:
New Traffic + Retry Traffic.
Это может вызвать secondary overload даже при достаточной capacity для обычного steady-state traffic.
Шаг 8. Используйте serving telemetry корректно
Current vLLM exposes production metrics, включая:
vllm:num_requests_running;vllm:num_requests_waiting;vllm:kv_cache_usage_perc;vllm:request_success;vllm:e2e_request_latency_seconds;vllm:inter_token_latency_seconds.
Они полезны как server-side evidence.
Но трактовать их нужно точно.
num_requests_running — не число client connections
Это engine/scheduler-side metric.
Она показывает requests, находящиеся в model execution state, а не весь внешний service concurrency.
num_requests_waiting помогает увидеть queue pressure
После loss replica полезно смотреть:
растёт ли waiting queue?
Это может показать, что surviving capacity недостаточна.
Но metric не заменяет client-observed latency.
kv_cache_usage_perc — ratio
Если metric имеет значение:
0.85
это соответствует 85% utilization, если dashboard не преобразует шкалу.
Не путать raw ratio и displayed percent.
request_success не заменяет request ledger
Aggregate counter не отвечает:
какой request потерян;
был ли он retry;
что увидел streaming client.
Поэтому:
Aggregate Success Counter ≠ Request-Level Failover Evidence.
Client-side measurement обязательно
Для user-visible incident особенно важна latency на стороне load generator/client, потому что она включает:
routing;
network;
queueing;
retry;
serving.
Server-side metrics нужны, но не являются полным verdict.
TTFT, ITL и TPOT — разные метрики
Current vllm bench serve определяет TTFT как время от отправки request до получения первого streamed output.
ITL измеряет интервалы между последовательными streamed outputs.
TPOT рассчитывается для request как:
TPOT = (E2E latency − TTFT) / (output tokens − 1)
и затем агрегируется.
При speculative decoding один streamed output может содержать несколько tokens, поэтому ITL и TPOT не обязаны совпадать.
Следовательно:
ITL ≠ TPOT by Definition.
Для failover они отвечают на разные вопросы
TTFT
Полезна для:
новых requests после failure;
retried requests;
queue/routing delay.
ITL
Полезна для:
streaming jitter;
gaps во время active generation.
E2E
Показывает полный user-visible completion.
Не обязательно делать каждую metric отдельным PASS/FAIL gate.
Названия метрик между tools могут отличаться
vLLM предупреждает, что benchmark terminology не стандартизирована и сравнивать нужно measurement points и formulas, а не только название metric.
Поэтому:
Same Metric Name ≠ Same Measurement Definition Across Tools.
Time-Series Metrics + Request-Level Ledger
Нужны оба слоя.
Time series
Показывают:
queue;
utilization;
latency distribution;
cache pressure.
Request ledger
Показывает:
конкретный request;
backend;
retry;
client-visible outcome.
Только вместе они дают полноценную failover картину.
Шаг 9. Опишите failure injection точно
Не:
«выключили сервер».
А:
target;
exact action;
exact timestamp;
affected layer;
expected consequence.
Failure Injection Matrix
Scenario | Fault | Graceful | Проверяемый механизм |
|---|---|---|---|
A | planned Pod/service termination | yes | drain lifecycle |
B | abrupt serving process loss | no | process recovery/routing |
C | complete node loss | no | node-level HA |
D | network isolation | no | detection/routing timeout |
E | planned node drain | yes | maintenance path |
Не обязательно выполнять всю matrix сразу.
Сначала выбирается наиболее material failure requirement.
Шаг 10. Задайте acceptance criteria до fault
Нельзя увидеть результат, а потом решить:
«Наверное, достаточно хорошо».
Заранее определить:
допустимы ли lost requests;
допустимы ли retries;
acceptable streaming behaviour;
degraded latency;
minimum surviving throughput;
normal SLO recovery target;
full capacity recovery target, если нужен.
Численные values проектные.
Availability SLA ≠ Complete Failure-Test Acceptance Criteria
SLA за месяц не говорит:
сколько запросов можно потерять в конкретной аварии;
разрешён ли retry;
сколько может длиться degraded state.
Поэтому fault test требует собственного acceptance contract.
Acceptance Gate
PASS возможен, если одновременно:
Expected Failure Was Actually Injected
Detection Met Project Requirement
Failed Backend Stopped Receiving Regular New Traffic according to Policy
In-Flight Outcomes Met Defined Policy
Surviving Capacity Met Degraded Requirement
Normal Latency/Error SLO Recovered within Threshold
Full Capacity Recovery Met Requirement, if applicable
Evidence Complete.
Это project methodology, а не универсальный отраслевой standard.
Один успешный failover ещё ничего не доказывает полностью
Fault result зависит от:
timing;
queue state;
cache state;
retries;
request mix.
Поэтому:
One Successful Failover ≠ Proven Reliability.
Количество repeats определяется risk и acceptance process.
Fault timing нужно фиксировать
Failure может произойти:
idle;
во время prefill;
во время long decode;
при большой queue.
Representative test желательно проводить под active target load.
Retest: одна controlled change за раз
Если первый run провален, не меняйте одновременно:
health interval;
retry count;
timeout;
replica count;
readiness.
Лучше:
One Controlled Change
→ Same Failure Scenario
→ Same Workload
→ Same Cache Policy
→ Retest.
LLM Inference Failover Test Pack
Availability Requirement Card
Поле | Значение |
|---|---|
Critical service | |
Failure scenario | |
Target workload | |
Allowed request loss | |
Retry policy | |
Streaming policy | |
Normal SLO | |
Degraded-state requirement | |
Normal-SLO recovery target | |
Full-capacity recovery requirement |
Failure Domain Map
Physical and logical dependencies.
Probe Contract Card
Startup/readiness/liveness and actual traffic-admission semantics.
Request Load Card
Prompt/output/concurrency/cache policy.
Failure Injection Matrix
Exact fault.
Request Outcome Ledger
Client-visible result каждого affected request.
Failure Timeline
Detection → routing → degraded state → normal SLO → full capacity.
Degraded Capacity Table
Surviving performance.
Acceptance Gate
PASS / FAIL.
Evidence Pack
Raw configuration and logs.
Result Table
Run | Fault | Detect | Routing | Lost Requests | Interrupted Streams | Degraded Stabilization | Normal SLO Recovery | Full Capacity |
|---|---|---|---|---|---|---|---|---|
Пока controlled stand не выполнен, таблица остаётся template.
Failure Evidence Pack
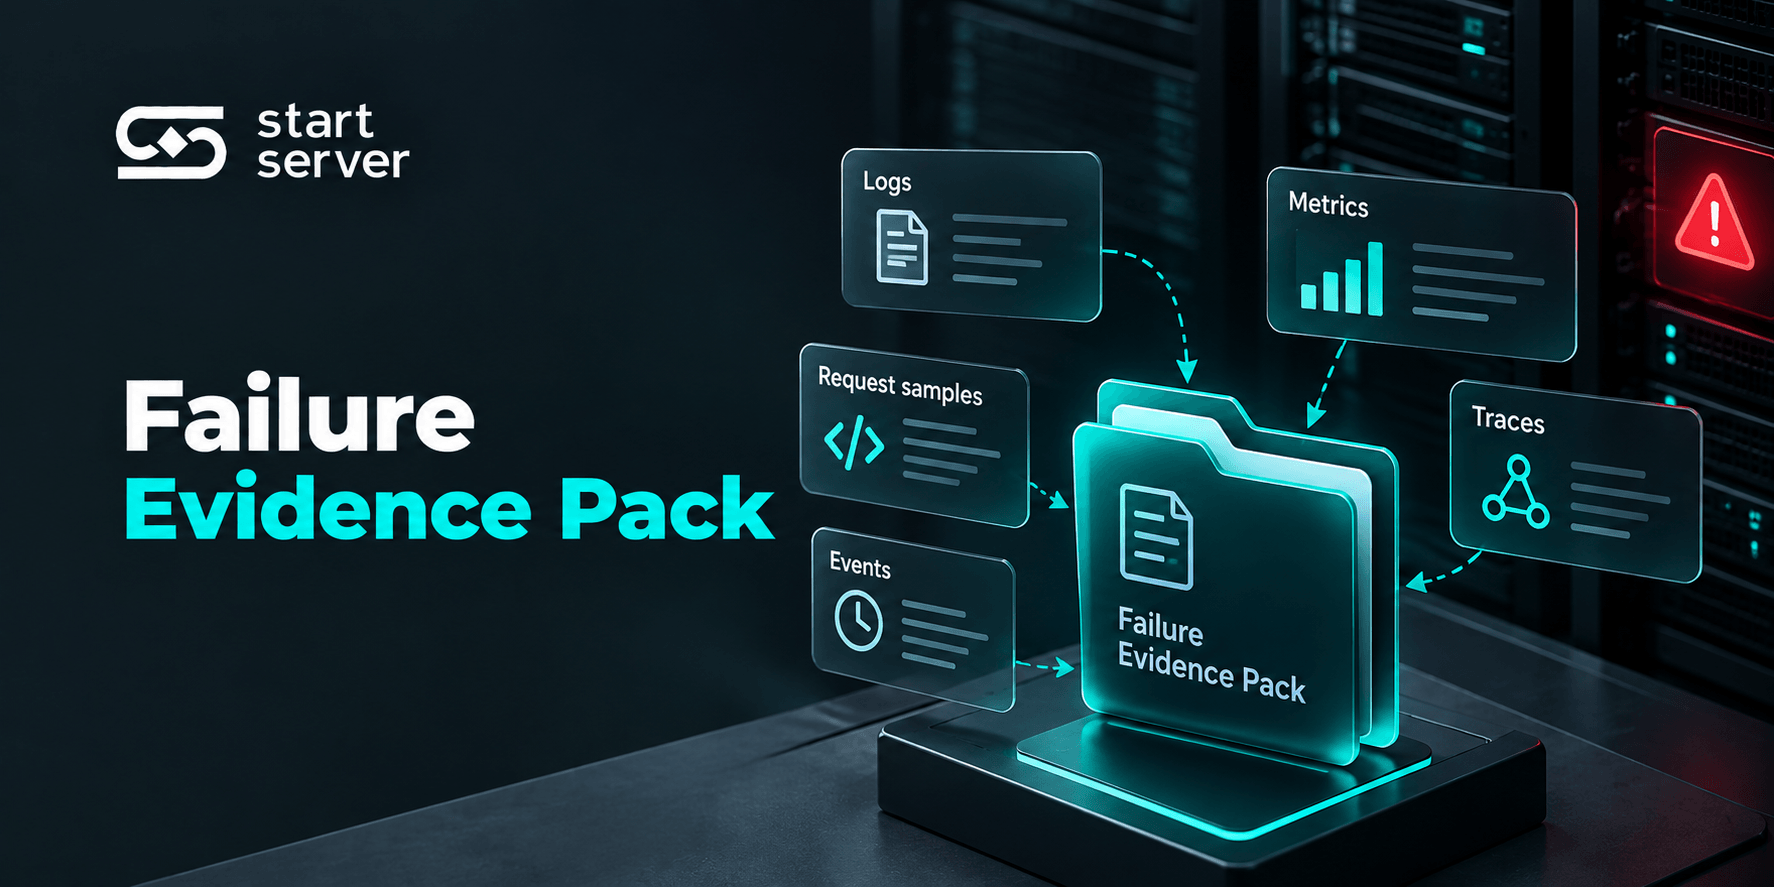
Architecture
replicas;
physical/virtual nodes;
failure domains;
router;
model source;
shared dependencies.
Software
serving version;
router/load-balancer version;
orchestrator;
load generator/client.
Probes
startup contract;
readiness contract;
liveness contract.
Workload
model;
prompt/output distribution;
concurrency;
streaming;
cache-state policy.
Fault
target;
action;
timestamp.
Requests
IDs;
backend;
output before fault;
retry;
final client outcome.
Routing
health state;
EndpointSlice/backend state;
routing decision.
Serving
running/waiting;
KV-cache pressure;
latency metrics;
engine state.
Recovery
replacement lifecycle;
readiness;
degraded stabilization;
normal SLO;
full capacity if applicable.
Когда можно использовать result-driven H1
Заголовок:
Проверка отказа узла инференса: что произошло с запросами на стенде
можно использовать только при наличии:
Evidence | Ready? |
|---|---|
Exact architecture | |
Node/GPU placement | |
Failure-domain map | |
Probe contracts | |
Serving version | |
Router config/version | |
Representative workload | |
Cache-state policy | |
Exact fault | |
Synchronized timestamps | |
Request IDs | |
Client logs | |
Router logs | |
Serving metrics/logs | |
Orchestrator/node events | |
Retry policy | |
Streaming outcomes | |
Degraded-capacity results | |
Acceptance criteria | |
Repeated runs | |
Raw evidence |
Что нельзя придумывать
Не писать:
«переключение заняло три секунды».
Не придумывать:
number of lost requests;
retry success;
p95 recovery;
warm-up interval;
interrupted streams.
Не обещать:
zero downtime
без точного definition и controlled evidence.
Zero downtime тоже требует definition
Оно может означать:
new requests не падают;
нет request loss;
не рвутся streams;
SLO не нарушается вообще.
Это разные требования.
Поэтому phrase без acceptance definition малоинформативна.
Связь с проектированием HA-требований
На этапе проектирования сначала определяется:
какое availability requirement должно попасть в specification?
Failover testing отвечает на следующий вопрос:
выполняет ли deployment это requirement при fault injection?
Связка:
HA Requirement → HA Validation.
Связь с общей программой приёмки GPU-сервера
В общей программе приёмки reliability может быть одним из направлений проверки.
Здесь этот branch детализируется до:
конкретного fault;
судьбы requests;
routing reaction;
degraded capacity;
recovery.
То есть общий acceptance test и глубокое failover validation решают разные уровни задачи.
Связь с production monitoring
Production monitoring отвечает на вопрос:
что наблюдать постоянно?
Failover test отвечает на другой:
как намеренно создать controlled failure и проверить реакцию системы?
Metrics могут пересекаться.
Цель различается.
Kubernetes — только пример
Методика применима также к:
VM;
bare metal;
другим orchestrators;
proprietary serving platforms.
Kubernetes используется для конкретных примеров:
probes;
EndpointSlice;
PDB;
drain.
Failure Test Decision Tree
Exact failure scenario defined?
Нет
→ HA test невозможно корректно поставить.
Да ↓
Failure domains mapped?
Нет
→ replica count недостаточен как evidence.
Да ↓
Healthy baseline выполняет normal SLO?
Нет
→ сначала исправить baseline.
Да ↓
Probe contract понятен?
Нет
→ нельзя интерпретировать readiness/replacement state.
Да ↓
Representative workload и cache policy fixed?
Нет
→ runs несопоставимы.
Да ↓
Request IDs и synchronized evidence есть?
Нет
→ request outcomes нельзя надёжно восстановить.
Да ↓
Injected fault соответствует requirement?
Нет
→ тестируется другой scenario.
Да ↓
Routing reaction соответствует policy?
Нет
→ detection/routing gap.
Да ↓
In-flight requests соответствуют agreed policy?
Нет
→ retry/draining/application gap.
Да ↓
Surviving capacity выполняет degraded requirement?
Нет
→ redundancy/capacity gap.
Да ↓
Normal SLO восстановлен вовремя?
Нет
→ recovery gap.
Да ↓
Full capacity восстановлена, если требовалось?
Нет
→ replacement/recovery gap.
Да ↓
Результат повторяется при сопоставимом cache/workload state?
Нет
→ нужна дополнительная validation.
Да
→ HA requirement подтверждён в границах tested scenario.
Что подготовить к испытанию
Нужны:
model/revision;
serving stack/version;
deployment diagram;
replica count;
physical/VM placement;
router/load balancer;
orchestrator;
model source/storage;
probe configuration;
prompt/output distribution;
request rate;
peak concurrency;
streaming share;
retry/timeout policy;
cache-state policy;
normal SLO;
degraded requirement;
exact failure scenario.
CTA: Согласовать испытание отказоустойчивости.
Главное
Отказоустойчивость нельзя подтвердить фразой:
«У нас две replicas».
Сначала нужно доказать, что они покрывают независимый failure domain.
Затем — понять, что именно означают инфраструктурные signals.
В Kubernetes terminating endpoint имеет отдельные ready, serving и terminating conditions, причём proxies обычно исключают terminating endpoints из regular traffic, но спецификация допускает специальное routing behaviour, когда все endpoints terminating.
PDB тоже не является общей страховкой: он ограничивает поддерживаемые voluntary evictions, но не предотвращает involuntary node failure и может быть обойдён direct Pod/Deployment deletion.
Readiness сообщает только то, что проверяет конкретный probe.
Kubernetes способен остановить regular traffic к Pod с failed readiness, но сам по себе не знает, загрузилась ли LLM и выполняет ли backend latency requirement.
После fault нужно измерять отдельно:
Detection
→ Routing Reaction
→ Request Outcomes
→ Degraded-Service Recovery
→ Normal SLO Recovery
→ Full Capacity Recovery if Required.
Client-side metrics тоже нельзя смешивать: vLLM benchmark определяет TTFT как время от отправки request до first streamed output, ITL — как интервалы между streamed outputs, а TPOT — как derived time per output token.
При speculative decoding ITL и TPOT могут заметно различаться.
Поэтому сильный verdict звучит не:
«система отказоустойчива».
А:
При зафиксированной workload, cache policy и конкретном tested failure scenario deployment выполнил заранее заданные требования к routing, client-visible request outcomes, degraded capacity и восстановлению SLO. Вывод действует только для протестированной architecture, failure domain и нагрузки.
Ключевые правила:
HA Requirement without Failure Scenario = Incomplete Requirement.
Graceful Drain PASS ≠ Hard Node-Failure PASS.
PDB Configured ≠ Involuntary Node Failure Protected.
PDB Protection ≠ Protection from Every Voluntary Pod Removal.
Replica Count ≠ Independent Failure Domains.
Healthy Endpoint ≠ Production-Capacity Baseline.
Startup Probe ≠ Readiness Probe ≠ Liveness Probe.
Kubernetes Ready ≠ Application SLO Proven.
Terminating Endpoint ≠ Guaranteed Zero Traffic under Every Consumer Policy.
Unsynchronized Logs → Weak Failure Timeline.
Process Started ≠ Inference Ready.
Transport Ready ≠ Inference Ready.
Replica Ready ≠ Service SLO Recovered Automatically.
In-Flight Request ≠ Automatically Recoverable Request.
Request Retry ≠ Transparent Generation Continuation.
Failover Result without Retry Policy = Incomplete Result.
Backend Removal ≠ Full Service Recovery.
Replica Redundancy without Surviving Capacity ≠ High Availability.
Aggregate Success Counter ≠ Request-Level Failover Evidence.
ITL ≠ TPOT by Definition.
Same Metric Name ≠ Same Measurement Definition Across Tools.
Repeated Run ≠ Comparable Run if Cache State Changes.
Availability SLA ≠ Complete Failure-Test Acceptance Criteria.
One Successful Failover ≠ Proven Reliability.
Главная последовательность:
Availability Requirement
→ Exact Failure Scenario
→ Failure Domains
→ Healthy Baseline
→ Probe Contract
→ Fixed Representative Load
→ Controlled Cache State
→ Request-Level Evidence
→ Fault Injection
→ Detection
→ Routing Reaction
→ New + In-Flight Request Outcomes
→ Degraded Capacity
→ Replacement Readiness
→ Normal SLO Recovery
→ Full Capacity Recovery if Required
→ Repeat Comparable Run
→ Acceptance against Predefined Criteria
→ Evidence Pack.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


