Как спланировать эксперимент с batch size для обработки документов на GPU
Какой batch_size выбрать для пакетной обработки документов на GPU?
Универсального значения нет.
Даже batch_size=32, который является default для SentenceTransformer.encode() и encode_document(), не является рекомендацией использовать именно 32. Документация Sentence Transformers прямо советует проверить несколько batch sizes на собственном subset данных, потому что оптимальное значение зависит от hardware, размера модели, precision и длины inputs.
То же предупреждение есть в Transformers: batching способен как значительно ускорить GPU inference, так и замедлить его. Результат зависит от hardware, данных и модели; irregular sequence lengths способны резко увеличить padding overhead, а слишком большой batch — закончиться OOM.
Поэтому правильный вопрос звучит не:
«Какой batch size считается оптимальным?»
А:
Какой batch size даёт устойчивый throughput на нашей модели, нашем корпусе и нашем GPU, не нарушая memory, quality и stability constraints?
Рабочая последовательность:
Fixed Corpus → Fixed Model / Software → Define Batch Semantics → Fix Padding / Data Path → Define Output Check → Representative Warm-up → Batch Sweep → Repeated Runs → Throughput + Memory → Quality / Consistency → OOM / Failures → Efficient Region → Operational Batch.
Главный принцип:
Largest Batch that Fits ≠ Best Operational Batch.
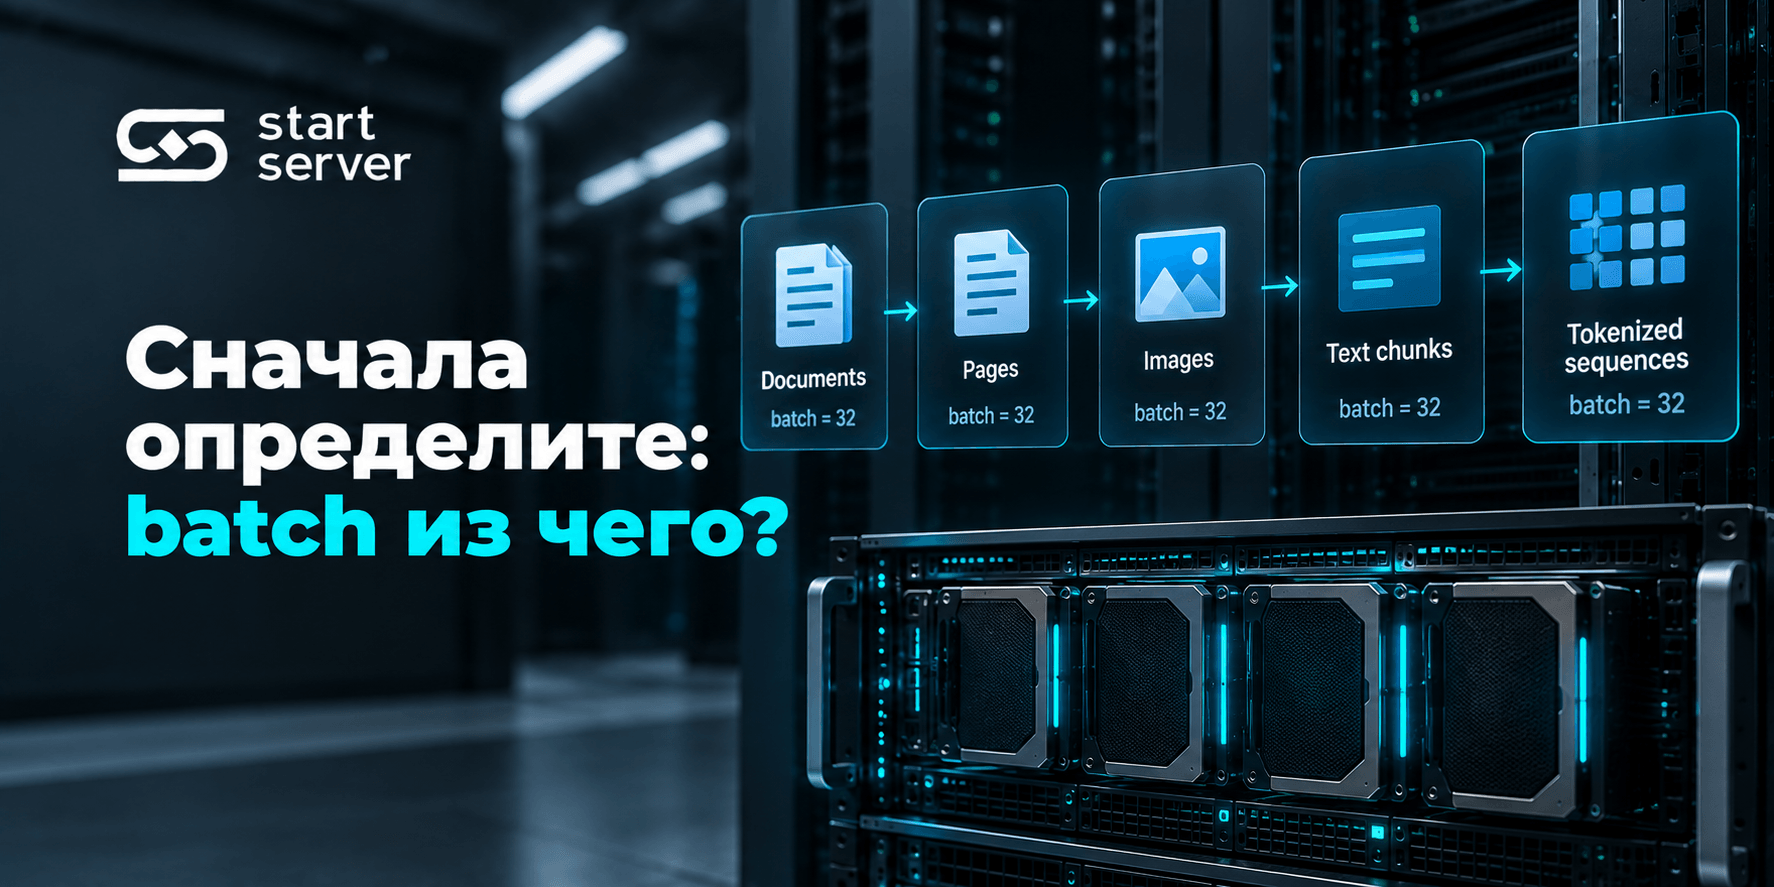
Сначала определите: batch из чего?
Число:
batch_size=32
само по себе ещё не описывает workload.
В document pipeline batch может означать:
32 исходных документа;
32 pages;
32 images;
32 text chunks;
32 tokenized sequences;
32 passages для embedding;
32 query-document pairs для reranking.
Поэтому первое обязательное поле Experiment Card:
Batch Unit.
Если в одном run batch=32 означает 32 исходных документов, а в другом — 32 chunks, это уже разные workloads.
Same Batch Size Number ≠ Same Workload Unit.
Default Batch Size ≠ Optimal Batch Size
В актуальном API Sentence Transformers методы encode(), encode_document() и encode_query() имеют default batch_size=32.
Но рядом с этим documentation прямо рекомендует benchmark нескольких значений на небольшом subset собственных данных.
Следовательно:
Default Batch Size ≠ Optimal Batch Size.
Default нужен как стартовое значение API.
Operational setting определяется измерением.
Не смешивайте inference batch size и training batch size
Training batch size связан с:
gradient accumulation;
optimizer;
learning rate;
convergence;
global effective batch.
В этой статье рассматривается другая задача:
offline inference / document processing.
Здесь batch size — число inputs, которые pipeline совместно передаёт на очередной inference step.
Не смешивайте offline batch size и serving concurrency
Для online LLM serving важны:
request rate;
concurrency;
scheduler;
continuous batching;
TTFT;
latency.
В offline document processing обычно есть конечный corpus, который нужно обработать.
Поэтому:
Offline Batch Size ≠ Serving Concurrency.
И:
Static Batch Experiment ≠ Continuous-Batching Benchmark.
Вывод:
batch_size=64оказался удачным для offline embeddings
нельзя переносить в:
concurrency 64 оптимальна для LLM API.
Почему чужой benchmark не даёт ваш batch size
Transformers прямо формулирует практическое правило:
измерять performance на своей нагрузке и своём hardware.
Документация отдельно показывает, что batching может дать как ускорение, так и серьёзное замедление, а большой batch при неблагоприятной длине sequences способен закончиться CUDA OOM.
Отсюда:
Best Batch Size is Workload-Specific.
Выберите одну конкретную pipeline
Не стоит одним experiment пытаться оптимизировать одновременно:
OCR;
embeddings;
classification;
reranking;
summarization;
VLM extraction.
У них разные:
input shapes;
preprocessing;
memory profile;
compute pattern.
Для каждого нужен отдельный batch-size sweep.
Для document/RAG pipeline удобным примером может быть:
document chunk → tokenizer → encoder → embedding.
Но методика статьи применима и к другим inference tasks.
Зафиксируйте corpus
До первого run создайте Corpus Profile.
Поле | Значение |
|---|---|
Corpus ID / hash | |
Source documents | |
Model inputs/chunks | |
Total input tokens | |
File/type distribution | |
Input-length distribution | |
Corpus order | |
Preprocessing version |
Нельзя сравнивать:
batch 8
на одной выборке
и:
batch 64
на другой.
Different Corpus ≠ Batch-Size Comparison.
Средней длины input недостаточно
Два корпуса могут иметь одинаковый mean input length, но совершенно разное распределение.
Например:
Corpus A
почти все inputs около одной длины.
Corpus B
много коротких inputs и небольшой tail очень длинных.
Для token-sequence pipelines это существенно, потому что batched tensors обычно требуют rectangular shapes. Transformers поддерживает padding до longest sequence в batch или до фиксированного max_length.
Один длинный input внутри batch способен увеличить padding work для остальных.
Поэтому сохраняйте не только average, но хотя бы:
min;
median;
upper percentile;
max.
Лучше — полное distribution.
Главная формула:
Same Mean Length ≠ Same Batch Workload.
Padding является частью workload
Для token-sequence pipelines зафиксируйте:
padding;truncation;
max_length;bucketing/sorting.
В Transformers:
padding=True/longestозначает padding до самой длинной sequence текущего batch;padding="max_length"— до заданного или model maximum length;padding=False— без padding.
Это разные workloads.
Поэтому:
Same Batch Size + Different Padding Strategy ≠ Same Workload.
Но не переносите padding-логику на любую document pipeline
Этот вывод относится прежде всего к token-sequence models.
Vision, OCR или multimodal pipeline могут иметь:
image resizing;
tiling;
frame batching;
собственную shape policy.
Поэтому в Experiment Card фиксируйте именно тот shape/preprocessing behaviour, который реально использует ваша pipeline.
Bucketing по длине — отдельная переменная
Если inputs предварительно группируются по похожей длине, padding overhead может уменьшиться.
Но тогда разницу нельзя полностью приписать batch size.
Сравнение:
Run A
random order
и:
Run B
length bucketing
исследует уже две переменные.
Если цель:
влияние только batch size,
bucketing strategy должна быть фиксированной.
Зафиксируйте precision правильно
Слово precision может означать разные вещи.
Нужно отдельно хранить:
Model execution dtype
Например:
FP32;
FP16;
BF16.
Output representation / quantization
Например, Sentence Transformers encode() имеет отдельный параметр precision для output embeddings с вариантами float32, int8, uint8, binary, ubinary.
Это не обязательно то же самое, что compute dtype самой модели.
Поэтому:
Different Execution Precision ≠ Batch-Size-Only Experiment.
И отдельно:
Different Output Representation ≠ Same Output Pipeline.
Зафиксируйте software baseline
Experiment Card должен содержать:
model ID;
model revision;
tokenizer/processor;
framework;
framework version;
pipeline/runtime version;
driver;
CUDA/ROCm;
GPU SKU/count;
CPU;
RAM.
Иначе результат:
batch 64 = X inputs/s
будет трудно воспроизвести.
Меняйте одну главную переменную
Основная independent variable:
Batch Size.
Можно использовать sweep:
1 → 2 → 4 → 8 → 16 → 32 → ...
но это только пример.
Нет требования:
использовать только степени двойки;
тестировать фиксированный максимальный batch.
Важно другое:
между runs все остальные параметры должны оставаться одинаковыми.
Multiple Changing Variables ≠ Controlled Batch-Size Experiment.
Data pipeline тоже нужно заморозить
Не меняйте одновременно с batch size:
num_workers;prefetch;
pinned memory;
file-read concurrency;
CPU preprocessing parallelism.
Иначе experiment исследует:
batch size + data-loading optimization.
Лучше:
Experiment A — Batch Size
потом:
Experiment B — Data Path.
Почему нужно наблюдать CPU и I/O
Document pipeline часто включает:
file read;
PDF parsing;
image decode;
tokenization;
chunking;
serialization;
database/network output.
Если bottleneck находится вне GPU, увеличение batch size может почти не менять E2E throughput.
Поэтому:
Low Pipeline Throughput ≠ Automatically Too-Small Batch.
Разделите model-only и end-to-end timing
Это одна из главных технических границ.
Model-only timing
Измеряет GPU/model interval.
Для такого измерения можно использовать:
accelerator-aware benchmark utility;
CUDA Events + synchronization;
profiler.
PyTorch использует CUDA Events и torch.cuda.synchronize() в своих примерах точного GPU timing.
End-to-End timing
Измеряет полную pipeline:
read → preprocess → transfer → model → postprocess → write.
Для него нужен wall-clock timer с корректной completion boundary — нельзя остановить таймер до того, как относящаяся к run asynchronous GPU work реально завершилась.
Поэтому:
Model Throughput ≠ Pipeline Throughput.
Почему обычный Python timer может ошибиться на CUDA
CUDA operations выполняются асинхронно относительно host.
PyTorch benchmark tutorial прямо показывает, что обычный timeit без CUDA synchronization способен в основном измерить kernel launch time, тогда как torch.utils.benchmark синхронизирует accelerator operations.
Поэтому:
просто
start = time.time(); model(...); end = time.time()
не является универсально корректным GPU timing method.
torch.utils.benchmark полезен для model-level measurements
PyTorch torch.utils.benchmark.Timer:
выполняет warm-up;
учитывает asynchronous accelerator synchronization;
поддерживает repetitions/blocked autorange;
помогает оценивать reliability measurements.
Это хороший инструмент для micro/model-level tests.
Но он не заменяет bespoke E2E measurement, если нужно учитывать:
disk;
parser;
tokenization;
CPU→GPU transfer;
output writing.
Warm-up нужно отделять от measurement
Первый GPU run может включать:
lazy library initialization;
kernel initialization;
JIT/compilation;
allocation;
cache population.
PyTorch benchmark tutorial отдельно показывает эффект первого cuBLAS invocation и автоматически выполняет warm-up.
Поэтому:
Warm-up Time ≠ Steady-State Processing Time.
Warm-up должен быть representative
Если execution path зависит от input shapes, прогрев только на одном коротком input может быть недостаточным.
Это особенно важно при:
compilation;
shape-dependent kernels;
CUDA graphs;
varying sequence lengths.
Поэтому warm-up workload должна представлять measured shapes.
Cold-start и steady-state измеряйте отдельно
Если startup важен:
Cold Start
может включать:
model loading;
initialization;
first compile;
first inference.
Steady State
показывает уже прогретую pipeline.
Не смешивайте их в одну цифру throughput без явного определения.
Делайте повторные runs
Performance зависит от:
system noise;
cache state;
thermal state;
input distribution;
background processes.
PyTorch benchmark utilities используют multiple measurements именно потому, что run-to-run variation мешает корректному сравнению.
До начала experiment определите:
repetitions;
run order;
aggregation method;
treatment failed runs.
Не публикуйте только лучший run
Если measurements дали:
920 inputs/s;
970;
945;
1 420;
выбрать только:
1 420
как «результат» — плохая практика.
Сохраните все raw runs.
Для summary можно использовать:
median;
mean;
percentile;
confidence interval.
Но aggregation method должна быть объявлена заранее.
Главный принцип:
Peak Throughput ≠ Reproducible Throughput.
Run order тоже фиксируйте
Если всегда тестировать:
1 → 2 → 4 → 8 → 16 → 32
поздние runs могут получить:
другой thermal state;
другой cache state;
полностью прогретый filesystem;
compilation advantage.
В более строгом experiment можно использовать:
repeated sweeps;
balanced order;
randomized order;
controlled reset.
Главное — описать methodology.
Определите cache state
Решите заранее:
Cold
или:
Warm / steady state.
Document pipeline может зависеть от:
OS page cache;
application cache;
preprocessed assets;
tokenizer caches.
Нельзя считать:
batch 8 cold
и:
batch 64 warm
чистым batch comparison.
Измеряйте throughput на нескольких уровнях
Для business layer:
Documents/s
или:
Corpus Completion Time.
Для model layer:
Inputs/s
или:
Tokens/s, если эта metric релевантна.
Если один document создаёт разное количество chunks, documents/s не отражает полный объём GPU work.
Поэтому лучше публиковать минимум две единицы:
documents/s
и:
model inputs/s.
Documents/s имеет смысл только при ясном denominator
Формула:
Documents/s = completed source documents / measured seconds.
Но если chunking policy изменилась, documents/s уже нельзя сравнивать как pure batch result.
Поэтому preprocessing/chunking должны быть фиксированы.
Corpus completion time часто важнее microseconds
Для offline processing заказчику может быть важнее:
обработается ли ежедневный корпус за 4 часа?
чем:
один kernel быстрее на 20 µs.
Поэтому E2E corpus completion time — полноценная business-facing metric.
Измеряйте GPU memory в нескольких слоях
Один показатель VRAM недостаточен.
Peak Allocated
max_memory_allocated()
показывает максимум GPU memory, занятой tensors через PyTorch allocator.
Peak Reserved
max_memory_reserved()
показывает maximum GPU memory, управляемую caching allocator.
Device-Wide Memory
Отдельная device-level metric показывает память GPU в целом, включая allocations, которые PyTorch allocator может не видеть.
PyTorch прямо рекомендует сравнивать allocator data с raw device memory при поиске non-PyTorch allocations; для этого существует device_memory_used().
Поэтому:
Allocated Memory ≠ Reserved Memory ≠ Device-Wide GPU Memory.
Не рассчитывайте headroom только по max_memory_allocated()
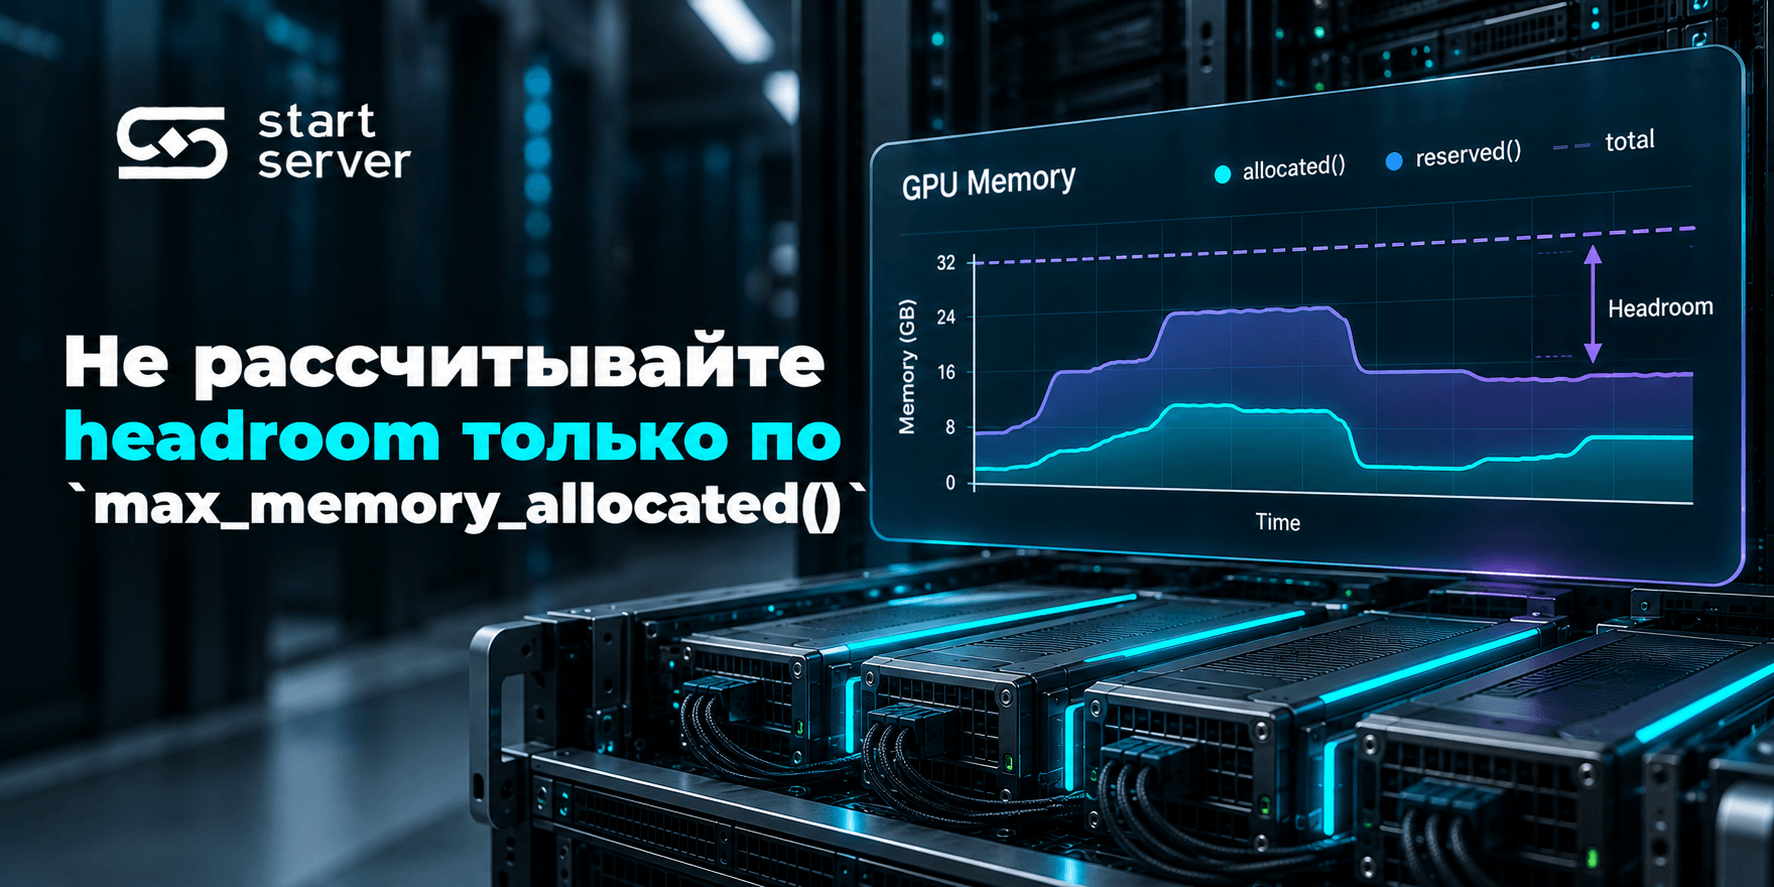
Ошибочный вывод:
peak allocated = 70 GB на GPU 80 GB → остаётся 10 GB headroom.
Почему неверно?
Дополнительно могут существовать:
reserved allocator memory;
CUDA context;
library allocations;
third-party allocations;
другие процессы.
PyTorch прямо отмечает, что allocator-visible memory может быть меньше значения device-wide tools.
Перед каждым run сбрасывайте peak statistics
Для измерительного interval используйте current peak-statistics workflow:
reset peak stats → run → read peak values.
max_memory_reserved() прямо документирует использование reset_peak_memory_stats() для сброса начальной точки peak measurement.
Так peak одного batch не будет случайно включать предыдущий run.
OOM — полноценный результат
Пример структуры:
Batch | Status |
|---|---|
16 | PASS |
32 | PASS |
64 | PASS |
128 | OOM |
128 = OOM не нужно удалять.
Сохраните:
exact exception;
model/configuration;
input profile;
allocator/device memory evidence.
OOM Point is Evidence, not Missing Data.
Но это boundary только для конкретного experiment, а не универсальный hardware limit.
User-facing batch не всегда совпадает с внутренней execution granularity
Этот тезис требует условия.
Для обычного SentenceTransformer.encode(batch_size=32) параметр действительно управляет batching inputs.
Но отдельные pipelines могут дополнительно:
chunk inputs;
microbatch;
repack;
dynamically schedule;
применять fallback.
Transformers, например, описывает ChunkPipeline, где один пользовательский input способен породить несколько model forward passes, при этом batching обрабатывается внутри pipeline.
Поэтому корректная формулировка:
User-Facing Batch Size May Differ from Internal Execution Granularity.
Но только если конкретная pipeline имеет соответствующую internal logic.
Не предполагайте автоматический OOM fallback
Некоторые приложения могут после OOM:
уменьшить microbatch;
split workload;
повторить request.
Но это не универсальное свойство Transformers, Sentence Transformers или любого другого framework.
Поэтому писать нужно:
если ваша pipeline реализует automatic splitting/OOM recovery.
Если fallback есть — фиксируйте requested и effective batch
Например:
Requested: 128
Runtime fallback: 64
Итог нельзя записывать как:
batch 128 PASS.
Это уже другой execution behaviour.
Самый большой batch не обязательно лучший
Увеличение batch size может:
сначала повышать GPU utilization;
увеличивать throughput;
выйти на plateau;
увеличить memory pressure;
приблизить workload к OOM.
Operational optimum часто находится до абсолютной memory boundary.
Поэтому:
Largest Batch that Fits ≠ Best Operational Batch.
Ищите efficient region, а не математический максимум любой ценой
Простая decision rule могла бы выглядеть как:
arg max Throughput(B)
при constraints.
Это полезно концептуально, но production choice обычно должен учитывать headroom.
Лучше:
Найти область высокой воспроизводимой эффективности, в которой дальнейший рост batch даёт diminishing returns или ухудшает operational constraints.
Эту область в статье называем:
Throughput Knee.
Это рабочий термин, а не стандартизованная benchmark metric.
Throughput Knee не имеет универсального процента
Не писать:
если прирост меньше 10%, batch увеличивать бессмысленно.
Для одного проекта:
+5%
может окупать upgrade.
Для другого:
+20%
не стоит снижения headroom.
Decision привязан к workload requirements.
Quality / output check определите заранее
Batch-size sweep не должен незаметно изменить результат pipeline.
Для разных задач проверка разная.
Classification
labels/task metric.
OCR
CER/WER.
Extraction
field accuracy/F1.
Embeddings
retrieval/downstream quality;
либо другой predefined consistency criterion.
Но не обязательно запускать огромный downstream benchmark после каждого run, если pipeline semantics гарантированы и достаточно заранее выбранного output-consistency check.
Главное:
Output/Quality Criterion Before Performance Interpretation.
Не требуйте bit-identical output без причины
Разные:
kernels;
execution dtype;
numerical paths
могут дать небольшие floating-point differences.
Поэтому practical gate чаще выглядит как:
output quality remains within predefined tolerance.
Если bitwise identity является реальным requirement — тогда его нужно задать отдельно.
Если throughput перестал расти, найдите bottleneck
Plateau может означать:
GPU compute saturation;
memory bandwidth limit;
CPU preprocessing;
storage;
tokenization;
serialization;
framework overhead.
Поэтому:
Throughput Plateau ≠ Automatically GPU Compute Limit.
Batch sweep показывает shape проблемы, но не всегда root cause.
GPU utilization не является финальным критерием
100% utilization не доказывает:
максимальную полезную производительность.
И низкая utilization не доказывает автоматически:
batch слишком маленький.
Основная outcome metric:
E2E throughput;
completion time;
output correctness.
Telemetry используется для объяснения результата.
Stability тоже входит в выбор
Batch, который:
проходит только часть runs;
периодически OOM;
имеет большой variance;
не должен выигрывать только за счёт одного peak result.
Поэтому operational choice учитывает:
reproducibility;
memory headroom;
output consistency;
stability.
Run Matrix
Главный рабочий asset:
Batch | Run | E2E time | Model time | Docs/s | Inputs/s | Tokens/s | Peak allocated | Peak reserved | Device memory | Output check | Status |
|---|---|---|---|---|---|---|---|---|---|---|---|
1 | |||||||||||
2 | |||||||||||
4 | |||||||||||
8 | |||||||||||
… |
Не каждое поле обязательно для каждой pipeline.
Но должны быть ясны:
timing boundary;
memory metric;
denominator throughput.
Batch Experiment Card
Перед запуском заполните:
Поле | Значение |
|---|---|
Task | |
Corpus ID/hash | |
Documents | |
Model inputs | |
Length distribution | |
Model/revision | |
Tokenizer/processor | |
Model execution dtype | |
Output precision/quantization | |
GPU SKU/count | |
CPU/RAM | |
Driver | |
CUDA/ROCm | |
Framework/version | |
Pipeline/runtime version | |
Batch unit | |
User batch parameter | |
Internal chunk/microbatch semantics | |
Padding | |
Truncation | |
Bucketing | |
DataLoader/workers | |
Cache state | |
Warm-up shapes | |
E2E timing method | |
GPU timing method | |
Repetitions | |
Output/quality check |
Result Summary
После появления настоящих measurements:
Batch | Representative throughput | Relative speedup | Peak memory | Output check | Stability | Decision |
|---|---|---|---|---|---|---|
Relative speedup:
Speedup(B) = Throughput(B) / Throughput(Baseline)
Baseline должен быть назван явно.
Operational Decision Rule
Рабочая логика:
Find Efficient Region
↓
Reject OOM / Unstable Configurations
↓
Check Output / Quality Requirement
↓
Check Memory Constraint
↓
Apply Latency Limit if Relevant
↓
Compare Reproducible Throughput
↓
Prefer Sufficient Operational Headroom
↓
Retest Selected Batch on Representative Corpus.
То есть выбираем не обязательно абсолютный maximum.
Выбираем устойчивую точку, которая закрывает реальную задачу.
Не задавайте универсальный memory headroom
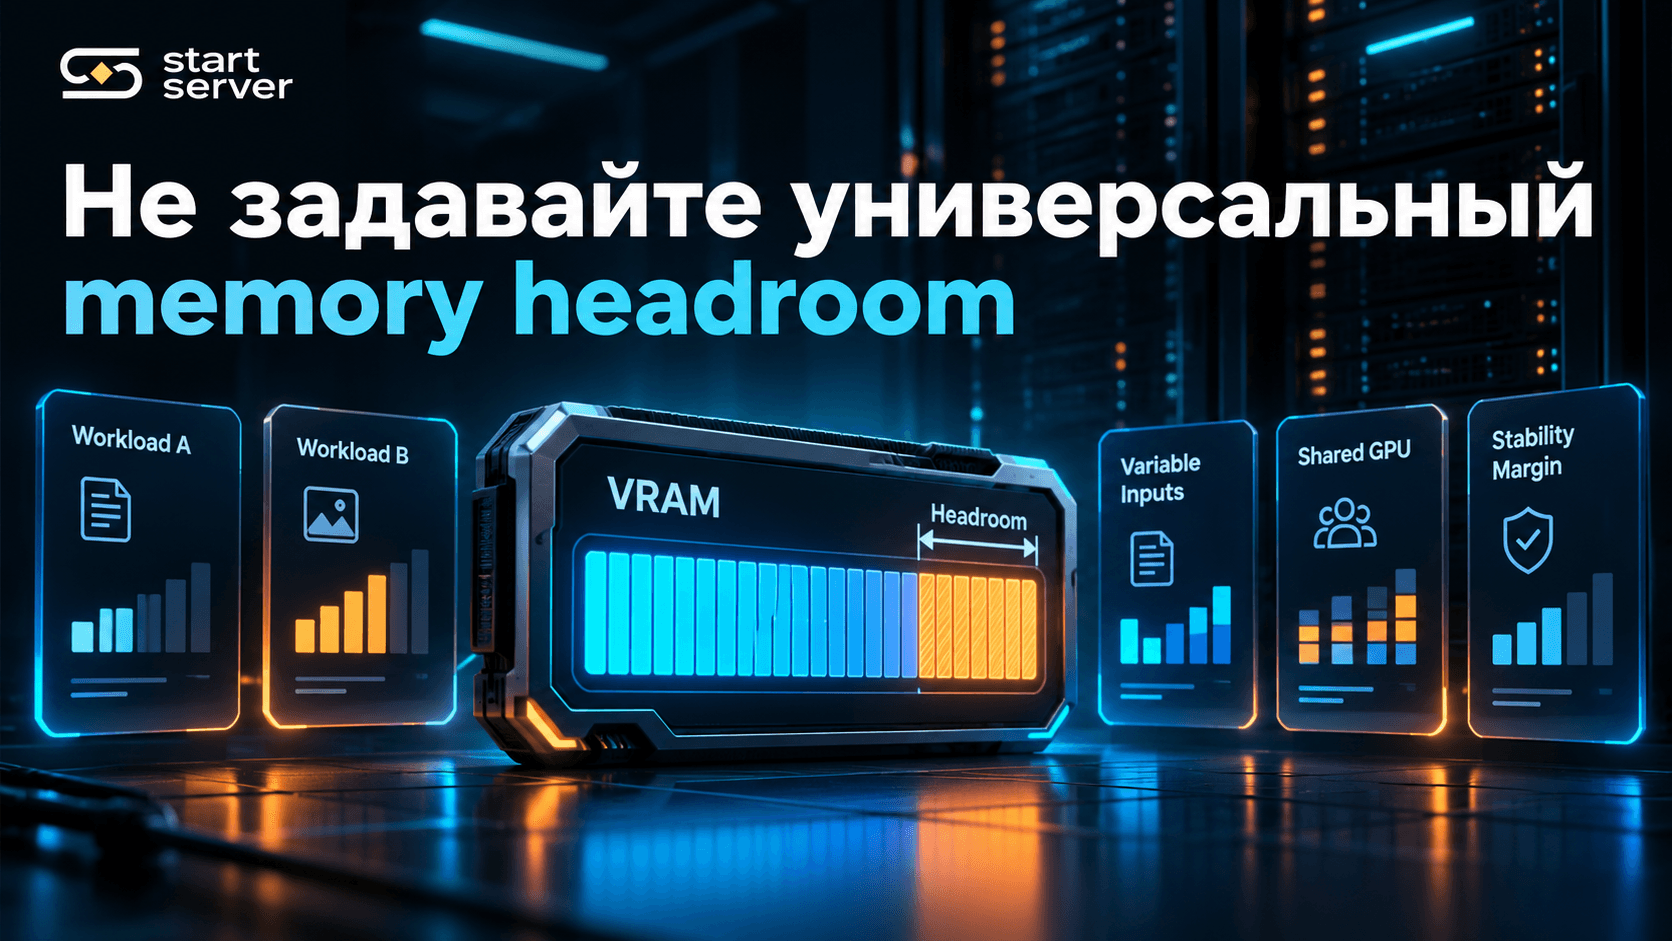
Нельзя писать:
всегда оставляйте 10% или 20% VRAM.
Нужный запас зависит от:
input variation;
runtime;
external allocations;
scheduler;
других процессов.
Headroom должен определяться на конкретной pipeline.
Финально подтвердите выбранный batch на representative corpus
Небольшой subset удобен для поиска диапазона — Sentence Transformers прямо рекомендует benchmark нескольких значений на small subset данных.
Но после выбора batch полезно повторить его на:
полном corpus;
либо достаточно representative workload,
чтобы увидеть:
long-tail input lengths;
rare OOM;
stability;
real completion time.
Что нельзя публиковать без реального стенда
Пока нет raw evidence, нельзя писать:
«мы получили +42% throughput».
Нельзя придумывать:
GPU model;
corpus;
durations;
peak VRAM;
OOM point;
quality delta.
И нельзя выдавать чужой benchmark за измерение Start Server.
Поэтому текущая версия статьи — это методика постановки эксперимента.
После реального stand run материал можно обновить до:
Измеряем влияние batch size на пакетную обработку документов
с настоящими таблицами и графиками.
Когда result-driven версия будет готова
Нужны:
Evidence | Ready? |
|---|---|
Exact GPU/server | |
Corpus ID/hash | |
Model/revision | |
Software versions | |
Execution dtype | |
Batch semantics | |
Padding/chunking | |
Warm-up procedure | |
Timing methodology | |
Batch sweep | |
Replicates | |
Raw throughput | |
Allocated/reserved/device memory | |
Output/quality results | |
OOM/failures | |
Telemetry |
Практический протокол
Шаг 1. Определите один task
Например:
document embeddings.
Шаг 2. Зафиксируйте corpus
Один и тот же для всех runs.
Шаг 3. Сохраните input-length distribution
Не ограничивайтесь mean.
Шаг 4. Зафиксируйте model/software/hardware
Exact revisions.
Шаг 5. Определите batch unit и internal semantics
Что именно означает один element batch?
Шаг 6. Зафиксируйте padding/chunking/bucketing
Это часть workload.
Шаг 7. Определите output check
До просмотра performance.
Шаг 8. Определите sweep
От малого устойчивого batch до meaningful upper bound.
Шаг 9. Сделайте representative warm-up
Отдельно от measured window.
Шаг 10. Выполните повторные runs
По одинаковой methodology.
Шаг 11. Измерьте
E2E time;
model time;
documents/s;
model inputs/s;
tokens/s, если релевантно;
peak allocated;
peak reserved;
device-wide memory;
output/quality;
status.
Шаг 12. Не удаляйте OOM
Сохраните как boundary evidence.
Шаг 13. Найдите efficient region
Не только absolute maximum.
Шаг 14. Выберите operational batch с headroom
С учётом workload constraints.
Шаг 15. Повторите выбранную configuration на representative corpus
И только после этого используйте её как production baseline.
Что передать Start Server для такого теста
Если batch experiment нужен для sizing GPU-сервера, подготовьте:
тип document task;
representative corpus/profile;
model/revision;
current GPU;
execution dtype;
current batch;
input-length distribution;
daily/total volume;
target completion time;
quality requirement;
current OOM/memory evidence.
CTA: Обсудить тест на вашем потоке документов.
Главное
Batch size — не паспортная характеристика GPU.
И не число, которое стоит копировать из чужой статьи.
Transformers прямо предупреждает, что batching может как ускорять, так и замедлять inference в зависимости от model, hardware и данных; irregular sequence lengths способны создать большой padding overhead и OOM.
Sentence Transformers также рекомендует измерять несколько batch sizes на своей workload, поскольку оптимальное значение зависит от hardware, model size, precision и input length.
Рабочая последовательность:
Fixed Corpus
→ Fixed Model / Software
→ Define Batch Unit
→ Fix Padding / Chunking
→ Define Output Check
→ Representative Warm-up
→ Batch Sweep
→ Repeated Measurements
→ E2E + Model Timing
→ Allocated / Reserved / Device Memory
→ OOM / Failure
→ Efficient Region
→ Operational Batch with Headroom
→ Representative Retest.
Ключевые правила:
Default Batch Size ≠ Optimal Batch Size.
Same Batch Size Number ≠ Same Workload Unit.
Offline Batch Size ≠ Serving Concurrency.
Different Corpus ≠ Batch-Size Comparison.
Same Mean Length ≠ Same Batch Workload.
Same Batch Size + Different Padding Strategy ≠ Same Workload.
Different Execution Precision ≠ Batch-Size-Only Experiment.
Multiple Changing Variables ≠ Controlled Batch-Size Experiment.
Warm-up Time ≠ Steady-State Processing Time.
Model Throughput ≠ Pipeline Throughput.
Peak Throughput ≠ Reproducible Throughput.
Allocated Memory ≠ Reserved Memory ≠ Device-Wide GPU Memory.
OOM Point is Evidence, not Missing Data.
User-Facing Batch Size May Differ from Internal Execution Granularity — when the pipeline performs chunking, microbatching, repacking or similar internal scheduling.
Largest Batch that Fits ≠ Best Operational Batch.
Low Pipeline Throughput ≠ Automatically Too-Small Batch.
Throughput Plateau ≠ Automatically GPU Compute Limit.
Самый важный вывод:
Выбирайте не максимальный batch, который один раз поместился в VRAM, а воспроизводимую рабочую точку на representative corpus, где throughput высок, output соответствует требованиям, runs стабильны и остаётся достаточный memory headroom.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


