Процессор с большим количеством ядер и PCIe-линий ещё не гарантирует хорошую GPU-серверную конфигурацию.
CPU может выглядеть подходящим в datasheet, но конкретная серверная платформа распределит его I/O между GPU, сетевыми картами, NVMe, PCIe switches и вторым процессором совсем не так, как предполагалось при расчёте.
И обратная ситуация возможна: I/O topology подходит идеально, но host-side preprocessing упирается в CPU.
Поэтому выбирать CPU для GPU-сервера нужно в таком порядке:
GPU / NIC / NVMe
↓
требуемые PCIe links
↓
возможности CPU
↓
конкретная серверная платформа
↓
root complexes / switches
↓
socket и NUMA locality
↓
фактические PCIe links
↓
CPU workload
↓
нагрузочная проверка
Короткое правило:
Что CPU делает в GPU-сервере
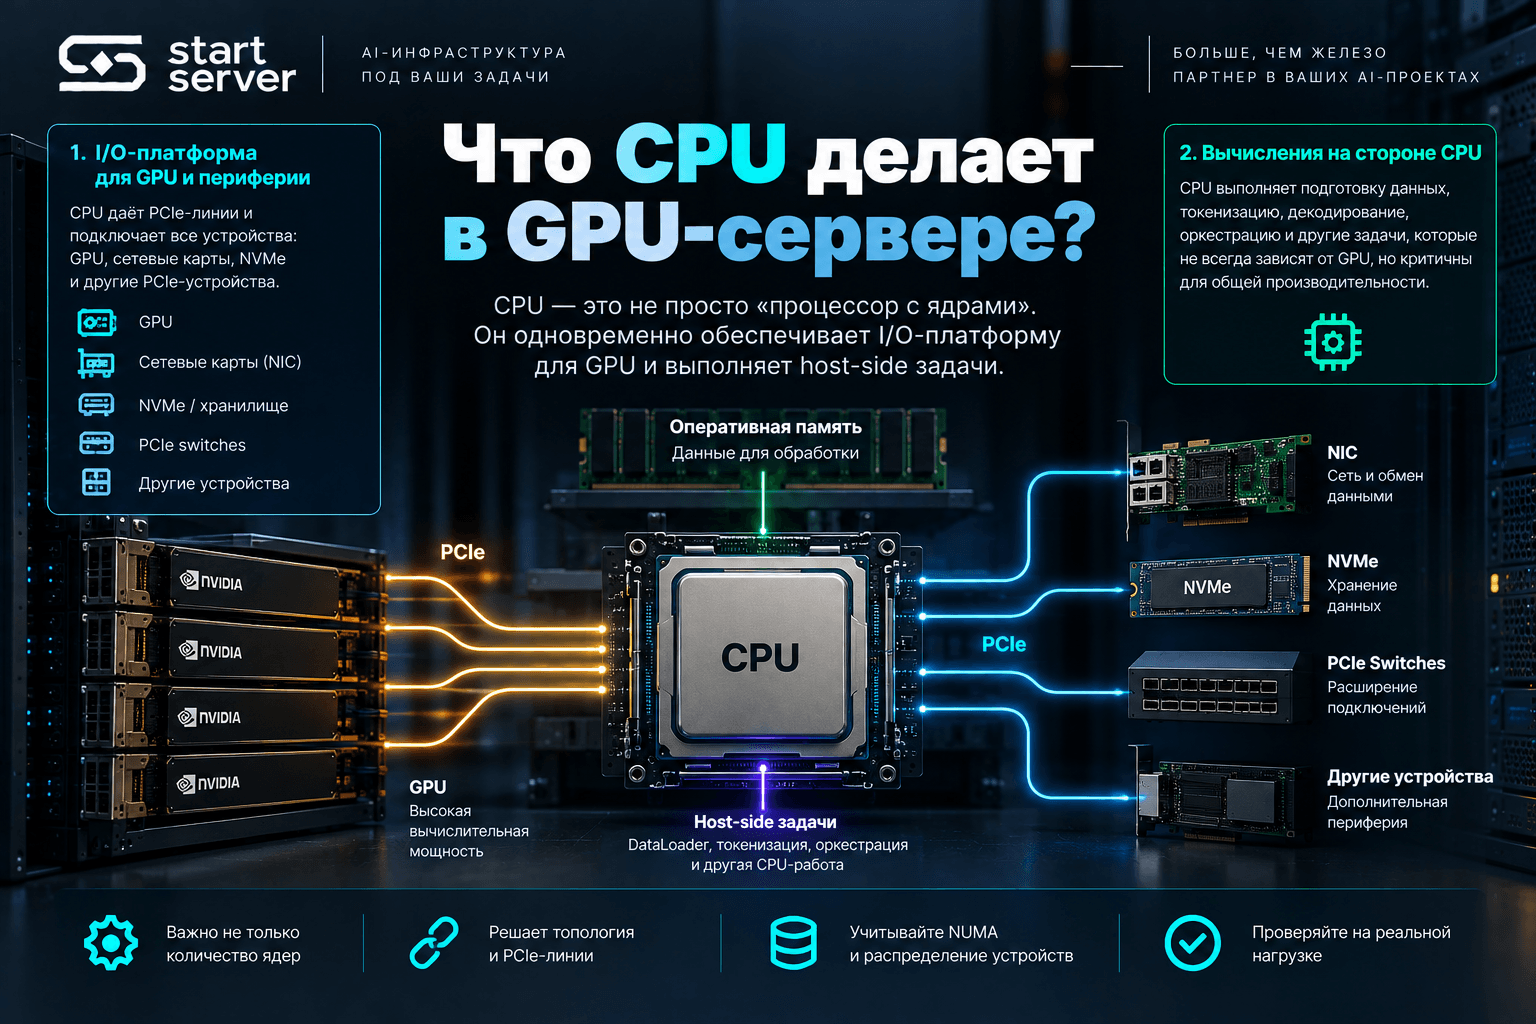
В GPU-сервере процессор решает две разные задачи.
Первая — обеспечивает I/O platform для GPU и периферии. Нужно физически подключить ускорители, сетевые адаптеры, NVMe и другие PCIe devices и дать им необходимую connectivity.
Вторая — выполняет host-side работу: DataLoader, tokenization, decode, augmentation, compression, network/storage processing, orchestration и другие CPU-задачи.
Поэтому CPU должен пройти два независимых теста:
I/O topology подходит?
+
Host compute достаточен?
=
CPU/platform подходит
Процессор с 128 ядрами не исправляет неудачное подключение NIC к GPU.
И большое количество PCIe-линий само по себе не ускоряет CPU-intensive preprocessing.
Почему количество PCIe-линий — только первый фильтр
Допустим, CPU поддерживает до 128 PCIe Gen5 lanes.
Из этой строки нельзя заключить, что сервер даст:
GPU0 → x16 напрямую
GPU1 → x16 напрямую
GPU2 → x16 напрямую
GPU3 → x16 напрямую
NIC0 → x16
NIC1 → x16
NVMe0–7 → x4 каждый
CPU задаёт архитектурный ресурс.
Реальная платформа распределяет его между:
GPU risers;
storage backplanes;
NIC/OCP slots;
PCIe switches;
дополнительными контроллерами;
а в двухсокетной системе — ещё и межпроцессорной связью.
Поэтому:
Сначала посчитайте ideal PCIe budget
Предположим, нужно установить:
4 × GPU x16
2 × NIC x16
8 × NVMe x4
Простая арифметика:
GPU:
4 × 16 = 64 lanes
NIC:
2 × 16 = 32 lanes
NVMe:
8 × 4 = 32 lanes
Итого:
128 lanes
Эти 128 lanes полезны как ideal endpoint demand: столько потребовали бы устройства при указанной ширине независимых прямых links.
Но это ещё не означает:
нужен CPU с 128 PCIe-линиями — задача решена.
Следующий этап гораздо важнее. Нужно выяснить:
какие endpoints подключены напрямую;
какие находятся за PCIe switch;
каков upstream у switch;
как организован NVMe backplane;
какой socket владеет каждым root port;
какие high-speed links недоступны периферии в 2P;
какая ширина действительно требуется workload.
Lane arithmetic помогает отсеять явно неподходящие варианты. Она не заменяет block diagram.
Почему два CPU не означают вдвое больше PCIe для устройств
AMD EPYC 9005 хорошо показывает эту ловушку.
В single-socket design EPYC 9005 предоставляет до 128 PCIe Gen5 lanes. Но в двухсокетной системе те же physical high-speed connections могут использоваться для xGMI/Infinity Fabric между процессорами.
AMD описывает типичный 2P-вариант с четырьмя xGMI links:
128 high-speed lanes / socket
− 64 lanes для 4 × xGMI
=
64 PCIe lanes / socket
2 sockets → 128 PCIe lanes для I/O
Производитель системы может вместо четырёх использовать три xGMI links. Тогда на socket остаётся до 80 PCIe lanes, а на 2P-систему — до 160. Выбор зависит от баланса между peripheral I/O и межсокетной bandwidth.
Следовательно:
2 × CPU с capability 128 lanes
≠
256 peripheral PCIe lanes
автоматически.
Именно поэтому для 2P-конфигурации CPU datasheet недостаточно.
У Intel логика выбора такая же
Intel указывает для Xeon 6 варианты до 136 PCIe 5.0 lanes для one-socket server designs и до 192 lanes для two-socket servers, а также до 12 memory channels в соответствующих вариантах семейства.
Но это platform/family capability.
Нельзя перенести число 136 на любой сервер с надписью Xeon 6.
Нужно знать:
exact CPU SKU
server model
1P / 2P
GPU base
riser option
NIC configuration
storage backplane
Поэтому таблица вида:
CPU | PCIe lanes |
EPYC | X |
Xeon | Y |
слишком поверхностна для выбора GPU-сервера.
Даже один server model может иметь несколько разных топологий
Хороший пример — Lenovo ThinkSystem SR675 V3.
Для одного шасси Lenovo документирует несколько GPU configurations.
В 4-GPU модели есть, например:
2P direct x16 configuration;
1P x16 configuration через PCIe switch.
В 8-GPU модели доступны как direct x8 connections, так и x16 downstream connections через switched risers.
То есть:
ThinkSystem SR675 V3
ещё не описывает PCIe topology.
Нужна конкретная:
base configuration
+
GPU riser
+
CPU count
+
I/O riser
+
storage option
Четыре GPU не обязательно требуют двух CPU
У того же SR675 V3 официально существуют 4-GPU configurations с одним процессором и switched x16 riser, наряду с двухсокетными direct x16 configurations.
Поэтому правило:
4 GPU → 2 CPU
технически неверно.
Второй socket оправдан, если он решает конкретное ограничение:
Причина | Может потребовать 2P |
Не хватает I/O topology | Да |
OEM требует 2P для выбранной GPU configuration | Да |
Не хватает CPU compute | Возможно |
Нужна дополнительная RAM capacity/bandwidth | Возможно |
Требуется больше memory channels | Возможно |
Просто хочется «более мощный сервер» | Нет |
Если один CPU уже закрывает I/O, compute и memory requirements, второй socket не становится преимуществом сам по себе.
Восемь GPU могут использовать совсем другую архитектуру
В 8-GPU вариантах того же Lenovo платформа уже предлагает другой design.
Direct riser обеспечивает восьми GPU links x8, а switched configuration предоставляет x16 downstream connections при подписке через PCIe switch.
Здесь особенно хорошо видно различие:
x16 со стороны GPU
не обязательно означает:
отдельный x16 upstream до CPU
на каждую карту.
Поэтому надо различать endpoint link и shared upstream topology.
Механический x16 slot, electrical width и negotiated width — три разные вещи
Надпись PCIe x16 slot может описывать физический разъём.
Но для GPU-сервера интересуют как минимум:
physical connector
electrical width
PCIe generation
upstream path
А после сборки появляется ещё один параметр:
negotiated width / speed
Таким образом, возможна конфигурация, где карта физически установлена в x16 connector, но серверная разводка предусматривает x8.
И это само по себе не является неисправностью.
PCIe switch — не синоним bottleneck
Типовая switched topology:
CPU / root complex
↓
PCIe switch
├─ GPU0
├─ GPU1
├─ GPU2
└─ GPU3
Такой design позволяет подключить больше endpoints, чем доступно независимых CPU root ports.
У него может быть shared upstream. Но наличие switch ещё не доказывает, что этот upstream ограничит workload.
Нужно знать:
upstream width/generation
число downstream devices
одновременный traffic
направление transfers
P2P requirements
реальный workload throughput
Lenovo использует switched risers и в официальных GPU Direct configurations, поэтому само наличие PCIe switch нельзя считать отрицательным признаком.
Правильный вопрос:
Какие устройства одновременно делят upstream и нужен ли им в этот момент полный downstream bandwidth?
Direct и switched topology: что сравнивать
Параметр | Direct attach | Через switch |
Path до root complex | Обычно проще | Есть дополнительный PCIe bridge/switch |
Fan-out | Ограничен CPU/platform routing | Может быть выше |
Shared upstream | Меньше возможностей для sharing | Возможен |
P2P | Зависит от платформы | Зависит от switch/platform |
Анализ topology | Проще | Нужно знать downstream и upstream |
Ни одна из колонок не означает автоматически лучшую производительность.
Пригодность определяется critical data paths.
NUMA node и CPU socket — не одно и то же
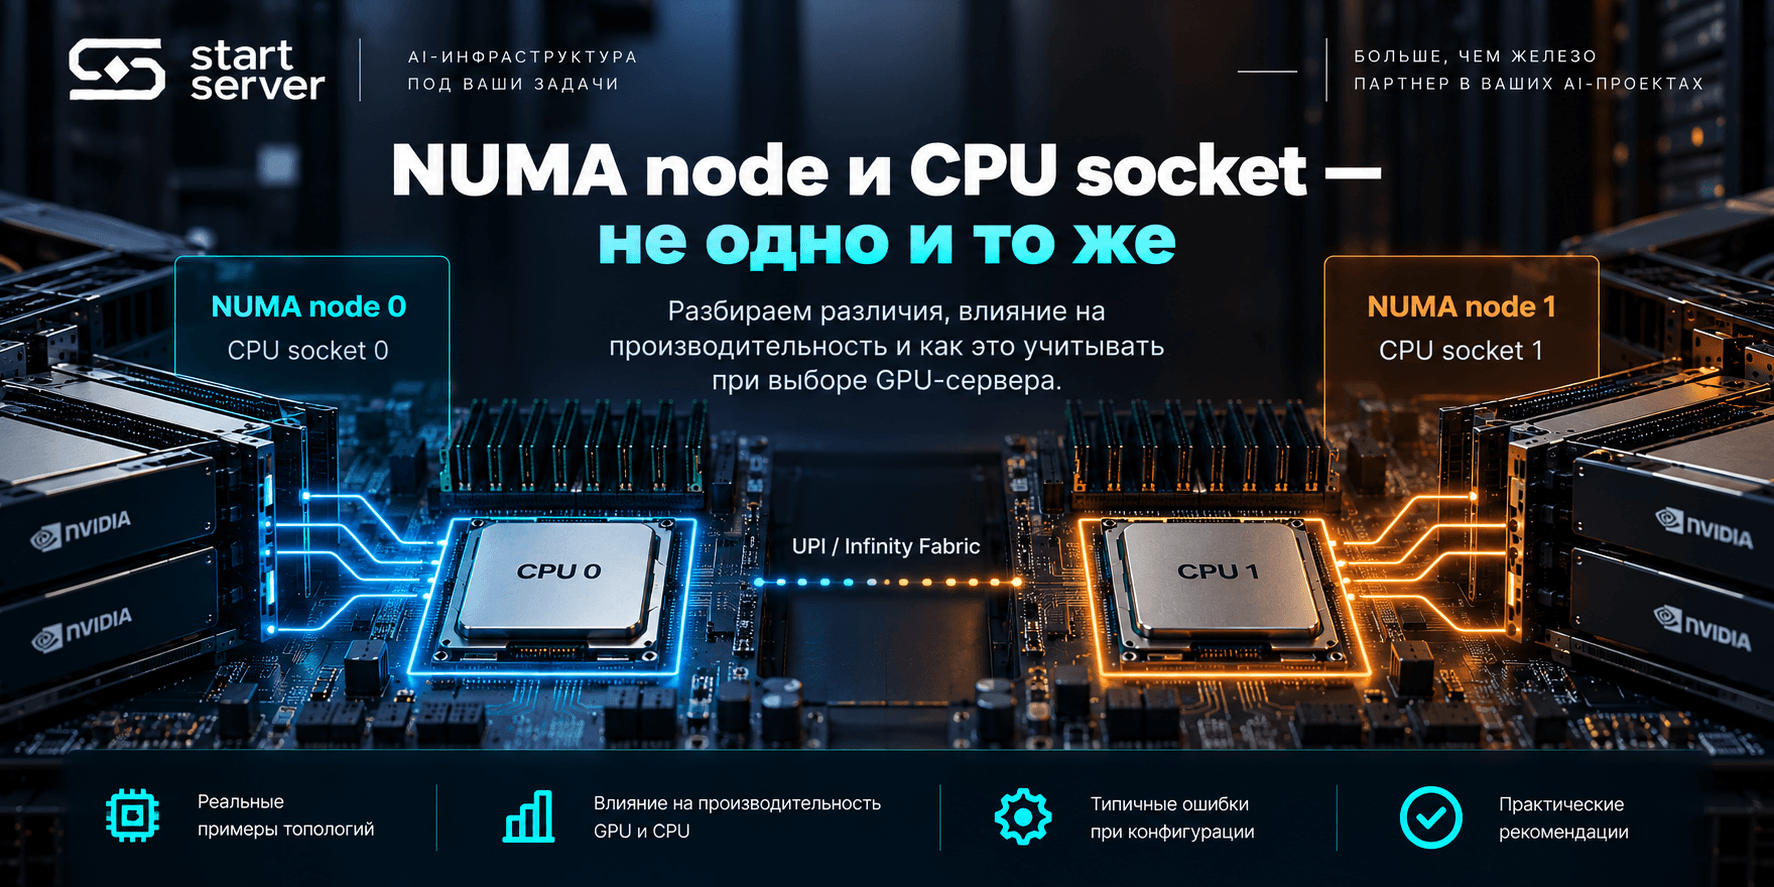
Это важнейшее уточнение.
Для простой двухсокетной схемы часто рисуют:
CPU0 / NUMA0
CPU1 / NUMA1
Но это всего лишь возможная конфигурация.
Например, AMD EPYC 9005 поддерживает настройки NPS:
NPS1 → 1 NUMA node / socket
NPS2 → 2 NUMA nodes / socket
NPS4 → 4 NUMA nodes / socket
При NPS4 PCIe device получает locality относительно того NUMA domain, где расположен соответствующий PCIe root complex.
Поэтому на реальной системе таблица должна иметь два разных поля:
Root socket
NUMA node
а не одно поле CPU/NUMA.
Это особенно важно для placement CPU workers и memory.
Правильная NUMA-карта выглядит подробнее
Условная система при одном NUMA node на socket может выглядеть так:
Socket 0
NUMA 0
├─ GPU0
├─ GPU1
├─ NIC0
└─ NVMe group A
Socket 1
NUMA 1
├─ GPU2
├─ GPU3
├─ NIC1
└─ NVMe group B
Но при NPS4 один socket уже может содержать несколько NUMA domains.
Поэтому универсальная карта должна хранить:
Device | Root socket | NUMA node |
GPU0 | 0 | 0 |
GPU1 | 0 | 1 |
NIC0 | 0 | 0 |
NVMe0 | 0 | 1 |
GPU2 | 1 | 4 |
Числа здесь только иллюстративные.
Главный вопрос после этого:
какие устройства должны интенсивно обмениваться друг с другом?
Добавьте к каждому устройству critical peer
Предположим:
GPU0 ↔ NIC0
GPU1 ↔ NVMe group A
CPU workers ↔ GPU0/1
GPU2 ↔ NIC1
Это намного полезнее списка:
4 GPU
2 NIC
8 NVMe
Потому что topology становится связана с workload.
Для каждого bandwidth-sensitive endpoint нужно определить:
device
→ root path
→ locality
→ critical peer
И уже после этого оценивать, хорошее ли размещение.
Для GPUDirect RDMA GPU↔NIC topology особенно важна
Для GPUDirect RDMA NVIDIA указывает важное ограничение: GPU и сторонний PCIe peer должны находиться под одним upstream PCIe root complex. NVIDIA также разделяет пути, состоящие только из PCIe switches, path через один CPU/host bridge и cross-socket path через CPU-to-CPU interconnect; последний вариант может быть серьёзно ограничен или работать нестабильно на отдельных платформах.
Поэтому для RDMA недостаточно строки:
NIC: ConnectX, 400 Gbit/s
Нужно знать её размещение относительно целевых GPU.
Условно:
GPU
└─ PCIe switch
└─ NIC
и:
GPU
└─ CPU0
↓
inter-socket
↓
CPU1
└─ NIC
— разные topology.
Эта оговорка относится именно к GPUDirect RDMA и другим соответствующим peer-to-peer scenarios, а не автоматически ко всему сетевому трафику.
NVLink и NVSwitch не отменяют host NUMA
В HGX-системе GPU↔GPU traffic может идти по NVLink/NVSwitch.
Но это не означает, что расположение CPU, NIC и storage стало безразличным.
Есть два слоя:
GPU ↔ GPU
NVLink / NVSwitch
и:
CPU / RAM / NIC / NVMe ↔ GPU
PCIe / host topology
Поэтому даже для HGX-сервера всё ещё нужно знать, откуда к GPU приходят данные с host/network/storage side.
Сколько CPU cores нужно GPU-серверу
После I/O topology можно переходить к вычислительной части CPU.
Универсального:
8 CPU cores на GPU
или:
8 GPU → 64 CPU cores
нет.
В одном workload CPU почти только запускает GPU work.
В другом на CPU выполняются:
image/video decode
augmentation
tokenization
compression
DataLoader workers
network processing
storage processing
Правильный sizing выглядит так:
GPU недогружены?
↓
данные не успевают?
↓
CPU насыщен?
↓
какая именно host-задача насыщена?
↓
растёт ли throughput при добавлении cores?
Memory channels входят в выбор платформы
В SS-008 мы рассчитывали, сколько системной RAM требуется data pipeline.
Но одинаковые 512 GB памяти могут иметь разную topology.
EPYC 9005 имеет 12 memory channels на socket; для Xeon 6 Intel также указывает варианты до 12 channels.
При выборе GPU-сервера нужно знать:
socket count
NUMA mode
memory channels
DIMM population
locality CPU workers
locality I/O devices
Потому что:
объём RAM и её доступная bandwidth/locality — разные свойства.
Но размер памяти здесь повторно не рассчитываем: это задача SS-008.
Как читать OEM block diagram
На diagram нужны не маркетинговые подписи, а следующие элементы:
CPU/socket
root ports
PCIe switches
GPU risers
NIC/OCP
NVMe backplane
chipset
inter-socket links
Для каждого критичного устройства ответьте:
Вопрос | Что фиксируем |
К какому socket/root complex подключено? | ownership |
Есть ли PCIe switch? | path |
Какой upstream? | потенциальный shared resource |
Какая electrical width? | запланированный link |
Какой NUMA node ожидается? | locality |
С кем устройство активно работает? | critical peer |
Block diagram — один из ключевых документов закупки GPU-сервера, а не вспомогательная картинка из manual.
Как проверить PCIe tree после сборки
Для Linux базовая команда:
lspci -t
lspci -t показывает дерево PCI buses, bridges, devices и connections.
Это позволяет увидеть, что GPU не просто присутствуют в системе, а находятся за ожидаемыми bridges/switches.
Полезно сразу сохранять BDF каждого критичного устройства:
domain:bus:device.function
например:
0000:65:00.0
BDF затем связывает вывод разных инструментов в одну topology matrix.
Как проверить фактический PCIe link
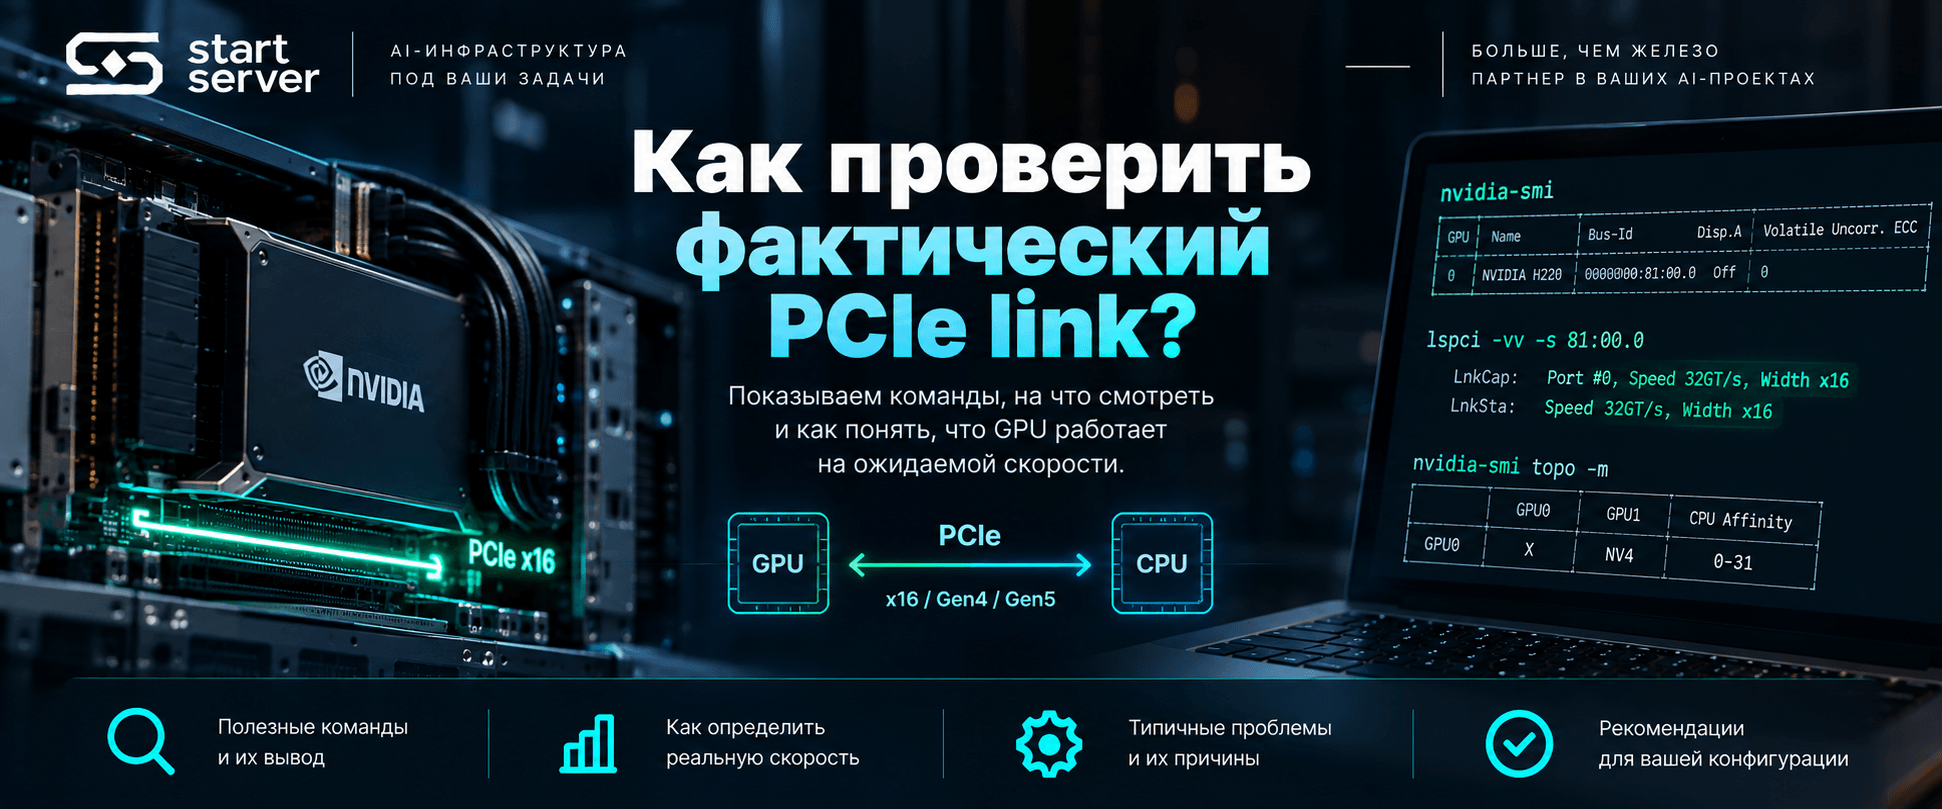
Для конкретного BDF:
lspci -s <BDF> -vv
В PCI Express capability нас интересуют прежде всего:
LnkCap
LnkSta
LnkCap используется для capability link, а LnkSta показывает текущую negotiated speed/width.
Пример:
LnkCap: ... Width x16
LnkSta: ... Width x16
соответствует ожидаемой ширине.
Если:
LnkCap: ... Width x16
LnkSta: ... Width x8
это повод проверить конфигурацию.
Но не повод автоматически объявлять аппаратную неисправность. x8 может быть предусмотрен riser design или конфигурацией OEM.
Таким образом:
Проверяйте именно configured server, а не только CPU
Хорошая acceptance запись:
GPU0
Expected:
Gen5 x16
specific riser
root socket 0
expected locality ...
Actual:
BDF ...
LnkSta ...
PCI tree ...
NUMA ...
Если expected и actual расходятся, только тогда начинается диагностика:
другая riser configuration;
BIOS;
bifurcation;
не тот slot;
device limitation;
link training;
hardware issue.
Не угадываем причину по одной строке lspci.
numactl --hardware отвечает только на часть вопроса
Для NUMA inventory полезен:
numactl --hardware
Он показывает доступные NUMA nodes, CPU sets и память.
Но он не является полной картой PCIe hierarchy.
Поэтому для GPU-сервера нужны и другие источники.
lstopo связывает CPU, memory и I/O hierarchy
hwloc умеет обнаруживать PCI devices и bridges и связывать их с ближайшими CPU/memory objects в topology. lstopo отображает эту структуру и поэтому особенно полезен для анализа I/O locality.
Это не замена OEM diagram.
Логика такая:
OEM block diagram
→ что должно быть физически
lstopo
→ как locality видит ОС
На Linux это хороший способ проверить, рядом с какой частью CPU/memory hierarchy находится I/O device.
Что показывает nvidia-smi topo -m
Для NVIDIA GPU базовая команда:
nvidia-smi topo -m
выводит GPU/NIC connectivity и CPU/memory affinities.
Основные обозначения:
Код | Path |
PIX | через один PCIe switch |
PXB | через несколько PCIe switches |
PHB | через PCIe Host Bridge |
NODE | через host bridges внутри одного NUMA node |
SYS | через PCIe и меж-NUMA SMP interconnect |
NV# | через NVLink connections |
Особенно заметен SYS: он показывает, что path пересекает NUMA/system interconnect.
Но:
Если это critical path, его нужно проверить workload test.
PIX тоже не является автоматической гарантией скорости
Для GPUDirect RDMA NVIDIA действительно считает PCIe-switch-only path наиболее благоприятным из описанных topology scenarios. Но даже он не даёт гарантированную цифру throughput для произвольной системы.
Реальный результат зависит от:
switch architecture
upstream links
simultaneous traffic
NIC/GPU
software stack
transfer pattern
Поэтому nvidia-smi topo нужно читать как карту маршрутов, а не рейтинг сервера.
Новые nvidia-smi позволяют смотреть GPU, NIC и NVMe отдельно
В актуальной документации доступны:
nvidia-smi topo -gpu
nvidia-smi topo -nic
nvidia-smi topo -nvme
nvidia-smi topo -cpu
nvidia-smi topo -all
-all объединяет GPU, NIC и NVMe connectivity и добавляет CPU/memory/NUMA information для GPU.
Для статьи базовой командой всё равно оставляем:
nvidia-smi topo -m
поскольку на старых driver/tooling versions новые subcommands могут отсутствовать.
Ни одна команда не заменяет остальные источники
Источник | Что проверяет |
CPU datasheet | theoretical CPU capability |
OEM configuration guide | поддерживаемые варианты сборки |
OEM block diagram | проект platform topology |
lspci -t | фактический PCIe tree |
lspci -vv | capability/current link |
numactl --hardware | CPU/memory NUMA topology |
lstopo | CPU/memory/I/O locality |
nvidia-smi topo | GPU/NIC/NVMe paths |
workload benchmark | влияет ли topology на вашу задачу |
Правильная проверка GPU-сервера — это совпадение нескольких независимых уровней.
Acceptance matrix для CPU/GPU-платформы
Перед заказом и после поставки полезно заполнить одну таблицу:
Device | BDF | Expected link | Actual link | Switch/path | Root socket | NUMA node | Critical peer |
GPU0 | … | Gen5 x16 | … | … | 0 | … | NIC0 |
GPU1 | … | Gen5 x16 | … | … | 0 | … | NVMe A |
GPU2 | … | Gen5 x16 | … | … | 1 | … | NIC1 |
NIC0 | … | Gen5 x16 | … | … | 0 | … | GPU0 |
NVMe0 | … | Gen5 x4 | … | … | 0 | … | GPU1 |
Обратите внимание: Root socket и NUMA node — отдельные столбцы.
Критерий готовности:
Именно эта таблица намного полезнее рейтинга «лучших CPU для AI».
Как проверить, влияет ли NUMA на workload
Предположим, topology выявила:
GPU0 ↔ NIC1 = SYS
или CPU preprocessing выполняется далеко от NUMA node, к которому локальна целевая GPU.
Это гипотеза о bottleneck.
Проверять её нужно сравнением:
одинаковая задача
одинаковая GPU
одинаковая NIC/storage
одинаковый software stack
local placement
vs
remote placement
И измерять:
throughput
latency
GPU utilization
network/storage throughput
CPU load
Только после этого можно говорить:
для нашей платформы remote placement стоил столько-то.
Универсального:
cross-NUMA = −20%
не существует.
Полный порядок выбора CPU для GPU-сервера
1. Зафиксировать workload
↓
2. Определить GPU
↓
3. Перечислить NIC и NVMe
↓
4. Определить critical data paths
↓
5. Посчитать ideal endpoint lane demand
↓
6. Отобрать CPU по I/O capability
↓
7. Выбрать exact server configuration
↓
8. Проверить OEM compatibility
↓
9. Прочитать block diagram
↓
10. Найти switches / shared uplinks
↓
11. Определить root sockets
↓
12. Определить NUMA mode/nodes
↓
13. Проверить host CPU workload
↓
14. Проверить memory subsystem
↓
15. Собрать сервер
↓
16. Проверить PCIe tree
↓
17. Проверить negotiated links
↓
18. Проверить NUMA/I/O topology
↓
19. Выполнить workload validation
Такой подход отвечает сразу на два вопроса:
Можно ли физически собрать нужную конфигурацию?
и:
Будет ли её topology подходящей именно для нашего data flow?
Worksheet для выбора CPU и платформы
WORKLOAD
Primary workload:
Critical data paths:
GPU
Exact model:
Count:
Expected PCIe generation:
Expected electrical width:
P2P requirements:
NETWORK
NIC model:
Count:
PCIe link:
RDMA:
GPUDirect RDMA required:
STORAGE
NVMe model/count:
Link per drive:
Backplane:
Critical GPU path:
CPU
Exact SKU:
Socket count:
PCIe capability:
Cores:
Memory channels:
SERVER
Exact model:
Base configuration:
Riser configuration:
GPU topology:
PCIe switches:
NIC/OCP topology:
NVMe topology:
NUMA
BIOS NUMA/NPS/SNC mode:
Root socket per device:
NUMA node per device:
CPU worker placement:
VALIDATION
PCI BDF map:
lspci tree:
Expected link:
Actual LnkSta:
numactl:
lstopo:
nvidia-smi topo:
Cross-NUMA critical paths:
PERFORMANCE
CPU saturation:
Locality A/B test:
I/O saturation:
Unresolved topology risks:
RESULT
CPU/platform accepted:
Особенно важное новое поле после technical review:
BIOS NUMA/NPS/SNC mode
Как понять, что CPU недостаточен
CPU/platform может быть слабым не только из-за количества ядер.
Проблема возможна, если:
OEM не поддерживает требуемое сочетание GPU/NIC/NVMe;
platform topology не даёт нужных links;
critical peers оказываются неудобно распределены;
CPU preprocessing насыщает cores;
memory subsystem не обеспечивает host workload;
второй socket создаёт нежелательный remote path для критичных устройств.
Это разные причины и требуют разных решений.
Как понять, что CPU избыточен
Если:
platform I/O requirement закрыт;
CPU не насыщается;
GPU получают данные вовремя;
memory subsystem не bottleneck;
добавление cores не меняет throughput;
переход на более старший CPU может не дать полезного эффекта.
А установка второго процессора без I/O/compute/memory причины может лишь усложнить NUMA topology.
В GPU-сервере нужен не максимальный CPU из прайс-листа.
Нужен CPU и server design, которые закрывают конкретные host-side ограничения workload.
Какой CPU выбрать для GPU-сервера
Начинайте со списка GPU, NIC и NVMe и с путей данных между ними.
Посчитайте ideal PCIe lane demand, но используйте это число только как первичный фильтр CPU.
После этого обязательно проверяйте exact server configuration: CPU count, risers, switches, storage backplane, NIC placement и electrical widths.
Отдельно зафиксируйте NUMA mode. Один CPU socket не обязательно соответствует одному NUMA node: архитектура и BIOS могут делить socket на несколько NUMA domains.
После сборки сравните план с фактической машиной:
OEM block diagram
↕
lspci tree / LnkSta
↕
NUMA topology
↕
lstopo
↕
GPU/NIC/NVMe topology
И только после этого используйте workload benchmark для оценки того, имеет ли найденная locality практическое значение.
Итоговый критерий можно записать так:
Подходящий CPU для GPU-сервера
=
достаточная CPU I/O capability
+
поддерживаемая OEM configuration
+
подходящая PCIe/NUMA topology
+
достаточный host compute
+
достаточная memory subsystem
+
проверенная actual configuration
Коротко:
Проверить баланс CPU, GPU и периферии
Для проверки конфигурации нужны точные модели и количество GPU, NIC и NVMe, CPU SKU, server model, base/riser configuration, планируемый NUMA mode и критичные потоки данных — например NIC→GPU или NVMe→GPU.
По этим данным можно проверить PCIe budget, switches, root/socket/NUMA placement и определить, подходит ли выбранная CPU/platform configuration до закупки оборудования.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


