Два GPU-сервера могут работать с датасетами одинакового размера, но требовать совершенно разную подсистему хранения.
Первый читает крупные подготовленные shards, почти ничего не пишет локально и сохраняет checkpoint раз в несколько часов. Второй обрабатывает миллионы небольших объектов, создаёт temporary data и регулярно пишет большие distributed checkpoints.
Для обоих можно найти NVMe с высокой максимальной скоростью чтения. Но из цифры вроде:
Sequential read: 14 GB/s
ещё нельзя понять, подходит ли накопитель конкретному training workload.
Для выбора NVMe нужно отдельно определить четыре бюджета:
Capacity
+
Read profile
+
Checkpoint / write profile
+
Endurance
↓
SSD class
↓
Drive count / pool layout
↓
Measured validation
Сколько и каких NVMe нужно для обучения: короткий ответ
Нагрузка | Что проверять в первую очередь |
Крупные dataset shards | sustained read throughput |
Много небольших samples | IOPS и latency |
Local dataset cache | capacity и read performance |
Большие checkpoints | sustained write throughput |
Частые checkpoints | write throughput и endurance |
Temporary preprocessing | mixed R/W и endurance |
Recoverable scratch/cache | capacity и performance |
Единственная копия данных | reliability и failure model |
Async checkpoint | staging + long-term drain rate |
Современные NVIDIA AI systems сами используют многоуровневую storage architecture: shared storage остаётся источником данных, local NVMe может работать как dataset cache и как быстрый временный tier для checkpointing. Это хороший пример того, почему «локальный SSD» не имеет единственной роли.
Сначала определите роль локального NVMe
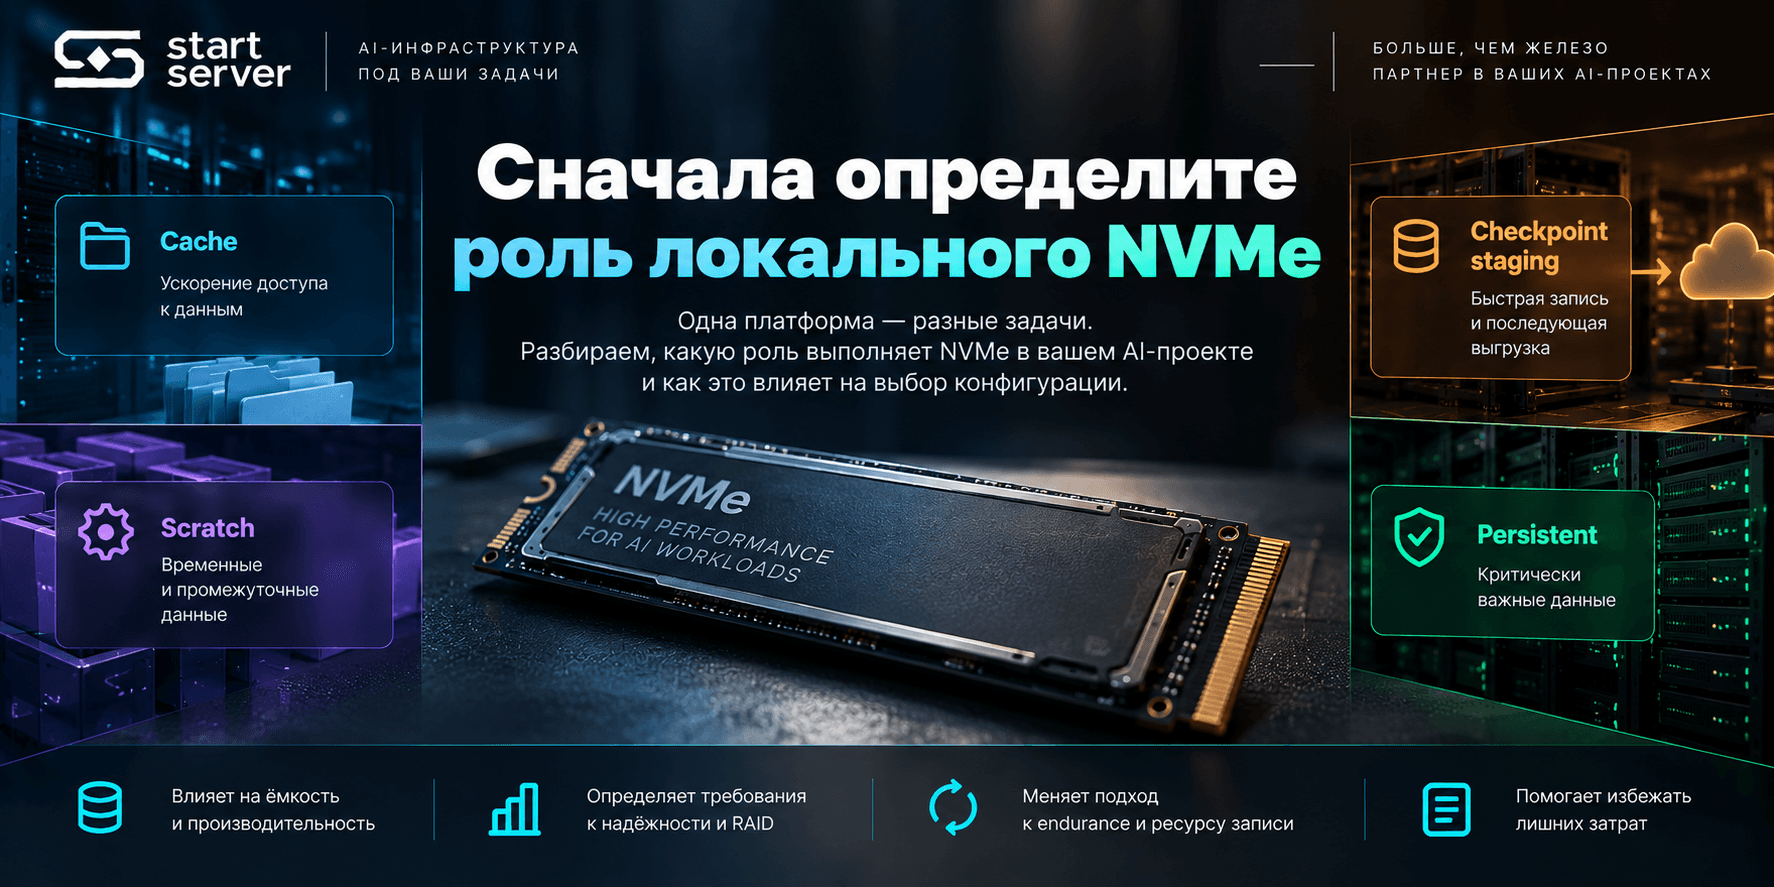
До расчёта GB/s нужно ответить на вопрос:
Что случится, если local NVMe pool будет полностью потерян?
Возможны четыре существенно разные роли.
Cache содержит копию данных, оригинал которых находится на другом storage. Потеря pool означает необходимость заполнить cache заново.
Scratch используется для воспроизводимых temporary/intermediate данных.
Checkpoint staging быстро принимает checkpoint, который затем должен попасть на более долговечное storage.
Persistent/authoritative storage содержит данные, потеря которых означает реальную потерю результата.
Эта классификация влияет не только на RAID. Она меняет требования к redundancy, PLP, endurance, capacity и recovery procedure.
Например, в DGX GB local E1.S NVMe объединяются в RAID 0 именно для caching. NVIDIA отдельно указывает, что local NVMe также может временно ускорять checkpointing, тогда как основные checkpoints обычно сохраняются на shared high-performance storage ради надёжности.
Отсюда правильный вывод не:
RAID0 нужен для AI.
А:
RAID level выбирается по failure model данных.
Размер dataset не равен ёмкости local NVMe
Если dataset занимает 20 TB, это не означает:
Local NVMe ≥ 20 TB
При наличии shared storage local SSD может хранить только рабочий cache.
NVIDIA прямо описывает такую модель: первое чтение идёт с shared storage, данные могут быть помещены в local NVMe cache, а повторные обращения обслуживаются уже локально.
Но и обратный расчёт неверен:
Dataset = 4 TB
→ достаточно 4 TB NVMe
У локального pool могут быть дополнительные потребители:
Local capacity requirement
≈
active dataset / cache
+
processed representation
+
retained checkpoints
+
temporary files
+
other persistent data
+
explicit operational reserve
Это структура бюджета, а не универсальная формула.
Не существует хорошего правила:
SSD capacity = dataset × 2
Total dataset и local working set — разные величины
Предположим:
Total dataset: 50 TB
Active working set: 8 TB
Если оставшиеся данные доступны на shared storage, а training node работает только с активной частью, local SSD необязательно должен вместить все 50 TB.
Для storage sizing поэтому нужно фиксировать отдельно:
Total dataset
Local active working set
Local cache policy
Processed representation
Checkpoint retention
Это аналогично расчёту RAM: полный dataset и одновременно используемый working set — разные вещи.
Sequential throughput, IOPS и latency нельзя заменять одной цифрой
Крупный shard и тысячи мелких файлов создают разные storage workloads.
Access pattern | Основные метрики |
Large sequential read | GB/s |
Large sequential write | GB/s |
Small random read | IOPS + latency |
Small random write | IOPS + latency + endurance |
Mixed R/W | throughput + IOPS + tail latency |
Metadata-heavy workload | latency + filesystem behavior |
Поэтому SSD с более высоким sequential read необязательно быстрее для dataset из миллионов небольших объектов.
Производители enterprise SSD сами измеряют эти режимы раздельно. Например, для KIOXIA CM9 sequential и random performance публикуются как разные характеристики; CM9-R заявляет до 3,400K random-read IOPS и до 540K random-write IOPS, тогда как mixed-use CM9-V — до 3,400K и 800K соответственно.
Размер I/O request тоже имеет значение
Нельзя сравнивать результат крупного sequential I/O с production workload, который почти полностью состоит из мелких random requests.
Поэтому вопрос:
Какова максимальная скорость SSD?
лучше заменить на:
Какие request sizes, access pattern и concurrency создаёт приложение?
Если datasheet измеряет sequential throughput крупными blocks, а training job выдаёт мелкие random requests, headline GB/s описывает другой режим работы.
Почему миллионы небольших файлов могут не упираться в GB/s
Для dataset из множества JPEG путь может выглядеть так:
filesystem metadata
↓
small file read
↓
DataLoader
↓
CPU decode
↓
augmentation
↓
GPU
Bottleneck может находиться в filesystem metadata, CPU decode или DataLoader ещё до насыщения NVMe.
Поэтому:
GPU idle не является доказательством storage bottleneck.
Нужно проверить цепочку:
GPU ждёт данные?
↓
DataLoader действительно ждёт I/O?
↓
CPU preprocessing не насыщен?
↓
Есть заметная storage queue / latency?
↓
Упирается ли read throughput в storage path?
Checkpoint нужно считать отдельным storage workload
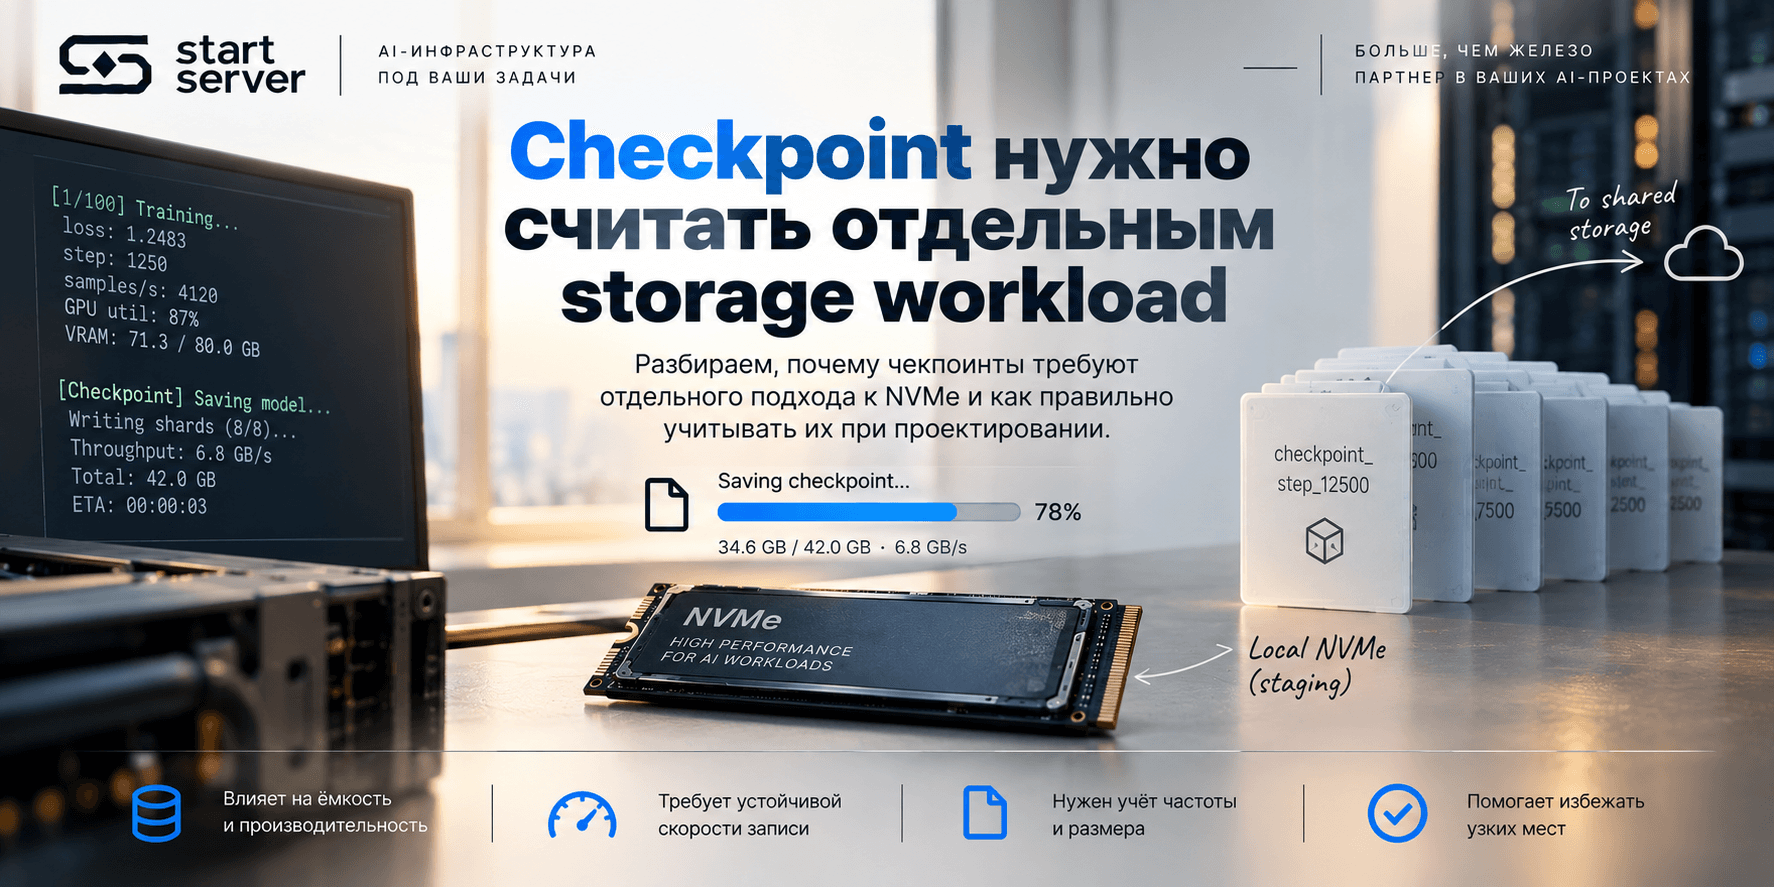
Dataset reads могут быть почти полностью read-heavy, а checkpoint раз в несколько минут создавать большой write burst.
Для больших distributed workloads checkpointing может становиться заметным ограничением, потому что synchronous save остаётся в critical path training до окончания соответствующей операции записи. PyTorch Distributed Checkpoint при этом может сохранять данные с нескольких ranks параллельно и создаёт multiple files — как минимум по одному на rank в описываемой модели DCP.
Поэтому storage нужно проверять отдельно на:
training reads
и
checkpoint writes
Даже если оба используют один и тот же NVMe pool.
Как рассчитать storage SLA для synchronous checkpoint
Пусть:
C = размер checkpoint
T_pause = максимально допустимая пауза
Тогда минимальный application-level throughput:
B_write_required ≈ C / T_pause
Учебный пример:
Checkpoint = 500 GiB
Допустимая пауза = 60 s
Получаем:
500 / 60
≈ 8.33 GiB/s
Но manufacturers SSD обычно публикуют throughput в decimal GB/s.
Перевод:
8.33 GiB/s
≈ 8.95 GB/s
Полученные 8.95 GB/s — требование к end-to-end checkpoint path.
Это не означает:
достаточно SSD с advertised sequential write 9 GB/s.
Между моделью и SSD находятся:
checkpoint serialization/sharding
filesystem
parallel writers
sync semantics
RAID / striping
block layer
PCIe topology
SSD
C / T задаёт SLA приложения, а не готовый SKU.
Почему checkpoint нельзя benchmark-ить только через один большой файл
PyTorch DCP сохраняет distributed state с нескольких ranks параллельно и формирует несколько файлов.
Поэтому реальный профиль может быть:
32 или 64 writers
↓
множество checkpoint shards
↓
parallel writes
а не:
1 writer
→ 1 большой файл
Для проверки нужно знать:
writer count
file count
file-size distribution
concurrency
sync semantics
Async checkpoint не отменяет storage workload
Asynchronous checkpointing позволяет отделить часть save operation от основного training loop, но данные всё равно нужно записать.
В актуальном PyTorch DCP async_save() сначала создаёт безопасную staged representation checkpoint — обычно в CPU RAM — после чего storage save выполняется отдельно. PyTorch предупреждает как о дополнительном memory pressure, так и о необходимости управлять количеством одновременно незавершённых checkpoints.
Поэтому фраза:
async checkpoint не требует быстрого storage
неверна.
Меняется SLA, а не исчезает I/O.
У asynchronous checkpoint два разных ограничения
Для обычного synchronous режима:
B_sync ≈ C / T_pause
Для долговременного async pipeline появляется другое минимальное условие:
B_drain_average ≳ C / T_interval
где T_interval — интервал между создаваемыми checkpoints.
Пусть:
C = 500 GiB
T_interval = 15 min = 900 s
Тогда:
500 / 900
≈ 0.56 GiB/s
≈ 0.60 GB/s
Около 0.60 GB/s — лишь средняя скорость drain, ниже которой backlog при непрерывной такой нагрузке будет накапливаться.
Это не минимальная требуемая скорость SSD во всех смыслах.
На практике остаются:
burst write;
staging capacity;
другие reads/writes;
желаемое время завершения checkpoint;
количество concurrent writers;
CPU memory pressure.
PyTorch сам рекомендует контролировать незавершённые async requests вместо бесконтрольного накопления checkpoint operations.
В новых PyTorch можно асинхронно выполнять и staging — но это version-specific
Есть ещё один нюанс.
В более новых PyTorch DefaultStager может вынести подготовку state dictionary и GPU→CPU copy в background thread. Стандартный async path и fully asynchronous staging — не одно и то же. PyTorch также отмечает, что pinned-memory staging удерживает дополнительный CPU memory footprint и требует собственных CPU resources.
Поэтому в storage sizing не нужно предполагать:
async = нулевая pause.
Нужно измерить конкретный framework/version/checkpoint implementation.
Checkpoint capacity определяется retention policy
Если:
Checkpoint size = C
Локально храним N generations
то базовая оценка:
Checkpoint capacity ≈ C × N
Например:
500 GiB × 4
= 2000 GiB
Но это только storage component.
Реальная политика может включать:
current checkpoint
+
previous versions
+
checkpoint being uploaded
+
temporary/incomplete save
или, наоборот, local storage может хранить лишь один staging checkpoint.
Поэтому retention policy нужно фиксировать явно.
Endurance нужно считать отдельно от производительности
После GB/s возникает другой вопрос:
Сколько записи SSD должен пережить?
Для enterprise SSD часто используется DWPD — Drive Writes Per Day.
Упрощённо:
Nominal daily write budget
≈
User capacity × DWPD
Например:
6.4 TB × 3 DWPD
= 19.2 TB/day
Но 3 DWPD имеет смысл только вместе со сроком rating и workload assumptions производителя.
Нельзя отрывать число DWPD от datasheet.
Два быстрых Gen5 SSD могут иметь в три раза разную endurance class
Хорошая иллюстрация — KIOXIA CM9.
CM9-R — read-intensive PCIe 5.0 / NVMe 2.0 SSD с 1 DWPD.
CM9-V — mixed-use PCIe 5.0 / NVMe 2.0 SSD с 3 DWPD.
Обе серии имеют Power Loss Protection, но предназначены для разных write profiles.
То есть одинаковая interface generation и высокий read performance ещё ничего не говорят о подходящем объёме ежедневной записи.
Solidigm показывает ту же сегментацию: D7-PS1010 относится к 1-DWPD class, а PS1030 — к 3-DWPD class; при этом обе линейки имеют PCIe 5.0 и сходные верхние последовательные показатели, но различаются по целевому write workload и max PBW.
Как оценить workload DWPD
Сначала считаем host writes/day.
Например:
Checkpoints: 6 TB/day
Temp output: 2 TB/day
Cache/staging: 3 TB/day
─────────
Host writes: 11 TB/day
Если вся запись приходится на один 7.68-TB SSD:
11 / 7.68
≈ 1.43 drive writes/day
Это workload-derived estimate порядка 1.43 DWPD.
Он уже показывает, что SSD класса 1 DWPD нельзя выбирать без дальнейшего анализа.
Но из этого не следует автоматически:
покупаем 3-DWPD SSD.
Нужно проверить:
exact SKU;
endurance rating period;
vendor workload conditions;
проектный срок;
распределение writes между drives;
RAID/filesystem behavior.
Для пула DWPD нужно считать по фактическому распределению записи
Если четыре SSD объединены в stripe, нельзя просто взять общий logical TB/day и считать, что каждый диск получает ровно четверть во всех режимах.
На распределение могут влиять:
stripe geometry
filesystem
metadata
parity/mirror
copy-on-write
workload distribution
Поэтому предварительную модель можно построить арифметически, но per-drive host writes лучше подтвердить telemetry.
Особенно осторожно нужно относиться к RAID1/RAID5/RAID6 и CoW-filesystems: logical application writes и записи на каждый SSD уже не совпадают напрямую.
NVMe SMART позволяет измерить host writes
В NVMe SMART/Health information есть поле:
Data Units Written
Оно отражает количество данных, записанных host в controller, без metadata; единица счётчика равна тысяче 512-byte units и округляется вверх.
Практическая методика:
SMART before
↓
Representative workload
↓
SMART after
↓
Δ Data Units Written
↓
Host writes for workload
Это позволяет проверить расчёт endurance реальной нагрузкой.
Data Units Written — не запись в NAND
Это принципиальное ограничение.
NVMe определяет Data Units Written как host writes to controller.
Контроллер внутри SSD может выполнять:
garbage collection
wear leveling
internal relocation
поэтому:
Host writes
≠
NAND/media writes
Без vendor-specific media-write telemetry нельзя вычислить реальную NAND write amplification только из стандартного Data Units Written.
Поэтому в статье используем термин host writes, а не «износ NAND в TB».
Performance, endurance и PLP отвечают на разные вопросы
Характеристика | Что она определяет |
Capacity | сколько помещается |
Sequential GB/s | крупные transfers |
Random IOPS | количество мелких операций |
Latency | задержка операций |
DWPD/TBW/PBW | write endurance |
PLP | поведение при потере питания |
Form factor | совместимость с сервером |
Это независимые свойства.
SSD с 3 DWPD не обязательно быстрее SSD с 1 DWPD.
PLP не повышает throughput.
PCIe Gen5 не определяет endurance.
Например, обе KIOXIA CM9-series имеют enterprise PLP, хотя одна относится к 1-DWPD read-intensive class, а другая к 3-DWPD mixed-use.
RAID0 может быть правильным решением — только для подходящих данных
Для recoverable cache/scratch striping без redundancy может быть оправдано.
NVIDIA именно так использует local cache NVMe в DGX GB — RAID 0 как единый cache volume.
Но это platform-specific архитектурное решение для восстанавливаемого cache.
Если на pool лежит единственная актуальная копия checkpoint, failure model уже совершенно другой.
Поэтому:
Сколько SSD нужно: три независимых ограничения
Для предварительного выбора полезно отдельно получить:
N_capacity
N_performance
N_endurance
Candidate configuration должна удовлетворять каждому из ограничений.
Концептуально:
N_candidate
≥ max(
N_capacity,
N_performance,
N_endurance
)
Но здесь есть важная оговорка.
N_capacity обычно можно рассчитать достаточно прямо.
N_endurance — предварительно оценить из write distribution.
А N_performance нельзя надёжно получить простым линейным делением, потому что aggregate throughput SSD не обязан масштабироваться пропорционально их количеству.
Поэтому N_performance — результат candidate design + benchmark, а не только арифметики.
Самый жёсткий бюджет может оказаться не capacity
Например:
Capacity → 2 SSD
Endurance → 3 SSD
Performance → candidate 4 SSD
Тогда рассматривать нужно как минимум четырёхдисковую конфигурацию.
Но даже здесь не делаем вывод:
4 SSD точно подходят
Потому что ещё не проверены:
PCIe topology
shared uplinks
RAID/stripe implementation
filesystem
request concurrency
CPU/NUMA
То есть drive-count calculation создаёт candidate pool, а не финальную гарантию.
Почему четыре SSD по 10 GB/s не дают гарантированные 40 GB/s
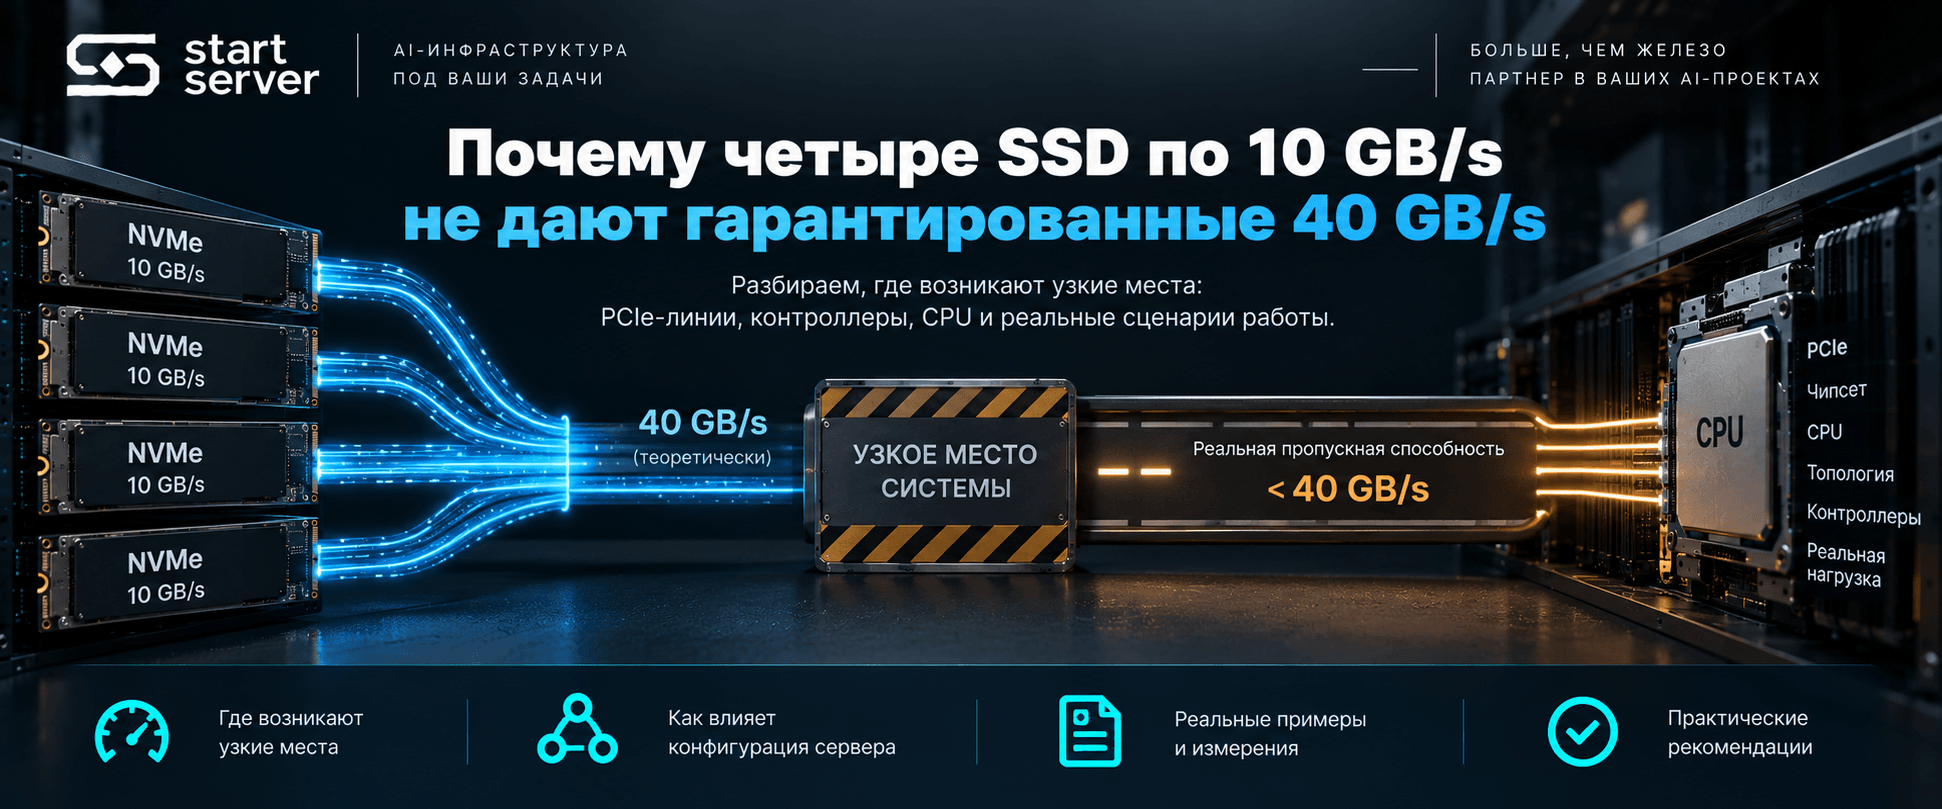
Рекламная арифметика:
4 × 10 GB/s = 40 GB/s
описывает только сумму отдельных headline limits.
Реальный путь:
Application
↓
Filesystem
↓
RAID / stripe
↓
Linux block layer
↓
PCIe switches / root complex
↓
SSD0 SSD1 SSD2 SSD3
может иметь shared bottleneck задолго до теоретических 40 GB/s.
NVMe topology нужно проверить до benchmark
Несколько быстрых SSD могут находиться:
за одним PCIe switch;
на разных root complexes;
на разных sockets;
за общим upstream.
Этот вопрос подробно разобран в SS-009.
Для SS-010 достаточно зафиксировать:
Drive BDF
PCIe speed/width
Root socket
NUMA locality
Switch/uplink
чтобы storage benchmark измерял именно предполагаемую архитектуру, а не случайное размещение накопителей.
NVMe в сервере не означает GPUDirect Storage
GPUDirect Storage — отдельный software/hardware path.
Сам факт наличия local NVMe не включает GDS автоматически.
Поэтому:
NVMe installed
≠
GDS enabled
Если GDS действительно является требованием проекта, его compatibility, filesystem/software path и storage↔GPU topology нужно проверять отдельно.
SS-010 не использует наличие GDS как предположение по умолчанию.
Сначала измеряйте training, потом пишите synthetic benchmark
Правильный порядок:
Actual training
↓
I/O profile
↓
Matched synthetic workload
↓
Storage capability
а не наоборот.
Перед fio полезно определить:
sequential / random
read / write ratio
request size
reader/writer count
queue depth
checkpoint concurrency
И только затем строить тест.
iostat помогает увидеть фактическую block-device нагрузку
Хорошая первая команда:
iostat -x 1
Она показывает, среди прочего:
read/write rates;
размер requests;
await;
r_await / w_await;
average queue size.
Эти показатели полезны вместе с application telemetry.
Например, рост queue и latency одновременно с data wait гораздо интереснее, чем одиночная цифра throughput.
%util=100 не доказывает, что современный NVMe полностью исчерпан
Это особенно важная поправка к популярным Linux guides.
Документация iostat прямо говорит: близкий к 100% %util указывает на saturation для устройств, обслуживающих запросы последовательно, но для parallel devices вроде RAID и современных SSD этот показатель не отражает performance limits таким же образом.
Поэтому нельзя писать:
%util = 100%
→ NVMe bottleneck доказан
Нужно смотреть одновременно на:
application wait
throughput
latency
queue depth
request size
и изменение поведения при дополнительной нагрузке.
fio должен имитировать конкретный access pattern
fio умеет задавать разные виды I/O:
read
write
randread
randwrite
sequential mixed
random mixed
а также direct/buffered I/O, block size, number of jobs, queue depth и latency reporting.
Следовательно, benchmark:
4 KiB random read
QD128
не подтверждает performance workload, который на самом деле последовательно читает крупные shards небольшой concurrency.
Requested iodepth и фактически достигнутая depth — разные вещи
Если в fio указано:
iodepth=32
это ещё не гарантирует 32 одновременно находящихся в полёте I/O.
Документация fio прямо предупреждает, что sync engines и ограничения OS/ioengine могут не позволить достичь requested depth; результат нужно проверять по I/O depth distribution.
Поэтому в benchmark report недостаточно написать:
QD32.
Нужно подтвердить, что workload действительно работал при ожидаемой глубине.
Для random workload нужны latency percentiles
Среднее значение latency способно скрывать редкие, но очень длинные задержки.
fio умеет выводить completion и total latency percentiles и позволяет явно задавать percentile list.
Для latency-sensitive pipeline полезнее сохранять минимум:
p50
p95
p99
чем только average latency.
Особенно когда параллельно работают десятки DataLoader workers.
Direct I/O и реальный training отвечают на разные вопросы
В fio:
direct=1
обычно означает non-buffered/O_DIRECT I/O, тогда как default buffered mode использует другой path.
Поэтому:
fio direct test
→ capability underlying storage path
а:
actual training
→ application + filesystem + cache behavior
Это два разных измерения.
Если repeated epochs выигрывают от page cache или application cache, direct benchmark намеренно исключает часть production behavior.
Он полезен, но не заменяет training test.
Как выбирать exact SSD SKU
После расчёта workload можно переходить к datasheet.
Нужно зафиксировать не только family name, а:
Exact SKU / capacity
Form factor
PCIe generation
Sequential read/write
Random read/write
DWPD
Rating period
TBW/PBW
PLP
Server compatibility
Почему exact capacity важна: характеристики внутри одной серии могут отличаться.
Например, CM9-R существует в широком диапазоне capacities, а сама серия характеризуется как 1-DWPD read-intensive. CM9-V имеет другие capacity limits и 3-DWPD mixed-use positioning.
Нельзя сравнивать просто:
KIOXIA CM9
vs
Solidigm D7
без SKU/capacity.
PCIe Gen5 — не самостоятельная причина покупки
Gen5 увеличивает потенциальную interface bandwidth.
Но end-to-end training может ограничиваться:
filesystem metadata
small random I/O
CPU decode
DataLoader
checkpoint serialization
shared PCIe uplink
network storage
Поэтому решение должно звучать:
А не:
Для AI нужен Gen5.
Форм-фактор и backplane являются частью выбора SSD
Даже идеальный по endurance и performance SSD бесполезен, если сервер его не поддерживает.
Нужно проверить:
U.2 / U.3 / E3.S / E1.S
PCIe generation
backplane
hot-swap support
power
thermal design
supported SSD list
Например, современные enterprise families выпускаются в разных form factors: Solidigm D7-PS1010/PS1030 доступны в U.2 и E3.S, а KIOXIA CM9 также имеет серверные варианты для разных physical layouts.
Поэтому:
4 × 7.68 TB Gen5 NVMe
ещё не является полной BOM-спецификацией.
Не смешивайте decimal и binary units
При capacity и throughput это приводит к вполне заметной ошибке.
1 TB = 10^12 bytes
1 TiB = 2^40 bytes
1 GB/s = 10^9 bytes/s
1 GiB/s = 2^30 bytes/s
Именно поэтому в checkpoint example:
500 GiB / 60 s
= 8.33 GiB/s
≈ 8.95 GB/s
а не 8.33 GB/s.
При sizing около физического предела pool разница уже существенна.
Полный порядок выбора NVMe для обучения
1. Определить роль local NVMe
↓
2. Определить local working set
↓
3. Зафиксировать file/object distribution
↓
4. Определить read pattern
↓
5. Измерить production read workload
↓
6. Определить checkpoint size
↓
7. Зафиксировать checkpoint frequency
↓
8. Разделить sync / async mode
↓
9. Посчитать checkpoint SLA
↓
10. Измерить host writes/day
↓
11. Определить endurance requirement
↓
12. Посчитать capacity
↓
13. Выбрать exact SSD candidates
↓
14. Сформировать candidate drive count
↓
15. Проверить backplane / PCIe topology
↓
16. Собрать storage pool
↓
17. Провести matched synthetic test
↓
18. Проверить actual training/checkpoint
Это позволяет перейти от workload к оборудованию без магического правила:
AI → Gen5 → 4 SSD
Worksheet для выбора NVMe-пула
STORAGE ROLE
Authoritative:
Cache:
Scratch:
Checkpoint staging:
DATASET
Total dataset:
Local active working set:
File/object count:
p50 object size:
p95 object size:
Format:
Repeated epochs:
READ PROFILE
Sequential / random / mixed:
Typical request size:
Concurrent readers:
Measured throughput:
Measured IOPS:
p50 latency:
p95 latency:
p99 latency:
CHECKPOINT
Checkpoint size:
Writer count:
Files per checkpoint:
Frequency:
Sync / async:
Staging implementation:
Allowed blocking pause:
Required completion/drain time:
WRITES
Checkpoint TB/day:
Cache/staging TB/day:
Temporary TB/day:
Measured host writes/day:
Estimated workload DWPD:
CAPACITY
Local dataset/cache:
Processed data:
Checkpoint retention:
Temporary:
Other persistent data:
Explicit reserve:
Required total:
SSD
Exact SKU:
User capacity:
Form factor:
PCIe:
Sequential read:
Sequential write:
Random read:
Random write:
DWPD:
Rating period:
TBW/PBW:
PLP:
POOL
Drive count:
RAID / stripe:
Recoverable:
Expected topology:
Root/NUMA placement:
VALIDATION
Actual read throughput:
Actual write throughput:
Actual I/O depth:
IOPS:
p95/p99 latency:
Checkpoint duration:
SMART Data Units Written delta:
GPU/data wait:
RESULT
Capacity accepted:
Performance accepted:
Endurance accepted:
Failure model accepted:
Как понять, что storage вообще не является bottleneck
Допустим, GPU периодически простаивают.
Покупать ещё NVMe сразу не нужно.
Проверяем:
GPU wait
↓
Application ждёт data?
↓
CPU preprocessing saturated?
↓
Есть ли значительный block-device I/O?
↓
Растут ли queue и latency?
↓
Меняется ли application throughput
при увеличении storage capability?
Если storage path далёк от наблюдаемого предела, latency не ухудшается, а CPU decode упирается в cores, дополнительный SSD проблему не устранит.
GPU starvation и storage bottleneck — не синонимы.
Какие NVMe в итоге нужны для обучения моделей
Начните не с модели SSD, а с роли storage.
Для dataset cache определите active working set и read pattern. Для checkpoint storage отдельно задайте размер checkpoint, writer concurrency, frequency, sync/async strategy и допустимую задержку. Для write-heavy workloads измерьте host writes/day и сравните их с endurance exact SKU.
После этого SSD pool должен одновременно пройти три проверки:
Capacity достаточно?
Performance достаточно?
Endurance достаточно?
При этом performance нельзя получить только умножением рекламных GB/s на число накопителей.
Candidate pool нужно проверить на фактической PCIe/NUMA topology, затем прогнать synthetic workload, соответствующий реальному I/O profile, и наконец — настоящий training/checkpoint workload.
Итоговый алгоритм:
Рассчитать подсистему накопителей
Для расчёта нужны объём dataset и local working set, количество и распределение размеров файлов, фактический read pattern, размер и частота checkpoints, число writers, sync/async strategy, ежедневный объём host writes и роль local NVMe — cache, scratch, staging или persistent storage.
По этим данным можно определить требуемую ёмкость, read/write throughput, endurance class и candidate drive count, а затем проверить, сможет ли выбранная GPU-серверная платформа реализовать этот storage design.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


