«Возьмём GPU помощнее, а там разберёмся» — так не работает. Так тратят несколько миллионов рублей и получают железо, которое не может нормально запустить нужную модель.
Заказчик смотрит на TFLOPS, количество ядер, красивую цифру в характеристиках GPU. Потом выясняется: модели не хватает VRAM, четыре видеокарты неправильно подключены к PCIe, сервер не справляется с охлаждением. Дорогая конфигурация в итоге работает хуже, чем более дешёвая, но правильно собранная.
Правильный вопрос звучит не «какой сервер нужен для ИИ», а «какую задачу должен решать сервер и какие ресурсы для этого нужны».
Разберём, как выбрать AI-сервер в 2026 году: сколько GPU и VRAM нужно для разных задач, чем инференс отличается от обучения, когда хватит одной видеокарты, а когда без multi-GPU не обойтись.
Почему TFLOPS — не главное
Начинать выбор с TFLOPS — частая ошибка. В большинстве AI-задач упираешься в GPU, но важна не только вычислительная мощность. Архитектура, Tensor-ядра, форматы вычислений, объём и тип VRAM, пропускная способность памяти, энергопотребление, возможность связи с другими GPU — всё это имеет значение.
Но сначала — VRAM. Если модель не помещается в видеопамять, мощность GPU уже неважна. Можно купить самый быстрый ускоритель на рынке — и всё равно упереться в память.
Поэтому первый вопрос всегда один: какую модель вы запускаете и в каком формате? Для LLM разница огромна — одна и та же модель в FP16, INT8 и INT4 требует совершенно разного объёма памяти.
Формула для первой прикидки:
количество параметров × байт на параметр = объём памяти под веса модели
Llama 3 70B в FP16: 70 млрд × 2 байта ≈ 140 ГБ.
«Отлично, берём GPU на 141 ГБ» — и вот тут многие останавливаются рано. Память нужна не только под веса. Есть ещё KV-cache, активации, служебные данные. Реальная потребность обычно заметно выше расчётного размера модели. С несколькими пользователями — ещё выше.
Правило простое: сначала VRAM, потом производительность GPU.
А ещё
Кейс: как мы посчитали VRAM для Llama 3 70B и ошиблись на 30%
Клиент попросил сервер под Llama 3 70B. Посчитали веса — около 130 ГБ. Решили, что H200 со 141 ГБ справится. На бумаге сходилось.
На практике — нет.
Забыли про KV-cache — память под уже обработанные токены. При контексте 2048 и одном пользователе она добавляет ещё десятки гигабайт.
130 ГБ на веса + 26 ГБ на KV-cache ≈ 156 ГБ. У H200 — 141 ГБ. Не помещается.
Пришлось квантовать до INT8. Памяти хватило, но клиент был недоволен потерей качества.
С тех пор VRAM считаем не по размеру весов, а с запасом: runtime, формат модели, контекст, batch size, количество пользователей. Причём если пользователей десять, а не один, KV-cache растёт пропорционально — это уже не мелочь, а десятки гигабайт разницы.
Так что «сколько VRAM нужно для LLM» — вопрос без единого числа в ответе. Нужно знать размер и формат модели, есть ли квантование, размер контекста, batch size, число одновременных пользователей и требуемую скорость.
Квантование
Квантование снижает объём памяти под параметры модели. FP16 → INT8 — размер падает примерно вдвое. 4-битные форматы экономят ещё больше. Библиотеки вроде bitsandbytes дают 8-битное и 4-битное квантование из коробки.
L40S, RTX PRO 6000 или H200?
Универсального лучшего GPU не существует. Три карты — три разных класса задач.
NVIDIA L40S. 48 ГБ GDDR6 ECC, 864 ГБ/с, до 350 Вт. Универсальный вариант, когда не нужен огромный объём VRAM на одной карте: генерация изображений, инференс небольших LLM, компьютерное зрение, смешанные нагрузки. Для Stable Diffusion или Flux одной карты часто хватает на несколько сотен креативов в день. С крупными моделями — уже нет: Llama 3 70B в FP16 на одну L40S не помещается.
NVIDIA RTX PRO 6000 Blackwell. 96 ГБ GDDR7 ECC, 1792 ГБ/с. Вариант для локальной AI-разработки, LLM, генеративного ИИ. Llama 3 70B в INT8 — уже реалистично: около 65 ГБ на веса плюс запас под KV-cache. Подходит и для дообучения с LoRA — команда дообучала 40-миллиардную модель на юридических текстах на двух таких картах, время обучения упало с двух недель до восьми часов.
NVIDIA H200. Другой класс. 141 ГБ HBM3e, до 4,8 ТБ/с, энергопотребление до 600 Вт и выше. Крупные LLM, высокопроизводительный инференс, обучение, HPC. Цена соответствующая. Покупать её просто потому, что мощнее — не всегда логично: для генерации изображений или небольшой LLM она может не успеть окупиться.
GPU | Память | Тип памяти | Для каких задач |
NVIDIA L40S | 48 ГБ | GDDR6 ECC | Инференс, генеративный ИИ, компьютерное зрение |
NVIDIA RTX PRO 6000 Blackwell | 96 ГБ | GDDR7 ECC | LLM, AI-разработка, data science, генеративный ИИ |
NVIDIA H200 | 141 ГБ | HBM3e | Крупные LLM, инференс, обучение, HPC |
Это не рейтинг от лучшего к худшему. L40S может быть разумнее H200, просто потому что дешевле и не требует такого бюджета.
Один, два или восемь GPU
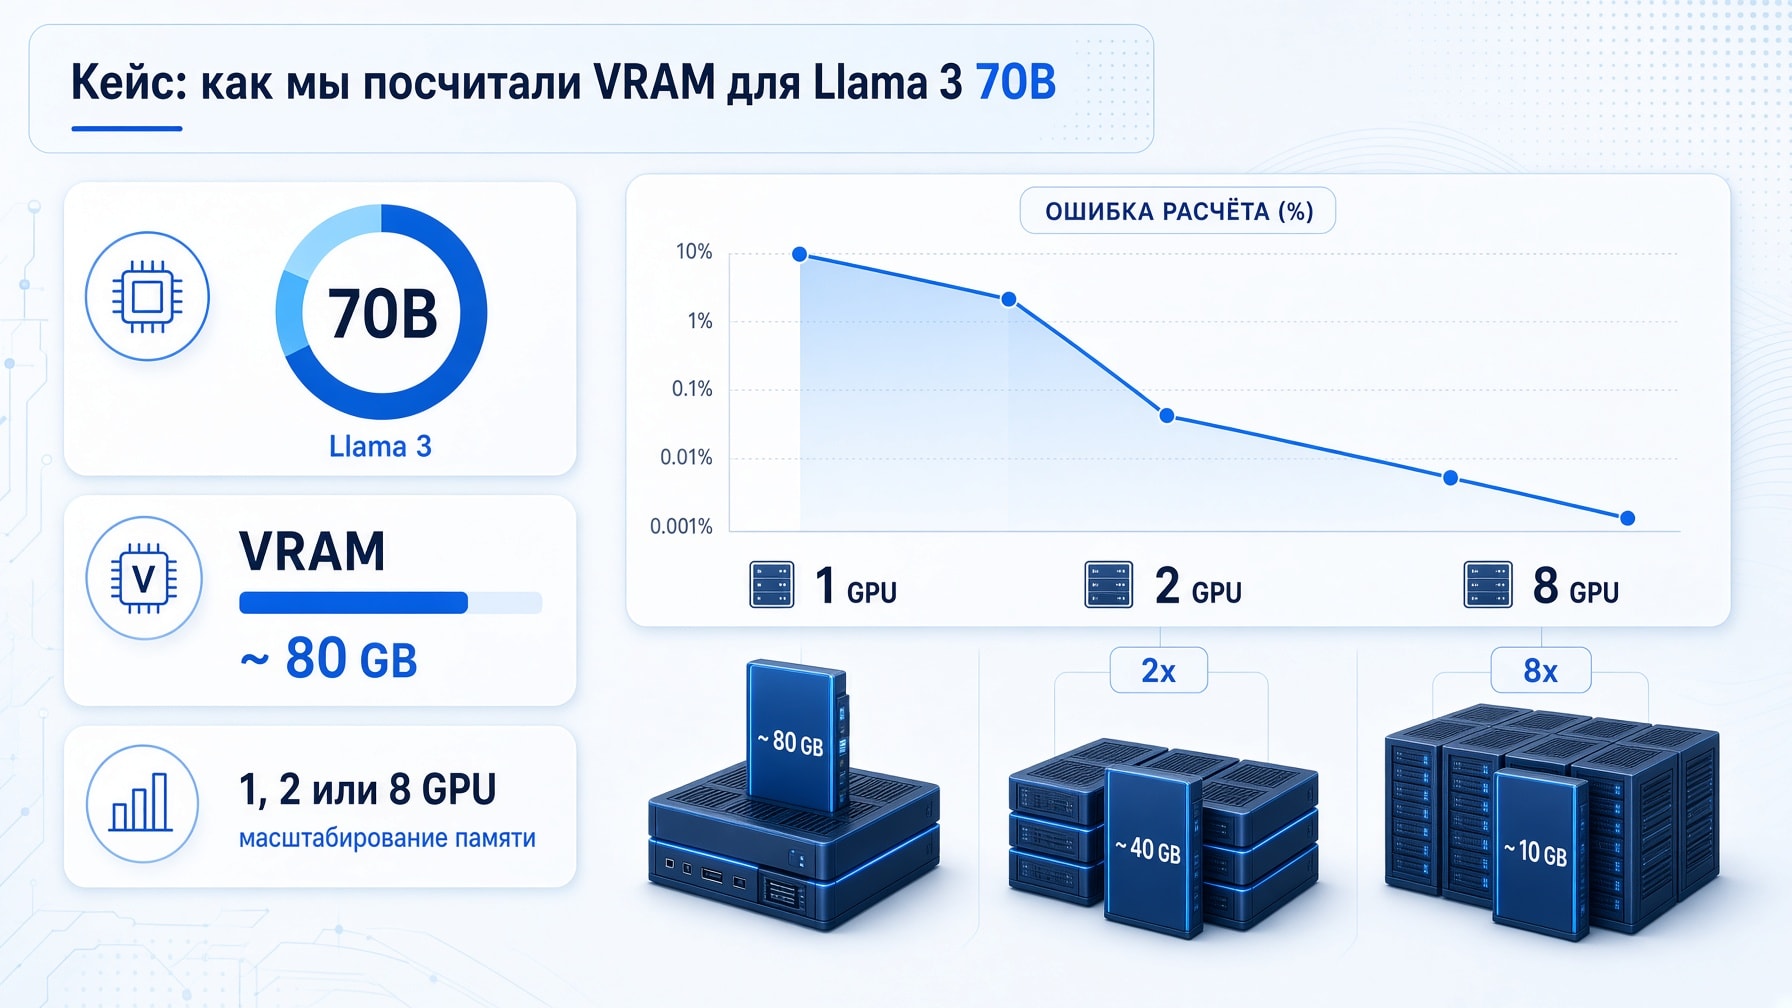
Одна GPU — если модель помещается в VRAM, нагрузка умеренная, пользователей немного. Проще всего в настройке и эксплуатации.
Две GPU — когда одной не хватает по памяти или производительности: модель не влезает, нужен больший throughput, несколько моделей одновременно, fine-tuning, распределение вычислений. Важно: две карты не значит вдвое больше производительности. Зависит от того, как задача распределяется между ними.
Четыре GPU. Здесь уже важна PCIe-топология, количество линий PCIe, межGPU-взаимодействие, питание, охлаждение, процессорная платформа, RAM, сеть. Просто поставить четыре мощные карты в корпус — недостаточно.
Восемь GPU — для крупных AI-систем, обучения больших моделей, высоконагруженного инференса, кластеров. Тут уже проектируется не сервер, а инфраструктура. И чем больше GPU, тем дороже ошибка на этапе проектирования.
Процессор, RAM, диски: на чём можно сэкономить, а на чём нет
GPU — главный компонент, но не единственный. Хорошая новость: не всё нужно покупать самое дорогое.
CPU отвечает за подготовку данных, загрузку моделей, ОС, сеть, диски, оркестрацию задач. Один мощный GPU — и топовый процессор за полтора миллиона может оказаться лишней тратой. Важнее подобрать CPU, который не ограничивает GPU, даёт нужное количество линий PCIe и объём RAM, подходит под платформу. С ростом числа GPU требования к процессору растут тоже.
RAM не заменяет VRAM. 80 ГБ нужно GPU-памяти — 256 ГБ обычной RAM это не решит. Оперативная память нужна для датасетов, подготовки данных, системных процессов, кэша, промежуточных вычислений. Считать нужно от задачи, не «на глаз».
SSD — обычно NVMe. Модели, датасеты, checkpoints, контейнеры, результаты экспериментов. Медленный диск — отдельное узкое место, особенно при обучении. Но десятки терабайт локального NVMe только потому, что сервер «для ИИ» — необязательно. В крупных проектах вычисления и хранилище разумнее разделять.
PCIe и NVLink: как одна шина задушила 4 GPU
Компания купила сервер с 4×A100 за 12 миллионов рублей. GPU мощные, на бумаге всё отлично. Проблема нашлась после установки.
Характеристики видеокарт проверили, PCIe-топологию — нет. При установке четырёх карт слоты оказались в конфигурации x8/x8/x8/x8, а не x16, как предполагалось. Производительность распределённого обучения — на 40% ниже ожидаемой.
Вопрос был простой: «Почему модель обучается почти в два раза дольше, чем в облаке?» lspci и разбор распределения линий сразу показали причину. Хуже всего — программно это не исправить. Пришлось менять платформу.
Вывод: запрашивайте у поставщика схему распределения PCIe-линий до покупки. Количество слотов само по себе ничего не гарантирует.
Охлаждение и питание: про это забывают, а зря
Мощный GPU превращает электричество в тепло. Больше ускорителей — серьёзнее задача охлаждения. L40S — до 350 Вт, RTX PRO 6000 Blackwell — около 600 Вт, H200 — до 600 Вт и выше. Несколько таких карт в одном сервере — заметная тепловая нагрузка.
Стартап собирал сервер на 4×RTX 4090 и решил сэкономить на корпусе — взяли обычный, для ПК. На тестах всё было в порядке. Через час работы карты грелись до 90°C, включался троттлинг, производительность падала на 30%. Экономия на корпусе обернулась потерей производительности.
В серверной сложнее: выше плотность, ограниченный воздушный поток, несколько GPU выделяют много тепла. Заранее считайте мощность блока питания и запас по нему, охлаждение, воздушный поток, температуру в серверной, плотность размещения, требования шасси. С несколькими мощными ускорителями охлаждение — не второстепенный параметр.
Свой сервер или облако? Считаем деньги
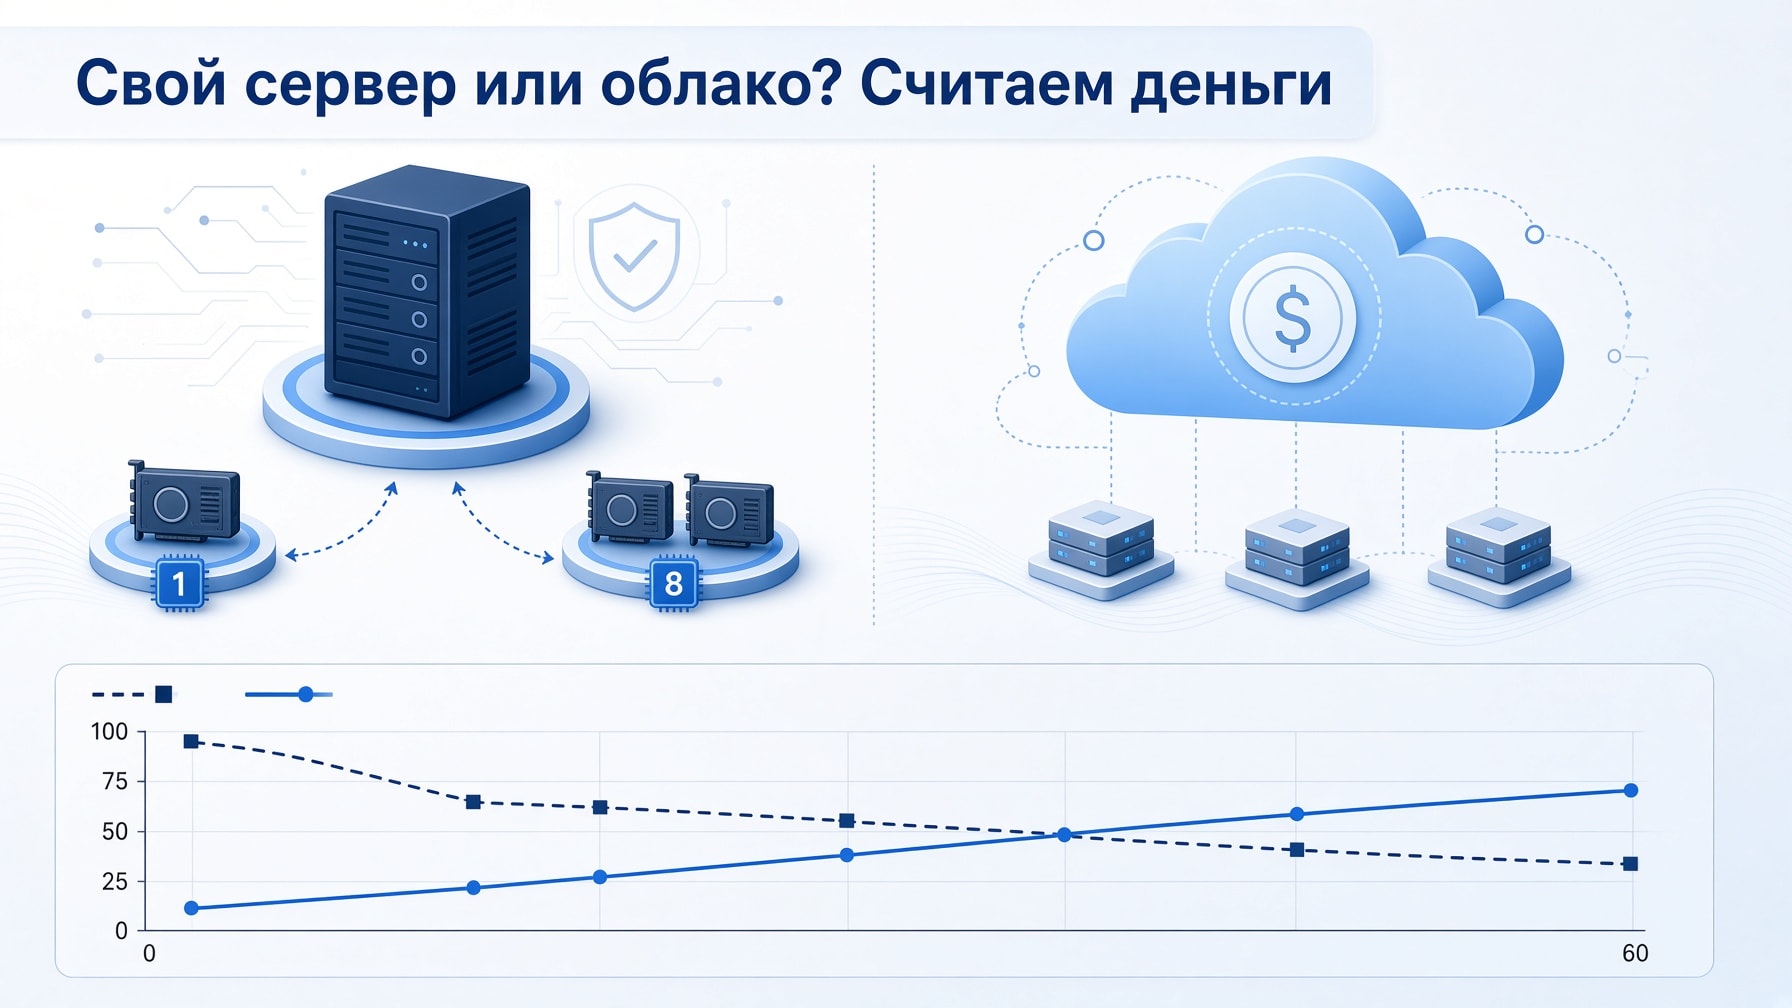
Зависит от нагрузки. Считать нужно, а не гадать.
Сервер 4×L40S — около 6,5 млн рублей. В облаке аналог — около 2 долларов за L40S в час.
720 часов × $2 × 4 GPU = $5760 в месяц ≈ 518 000 рублей при курсе 90. За год — около 6,2 млн. Сервер окупается примерно за год.
Но если сервер нужен пять дней в неделю по восемь часов — это 160 часов в месяц: 160 × $2 × 4 = $1280 ≈ 115 000 рублей в месяц, или 1,38 млн в год. Здесь покупка сервера за 6,5 млн уже не так очевидна — окупаемость растягивается на годы.
Перед покупкой: возьмите аналогичную конфигурацию в аренду, проверьте реальную загрузку GPU/CPU/RAM/дисков, посчитайте фактические часы работы в месяц, сравните аренду за год с покупкой, добавьте электричество, охлаждение, обслуживание, размещение — и посчитайте полный TCO.
Свой сервер выгоднее, если GPU загружены постоянно, нагрузка предсказуема, срок использования — несколько лет, есть требования к хранению данных, важна независимость от провайдера или аренда стала слишком дорогой.
Иногда цена вообще не главный аргумент. У одного клиента был проект с медицинскими данными — их нельзя было выносить в облако по требованиям к обработке и хранению. Сервер купили даже при небольшой загрузке. Безопасность и контроль оказались важнее экономии.
Чек-лист перед покупкой AI-сервера
Модель и нагрузка
Какая модель, сколько параметров, какой формат?
Используется ли квантование?
Сколько VRAM требуется?
Инференс или обучение?
Сколько пользователей одновременно, какой нужен throughput?
Железо
Сколько GPU нужно, помещается ли модель в их память?
Можно ли масштабировать сервер?
Сколько линий PCIe доступно, как подключены GPU?
Нужен ли NVLink или аналог?
Достаточно ли RAM и NVMe?
Какой сетевой интерфейс нужен?
Эксплуатация
Хватит ли мощности блока питания, справится ли охлаждение?
Подходит ли сервер под стойку?
Совместимы ли GPU с ОС, CUDA, PyTorch, TensorFlow?
Какова полная стоимость владения?
Что будет, если нагрузка вырастет через год?
Частые вопросы
Что такое AI-сервер? Сервер с GPU или другими ускорителями, заточенный под задачи ИИ и машинного обучения. Например, сервер с 2-4 GPU под инференс LLM для внутреннего чат-бота компании.
Чем AI-сервер отличается от обычного? Ускорителями и инфраструктурой под высокую нагрузку — GPU, VRAM, PCIe, питание, охлаждение. Обычный веб-сервер с этими параметрами почти не работает: там на первом месте CPU и диски.
Сколько GPU нужно для ИИ? От одной до восьми и больше. Одна карта — для небольшой модели и умеренной нагрузки, например инференса 7B-модели для десятка пользователей. Несколько — для крупных LLM или обучения, как в кейсе с 4×A100 выше.
Сколько VRAM нужно для LLM? Зависит от модели, формата, квантования, контекста, числа пользователей. Пример: 7B-модель в INT4 уместится и в 8 ГБ, а 70B в FP16 с несколькими пользователями потребует уже 150+ ГБ, как в кейсе с Llama 3 выше.
Можно ли запустить большую LLM на одной видеокарте? Да, если формат помещается в VRAM. Например, 70B-модель в INT4 может влезть в одну RTX PRO 6000, тогда как в FP16 та же модель туда не поместится.
Что важнее: VRAM или производительность GPU? Сначала VRAM — если модель не помещается, скорость уже неважна. Дальше сравниваются TFLOPS, пропускная способность и остальное.
Можно ли объединить несколько GPU? Да, но не как «одна большая видеокарта». Пример — сервер 4×A100 из этой статьи: карты формально мощные, но из-за неправильной PCIe-топологии производительность распределённого обучения просела на 40%.
Нужен ли мощный CPU для AI-сервера? Не всегда. Для одного GPU достаточно среднего процессора, который не станет узким местом — топовый CPU за полтора миллиона в такой сборке просто простаивает.
Сколько RAM нужно для AI-сервера? Зависит от датасетов и числа параллельных процессов. Для инференса одной модели часто хватает 64-128 ГБ, для активной подготовки данных и обучения — больше.
Какой SSD нужен для AI? NVMe — под модели, датасеты, checkpoints, кэши. Пример: чекпоинты 70B-модели при частом сохранении легко занимают сотни гигабайт, и на SATA SSD запись начинает тормозить весь пайплайн.
Что лучше: один мощный GPU или несколько? Один — если модели и нагрузки хватает, как в сценарии с генерацией изображений на одной L40S. Несколько — если нужен больший VRAM, throughput или распределённое обучение, как в кейсе с двумя RTX PRO 6000 под LoRA.
Какой GPU выбрать для LLM? Смотрите на VRAM и требования модели. Небольшая LLM — L40S, средняя с квантованием — RTX PRO 6000, крупная в высоком качестве — H200, как в сравнении выше.
Какой сервер нужен для обучения нейросетей? Обычно больше ресурсов, чем для инференса: GPU, VRAM, межGPU-связь, RAM, накопители, сеть. Обучение 40B-модели с LoRA на двух RTX PRO 6000 из кейса выше — пример среднего уровня такой конфигурации.
Что выбрать: облачный GPU или выделенный сервер? Периодическая нагрузка — облако, как в примере с 160 часами в месяц выше. Постоянная высокая загрузка — свой сервер, как в примере с 720 часами.
Можно ли начать с одной GPU и потом расширить сервер? Да, если платформа изначально это поддерживает — например, есть свободные PCIe-слоты и запас по питанию. Проверяйте это до покупки, а не после.
Итог
Не начинайте с поиска самой дорогой видеокарты. Сначала модель и задача. Потом VRAM: формат, квантование, число пользователей, требуемая скорость. Только после этого — GPU, CPU, RAM, накопители, сеть, питание, охлаждение.
Небольшая модель и умеренная нагрузка — хватит одного GPU. Крупная LLM, обучение, высокая нагрузка — нужна multi-GPU-система или кластер.
Хороший AI-сервер — не самый мощный. Это конфигурация без очевидных узких мест, с запасом под конкретную задачу.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


