Видеокарту для ИИ выбирают не по игровому FPS и не по одной цифре TFLOPS. Сначала определяют модель и режим работы, затем считают необходимый объем видеопамяти, проверяют программную совместимость и только после этого сравнивают скорость, энергопотребление и стоимость готовой системы.
Для локального инференса небольшой модели может хватить одной потребительской GPU с 12-16 ГБ VRAM. Для более крупной LLM, длинного контекста или нескольких одновременных пользователей нужны 24, 32, 48 или 96 ГБ. Полное обучение и высоконагруженный сервис часто требуют серверных ускорителей с HBM, быстрых связей между GPU и специализированной платформы.
Универсальной лучшей видеокарты для нейросетей нет. GPU становится подходящей только относительно конкретной нагрузки: модели, точности вычислений, batch size, контекста, числа запросов, допустимой задержки и программного стека.
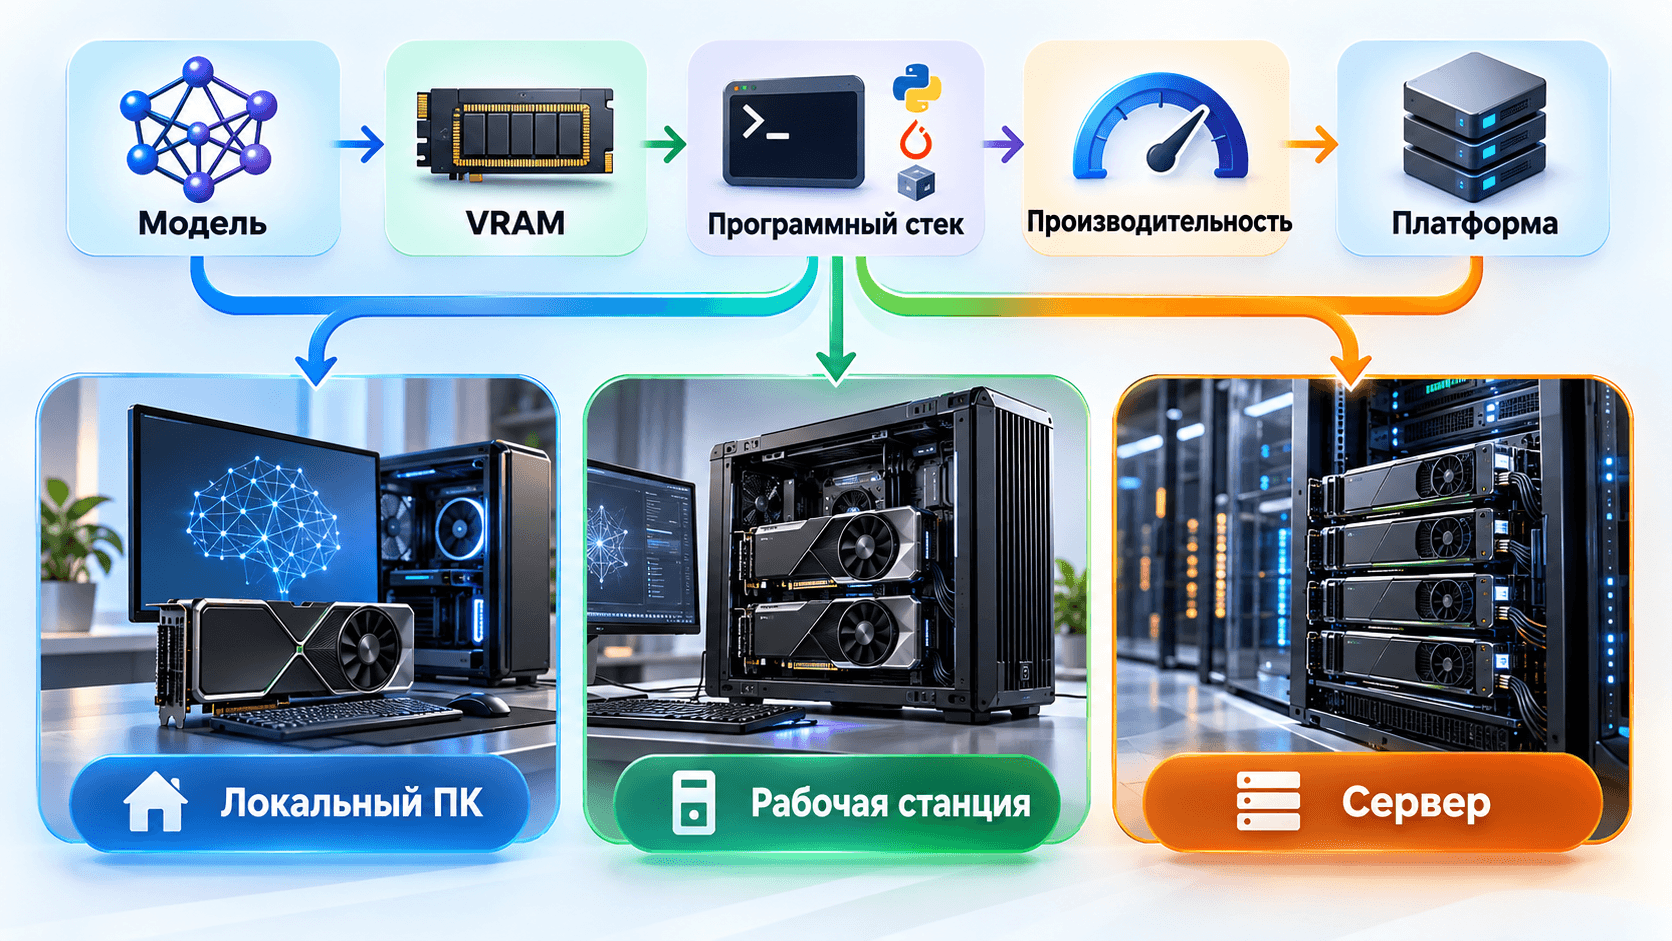
Короткий ответ: какая видеокарта нужна для ИИ
Если нужен быстрый ориентир, используйте такую развилку:
Сценарий | С чего начать подбор | Что проверить до покупки |
|---|---|---|
Знакомство с локальными моделями, разработка и прототипы | Одна GPU с 12-16 ГБ VRAM | Помещается ли точная модель, поддерживает ли ее runtime, достаточно ли питания и охлаждения |
Локальный ИИ с более крупными LLM, генерацией изображений и несколькими моделями | 24-32 ГБ VRAM | Реальный размер checkpoint, контекст, offload, скорость памяти, совместимость корпуса и БП |
Профессиональная рабочая станция, большой локальный контекст, несколько пользователей | 48-96 ГБ VRAM, ECC и профессиональный класс | Драйвер, лицензирование, режим разделения ресурсов, охлаждение и гарантийная модель |
Корпоративный инференс, компьютерное зрение, транскодирование | L4, L40S, RTX PRO или другой ускоритель под профиль нагрузки | Latency, throughput, число потоков, кодеки, vGPU, режим 24 на 7 |
Обучение, крупный fine-tuning, большие LLM и HPC | H200, Instinct MI300X или более новый датацентровый класс | HBM, interconnect, multi-GPU topology, сеть, СХД, питание и программный стек |
Диапазоны VRAM в таблице не являются гарантией запуска. Две модели с одинаковым числом параметров могут занимать разный объем памяти. На итог влияют тип архитектуры, формат весов, контекст, KV-cache, batch size, активации, runtime и служебные буферы.
Если задача уже описана на уровне сервиса, а не отдельного эксперимента, полезно сразу смотреть каталог видеокарт и GPU-ускорителей вместе с совместимой платформой. Карта, сервер и программная среда образуют одну систему.
Почему для ИИ используют видеокарты
Большая часть вычислений в нейросетях сводится к операциям над матрицами и тензорами. GPU содержит множество вычислительных блоков и выполняет большое число похожих операций параллельно. Центральный процессор лучше справляется с последовательной логикой, управлением системой, подготовкой данных и задачами общего назначения.
Это отвечает на запрос «зачем видеокарта для ИИ», но не означает, что CPU больше не нужен. В рабочей системе процессор читает и преобразует данные, обслуживает сеть и хранилище, запускает процессы, управляет очередями и передает работу ускорителю. Недостаток RAM, медленный NVMe или неудачная PCIe-топология могут оставить дорогую GPU без данных.
Использование видеокарты для ИИ дает три практических преимущества:
Параллельная обработка больших массивов чисел ускоряет обучение и инференс.
Специализированные матричные блоки работают с форматами FP32, TF32, BF16, FP16, FP8, INT8 или FP4, если конкретные GPU и ПО их поддерживают.
Высокая пропускная способность локальной памяти сокращает время перемещения весов, активаций и других данных внутри ускорителя.
Сначала разделите инференс, дообучение и полное обучение
Фраза «видеокарта для работы с ИИ» объединяет нагрузки с очень разными требованиями.
Инференс
Инференс означает запуск уже обученной модели. Для LLM GPU хранит веса, KV-cache, промежуточные данные и рабочие буферы. Для сервиса имеют значение:
время до первого токена;
скорость генерации;
число одновременных запросов;
длина входа и ответа;
стабильность задержки под нагрузкой;
объем памяти на один процесс или реплику.
Локальная нейросеть с одним пользователем и корпоративный API на сотни одновременных запросов могут использовать одну модель, но потребуют разных конфигураций.
Дообучение
LoRA и QLoRA уменьшают объем обучаемых параметров и могут сделать эксперимент доступным на одной или нескольких GPU. Однако память все равно требуется для базовой модели, адаптеров, активаций, градиентов, оптимизатора и служебных данных. Нельзя определить подходящую видеокарту только по слову fine-tuning.
Полное обучение
Видеокарта для обучения нейросетей с обновлением всех параметров должна хранить намного больше данных, чем при инференсе. Для типичного mixed precision training с AdamW документация Hugging Face приводит ориентир 18 байт на параметр плюс память активаций. Это пример для понимания масштаба, а не универсальная формула для любой архитектуры.
Модель на 8 млрд параметров при таком грубом ориентире потребует около 144 ГБ еще до учета активаций. Распределенное обучение, ZeRO, checkpointing, offload и другие методы меняют расклад, но добавляют коммуникации и требования к системе. Поэтому мощные видеокарты для ИИ в обучающем кластере выбирают вместе с топологией, сетью и хранилищем.
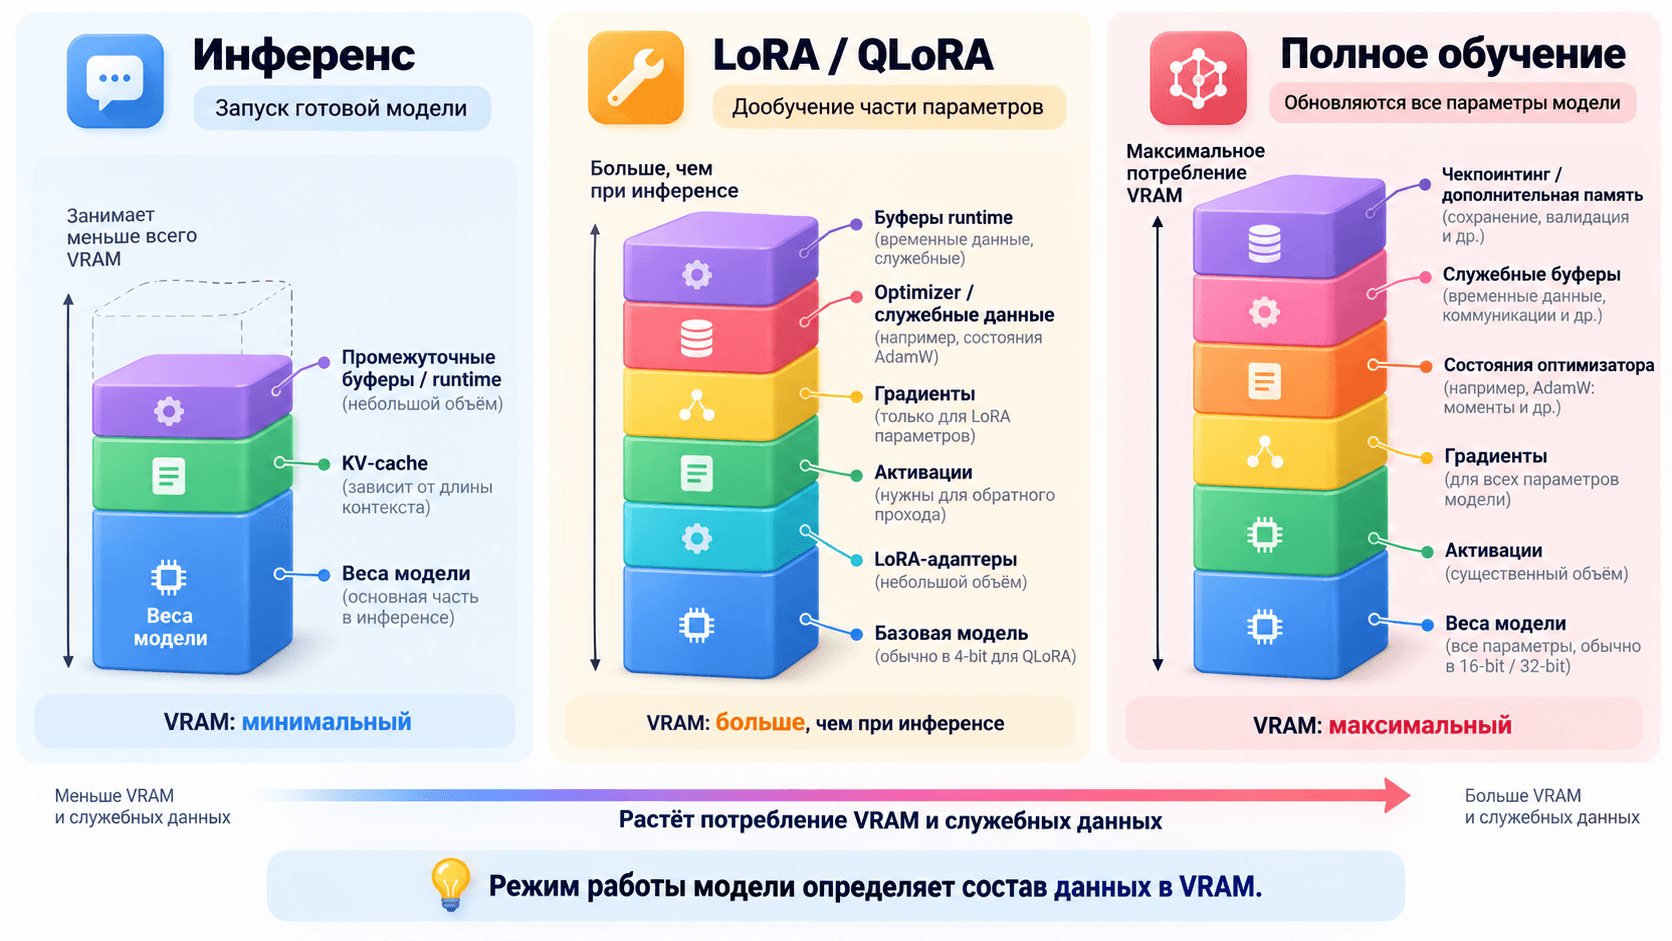
VRAM: главный фильтр при выборе видеокарты для нейросетей
Объем видеопамяти определяет, помещается ли задача на одной GPU и какой запас остается под рабочую нагрузку. Высокая вычислительная скорость не компенсирует нехватку VRAM. Перенос части данных в системную RAM возможен в некоторых runtime, но обычно снижает скорость и меняет задержку.
Для первого расчета памяти весов можно использовать формулу:
память весов в байтах = число параметров x число бит на параметр / 8
Грубая арифметика выглядит так:
Размер модели | BF16 или FP16, только веса | 8 бит, только веса | 4 бита, только веса |
|---|---|---|---|
8 млрд параметров | около 16 ГБ | около 8 ГБ | около 4 ГБ |
14 млрд параметров | около 28 ГБ | около 14 ГБ | около 7 ГБ |
32 млрд параметров | около 64 ГБ | около 32 ГБ | около 16 ГБ |
70 млрд параметров | около 140 ГБ | около 70 ГБ | около 35 ГБ |
Эта таблица отвечает только на вопрос о математическом размере весов. Реальный файл может содержать дополнительную информацию, а запущенная модель использует память сверх весов.
Для LLM нужно добавить KV-cache. Его объем зависит от архитектуры модели, precision cache, длины контекста, batch size и числа одновременных последовательностей. Для генерации изображений учитываются основная модель, текстовые энкодеры, VAE, ControlNet, LoRA, размер изображения и параметры batch. При обучении к расчету добавляются градиенты, optimizer states и активации.
Поэтому запрос «32 ГБ видеокарта для ИИ» еще не описывает задачу. Для одной 32B-модели в 8-битном формате 32 ГБ уже заняты арифметической оценкой весов. Запаса на runtime и контекст не остается. Та же память для меньшей модели может дать комфортный резерв.
Какие характеристики GPU влияют на работу с ИИ
После фильтра по VRAM сравнивают остальные параметры. Их приоритет меняется от нагрузки к нагрузке.
Пропускная способность памяти
Она показывает, какой объем данных память GPU теоретически может передать за секунду. Для некоторых LLM-сценариев генерация токенов сильно зависит от чтения весов из памяти. Но паспортная пропускная способность не превращается напрямую в tokens per second. На результат влияют kernel implementation, quantization, batch, модель и загрузка GPU.
Вычислительные форматы
FP32 нужен для задач, где критична точность. BF16 и FP16 широко применяются в обучении и инференсе. FP8, INT8 и FP4 способны увеличить throughput и снизить потребление памяти, если GPU, модель и runtime поддерживают этот режим с приемлемым качеством.
Сравнивать пиковые значения можно только при одинаковой precision и одинаковых условиях. Число с учетом sparsity нельзя напрямую сопоставлять с числом без sparsity.
Связь между GPU
Две видеокарты для ИИ не образуют одну большую видеокарту автоматически. У каждой остается собственная память. Чтобы разместить одну модель на нескольких устройствах, runtime должен разбить веса и вычисления между GPU.
Дальше важна скорость обмена. PCIe может быть достаточен для независимых задач или некоторых режимов параллелизма. Для интенсивных коллективных операций при обучении и крупном multi-GPU инференсе ценность получают NVLink, NVSwitch или Infinity Fabric. Подробности зависят от конкретного исполнения карты и сервера.
Энергопотребление и охлаждение
Паспортная мощность GPU влияет на блоки питания, PDU, кабели, тепловую нагрузку и допустимое число ускорителей в шасси. Пассивная серверная карта рассчитана на направленный воздушный поток внутри совместимой платформы. Ее нельзя оценивать как обычную настольную видеокарту без проверки охлаждения.
ECC, RAS и режим эксплуатации
Для длительной корпоративной нагрузки учитывают коррекцию ошибок памяти, диагностику, управление, поддержку vGPU или MIG, драйверный цикл, гарантию и совместимость с сервером. ECC полезна, но сама по себе не делает карту серверной. Надежность определяется всей платформой.
Видеокарты для ИИ в 2026 году: сравнение классов
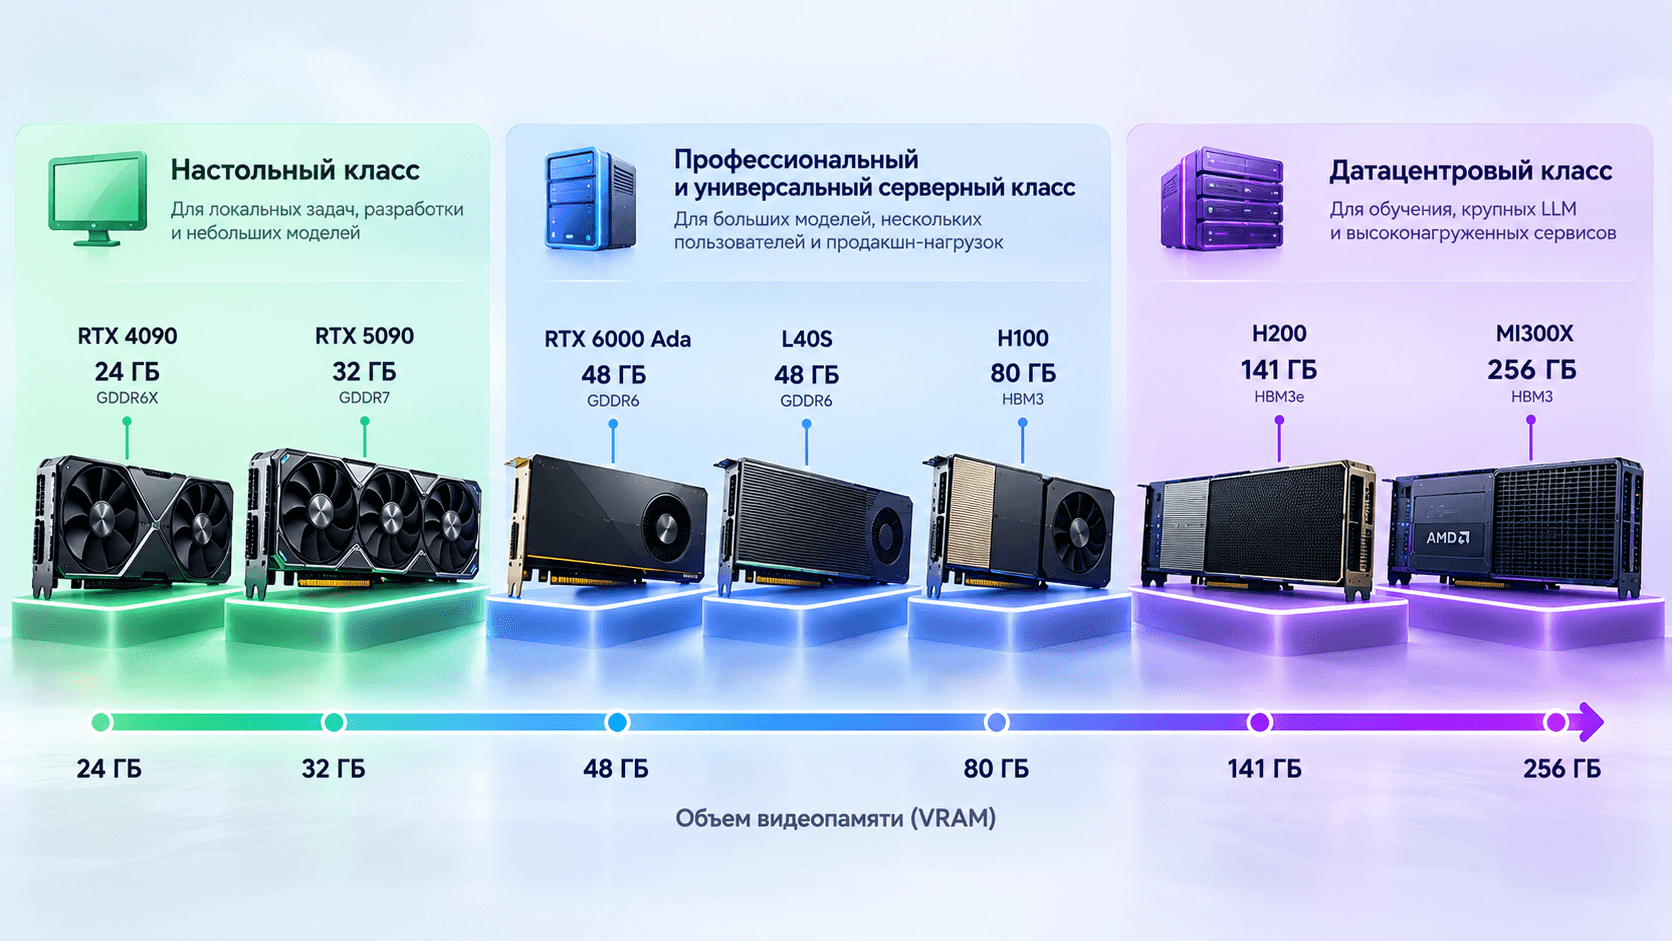
Ниже не рейтинг видеокарт для ИИ, а карта классов. Характеристики относятся к указанному исполнению и сверены по страницам производителей. Реальная производительность зависит от приложения.
GPU | Память | Пропускная способность памяти | Максимальная мощность | Класс и типичный сценарий |
|---|---|---|---|---|
NVIDIA GeForce RTX 5090 | 32 ГБ GDDR7 | 1 792 ГБ/с | 575 Вт | Настольная разработка, локальный ИИ, генерация и прототипы при достаточных 32 ГБ |
NVIDIA L4 | 24 ГБ | 300 ГБ/с | 72 Вт | Энергоэффективный серверный инференс, видео, edge и высокая плотность |
NVIDIA L40S | 48 ГБ GDDR6 ECC | 864 ГБ/с | 350 Вт | Универсальная серверная GPU для инференса, генеративного ИИ, графики и видео |
NVIDIA RTX PRO 6000 Blackwell Server Edition | 96 ГБ GDDR7 ECC | 1 597 ГБ/с | до 600 Вт, настраивается | Enterprise AI, LLM, визуальные вычисления, большие однокарточные нагрузки |
NVIDIA H200 SXM | 141 ГБ HBM3e | 4,8 ТБ/с | до 700 Вт, настраивается | Крупные LLM, memory-intensive инференс, обучение и HPC в HGX-системах |
AMD Instinct MI300X | 192 ГБ HBM3 | 5,3 ТБ/с | 750 Вт peak | Крупные LLM, обучение, инференс и HPC в специализированной OAM-платформе |
AMD Instinct MI325X | 256 ГБ HBM3e | 6 ТБ/с | 1 000 Вт peak | Очень крупные модели и memory-intensive AI в OAM-платформе |
У NVIDIA L4 меньше памяти и вычислительных ресурсов, чем у H200, но это не делает ее плохим ускорителем. При видеопотоках, ограниченном энергобюджете или большом числе независимых небольших моделей L4 может оказаться ближе к задаче. H200 имеет смысл там, где приложение использует ее объем HBM, пропускную способность и серверную межGPU-связь.
RTX 5090 предоставляет 32 ГБ VRAM и высокую пропускную способность в настольном форм-факторе. Она подходит для локальной разработки, но не заменяет автоматически серверную карту: отличаются охлаждение, эксплуатационный режим, управление, поддержка профессионального ПО и плотность установки.
RTX PRO 6000 Blackwell Server Edition с 96 ГБ занимает промежуточное положение между массовой GeForce и HBM-ускорителями верхнего серверного класса. Сравнение конкретных 48 и 96 ГБ конфигураций разобрано в материале L40S или RTX PRO 6000 для LLM.
Если проекту нужен большой объем памяти на одной AMD GPU, в каталоге есть AMD Instinct MI300X OAM 192GB. Это OAM-модуль для специализированной платформы, а не карта, которую устанавливают в свободный PCIe-слот рабочей станции.
NVIDIA или AMD для нейросетей
Запрос «видеокарта для ИИ NVIDIA или AMD» нельзя закрыть сравнением логотипов. Сначала нужно проверить поддержку конкретного приложения.
Когда проще начать с NVIDIA
Многие AI-инструменты, контейнеры и готовые инструкции ориентированы на CUDA. Это снижает риск, что нужная библиотека, custom kernel или расширение потребует самостоятельной адаптации. Для команды, которая уже использует CUDA-код и NVIDIA-образы, стоимость миграции тоже становится частью выбора.
Когда имеет смысл AMD
AMD Instinct предлагает большой объем HBM и экосистему ROCm для AI и HPC. PyTorch выпускается в вариантах для ROCm, но совместимость нужно проверять по точной версии GPU, ОС, ROCm, фреймворка и контейнера. Фраза «PyTorch поддерживает ROCm» не доказывает работоспособность конкретного приложения со всеми его расширениями.
До закупки AMD GPU полезно выполнить пилот на целевом checkpoint и runtime:
Зафиксировать версии ОС, драйвера, ROCm, PyTorch и библиотек.
Проверить загрузку модели, используемые precision и kernels.
Измерить память, latency, throughput и стабильность.
Проверить multi-GPU режим, если он потребуется в production.
Убедиться, что обновление версии не ломает критичные зависимости.
Подробный разбор миграционного риска есть в сравнении AMD MI300X или NVIDIA H200 для LLM.
Потребительская, профессиональная или серверная видеокарта
Дешевые видеокарты для ИИ часто относятся к потребительскому классу. Для одного разработчика это может быть рационально. Для общего сервиса требования меняются.
Критерий | Потребительская GPU | Профессиональная GPU | Серверный ускоритель |
|---|---|---|---|
Основной формат | Настольная карта с активным охлаждением | Рабочая станция или серверное исполнение | Пассивная PCIe, SXM или OAM в совместимой платформе |
Память | Обычно меньше, без обязательной ECC | Больше VRAM, часто ECC | Большой GDDR или HBM, ECC и RAS-функции |
Размещение | Корпус ПК или workstation | Workstation или сертифицированный сервер | Специализированный сервер, HGX, MGX или OAM-платформа |
Управление | Через ОС и драйвер | Профессиональные драйверы, иногда vGPU и MIG | Централизованное управление, телеметрия и серверный жизненный цикл |
Типичный режим | Личная разработка и прототипы | Профессиональные и общие нагрузки | Production, высокая плотность, обучение, кластеры |
Видеокарты для ИИ и игр удобны, когда одна машина используется и для разработки, и как обычная рабочая станция. Их ограничения проявляются при круглосуточной загрузке, удаленном доступе нескольких команд, высокой плотности GPU и требованиях к обслуживанию.
Видеокарта для локального ИИ дома
Для домашнего ИИ чаще всего ищут баланс между VRAM, ценой, шумом, питанием и простотой установки. Здесь полезнее отталкиваться от точной модели, а не от списка «топ видеокарт для локальных нейросетей».
Практический порядок:
Выберите checkpoint и формат весов, который вы действительно планируете запускать.
Рассчитайте размер весов и запас под контекст или граф генерации.
Проверьте поддержку GPU в LM Studio, Ollama, llama.cpp, PyTorch, ComfyUI или другом выбранном приложении.
Проверьте мощность БП, разъемы, размеры карты и охлаждение корпуса.
Найдите результаты именно для вашей модели и runtime.
Бюджетная видеокарта для ИИ с 12-16 ГБ способна закрыть обучение, знакомство с небольшими LLM, часть задач генерации изображений и разработку кода. Она перестает быть экономной, если приходится постоянно выгружать слои в RAM, уменьшать контекст или менять модель только из-за памяти.
Карта с 24-32 ГБ расширяет выбор локальных моделей и снижает потребность в offload. Профессиональные 48-96 ГБ дают еще больше пространства, но требуют сравнения общей стоимости системы. Иногда две недорогие карты дают больше суммарной VRAM, однако добавляют ограничения по платформе, питанию, охлаждению и поддержке multi-GPU.
Покупая видеокарту для ИИ с рук, проверяйте точный артикул, объем памяти, состояние разъемов, результат нагрузочного теста, ошибки памяти, температуру, охлаждение и происхождение устройства. Низкая цена не компенсирует отсутствие поддержки нужных форматов или нестабильность под длительной нагрузкой.
Одна или две видеокарты для ИИ
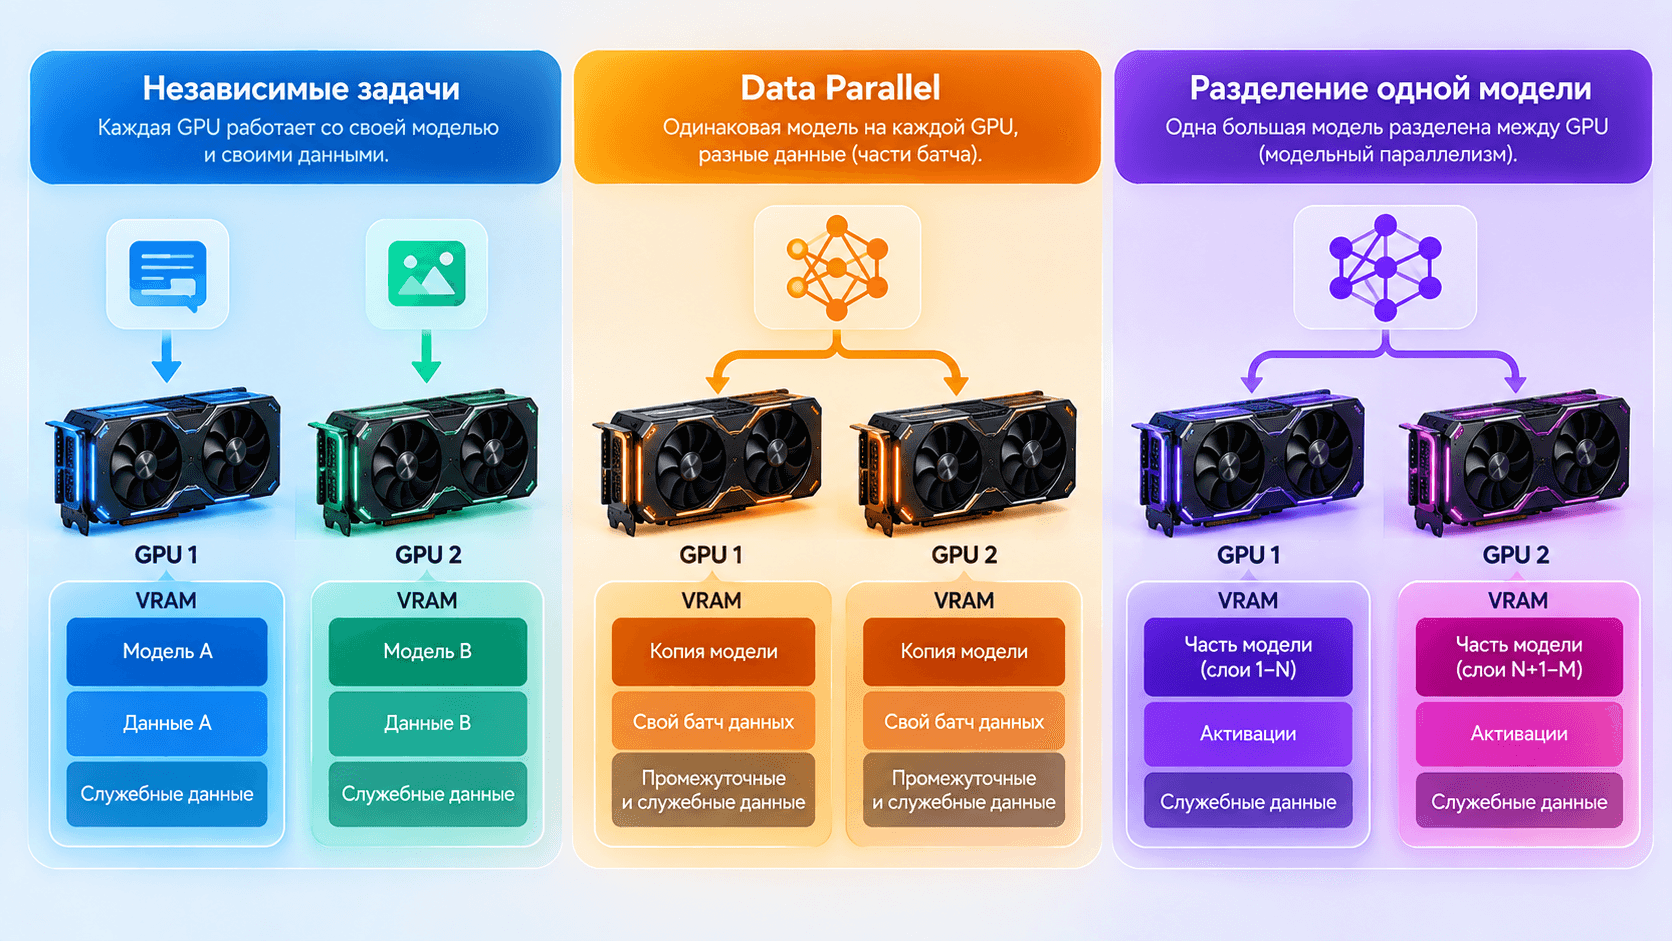
Две GPU полезны в трех разных режимах:
запуск двух независимых задач, по одной на каждом ускорителе;
data parallel training, где каждая GPU содержит копию модели и обрабатывает свою часть batch;
разделение одной модели через tensor parallel, pipeline parallel или sharding.
Только третий режим позволяет работать с моделью, которая не помещается на одном устройстве. И даже тогда память не становится единым прозрачным пулом. Runtime должен поддерживать разбиение, а слои и служебные данные распределяются не всегда равномерно.
Пример: две GPU по 24 ГБ имеют 48 ГБ физической памяти суммарно, но это не гарантирует запуск задачи, которой требуется 47 ГБ на одном устройстве. Часть памяти может дублироваться, а скорость обмена через PCIe способна ограничить производительность.
Если выбирается сервер на 2, 4 или 8 ускорителей, используйте отдельное руководство сколько GPU нужно для LLM. Там выбор связан с model parallelism, topology и профилем нагрузки.
Когда нужен GPU-сервер для ИИ
Настольная карта подходит для разработки, пока ресурс принадлежит одному пользователю, задачи запускаются вручную, а простой не критичен. GPU-сервер становится сильным кандидатом, когда появляются:
несколько пользователей или сервисов;
очередь длительных задач;
удаленный доступ и централизованное управление;
круглосуточная нагрузка;
несколько ускорителей;
требования к резервированию, мониторингу и обслуживанию;
большие локальные датасеты и checkpoints;
необходимость масштабировать решение на другие узлы.
В сервере нужно согласовать GPU с CPU, RAM, NVMe, NIC, PCIe-топологией, блоками питания и охлаждением. Подробный порядок описан в статье как выбрать сервер для ИИ.
Как сравнивать производительность видеокарт для ИИ
Паспортные характеристики помогают отсеять несовместимые варианты. Финальное сравнение выполняют на целевой нагрузке.
Для LLM фиксируют:
название и версию checkpoint;
precision и способ quantization;
runtime и его версию;
длину входа и выхода;
batch size и concurrency;
число GPU и способ parallelism;
время до первого токена, tokens per second и percentile latency;
фактическое потребление VRAM и энергии.
Для computer vision полезны images per second, latency pipeline, разрешение, batch, этапы decode и preprocessing. Для обучения измеряют samples per second, время эпохи или time-to-train, масштабирование между GPU и устойчивость длительного запуска.
Сравнение видеокарт для нейросетей без одинаковых условий вводит в заблуждение. Нельзя сопоставлять FP8 на одной карте с BF16 на другой, разные модели, разный batch или результаты с sparsity и без нее. Отдельная инструкция как читать бенчмарки GPU для LLM помогает проверить методику до закупки.
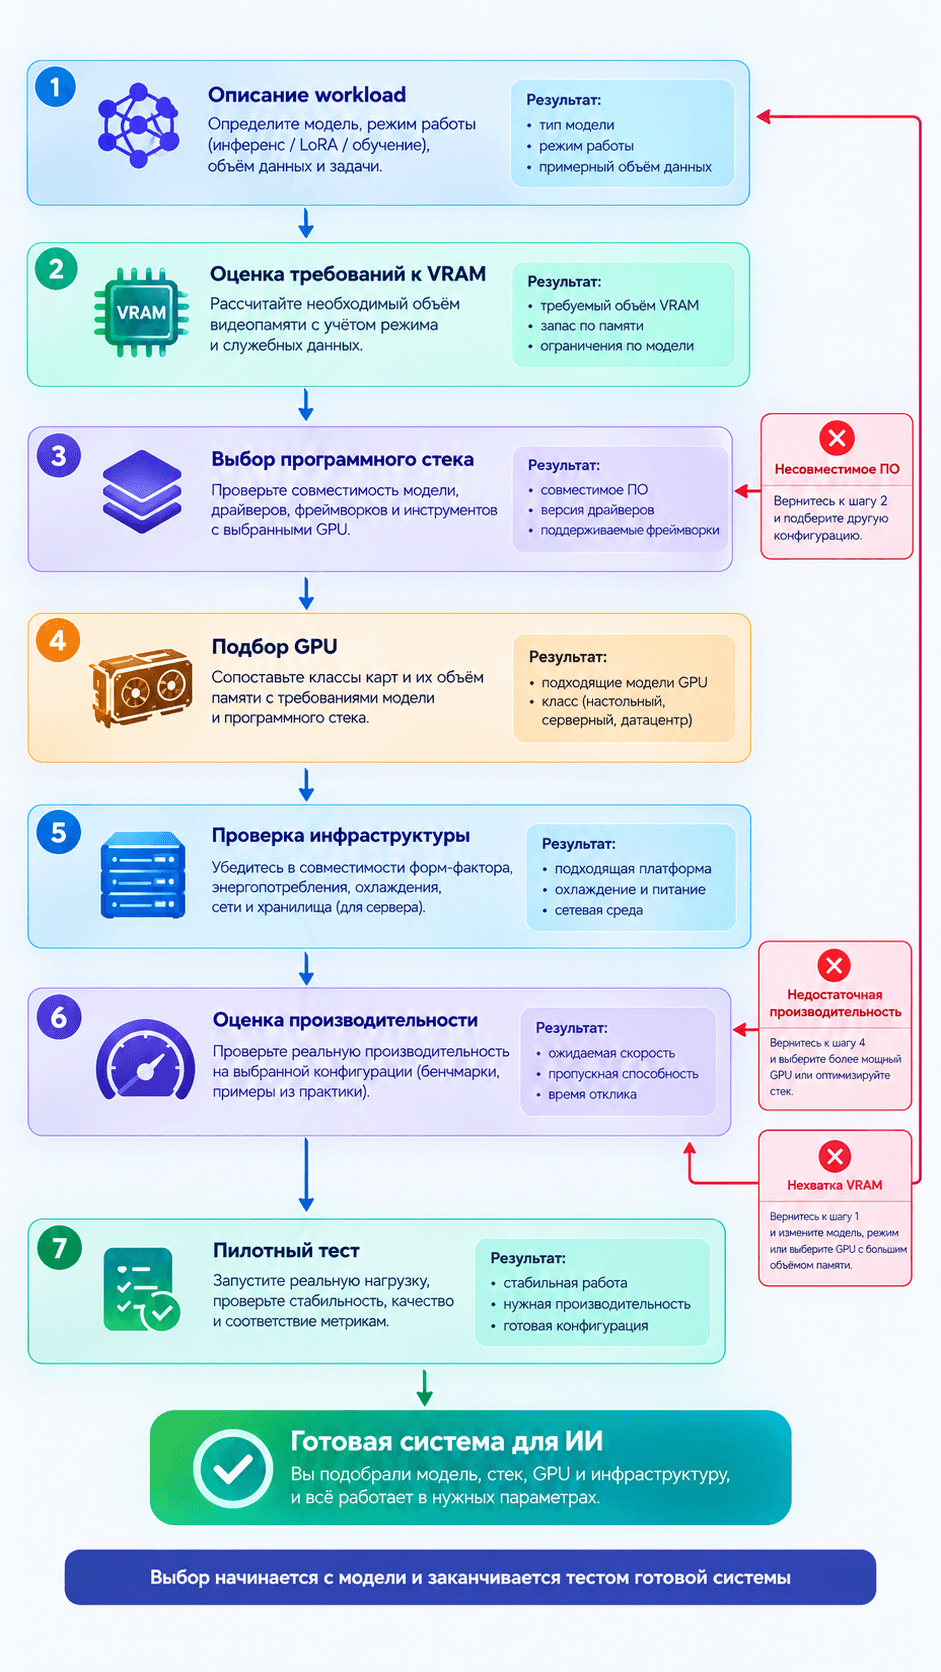
Алгоритм выбора GPU для ИИ
Этот порядок подходит для локальной системы, рабочей станции и сервера.
Шаг 1. Опишите workload
Зафиксируйте модель, задачу, режим работы и пользователей. Для LLM добавьте context, input length, output length и concurrency. Для генерации изображений укажите resolution, batch и используемые модули. Для обучения нужны dataset, precision, optimizer и целевой срок.
Шаг 2. Зафиксируйте программный стек
Запишите ОС, framework, runtime, containers, custom kernels и версии драйверов. Решите, требуется CUDA, ROCm или другой backend. Проверьте официальную матрицу поддержки.
Шаг 3. Рассчитайте VRAM с запасом
Сначала посчитайте веса, затем добавьте KV-cache, активации, optimizer states, рабочие буферы и запас для выбранного режима. Проверьте расчет реальным запуском или memory estimator.
Шаг 4. Определите метрики сервиса
Нужны численные требования: допустимая задержка, throughput, число одновременных запросов, время обучения, SLA и часы загрузки. Без этого более дорогую GPU нельзя обосновать.
Шаг 5. Выберите одну или несколько GPU
Проверьте, помещается ли workload на одной карте. Если нет, определите механизм разбиения и требования к interconnect. Для независимых моделей иногда выгоднее несколько отдельных GPU меньшего класса.
Шаг 6. Проверьте платформу
Сопоставьте GPU с server support matrix, PCIe slots и lanes, механикой, airflow, PSU, PDU, RAM, NVMe и сетью. Для OAM и SXM выбирается готовая специализированная платформа.
Шаг 7. Проведите пилот
Запустите точный checkpoint на целевом software stack. Измерьте память, скорость, задержку, энергопотребление и стабильность. Сравнивайте не отдельные GPU, а готовые конфигурации при одинаковой нагрузке.
Ошибки при выборе видеокарты для нейросетей
Покупать самую мощную карту без описания задачи
Самая мощная видеокарта для ИИ по одной паспортной метрике может быть избыточной или несовместимой. Для небольшой модели ограничением окажется не GPU, а CPU preprocessing, сеть или storage.
Считать, что VRAM нескольких карт складывается автоматически
Память распределяется только при поддержке со стороны runtime. Нужно учитывать дублирование, imbalance и трафик между GPU.
Выбирать по игровым тестам
FPS не показывает, как карта выполняет BF16 training, quantized LLM inference, video decode или collective operations. Общий запрос «сравнение видеокарт» с высоким показателем Wordstat относится преимущественно к играм и массовым моделям, поэтому он не должен задавать структуру AI-подбора.
Игнорировать программную совместимость
Недорогая видеокарта для ИИ становится дорогой, если команда тратит недели на замену unsupported kernels и сборку зависимостей. Проверка приложения предшествует покупке.
Сравнивать цену отдельной GPU вместо всей системы
К стоимости добавляются сервер, CPU, RAM, диски, сеть, лицензии, питание, охлаждение, размещение и сопровождение. Для production полезнее считать стоимость требуемого throughput или завершенного обучения.
Оставлять охлаждение на потом
Современная настольная карта может потреблять сотни ватт, а сервер с несколькими ускорителями требует рассчитанного airflow и подходящей стойки. Ограничение мощности из-за температуры меняет реальную производительность.
Что подготовить перед покупкой видеокарты для ИИ
Чтобы инженер мог подобрать GPU без гадания, соберите короткий паспорт нагрузки:
название модели или ссылка на checkpoint;
инференс, LoRA, QLoRA или полное обучение;
precision и quantization;
длина контекста, число одновременных запросов и целевая скорость;
размер данных и скорость их поступления;
текущий software stack;
число пользователей и режим доступа;
настольное, серверное или ЦОД-размещение;
доступное питание и охлаждение;
требования к росту на 12-24 месяца.
FAQ
Нужна ли видеокарта для ИИ
Не всегда. Небольшую модель можно запустить на CPU, а облачный API вообще не требует локальной GPU. Видеокарта нужна, когда локальный инференс, генерация или обучение должны выполняться с приемлемой скоростью. Решение зависит от модели, задержки, приватности данных и режима нагрузки.
Какая видеокарта лучше для нейросетей
Та, которая поддерживает выбранный стек, вмещает модель и рабочие данные, обеспечивает нужную скорость и подходит платформе по питанию и охлаждению. Универсального победителя нет: для локального прототипа, видеоинференса и обучения крупной LLM нужны разные классы GPU.
Какая минимальная видеокарта нужна для ИИ
Минимум определяется конкретным приложением. Для первого знакомства с небольшими локальными моделями часто рассматривают 12-16 ГБ VRAM, но некоторые задачи работают и с меньшей памятью, а другие не помещаются в 24 ГБ. Сначала проверьте требования выбранной модели и runtime.
Что важнее для нейросетей, VRAM или мощность GPU
Сначала VRAM выступает как ограничитель вместимости. Если задача не помещается, высокая вычислительная скорость не помогает. После проверки памяти сравнивают bandwidth, поддерживаемые форматы, реальную производительность и энергопотребление.
Можно ли использовать видеокарту для ИИ и игр
Да. Потребительская GeForce или Radeon может использоваться для локальной разработки, инференса и генерации. Для общего корпоративного сервиса нужно отдельно проверить надежность, удаленное управление, режим 24 на 7, охлаждение, плотность установки и поддержку нужного ПО.
Подойдет ли AMD видеокарта для нейросетей
Подойдет, если точная модель GPU, ОС, ROCm, framework и приложение совместимы. Для AMD Instinct и поддерживаемых Radeon есть рабочие AI-сценарии, но проверять нужно весь software stack, включая custom kernels и контейнеры.
Складывается ли память двух видеокарт
Физически общий объем можно посчитать, но единым прозрачным пулом он не становится. Одна модель использует несколько GPU только при поддержке соответствующего parallelism или sharding. Часть данных может дублироваться.
Сколько VRAM нужно для LLM
Для первичной оценки умножьте число параметров на байты выбранного формата. Затем добавьте память runtime, KV-cache, контекста, batch и параллельных запросов. Для обучения дополнительно нужны градиенты, optimizer states и активации.
Когда нужна серверная видеокарта для ИИ
Когда важны большой VRAM, HBM, высокая плотность, multi-GPU, ECC, RAS, vGPU, централизованное управление, длительная нагрузка или сертифицированная серверная платформа. Для одного разработчика такие возможности могут быть избыточны.
Какую видеокарту купить для обучения нейросетей
Сначала определите тип обучения. LoRA небольшой модели и полное обучение миллиардной модели отличаются по памяти на порядок. Зафиксируйте framework, precision, batch size, размер модели и желаемое время обучения, затем проведите тест на кандидате.
Подбор GPU под реальную нагрузку
Для расчета пришлите модель или checkpoint, режим работы, precision, длину контекста, batch, число одновременных пользователей и используемый software stack. Start Server сопоставит нагрузку с VRAM, количеством GPU, серверной платформой, CPU, RAM, NVMe, сетью, питанием и охлаждением.
Результатом должна стать проверяемая спецификация и план пилотного теста, а не универсальный список видеокарт. Перейдите в каталог AI-серверов и GPU-конфигураций, чтобы выбрать класс решения и отправить требования к проекту.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


