Переход от одного GPU-сервера к многоузловому кластеру кажется простой задачей: если восемь GPU недостаточно, поставить шестнадцать или тридцать две.
На практике дополнительные GPU увеличивают не только доступный compute. Вместе с ними появляются межузловые коммуникации, синхронизация, новые требования к topology, checkpointing и recovery.
Поэтому многоузловой GPU-кластер нужен не потому, что модель «большая».
Сначала нужно доказать одно из двух:
training job не помещается в разумную single-node конфигурацию
или:
job помещается, но один узел не выполняет требуемый time-to-train, а дополнительные узлы действительно ускоряют тот же объём работы.
Практическая последовательность:
Почему больше GPU не означает пропорционально быстрее
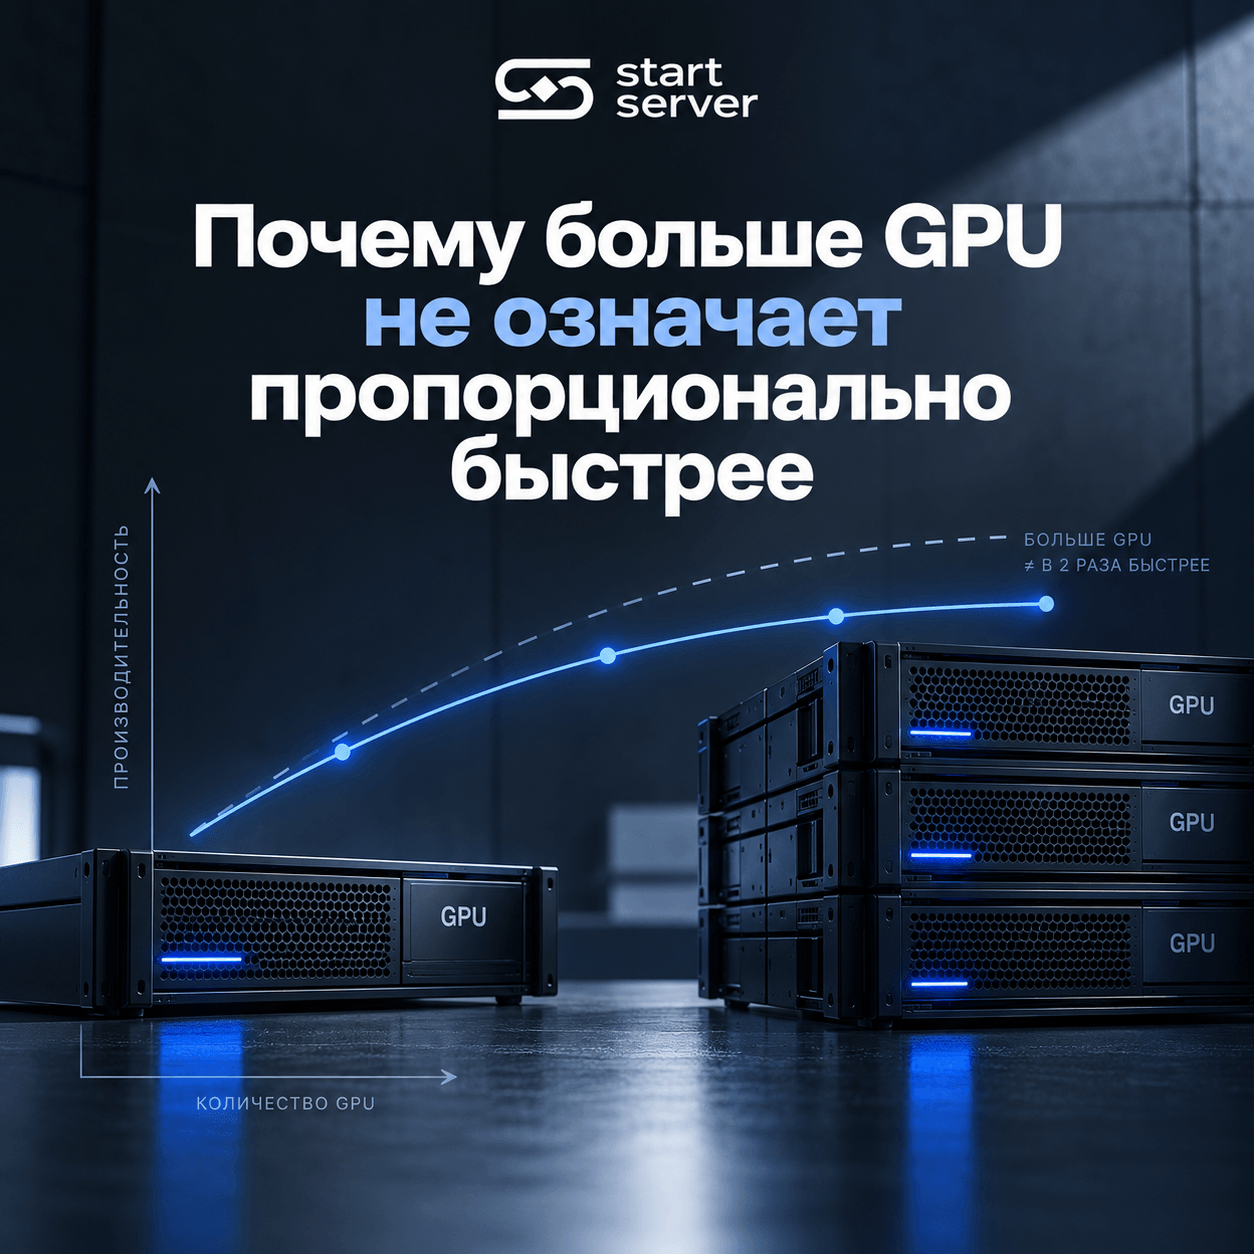
Предположим, обучение выполняется на восьми GPU.
Можно ожидать, что шестнадцать GPU дадут примерно двукратное ускорение. Но при переходе через границу сервера часть данных начинает передаваться между узлами.
Разные варианты distributed training требуют разных коммуникаций, а часть обменов может перекрываться с вычислениями.
Итоговое ускорение зависит от:
training configuration;
parallelism;
GPU и network topology;
объёма вычислений на rank;
communication overhead;
возможности перекрыть communication с compute;
checkpointing;
input pipeline.
Поэтому 2× GPU не означает автоматически 2× speed.
Ускорение нужно измерять на реальной training job.
Сначала зафиксируйте exact training job
До сравнения серверов или кластеров нужно зафиксировать workload.
Параметр | Значение |
Framework/version | |
Model/version | |
Dense / MoE | |
Precision | |
Optimizer | |
Sequence length | |
Global batch | |
Microbatch | |
Gradient accumulation | |
Activation checkpointing | |
Distributed strategy | |
Training target |
Это важно: изменение sequence length, optimizer или microbatch может изменить и память, и производительность не меньше, чем замена GPU.
Первый вопрос: помещается ли job в один узел
Первое основание для multi-node — нехватка памяти.
Но training memory нельзя считать только по размеру checkpoint или model weights.
Во время обучения память может требоваться для:
parameters;
gradients;
optimizer states;
activations;
временных tensors;
communication и runtime buffers.
Поэтому главный показатель:
peak GPU memory per rank
на representative training workload.
Успешно загрузить модель недостаточно. Конфигурация должна устойчиво пройти forward, backward и optimizer step с требуемыми sequence length и microbatch.
Почему количество параметров не определяет training VRAM
Одна и та же модель может иметь разный memory footprint.
Фактор | Что меняется |
Precision | представление model state |
Optimizer | объём optimizer states |
Sequence length | activations |
Microbatch | объём одновременно активных tensors |
Sharding | replicated и distributed state |
Activation checkpointing | сохранённые activations |
Parallelism | placement state и compute |
Поэтому формула:
модель N параметров → N GPU
не подходит для проектирования training infrastructure.
OOM на одной GPU ещё не означает multi-node
Если job не помещается на одной карте, следующий вопрос:
можно ли распределить workload между GPU одного сервера?
Перед scale-out стоит проверить:
FSDP или другой sharding;
distributed optimizer;
tensor parallelism;
pipeline parallelism;
context parallelism;
activation checkpointing;
уменьшение microbatch с gradient accumulation.
Правильная последовательность:
Переход непосредственно от OOM одной GPU к нескольким серверам может быть преждевременным.
Почему FSDP меняет границу memory fit
При replicated data parallelism существенная часть model state присутствует на каждом worker.
Sharded-подходы могут распределить между ranks:
parameters;
gradients;
optimizer states.
За счёт этого workload способен начать помещаться на том же общем числе GPU.
Но такой выигрыш по памяти имеет цену.
Для вычислений shards приходится собирать и синхронизировать между ranks. Поэтому после:
Memory PASS
нужно снова проверить:
Performance PASS.
Уменьшение peak VRAM само по себе не делает конфигурацию оптимальной.
Activation checkpointing: память в обмен на compute
Activation checkpointing уменьшает число intermediate activations, которые хранятся до backward.
Часть результатов вместо этого пересчитывается.
Получается компромисс:
меньше memory → больше recompute.
Поэтому после включения activation checkpointing нужно заново измерить:
step time;
throughput;
time-to-fixed-work.
Конфигурация может начать помещаться, но стать заметно медленнее.
Почему sequence length особенно важен
При long-context training activations могут занимать значительную часть памяти.
Поэтому одна и та же модель при разных sequence length может иметь разные требования к:
VRAM;
microbatch;
sharding;
parallelism;
communication.
Обсуждать memory fit training job без sequence length недостаточно.
Суммарная VRAM кластера — не единый memory pool
Расчёт:
16 GPU × объём VRAM одной карты
показывает физическую сумму памяти, но не говорит, сколько из неё доступно для конкретного training state.
Разные tensors могут:
реплицироваться;
шардироваться;
временно materialize;
требовать дополнительных buffers.
Поэтому вопрос не:
сколько суммарной VRAM в кластере?
а:
Ответ подтверждается измерением peak memory.
Scale-up нужно проверить до scale-out
Если задача решается внутри одного multi-GPU сервера, переход к нескольким узлам добавляет сложность без доказанной необходимости.
Перед scale-out полезно проверить:
GPU с большей VRAM;
больше GPU в одном узле;
другой sharding;
другой microbatch;
activation checkpointing;
другой TP/PP/CP layout.
Если single node выполняет и Memory PASS, и целевой time-to-train, многоузловая архитектура для этой задачи не обязательна.
Второй вопрос: выполняется ли target time-to-train
Training job может помещаться на одном узле, но обучаться слишком долго.
Это второе основание для multi-node.
До benchmark нужно определить цель:
выполнить фиксированный training workload;
обработать фиксированное количество samples или tokens;
завершить согласованный training run;
сократить экспериментальный цикл до требуемого времени.
Без такой цели легко оптимизировать красивый step time вместо реального time-to-solution.
Сначала нужен single-node baseline
Перед добавлением узлов нужно получить устойчивый baseline на одном сервере.
Метрика | Значение |
GPU/node | |
GPU topology | |
Parallelism | |
Global batch | |
Sequence length | |
Steady-state mean step time | |
Steady-state p95 step time | |
Tokens/s или samples/s | |
Peak GPU memory | |
Checkpoint blocking overhead | |
Total checkpoint completion time |
Одноразовые initialization, compilation и warm-up лучше учитывать отдельно.
Baseline должен отражать representative steady-state training.
Почему parallelism определяет network workload
Distributed training не создаёт одного универсального вида traffic.
Parallelism | Что распределяется | Типичный communication pattern |
DP/DDP | batch replicas | gradient collectives |
FSDP | model state | all-gather / reduce-scatter |
TP | tensors внутри layers | частые collectives |
PP | model stages | point-to-point |
CP | sequence/context | context/KV communication |
EP | experts | token dispatch / collectives |
Поэтому вопрос:
какая сеть нужна для обучения LLM?
без parallelism map недостаточно конкретен.
Правильнее спрашивать:
Почему нет универсальной bandwidth для LLM-кластера
Две jobs на одинаковом числе GPU могут генерировать совершенно разный network traffic.
Влияют:
parallelism;
message sizes;
число ranks;
частота collectives;
topology;
overlap с compute.
Поэтому нельзя универсально определить:
для LLM нужна сеть N Гбит/с.
Network requirement подтверждается workload и benchmark конкретной topology.
Что меняется при пересечении границы узла
В single-node системе communication между GPU может идти по внутреннему interconnect.
После добавления второго узла часть exchanges начинает проходить через inter-node fabric.
Поэтому training topology нужно описывать как минимум через:
nodes × GPU/node
и дополнительно фиксировать:
intra-node GPU topology;
NIC placement;
inter-node fabric;
rank-to-GPU/NIC mapping.
Запись:
16 GPU
сама по себе ещё не описывает training system.
Почему 16 GPU могут быть разными архитектурами
Сравним:
2 узла × 8 GPU
и:
4 узла × 4 GPU.
Total GPU count одинаков.
Но communication paths и доля межузловых exchanges могут различаться.
Поэтому benchmark одной topology нельзя автоматически переносить на другую.
Перед training benchmark проверьте fabric
Длительный training run — неудобный способ впервые обнаружить проблему network topology.
Сначала полезно проверить relevant communication patterns.
В зависимости от workload это могут быть:
All-Reduce;
All-Gather;
Reduce-Scatter;
All-to-All;
point-to-point.
Что показывает NCCL benchmark
NCCL benchmark проверяет communication layer в конкретном контексте:
collective;
message size;
rank count;
topology.
Он помогает выявить:
ошибки configuration;
проблемы NIC mapping;
degraded links;
неожиданные topology bottlenecks.
Но результат всегда нужно описывать вместе с условиями теста.
Одна цифра:
NCCL bandwidth = X
без названия collective и topology малоинформативна.
Хороший NCCL не гарантирует хороший training scaling
Training job включает не только communication.
Есть ещё:
model compute;
optimizer;
activation recompute;
pipeline scheduling;
load balance;
input pipeline.
Поэтому:
Fabric PASS ≠ Training Scaling PASS.
Communication benchmark проверяет инфраструктурный слой.
Затем нужен реальный training benchmark.
Когда fabric нужно разбирать до training test
Если communication benchmark заметно не достигает ожидаемого результата для данной topology, сначала стоит проверить:
links;
NIC placement;
routing;
system configuration.
Иначе training test одновременно измеряет application behaviour и infrastructure problem, что усложняет диагностику.
Первый важный proof point: 1 node → 2 nodes
Два узла — первый тест, где workload пересекает server boundary.
Для такого benchmark нужно сохранить:
fixed workload definition;
parallelism;
step time;
throughput;
speedup;
exposed communication;
memory;
checkpoint overhead.
Это позволяет увидеть именно цену первого scale-out.
Что такое strong scaling
Strong scaling отвечает на вопрос:
насколько быстрее один и тот же фиксированный объём работы выполняется при увеличении вычислительных ресурсов?
Для fixed workload:
Speedup = Tbaseline / Tcandidate
Если количество сопоставимых ресурсов увеличилось в k раз:
Scaling efficiency = Speedup / k
Например, два одинаковых узла дают resource multiple 2.
Идеальный математический ориентир — speedup 2×.
Когда scaling efficiency можно сравнивать
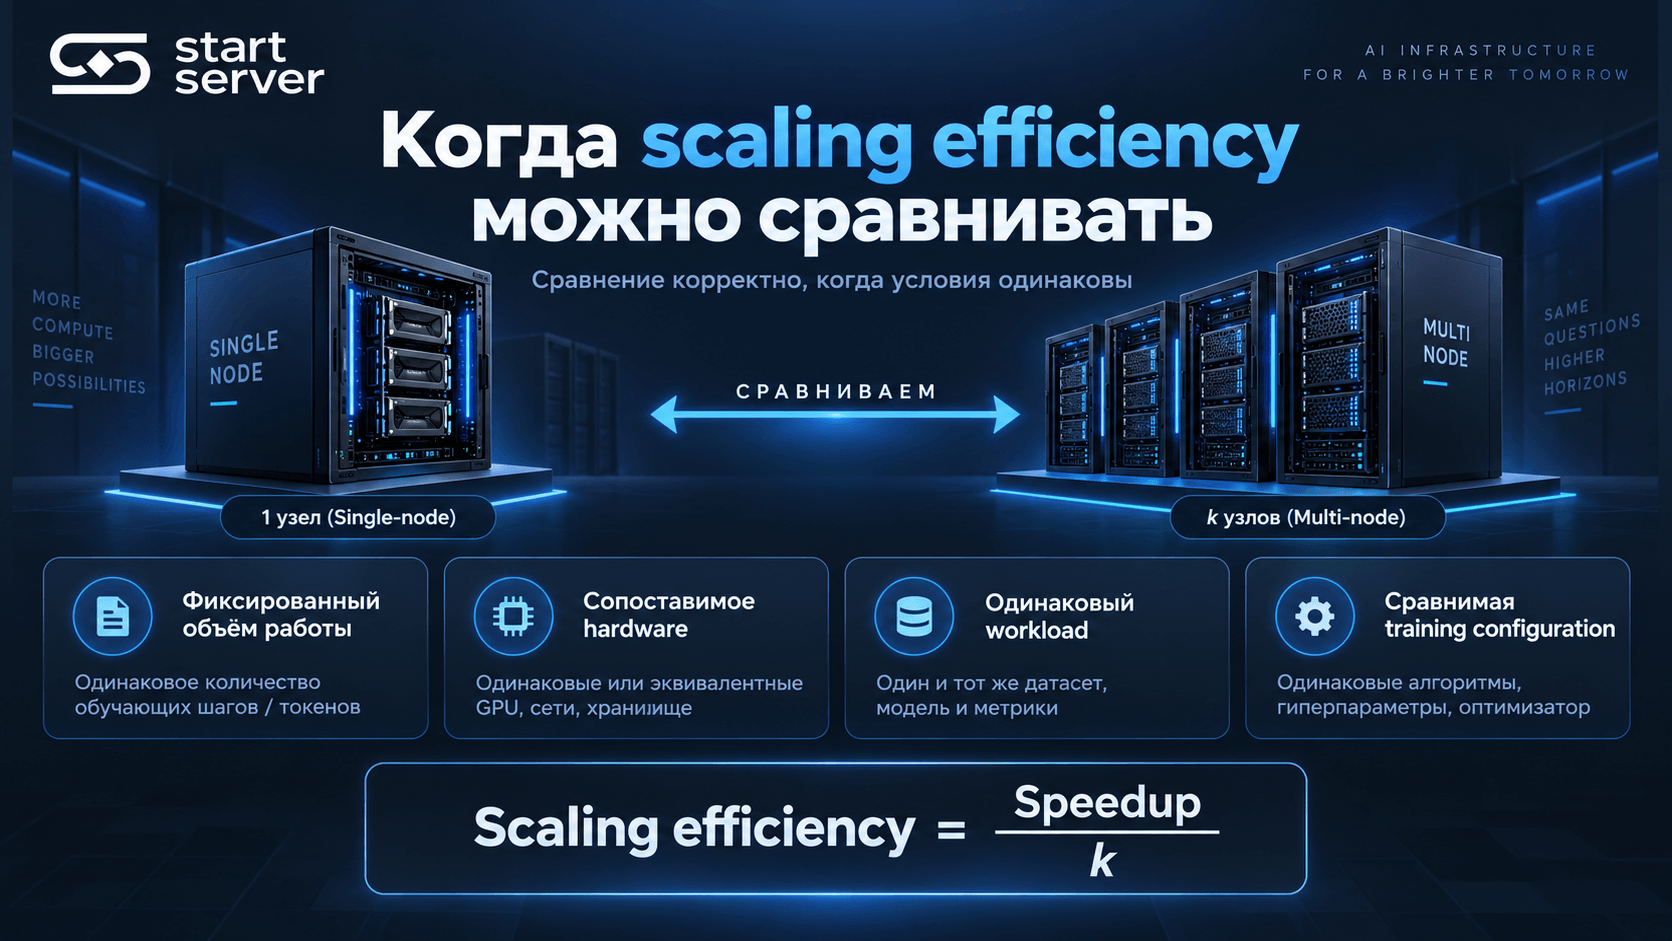
Формула имеет смысл, когда:
объём работы фиксирован;
hardware сопоставимо;
workload definition одинаков;
training configuration сравнима.
Если одновременно меняются тип GPU, workload и training recipe, простая efficiency уже не изолирует эффект scale-out.
Универсального хорошего процента efficiency нет
Нельзя установить для любого проекта:
80% — хорошо, 70% — плохо.
Допустимый результат зависит от:
target time-to-train;
стоимости дополнительных узлов;
длины training run;
частоты экспериментов;
project economics.
Scaling efficiency помогает сравнивать варианты, но не заменяет требования проекта.
Почему step time нельзя использовать без work/step
Представим:
Один узел
global batch = 256
step time = 10 секунд
Два узла
global batch = 512
step time = 10 секунд
Если смотреть только на step time:
ускорения нет.
Но за один step теперь выполняется другой объём работы.
Поэтому вместе со step time нужно хранить:
samples/step или tokens/step;
samples/s или tokens/s;
time-to-fixed-work.
Если меняется global batch, это другой benchmark regime
Изменение global batch может влиять не только на infrastructure throughput, но и на training recipe:
количество steps;
optimizer behaviour;
convergence.
Поэтому для infrastructure strong scaling лучше фиксировать объём работы.
Если batch меняется, это нужно явно отметить и сравнивать normalized throughput или полный fixed-work run.
Почему time-to-fixed-work полезнее одного step
Для чистого infrastructure comparison удобно спросить:
сколько времени каждая configuration выполняет одинаковый объём работы?
Так сравнение меньше зависит от интерпретации step size.
После этого отдельно можно оценивать production time-to-target, если эквивалентность ML recipe и convergence подтверждена.
Communication может перекрываться с compute
Distributed training stack может запускать часть communication одновременно с полезными вычислениями.
Например, synchronization gradients или gathering parameters могут частично идти параллельно с compute.
Поэтому простая формула:
Step time = Compute + сумма времени NCCL
в общем случае неверна.
Если collectives перекрываются с compute, их durations нельзя просто сложить и назвать overhead.
Что такое exposed communication
Для architecture decision полезнее измерять:
Назовём её exposed communication.
На profiler timeline часть NCCL operations может находиться под compute.
Тогда:
total communication activity ≠ exposed communication overhead.
Это важное различие при анализе multi-node scaling.
Communication share — диагностическая метрика
Можно сравнивать, как exposed communication меняется:
на одном узле;
на двух;
на целевом N-node scale.
Если при увеличении числа GPU она растёт, нужно проверить:
fabric;
topology;
parallelism mapping;
workload granularity.
Но универсального порога:
больше X% — плохо
нет.
Почему scaling ухудшается при росте числа GPU
При fixed workload работа распределяется между большим числом ranks.
Compute на один rank становится меньше.
Но часть communication latency и synchronization не уменьшается пропорционально.
Со временем distributed overhead становится сложнее скрывать под compute.
Поэтому возможно:
1 → 2 nodes — хороший speedup
но:
4 → 8 nodes — заметно хуже.
Это нормальная причина строить scaling curve, а не экстраполировать один результат.
Почему 1→2 нельзя линейно переносить на target scale
При росте кластера меняются:
размеры collective groups;
topology;
communication paths;
parallelism mapping;
вероятность imbalance между ranks.
Поэтому хороший 2-node benchmark не доказывает хороший результат на 8 или 16 узлах.
TP, PP, CP и EP — architecture variables
Если profiler показывает communication bottleneck, можно проверить другой parallelism layout.
Например:
изменить TP degree;
изменить PP mapping;
использовать CP при long-context workload;
изменить сочетание data и model parallelism.
Но нельзя вводить универсальное правило:
TP всегда должен оставаться внутри одного узла.
Правильный placement зависит от конкретной topology и подтверждается benchmark.
Pipeline parallelism тоже имеет overhead
Pipeline Parallelism распределяет model stages между devices.
При этом появляются:
point-to-point transfers;
pipeline scheduling;
потенциальные idle periods;
необходимость балансировать stages;
зависимость от microbatching.
Поэтому увеличение PP degree тоже требует измерения.
MoE имеет собственный network profile
В Mixture-of-Experts training tokens могут маршрутизироваться между experts на разных ranks.
Это может создавать All-to-All-style traffic.
Следовательно, результаты scaling dense model нельзя автоматически переносить на MoE.
Для representative MoE benchmark нужно сохранять:
EP degree;
routing configuration;
load balance.
Checkpointing — часть полного training run
Training job состоит не только из steady-state steps.
Периодически состояние нужно сохранять.
Поэтому отдельно измеряют:
checkpoint blocking overhead;
total checkpoint completion time;
load/recovery time.
Blocking overhead и total save time — разные показатели
При asynchronous checkpointing часть работы может продолжаться после staging checkpoint data.
Поэтому:
checkpoint полностью сохранился за 90 секунд
не обязательно означает:
training был остановлен на 90 секунд.
Для qualification нужны обе величины:
blocking overhead
и:
total completion time.
Async checkpointing также может требовать дополнительную CPU RAM и host resources для staging.
Checkpoint interval тоже является trade-off
Частые checkpoints:
увеличивают save overhead.
Редкие:
потенциально увеличивают объём потерянного compute после interruption.
Поэтому универсального:
checkpoint каждые N минут
не существует.
Политику выбирают под конкретный training run и recovery requirements.
Recovery нужно проверить отдельно
Для проекта полезно провести representative recovery scenario и измерить:
checkpoint load;
restart;
время до возобновления useful training.
Не нужно придумывать универсальную вероятность отказа.
Если production history ещё нет, assumptions следует обозначить явно.
Что здесь означает training goodput
В этой статье под training goodput будем понимать:
Это не универсальная стандартизованная процентная формула.
Здесь термин нужен, чтобы отличить:
peak steady-state throughput
от:
полезной производительности полного training run.
Почему peak throughput недостаточно
Система может демонстрировать высокий:
tokens/s;
samples/s;
на representative steady-state steps.
Но заметную часть wall-clock терять на:
checkpoints;
recovery;
data stalls;
slow ranks.
Тогда isolated benchmark выглядит хорошо, а полный training run выполняется хуже ожидаемого.
Поэтому:
Peak Throughput PASS ≠ Full-Run PASS.
Single-Node → Multi-Node Decision Worksheet
Training identity
Параметр | Значение |
Model/version | |
Dense/MoE | |
Precision | |
Optimizer | |
Sequence length | |
Global batch | |
Microbatch | |
Fixed benchmark workload | |
Production training target |
Parallelism
Параметр | Значение |
DP/FSDP | |
TP | |
PP | |
CP | |
EP | |
Activation checkpointing | |
Distributed optimizer |
Single-node baseline
Метрика | Значение |
GPU/node | |
Peak memory/rank | |
Steady-state p50/p95 step | |
Tokens/s или samples/s | |
Time-to-fixed-work | |
Production target | PASS / FAIL |
Checkpoint blocking overhead |
Multi-node candidate
Метрика | Значение |
Nodes | |
Total GPU | |
Fabric/topology | |
Relevant communication tests | |
Steady-state step time | |
Throughput | |
Time-to-fixed-work | |
Speedup | |
Scaling efficiency | |
Exposed communication | |
Checkpoint blocking overhead | |
Total checkpoint completion | |
Recovery time |
Decision
Gate | Result |
Memory | PASS / FAIL |
Fabric | PASS / FAIL |
Scaling | PASS / FAIL |
Operational overhead | PASS / FAIL |
Full-run objective | PASS / FAIL |
Architecture | single / multi-node |
Как провести qualification
1. Зафиксировать training configuration
Сохранить:
software versions;
model;
optimizer;
precision;
sequence;
batch;
parallelism.
2. Определить fixed benchmark workload
Нужно заранее понимать, какой одинаковый объём работы выполняют сравниваемые configurations.
3. Измерить peak memory
Не заменять измерение checkpoint size или parameter count.
4. Получить максимально разумный single-node baseline
Проверить:
sharding;
multi-GPU;
activation checkpointing;
microbatch;
parallelism.
5. Проверить production target
Если single node уже выполняет требуемый time-to-train, performance-driven multi-node для этой цели не обязателен.
6. Зафиксировать topology и parallelism map
Без них сложно интерпретировать network benchmark.
7. Проверить relevant communication operations
Сравнить результат с ожидаемым уровнем конкретной topology.
8. Провести 1→2-node fixed-work benchmark
Сохранить:
throughput;
time-to-fixed-work;
speedup;
scaling efficiency;
exposed communication.
9. Проверить target scale
Не экстраполировать 2-node speedup линейно.
10. Отдельно измерить operational overhead
Сохранить:
checkpoint blocking;
total save;
recovery;
заметные stalls.
11. Проверить full-run objective
Оценить полезный progress за wall-clock, а не только лучший isolated step.
Когда multi-node действительно нужен
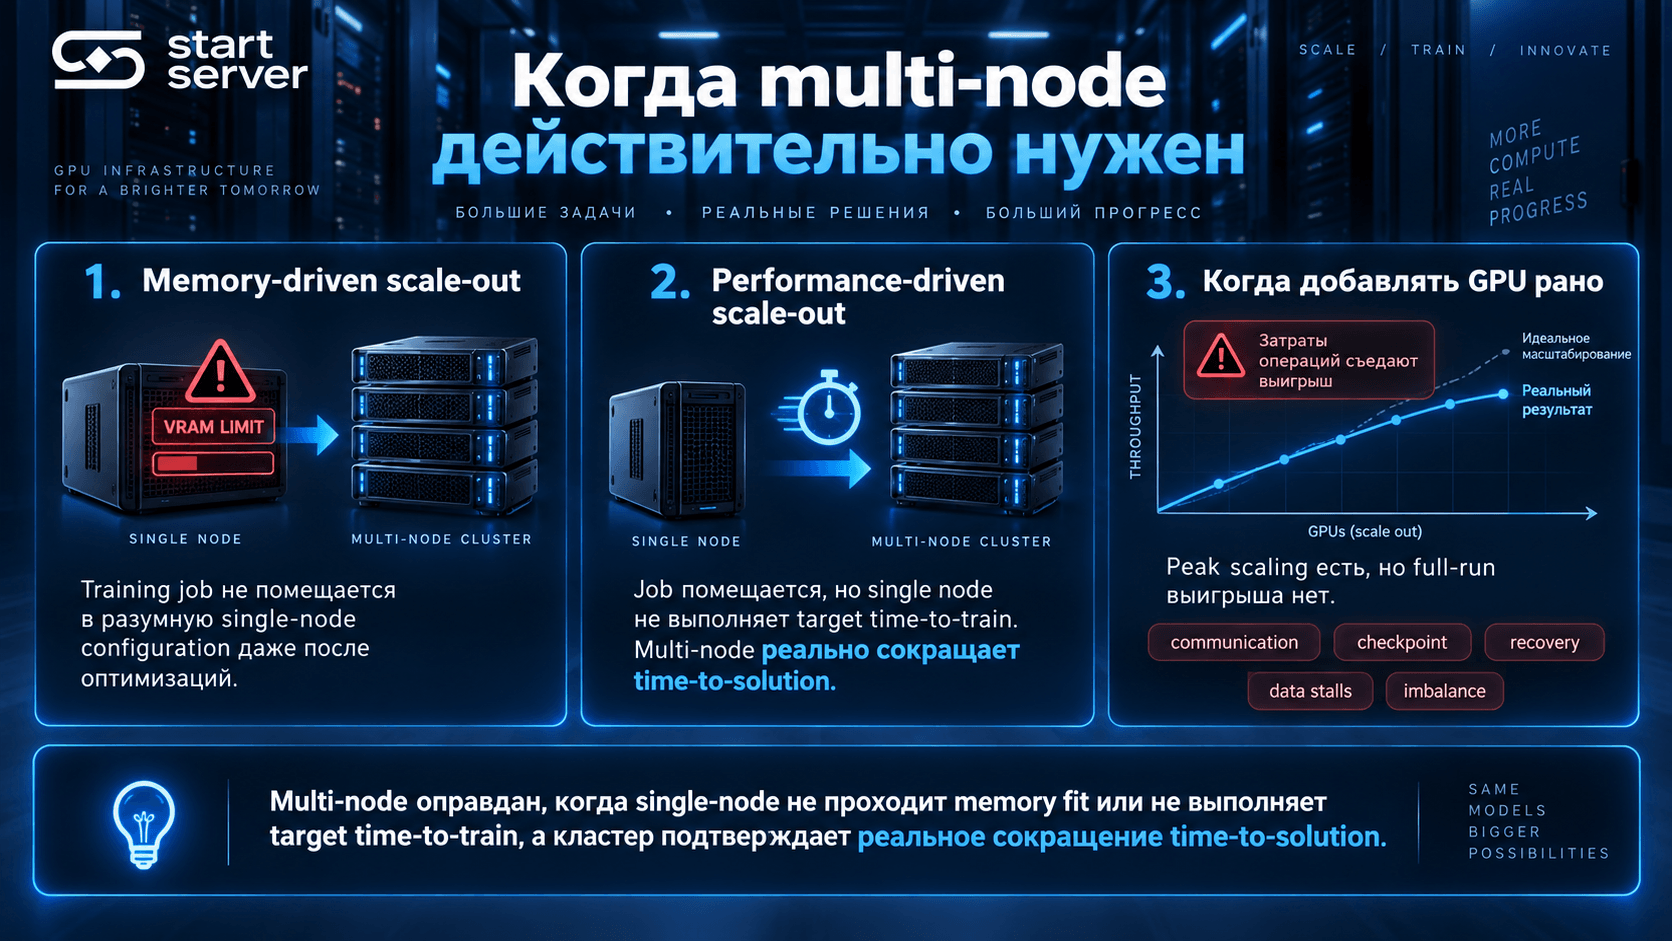
Сценарий 1. Memory-driven scale-out
Training job после приемлемых optimizations всё ещё не помещается в максимальную разумную single-node configuration.
Multi-node становится memory-driven candidate.
Сценарий 2. Performance-driven scale-out
Job помещается, но single node не выполняет target.
Fixed-work multi-node benchmark показывает полезное сокращение time-to-solution.
Multi-node становится performance-driven candidate.
Сценарий 3. Peak scaling есть, full-run выигрыша нет
Steady-state throughput растёт, но преимущества теряются из-за:
communication;
checkpoint;
recovery;
data stalls;
imbalance.
Такой cluster ещё не проходит full-run qualification.
Когда проблема может быть не в количестве GPU
Симптом | Что проверить |
Training OOM | sharding, optimizer state, activations |
FSDP устранил OOM, но training медленный | communication/materialization |
2 nodes почти не ускорили fixed work | parallelism / exposed communication |
Communication benchmark ниже ожидаемого | fabric / topology / NIC mapping |
Fabric benchmark хороший, scaling слабый | application parallelism |
GPU ждут synchronization | critical-path communication |
TP плохо масштабируется | communication granularity |
PP имеет idle periods | stage balance / microbatching |
MoE масштабируется слабо | expert routing / load balance |
GPU ждут input | data pipeline |
Один rank систематически медленнее | straggler |
Checkpoint сильно блокирует training | staging/save path |
Peak throughput хороший, full run медленный | checkpoint/recovery/stalls |
Таблица показывает направления проверки, а не автоматически устанавливает причину.
Какие данные нужны для проектирования GPU-кластера
Перед выбором rack-scale architecture полезно собрать:
Блок | Данные |
Model | version, dense/MoE |
Training | precision, optimizer, sequence, batch |
Memory | peak memory/rank |
Parallelism | DP/FSDP, TP, PP, CP, EP |
Single node | steady-state step, throughput, fixed-work time |
Fabric | topology + relevant communication results |
Multi-node | 2-node + target-scale fixed-work results |
Profiler | exposed communication, stalls |
Checkpoint | blocking overhead, total completion |
Recovery | representative restart |
Target | production time-to-train / throughput |
После этого вопрос:
Нужен ли нам многоузловой GPU-кластер?
можно заменить измеримым требованием:
Exact training job либо не проходит Memory PASS в разумной single-node configuration, либо single node не выполняет target, а multi-node fixed-work benchmark показывает достаточное сокращение time-to-solution и сохраняет выигрыш после operational overhead.
Главное
Многоузловой GPU-кластер нужен не потому, что модель имеет определённое число параметров.
Сначала фиксируют:
model → optimizer → precision → sequence → batch → parallelism.
Затем проверяют:
Memory PASS на максимально разумной single-node configuration.
Если job помещается:
выполняет ли single node target time-to-train?
Если нет, начинается scale-out qualification:
fabric → 1→2-node fixed-work benchmark → target-scale benchmark.
При этом:
Single-GPU OOM ≠ multi-node requirement.
NCCL/Fabric PASS ≠ Training Scaling PASS.
Total communication activity ≠ exposed communication overhead.
Step time без work/step ≠ scaling proof.
2× GPU ≠ автоматически 2× speed.
Peak throughput ≠ full-run efficiency.
Финальное решение принимают по тому, насколько multi-node уменьшает time-to-fixed-work и production time-to-solution, сохраняя выигрыш после communication, checkpoint, recovery и других существенных stalls.
Только после этого scale-out становится доказанной архитектурной необходимостью, а не просто более крупной конфигурацией.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


