Компьютерное зрение, или Computer Vision, это область искусственного интеллекта, в которой программа извлекает информацию из изображений и видео. Система может определить класс объекта, найти его координаты, выделить контур, прочитать текст, проследить движение или оценить положение в трехмерном пространстве.
Цель компьютерного зрения состоит не в том, чтобы получить красивую картинку. Результатом должна стать структурированная информация или действие: код дефекта, координаты детали, номер автомобиля, число посетителей, маска повреждения, траектория объекта или сигнал производственному контроллеру.
Реальная система компьютерного зрения включает больше компонентов, чем нейросеть. Нужны камера и оптика, стабильное освещение, канал передачи данных, декодирование, алгоритмы предобработки, модель, сервер или edge-устройство, постобработка, интеграция с бизнес-системой и мониторинг качества.
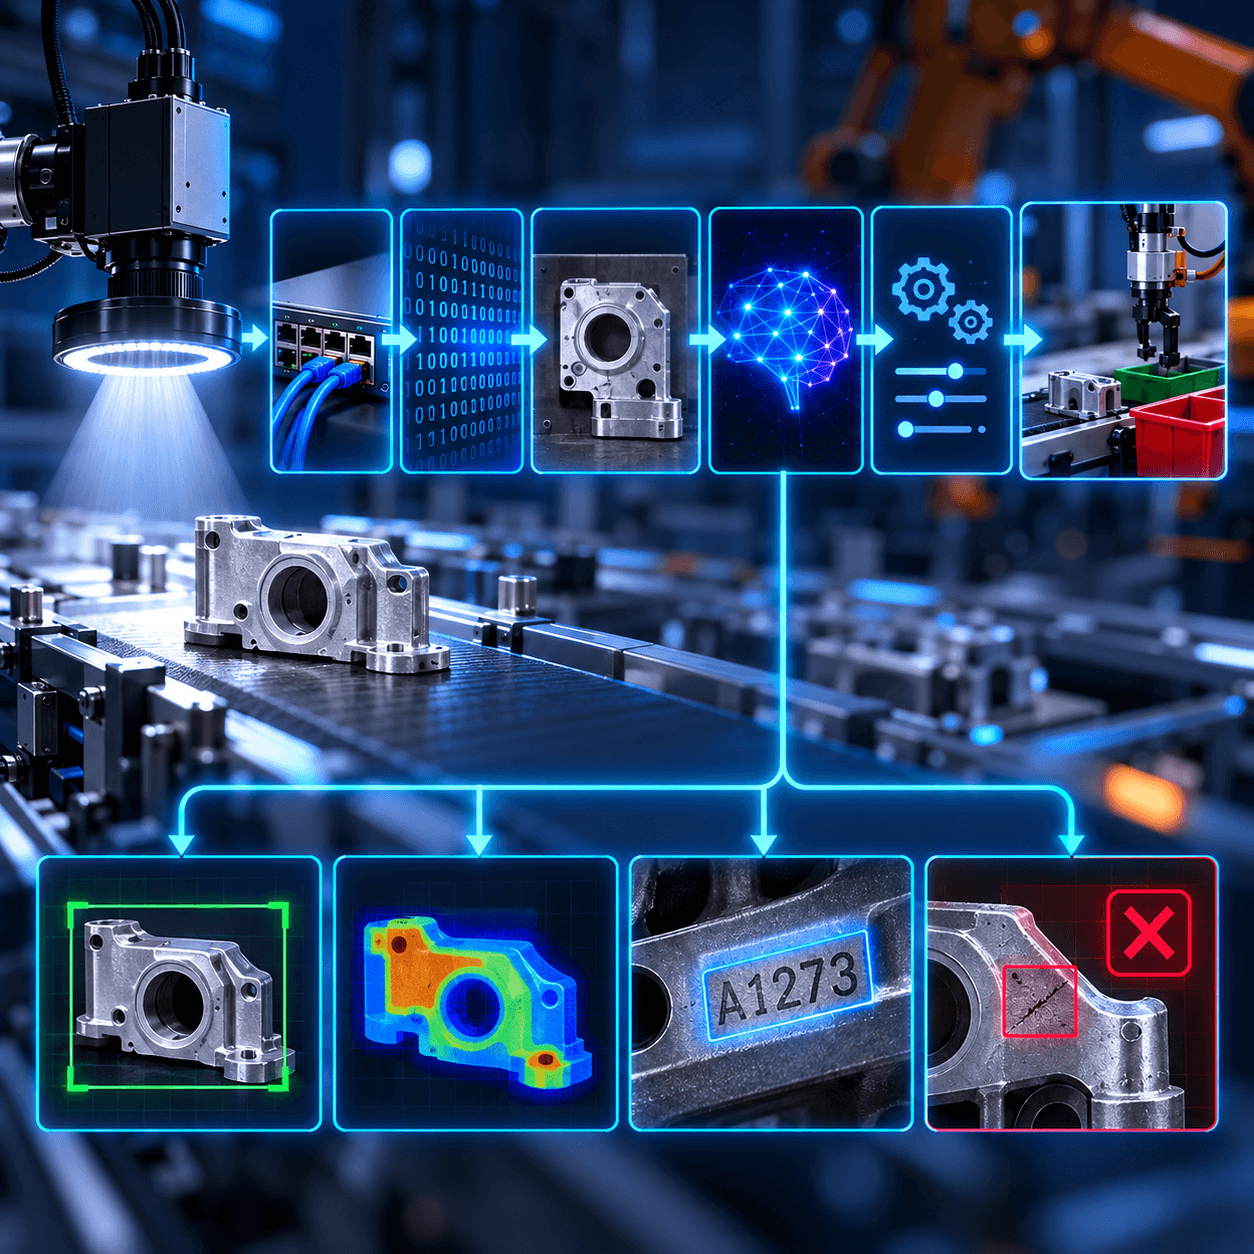
Что такое компьютерное зрение простыми словами
Цифровое изображение состоит из числовых значений пикселей. Для цветной фотографии это обычно несколько каналов, для камеры глубины к цвету добавляется расстояние, а для видео появляется временная последовательность кадров. Алгоритм преобразует эти данные в признаки и предсказание, полезное для конкретной задачи.
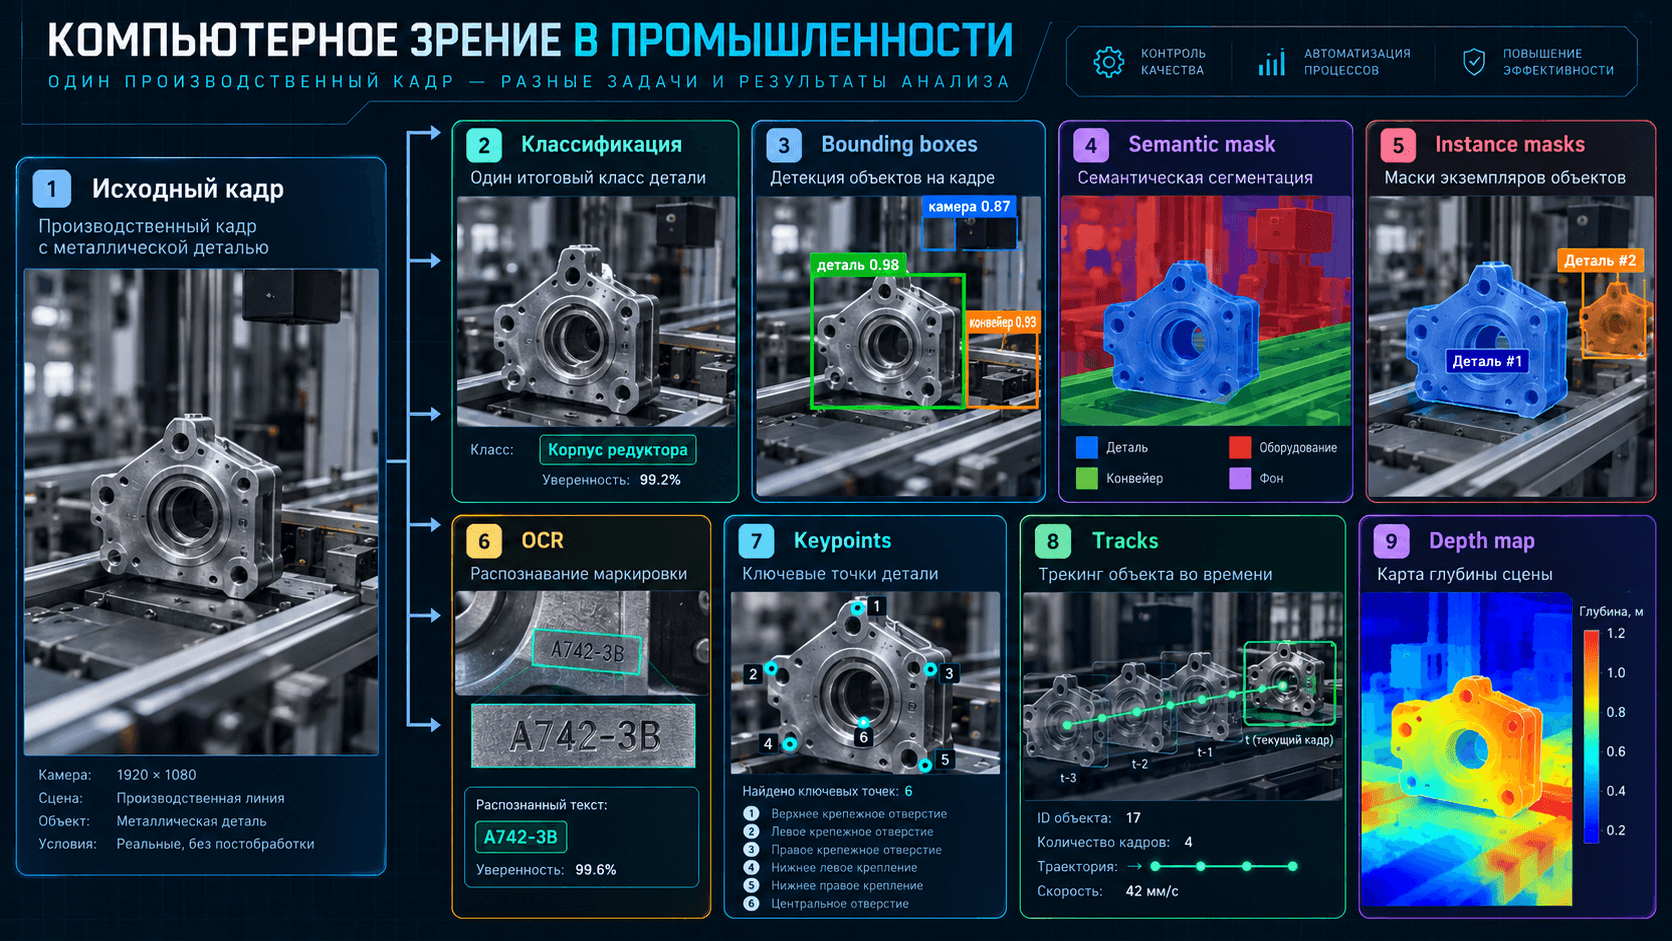
Простой классификатор отвечает: «На изображении деталь класса A». Детектор добавляет координаты: «В этой области кадра находится деталь A». Сегментация определяет принадлежность каждого пикселя. Трекинг связывает один объект на соседних кадрах. 3D computer vision восстанавливает глубину, позу или геометрию сцены.
Компьютерное зрение относится к технологиям искусственного интеллекта, но не каждая операция над изображением требует AI. Изменение размера, фильтрация шума, коррекция перспективы или поиск контуров могут выполняться классическими алгоритмами. Машинное и глубокое обучение применяют, когда правила сложно описать вручную или сцены сильно меняются.
Компьютерное зрение является функциональным направлением AI, а машинное обучение является одним из способов создавать для него модели. Эти понятия связаны, но не взаимозаменяемы.
Компьютерное, машинное и техническое зрение: в чем разница
Компьютерное зрение является широкой областью методов анализа изображений, видео и трехмерных данных. Термины машинное и техническое зрение чаще используют для прикладной системы, которая воспринимает физический объект и влияет на процесс.
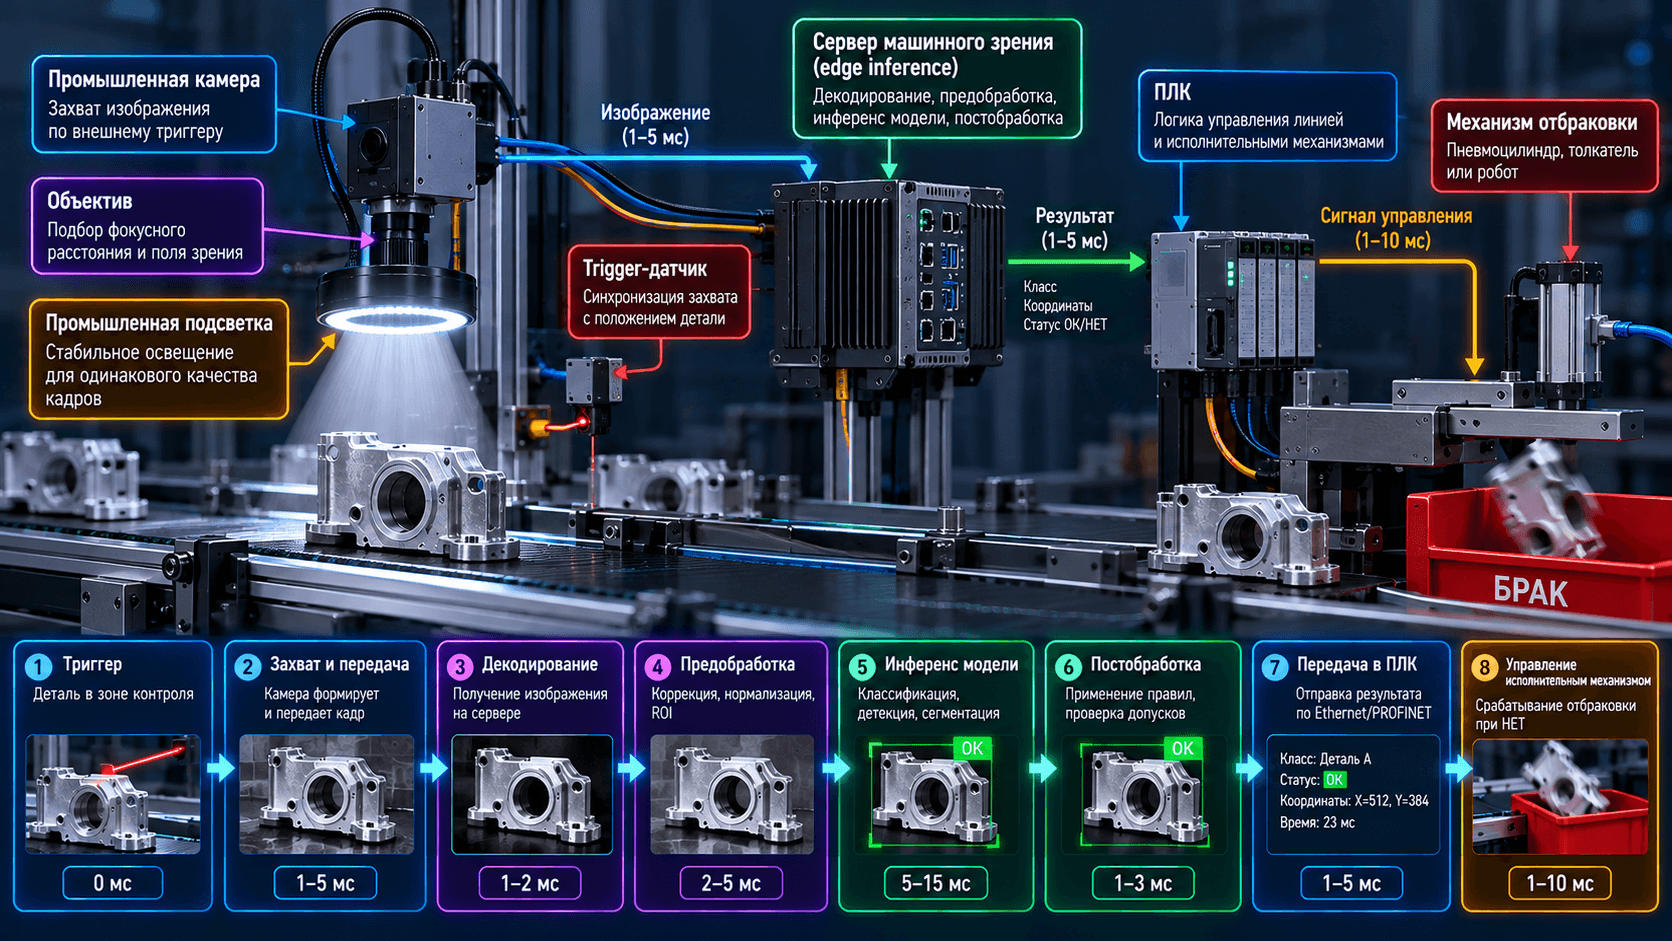
Например, модель обнаружения царапины относится к computer vision. Контрольная станция с камерой, объективом, подсветкой, датчиком положения изделия, промышленным компьютером и механизмом отбраковки является системой машинного зрения.
Видеоаналитика работает с видеопотоком и событиями во времени. Она может использовать детекцию, классификацию и tracking, а затем считать пересечения зоны, длительность нахождения, очереди или нарушения. Не любая задача CV является видеоаналитикой: OCR одного скана или классификация фотографии не требуют видеопотока.
Термин | Что описывает | Типичный вход | Результат |
|---|---|---|---|
Компьютерное зрение | область методов и моделей | фото, видео, depth, point cloud | класс, координаты, маска, текст, поза, траектория |
Машинное или техническое зрение | прикладной аппаратно-программный контур | данные камеры и датчиков | решение для автоматики или оператора |
Видеоаналитика | анализ событий во времени | один или много видеопотоков | событие, счетчик, маршрут, тревога |
Обработка изображений | преобразование и измерение пикселей | отдельное изображение или кадр | улучшенное изображение, контуры, геометрические признаки |
Основные задачи компьютерного зрения
Официальная документация TorchVision выделяет модели для классификации, семантической сегментации, детекции, instance segmentation, keypoints, видео и optical flow. В проекте задачи часто комбинируются в один pipeline.
Классификация изображений
Классификация присваивает всему изображению один или несколько классов. Модель может определить тип детали, категорию товара, вид растения или наличие дефекта на уже вырезанном фрагменте.
Если в кадре несколько объектов и нужно знать их положение, одной классификации недостаточно. Модель способна правильно определить класс, но не сообщить, где именно находится объект.
Локализация и детекция объектов
Локализация находит координаты одного объекта. Детекция обнаруживает несколько объектов и возвращает для каждого класс, confidence и bounding box. Так решаются подсчет объектов, контроль зоны, поиск транспорта, деталей, средств индивидуальной защиты и других сущностей.
Порог confidence влияет на баланс ошибок. Высокий порог уменьшает часть ложных срабатываний, но способен увеличить пропуски. Его выбирают по цене false positive и false negative, а не по привычному значению.
Семантическая и instance segmentation
Семантическая сегментация присваивает класс каждому пикселю, но не обязательно разделяет разные экземпляры одного класса. Instance segmentation выделяет отдельную маску для каждого объекта. Panoptic segmentation объединяет разметку объектов и фона.
Сегментация нужна, когда рамки недостаточно: для оценки площади дефекта, контура повреждения, свободной зоны, дорожного покрытия или границ объекта сложной формы.
OCR и анализ документов
OCR распознает символы и строки. Полный документный pipeline также находит поля, таблицы, печати, подписи и структуру страницы. После распознавания компьютерное зрение может работать вместе с NLP, чтобы классифицировать документ и извлечь сущности.
Качество OCR зависит от разрешения, фокуса, перспективы, бликов, шрифта и разметки страницы. Поэтому модель языка не исправляет плохое изображение автоматически.
Распознавание лиц и визуальная идентификация
В face pipeline сначала находят лицо, затем выравнивают изображение и получают числовое представление. Верификация отвечает, принадлежат ли два изображения одному человеку. Идентификация ищет совпадение среди множества записей.
Для таких систем нужны отдельная оценка ошибок, защита биометрических шаблонов, контроль доступа и проверка допустимости сценария. Распознавание лица нельзя оценивать одной точностью классификатора.
Keypoints и оценка позы
Модель keypoint detection находит характерные точки: суставы человека, ориентиры лица, углы детали или точки захвата. По ним оценивают позу, жест, геометрию и движение.
В робототехнике результат должен быть привязан к координатам рабочего пространства. Для этого нужны калибровка камеры, преобразование систем координат и часто данные глубины.
Tracking и распознавание действий
Трекинг поддерживает идентификатор объекта между кадрами. Он позволяет считать уникальные объекты, строить траектории, измерять время нахождения и анализировать пересечение зон.
Распознавание действий использует последовательность кадров. Простое событие можно получить правилами над треками, а сложное действие потребует видео-модели. Детектор на одном кадре не понимает длительность и порядок событий.
Поиск аномалий и дефектов
Классификатор дефектов требует примеров каждого известного класса. Anomaly detection учится представлению нормального объекта и ищет отклонения. Этот подход полезен, когда брак редок или его виды заранее неизвестны, но порог аномалии все равно калибруют на реальной линии.
3D-зрение, глубина и навигация
Стереокамеры, камеры глубины, structured light, LiDAR и несколько ракурсов помогают восстановить расстояние и геометрию. Задачи включают оценку глубины, 3D-реконструкцию, visual odometry, SLAM и определение позы объекта.
Задача | Выход модели | Пример применения | Базовая метрика |
|---|---|---|---|
Классификация | класс или набор классов | сортировка изображения товара | precision, recall, F1 |
Детекция | класс и bounding box | поиск деталей или людей | mAP при заданных IoU |
Сегментация | маска пикселей | площадь дефекта | IoU, Dice |
OCR | строка и координаты текста | документы и маркировка | CER, WER, точность полей |
Keypoints | координаты точек | поза человека или детали | ошибка координат, PCK |
Tracking | ID и траектория | подсчет и движение объектов | IDF1, HOTA, ошибки ID |
Anomaly detection | anomaly score или область | неизвестный дефект | recall при допустимом false positive rate |
Depth и 3D | глубина, point cloud, поза | роботизированный захват | ошибка расстояния или позы |
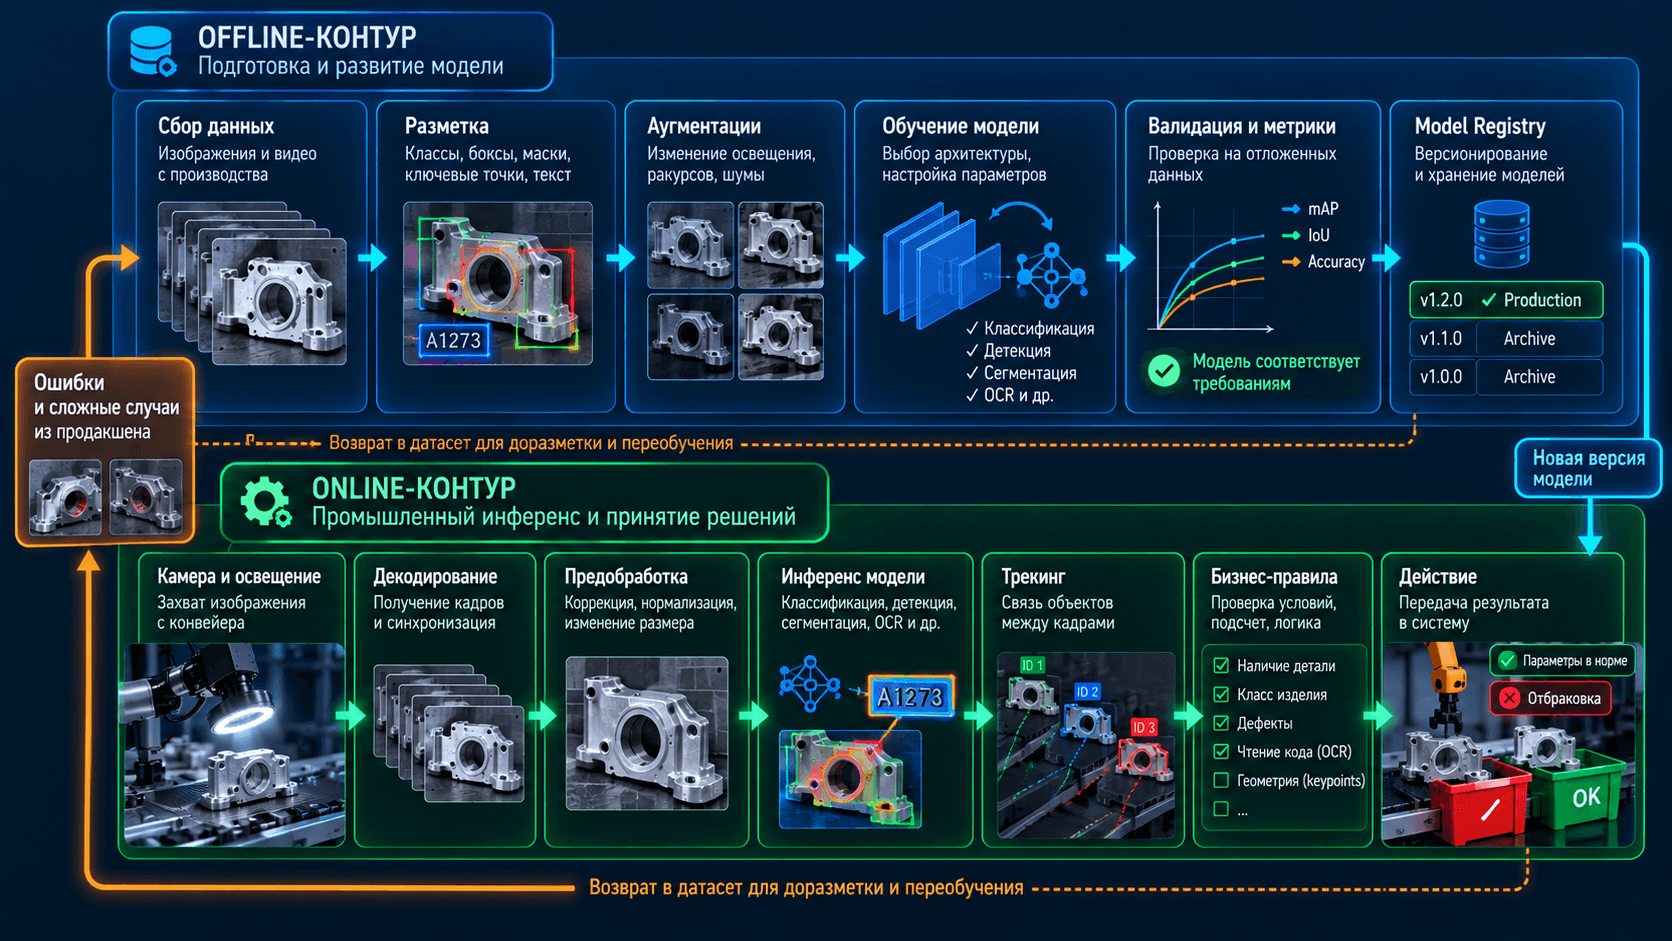
Как работает система компьютерного зрения
1. Формулировка измеримого результата
Проект начинается не с выбора нейросети, а с решения. Нужно определить объект контроля, допустимые ошибки и действие системы. Формулировка «распознавать дефекты» слишком широка. Рабочее требование описывает типы дефектов, минимальный размер, скорость линии, время реакции и действия при низкой уверенности.
2. Получение изображения
Камера должна увидеть нужный признак с достаточным количеством пикселей. На результат влияют объектив, фокусное расстояние, выдержка, rolling или global shutter, освещение, поляризация, угол съемки, фон и вибрация.
Камера с большим числом мегапикселей не решает проблему сама. Более высокое разрешение увеличивает сетевой трафик, время декодирования, память и вычислительную нагрузку. Оптику и расположение выбирают по размеру объекта и полю зрения.
3. Подготовка и разметка данных
Датасет должен покрывать реальную вариативность: смены, камеры, партии продукции, сезоны, освещение, загрязнение, редкие классы и пограничные случаи. Обучающую, валидационную и тестовую выборки разделяют так, чтобы почти одинаковые кадры одного события не оказались по обе стороны проверки.
Разметка определяется задачей. Для классификации нужен класс изображения, для детекции нужны рамки, для сегментации маски, для OCR текст и координаты. Ошибки разметки ограничивают потолок качества модели.
4. Предобработка и аугментации
Изображение масштабируют, нормализуют и переводят в требуемое цветовое пространство. Геометрическую калибровку используют для коррекции дисторсии и измерений. Аугментации имитируют допустимые изменения, но не должны создавать физически невозможные примеры.
Документация OpenCV включает обработку изображений, video I/O, калибровку камер, 3D-реконструкцию, признаки, object detection и inference нейросетей. В production эти операции часто соседствуют с обучаемой моделью.
5. Обучение модели
Модель учится на размеченных данных минимизировать функцию потерь. Для нового проекта часто берут предобученную архитектуру и дообучают на доменных данных. Это не отменяет проверку лицензии весов и датасета.
CNN хорошо извлекают локальные визуальные признаки. Vision Transformer и гибридные архитектуры используют механизмы attention. Архитектурное семейство не гарантирует качество: важны данные, размер входа, режим обучения, функция потерь и проверка на целевом домене.
6. Валидация и выбор порогов
Метрику выбирают по задаче и стоимости ошибки. Для контроля опасного дефекта recall может быть важнее общей accuracy. Для автоматической отбраковки нужно ограничить false positive rate, иначе система будет удалять годную продукцию.
Отчет следует разбивать по камерам, сменам, классам и условиям. Средний результат способен скрыть провал на редком, но критичном классе.
7. Inference и постобработка
На инференсе камера или файл поступает в pipeline. Поток декодируется, кадр готовится, модель формирует предсказание, затем применяются пороги, non-maximum suppression, правила зон, tracking и бизнес-логика.
Официальная архитектура NVIDIA DeepStream показывает последовательность source, decode, preprocessing, batching, inference, tracking, визуализация и передача метаданных. Это полезная иллюстрация того, почему скорость одной модели не равна скорости всей системы.
8. Действие и обратная связь
Результат передается в MES, WMS, VMS, СКУД, робот, контроллер линии или рабочее место оператора. Нужно определить поведение при потере камеры, задержке, низкой уверенности и недоступности сервера.
Ошибочные и спорные случаи возвращают в контур разметки. После проверки они становятся материалом для новой версии модели. Без такого цикла качество со временем расходится с изменяющейся реальностью.
Алгоритмы и технологии компьютерного зрения
Классические методы
Классическое компьютерное зрение использует фильтрацию, пороги, морфологические операции, поиск контуров, углов и линий, сопоставление признаков, optical flow, геометрию нескольких камер и template matching. Такие методы прозрачны и эффективны в контролируемой сцене.
Если объект всегда расположен одинаково, освещение стабильно, а признак легко измерить, нейросеть может быть избыточной. Классический алгоритм проще проверить и запустить на CPU.
Машинное и глубокое обучение
Модель машинного обучения получает признаки и учится разделять классы. Глубокая нейронная сеть одновременно формирует признаки и выход для классификации, детекции или сегментации. Она лучше переносит сложную визуальную вариативность, но требует данных и контроля поведения.
Нейросеть компьютерного зрения не «понимает» объект как человек. Она оценивает закономерности, усвоенные из данных. Изменение камеры, фона, партии материала или погоды может изменить распределение входов и снизить качество.
Готовая модель, дообучение или разработка
Готовая модель подходит, когда классы и условия близки к ее обучающим данным. Дообучение требуется для нового домена, ракурса или набора классов. Разработка собственной архитектуры оправдана, если типовая модель не закрывает ограничение по качеству, скорости, памяти или лицензированию.
Решение принимают по результатам baseline. Сначала строят простейший рабочий pipeline и измеряют его на данных заказчика. Сложность добавляют только для исправления конкретной ошибки.
Метрики качества компьютерного зрения
Accuracy полезна только при сбалансированных классах и одинаковой цене ошибок. В реальном проекте используют набор метрик.
Precision показывает долю верных срабатываний среди всех срабатываний модели.
Recall показывает долю найденных целевых объектов среди всех реальных объектов.
F1 объединяет precision и recall в одну величину, но скрывает конкретный компромисс.
IoU измеряет пересечение предсказанной и эталонной области относительно их объединения.
mAP агрегирует качество детекции по классам и порогам IoU согласно выбранному протоколу.
CER и WER оценивают ошибки OCR на уровне символов и слов.
Для tracking нужны метрики сохранения идентичности и качества траекторий.
Кроме качества модели измеряют end-to-end характеристики:
задержку от получения кадра до действия;
устойчивый throughput в кадрах или объектах за секунду;
процент отброшенных кадров;
время восстановления после потери потока;
загрузку decode, CPU, GPU, VRAM, RAM, сети и storage;
долю случаев, отправленных оператору;
бизнес-метрику: пропущенные дефекты, ложная отбраковка, время проверки или предотвращенные простои.
Тестовый набор должен отражать эксплуатацию. Если одна камера дает много похожих кадров, случайное перемешивание завысит результат. Лучше разделять данные по времени, партиям, камерам или площадкам.
Где применяется компьютерное зрение
Производство и контроль качества
Промышленное компьютерное зрение проверяет геометрию, поверхность, комплектность, маркировку, положение детали и соблюдение операции. Камера фиксирует изделие, модель находит отклонение, а система сохраняет результат и передает сигнал оператору или автоматике.
Для контроля мелкого дефекта качество оптики и света часто важнее перехода на более крупную модель. Сцену проектируют так, чтобы дефект был виден стабильно и занимал достаточное число пикселей.
Безопасность и видеоаналитика
Видеоаналитика обнаруживает людей и транспорт, отслеживает движение, контролирует зоны, считает объекты и формирует события. Для большого числа камер нагрузку определяют разрешение, кодек, FPS, частота запуска модели, число объектов и цепочка вторичных моделей.
Распознавание события требует правил эксплуатации. Например, нахождение человека в зоне может быть нормальным при остановленной линии и критичным во время движения оборудования.
Транспорт и логистика
CV применяют для распознавания номеров и контейнеров, контроля загрузки, учета транспорта, анализа очередей, повреждений и навигации роботов. В логистике полезный результат часто получается после объединения OCR, детекции, tracking и данных WMS.
Ритейл и склады
Системы считают посетителей, анализируют очереди, проверяют выкладку, распознают товары и контролируют наличие. Метрики модели нужно связывать с бизнес-процессом: ошибка подсчета и ошибочная идентификация товара имеют разную цену.
Робототехника, дроны и БПЛА
Компьютерное зрение робота определяет положение объекта, точку захвата, свободное пространство и препятствия. Для дронов применяются detection, tracking, visual odometry и построение карты.
На мобильной платформе ограничены питание, охлаждение и канал связи. Часть inference выполняют на edge, а тяжелое обучение и агрегацию данных оставляют центральному серверу.
Медицина и научные изображения
Модели анализируют рентгеновские снимки, КТ, МРТ, микроскопию и другие визуальные данные. Они могут выделять области интереса, сегментировать структуры и помогать сортировать исследования. Для медицинского применения необходимы профильная клиническая проверка, управление риском и соблюдение требований к конкретному классу системы. Обычный CV-прототип нельзя выдавать за диагностическое средство.
Документы и корпоративные процессы
OCR и document vision извлекают данные из счетов, актов, анкет, накладных и архивов. После определения структуры страницы результат проверяется правилами или языковой моделью. Для финансово значимых полей нужен контроль confidence и ручная проверка спорных случаев.
Сельское хозяйство и дистанционное наблюдение
Компьютерное зрение помогает считать растения и животных, оценивать состояние посевов, выявлять сорняки, сортировать продукцию и анализировать спутниковые или аэрофотоснимки. Модель должна учитывать сезон, регион, сенсор и высоту съемки.
Из чего состоит система машинного зрения
Камера, сенсор и оптика
Камеру выбирают по полю зрения, рабочему расстоянию, минимальному размеру признака, скорости объекта и условиям среды. Для быстро движущейся линии может потребоваться global shutter. Для измерений важны стабильная геометрия и калибровка.
Освещение
Форма, направление, спектр и поляризация света определяют контраст признака. Кольцевая, купольная, контровая или линейная подсветка решают разные задачи. Автоматическая экспозиция способна менять изображение между кадрами и мешать измерению, поэтому режим фиксируют после настройки.
Синхронизация и ввод-вывод
Датчик присутствия изделия или энкодер запускает съемку в нужный момент. Trigger, строб, промышленный интерфейс и контроллер обеспечивают связь с линией. Для автоматической отбраковки нужно учитывать задержку от кадра до исполнительного механизма.
Вычислительный узел
CPU принимает потоки, декодирует часть форматов, готовит данные и выполняет бизнес-логику. GPU ускоряет нейросетевой inference и обучение. RAM хранит буферы и данные приложения. NVMe используется для локального кэша, датасетов и журналов, а сеть связывает камеры, сервер, СХД и производственные системы.
Программный стек
Python широко используется для исследования и обучения, C++ применяется в производительных компонентах и интеграции. OpenCV закрывает ввод-вывод, обработку, калибровку и классические методы. PyTorch и другие ML-фреймворки применяются для обучения. ONNX, TensorRT или другой runtime помогают переносить и оптимизировать inference.
Выбор языка и библиотеки вторичен по отношению к задаче. В production важны воспроизводимая сборка, versioning модели, мониторинг, rollback и совместимость драйверов.
Какая инфраструктура нужна для Computer Vision
Обучение и инференс требуют разных конфигураций
Обучение модели использует размеченный датасет, аугментации, обратное распространение ошибки и серии экспериментов. На него влияют объем VRAM, скорость GPU, CPU-подготовка данных, RAM и NVMe.
Inference обрабатывает новые изображения. Здесь важны задержка, устойчивый throughput, число потоков, decode, precision вычислений и режим batch. Сервер, удачный для обучения крупной модели, не всегда экономичен для круглосуточной видеоаналитики.
Что нужно знать для расчета сервера
Минимальный набор исходных данных:
число камер или источников;
разрешение, FPS и кодек каждого потока;
сколько кадров реально поступает в модель;
архитектура и размер входа модели;
одна модель или каскад detector, tracker и classifier;
допустимая end-to-end задержка;
batch и число одновременных запросов;
требования к хранению исходного видео и событий;
обучение, инференс или оба режима;
работа в ЦОД, на edge или в распределенной схеме.
Пример: 40 камер передают видео с частотой 25 FPS, но анализ запускается для 5 кадров в секунду с каждого потока. Модель должна обработать минимум 40 × 5 = 200 кадров/с, плюс резерв на пики. При этом decode может работать с полным потоком, а tracking и постобработка добавляют собственную нагрузку. Поэтому бенчмарк одной модели на заранее подготовленных кадрах недостаточен.
Edge, центральный сервер или гибрид
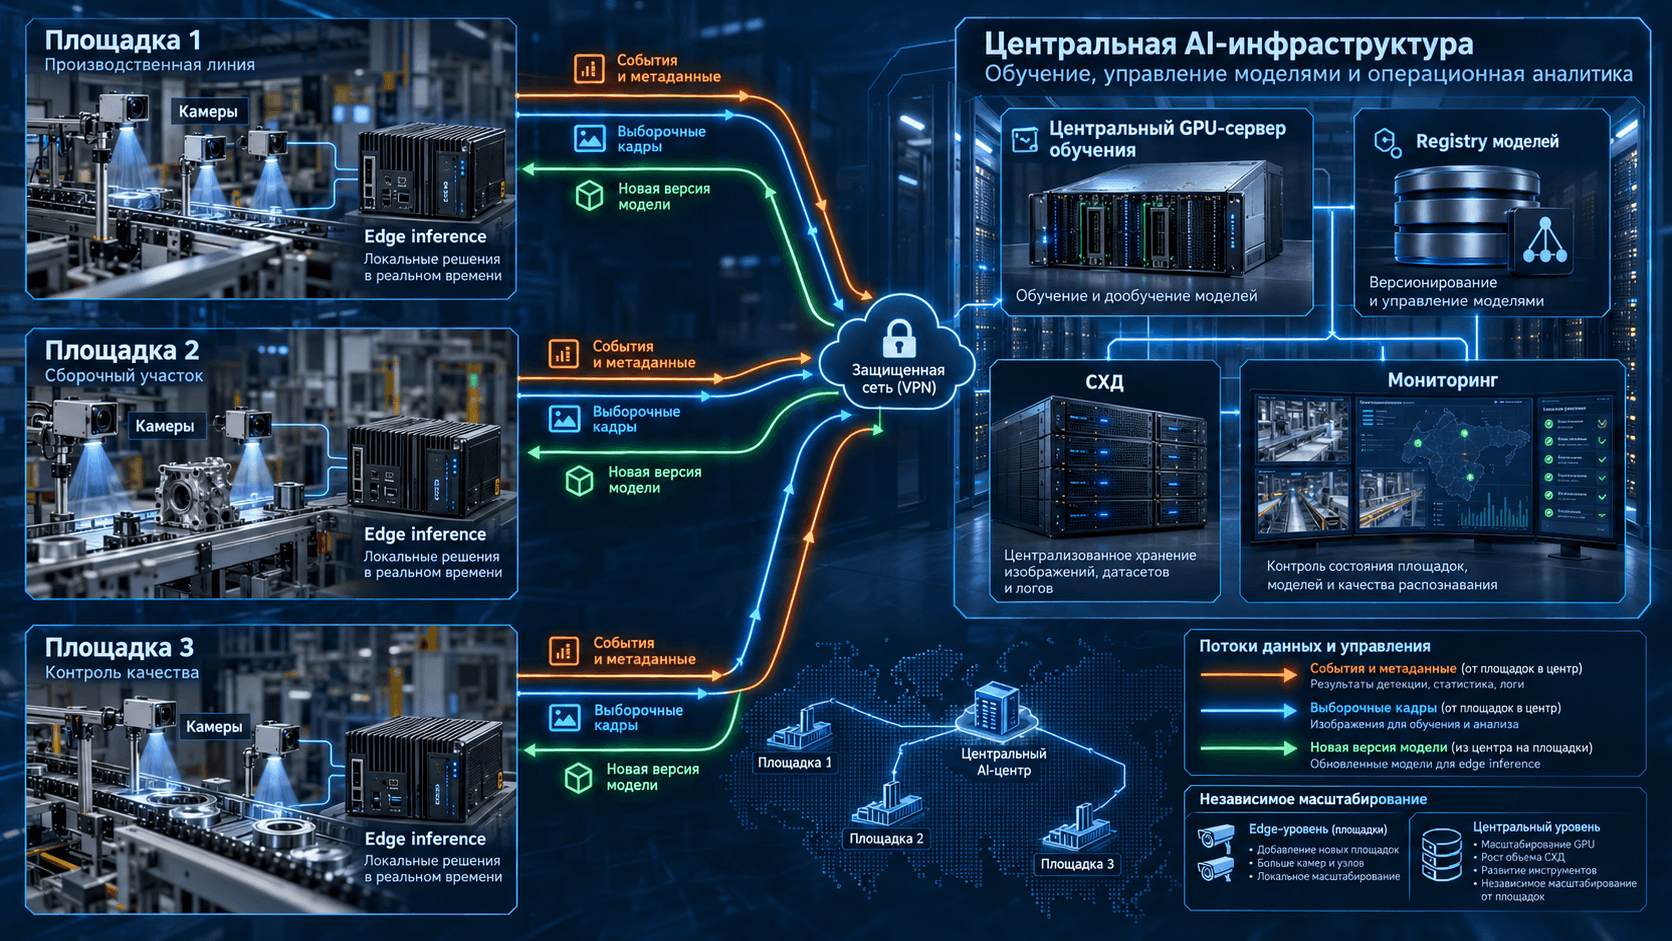
Edge inference размещают рядом с камерой или линией. Он снижает задержку и зависимость от канала, но ограничен питанием и охлаждением. Центральный сервер проще обслуживать и плотнее загружать, однако ему нужна сеть с достаточной пропускной способностью.
Гибридная схема оставляет inference на площадке, а обучение, registry моделей и общий датасет размещает в центре. Такой подход подходит нескольким производственным линиям или филиалам.
GPU, VRAM и видеодекодирование
GPU выбирают по измеренному pipeline, а не по числу камер в рекламной таблице. Два проекта с одинаковыми потоками различаются из-за кодека, размера входа, частоты inference, модели и точности вычислений.
Для плотного инференса и AI-video могут быть полезны компактные ускорители с аппаратным декодированием. Для обучения и более тяжелых моделей требуется больше VRAM и вычислительной мощности. Базовые критерии раскрыты в статье о выборе сервера для ИИ, а разделение двух режимов разобрано в материале об обучении и инференсе на одном GPU-сервере.
В каталоге выделены серверы для видеоаналитики и компьютерного зрения, а также системы с NVIDIA L40S и L4. Для компактного inference-контура можно рассматривать платформу Lenovo ThinkSystem SR630 V4 с однослотовыми ускорителями, а для более гибкой 2U-конфигурации: HPE ProLiant DL385 Gen11. Совместимость конкретной GPU, riser, блока питания и охлаждения проверяют по выбранной конфигурации.
Хранение изображений и видео
Исходный видеопоток способен создать намного больший объем, чем метаданные событий. Нужно заранее решить, хранить ли все видео, только фрагменты событий, отдельные кадры или признаки. Срок хранения и bitrate определяют емкость, а обучение модели требует быстрый доступ к размеченным изображениям.
Как внедрить компьютерное зрение
1. Выберите один измеримый процесс
Подходящая задача имеет повторяемый визуальный признак, достаточный поток примеров и понятную цену ошибки. Начинать со всей площадки сразу рискованно. Пилот ограничивают одной линией, одним объектом и несколькими классами результата.
2. Проведите обследование сцены
Проверьте рабочее расстояние, поле зрения, скорость объектов, вибрации, освещение, загрязнение, доступ к сети и точку интеграции. Сделайте изображения в реальных условиях, а не только лабораторные образцы.
3. Сформируйте датасет и критерии приемки
Определите правила разметки, классы, пограничные случаи и контроль качества. Разделите данные по времени или партиям. Зафиксируйте recall, допустимую ложную отбраковку, end-to-end latency и доступность системы.
4. Постройте baseline
Сравните простой классический алгоритм, готовую модель и дообучение. Оцените ошибки по категориям. Baseline показывает, нужен ли сложный стек и где фактически находится ограничение.
5. Проведите пилот на потоке
Offline-метрики не проверяют камеру, сеть, decode, интеграцию и задержку. Пилот запускают на реальном потоке, сначала в теневом режиме без автоматического воздействия на процесс.
6. Спроектируйте production-контур
Рассчитайте серверы, edge-узлы, сеть, storage, резервирование, мониторинг и безопасность. Определите управление версиями модели, обновление без простоя и возврат к предыдущей версии. В программу ввода оборудования включите приемочные испытания GPU-сервера на целевой нагрузке.
7. Контролируйте качество после запуска
Собирайте распределение confidence, долю неизвестных случаев, ошибки операторов, изменение входных данных и бизнес-метрики. Новая партия продукции или перенос камеры могут потребовать повторной проверки. Инфраструктурную телеметрию удобно сверить с отдельным руководством по мониторингу GPU-сервера.
Типичные ошибки проектов Computer Vision
Выбор модели до постановки задачи
Название архитектуры не определяет бизнес-результат. Сначала задают выход, цену ошибок и условия сцены, затем сравнивают модели.
Слабая оптика, которую пытаются компенсировать AI
Если дефект неразличим на кадре, нейросеть не восстановит надежную информацию. Исправление света и ракурса часто дает больший эффект, чем увеличение модели.
Утечка похожих кадров между выборками
Соседние кадры одного видео почти одинаковы. При случайном разделении модель проверяется на знакомой сцене, а метрика оказывается завышенной.
Одна accuracy для несбалансированной задачи
Если брак встречается редко, модель может получить высокую accuracy, всегда отвечая «норма». Нужны confusion matrix, precision, recall и оценка по каждому классу.
Benchmark только нейросети
В production время тратится на прием потока, decode, resize, копирование памяти, inference, tracking, правила и отправку результата. Измеряют полный pipeline.
Автоматическое действие без безопасного режима
При потере камеры, перегрузке сервера или низкой уверенности система должна переходить в определенное состояние. Для критичных процессов предусматривают ручное подтверждение или безопасный fallback.
Отсутствие мониторинга данных
Температура света, загрязнение объектива, новая упаковка и другой ракурс меняют вход. Без выборочной проверки и обратной связи деградация останется незаметной.
Частые вопросы о компьютерном зрении
Что такое компьютерное зрение?
Компьютерное зрение является областью искусственного интеллекта, которая извлекает структурированную информацию из изображений, видео и трехмерных данных. Результатом может быть класс, координаты объекта, маска, текст, поза или событие.
Какие задачи решает компьютерное зрение?
Основные задачи: классификация, детекция, сегментация, OCR, распознавание лиц, keypoints, tracking, анализ действий, anomaly detection, оценка глубины и 3D-реконструкция.
Как работает компьютерное зрение?
Система получает изображение, выполняет калибровку и предобработку, запускает алгоритм или нейросеть, преобразует предсказание в правило и передает результат приложению либо автоматике.
Компьютерное зрение и машинное обучение связаны?
Да. Многие современные модели CV обучаются на данных методами машинного и глубокого обучения. При этом классические алгоритмы обработки изображений и геометрии тоже остаются частью системы.
Чем компьютерное зрение отличается от машинного зрения?
Computer Vision обозначает широкую область методов. Машинное или техническое зрение чаще означает прикладной комплекс из камеры, света, вычислителя, ПО и интеграции с физическим процессом.
Чем видеоаналитика отличается от компьютерного зрения?
Видеоаналитика применяет методы CV к видеопотокам и событиям во времени. Она использует детекцию и tracking, а затем считает объекты, контролирует зоны или формирует тревоги.
Где применяется компьютерное зрение?
Технологию используют в промышленности, логистике, транспорте, ритейле, безопасности, робототехнике, БПЛА, медицине, сельском хозяйстве и обработке документов.
Что нужно для обучения модели компьютерного зрения?
Нужны репрезентативные данные, правила разметки, отдельные выборки для обучения и проверки, модель, вычислительная инфраструктура и метрика, связанная с ценой ошибки.
На каком языке программируют компьютерное зрение?
Для исследований часто используют Python. Производительные части и интеграции также разрабатывают на C++. Важнее языка являются поддержка библиотек, стабильность runtime и требования к задержке.
Всегда ли для CV нужна видеокарта?
Нет. Классический алгоритм или легкая модель могут работать на CPU или специализированном edge-ускорителе. GPU нужен, когда модель, поток данных и требования к скорости оправдывают параллельные вычисления.
Как оценивать качество модели CV?
Метрика зависит от задачи: precision и recall для классификации, mAP для детекции, IoU или Dice для сегментации, CER для OCR. Для системы также измеряют задержку, throughput и бизнес-ошибки.
Как рассчитать сервер видеоаналитики?
Нужно знать число потоков, разрешение, FPS, кодек, частоту inference, модель, размер входа, batch, допустимую задержку и срок хранения. После этого pipeline тестируют на целевой GPU вместе с decode и постобработкой.
Инфраструктура для проекта компьютерного зрения
Для расчета подготовьте число камер, примеры потоков, разрешение, FPS, кодек, перечень задач, модель или baseline, допустимую задержку, метрики приемки, срок хранения и план роста. Эти данные позволяют отдельно посчитать edge-инференс, центральное обучение, сеть и СХД.
Start Server проектирует и поставляет AI-инфраструктуру для Computer Vision: GPU-серверы, edge-узлы, сеть, хранение, контейнерный контур и мониторинг. Команда может проверить совместимость компонентов и рассчитать конфигурацию на реальном pipeline. Отправьте исходные параметры через контакты Start Server или начните с категории серверов для видеоаналитики и CV.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


