У NVIDIA L40S — 48 GB видеопамяти. У RTX PRO 6000 Blackwell Server Edition — 96 GB. Если остановиться на этом сравнении, выбор выглядит почти очевидным: новая карта вдвое вместительнее, у неё выше пропускная способность памяти и более свежая архитектура.
Для LLM-сервера этого недостаточно.
Гораздо полезнее сначала задать другой вопрос: что именно не помещается или не работает с нужными параметрами на 48 GB?
Если модель вместе с рабочей нагрузкой спокойно укладывается в память L40S и обеспечивает требуемую скорость, дополнительные 48 GB сами по себе ещё не делают RTX PRO 6000 необходимой. Но если 48 GB заставляют сильнее квантовать модель, ограничивать контекст, снижать число параллельных запросов или делить модель между несколькими GPU, переход на 96 GB уже способен изменить всю конфигурацию сервера.
Поэтому ниже мы сравниваем не просто две видеокарты. Смотрим на связку:
модель → precision → память весов → KV-cache → параллельность → число GPU → серверная платформа.
L40S или RTX PRO 6000: короткий ответ
Ориентироваться можно так:
Ситуация | С чего начать выбор |
Модель и рабочая нагрузка уверенно помещаются в 48 GB | L40S остаётся полноценным кандидатом |
Уже веса модели выходят за 48 GB | RTX PRO 6000 96 GB либо multi-GPU |
Веса помещаются, но памяти не хватает под длинный контекст и параллельные запросы | 96 GB становятся намного интереснее |
Нужно сократить число GPU на одну модель | Проверить, позволяет ли RTX PRO 6000 разместить workload на одной карте |
Нужен Blackwell/NVFP4-стек | RTX PRO 6000 |
Требуется аппаратно разделить GPU между несколькими нагрузками | RTX PRO 6000 благодаря MIG |
L40S уже используется и закрывает требования | Обновление нужно обосновать конкретным ограничением |
Последняя строка здесь не менее важна первой. В серверной инфраструктуре «новее» и «нужно» — разные вещи.
Что действительно отличается у L40S и RTX PRO 6000
L40S основана на архитектуре Ada Lovelace. NVIDIA указывает для неё 48 GB GDDR6 ECC, пропускную способность памяти 864 GB/s, PCIe Gen4 x16 и максимальную мощность 350 W. Карта пассивно охлаждается, поддерживает vGPU, но не MIG.
RTX PRO 6000 Blackwell Server Edition относится уже к поколению Blackwell. У неё 96 GB GDDR7 ECC и 1597 GB/s memory bandwidth. NVIDIA также указывает FP4- и FP8-возможности Tensor Cores, PCIe Gen5 и MIG. Максимальное энергопотребление — до 600 W с возможностью конфигурации power limit.
Параметр | NVIDIA L40S | RTX PRO 6000 Blackwell Server Edition |
Архитектура | Ada Lovelace | Blackwell |
VRAM | 48 GB GDDR6 ECC | 96 GB GDDR7 ECC |
Пропускная способность памяти | 864 GB/s | 1597 GB/s |
Интерфейс | PCIe Gen4 x16 | PCIe Gen5 |
Максимальная мощность GPU | 350 W | до 600 W, configurable |
FP8 | да | да |
FP4/NVFP4 Blackwell | нет соответствующих Blackwell-возможностей | да при поддержке стека |
MIG | нет | да |
Разница заметная. Но для выбора LLM-сервера наиболее интересны не CUDA cores и не поколение PCIe.
В первую очередь важны объём памяти и то, что мы собираемся в ней разместить.
96 GB — это не просто «модель в два раза больше»
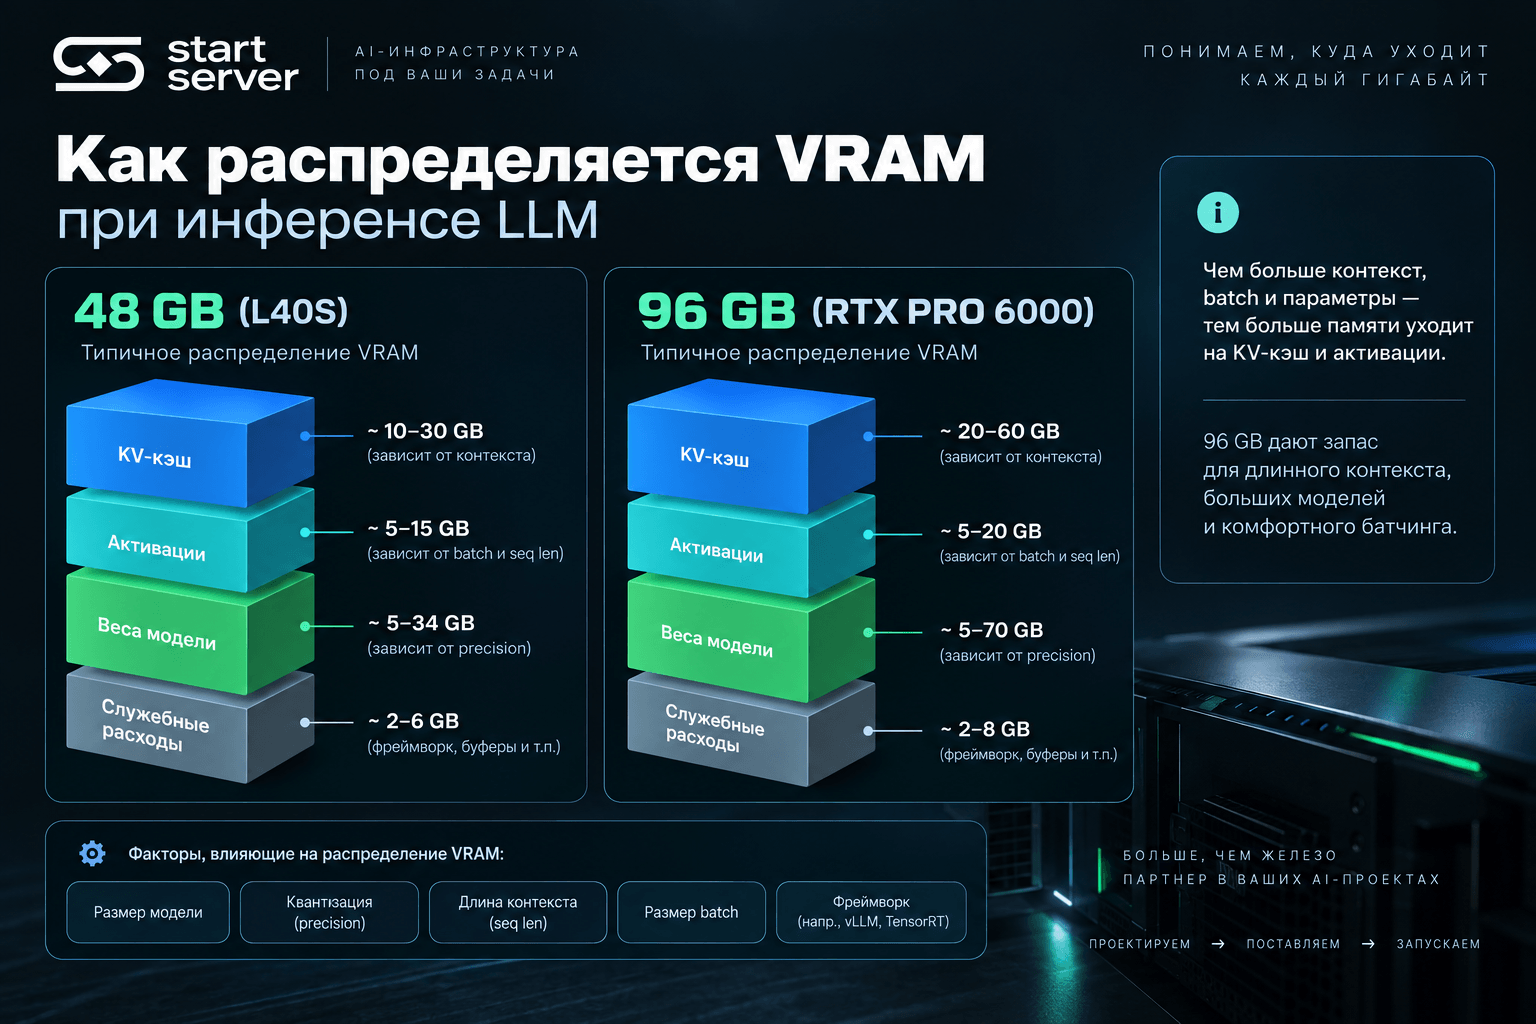
Во время инференса VRAM занята не только весами модели.
Упрощённо её бюджет приходится делить между несколькими составляющими:
веса модели + KV-cache + память inference engine и временные буферы + рабочий запас.
Точный состав зависит от архитектуры модели, формата весов и программного стека, поэтому превращать эту запись в универсальную формулу не нужно.
Зато весовую часть можно достаточно быстро оценить ещё до выбора сервера.
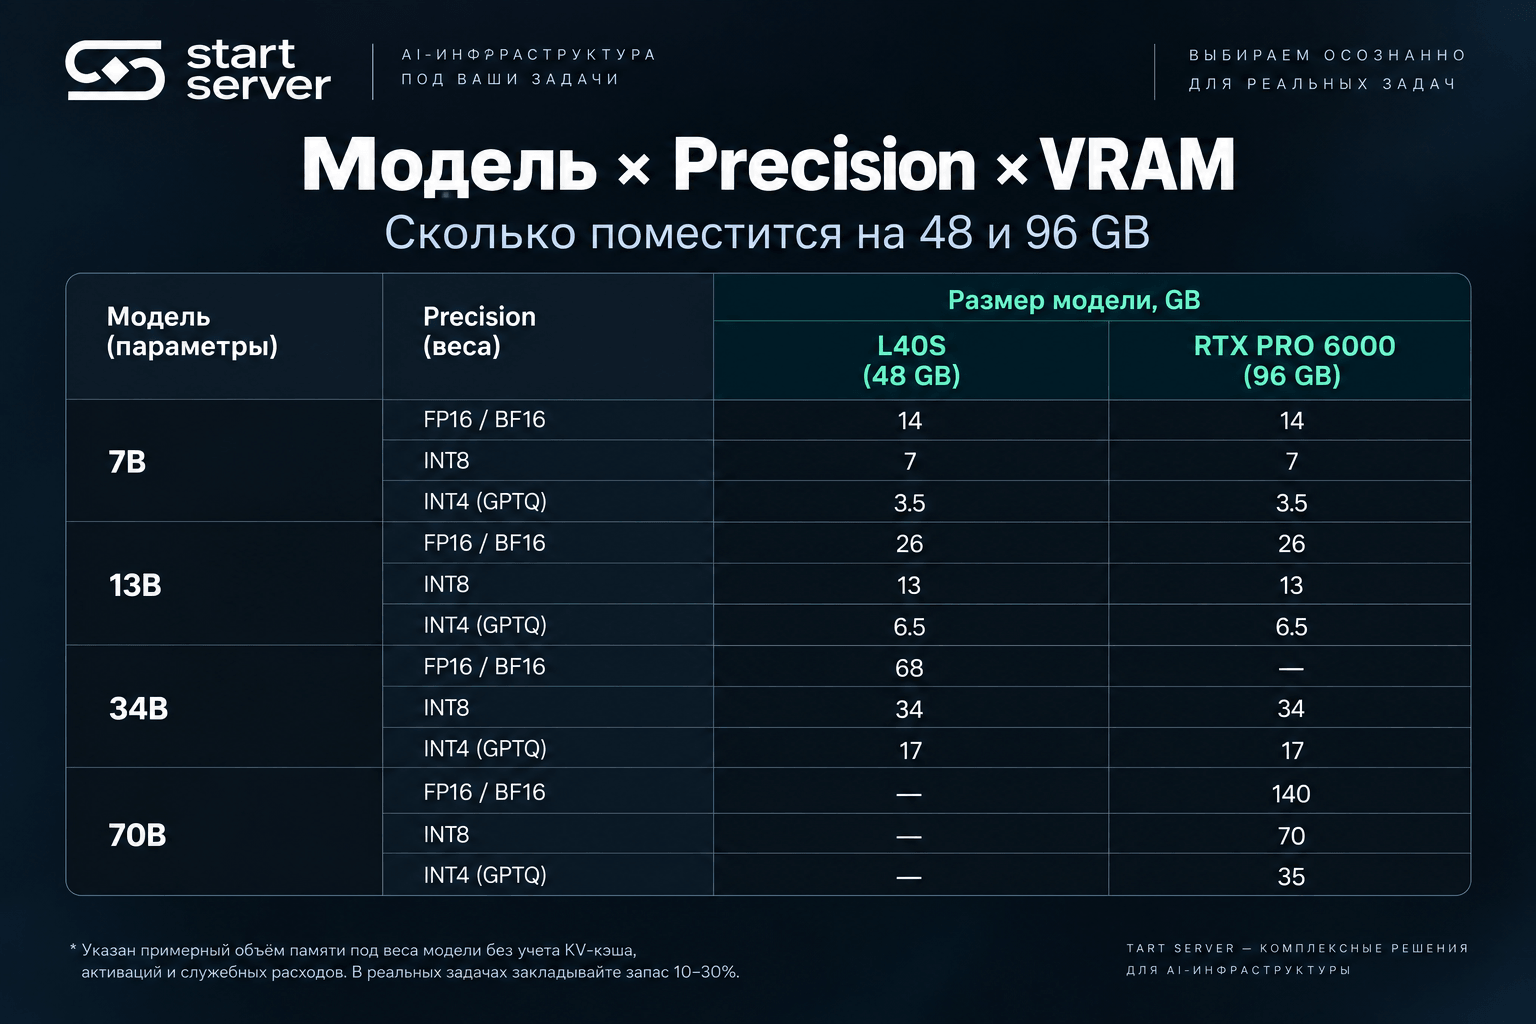
Сколько памяти требуют веса LLM
Для BF16 и FP16 полезный первый ориентир — около двух байт на параметр.
Hugging Face формулирует практическое правило именно так: модели с X миллиардами параметров требуется примерно 2 × X GB VRAM только для загрузки весов в BF16/FP16. Для 70B это около 140 GB.
Получается следующая предварительная картина:
Размер модели | BF16/FP16, только веса | Идеальная оценка 8 bit* | Идеальная оценка 4 bit* | L40S 48 GB | RTX PRO 6000 96 GB |
8B | ~16 GB | ~8 GB | ~4 GB | большой запас по весам | большой запас по весам |
14B | ~28 GB | ~14 GB | ~7 GB | помещается по весам | большой запас |
32B | ~64 GB | ~32 GB | ~16 GB | BF16 не помещается | BF16 помещается по весам |
70B | ~140 GB | ~70 GB | ~35 GB | BF16 и ~8 bit не помещаются | BF16 не помещается; ~8 bit помещается арифметически |
* Для 8- и 4-битных колонок это именно идеализированная битовая оценка. Она не равна гарантированному размеру конкретного quantized checkpoint.
Hugging Face, например, приводит для Llama 3.1 70B приблизительно 140 GB в FP16, 70 GB в FP8 и 35 GB в INT4 — и отдельно предупреждает, что эти цифры относятся к загрузке checkpoint и не включают другую память исполнения.
32B в BF16 — очень наглядная граница
Посчитаем только веса:
32 млрд × 2 байта ≈ 64 GB.
Для одной L40S с 48 GB вопрос заканчивается уже здесь: веса не помещаются.
У RTX PRO 6000 с 96 GB арифметически остаётся около 32 GB сверх весовой оценки.
Важно слово «арифметически».
Эти 32 GB нельзя заранее объявить свободной памятью для KV-cache. Сначала нужно знать реальную модель и посмотреть, сколько памяти занимает движок при конкретном запуске.
Но уже на этом этапе видно: 96 GB открывают однокарточный вариант, которого в BF16 на L40S просто нет.
Теперь 70B
Для BF16:
70 млрд × 2 байта ≈ 140 GB.
Ни на 48 GB L40S, ни на 96 GB RTX PRO 6000 такие веса целиком не помещаются.
А вот при условной 8-битной оценке:
70 млрд × 1 байт ≈ 70 GB.
На L40S снова нет.
На RTX PRO 6000 — по объёму весов уже возможно.
Но между фразами «веса арифметически занимают около 70 GB» и «эта 70B-модель нормально работает на одной RTX PRO 6000» лежит ещё довольно много инженерной работы.
Почему «4 bit = размер модели / 4» — опасное упрощение
Сама арифметика правильная. Проблема в том, что реальный формат модели состоит не только из идеального массива четырёхбитных значений.
У разных методов квантования есть собственные scales, metadata, группировка параметров и компоненты, которые могут храниться с другой точностью. Кроме того, память нужна самому runtime.
Поэтому для 70B получаются две разные формулировки.
Плохая:
70B в 4 bit занимает 35 GB и запускается на L40S.
Нормальная:
Для 70B идеальная 4-битная оценка весов составляет около 35 GB. Это попадает в диапазон 48 GB L40S, но реальную возможность запуска нужно проверять по конкретному checkpoint, движку и требуемому KV-cache.
Вторая версия менее эффектная. Зато она не заканчивается неожиданным CUDA out of memory после закупки сервера.
KV-cache: почему одна модель может требовать разное количество VRAM
Допустим, две компании используют один и тот же checkpoint.
В первой системе модель отвечает нескольким сотрудникам, а запросы короткие.
Во второй — это корпоративный AI-сервис с длинным контекстом и десятками одновременно активных запросов.
Память весов одинаковая.
Рабочие требования — нет.
Одна из причин — KV-cache. Inference engine сохраняет данные attention для уже обработанных токенов и затем использует их при генерации следующих. При увеличении объёма обрабатываемого контекста и количества одновременно обслуживаемых последовательностей растёт и потребность в памяти.
В vLLM KV-cache прямо выделен в самостоятельную конфигурацию: можно управлять его размером, dtype и долей GPU memory, доступной model executor. Документация также отмечает, что уменьшение числа одновременно обрабатываемых последовательностей сокращает потребность в KV-cache.
Поэтому вопрос:
Помещается ли файл модели в 48 GB?
для production-инференса слишком узкий.
Лучше спросить:
Помещается ли модель при нашей длине контекста и concurrency, причём с нормальным запасом памяти?
И вот здесь разница между 48 и 96 GB становится намного практичнее.
Где проходит граница 48 GB
Предварительно её можно представить так:
Сценарий | L40S 48 GB | RTX PRO 6000 96 GB | Что ещё проверить |
8B BF16 | большой запас по весам | большой запас | требуемые latency и throughput |
14B BF16 | веса помещаются | большой запас | context и concurrency |
32B BF16 | веса не помещаются | веса помещаются | KV-cache и runtime |
70B BF16 | не помещается | не помещается | multi-GPU или меньшая precision |
70B ~8 bit | веса не помещаются | возможно по весам | checkpoint, cache, runtime |
70B ~4 bit | возможно по весам | существенно больший запас | качество квантования и production-нагрузка |
Эта таблица специально не говорит «запускается».
Она отвечает только на первый вопрос — есть ли вообще смысл рассматривать одну такую GPU по объёму весов.
Когда 96 GB позволяют рассматривать одну GPU вместо двух
Вот сценарий, который часто важнее абстрактных процентов производительности.
Представим workload, которому с учётом модели и рабочей памяти нужно больше 48 GB, но меньше доступного бюджета 96-гигабайтной карты.
На L40S одна GPU отпадает. Придётся рассматривать как минимум несколько GPU, разделять модель и выбирать подходящий parallelism.
Если тот же workload укладывается на одной RTX PRO 6000 с нормальным запасом, архитектура становится другой.
Это потенциально означает меньше GPU на экземпляр модели, меньше меж-GPU взаимодействий и более простой deployment.
Но здесь нельзя автоматически делать второй скачок:
одна RTX PRO 6000 выгоднее двух L40S.
Для такого вывода нужны актуальные цены на готовые серверные конфигурации, требования по throughput, энергопотреблению и SLA.
Поэтому сравнивать надо не цену GPU в вакууме, а, например:
1 × RTX PRO 6000 против 2 × L40S для одной и той же целевой нагрузки.
И только потом считать экономику.
Насколько RTX PRO 6000 быстрее L40S в реальном inference
Единого процента нет.
Производительность меняется вместе с моделью, quantization, размером batch, длиной входа и выхода, concurrency и runtime.
Но есть полезные внешние измерения.
В 2026 году Dell опубликовала тестирование PowerEdge R7725. В стенде использовались Ubuntu 24.04, NVIDIA driver 590.48.01, CUDA 13.1 и TensorRT-LLM 1.3.0rc5. Тест включал 2000 запросов со средней длиной входа 2048 и выхода 256 токенов. Для RTX PRO 6000 GPU в этой системе power limit через iDRAC был установлен на 450 W при паспортном 600 W.
Для Llama 3.1 8B получили:
GPU | Precision | Throughput |
1 × L40S | FP8 | 1539,7 tokens/s |
1 × RTX PRO 6000 | FP8 | 2741,4 tokens/s |
1 × RTX PRO 6000 | NVFP4 | 3639,6 tokens/s |
При одинаковом FP8 RTX PRO 6000 в этом конкретном тесте дала примерно +78% throughput. Средняя latency для этих же FP8-конфигураций составила 3551,4 мс на L40S против 1746,6 мс на RTX PRO 6000.
Это сильный результат.
Но из него нельзя получить универсальную формулу:
RTX PRO 6000 = L40S × 1,78.
Даже в том же исследовании Dell на другой модели соотношение было другим. Например, для двух GPU и Nemotron 30B в FP8 прирост throughput составил 85%.
Benchmark имеет смысл только вместе с условиями.
Tokens/s тоже недостаточно
Для batch-обработки можно хотеть максимальный общий throughput.
Для корпоративного чат-бота пользователь в первую очередь замечает, сколько проходит времени до появления первого токена и насколько плавно идёт дальнейшая генерация.
Для большой системы становится критичным ещё и concurrency.
Поэтому при выборе inference-сервера разумнее смотреть сразу на несколько характеристик:
throughput, TTFT, inter-token latency, рабочую параллельность, допустимую длину контекста и запас VRAM.
А если используется квантование — ещё и на качество результата.
Высокие tokens/s перестают быть преимуществом, если выбранный режим ухудшает ответы модели сильнее, чем допустимо для задачи.
Когда L40S всё ещё рациональна
У RTX PRO 6000 практически по всем характеристикам спецификации больше возможностей. Это не означает, что любой новый сервер автоматически нужно строить именно на ней.
Возьмём 8B или 14B модель, которая с нужным context и concurrency уверенно помещается в L40S.
В этом случае 96 GB могут почти не влиять на архитектуру решения.
Дальше выбор определяется уже не объёмом памяти, а требуемой производительностью, ценой конфигурации, энергобюджетом площадки и перспективой роста нагрузки.
То же относится к существующим серверам на L40S. Если они обеспечивают нужный SLA, менять GPU только из-за появления Blackwell странно. Сначала полезно найти ограничение, которое обновление должно устранить.
Например:
У нас не хватает памяти при 32K контексте.
Это причина для пересчёта.
Вышла более новая карта.
Само по себе — нет.
Когда RTX PRO 6000 меняет решение
Самый очевидный случай — модель или рабочая нагрузка выходит за предел 48 GB.
Второй — веса помещаются, но при production-concurrency памяти под KV-cache уже мало.
Третий — workload действительно использует возможности Blackwell и NVFP4.
Четвёртый сценарий связан не с одной большой моделью, а, наоборот, с несколькими независимыми нагрузками.
RTX PRO 6000 поддерживает Multi-Instance GPU. NVIDIA указывает возможность создать до четырёх аппаратно изолированных MIG-инстансов. Для 96 GB RTX PRO 6000 доступны, в частности, профили 1g.24gb — до четырёх экземпляров, 2g.48gb — до двух и полный 4g.96gb.
L40S MIG не поддерживает.
Это может быть полезно, когда одну физическую GPU нужно разделить между несколькими командами или сервисами с аппаратной изоляцией ресурсов.
Но MIG — не способ получить четыре GPU из одной.
Compute и память исходной карты делятся между инстансами.
RTX PRO 6000 нельзя просто поставить вместо L40S в любой сервер
Ещё один частый источник ошибок — смотреть только на PCIe.
L40S рассчитана максимум на 350 W. Для RTX PRO 6000 Server Edition NVIDIA указывает максимальное потребление до 600 W.
Разница между паспортными максимумами составляет до 250 W на ускоритель.
В восьми-GPU конфигурации это уже до 2 кВт разницы именно между суммой максимальных power envelopes GPU.
Это не значит, что сервер постоянно потребляет дополнительные 2 кВт. Зато хорошо показывает, почему нельзя выбирать карту отдельно от платформы.
Нужно проверить конкретный server SKU: поддерживаемые GPU, допустимое их количество, питание, охлаждение, расположение слотов, BIOS/firmware и программный стек.
Показательный пример — уже упомянутый стенд Dell. PowerEdge R7725 был оснащён двумя блоками питания по 3200 W, а RTX PRO 6000 работали с ограничением 450 W на GPU через iDRAC.
То есть даже настоящий benchmark RTX PRO 6000 нужно читать вместе с параметрами сервера.
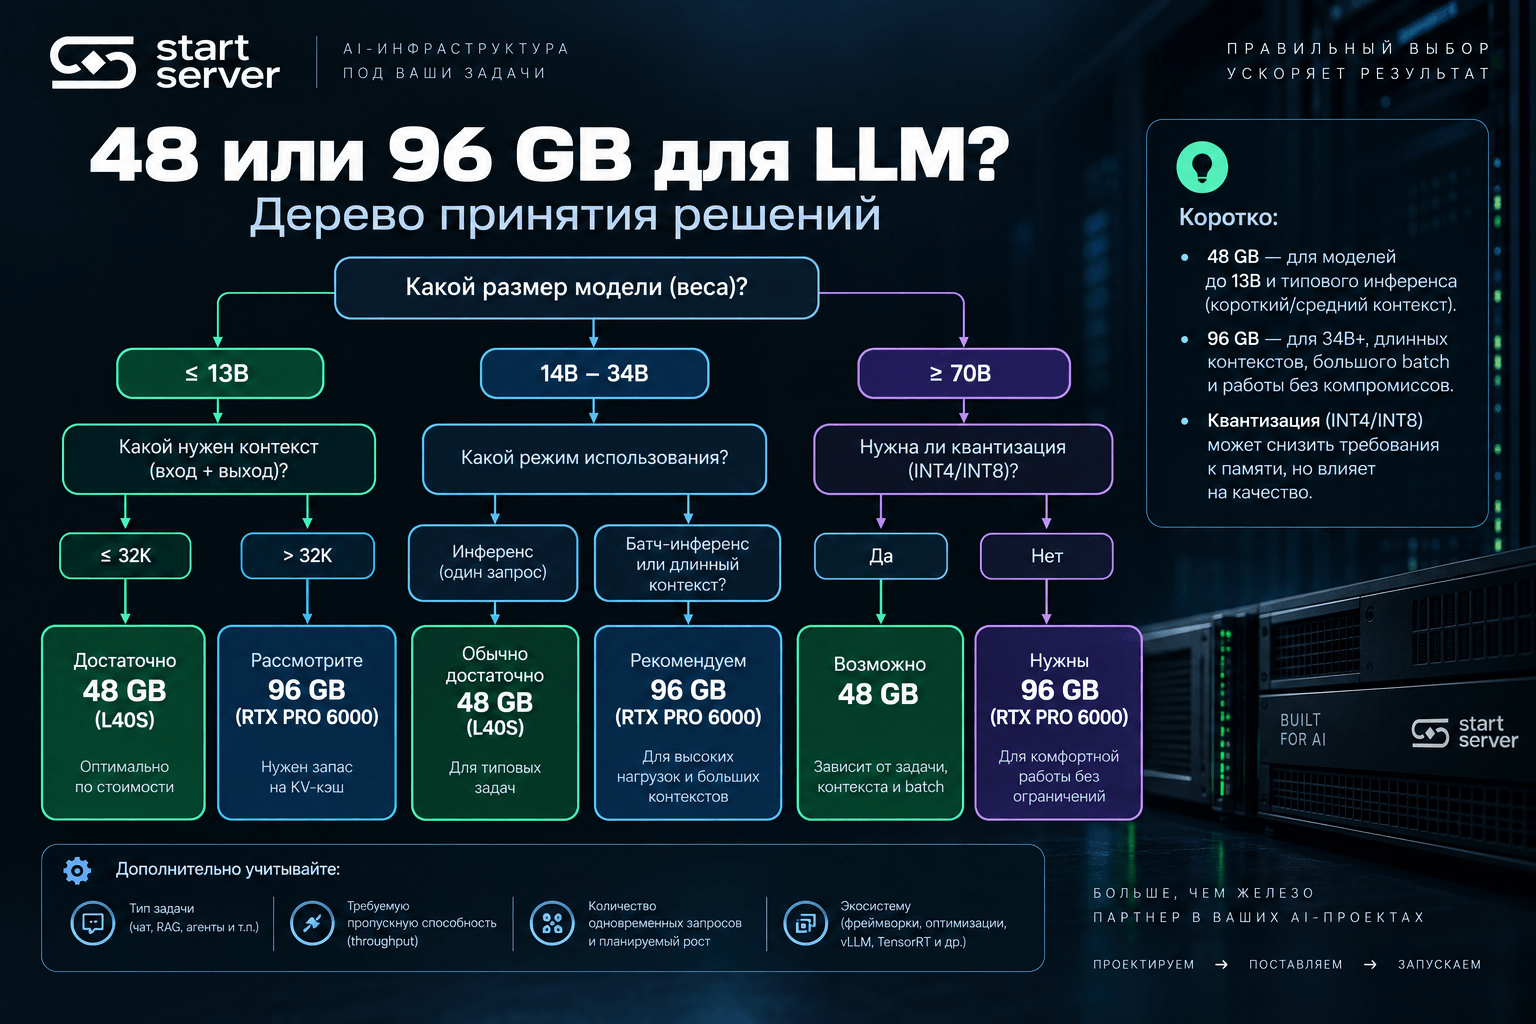
Как выбрать между L40S и RTX PRO 6000 без гадания
Сначала зафиксируйте конкретный checkpoint и precision. После этого оцените память весов.
Если уже этот расчёт выходит за 48 GB, становится понятно, почему L40S на одной GPU не подходит.
Если веса помещаются, добавьте реальные параметры нагрузки: длину контекста, concurrency, требуемый throughput и допустимую задержку.
И только после этого выбирайте количество GPU и сервер.
На практике порядок получается такой:
модель → precision → weights → context/concurrency → benchmark → GPU → сервер.
Если идти в обратную сторону — сначала выбрать «хорошую видеокарту», а потом пытаться понять, что на ней запускать, — шанс переплатить или получить неудобную конфигурацию заметно выше.
Итог: 48 или 96 GB?
RTX PRO 6000 Blackwell Server Edition технически существенно превосходит L40S по ёмкости и пропускной способности памяти и добавляет возможности Blackwell и MIG. В опубликованных тестах Dell она показывает заметный прирост производительности и при сопоставимой FP8-нагрузке.
Но правильный выбор начинается не с характеристики GPU.
Если workload уверенно укладывается в 48 GB и L40S обеспечивает требуемый SLA, дополнительные 48 GB могут не изменить архитектуру проекта.
RTX PRO 6000 особенно интересна там, где 48 GB уже заставляют идти на компромиссы: модель не помещается в нужной precision, не хватает памяти под KV-cache, приходится ограничивать concurrency или использовать несколько GPU только из-за ёмкости одной карты.
В таком случае сравнивать нужно уже не L40S и RTX PRO 6000 сами по себе.
Сравнивайте две готовые серверные конфигурации под один workload и один SLA.
Именно там обычно находится правильный ответ.
Подбор GPU-сервера под вашу LLM
Если выбираете между L40S и RTX PRO 6000, для расчёта достаточно начать с пяти параметров: точный model ID или checkpoint, precision/quantization, рабочая длина контекста, ожидаемое число одновременных запросов и требование по задержке.
По этим данным можно сравнить необходимый объём VRAM, количество GPU и серверную платформу под одну и ту же нагрузку — вместо выбора оборудования только по таблице характеристик.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


