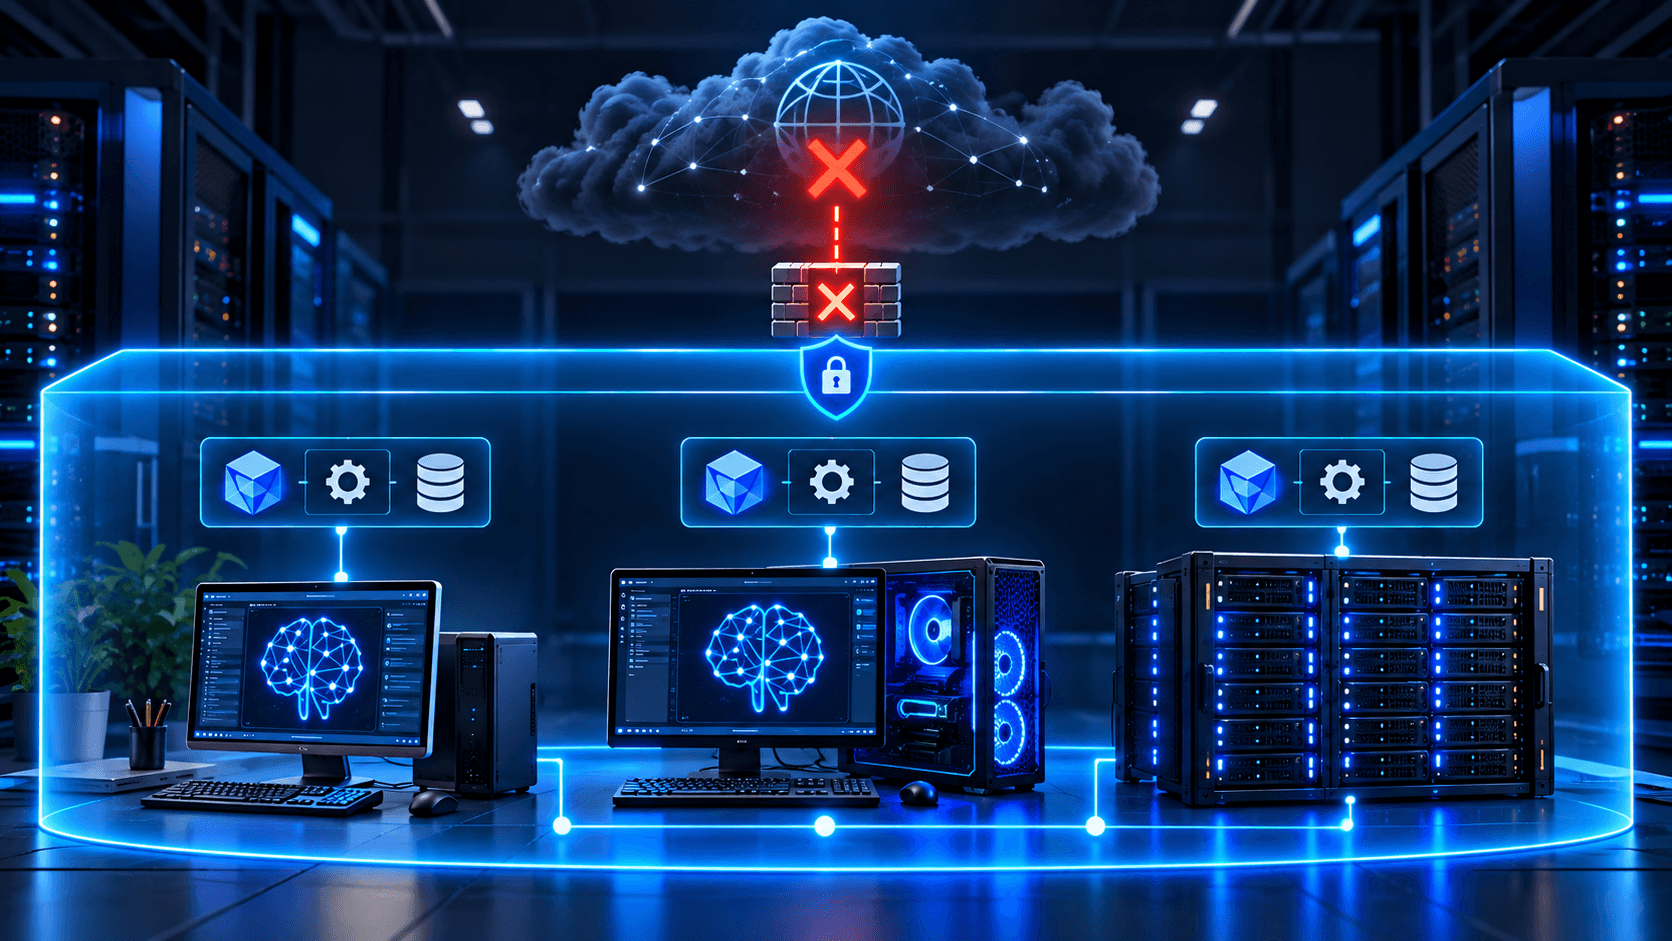
Локальная нейросеть может работать без интернета, если модель, программа запуска, драйверы и все зависимости заранее сохранены на компьютере или сервере. Во время инференса вычисления выполняются на CPU, GPU или другом локальном ускорителе, а запросы не обязаны уходить во внешний API.
Для первого запуска обычно нужен интернет, чтобы скачать приложение и файлы модели. В изолированный контур их можно перенести с подготовленной станции через проверенный носитель или внутренний репозиторий. После этого текстовый помощник, генератор изображений, распознавание речи, компьютерное зрение и локальный RAG способны работать офлайн.
Сначала нужно решить, что именно требуется:
личный чат на одном ПК;
генерация изображений или обработка фото;
помощник для программирования;
поиск и ответы по локальным документам;
распознавание и перевод речи;
общий AI-сервис для сотрудников;
полностью изолированная система без маршрута в интернет.
Что такое локальная нейросеть
Локальной называют модель, инференс которой выполняется на устройстве пользователя или на сервере организации. Веса модели загружаются с локального диска в оперативную память или видеопамять, а программа вычисляет ответ на собственном оборудовании.
Полный стек выглядит так:
интерфейс или приложение -> runtime -> модель и tokenizer -> CPU, GPU или NPU -> локальные данные
В эту схему могут добавляться embedding-модель, векторная база, reranker, инструменты, журналирование и API. Если хотя бы один обязательный компонент обращается к внешнему облаку, весь процесс уже нельзя считать полностью офлайн.
Локальный запуск не означает обучение модели с нуля. Чаще пользователь скачивает готовые веса, иногда применяет квантование или адаптер, а затем выполняет инференс. Обучение локальной нейросети, fine-tuning и создание новой модели предъявляют другие требования к данным, памяти и вычислениям.
Если нужно понять, что находится внутри текстовой модели, начните с материала как работает большая языковая модель. Здесь основной вопрос практический: как разместить модель в собственном контуре и не зависеть от интернета во время работы.
Локально, офлайн, приватно и в закрытом контуре: в чем разница
Эти понятия описывают разные свойства системы.
Режим | Где выполняется модель | Может ли программа обращаться наружу | Что нужно проверить |
|---|---|---|---|
Локальный запуск | на ПК или своем сервере | да, если включены обновления, облачные модели, поиск или телеметрия | сетевые настройки каждого компонента |
Офлайн-режим | на локальном устройстве | рабочий процесс не требует интернета | все файлы и зависимости загружены заранее |
Приватный контур | внутри инфраструктуры организации | только по разрешенным маршрутам и политикам | доступ, логи, шифрование, интеграции и хранение данных |
Air gap | в физически изолированной среде | сетевого маршрута в интернет нет | контролируемый перенос файлов, обновления и аудит |
Программа может запускать модель локально, но обращаться к сайту за каталогом моделей или обновлениями. Агент может использовать локальную LLM, а поиск выполнять через облачный API. Интерфейс может сохранять запросы в сторонней аналитике. Поэтому надпись local не является доказательством приватности.
Какие нейросети работают без интернета
Офлайн может работать модель, для которой доступны локальные веса и совместимый runtime. Точный список меняется быстрее, чем требования к архитектуре, поэтому надежнее выбирать по задаче и официальной карточке модели.
Задача | Что запускается локально | Что потребуется дополнительно |
|---|---|---|
Текст и диалог | LLM семейств Qwen, Llama, Gemma, Mistral, DeepSeek и другие модели с доступными весами | tokenizer, шаблон чата, runtime, память под контекст |
Программирование | специализированная code model или универсальная LLM | доступ к репозиторию, индекс кода, безопасные инструменты |
Документы и RAG | LLM, embeddings, vector database, parser, иногда reranker | локальный индекс, правила доступа и ссылки на источники |
Генерация изображений | diffusion или flow model | VAE, text encoder, workflow, иногда дополнительные модели |
Редактирование фото | image model, inpainting, upscaler, control modules | совместимый граф и локальные checkpoints |
Видео и 3D | video или 3D generation pipeline | больше памяти, места на диске и времени обработки |
Распознавание речи | ASR-модель, например Whisper | аудиодекодер, локальный checkpoint |
Озвучка и музыка | TTS или audio generation model | голосовые модели, vocoder, проверка лицензии |
Компьютерное зрение | детектор, классификатор, OCR или segmenter | декодирование видео, камеры, pipeline предобработки |
Для генерации картинок на локальном устройстве часто используют ComfyUI. Его официальная документация описывает открытый node-based интерфейс, который запускается на собственном компьютере. Для речи официальный репозиторий Whisper предоставляет код и checkpoints нескольких размеров. В обоих случаях сначала нужно подготовить модель и зависимости.
Локальная видео-нейросеть обычно тяжелее текстового чата или генератора одного изображения. Видеоряд содержит много кадров, а генеративная модель должна хранить дополнительные состояния. Возможность запуска определяется конкретным workflow, разрешением, числом кадров, precision, offload и доступной памятью.
Какая локальная нейросеть лучше
Рейтинг по одному названию быстро устаревает. Семейства Qwen, Llama, Gemma, Mistral и DeepSeek выпускаются в разных размерах, вариантах, форматах и лицензиях. Модель, которая хорошо пишет код, может хуже работать с длинным русским документом. Более крупная модель способна отвечать медленнее и не помещаться в доступную память.
Сравнивайте кандидатов по семи критериям:
Задача: диалог, код, извлечение фактов, изображение, речь или другой pipeline.
Язык: проверьте русский на собственном наборе вопросов, а не по названию модели.
Лицензия: разрешены ли коммерческое использование, модификация и внутреннее распространение.
Формат: поддерживает ли runtime GGUF, Safetensors или другой checkpoint.
Память: помещаются ли веса, контекст и рабочие буферы.
Качество: точность, галлюцинации, следование инструкции, код или визуальный результат.
Скорость: time to first token, tokens per second, время генерации, latency и параллельность.
Лучшие локальные нейросети 2026 года для конкретной организации определяются тестом. Соберите 30-100 реальных задач, заранее опишите критерии правильности и сравните модели при одинаковых настройках. Публичный benchmark полезен для отбора кандидатов, но не заменяет проверку на ваших документах, языке и аппаратуре.
Что значит модель без цензуры или ограничений
Локальный владелец контролирует system prompt, guardrails и доступные инструменты, но это не отменяет лицензию, закон, права на данные и внутреннюю политику. Модель с ослабленными ограничениями может чаще генерировать опасный код, недопустимый контент или уверенные ошибочные инструкции.
Что нужно скачать для работы без интернета
Файл весов является только одной частью. Для устойчивого офлайн-запуска подготовьте комплект:
приложение или runtime нужной версии;
точный checkpoint модели;
tokenizer, config и chat template;
драйвер GPU и необходимые runtime-библиотеки;
Python wheels, контейнеры или системные пакеты;
embedding-модель и reranker, если используется RAG;
локальный интерфейс или API;
лицензии, model card и список ограничений;
контрольные суммы и сведения о происхождении файлов;
тестовые запросы и инструкция восстановления.
LM Studio официально поддерживает офлайн-чат, работу с документами и локальный сервер после загрузки моделей и runtimes. Поиск и скачивание моделей, загрузка runtimes и проверка обновлений требуют соединения. Это разделение описано в документации LM Studio об офлайн-работе.
Hugging Face Transformers также поддерживает изолированный запуск. Модель и файлы нужно заранее сохранить в cache или локальный каталог, после чего включить offline mode либо использовать local_files_only. Порядок приведен в официальной инструкции Transformers.
Безопасность загружаемой модели
Скачивайте файлы из официального репозитория автора или проверенного registry. Зафиксируйте точную revision или commit, хэш, лицензию и model card. Не запускайте случайные install scripts и custom code с правами администратора.
Особенно осторожно обращайтесь с pickle checkpoints. Документация Hugging Face предупреждает, что десериализация pickle может выполнять произвольный код. Safetensors создан как более безопасный формат для тензоров, но сам формат весов не проверяет код приложения, custom nodes и зависимости.
Для закрытого контура полезен внутренний registry. В него после проверки помещают одобренные модели, контейнеры и пакеты. Пользовательские рабочие места получают артефакты из этого registry, а не скачивают случайные сборки напрямую.
Сколько RAM и VRAM нужно локальной нейросети
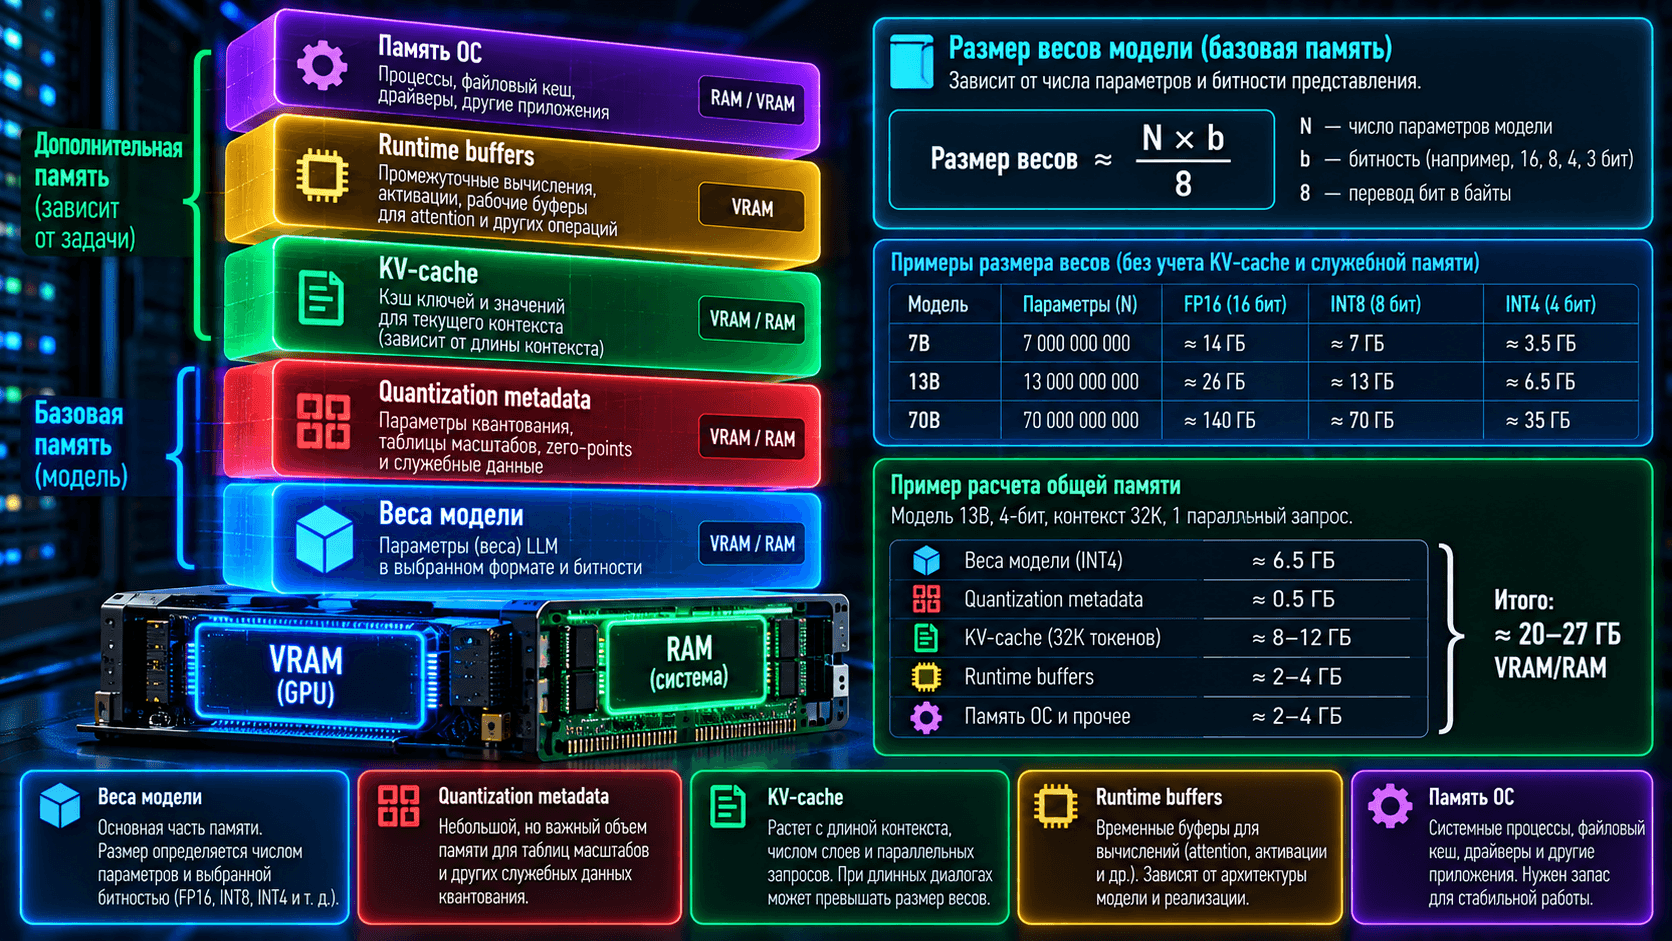
Первую оценку памяти для весов можно получить по формуле:
память весов = число параметров x бит на параметр / 8
Примерные нижние оценки без служебных данных:
Размер модели | FP16, 16 бит | 8 бит | 4 бита |
|---|---|---|---|
3 млрд параметров | 6 ГБ | 3 ГБ | 1,5 ГБ |
8 млрд параметров | 16 ГБ | 8 ГБ | 4 ГБ |
32 млрд параметров | 64 ГБ | 32 ГБ | 16 ГБ |
70 млрд параметров | 140 ГБ | 70 ГБ | 35 ГБ |
Это арифметика весов, а не готовое требование к видеокарте. Формат квантования хранит scales и metadata, runtime создает буферы, операционная система использует часть RAM, а LLM выделяет KV-cache под контекст и параллельные запросы. Поэтому файл модели размером 16 ГБ не гарантирует запуск в 16 ГБ VRAM.
Можно ли работать только на CPU
Да, некоторые текстовые, speech и vision models выполняются на CPU. Веса размещаются в системной RAM, а скорость зависит от процессора, memory bandwidth, числа потоков, формата и реализации. CPU полезен для проверки, редких запросов и локальных нейросетей для слабых ПК, если длительное ожидание приемлемо.
GPU дает большую параллельную вычислительную мощность и обычно сокращает время ответа. Первое ограничение часто связано с VRAM. При частичном offload часть слоев находится на GPU, часть в RAM. Это позволяет запустить более крупную модель, но обмен через системную шину способен снизить скорость.
Сколько места нужно на диске
Учитывайте не один checkpoint, а все варианты модели, cache загрузчика, runtimes, контейнеры, embedding models, индексы документов и результаты генерации. NVMe уменьшает время загрузки крупных моделей и обработки локальных данных, но не заменяет RAM или VRAM во время активного инференса.
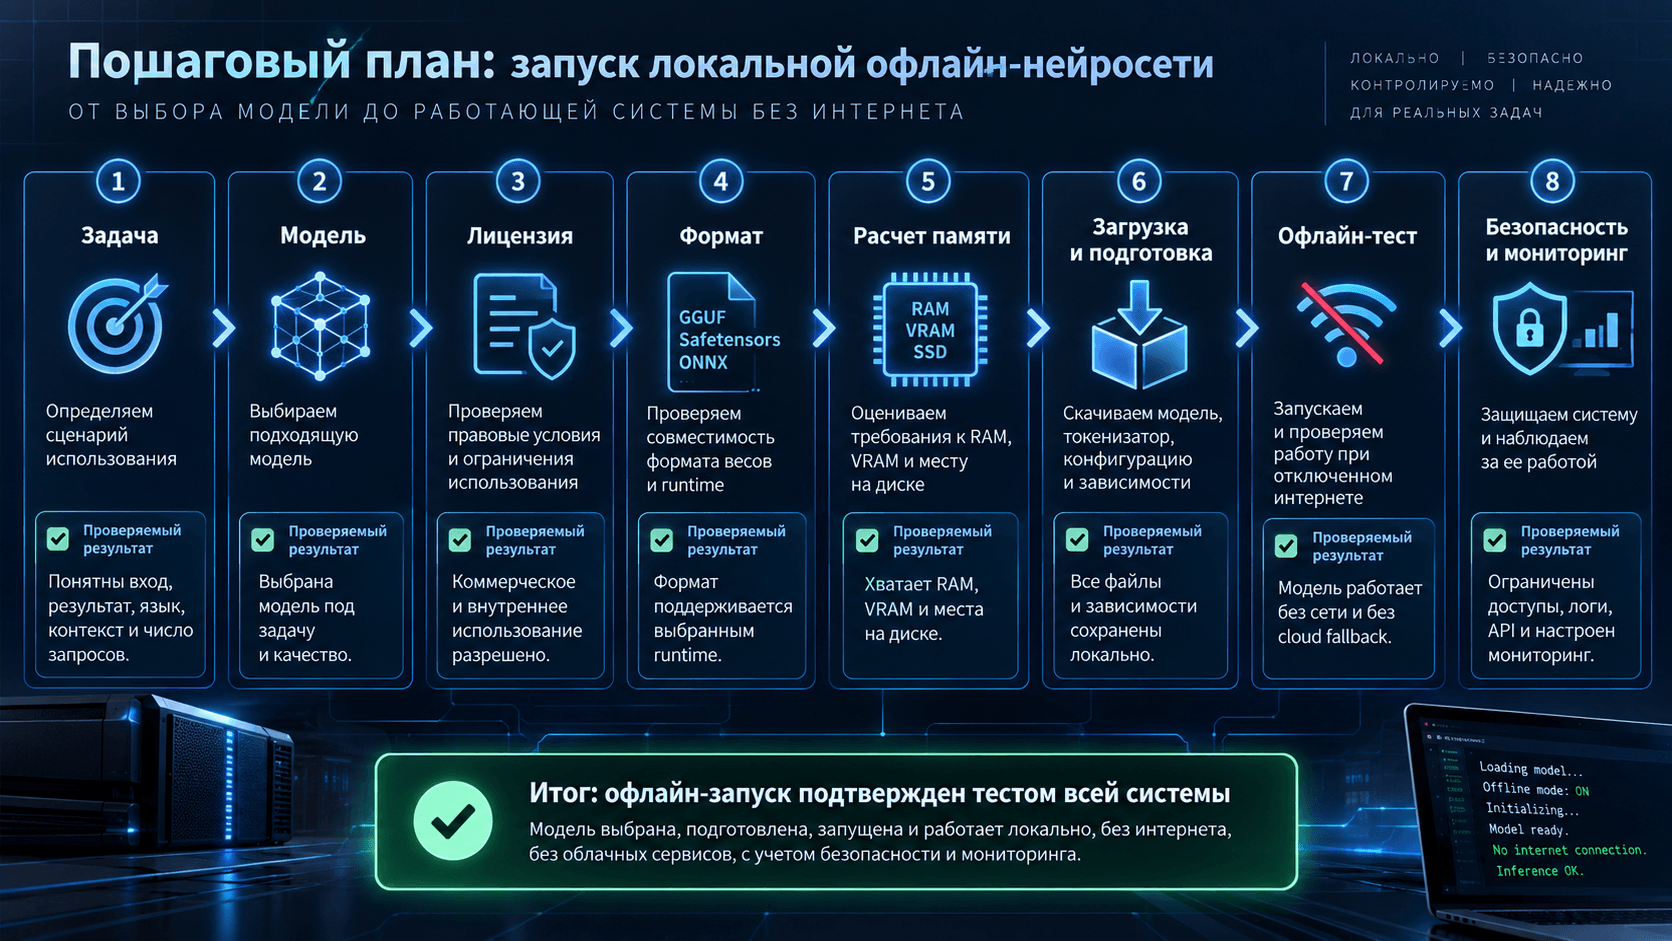
Как запустить локальную нейросеть на ПК
Ниже приведен общий порядок. Конкретные кнопки и команды меняются между версиями, поэтому установочные файлы и документацию берите у разработчика.
Шаг 1. Определите задачу
Не начинайте с рейтинга моделей. Запишите:
что поступает на вход;
какой результат нужен;
требуется ли русский язык;
какой максимальный контекст нужен;
сколько запросов выполняется одновременно;
допустимо ли ожидание;
должен ли компьютер быть полностью отключен от сети.
Для текста выберите 10-20 контрольных prompts. Для изображений сохраните одинаковые prompts, seed, разрешение и workflow. Для речи подготовьте записи с реальным шумом и акцентами.
Шаг 2. Проверьте компьютер
Запишите модель CPU, объем RAM, модель GPU, VRAM, свободное место на диске и операционную систему. На macOS с Apple Silicon приложения могут использовать unified memory, но доступный объем делят система, CPU и GPU. На ПК с дискретной видеокартой системная RAM и VRAM являются отдельными пулами.
Шаг 3. Выберите приложение
Для текстовой модели есть три типовых пути.
Путь | Кому подходит | Особенности |
|---|---|---|
Desktop-приложение, например LM Studio | пользователю без разработки | поиск моделей, чат, документы и локальный API в одном интерфейсе |
Runtime и CLI, например Ollama или llama.cpp | разработчику и локальной интеграции | API, автоматизация, контроль формата и параметров |
Python и Hugging Face | исследованию, custom pipeline и fine-tuning | больше контроля, но нужно подготовить окружение и зависимости |
Для графических моделей применяют ComfyUI и другие совместимые приложения. Для каждой программы проверьте официальную поддержку вашей ОС и ускорителя.
Шаг 4. Выберите и скачайте модель
Сопоставьте размер файла с доступной памятью. Проверьте язык, лицензию, формат, context limit и шаблон чата. Скачайте все shards и вспомогательные файлы. Если модель загружается через приложение, найдите каталог хранения и убедитесь, что файлы доступны после перезагрузки.
llama.cpp использует модели в GGUF. Hugging Face pipelines часто работают с Safetensors и конфигурационными файлами. Название семейства без формата недостаточно: одна и та же модель может иметь несколько квантований, несовместимых с выбранным runtime или дающих разное качество.
Шаг 5. Выполните первый запуск с интернетом
Запустите контрольные prompts и проверьте, что вычисления идут на ожидаемом CPU или GPU. Сохраните версии приложения, runtime, драйвера и модели. Для Ollama практическая последовательность выглядит так:
ollama pull <имя-локальной-модели>
ollama run <имя-локальной-модели>
Команда pull требует доступ к registry. После загрузки локальная модель вызывается через локальный сервер. Актуальная документация Ollama API разделяет локальный endpoint и прямой cloud endpoint. Для строгого офлайн-режима отключите cloud features и не выбирайте cloud model.
Шаг 6. Проверьте работу без интернета
Отключите Wi-Fi и кабель либо запретите внешние соединения межсетевым экраном. Перезагрузите приложение и повторите тест. Проверьте:
модель открывается после холодного старта;
prompt обрабатывается без паузы на скачивание;
локальные документы доступны;
UI не переключается на облачный backend;
в сетевом журнале нет исходящих соединений;
локальный API слушает только нужный интерфейс;
после перезагрузки результат воспроизводится.
Такой тест надежнее обещания работает локально на странице приложения.
Как установить нейросеть в полностью изолированный контур
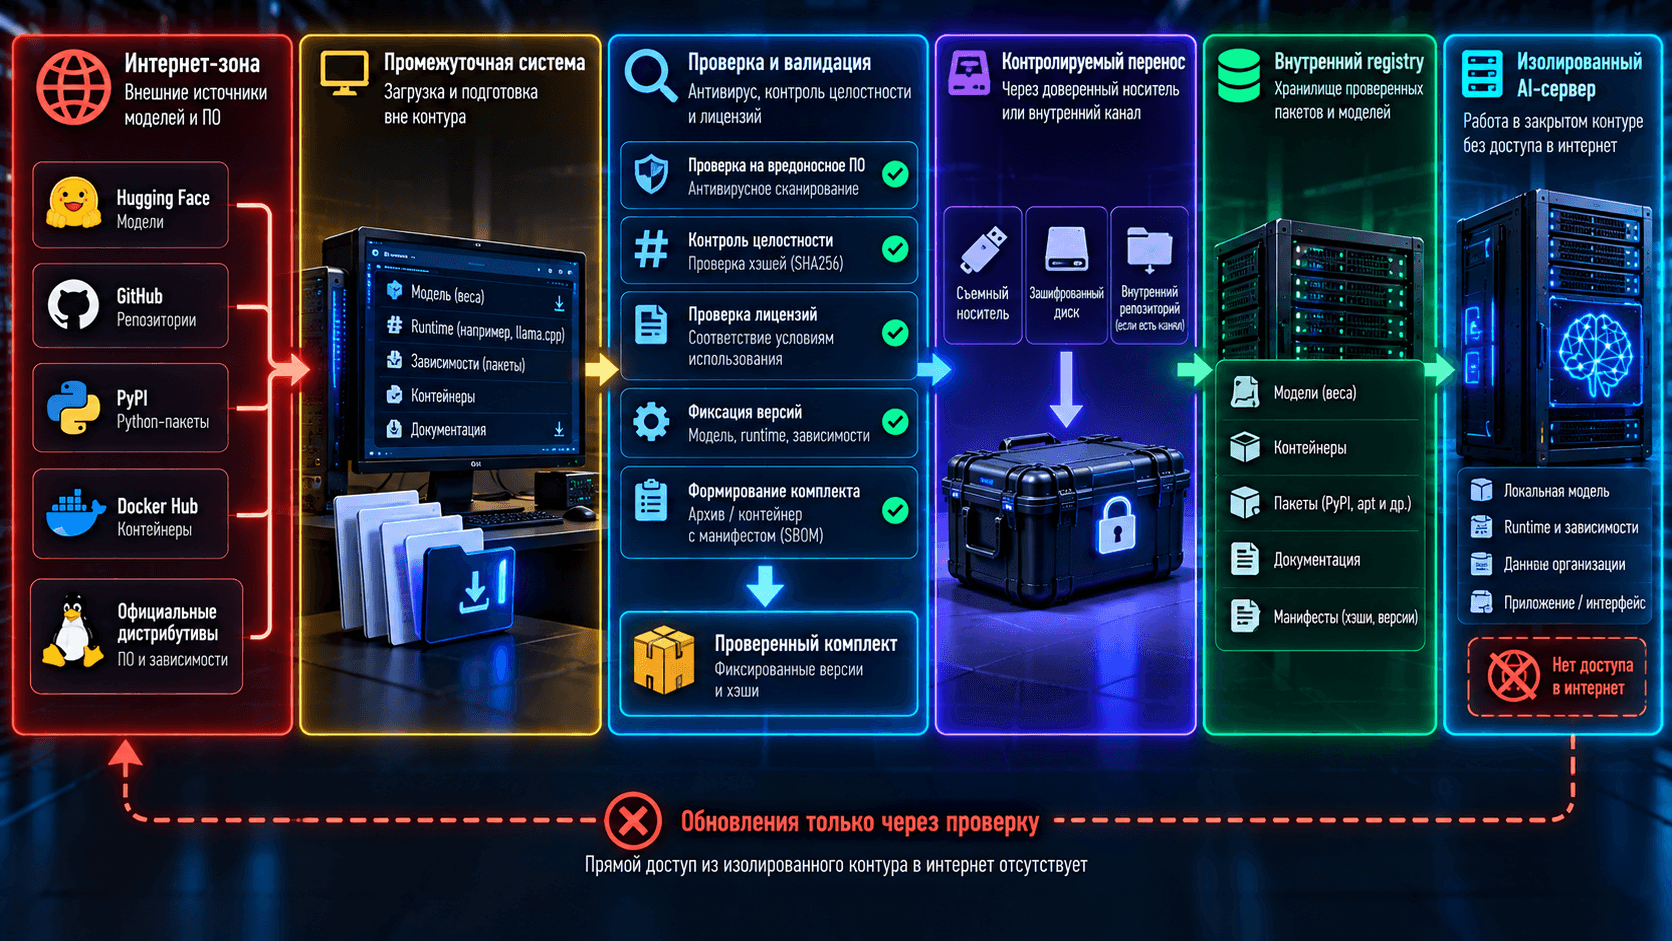
Air-gapped установка начинается на отдельной staging-системе с интернетом. На ней скачивают и проверяют артефакты, затем переносят их в закрытую среду.
Минимальный процесс:
Утвердить список моделей, пакетов, контейнеров и лицензий.
Скачать точные версии и все транзитивные зависимости.
Проверить происхождение, хэши, цифровые подписи и отчеты сканирования.
Сформировать manifest и software bill of materials.
Перенести комплект через контролируемый носитель или шлюз.
Импортировать артефакты во внутренний registry.
Установить без обращения к внешним репозиториям.
Запретить egress и выполнить приемочный тест.
Описать процесс обновления и отката.
Если Python при установке пытается получить недостающий wheel, а контейнер обращается к внешнему registry, комплект не является автономным. То же относится к tokenizer, embedding model, custom nodes, шрифтам и дополнительным checkpoints.
Локальная нейросеть для документов и RAG
Одна LLM отвечает из знаний, полученных при обучении, и контекста prompt. Без интернета она не узнает свежие факты автоматически. Подключить внутренние документы позволяет RAG, или retrieval-augmented generation.
Полностью локальный RAG включает:
документы -> parser -> chunks -> embeddings -> vector database -> retrieval -> локальная LLM -> ответ со ссылками
Каждый блок должен находиться внутри контура. Если embeddings вычисляет внешний API, документы или их фрагменты уходят наружу, даже когда финальная LLM локальна.
RAG не делает ответ гарантированно верным. Нужно измерять качество извлечения, наличие нужного фрагмента, корректность цитаты и итоговый ответ. Также требуется разграничить документы по пользователям. Общий индекс без ACL способен показать сотруднику данные, к которым у него нет доступа.
Для пилота можно использовать локальную работу с документами в LM Studio. Для общего сервиса нужны ingestion, индексация, versioning, vector database, мониторинг и резервное копирование. Полный состав проверяется по методике аудита спецификации RAG-сервера, а подходящие аппаратные классы собраны в категории RAG-систем.
Локальная нейросеть на телефоне
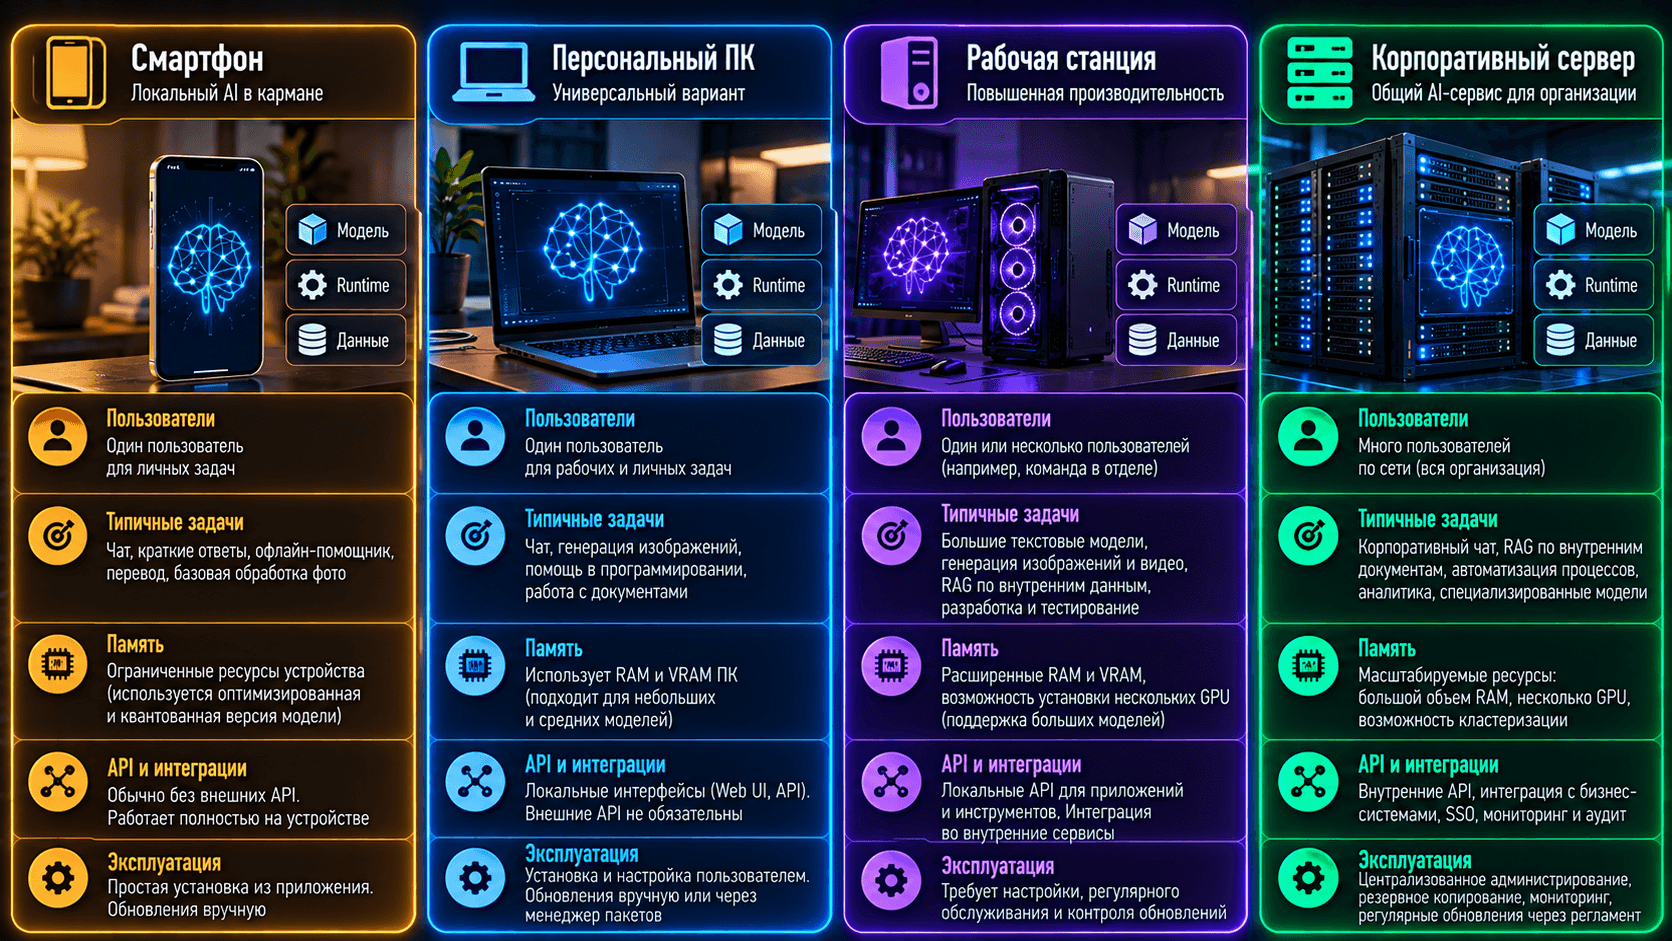
Нейросеть без интернета на Android или iPhone возможна, если приложение действительно хранит модель на устройстве и поддерживает on-device inference. Из-за ограничений памяти, охлаждения и батареи смартфоны обычно используют компактные и квантованные модели.
Перед загрузкой проверьте:
скачивается ли полный checkpoint или приложение является клиентом облака;
сколько места занимает модель;
поддерживается ли ваш процессор, GPU или NPU;
работает ли чат в авиарежиме после перезапуска;
где хранится история запросов;
есть ли облачный fallback;
как удаляются модель и данные.
Фраза нейросеть без интернета на телефон скачать часто ведет к приложениям, которые требуют соединения после установки. Тест в авиарежиме является обязательным. Производительность и нагрев проверяют на задаче реальной длины, а не по одному короткому ответу.
Локальная нейросеть на сервере
Один пользователь может запускать модель в desktop-приложении. Для отдела или компании нужен сервис с API, очередью запросов, аутентификацией, логами и мониторингом.
Архитектура общего сервиса включает:
один или несколько inference workers;
model server и scheduler;
API gateway с аутентификацией и rate limits;
локальный model registry;
хранилище prompts и логов по политике организации;
мониторинг latency, throughput, очереди, RAM, VRAM и ошибок;
RAG-компоненты, если нужны документы;
резервное копирование конфигураций и индексов.
Число сотрудников не определяет конфигурацию. Нужны размер модели, context length, длина ответа, одновременные запросы, целевая задержка и режим работы. Десять пользователей с длинными документами могут создать большую нагрузку, чем сто сотрудников с редкими короткими вопросами.
Категория серверов для production-инференса LLM показывает многопользовательский класс систем. Для небольших команд возможны компактные узлы. Например, ASUS Ascent GX10 с 128 ГБ общей памяти и GMKtec EVO-X2 с 128 ГБ памяти иллюстрируют два варианта компактной локальной платформы. Их нельзя сравнивать только по объему памяти: отличаются архитектура, ускоритель, bandwidth, software support и режим эксплуатации.
Локальный сервер или облако
Локальное оборудование дает контроль над данными, версией модели и доступной емкостью. Владелец также берет на себя закупку, настройку, обновления, резервирование и поддержку. Облако быстрее для короткого пилота и переменной нагрузки, но зависит от внешнего сервиса и его условий.
Сравнивайте варианты по одинаковому workload и уровню сервиса. Методика дана в статье как посчитать TCO локального GPU-сервера и облака.
В проекте частного AI-кластера для корпоративного LLM и RAG вычислительные GPU-узлы, NVMe СХД, сеть, серверы управления и программное окружение были объединены в закрытую инфраструктуру без передачи корпоративных данных во внешнее облако. Это пример серверного масштаба, а не требование для каждого локального запуска.
Безопасность локальной нейросети
Офлайн-режим сокращает внешнюю передачу данных, но не устраняет остальные риски.
Не открывайте локальный API без защиты
Localhost доступен с одного компьютера. Для общего доступа сервис начинают слушать на сетевом интерфейсе, и тогда нужны аутентификация, TLS, firewall, сегментация и журналирование. Локальные API некоторых runtimes по умолчанию не требуют ключа. Такой endpoint нельзя публиковать в интернет напрямую.
Ограничьте инструменты агента
Модель, которой дали полный доступ к компьютеру, может читать файлы, запускать команды и обращаться к сервисам от имени пользователя. Prompt injection способен превратить документ или страницу в вредоносную инструкцию. Разрешайте минимальный набор действий, запускайте инструменты в sandbox и требуйте подтверждение для изменений.
Не доверяйте ответу только потому, что модель локальна
Локальная LLM тоже галлюцинирует. Она может ошибаться в коде, фактах и расчетах. Для критичных задач нужны источники, проверка правил, тесты и участие специалиста.
Управляйте журналами и данными
Определите, где хранятся prompts, ответы, документы, embeddings и debug logs. Настройте сроки хранения, шифрование, резервное копирование и удаление. Если разные подразделения используют один сервис, примените разграничение доступа.
Обновляйте контролируемо
Закрытый контур не должен навсегда оставаться на уязвимой версии. Подготовьте периодический выпуск обновлений через staging, проверку, тест совместимости и откат. Фиксируйте model revision, container digest, driver и конфигурацию.
Как проверить качество и производительность
Локальный запуск считается успешным, когда модель выполняет целевую задачу с приемлемым качеством и скоростью, а не только открывает окно чата.
Для текстовой модели измеряйте:
долю правильных ответов на контрольном наборе;
наличие ссылок на документы при RAG;
time to first token;
скорость генерации;
latency полного ответа;
число параллельных запросов;
загрузку CPU и GPU;
RAM, VRAM, температуру и потребление;
ошибки и стабильность длительного теста.
Для изображений фиксируйте модель, workflow, seed, разрешение, steps, precision и время генерации. Для речи сохраняйте язык, длительность аудио, шум, real-time factor и качество расшифровки.
Типичные ошибки
Скачать слишком крупную модель
Число параметров не равно качеству конкретной задачи. Если веса и контекст не помещаются, система уходит в медленный offload или не запускается. Начните с меньшего кандидата и измерьте качество.
Путать локальную модель с актуальным поиском
Офлайн LLM не получает свежие сведения из интернета. Добавьте проверенную локальную базу знаний или контролируемый поиск, если задача требует новых данных.
Считать бесплатную модель бесплатной системой
Веса могут распространяться без платы, но остаются расходы на оборудование, электричество, хранение, внедрение и поддержку. Лицензия также может ограничивать коммерческое применение.
Скачивать неизвестные сборки
Случайный installer, custom node или pickle checkpoint способен выполнить код. Используйте доверенные репозитории, фиксированные revisions и сканирование.
Давать агенту полный доступ к ПК
Генерация текста и выполнение команд являются разными уровнями риска. Инструменты, файловую систему и учетные данные нужно изолировать.
Проверять офлайн-режим только выключением окна браузера
Приложение может обращаться к сети в фоне. Нужны firewall или физическое отключение, перезапуск и просмотр сетевого журнала.
Чек-лист перед запуском
задача и контрольный набор описаны;
выбрана модель с подходящим языком и лицензией;
формат поддерживается выбранным runtime;
веса, tokenizer, config и зависимости сохранены локально;
RAM и VRAM рассчитаны вместе с контекстом и буферами;
на диске есть место для моделей, cache, индексов и результатов;
источник файлов, revision и хэши зафиксированы;
cloud model и автоматический fallback отключены;
локальный API не открыт наружу без аутентификации;
документы, embeddings и логи остаются в нужном контуре;
инструменты агента ограничены;
выполнен тест после перезагрузки без интернета;
измерены качество, latency и потребление памяти;
подготовлены обновление, backup и откат.
Частые вопросы
Может ли нейросеть работать без интернета?
Да. Для этого модель, runtime, драйверы и зависимости должны находиться на устройстве. Облачный поиск, внешние API и автоматические обновления работать не будут.
Какая нейросеть работает без интернета?
Любая совместимая модель с доступными локальными весами и runtime. Для текста используют семейства Qwen, Llama, Gemma, Mistral, DeepSeek и другие open-weight модели. Для изображений, речи и зрения существуют отдельные checkpoints и приложения.
Как скачать нейросеть без интернета?
Само скачивание требует соединения на этом или другом компьютере. Для изолированной системы модель, приложение и зависимости загружают на staging-станции, проверяют и переносят внутрь контура.
Можно ли запустить нейросеть на ПК без видеокарты?
Да, если runtime поддерживает CPU и хватает RAM. Ответы обычно формируются медленнее. GPU нужен, когда требуется меньшая задержка, генерация изображений или более высокая нагрузка.
Сколько памяти нужно локальной нейросети?
Зависит от числа параметров, битности, контекста и runtime. Для нижней оценки умножьте параметры на биты и разделите на восемь, затем добавьте память под KV-cache, буферы и систему.
Можно ли установить локальную нейросеть на ноутбук?
Да. Проверьте RAM, VRAM или unified memory, свободный диск, поддержку ускорителя и охлаждение. Мобильная система может снижать скорость при длительной нагрузке.
Работает ли нейросеть без интернета на телефоне?
Да, если приложение использует on-device model. После загрузки включите авиарежим, перезапустите приложение и проверьте полный сценарий. Некоторые программы являются только клиентами облачного сервиса.
Как запустить Qwen, Llama или DeepSeek локально?
Выберите точную модель, размер, квантование и лицензию, затем совместимый runtime, например Ollama, llama.cpp, LM Studio или Transformers. Название семейства без варианта и формата недостаточно.
Можно ли работать с документами полностью офлайн?
Да, если parser, embedding model, vector database, reranker и LLM работают локально. Проверьте, что ни один этап не использует внешний API и что доступ к документам разграничен.
Локальная нейросеть гарантирует конфиденциальность?
Нет. Нужно проверить телеметрию, облачные функции, плагины, API, логи и резервные копии. Конфиденциальность является свойством всей архитектуры.
Нужно ли обучать локальную модель?
Обычно нет. Для большинства задач достаточно готовой модели, хорошей инструкции и при необходимости RAG. Fine-tuning применяют, когда измеримый тест показывает, что prompt и retrieval не решают задачу.
Как подобрать локальную AI-платформу
Для одного пользователя начните с контрольных задач, модели и теста на имеющемся ПК. Для общего корпоративного сервиса подготовьте:
точную модель и формат;
размер контекста и среднюю длину ответа;
число одновременных запросов;
требования к latency и доступности;
объем документов и частоту обновления индекса;
требования к интернет-изоляции и доступу;
срок хранения prompts и логов;
план роста и допустимый бюджет.
Start Server может сопоставить эти параметры с CPU, GPU, RAM, VRAM, NVMe и сетью, подготовить спецификацию локального сервера, схему закрытого контура и программу приемки. В результате выбирается не абстрактная мощная нейросеть, а воспроизводимая система под конкретные задачи и число пользователей.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


