Модель машинного обучения представляет собой функцию, параметры которой были найдены на данных. Она получает признаки объекта и выдает прогноз: число, класс, вероятность, группу, ранжированный список, вектор или сгенерированный результат. Алгоритм обучения определяет, как найти параметры модели, а метрика показывает, насколько результат полезен для поставленной задачи.
Универсально лучшей модели нет. Линейная регрессия может оказаться надежнее глубокой сети на небольшой табличной выборке. Градиентный бустинг часто силен на структурированных данных. Нейронные сети раскрываются на изображениях, речи и тексте, но требуют больше данных, вычислений и контроля. Выбор начинается не с модного названия алгоритма, а с типа ответа, стоимости ошибки, объема данных и ограничений production-системы.
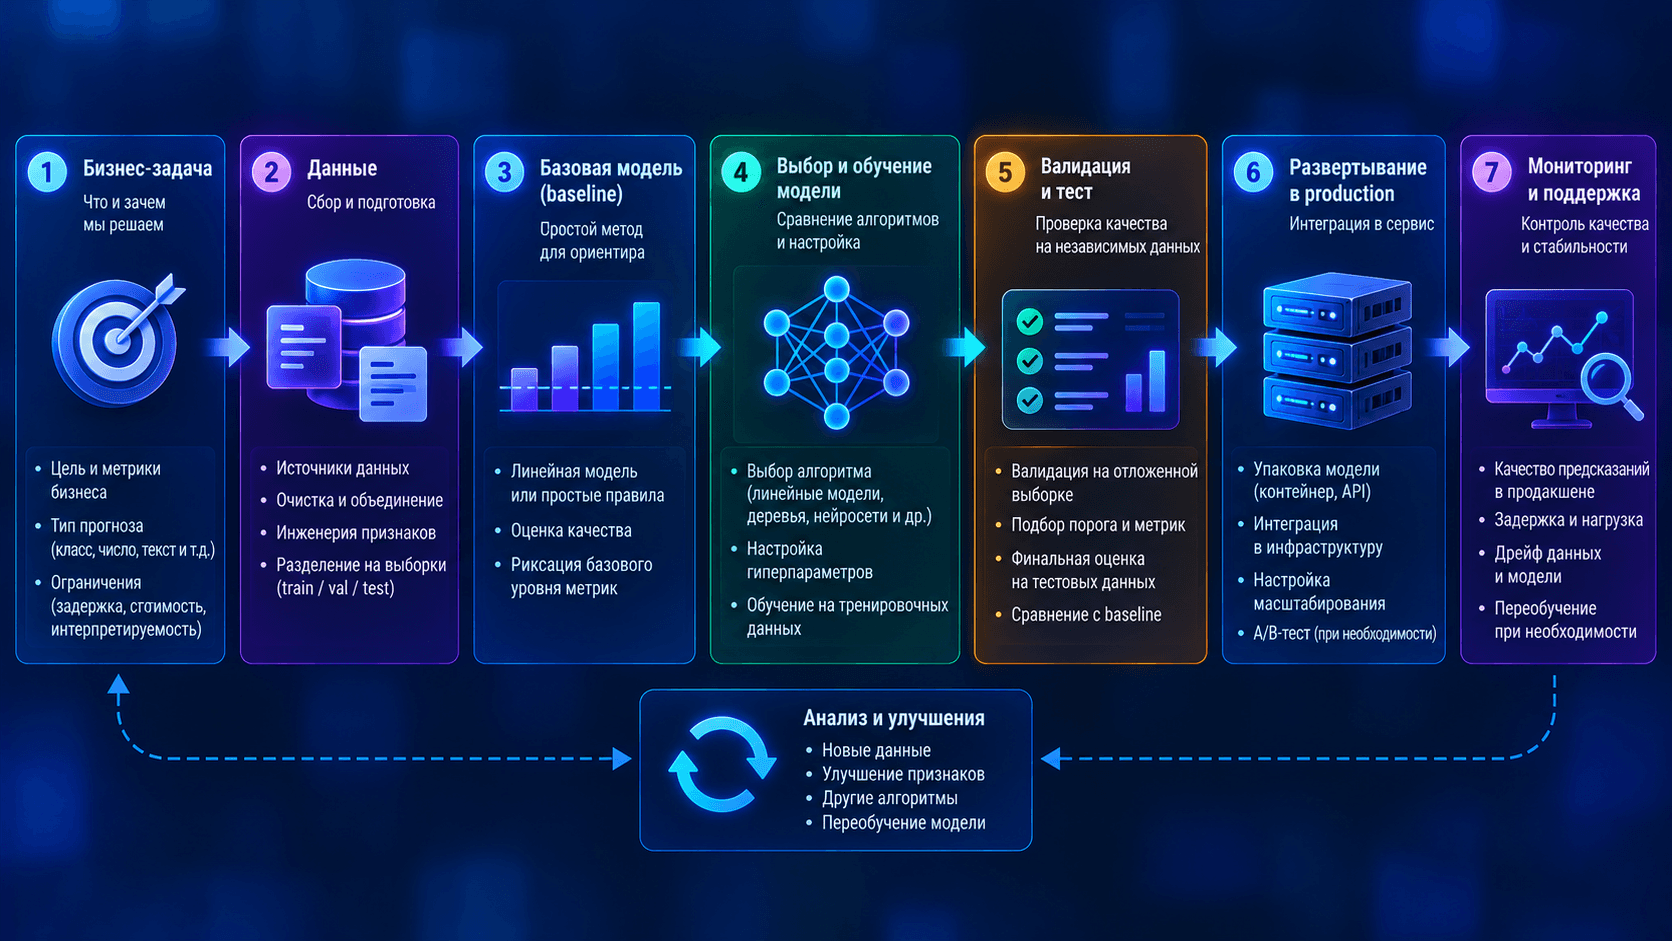
Что такое модель машинного обучения
Обычная программа следует явно записанным правилам. Модель ML извлекает закономерность из примеров. В линейной модели параметры являются коэффициентами при признаках. В дереве решений модель хранит условия разбиения. В нейронной сети знания распределены по весам слоев.
Полезно различать четыре понятия:
Понятие | Смысл | Пример |
|---|---|---|
Задача | какой результат нужен | предсказать отток клиента |
Алгоритм обучения | как параметры ищутся по данным | градиентный спуск, построение деревьев |
Модель | обученная функция с найденными параметрами | конкретный классификатор версии 1.4 |
Метрика | как измеряется качество | recall, F1, MAE |
Один алгоритм создает разные модели на разных данных и с разными гиперпараметрами. Поэтому фраза «мы используем XGBoost» еще не описывает готовое решение. Нужны версия данных, набор признаков, конфигурация обучения, порог решения, метрики и условия применения.
Классификация моделей машинного обучения
Одну модель можно отнести сразу к нескольким группам. Например, нейронная сеть может решать классификацию с учителем, а после обучения использоваться для пакетного или онлайн-инференса.
Обучение с учителем
Для каждого обучающего объекта известен правильный ответ. Если ответ категориальный, решается классификация. Если числовой, регрессия.
Примеры классификации: спам или обычное письмо, тип дефекта, риск мошенничества, тематика обращения. Примеры регрессии: прогноз спроса, время доставки, температура узла, стоимость ремонта.
Обучение без учителя
Разметки с правильными ответами нет. Алгоритм ищет структуру сам: группы похожих объектов, скрытые факторы или аномалии. Основные задачи включают кластеризацию, снижение размерности и поиск выбросов.
Алгоритмы кластеризации в машинном обучении нельзя оценивать только тем, насколько «красиво» выглядят группы. Нужно проверить устойчивость кластеров, полезность для процесса и связь с внешними показателями.
Обучение с подкреплением
Агент выполняет действия, получает награды и учится стратегии. Подход применяют в управлении, робототехнике, планировании и средах, где результат зависит от последовательности решений. Это не замена обычной классификации для табличной выборки.
Самообучение и перенос знаний
Self-supervised learning создает обучающий сигнал из самих данных. Так предварительно обучаются многие языковые и визуальные модели. Transfer learning переносит представления готовой модели в новую задачу. Fine-tuning изменяет часть или все веса, а дистилляция переносит поведение крупной модели в более компактную.
Основные алгоритмы машинного обучения
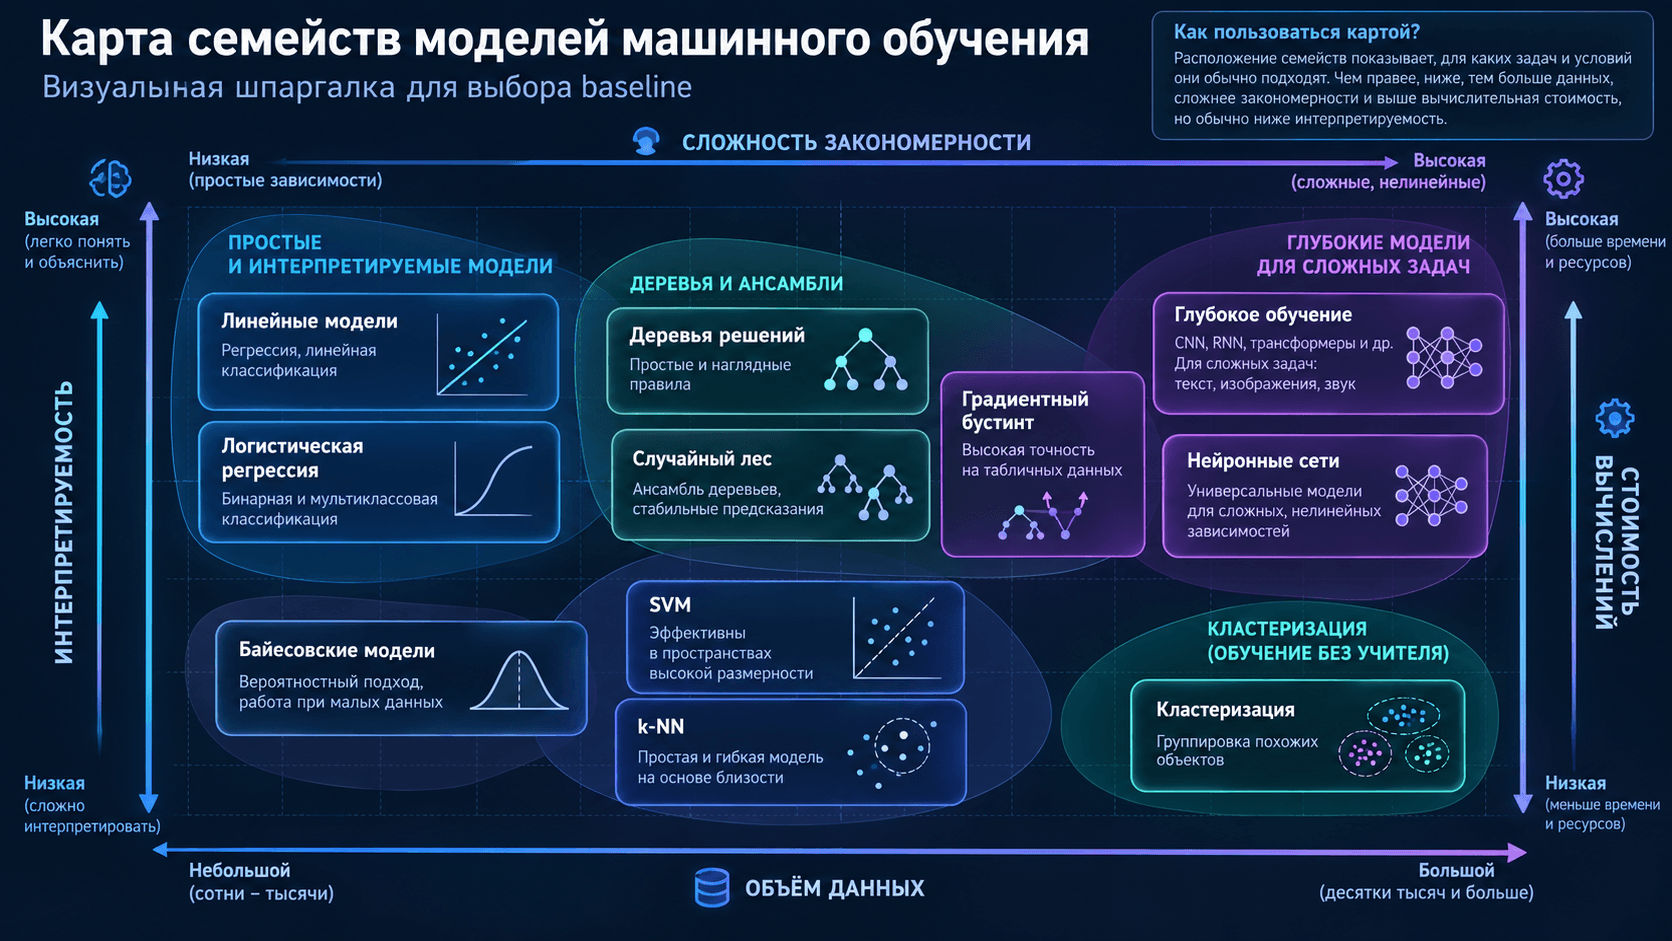
Линейные модели
Линейная регрессия предсказывает число как взвешенную сумму признаков. Логистическая регрессия оценивает вероятность класса. Эти модели быстро обучаются, хорошо работают на разреженных признаках и допускают интерпретацию коэффициентов.
Слабая сторона состоит не в «простоте», а в ограниченной форме зависимости. Нелинейность можно добавить признаками, однако сложная ручная инженерия иногда делает модель менее устойчивой.
Деревья решений и ансамбли
Дерево последовательно делит пространство признаков. Оно обрабатывает нелинейные зависимости и взаимодействия, но отдельное глубокое дерево легко переобучается.
Ансамбль моделей машинного обучения объединяет несколько предикторов. В случайном лесе деревья строятся с рандомизацией и усредняются. В градиентном бустинге новые деревья последовательно исправляют ошибки предыдущей композиции. Ансамбль способен улучшить качество, но увеличивает время обучения, инференса и объяснения результата.
Метод опорных векторов
SVM ищет разделяющую границу с максимальным запасом. Ядра позволяют строить нелинейные границы. Метод может быть силен на выборках умеренного размера, но плохо масштабируется на очень большие наборы и требует нормализации признаков.
Ближайшие соседи
k-NN сохраняет обучающие объекты и ищет ближайшие при прогнозе. Обучение почти отсутствует, зато инференс, память и качество сильно зависят от метрики расстояния, масштаба признаков и размерности.
Байесовские модели
Наивный Байес оценивает вероятности классов при упрощающем предположении о признаках. Он быстр и полезен как baseline для текста и других разреженных данных. Более сложные вероятностные модели позволяют работать с неопределенностью, но требуют корректных предположений о распределениях.
Нейронные сети
Нейросеть строит последовательность параметризованных преобразований. CNN исторически хорошо подходят для локальной структуры изображений, рекуррентные сети обрабатывают последовательности, а трансформер использует attention и стал базой многих языковых и мультимодальных моделей.
Нейронная сеть нужна не всякой задаче. При малом количестве строк, понятных табличных признаках и жестком требовании объяснимости разумно начать с линейной модели и бустинга. Устройство нейросетей подробно разобрано в статье нейронная сеть: как работает, виды и модели.
Семейство | Типичные данные | Сильная сторона | Ограничение |
|---|---|---|---|
Линейные модели | таблицы, разреженный текст | скорость и интерпретация | ограниченная нелинейность |
Деревья | табличные данные | взаимодействия признаков | одиночное дерево нестабильно |
Бустинг | таблицы и рейтинги | высокое качество на structured data | настройка и стоимость композиции |
SVM | выборки умеренного размера | сложные границы с ядрами | масштабирование |
k-NN | компактные пространства признаков | простой понятный baseline | дорогой поиск при инференсе |
Кластеризация | данные без меток | поиск структуры | нет единственного правильного разбиения |
Глубокие сети | текст, изображения, речь, видео | автоматическое изучение представлений | данные, вычисления и эксплуатация |
Как выбрать модель машинного обучения
1. Формализовать выход и единицу решения
Нужно определить, что прогнозируется и в какой момент. «Предсказывать отток» недостаточно. Корректная постановка указывает объект, горизонт, доступные на момент решения признаки и действие после прогноза.
2. Зафиксировать цену ошибок
Ложное одобрение кредита и пропуск мошеннической операции имеют разные последствия. От этого зависят метрика, порог классификации, стратегия разметки и требования к ручной проверке.
3. Разделить данные без утечки
Train используется для поиска весов, validation для выбора гиперпараметров и порога, test для финальной независимой оценки. При временных данных деление делают по времени. Если записи одного клиента попадают в разные части, применяют групповое разделение. Случайный split может дать завышенный результат.
4. Построить простой baseline
Baseline проверяет, есть ли в данных полезный сигнал. Для классификации это может быть частый класс и логистическая регрессия, для регрессии медиана и линейная модель. Сложный алгоритм сравнивают не с нулем, а с простым воспроизводимым решением.
5. Сравнить несколько семейств
На табличной задаче разумный набор включает линейную модель, дерево или лес и градиентный бустинг. Для текста можно сравнить линейный классификатор на TF-IDF с компактным трансформером. Для изображения полезно начать с transfer learning, а не обучать большую CNN с нуля.
6. Проверить эксплуатационные ограничения
Кандидаты сравнивают по качеству, latency, throughput, памяти, стоимости одного прогноза, доступности объяснения, устойчивости к пропускам и скорости переобучения. Иногда модель с F1 на доли процента ниже выигрывает за счет предсказуемой задержки и простой поддержки.
Метрики качества моделей машинного обучения
Классификация
Метрика | Что измеряет | Когда полезна |
|---|---|---|
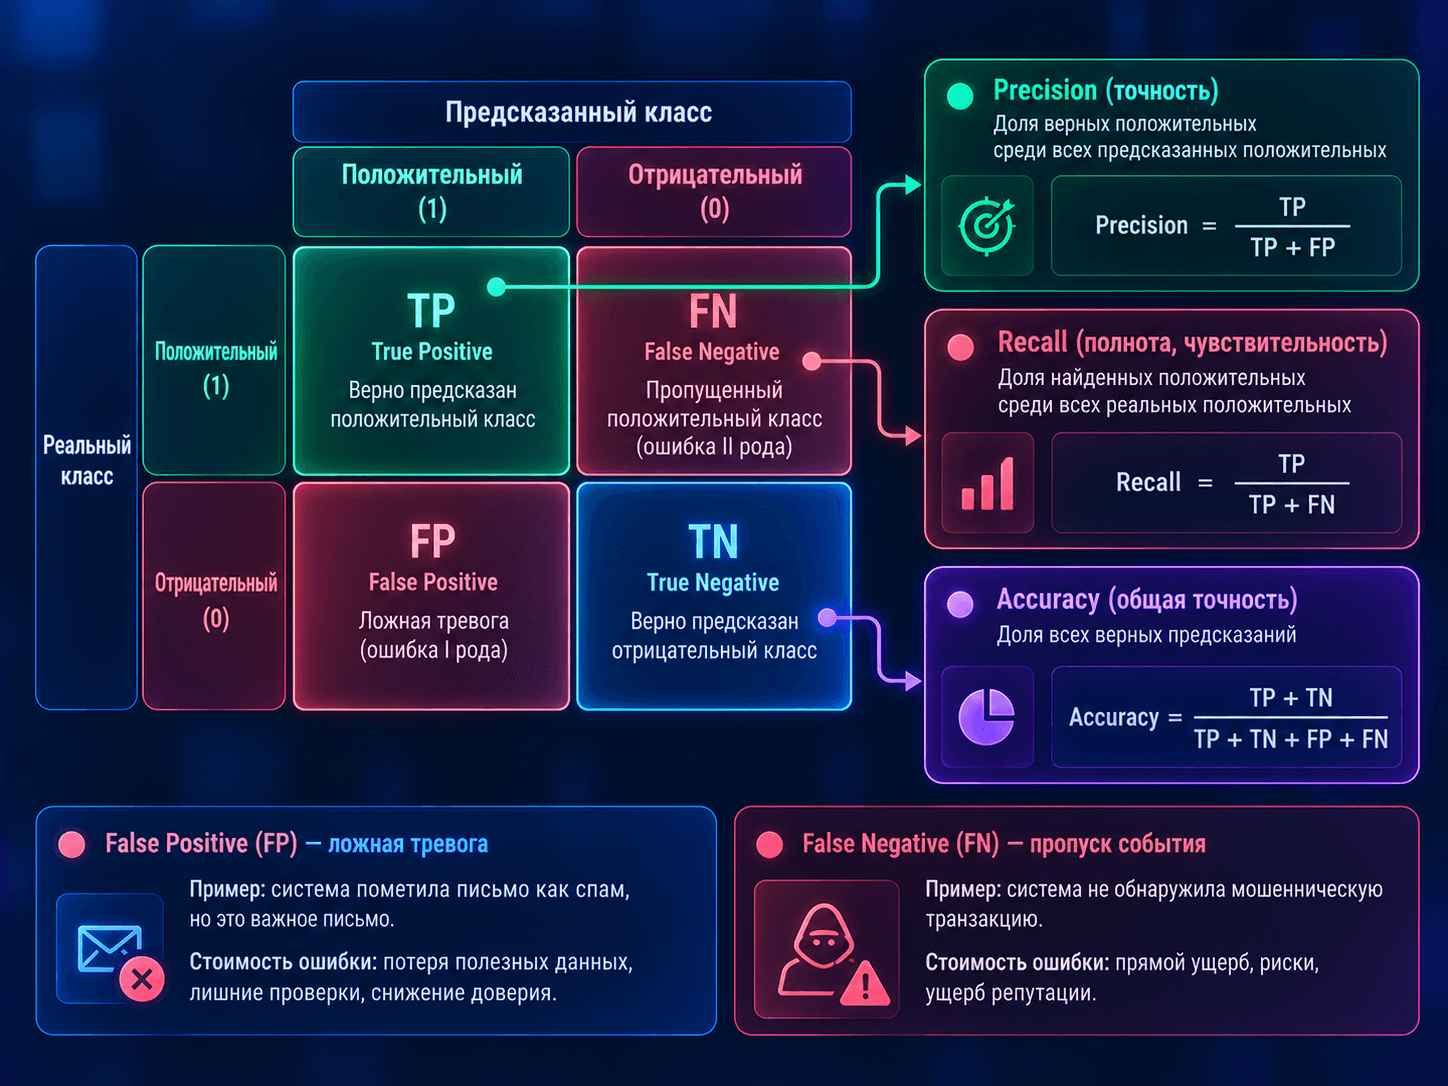
Accuracy | долю верных ответов | классы сбалансированы и ошибки близки по цене |
Precision | долю верных среди положительных прогнозов | ложное срабатывание дорого |
Recall | долю найденных положительных объектов | пропуск дорог |
F1 | гармонический баланс precision и recall | нужен единый показатель при дисбалансе |
ROC AUC | ранжирование классов по всем порогам | сравнение способности разделять классы |
PR AUC | precision и recall по порогам | редкий положительный класс |
Log loss | качество вероятностных прогнозов | важна калибровка уверенности |
Регрессия
MAE измеряет среднюю абсолютную ошибку в единицах целевой переменной. RMSE сильнее штрафует крупные отклонения. MAPE удобна в процентах, но ведет себя плохо рядом с нулем. R2 показывает долю объясненной вариации, однако сам по себе не сообщает размер ошибки в рублях, градусах или часах.
Метрику выбирают по бизнес-потере. Если крупная ошибка особенно опасна, используют штраф, который растет быстрее. Если важна медианная типичная ошибка, MAE часто понятнее.
Кластеризация и генеративные модели
Для кластеризации применяют silhouette score и другие внутренние критерии, но обязательно дополняют их устойчивостью и прикладной проверкой. Для поиска и рекомендаций используют precision@k, recall@k, MAP, NDCG. Для генеративной модели автоматической метрики недостаточно: нужны тестовый набор, оценка фактичности, безопасность, экспертный review и production-сигналы.
Валидация, переобучение и честное сравнение
Переобучение модели в машинном обучении означает, что она запомнила особенности train-выборки, но хуже работает на новых данных. Признак проблемы состоит в растущем разрыве между качеством на обучении и валидации.
Для контроля применяют cross-validation, регуляризацию, раннюю остановку, уменьшение сложности, больше данных и борьбу с leakage. Все преобразования, включая масштабирование, кодирование и отбор признаков, должны обучаться внутри каждого validation-fold. Иначе информация из проверки попадет в модель.
Финальное сравнение проводят при одинаковом split, одинаковой процедуре обработки и одинаковой метрике. Если гиперпараметры многократно подбирались по test, он перестает быть независимым.
Что влияет на выбор оборудования
Классические алгоритмы на таблицах часто хорошо работают на CPU и большом объеме RAM. GPU становится полезен для глубоких сетей, больших матричных операций, компьютерного зрения, LLM и ускоренных реализаций некоторых алгоритмов.
Расчет начинается с профиля workload:
Размер и формат данных.
Память для модели, batch и промежуточных тензоров.
Время обучения и частота переобучения.
Требования к latency и throughput инференса.
Число параллельных экспериментов.
Нужна ли multi-GPU коммуникация.
Скорость чтения данных и checkpoint.
Типичные ошибки при выборе модели
Выбирать алгоритм до постановки задачи и метрики.
Использовать accuracy при сильном дисбалансе классов.
Подбирать признаки на полной выборке до split.
Сравнивать модели на разных данных.
Игнорировать временную зависимость и группы объектов.
Считать высокое offline-качество гарантией бизнес-эффекта.
Не проверять калибровку вероятностей и рабочий порог.
Оценивать только среднее, не анализируя сегменты и редкие ошибки.
Не измерять latency, память и стоимость инференса.
Не отслеживать drift данных и качество после deployment.
Считать ансамбль бесплатным улучшением.
Не моделировать атаки, подмену данных и adversarial-входы для критической системы.
Примеры выбора модели
Прогноз числового спроса
Начните с сезонного baseline и линейной регрессии. Затем сравните бустинг и модель временного ряда на time split. Метрика должна учитывать цену недопоставки и избытка, поэтому одной RMSE может быть мало.
Поиск дефектов на изображении
Используйте transfer learning готовой CNN или vision transformer. Разделите данные по партиям или оборудованию, чтобы похожие кадры не попали в train и test одновременно. Смотрите recall дефекта при допустимом числе ложных тревог и измеряйте полный video pipeline.
Отток клиентов
Сравните логистическую регрессию и бустинг. Проверьте временной горизонт, leakage из будущих действий и калибровку вероятности. Порог выбирайте по емкости команды удержания и ожидаемой ценности контакта.
Классификация документов
Сначала протестируйте линейную модель на разреженных признаках. Затем сравните embedding-модель или трансформер. Если выигрыш мал, компактный baseline может быть дешевле и стабильнее.
FAQ
Что такое модель машинного обучения простыми словами?
Это обученная на данных функция, которая превращает входные признаки в прогноз. Ее поведение задают архитектура, найденные веса, preprocessing и порог принятия решения.
Какие виды моделей машинного обучения бывают?
Их делят по способу обучения, типу задачи и архитектуре. Основные группы включают supervised, unsupervised, reinforcement и self-supervised learning, а также линейные модели, деревья, ансамбли, вероятностные методы и нейронные сети.
Чем алгоритм отличается от модели?
Алгоритм описывает процедуру поиска параметров. Модель является результатом обучения этого алгоритма на конкретных данных.
Как выбрать модель машинного обучения?
Определить выход, цену ошибок и рабочую метрику, корректно разделить данные, построить baseline, сравнить несколько семейств и проверить ограничения production-системы.
Что такое веса модели в машинном обучении?
Это обучаемые параметры, которые определяют преобразование входа в выход. В линейной модели они являются коэффициентами, в нейросети распределены по слоям.
Что такое ансамбль моделей?
Это объединение нескольких предикторов. Ансамбль может снизить ошибку и нестабильность, но требует больше вычислений и усложняет сопровождение.
Какую метрику качества выбрать для классификации?
Выбор зависит от баланса классов и цены ошибок. Recall важен при дорогих пропусках, precision при дорогих ложных тревогах, а F1 полезна, когда нужен баланс. Порог следует подбирать отдельно.
Почему accuracy бывает плохой метрикой?
При редком положительном классе модель может получить высокую accuracy, всегда предсказывая большинство, и остаться бесполезной для задачи.
Как понять, что модель переобучилась?
Качество на train улучшается, а на независимой валидации перестает расти или падает. Проверку дополняют learning curves и оценкой на новых временных периодах или группах.
Нужен ли GPU для моделей машинного обучения?
Не всегда. Линейные модели, деревья и многие табличные задачи эффективно решаются на CPU. GPU чаще нужен для глубокого обучения и большой параллельной нагрузки.
Что подготовить для проектирования ML-контура
Соберите описание результата, примеры данных, объем и темп поступления, допустимые ошибки, целевую метрику, требования к latency, частоту переобучения и правила хранения. Start Server поможет сопоставить workload с CPU, RAM, GPU, NVMe, сетью и вариантом масштабирования. Передать вводные можно через контакты Start Server.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


