GPU utilization 100% ещё не означает проблему.
И наоборот, GPU utilization 30% не доказывает, что сервер работает плохо.
В эксплуатации нужно отвечать сразу на несколько разных вопросов:
Получает ли пользователь нужную производительность?
Не достиг ли runtime предела по queue, cache или другим ресурсам?
Есть ли у GPU, PCIe или межсоединения признаки operating constraint?
Есть ли evidence аппаратной, driver-level или fabric-проблемы?
Ответы находятся в разных группах метрик.
Поэтому мониторинг GPU-сервера полезнее строить не вокруг одного графика utilization, а как цепочку:
User SLI → Runtime → GPU Resources → Constraints → Data Path → Health / Errors → Incident Evidence.
Главный принцип:
Четыре слоя мониторинга GPU-сервера
Для эксплуатации удобно разделить показатели на четыре уровня.
Application SLI
То, что характеризует результат для пользователя или вычислительной задачи:
request latency;
TTFT;
ITL / TPOT;
throughput;
job duration;
error rate;
completed/failed requests.
Именно этот слой обычно отвечает на вопрос:
выполняется ли SLO сервиса?
Runtime и scheduler
То, что происходит внутри inference или training engine:
queue;
running/waiting requests;
KV-cache usage;
preemptions;
batching;
scheduler pressure.
Эти показатели часто объясняют, почему ухудшилась пользовательская latency.
GPU resource telemetry
То, как используется accelerator:
GPU utilization;
VRAM;
clocks;
temperature;
power;
PCIe traffic;
NVLink/XGMI traffic.
Они помогают обнаружить bottleneck или operating constraint.
Health и error telemetry
То, что может свидетельствовать о проблеме hardware, driver или interconnect:
ECC/RAS events;
NVIDIA XID;
clock/power/thermal constraint events;
PCIe recovery/replay;
NVLink/NVSwitch health;
vendor-specific health incidents.
Главная граница:
GPU Operations Metric Dictionary
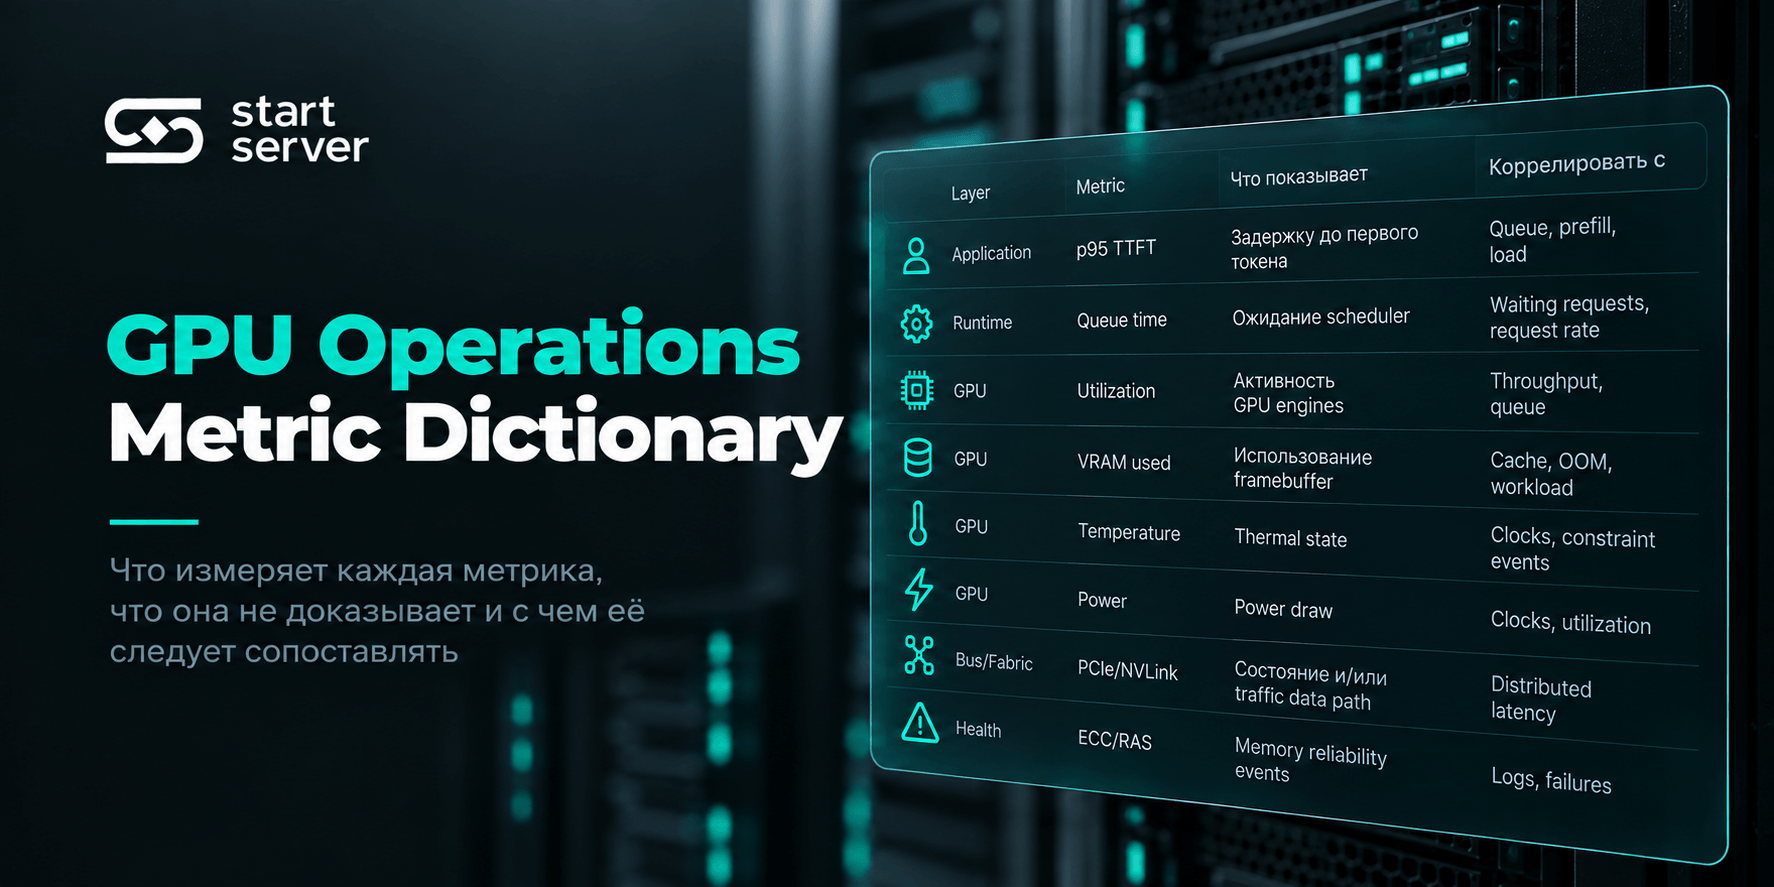
У каждой метрики полезно фиксировать не только название, но и:
что она измеряет;
чего она не доказывает;
с чем её следует сопоставлять.
Layer | Metric | Что показывает | Чего не доказывает | Коррелировать с |
Application | p95 TTFT | задержку до первого токена по выбранному определению | причину задержки | queue, prefill, load |
Application | ITL / TPOT | скорость продолжения generation | состояние hardware само по себе | decode, clocks, workload |
Runtime | queue time | ожидание scheduler | hardware failure | waiting requests, request rate |
Runtime | KV-cache usage | занятость cache | OOM сама по себе | preemptions, context |
GPU | utilization | активность GPU engines | здоровье и SLO | throughput, queue |
GPU | VRAM used | использование framebuffer | memory pressure само по себе | cache, OOM, workload |
GPU | temperature | thermal state | throttling без дополнительных evidence | clocks, constraint events |
GPU | power | power draw | performance напрямую | clocks, utilization |
GPU | clocks | operating frequency | причину изменения | temperature, power, events |
Health | ECC/RAS | memory reliability events | влияние на workload без context | logs, failures |
Health | XID/vendor events | incident evidence | единственную root cause | code, workload, telemetry |
Bus/Fabric | PCIe/NVLink/XGMI | состояние и/или traffic data path | application bottleneck сами по себе | distributed latency |
Последний столбец особенно важен: одна метрика редко объясняет incident самостоятельно.
Почему GPU utilization недостаточно
Utilization полезна, если понимать её роль.
GPU 98%, latency нормальная
Если:
throughput соответствует цели;
queue не растёт;
errors отсутствуют;
clocks стабильны;
то высокая загрузка может быть нормальным состоянием эффективно используемой GPU.
Не нужно создавать incident только потому, что accelerator занят.
GPU 98%, queue и TTFT растут
Это другая ситуация.
Если одновременно растут:
waiting requests;
queue time;
TTFT;
то workload, возможно, подошёл к capacity limit.
Здесь utilization — часть evidence, но проблема определяется не числом 98% само по себе, а ухудшением application SLI.
GPU 30%, throughput ниже нормы
Причина может находиться вне GPU:
CPU bottleneck;
storage;
network;
слишком маленькие batches;
scheduler;
synchronization;
input starvation.
Поэтому:
GPU 0%, workload отсутствует
Нормальный idle state.
Главные формулы:
GPU Utilization ≠ Health.
GPU Utilization ≠ Application Performance.
NVIDIA: telemetry через DCGM
Для NVIDIA-серверов одним из основных infrastructure-level инструментов является Data Center GPU Manager — DCGM.
dcgm-exporter публикует DCGM telemetry в Prometheus-формате и может отдавать resource, error, health и topology-related signals. Современный exporter также имеет собственные metric families для XID, clock events и GPU health status.
Для статьи важен не конкретный Helm chart, а принцип:
GPU Telemetry → Time Series → Correlation → Alert / Investigation.
DCGM Health — это passive monitoring
DCGM Health использует сохранённые field samples и проверяет включённые health watches.
Он не создаёт специальную нагрузку на GPU.
NVIDIA прямо определяет его как passive health monitoring и отдельно отличает от active diagnostics. Healthy означает, что включённые health rules не нашли incident в retained data; это не означает, что были проверены все subsystems или что GPU прошла stress test.
Поэтому:
DCGM Health PASS ≠ Active Diagnostic PASS.
И:
DCGM Health PASS ≠ Performance PASS.
Health status — не один общий health score
Современный dcgm-exporter экспортирует health result отдельно для каждого watch.
Значения:
0 = PASS;
10 = WARN;
20 = FAIL.
Дополнительно метрика содержит labels:
health_watch;
health_error_code;
health_error_severity;
health_error_category.
Это важная граница:
И ещё:
No Observed Health Incident ≠ Proven Healthy Hardware.
Отсутствие события означает отсутствие обнаруженного evidence в наблюдаемых данных, а не математическое доказательство отсутствия любой hardware-проблемы.
VRAM usage: занятость ещё не означает pressure
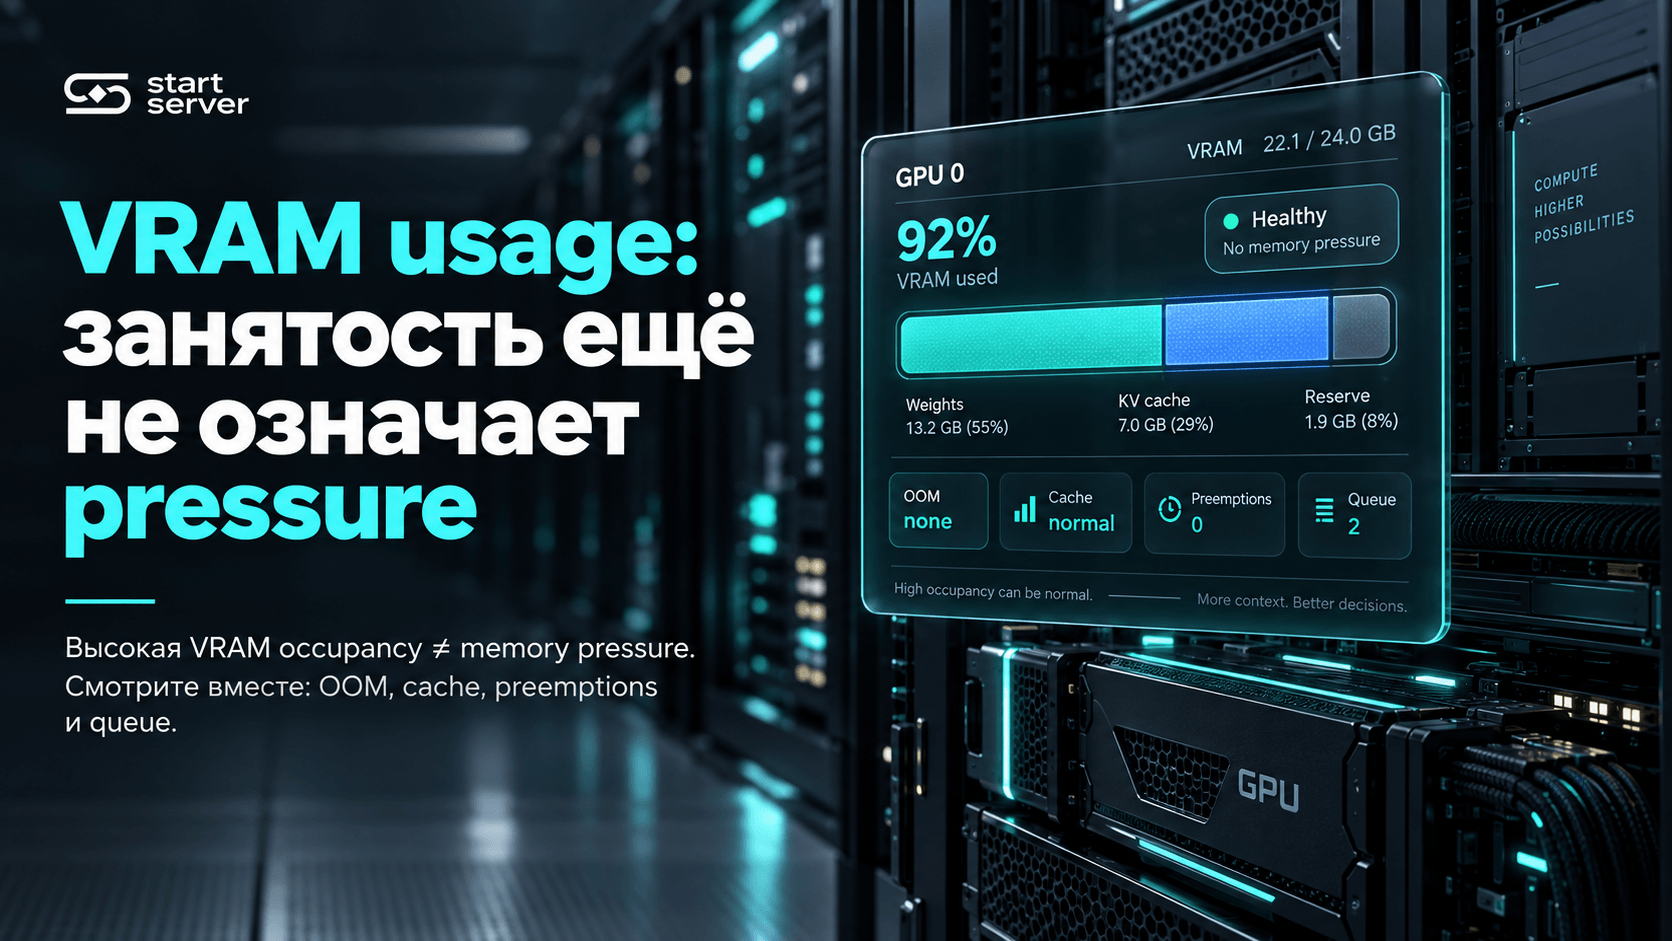
VRAM нужно собирать постоянно, но интерпретировать осторожно.
Высокая occupancy может объясняться:
model weights;
заранее выделенным KV cache;
allocator reserve;
нормальным состоянием serving engine.
Поэтому:
VRAM Used ≠ Memory Pressure.
Важнее смотреть вместе:
OOM events;
cache occupancy;
preemptions;
queue;
context/concurrency;
runtime logs.
Temperature: важен operating state, а не магическое число
Не следует вводить универсальное правило:
выше N °C GPU неисправна.
Thermal limits зависят от:
GPU model;
sensor;
firmware;
cooling design;
workload.
Температура особенно полезна в correlation.
Например:
Temperature ↑
Clock ↓
Thermal Constraint Event
Application Performance ↓
сильнее, чем просто:
GPU горячая.
Power: потребление не является performance score
Мониторить полезно:
current power;
power limit/cap;
power-related constraint events.
Но:
GPU потребляет меньше ватт
не значит автоматически:
GPU работает хуже.
Причиной могут быть:
idle;
другая фаза workload;
меньший batch;
штатный dynamic power state.
Power нужно сопоставлять с:
utilization;
clocks;
workload;
power-limit evidence.
Clocks: низкая частота требует причины
Clock graph особенно полезен рядом с:
utilization;
temperature;
power;
clock-event reason;
application performance.
Если GPU простаивает, низкий clock может быть штатным.
Если же при одинаковом workload:
clocks снизились;
throughput ухудшился;
появился thermal или power constraint;
это уже полезный diagnostic signal.
Главный принцип:
Clock events — не все являются аварийным throttling
Современный DCGM Exporter различает причины вроде:
gpu_idle;
clocks_setting;
power_cap;
hw_slowdown;
sync_boost;
sw_thermal;
hw_thermal;
hw_power_brake;
display_clocks.
Они имеют разную семантику.
Например:
gpu_idle
Низкая частота может объясняться отсутствием работы.
clocks_setting
Clock ограничен configuration.
power_cap
Frequency может быть ограничена power envelope.
sw_thermal / hw_thermal
Есть thermal constraint.
Поэтому:
clock event появился
не равно:
hardware аварийно throttling.
Нужно смотреть exact reason и влияние на workload.
AMD: violation telemetry зависит от поколения GPU
У AMD важно учитывать architecture.
Для Instinct MI300 Series и более новых data-center GPU AMD SMI предоставляет time-based violation metrics для power и thermal throttling.
Для MI100/MI200 и ряда более старых устройств используются throttle_status и per-reason bit flags, которые показывают текущий state, а не процент времени, проведённого в throttling. Эти механизмы не являются взаимозаменяемыми.
Поэтому:
Exact GPU Generation → Exact Available Metric.
Нельзя создавать один универсальный AMD alert template без проверки ASIC generation и AMD SMI support.
ECC и RAS
Memory reliability signals нужно отделять от resource usage.
AMD SMI предоставляет ECC single-bit/double-bit monitoring и другие RAS-related данные на поддерживаемом hardware.
На практике важны:
тип ошибки;
новое событие или historical counter;
affected block;
повторяемость;
влияние на workload;
vendor guidance.
Плохой универсальный вывод:
одна correctable ECC ошибка = GPU нужно заменить.
Корректнее:
NVIDIA XID: evidence, а не готовая root cause
XID следует трактовать как driver-reported incident evidence.
Одного номера XID недостаточно, чтобы автоматически заключить:
физически неисправна GPU.
При XID стоит сохранять:
exact code;
timestamp;
GPU UUID/BDF;
node;
driver;
workload;
соседние telemetry;
recent changes;
recovery action.
Главная формула:
XID = Incident Evidence, not Root Cause by Itself.
PCIe: три разных вопроса
PCIe monitoring нужно разделять минимум на:
Traffic
Сколько данных проходит через bus.
Link configuration
С какой negotiated speed/width работает link.
Reliability
Есть ли replay/recovery/error activity.
AMD SMI, например, может показывать PCIe bandwidth и PCIe replay error counts на поддерживаемом hardware.
Поэтому:
PCIe Traffic ≠ PCIe Health.
И:
Low GPU Utilization + Heavy Host Transfer ≠ GPU Failure.
Возможно, bottleneck находится в data movement.
NVLink: traffic и health — разные показатели
На NVIDIA multi-GPU system полезно видеть:
link state;
throughput;
error events;
fabric condition.
Большой traffic может быть нормальным.
Маленький traffic тоже может быть нормальным.
Для reliability нужны отдельные error/state signals.
Поэтому:
AMD XGMI — только там, где он реально существует
В AMD multi-GPU системах аналогичный fabric layer может включать XGMI.
Но наличие AMD GPU само по себе ещё не означает, что конкретная система использует XGMI или предоставляет нужные counters.
Правило:
AMD GPU ≠ XGMI Metric Available.
В dashboard добавляются только те fabric metrics, которые подтверждены для exact platform.
Metric support зависит от exact GPU и software stack
Не существует одного набора из 30–40 полей, который гарантированно присутствует на любой GPU.
Различаться могут:
поколения GPU;
firmware;
driver;
DCGM/AMD SMI version;
topology;
hardware feature set.
Правильная последовательность:
Required Signal → Vendor Tool → Exact Platform Support → Actual Metric.
Hardware telemetry недостаточно
Предположим:
utilization 95%;
temperature нормальная;
ECC events нет;
DCGM Health не показывает incident.
Это всё ещё не отвечает на вопрос:
хорошо ли работает LLM API?
Проблема может находиться в:
queue;
concurrency;
scheduler;
prompt size;
KV cache;
application.
Поэтому инфраструктурные графики нужно связывать с application SLI.
TTFT: всегда фиксируйте точное определение
Time To First Token кажется очевидной метрикой, но даже внутри одного serving stack разные interfaces могут использовать разные точки отсчёта.
В vLLM Prometheus:
vllm:time_to_first_token_seconds
— TTFT production metric. Документация связывает его с frontend arrival timing и первым token event.
При этом новый per-request metric:
time_to_first_token_ms
считается как:
scheduled → first output token.
То есть два показателя, называемых TTFT, могут включать разные участки request lifecycle.
Главный принцип:
Перед сравнением TTFT фиксируйте:
metric source;
version;
start event;
end event;
units.
Queue time
В vLLM доступна отдельная production metric:
vllm:request_queue_time_seconds.
Также существуют gauges running/waiting requests.
Поэтому ситуация:
TTFT ↑
Queue ↑
Waiting Requests ↑
сильнее указывает на scheduling/capacity pressure, чем на hardware failure.
Главная граница:
Latency ↑ + Queue ↑ ≠ Hardware Failure by Default.
ITL и TPOT — не одно и то же
vLLM Prometheus предоставляет:
vllm:inter_token_latency_seconds;
vllm:request_time_per_output_token_seconds.
ITL
Prometheus ITL измеряет время между последовательными streamed output events.
TPOT
Request-level TPOT рассчитывается как:
(E2E latency - TTFT) / (number of output tokens - 1).
Они могут быть близки, когда каждый streamed output содержит ровно один token.
Но при:
speculative decoding;
bundled outputs;
другой aggregation semantics
значения могут отличаться.
Следовательно:
Per-request ITL тоже имеет свою measurement semantics
Per-request vLLM metric:
mean_itl_ms
вычисляется по decode interval между первым и последним output token, делённому на число token intervals.
Это не обязательно буквально тот же time series, который лежит в Prometheus inter_token_latency_seconds.
Поэтому для latency monitoring полезно хранить:
Metric + Source + Version + Definition.
KV-cache usage: проверяйте units
В текущей vLLM documentation:
vllm:kv_cache_usage_perc
определена как fraction использованных KV-cache blocks от 0 до 1.
То есть:
0.8 = 80%.
Название _perc может ввести инженера в заблуждение, если он ожидает шкалу 0–100.
Поэтому:
Metric Name ≠ Units.
Units нужно зафиксировать в monitoring dictionary.
Высокая KV-cache occupancy ещё не означает incident
Как и с VRAM:
cache usage высокая
не равно:
workload сломан.
Полезнее смотреть correlation:
KV-cache usage ↑
Preemptions ↑
Waiting Requests ↑
TTFT / ITL degradation
→ исследовать memory/scheduler pressure.
Preemption — signal pressure, но не готовая root cause
vLLM экспортирует cumulative preemption metrics наряду с queue и cache statistics.
Но не нужно писать:
каждый preemption доказанно вызван исчерпанием KV cache.
Корректнее:
рост preemptions вместе с высокой cache occupancy и waiting queue является сильным evidence resource/scheduling pressure.
Дальше уже определяется конкретная причина.
Incident Correlation Matrix
Симптом | Сначала смотреть | Следующий слой | Hardware evidence |
TTFT вырос | TTFT definition, queue, prefill | GPU util, workload | constraint/error evidence |
ITL/TPOT ухудшились | decode/runtime | clocks, utilization | thermal/power events |
Throughput упал | request rate/workload | GPU util | clocks/fabric |
Один node медленнее | SLI per-node | resource metrics per-node | PCIe/fabric/ECC |
Requests падают | app/runtime logs | VRAM/runtime | XID/ECC/driver |
Multi-GPU scaling хуже | collective/runtime | fabric traffic | link state/errors |
GPU простаивает | queue/input pipeline | CPU/network/storage | PCIe/data path |
Preemptions растут | cache/concurrency | VRAM | hardware only if evidence exists |
Главный принцип:
Стройте одну Incident Timeline
Для сложного incident полезно свести временные ряды на одну шкалу:
Application SLI
↓
Queue / Runtime
↓
GPU Utilization / VRAM
↓
Clocks / Power / Temperature
↓
Constraint Events
↓
PCIe / NVLink / XGMI
↓
ECC / XID / Health Evidence
↓
Deploy / Driver / Configuration Changes
Тогда можно увидеть:
что произошло первым;
что было следствием;
какие показатели совпали только по времени.
Набор отдельных screenshots намного слабее общей timeline.
Dashboard и alert — разные вещи
Не каждая полезная metric должна генерировать alert.
GPU utilization
Полезный dashboard signal.
Плохой universal alert:
90% = warning.
VRAM
Полезный context signal.
Слабый alert без знания runtime/cache semantics.
Temperature
Полезна для trend.
Alert должен исходить из vendor threshold или validated operational policy.
Health/error event
Может быть incident signal — в зависимости от severity и classification.
Application latency
Хороший SLO-based alert, если SLO определён заранее.
Главное правило:
Interesting Metric ≠ Alert Condition.
Хороший alert должен объяснять контекст
Плохой:
GPU utilization 97%.
Лучше:
p95 TTFT вышел за SLO на inference-node-04; queue time и waiting requests растут, а в наблюдаемых hardware-health signals новый incident evidence не обнаружен.
Такой alert уже направляет расследование в сторону:
до того, как инженер начнёт искать неисправную GPU.
Не используйте универсальные thresholds
Не задавайте единый порог для всех систем:
utilization;
VRAM;
temperature;
power;
clocks;
ECC;
PCIe replay;
TTFT;
ITL.
Источник threshold должен быть явным.
Vendor threshold
Для hardware/health limit.
Application SLO
Для пользовательской характеристики.
Workload baseline
Для отклонения от известного нормального поведения.
Эти три типа порога нельзя смешивать.
Peer comparison особенно полезен в одинаковом кластере
Если восемь одинаковых nodes обслуживают сопоставимый workload, сравнение между ними может быть информативнее универсального threshold.
Например, один node показывает:
хуже TTFT;
ниже clocks;
выше temperature;
новые PCIe/ECC events,
а остальные семь — нет.
Это основание расследовать именно этот узел.
Рабочий метод:
Не сравнивайте разные workloads
Если утром concurrency = 2, а вечером = 50, изменение utilization и latency ожидаемо.
Для correlation сохраняйте:
model/revision;
request rate;
batch;
context;
input size;
output size;
concurrency;
application version.
Иначе изменение workload легко принять за hardware degradation.
Sampling interval не имеет универсального значения
Не нужно писать:
scrape каждые 5 секунд всегда правильно.
Sampling выбирается по:
скорости изменения сигнала;
monitoring overhead;
retention;
incident-response requirement.
Некоторые данные нужны часто:
temperature;
power;
utilization.
Другие меняются редко:
inventory;
configuration.
Counters и events вообще могут анализироваться через:
delta;
rate;
факт нового события.
Gauge, counter и event читаются по-разному
Gauge
Например:
temperature;
VRAM;
utilization.
Нужны current value и trend.
Counter
Например:
cumulative preemptions;
error counters;
request totals.
Часто важнее:
delta;
rate;
рост за window.
Event
Например:
XID;
health failure;
deploy.
Здесь важны timestamp и context.
Restart и reset влияют на counters
Некоторые counters сбрасываются после:
application restart;
exporter restart;
driver restart;
GPU reset;
monitoring daemon restart.
Например, exporter-owned DCGM cumulative XID и clock-event counters сбрасываются при restart/rebuild collector.
Поэтому Incident Card должен учитывать lifecycle.
Passive monitoring не заменяет active diagnostics
Production monitoring нужен для:
trends;
incidents;
historical evidence;
correlation.
Но зелёный dashboard не доказывает:
GPU прошла активный тест compute/memory/interconnect под контролируемой нагрузкой.
DCGM Diagnostics — отдельный механизм именно для active tests.
Поэтому:
Green Dashboard ≠ Stress Test PASS.
Minimum Dashboard
Вместо десятков случайных panels можно начать с шести блоков.
Service
success/error rate;
p95/p99 latency;
TTFT;
ITL/TPOT;
throughput;
queue.
Runtime
running/waiting requests;
KV-cache usage;
preemptions;
scheduler state.
GPU Resources
utilization;
VRAM;
temperature;
power;
clocks.
Constraints
clock-event reasons;
AMD violation/throttle state;
power/thermal constraint evidence.
Reliability / Data Path
DCGM Health;
ECC/RAS;
XID/vendor incidents;
PCIe;
NVLink/NVSwitch/XGMI where applicable.
Changes
deploy;
model update;
driver change;
reboot/reset;
configuration change.
GPU Incident Card
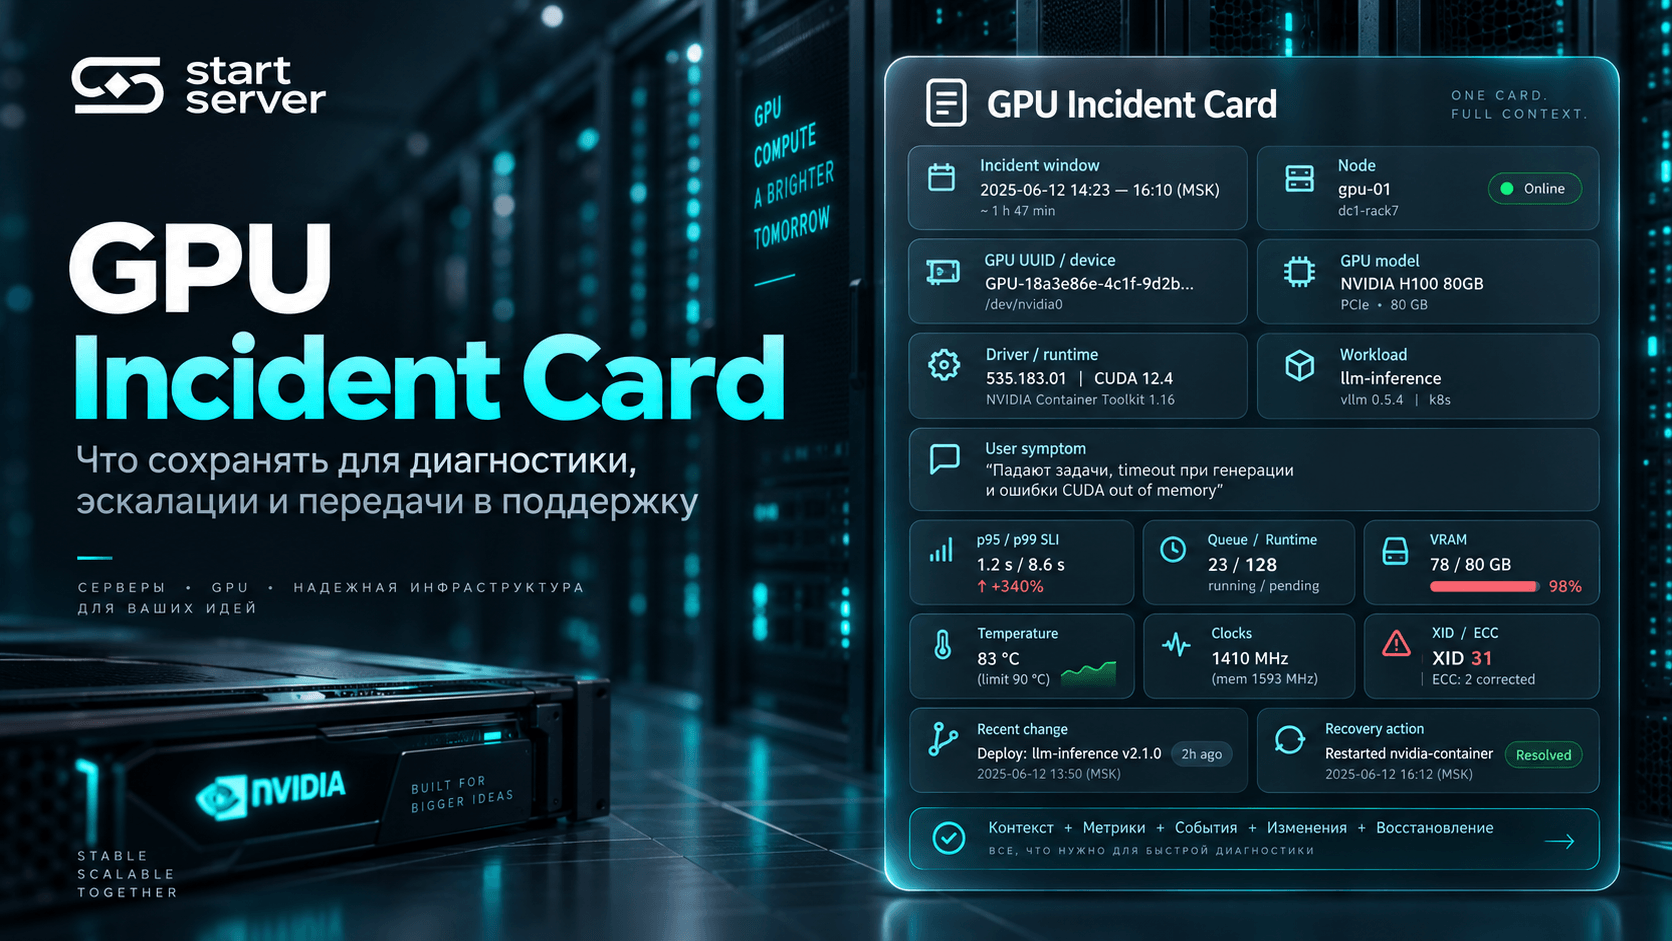
Поле | Значение |
Incident window | |
Node | |
GPU UUID/device | |
GPU model | |
Driver/runtime | |
Model/revision | |
Application/container version | |
Workload/concurrency | |
User symptom | |
Metric source/version | |
p95/p99 SLI | |
Queue/runtime | |
KV-cache/preemptions | |
GPU utilization | |
VRAM | |
Temperature | |
Power | |
Clocks | |
Constraint event | |
PCIe | |
NVLink/XGMI | |
ECC/RAS | |
XID/vendor event | |
Health-watch result | |
Logs | |
Recent change | |
Reset/restart | |
Recovery action | |
Reproducible |
Особенно полезно поле:
Без него одинаковое название TTFT или ITL может означать разные measurement semantics.
Пример 1. TTFT растёт, hardware incident evidence нет
Симптом:
пользователи дольше ждут первый token.
Monitoring:
TTFT ↑;
queue ↑;
waiting requests ↑;
utilization высокая;
clocks стабильны;
новый XID/ECC/health incident не обнаружен.
Первая гипотеза:
capacity / scheduler pressure.
Следующие действия:
request rate;
prompt length;
concurrency;
scheduler limits;
available serving capacity.
Не нужно начинать с замены GPU.
Пример 2. Throughput падает вместе с clock constraint
Одинаковый workload стал медленнее.
Monitoring:
throughput ↓;
utilization примерно прежняя;
clocks ↓;
temperature ↑;
появляется thermal-related clock event.
Здесь thermal branch становится сильной гипотезой.
Проверить:
inlet/cooling;
airflow;
fan/cooling subsystem;
соседнюю нагрузку;
vendor health/error signals.
Пример 3. GPU utilization низкая, server медленный
Monitoring:
throughput низкий;
utilization низкая;
queue почти отсутствует;
hardware incident evidence не появилось;
host→device/data path интенсивен;
CPU/input pipeline загружен.
Вероятная ветка:
accelerator ждёт данные.
Более мощная GPU сама по себе проблему может не исправить.
Пример 4. Memory pressure без CUDA OOM
Monitoring:
KV-cache occupancy высокая;
preemptions растут;
waiting queue растёт;
TTFT/ITL ухудшаются;
CUDA OOM нет.
Это сильный signal:
исследовать memory/scheduler pressure.
Но не готовый вывод:
доказано физически не хватает VRAM.
Root cause определяется отдельным troubleshooting workflow.
Что передавать в поддержку
Вместо одного screenshot полезно собрать единый пакет.
Infrastructure
server/node;
GPU SKU;
UUID;
topology;
driver;
OS.
Application
model/revision;
runtime;
application/container version.
Workload
request/job type;
batch/context;
input/output;
concurrency.
User symptom
latency;
throughput;
errors.
Metric definitions
monitoring source;
version;
units;
measurement definition.
Runtime
queue;
running/waiting;
cache;
preemptions.
GPU
utilization;
VRAM;
clocks;
power;
temperature;
constraint events.
Reliability
ECC/RAS;
XID/vendor events;
health-watch result;
PCIe/fabric.
Changes
deploy;
driver update;
reboot/reset;
config change.
Такой пакет позволяет быстрее разделить:
Application Bottleneck
от
Runtime Pressure
от
GPU Operating Constraint
от
Главное
Мониторинг GPU-сервера нельзя строить вокруг одного графика utilization.
Рабочая последовательность выглядит так:
User Symptom
→ Defined Application SLI
→ Runtime / Queue / Cache
→ GPU Resource State
→ Constraint Evidence
→ PCIe / GPU Fabric
→ Health / Error Evidence
→ Incident Timeline
→ Root Cause Hypothesis
→ Corrective Action
→ Verify SLI.
Ключевые границы:
GPU Utilization ≠ Health.
GPU Utilization ≠ Application Performance.
VRAM Used ≠ Memory Pressure.
Low Clock ≠ Throttling without Evidence.
NVLink Traffic ≠ NVLink Health.
DCGM Health PASS ≠ Performance PASS.
Passive Monitoring ≠ Active Diagnostics.
XID ≠ Root Cause by Itself.
Interesting Metric ≠ Alert Condition.
No Observed Health Incident ≠ Proven Healthy Hardware.
Metric Name ≠ Measurement Definition.
Для LLM-serving особенно важно хранить точное определение latency metrics. В текущем vLLM Prometheus TTFT, ITL и TPOT имеют собственную measurement semantics, а per-request TTFT/ITL используют другие lifecycle timestamps.
Точно так же hardware telemetry нужно читать в контексте workload: utilization показывает использование accelerator, clocks/power/temperature и clock/violation events — operating constraints, а ECC, XID и health results дают evidence для hardware/driver investigation.
Если GPU-инфраструктура поставляется для production AI-нагрузки Start Server, telemetry, dashboard, SLO и alerting лучше определить вместе с workload ещё до перехода системы в промышленную эксплуатацию.
CTA: Обсудить мониторинг поставляемой GPU-инфраструктуры.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


