NLP, или Natural Language Processing, это направление искусственного интеллекта и компьютерной лингвистики, которое позволяет программам анализировать, преобразовывать и генерировать человеческий язык. Входом может быть текст или расшифровка речи, а результатом становится класс, найденная сущность, перевод, краткое содержание, ответ или новый текст.
Цель обработки естественного языка определяется задачей. Одной системе нужно извлечь номер договора, другой определить тему обращения, третьей найти документ, четвертой сформировать ответ. Поэтому NLP не является одной программой или одной нейросетью.
Что относится к NLP
К обработке естественного языка относятся:
классификация текста и определение тематики;
анализ тональности;
извлечение именованных сущностей, NER;
определение частей речи и синтаксических связей;
информационный поиск и semantic search;
машинный перевод;
суммаризация;
вопросно-ответные системы;
проверка и нормализация текста;
генерация текста и диалоговые системы.
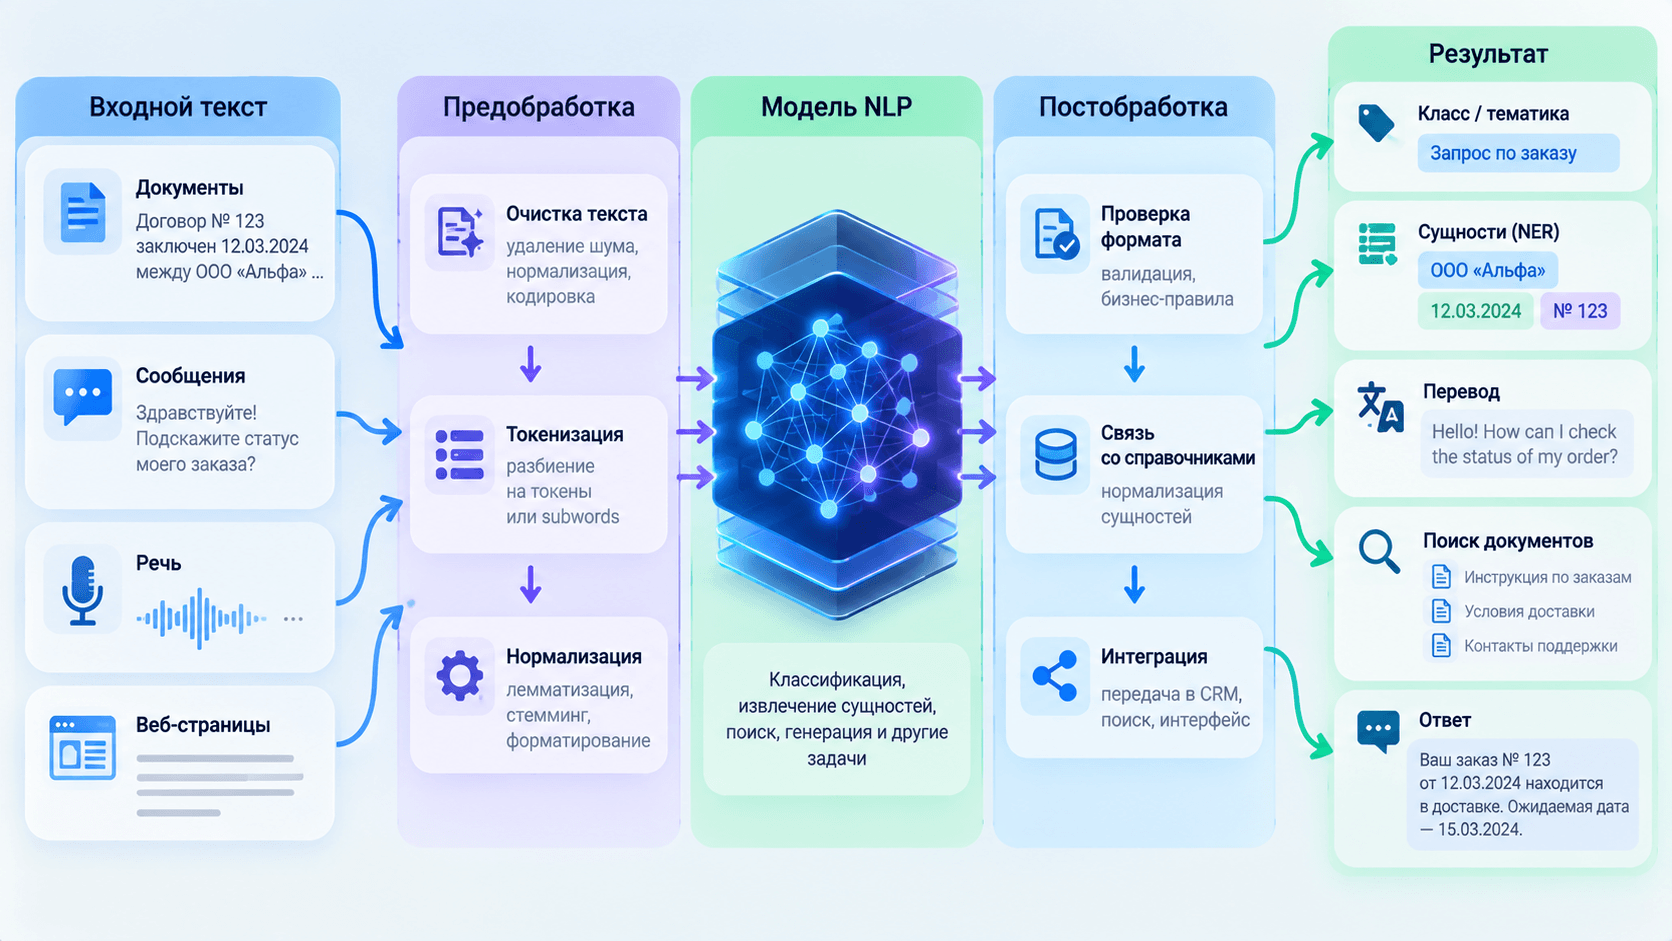
Как работает система обработки естественного языка
Реальный pipeline зависит от задачи, но часто включает пять уровней.
1. Получение и очистка данных
Система читает документы, сообщения, таблицы или результаты speech-to-text. На этом этапе исправляют encoding, выделяют структуру, удаляют технический мусор и сохраняют источник. Ошибка OCR или неверная кодировка может испортить результат до запуска модели.
2. Токенизация и нормализация
Текст разбивается на слова, subword units или другие токены. Для классических алгоритмов могут применяться лемматизация, stemming и удаление части служебных элементов. Для transformer models чрезмерная ручная нормализация иногда вредна, поскольку меняет тот формат, на котором модель обучалась.
3. Представление текста
Классические системы используют counts, TF-IDF и вручную заданные признаки. Нейронные модели формируют embeddings, которые кодируют контекстные признаки. Как устроено векторное представление и retrieval, разобрано в статье об эмбеддингах в RAG.
4. Модель
Модель выполняет классификацию, sequence labeling, генерацию или другую операцию. Это может быть логистическая регрессия, CRF, CNN, RNN, transformer, encoder model или большая языковая модель.
5. Постобработка и интеграция
Приложение проверяет формат, применяет business rules, связывает сущности со справочниками, учитывает права доступа и передает результат в CRM, поиск или интерфейс. Даже точная модель бесполезна, если система не обрабатывает пустой ответ, низкую уверенность и конфликт версий.
Основные задачи NLP
Задача | Пример входа | Результат | Типовая метрика |
|---|---|---|---|
Классификация | обращение клиента | тема или маршрут | precision, recall, F1 |
NER | договор или счет | организация, дата, сумма | entity-level F1 |
Sentiment analysis | отзыв | тональность | F1, accuracy с учетом баланса классов |
Поиск | вопрос пользователя | релевантные документы | Recall@k, MRR, nDCG |
Перевод | текст на одном языке | текст на другом | автоматические метрики и human evaluation |
Суммаризация | длинный документ | краткое содержание | factuality, coverage, human evaluation |
Question answering | вопрос и контекст | ответ с основанием | correctness, groundedness, citation accuracy |
Генерация | instruction и context | новый текст | качество, фактичность, безопасность, latency |
Методы обработки естественного языка
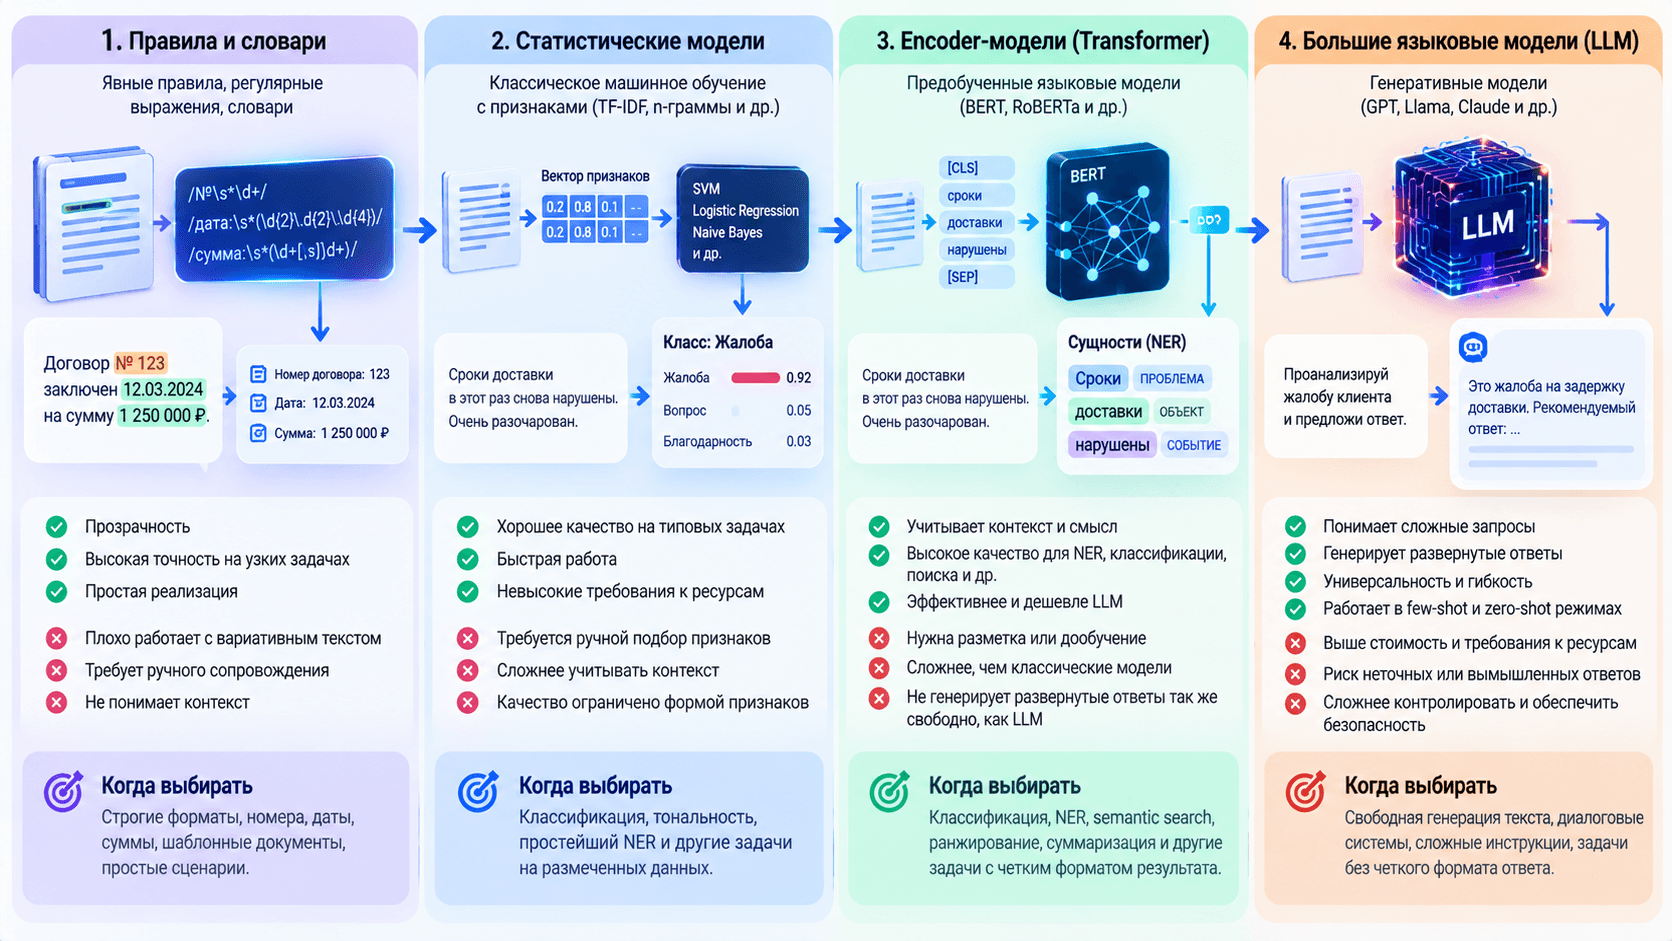
Правила и словари
Регулярные выражения, грамматики и словари дают контролируемый результат для узких форматов. Они хорошо работают с номерами, шаблонными кодами и строгими документами. Цена состоит в ручной поддержке вариантов и исключений.
Статистическое машинное обучение
Модель обучается на признаках и размеченных примерах. Такие решения остаются полезными для маршрутизации, фильтрации и классификации, особенно когда данных немного, классы стабильны и требуется низкая задержка.
Нейронные сети
CNN и RNN научились извлекать признаки из последовательностей, а transformers сделали удобным pretraining на крупных корпусах с последующей адаптацией. Базовое устройство разных архитектур раскрыто в статье что такое нейронная сеть.
Большие языковые модели
LLM способны выполнять много языковых задач через instruction и примеры в контексте. Они упрощают прототипирование, но могут генерировать неподтвержденные ответы, требуют контроля данных и создают заметную вычислительную нагрузку. Устройство большой языковой модели разобрано отдельно.
NLP, NLU и NLG
NLP является широким термином. Natural Language Understanding, NLU, обычно относится к извлечению смысла: intent, entities, relations и контекст. Natural Language Generation, NLG, описывает создание текста. В одном продукте эти части могут работать последовательно.
Компьютерная лингвистика изучает формальные и вычислительные модели языка шире конкретного продукта. В прикладной разработке границы терминов пересекаются, поэтому полезнее фиксировать вход, выход и метрики, чем спорить о названии модуля.
Особенности обработки русского языка
Русский язык имеет развитую морфологию, согласование, склонения и сравнительно свободный порядок слов. Одна сущность встречается в разных падежах, а смысл может зависеть от контекста и отрицания. Дополнительные проблемы создают е и ё, смешение кириллицы с латиницей, сокращения, опечатки и отраслевые обозначения.
Примеры применения NLP
Маршрутизация писем и заявок по теме и срочности.
Извлечение реквизитов из договоров, счетов и актов.
Поиск по базе знаний с учетом смысла запроса.
Анализ отзывов и причин обращений.
Сравнение версий документов.
Помощник оператора с найденными источниками.
Суммаризация встреч и длинных отчетов.
Машинный перевод и локализация.
Для медицины, права, финансов и других чувствительных областей результат должен проходить предметную проверку. Запросы Wordstat о задачах NLP в медицине показывают интерес к теме, но не дают основания обещать клиническую пригодность произвольной модели.
Как выбрать модель для NLP
Начните не с рейтинга моделей, а с таблицы ошибок. Зафиксируйте:
Входные данные, язык, длину и домен.
Выходной формат и допустимые ошибки.
Наличие разметки и эталонного набора.
Требования к объяснимости и ссылкам на источник.
Допустимую задержку, throughput и стоимость запроса.
Ограничения на передачу данных во внешние сервисы.
Частоту обновления и drift.
Для извлечения пяти стабильных полей из шаблонного документа LLM может оказаться избыточной. Для сложного диалога с длинным контекстом маленького классификатора недостаточно. Часто лучший production pipeline сочетает правила, компактные модели, retrieval и LLM.
Инфраструктура для NLP
Классические модели и preprocessing обычно работают на CPU. Neural encoders, rerankers и LLM получают заметное ускорение на GPU. Память зависит от размера модели, precision, batch, длины последовательности и числа одновременных запросов.
Массовая обработка документов дополнительно нагружает CPU, RAM и хранилище. Online-сервис требует очередей, batching, monitoring и резервирования. Для закрытого контура пригодны локальные нейросети без интернета, если все модели и зависимости развернуты внутри площадки.
FAQ
Что такое NLP простыми словами?
Это набор методов, с помощью которых программа работает с человеческим языком: анализирует текст, извлекает данные, ищет смысл, переводит или генерирует ответ.
Какова цель обработки естественного языка?
Цель состоит в преобразовании языка в результат конкретной задачи, например класс, список сущностей, перевод, найденный документ или ответ.
NLP относится к искусственному интеллекту?
Да, прикладное NLP обычно рассматривают как направление AI. При этом оно опирается и на лингвистику, статистику, правила и программную инженерию.
Чем NLP отличается от нейролингвистического программирования?
Natural Language Processing является вычислительной обработкой языка. Нейролингвистическое программирование относится к другому понятию и не является значением NLP в этой статье.
Все ли NLP-системы используют нейросети?
Нет. В production применяются правила, словари, классические ML-модели, нейронные сети и их комбинации.
NLP и LLM являются одним и тем же?
Нет. NLP является областью задач и методов. LLM представляет один класс моделей, который способен решать многие NLP-задачи.
Нужна ли GPU для NLP?
Для правил и компактных моделей часто достаточно CPU. GPU нужна крупным neural models, высокой параллельности или массовой пакетной обработке.
Как запустить NLP-проект
Соберите реальные примеры, определите выход и стоимость ошибок, разметьте контрольный набор, затем сравните простой baseline и более сложные модели. После измерения качества, latency и памяти можно выбирать сервер.
Start Server помогает рассчитать CPU, GPU, RAM, VRAM и storage для NLP pipeline и подготовить программу испытаний. Для оценки передайте тип задачи, модели-кандидаты, размер корпуса, длину входа, параллельность и требования к данным через контакты.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


