Б/у GPU-сервер нельзя принимать только потому, что он загружается, все ускорители видны системе, а диагностическая утилита показывает зелёный статус.
До покупки нужно доказать, какие именно физические экземпляры входят в поставку, какая часть их истории действительно доступна, что показывает текущее состояние и выдерживают ли GPU активные проверки памяти, PCIe/interconnect, compute и power/thermal path. Отдельно нужно определить гарантию и процедуру замены.
Рабочая последовательность:
condition definition
↓
exact device identity
↓
available history
↓
current passive health
↓
active GPU diagnostics
↓
PCIe / NVLink / XGMI
↓
power / thermal
↓
storage + server platform
↓
warranty / replacement
↓
CLEAR / CONDITIONAL /
UNKNOWN / REJECT
Главное правило:
И сразу три ограничения:
GPU видна системой
≠
исправность доказана
current health clean
≠
история эксплуатации чистая
active test PASS
≠
прогноз оставшегося срока службы
Сначала выясните, что означает «б/у» или refurbished
Б/У, used, refurbished и восстановленный не следует считать техническими синонимами.
В одном предложении refurbishment может означать диагностику и обслуживание. В другом — замену компонентов. Поэтому вместо предположения нужно получить письменное определение статуса конкретной поставки.
Поле | Что зафиксировать |
Condition label | NEW / USED / REFURBISHED / OTHER |
Определение | что этот статус означает |
Кто присвоил | OEM / интегратор / продавец |
История эксплуатации | известна / частична / неизвестна |
Выполненные работы | диагностика, ремонт, обслуживание |
Заменённые компоненты | exact part numbers, если известны |
Проверка после работ | scope |
Diagnostic report | есть / нет |
Warranty | scope / duration / exclusions |
Если продавец не может объяснить, что именно означает refurbished, в condition record ставится:
DEFINITION:
UNKNOWN
Это точнее, чем самостоятельно считать оборудование «полностью восстановленным».
Результаты тестов должны принадлежать конкретным экземплярам
Запись:
GPU 0 — PASS
GPU 1 — PASS
недостаточна для поставки, если после тестирования карты могли переставить или заменить.
Для каждой GPU полезно сохранить:
Server serial
↓
physical slot
↓
exact GPU SKU
↓
serial, если доступен
↓
UUID
↓
PCI BDF
↓
diagnostic artifact
NVIDIA XID logs связывают события с GPU GUID и PCI bus/device/function; NVIDIA описывает GUID как глобально уникальный неизменяемый идентификатор GPU. Это позволяет сопоставлять ошибку не просто с локальным индексом GPU 0, а с конкретным устройством.
AMD SMI также показывает устройства с BDF и UUID и поддерживает выбор конкретных GPU через эти identifiers.
Практический вывод:
История эксплуатации и состояние сейчас — не одно и то же
Это ключевая часть проверки used equipment.
NVIDIA DCGM Health Monitoring является пассивной системой: она анализирует сохранённые telemetry samples и не создаёт специальную нагрузку на GPU. Результат Healthy означает, что включённые health rules не нашли incident в retained data. Он не означает, что наблюдались абсолютно все подсистемы или что GPU прошла active stress test.
Глубина такой истории тоже ограничена. DCGM позволяет задавать sampling interval и maximum keep age; более короткий retention может удалить evidence предыдущего события. Watches также являются состоянием работающего host engine и не сохраняются как бессрочный архив через его restart.
Следовательно, допустимая формулировка:
В доступном окне telemetry выбранные DCGM health checks не обнаружили incident.
Недопустимая:
GPU за весь срок эксплуатации не имела ошибок.
Зафиксируйте, какую историю вы вообще получили
Источник | Период / статус |
BMC / system event log | |
Kernel / driver logs | |
GPU telemetry | |
Previous diagnostic reports | |
Repair records | |
Previous workload/use | KNOWN / PARTIAL / UNKNOWN |
Если monitoring существует только последние семь дней, всё более раннее время следует обозначить:
EARLIER HISTORY:
UNKNOWN
а не:
EARLIER ERRORS:
0
Почему nvidia-smi недостаточно
Тот факт, что GPU обнаружена driver и показывает температуру, память или utilization, — полезный inventory/current-state signal, но не полная аппаратная проверка.
DCGM active diagnostics разделяет тесты по назначению. В актуальной документации NVIDIA есть отдельные plugins для framebuffer memory, PCIe и peer paths, sustained compute/data-path workload, targeted compute stress, targeted power, GPU copy paths через NVLink/PCIe и специализированного memtest.
Поэтому логика проверки выглядит так:
GPU detected
↓
inventory confirmed
↓
not yet enough
memory
PCIe
interconnect
compute
power / thermal
XID — диагностический сигнал, а не готовый приговор
NVIDIA определяет XID как сообщение driver о GPU-related error в kernel/event log. Причиной может оказаться hardware problem, NVIDIA software или пользовательское приложение. Сам производитель рекомендует воспринимать XID как отправную точку расследования: одного номера не всегда достаточно для определения root cause.
Поэтому некорректны обе формулы:
XID exists
→ GPU defective
и:
XID not found
→ GPU healthy
Для события лучше хранить:
XID code:
Timestamp:
GPU GUID / PCI BDF:
Workload/context:
Repeated:
Immediate action:
Investigatory action:
Follow-up diagnostic:
Final disposition:
NVIDIA GPU memory: одного ECC = 0 недостаточно
Memory condition нужно разделять как минимум на текущие RAS-сигналы и активную проверку.
CURRENT RAS EVIDENCE
correctable / uncorrectable
page retirement
pending retirement
row-remap state
+
ACTIVE MEMORY EVIDENCE
memory test
memtest if applicable
DCGM предоставляет отдельный memory test для framebuffer allocation/read/write/data patterns и observed memory errors. Отдельный memtest предназначен для более специализированных address, bit, coupling, retention и data-pattern tests.
Следовательно:
ECC now = 0
не равно:
active memory diagnostic = PASS
и ни одно из этих утверждений не доказывает полную эксплуатационную историю.
Не используйте универсальный ECC threshold
Нельзя сделать общий закупочный стандарт:
0 → accept
1 → reject
для всех NVIDIA generations.
RAS mechanisms, page retirement, row remapping и vendor diagnostic interpretation зависят от конкретного поколения и software stack. Поэтому threshold должен следовать из документации exact GPU и согласованной программы приёмки, а не из универсальной таблицы статьи.
PCIe и GPU interconnect проверяются отдельно
Наличие всех ускорителей в inventory ещё не доказывает состояние data path между ними.
DCGM pcie отдельно нагружает PCIe и peer-to-peer paths и проверяет bandwidth, latency, link state и error counters. nvbandwidth предназначен для проверки доступных GPU copy paths через NVLink и PCIe.
Для multi-GPU сервера condition record должен иметь хотя бы:
Layer | Result / artifact |
PCIe link/path | |
Host ↔ GPU | |
GPU ↔ GPU | |
PCIe errors/replays | |
NVLink, если применим | |
NVSwitch, если применим | |
Copy-path diagnostic |
То есть:
8 GPUs visible
не означает автоматически:
8-GPU data path validated
Sustained load нужен для поиска проблем, которые не проявляются в idle
DCGM targeted_stress поддерживает sustained matrix workload с заданным performance target и во время выполнения следит также за memory, thermal, PCIe и другими GPU conditions.
Но это не создаёт универсальной нормы:
30 минут всегда достаточно
или:
24 часа гарантируют исправность
У тестов есть собственные parameters и продолжительность, а набор DCGM diagnostic suites также различается: quick, medium, long и extra-long включают разные проверки.
В отчёте важнее сохранить:
Tool/version:
Test:
Target devices:
Parameters:
Duration:
Environment:
PASS / FAIL / SKIP:
New errors:
Artifact:
Power test тоже требует контекста
DCGM targeted_power создаёт sustained compute load и пытается вывести GPU к заданному уровню board power. При этом проверяются operating conditions и ряд ошибок.
Особенно важное ограничение: если установленный power limit делает заданный target недостижимым, DCGM выделяет это как configuration constraint, а не как доказательство аппаратной неисправности.
Поэтому вместо одной строки:
POWER TEST:
FAIL
полезнее:
Configured target:
Effective power limit:
Observed power:
Temperature:
Thermal events:
Other errors:
Result:
Reason:
Даже полный DCGM PASS не равен полной аппаратной экспертизе
Это критическая оговорка.
NVIDIA прямо разделяет online diagnostics и полную hardware validation: DCGM tests работают внутри текущего software/hardware environment, а для complete hardware validation и RMA могут требоваться отдельные offline NVIDIA diagnostics.
Поэтому в Final запрещена формулировка:
DCGM PASS = GPU полностью исправна.
Корректнее:
Для AMD нужен другой diagnostic path
NVIDIA XID и DCGM нельзя использовать как универсальный язык диагностики любого accelerator.
AMD SMI предоставляет свой RAS stack. Актуальная документация AMD описывает correctable, uncorrectable и deferred ECC counts, в том числе breakdown по отдельным hardware blocks; CPER records содержат source, type, severity, timestamp и другую diagnostic information.
AMD SMI также предоставляет информацию о bad pages. Такие страницы могут иметь статус pending, reserved или unreservable, причём AMD отдельно отмечает, что причина retirement определяется ECC/RAS information, а не одним статусом страницы.
Минимальная AMD-ветка:
IDENTITY
Exact SKU:
UUID:
BDF:
RAS
Correctable:
Uncorrectable:
Deferred:
Per-block if supported:
CPER if available:
MEMORY PAGES
Pending:
Reserved / retired:
Unreservable:
INTERCONNECT
PCIe:
XGMI:
ACTIVE VALIDATION
Tool:
Test:
Parameters:
Duration:
Result:
SOFTWARE
AMD SMI:
ROCm:
NOT SUPPORTED нельзя превращать в ноль
AMD SMI API явно предусматривает случаи, когда определённая функция или metric не поддерживается на платформе.
Поэтому:
ECC metric:
NOT SUPPORTED
не равно:
ECC errors:
0
Это общее правило condition evidence: отсутствие наблюдаемого показателя не является доказательством отсутствия события.
XGMI counters тоже требуют правильной интерпретации
Для XGMI-систем после recovery/reset AMD рекомендует оценивать exposed error counters относительно baseline и смотреть на появление новых или растущих ошибок, поскольку некоторые counters являются cumulative.
Следовательно, универсальное требование:
all XGMI counters must equal 0
может быть методически неверным.
Важно понимать semantics конкретного counter и его delta.
Storage: SMART PASSED тоже недостаточно
Б/у GPU-сервер — это не только ускорители.
NVMe SMART/Health разделяет несколько сигналов состояния и эксплуатации: Critical Warning, endurance/Percentage Used, Power On Hours, Unexpected Power Losses/ранее Unsafe Shutdowns, Media and Data Integrity Errors и Error Information Log Entries.
Поэтому по каждому NVMe лучше зафиксировать:
Поле | Значение |
Exact SKU / serial | |
Critical Warning | |
Available Spare | |
Percentage Used | |
Power On Hours | |
Unexpected Power Losses / Unsafe Shutdowns | |
Media/Data Integrity Errors | |
Error Log | reviewed / not reviewed |
Percentage Used показывает расход endurance и должен интерпретироваться вместе с требованиями и specification конкретного накопителя, а не как универсальный порог статьи.
Error Log entry не равна автоматическому failure SSD
Официальный NVMe-CLI guide отдельно отмечает, что наличие Error Log entries не обязательно означает failure устройства: записи полезны для debugging и требуют анализа содержания ошибки.
То есть принцип тот же, что для GPU XID:
Нужно проверить и остальную платформу
Исправные GPU не компенсируют проблему системной платы, DIMM, PSU, cooling или BMC.
Condition Passport должен предусматривать:
BMC event log
firmware inventory
CPU
RAM
PSU
fans / cooling
NIC
storage/controller
risers / backplanes
physical inspection
Но universal thresholds вроде:
fan RPM > X = PASS
DIMM corrected errors < Y = PASS
в статье не задаются.
Они должны исходить из diagnostics и документации exact OEM platform.
Physical inspection остаётся отдельным слоем
Software telemetry не покажет все виды повреждений.
Для used equipment нужно визуально проверить как минимум доступные компоненты и признаки вмешательства:
connectors
retention hardware
risers / cables
PCB / repair traces
heatsinks
airflow path
liquid-cooling connections
if applicable
Физический осмотр тоже не заменяет активную диагностику — это другой тип evidence.
Гарантия и replacement являются частью condition risk
Тестирование уменьшает неопределённость, но не устраняет её.
До сделки нужно определить:
какие компоненты покрываются
кто даёт гарантию
какие serial numbers
входят в coverage
exclusions
first-line support
кто диагностирует defect
кто выполняет replacement
какое событие является
основанием замены
Фраза:
Warranty: 12 months
не описывает весь risk, если непонятно, распространяется ли она на GPU, storage и third-party components и как происходит замена.
GPU Server Condition & Acceptance Passport
Это основной рабочий инструмент SS-019.
DEAL
Supplier:
Quote ID:
Date:
Condition label:
Definition:
Assigned by:
Warranty summary:
Replacement owner:
SERVER IDENTITY
OEM:
Model:
Exact SKU:
Serial:
Asset tag:
BMC version:
BIOS:
Firmware baseline:
GPU INVENTORY
GPU 1
Manufacturer:
Exact SKU:
Serial, if exposed:
UUID:
PCI BDF:
Physical slot:
GPU 2
...
PROVENANCE
Previous use:
KNOWN / PARTIAL / UNKNOWN
Operating history:
AVAILABLE / PARTIAL / UNKNOWN
Repair/refurbishment record:
AVAILABLE / PARTIAL / UNKNOWN
Components replaced:
Performed by:
Date:
HISTORY EVIDENCE
BMC log period:
Kernel/driver log period:
GPU telemetry period:
Previous diagnostic reports:
Known historical events:
Unobserved period:
UNKNOWN
NVIDIA
IF APPLICABLE
DCGM version:
PASSIVE HEALTH
Enabled watches:
Sampling:
Retention:
Observation period:
Result:
Artifact:
XID
Codes:
Timestamps:
GPU GUID/BDF:
Context:
Repeated:
Investigation:
Disposition:
MEMORY
RAS evidence:
Page retirement:
Row-remap state:
Active memory:
Memtest if applicable:
INTERCONNECT
PCIe:
NVLink:
NVSwitch:
GPU-to-GPU path:
Artifact:
ACTIVE DIAGNOSTICS
Diagnostic:
Targeted stress:
Targeted power:
NVBandwidth:
Parameters:
Duration:
Environment:
PASS / FAIL / SKIP:
New errors:
Artifacts:
AMD
IF APPLICABLE
AMD SMI version:
ROCm version:
GPU UUID:
BDF:
RAS
Correctable:
Uncorrectable:
Deferred:
Per-block:
CPER:
MEMORY PAGES
Pending:
Reserved/retired:
Unreservable:
INTERCONNECT
PCIe:
XGMI:
Active validation:
Parameters:
Duration:
Result:
Artifacts:
THERMAL / POWER
Test workload:
Duration:
Environment:
Temperature:
Power:
Throttling/violations:
New events:
Artifact:
STORAGE
Drive SKU:
Serial:
Critical Warning:
Available Spare:
Percentage Used:
Power On Hours:
Unexpected Power Losses
/ Unsafe Shutdowns:
Media/Data Integrity Errors:
Error Log:
REVIEWED / NOT REVIEWED
SYSTEM
BMC events:
CPU:
RAM:
PSU:
Fans/cooling:
NIC:
Risers/backplanes:
Firmware:
Physical inspection:
SUPPORTABILITY
Required OS:
Driver:
CUDA / ROCm:
Runtime:
Supported:
YES / CONDITIONAL / NO
WARRANTY
Server:
GPU:
Storage:
Other:
Duration:
Exclusions:
REPLACEMENT
First-line owner:
Trigger:
Procedure:
Replacement type:
Time commitment:
if contractually defined
FINAL EVIDENCE STATUS
Identity:
CLEAR / CONDITIONAL /
UNKNOWN / REJECT
History:
CLEAR / CONDITIONAL /
UNKNOWN / REJECT
Current GPU state:
CLEAR / CONDITIONAL /
UNKNOWN / REJECT
Active diagnostics:
CLEAR / CONDITIONAL /
UNKNOWN / REJECT
System:
CLEAR / CONDITIONAL /
UNKNOWN / REJECT
Warranty/replacement:
CLEAR / CONDITIONAL /
UNKNOWN / REJECT
OVERALL:
CLEAR
CONDITIONAL
UNKNOWN
REJECT
Почему не нужен средний health score
Не стоит превращать Passport в:
Condition score:
86 / 100
Среднее число может скрыть один критический blocker.
Например:
GPU diagnostics:
CLEAR
storage:
CLEAR
serial identity:
CLEAR
GPU warranty:
UNKNOWN
Для одной компании это допустимый commercial risk.
Для другой — blocker закупки.
Поэтому используем четыре статуса:
Статус | Что означает |
CLEAR | необходимое evidence есть, условие выполнено |
CONDITIONAL | нужен дополнительный документ/test/action |
UNKNOWN | evidence отсутствует или недоступно |
REJECT | подтверждённое состояние нарушает обязательное требование |
Принцип:
UNKNOWN
≠
PASS
UNKNOWN
≠
FAIL
При этом закупочная политика вправе установить:
Condition Evidence Ladder
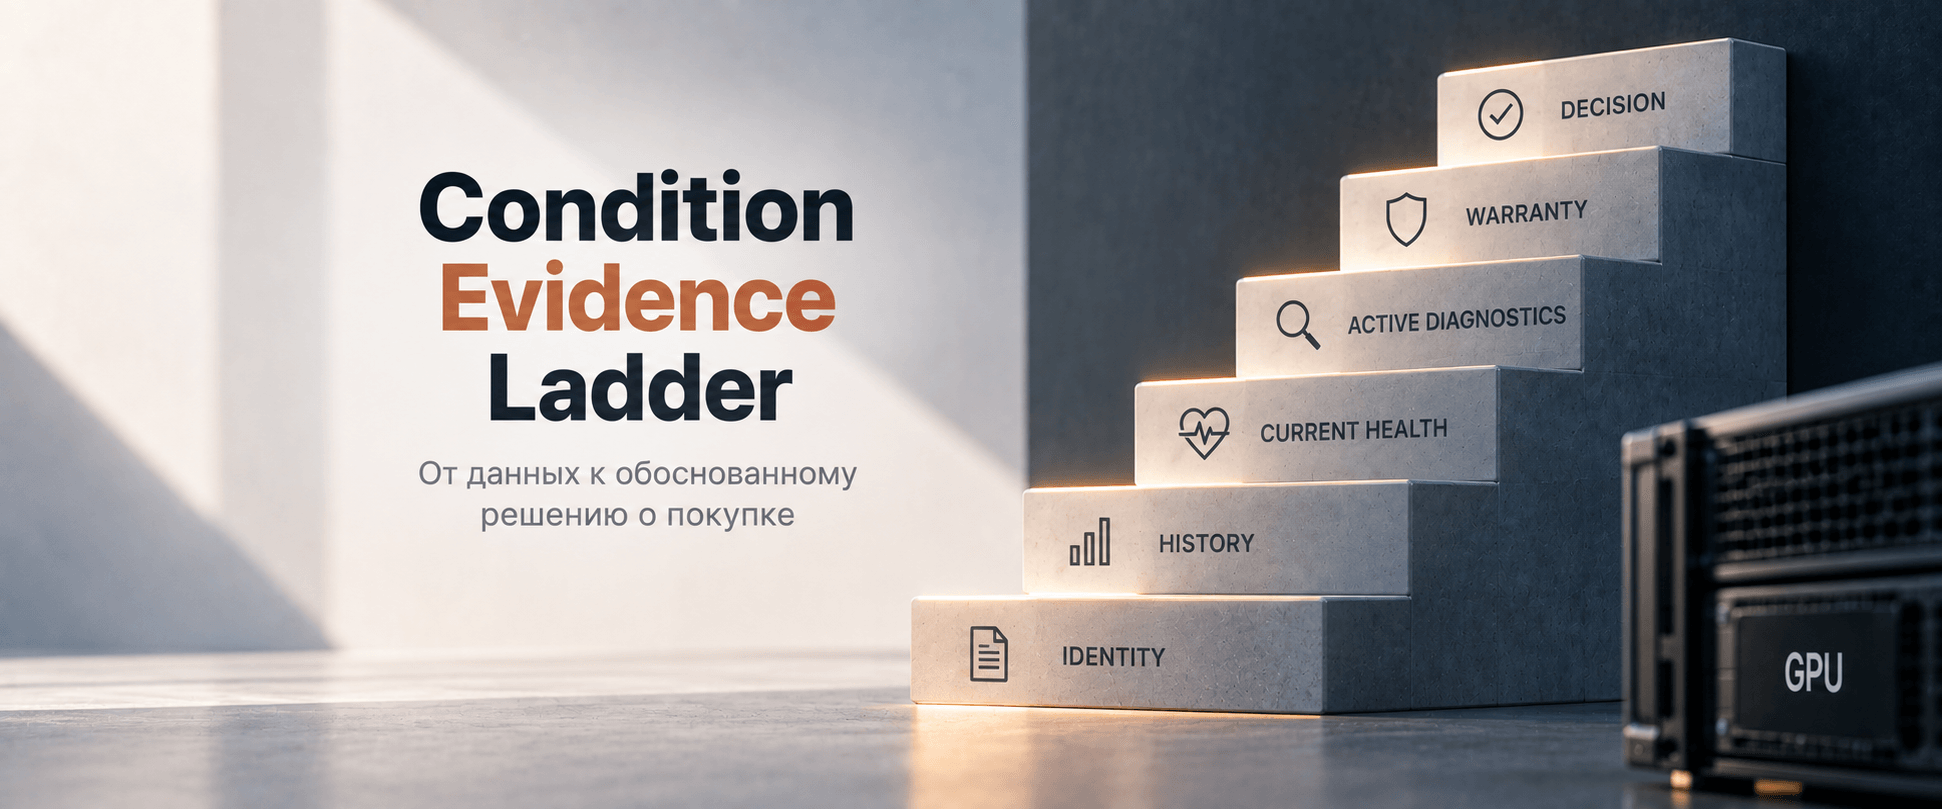
Для сравнения полноты доказательств можно использовать вспомогательную шкалу:
LEVEL 0
seller says:
«работает»
↓
LEVEL 1
exact inventory
+ stable identities
↓
LEVEL 2
available history
+ system logs
↓
LEVEL 3
current passive
GPU health
↓
LEVEL 4
active GPU diagnostics
↓
LEVEL 5
thermal / power /
interconnect validation
↓
LEVEL 6
target workload
acceptance
↓
LEVEL 7
warranty /
replacement responsibility
documented
Уровень 6 здесь только обозначает необходимость production-relevant acceptance. Полную программу, thresholds и pass/fail criteria нужно раскрывать отдельно в SS-045.
Что успешный test package всё равно не доказывает
Даже серьёзная проверка не позволяет автоматически написать:
за весь срок эксплуатации
ошибок не было
оборудование никогда
не ремонтировалось
GPU гарантированно
прослужат ещё N лет
failure probability = 0
любой будущий workload
будет stable
NVIDIA прямо предупреждает, что online DCGM diagnostics выполняются в текущем окружении и не заменяют полную offline hardware validation, которая может требоваться, в частности, для RMA.
Поэтому правильная интерпретация:
Что запросить у поставщика до оплаты
IDENTITY
exact server BOM
server serial
GPU identities
CONDITION
written definition
used / refurbished
repair/replacement record
HISTORY
BMC logs
driver/kernel logs
GPU telemetry
available observation period
CURRENT STATE
vendor-specific
health/RAS evidence
ACTIVE TESTS
memory
PCIe/interconnect
compute
power/thermal
tool/version
parameters
duration
raw report
STORAGE/SYSTEM
NVMe health
BMC/platform diagnostics
COMMERCIAL
warranty scope
exclusions
replacement owner
replacement trigger
procedure
Если часть информации объективно отсутствует, её не нужно заполнять предположением.
Правильное значение:
UNKNOWN.
Итоговый алгоритм проверки
1. Определить,
что означает condition label
↓
2. Сверить exact BOM
и physical identities
↓
3. Получить доступную историю
↓
4. Отметить periods UNKNOWN
↓
5. Снять current passive health
↓
6. Проверить vendor-specific RAS
↓
7. Выполнить active GPU tests
↓
8. Проверить PCIe/interconnect
↓
9. Проверить sustained load
↓
10. Проверить storage
↓
11. Проверить server platform
↓
12. Связать artifacts
с конкретными devices
↓
13. Зафиксировать warranty
и replacement
↓
14. CLEAR / CONDITIONAL /
UNKNOWN / REJECT
Так объектом решения становится не абстрактное:
б/у сервер
а конкретная:
BOM
+
physical devices
+
condition evidence
+
warranty/replacement responsibility
Запросить требования к приёмке оборудования
Для подготовки требований достаточно собрать:
server model / SKU
condition из предложения
GPU manufacturer
exact GPU SKU/count
serials / UUID,
если известны
диагностические отчёты,
если уже предоставлены
доступную историю:
BMC / GPU / storage
целевой workload
требования:
warranty
replacement
acceptance
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


