NPU, Neural Processing Unit, представляет специализированный вычислительный блок для операций нейронных сетей. Он оптимизирован для inference с низким энергопотреблением и часто входит в состав процессора ноутбука, смартфона, edge-устройства или отдельного AI-ускорителя.
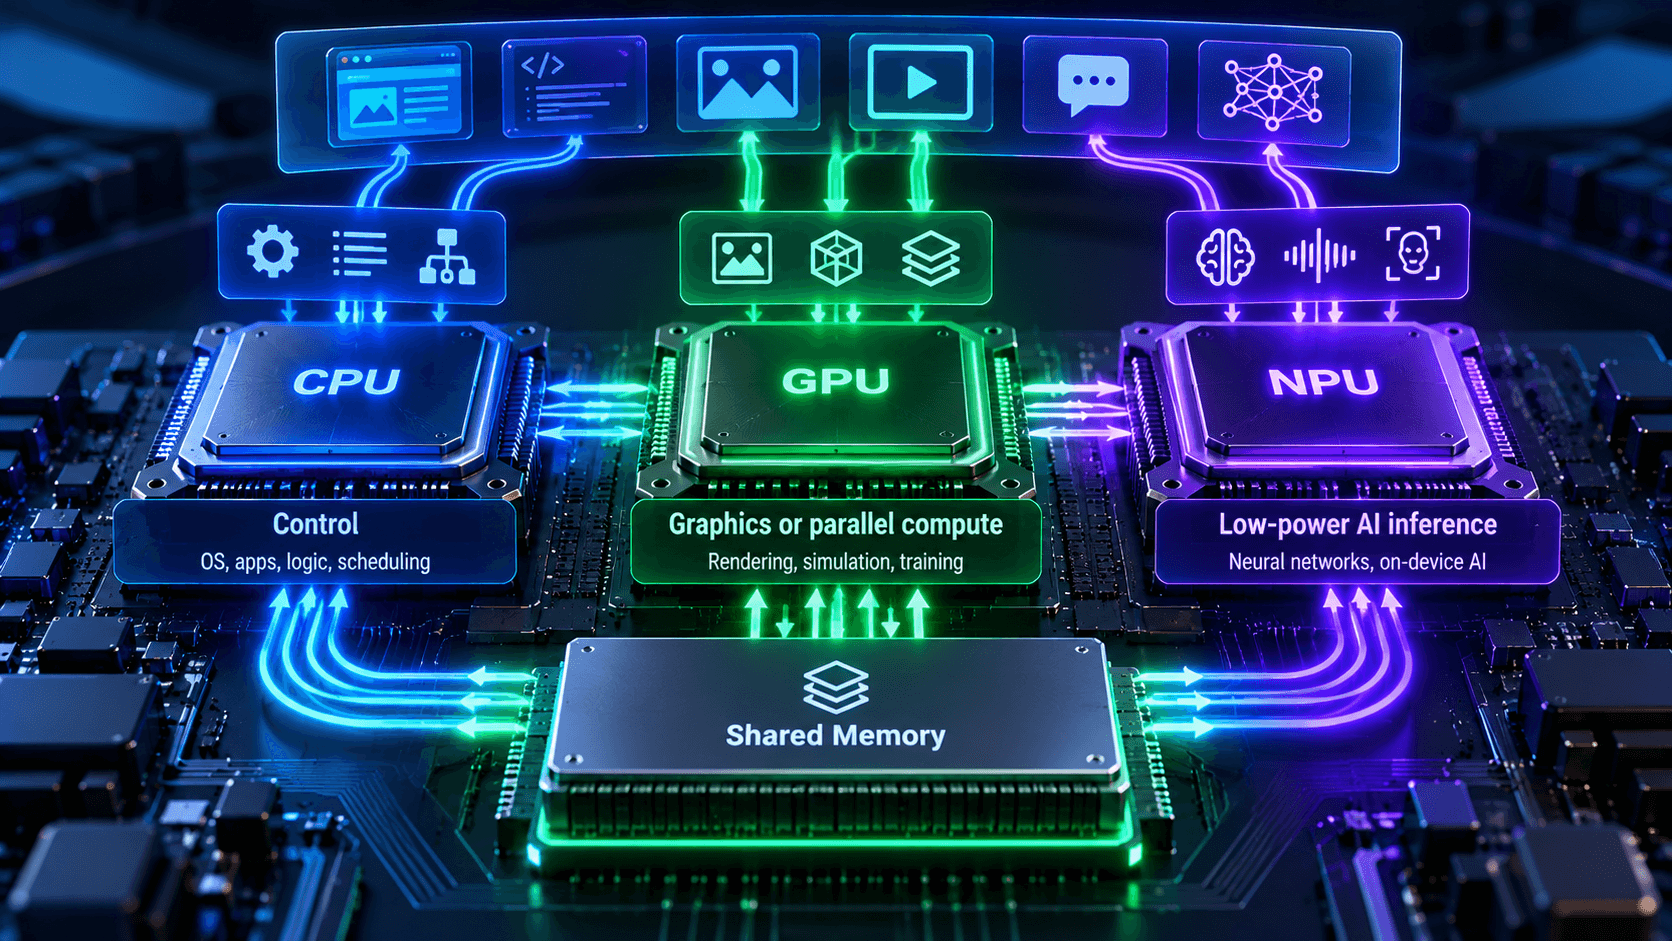
NPU не заменяет CPU и GPU. CPU управляет системой и выполняет разнообразный код. GPU дает высокую параллельную производительность и широкий AI software stack. NPU эффективно выполняет поддерживаемый граф модели, особенно при постоянной on-device нагрузке и ограничении по питанию.
Что такое NPU в компьютере
В AI PC NPU обычно встроен в один package или SoC с CPU и integrated GPU. Он имеет tensor или matrix units, локальную память, DMA и firmware для выполнения скомпилированного neural network graph.
Типовой путь выглядит так:
Приложение загружает модель через framework или API.
Execution provider проверяет поддерживаемые operators и data types.
Compiler преобразует и оптимизирует graph под конкретный NPU.
Runtime размещает tensors и запускает operations.
Неподдерживаемые части остаются на CPU или GPU, если fallback разрешен.
Приложение получает output и выполняет postprocessing.
Что находится внутри NPU
Конкретная архитектура зависит от производителя, но обычно присутствуют:
массивы multiply-accumulate units для matrix и tensor operations;
vector и scalar blocks;
on-chip SRAM или scratchpad;
DMA engines для переноса данных;
hardware scheduler;
support для INT8, FP16 и других data types;
compiler и runtime, которые раскладывают graph по блокам.
NPU старается держать данные рядом с вычислениями и уменьшать энергозатратные обращения к внешней памяти. Это дает высокую производительность на ватт для подходящих operators, но снижает универсальность относительно CPU и части GPU workloads.
CPU, GPU и NPU: в чем разница
Критерий | CPU | GPU | NPU |
|---|---|---|---|
Назначение | универсальный код и управление | massively parallel compute и graphics | neural network inference |
Сильная сторона | гибкость и low-latency control | throughput и зрелый AI stack | power efficiency на поддерживаемых моделях |
Типичные задачи | preprocessing, logic, database, fallback | training, крупный inference, video и HPC | camera effects, audio, OCR, compact models |
Память | system RAM и cache | VRAM или shared memory | shared system memory и on-chip buffers либо память модуля |
Программирование | самый широкий набор tools | CUDA, ROCm, graphics и AI runtimes | vendor compiler, execution provider и API |
Operator coverage | высокая | высокая в поддерживаемом framework | уже и зависит от поколения |
Обучение | возможно для малых задач | основной accelerator для deep learning | чаще inference, training support ограничен |
GPU и NPU нельзя сравнивать по названию. Discrete GPU потребляет больше энергии, но способен запускать крупную модель, training и unsupported operators. NPU выигрывает на sustained on-device inference, если graph хорошо компилируется.
Для каких задач используют NPU
Видеоконференции
Background blur, eye contact, noise suppression и framing должны работать постоянно, не разряжая батарею и не занимая GPU. Это естественный сценарий для встроенного NPU.
Компьютерное зрение на edge
Камера или промышленный controller выполняет classification, detection, segmentation или OCR рядом с источником данных. Низкое энергопотребление и отсутствие cloud latency важнее максимальной гибкости.
Речь и аудио
NPU может обслуживать keyword spotting, denoising, transcription и небольшие speech models. Streaming требует устойчивой latency, а не одной пиковой цифры.
Локальные языковые модели
Компактные language models можно запускать на NPU при поддержке operators, quantization, context и runtime. Большая LLM способна не поместиться в memory или использовать неподдерживаемые layers. CPU or GPU fallback иногда сводит на нет экономию.
Безопасность и персонализация
On-device inference оставляет часть данных на устройстве, снижает network dependency и latency. Конфиденциальность все равно зависит от приложения, telemetry, logs и обновлений, а не только от места вычисления.
Что такое TOPS у NPU
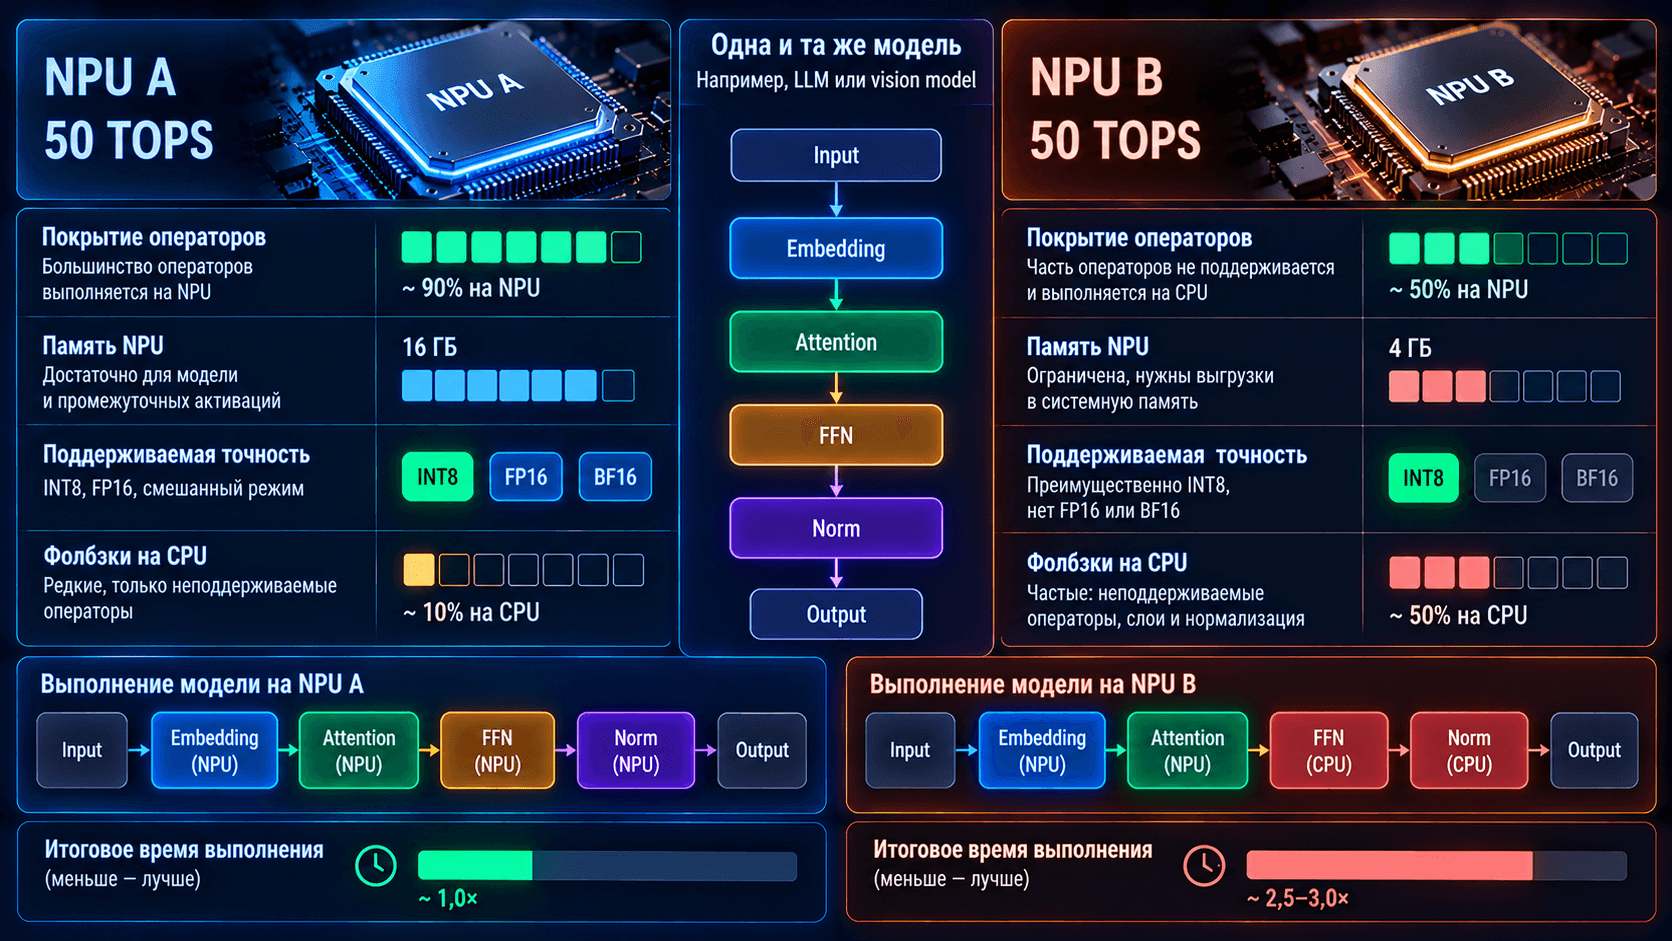
TOPS означает trillion operations per second, теоретический peak количества операций. Производители часто считают INT8 operations и могут по-разному учитывать sparsity. Поэтому NPU 50 TOPS не гарантирует более быстрый inference, чем другой accelerator с меньшей цифрой.
Для честного сравнения фиксируют:
precision, например INT8 или FP16;
sparsity и способ подсчета operation;
модель и input shape;
supported operators и fallback;
batch size;
latency и throughput;
power consumption;
memory traffic;
качество после quantization.
Intel NPU и Intel AI Boost
Intel называет встроенный NPU в поддерживаемых Core Ultra Intel AI Boost. Точная производительность и operator support зависят от поколения и модели процессора. Наличие NPU проверяют в product specification, а в Windows он отображается в Task Manager на поддерживаемой системе.
Для разработки применяются Windows ML, OpenVINO и vendor execution providers. Приложение должно направить graph на NPU. Установка Intel NPU driver сама по себе не переносит существующую CUDA или CPU-программу на AI Boost.
При выборе ноутбука с Intel NPU проверяют:
точный Core Ultra SKU;
NPU TOPS отдельно от total platform TOPS;
driver и OS version;
список поддерживаемых приложений;
RAM capacity и bandwidth;
длительную power envelope, а не короткий peak.
AMD NPU и Ryzen AI
AMD Ryzen AI объединяет CPU, Radeon GPU и NPU на архитектуре XDNA или XDNA2 в зависимости от поколения. Workload может выполняться на одном или нескольких blocks, если software stack поддерживает распределение.
AMD NPU driver нужен для взаимодействия runtime с hardware. Версия driver, firmware, framework и модель должны быть совместимы. Перенос модели включает export, quantization, compile и проверку numerical accuracy.
Qualcomm Hexagon NPU
Hexagon NPU входит в Snapdragon platforms. Qualcomm описывает fused architecture со scalar, vector и tensor accelerators и shared memory. Он предназначен для on-device inference с низким энергопотреблением.
В Snapdragon X Elite NPU заявлен на 45 TOPS, а более новые Snapdragon X Series могут иметь другие показатели. Версию platform нужно указывать точно. Для разработки используются Qualcomm AI Hub, QNN и поддерживаемые Windows execution providers.
Hexagon иллюстрирует, почему NPU является частью heterogeneous system. CPU обрабатывает control flow, GPU параллельную graphics или general compute нагрузку, а NPU поддерживаемую AI-часть.
Встроенный, внешний и серверный NPU
Встроенный NPU
Находится в SoC или processor package, использует shared memory и оптимизирован по энергопотреблению. Распространен в ноутбуках, смартфонах и embedded devices.
Внешний NPU-модуль
Подключается через M.2, PCIe, USB или proprietary interface. Примеры edge-class решений встречаются у Hailo и других vendors. Нужно проверять lane bandwidth, охлаждение, supported models, compiler и количество video streams.
Серверный AI-ускоритель
Некоторые специализированные accelerator cards также называются NPU. Они могут иметь собственную HBM или DRAM, high-speed interconnect и software ecosystem. Huawei Ascend, Baidu Kunlun и другие platforms не являются drop-in заменой NVIDIA CUDA GPU. Model porting и runtime compatibility проверяют отдельно.
Как использовать NPU
1. Найти целевой API
На Windows это может быть Windows ML, vendor execution provider или application-specific API. На embedded platform применяют SDK производителя.
2. Проверить format модели
Runtime может принимать ONNX, TFLite или vendor intermediate representation. Нужны поддерживаемые opset, shapes и data types.
3. Провести quantization
NPU часто оптимизирован для INT8 или другого low precision. После quantization проверяют качество на representative dataset, а не только успешную компиляцию.
4. Скомпилировать и разделить graph
Compiler отмечает supported operators. Если часть graph уходит на CPU, появляются transfer overhead и дополнительные synchronization points.
5. Измерить end-to-end
Сравнивайте CPU, GPU и NPU на одинаковом input и качестве. Фиксируйте latency, throughput, power, memory и thermal behavior после прогрева.
6. Настроить fallback
Production-приложение должно корректно работать без NPU или при ошибке driver, если бизнес-требования это допускают. Версия модели и execution provider журналируются.
Работает ли Ollama на NPU
Название Ollama в системе не означает автоматическое использование NPU. Нужен backend, который поддерживает конкретный NPU, model format, quantization и operators. Если backend использует CPU или GPU, наличие NPU в ноутбуке не изменит путь вычисления.
Проверяйте release notes Ollama, operating system, vendor runtime и фактическую utilization. Task Manager или vendor profiler должен показать нагрузку NPU, а benchmark должен включать time to first token, tokens per second и power.
В каких процессорах есть NPU
NPU встречаются в поддерживаемых Intel Core Ultra, AMD Ryzen AI, Qualcomm Snapdragon и других SoC. Название family недостаточно, поскольку внутри серии могут быть SKU с разной NPU performance или без нужной функции.
Порядок проверки:
Записать полный processor SKU.
Открыть official specifications.
Найти отдельную NPU section.
Проверить TOPS и data type.
Проверить driver для нужной ОС.
Проверить execution provider приложения.
Запустить representative model.
NPU или GPU для локального ИИ
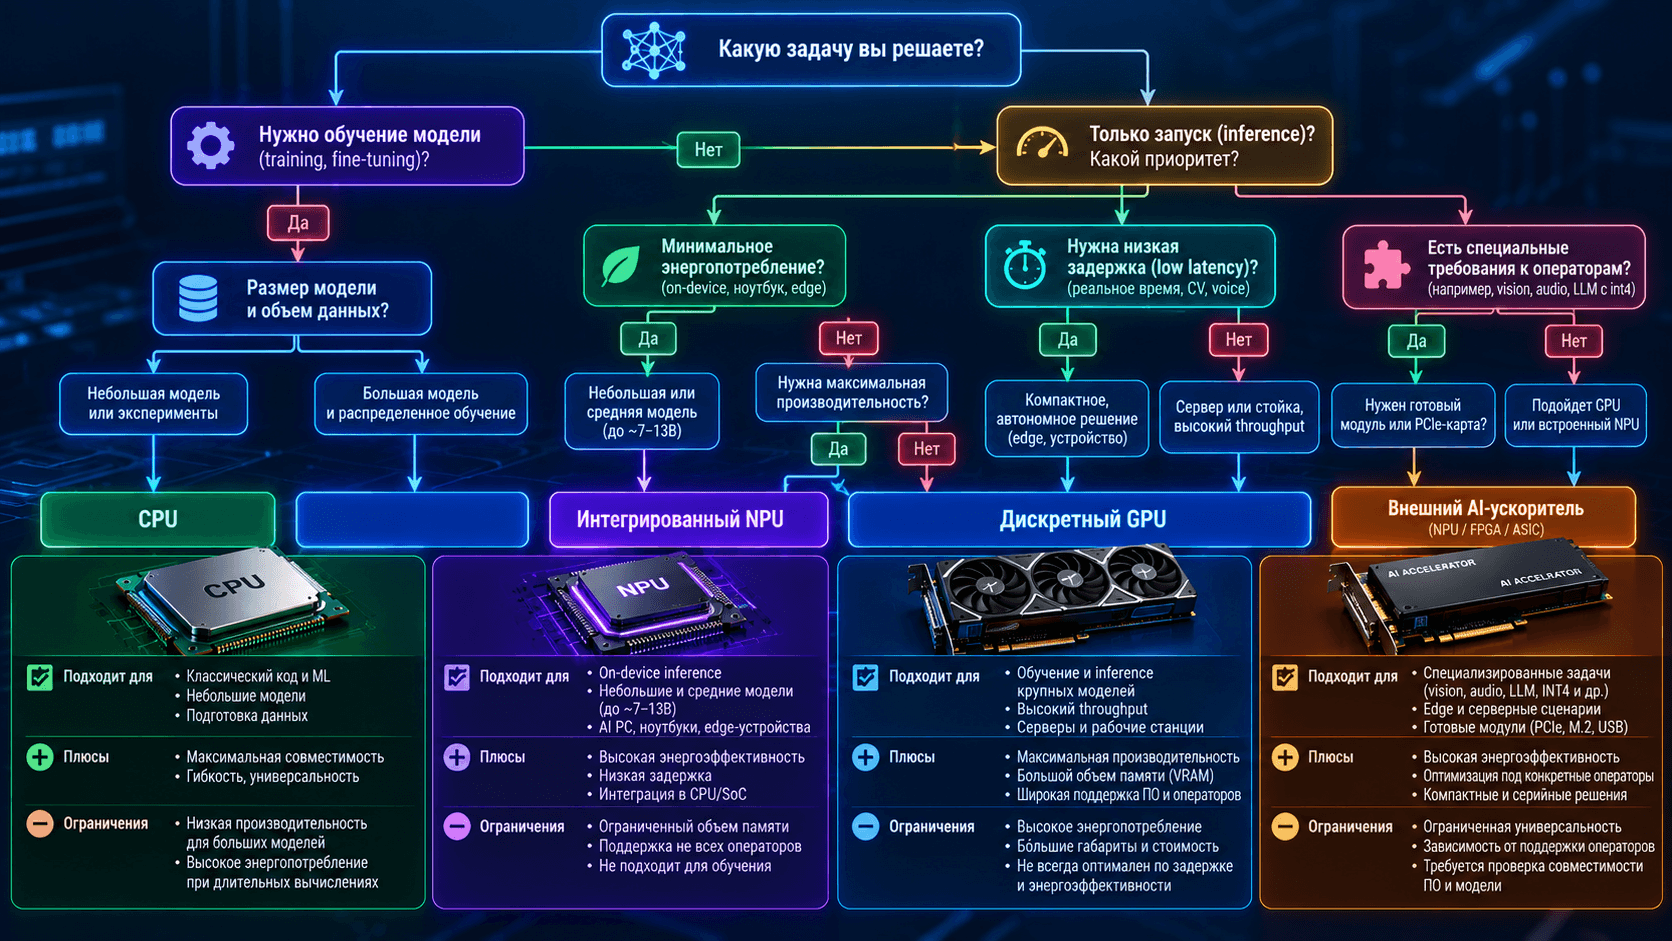
Выбирайте NPU, если модель поддерживается, должна работать долго, важны battery или низкая мощность, а latency и качество проходят тест.
Выбирайте GPU, если требуется training, крупная модель, широкий operator coverage, высокая throughput, mature CUDA или ROCm stack либо несколько frameworks.
CPU остается разумным вариантом для small model, редкого запроса, control-heavy pipeline и универсального fallback. Нередко лучшая система использует все три процессора.
Сценарий | Первый кандидат | Причина |
|---|---|---|
Background effects в видеозвонке | NPU | sustained low-power inference |
Обучение нейросети | GPU | gradients, memory и framework support |
Небольшой редкий classifier | CPU | простота и отсутствие transfer overhead |
Локальная компактная LLM | NPU или GPU | зависит от backend, memory и operators |
Большая LLM и высокий throughput | discrete GPU или AI accelerator | память и software ecosystem |
Камера на edge | NPU-module | power, latency и form factor |
Как выбрать NPU или компьютер с NPU
Определите модель и input shapes.
Найдите официальный supported model or operator list.
Проверьте precision и влияние quantization на качество.
Уточните NPU TOPS и методику подсчета.
Проверьте memory capacity и bandwidth всей platform.
Сверьте OS, driver, firmware и runtime.
Измерьте fallback на CPU or GPU.
Проверьте sustained performance под thermal limit.
Оцените latency, power и качество на своих данных.
Зафиксируйте procedure обновления driver и модели.
Типичные ошибки
Считать NPU универсальным ускорителем любого кода.
Ожидать automatic offload без integration.
Сравнивать TOPS при разных precision и sparsity.
Складывать CPU, GPU и NPU TOPS как реальную скорость приложения.
Игнорировать unsupported operators и fallback.
Не проверять качество после INT8 quantization.
Покупать ноутбук по marketing term AI PC без точного SKU.
Считать integrated NPU заменой discrete GPU для training.
Запускать крупную LLM без расчета memory.
Не фиксировать driver и runtime versions.
Переносить model между Intel, AMD и Qualcomm без recompilation.
Путать NPU с другими значениями аббревиатуры.
FAQ
Что такое NPU простыми словами?
Это специализированный processor для выполнения операций нейронных сетей, обычно с упором на быстрый и энергоэффективный inference.
Что означает NPU в компьютере?
Это отдельный AI compute block рядом с CPU и GPU. Он может выполнять camera, audio, OCR и другие supported AI features локально.
Чем NPU отличается от CPU?
CPU универсален и силен в control-heavy коде. NPU менее универсален, зато эффективнее выполняет поддерживаемые tensor operations.
Чем NPU отличается от GPU?
GPU дает высокую parallel throughput и широкий stack для training и inference. NPU оптимизирован для low-power inference и имеет более узкий operator coverage.
Что такое NPU TOPS?
Это теоретическое количество триллионов операций в секунду при заданном precision и условиях подсчета. TOPS не равны скорости конкретного приложения.
Что значит NPU 50 TOPS?
Производитель заявляет peak 50 трлн operations per second, обычно для low-precision AI math. Нужно проверить методику, модель, power и runtime.
В каких процессорах есть NPU?
В поддерживаемых Intel Core Ultra, AMD Ryzen AI, Qualcomm Snapdragon и других SoC. Наличие и характеристики проверяют по точному SKU.
Можно ли добавить внешний NPU?
Да, существуют M.2, PCIe и USB modules, а также server-class cards. Совместимость зависит от interface, driver, SDK, model compiler и cooling.
Можно ли использовать NPU для LLM?
Да, если runtime поддерживает architecture, operators, quantization и memory requirements модели. Для крупных LLM GPU или server accelerator обычно дает больше гибкости.
Как понять, использует ли программа NPU?
Проверить выбранный execution provider, profiling и hardware utilization. Сам факт наличия NPU не доказывает его использование.
Нужен ли ноутбук с NPU?
Он полезен, если используемые приложения имеют NPU path и важна энергоэффективная локальная работа. Для training или software без NPU support преимущество может не проявиться.
Что передать для подбора NPU-решения
Укажите модель, format, operators, precision, input shapes, latency, throughput, power budget, ОС, runtime и требования к локальности. Start Server поможет сравнить NPU, GPU и server-class accelerators, подобрать модуль или систему и провести совместимость на тесте. Передать вводные можно через контакты Start Server.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


