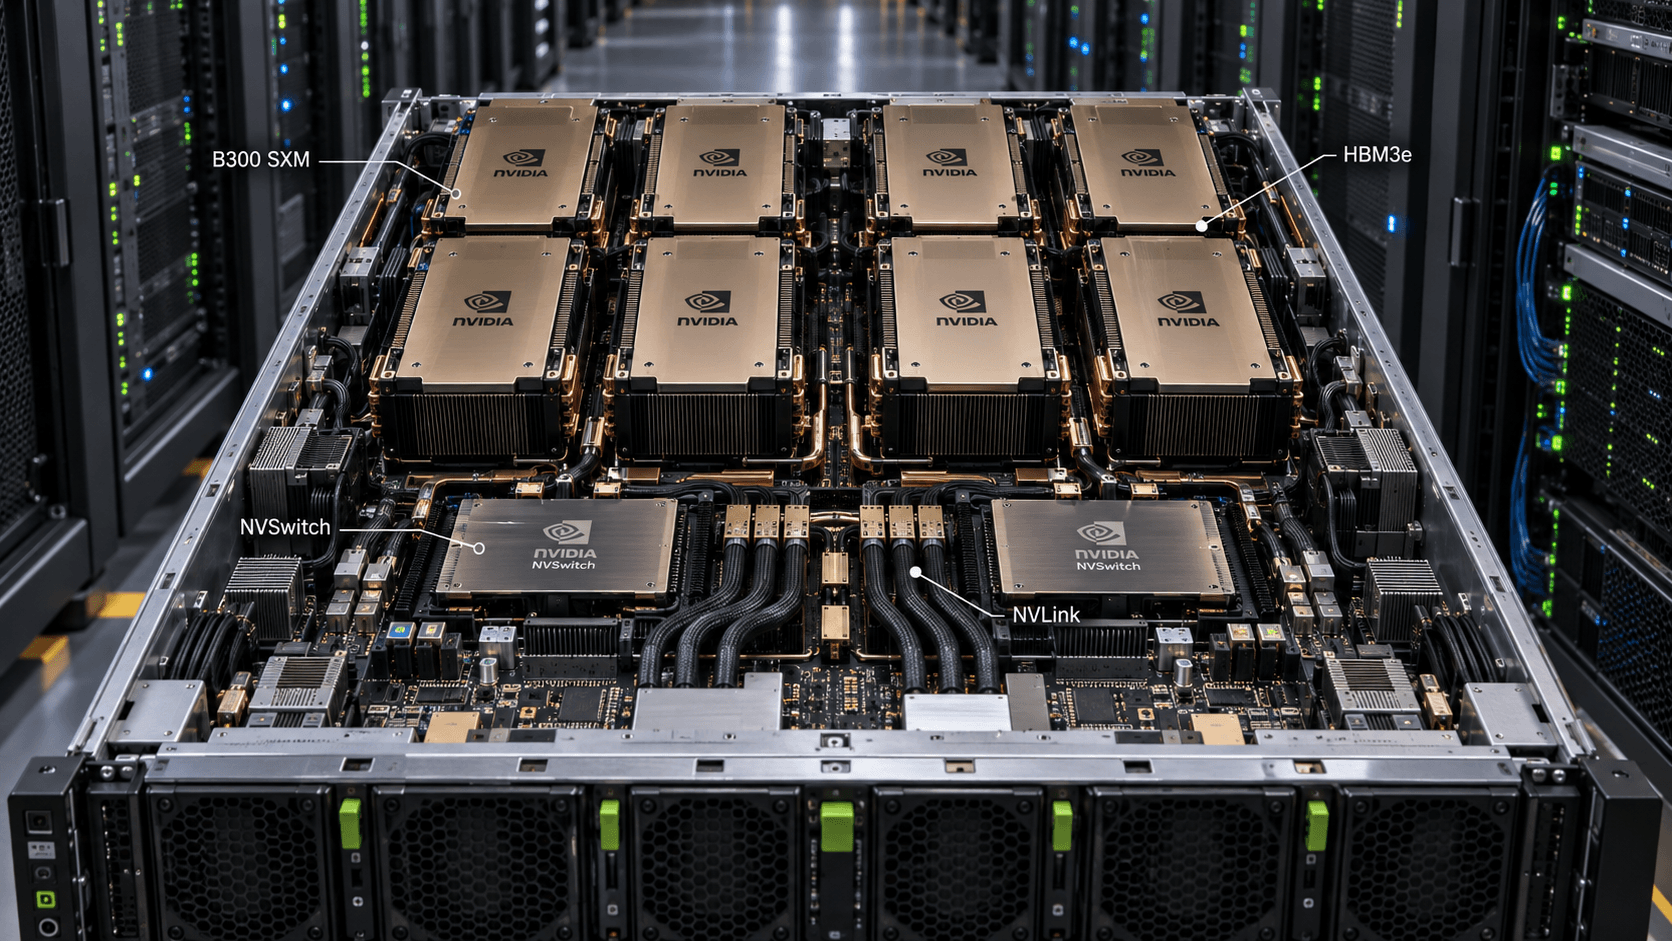
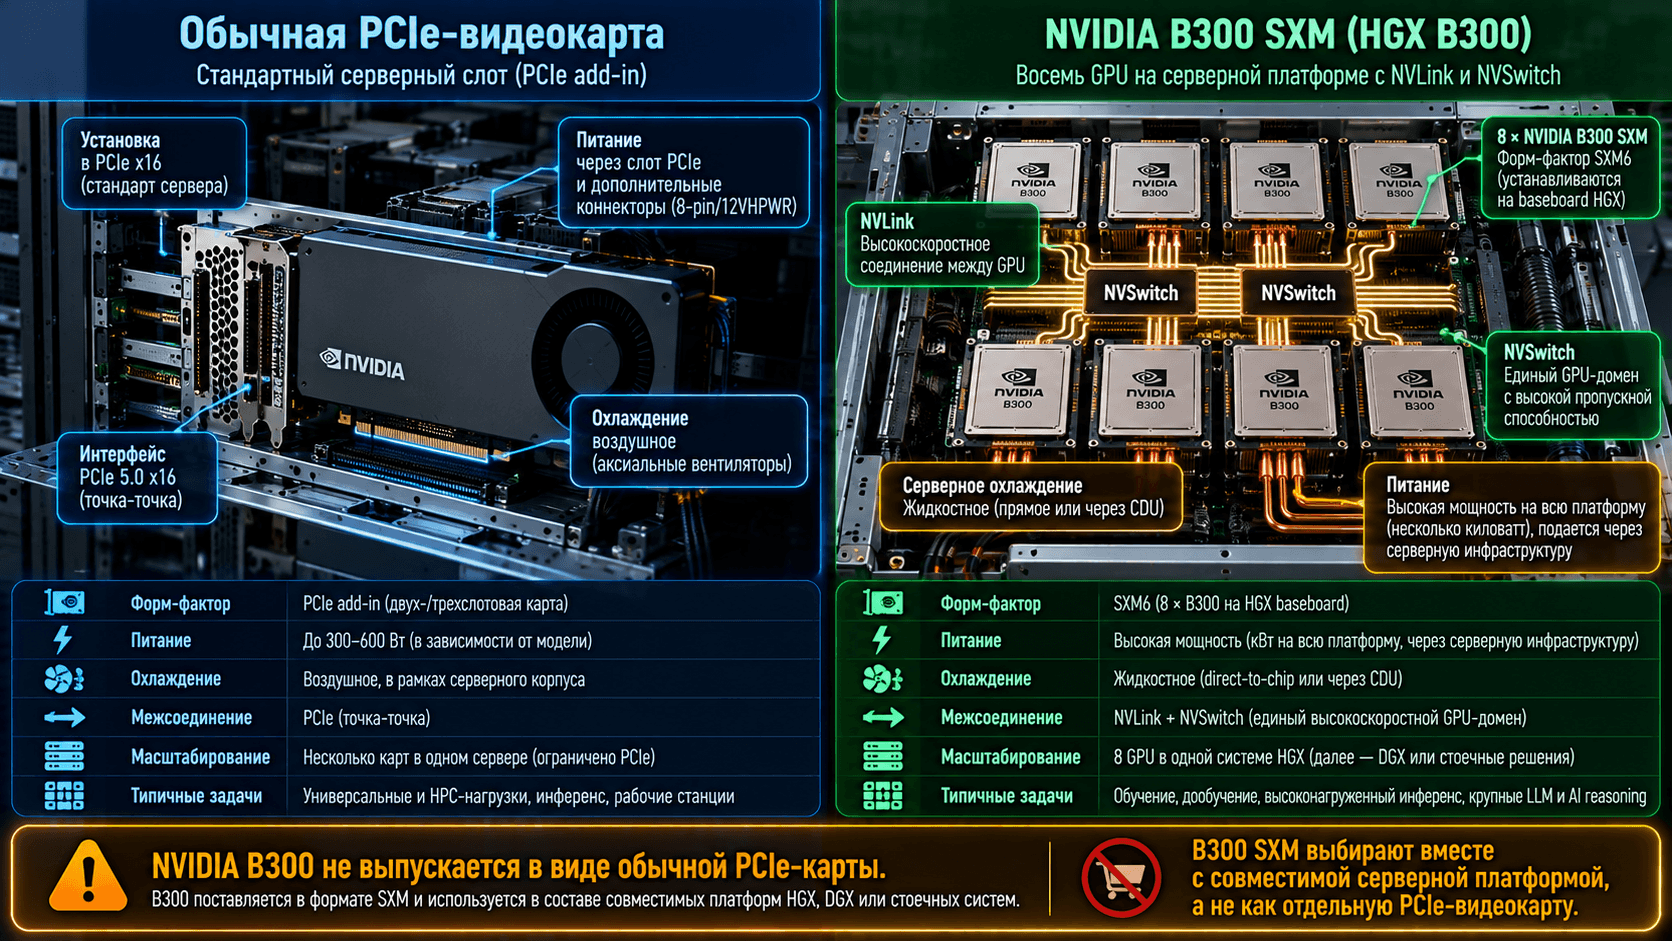
NVIDIA B300 представляет собой датацентровый GPU поколения Blackwell Ultra для обучения, дообучения и высоконагруженного инференса моделей искусственного интеллекта. Ускоритель устанавливается в специализированные SXM-системы, а не продается как обычная игровая или универсальная PCIe-видеокарта. Типичная платформа HGX B300 объединяет восемь GPU через NVLink и NVSwitch.
Главные изменения относительно B200 сосредоточены вокруг AI reasoning и крупных моделей: увеличенный объем HBM3e, более высокая производительность плотного FP4 и ускорение операций attention. Это не делает B300 лучшим выбором для любой задачи. Платформа дорога, требовательна к питанию, охлаждению, сети и хранилищу. Для классических FP64-расчетов она может оказаться менее подходящей, чем B200 или специализированный HPC-ускоритель.
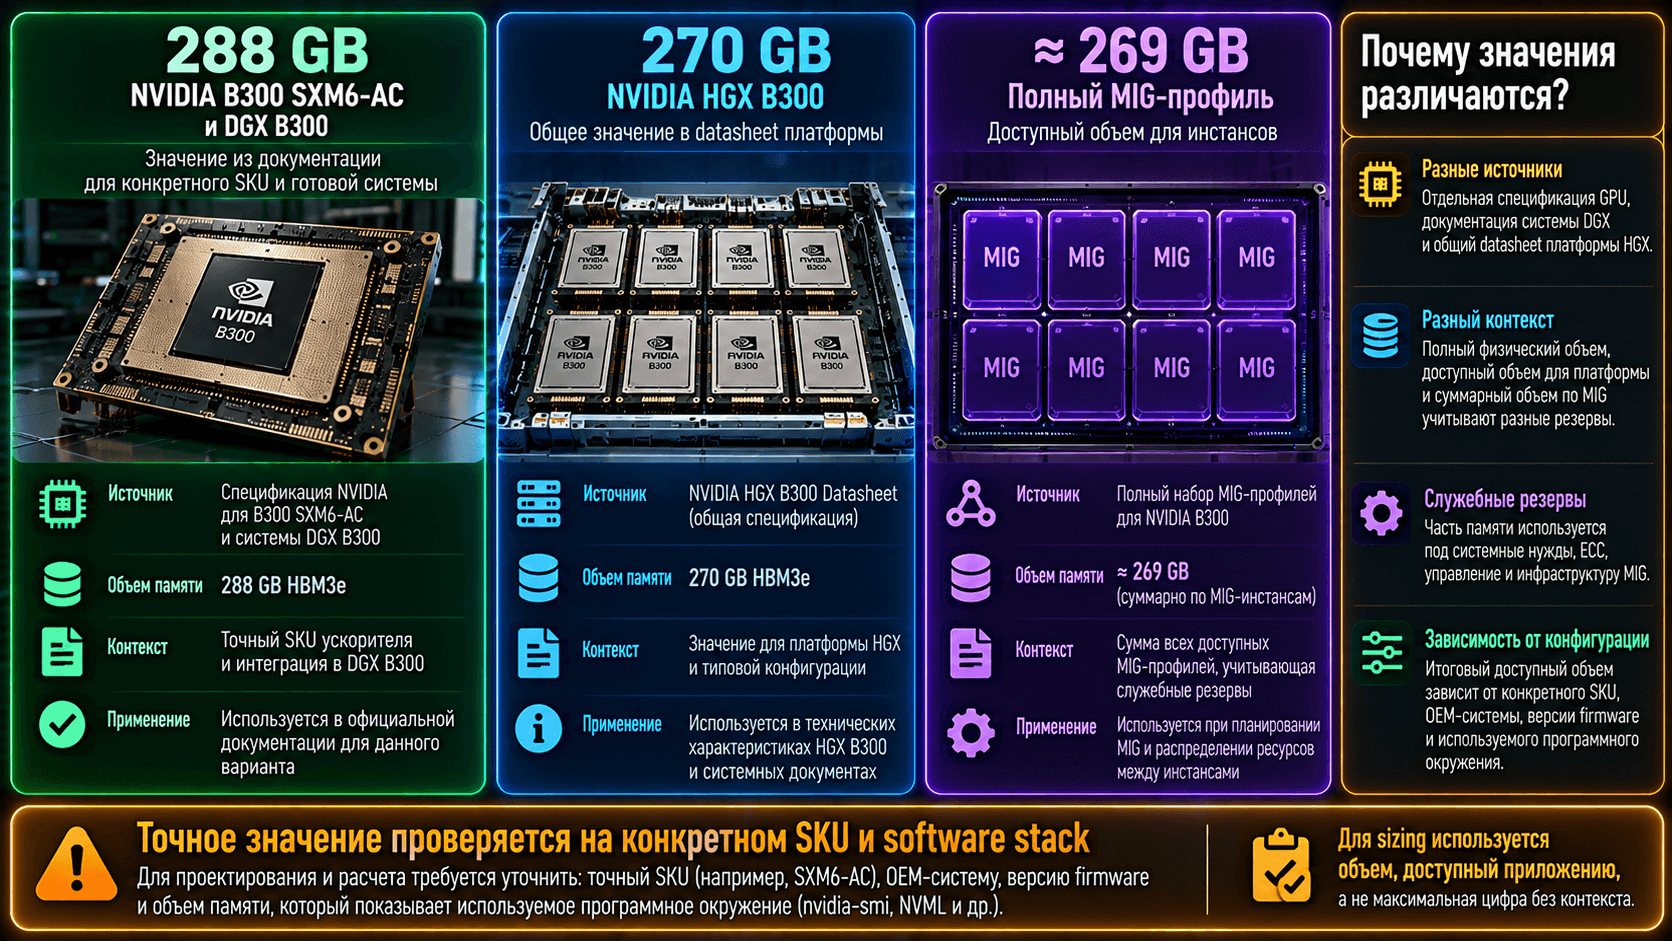
В официальных материалах встречаются два значения: 288 GB для точного SKU SXM6-AC и системы DGX B300, а также 270 GB в общей спецификации HGX B300 и полном MIG-профиле. Документация не дает одного универсального правила пересчета между ними. Для проектирования нужно проверить точный SKU, OEM-систему, версию firmware и объем, который показывает рабочее программное окружение.
Что такое NVIDIA B300
Полное название продукта в документации NVIDIA: B300 Tensor Core GPU. Он относится к Blackwell Ultra, развитию датацентровой архитектуры Blackwell. Ускоритель рассчитан прежде всего на трансформерные модели, AI reasoning, agentic AI, мультимодальные системы и другие нагрузки, которым нужны большая память и высокая скорость матричных операций.
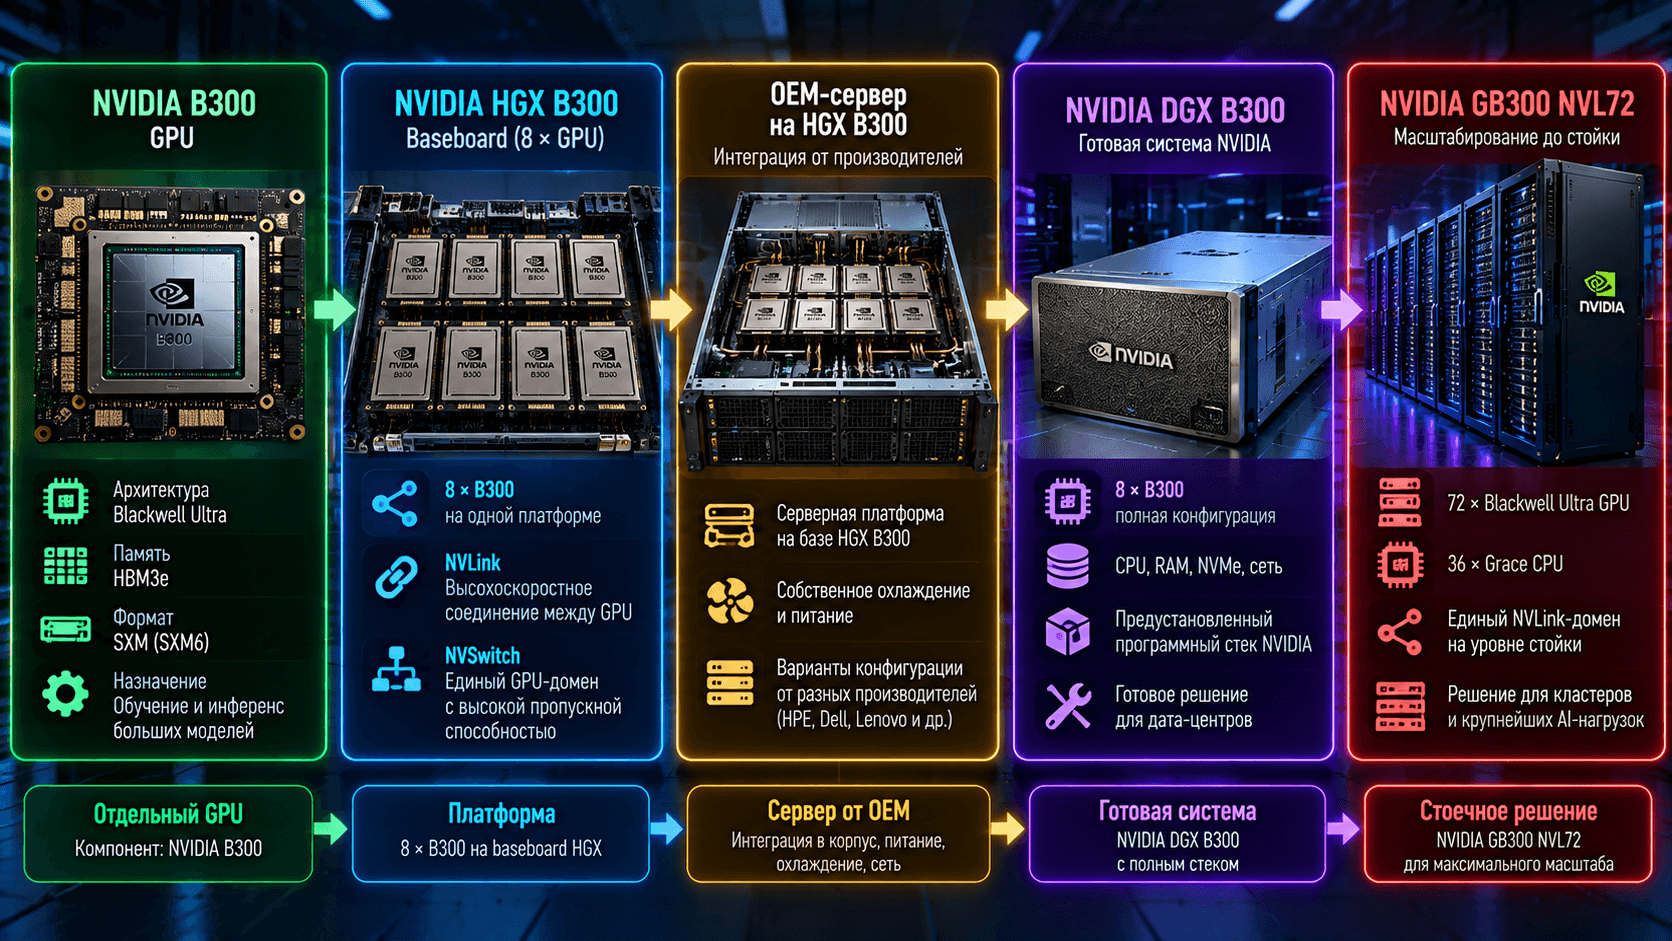
Название B300 также нельзя смешивать с тремя соседними продуктами:
Название | Что обозначает |
|---|---|
NVIDIA B300 | отдельный GPU Blackwell Ultra в датацентровой SXM-платформе |
NVIDIA HGX B300 | базовая восьми-GPU платформа NVIDIA, на которой OEM-производители строят серверы |
NVIDIA DGX B300 | законченная система NVIDIA с восемью B300, CPU, RAM, NVMe, сетью и программным стеком |
NVIDIA GB300 | Grace Blackwell Ultra Superchip, где Grace CPU связан с Blackwell Ultra GPU |
NVIDIA GB300 NVL72 | стоечная система с 72 Blackwell Ultra GPU и 36 Grace CPU в одном NVLink-домене |
Эта статья посвящена B300 и серверам на его основе. GB300 и GB300 NVL72 требуют отдельного разбора, потому что у них другая системная архитектура и требования к площадке.
Характеристики NVIDIA B300
У B300 нет одной универсальной таблицы, подходящей любой системе. NVIDIA и OEM-производители публикуют характеристики GPU, HGX baseboard и готового сервера на разных уровнях. В спецификации закупки нужно указывать, к какому уровню относится каждая цифра.
Ниже приведены основные параметры актуальной платформы HGX B300 и точного SKU NVIDIA-B300-SXM6-AC. Пиковые показатели не являются результатом прикладного benchmark.
Характеристика | NVIDIA B300 / HGX B300 | Что это означает на практике |
|---|---|---|
Архитектура | Blackwell Ultra | поколение ориентировано на обучение, post-training и reasoning inference |
Форм-фактор GPU | SXM | нужен совместимый GPU baseboard и сертифицированная серверная платформа |
GPU в HGX B300 | 8 | один тесно связанный multi-GPU узел |
Заявленная HBM3e точного SKU | до 288 GB на GPU для SKU SXM6-AC | фактически доступный объем следует проверять на конкретной системе |
Общая HGX-спецификация и полный MIG-профиль | около 270 GB на GPU | значение нельзя автоматически считать пересчетом любого 288 GB SKU |
Память узла | 2,3 TB в DGX guide и Enterprise RA, 2,1 TB в текущей HGX product table | это сумма памяти восьми GPU, а не единый автоматически общий адресный пул |
Пропускная способность HBM3e | до 7,7-8 TB/s на GPU, в зависимости от спецификации | важна для memory-bound частей инференса и обучения |
Compute capability | 10.3 | приложению и расширениям нужен код для совместимой архитектуры CUDA |
NVLink | пятое поколение, до 1,8 TB/s GPU-to-GPU на GPU | ускоряет обмен между GPU внутри узла |
Совокупная NVLink bandwidth HGX | 14,4 TB/s | характеристика всей внутренней GPU fabric |
FP4 Tensor Core, HGX | до 144 PFLOPS sparse и 108 PFLOPS dense | теоретический пик для поддерживаемого FP4 path |
FP8/FP6 Tensor Core, HGX | до 72 PFLOPS в опубликованной спецификации | нужно учитывать сноски о sparsity и фактический execution path |
MIG | до семи изолированных GPU instances | позволяет делить GPU между задачами, но не объединяет память нескольких GPU |
Межузловая сеть reference architecture | ConnectX-8, до 800 Gb/s на GPU | конкретная OEM-система может иметь другую комплектацию NIC и портов |
Почему встречаются 288 GB и 270 GB
Запрос nvidia b300 288gb sxm корректно отражает емкость, которую NVIDIA указывает для SKU NVIDIA-B300-SXM6-AC в текущих матрицах NIM и руководстве DGX B300. В то же время общий Blackwell Ultra datasheet и таблицы MIG для HGX B300 используют 270 GB на GPU, а для восьми-GPU платформы приводят 2,1 TB.
Эти числа нельзя молча подменять друг другом:
288 GB относится к заявленной емкости конкретного SKU и DGX B300 в актуальных руководствах;
270 GB указано для HGX B300 в общем datasheet и близко к полному MIG-профилю 269 GB;
расхождение может зависеть от SKU, ревизии платформы и способа представления памяти, поэтому его причина не должна додумываться без документации конкретной системы;
nvidia-smi, MIG profile и runtime показывают тот объем, с которым действительно работает приложение;OEM может использовать конкретную ревизию GPU, firmware и platform software.
Для предварительного расчета можно использовать 270 GB на GPU как консервативный предел, а затем подтвердить memory budget на точной системе. Это рабочее допущение для sizing, а не утверждение, что у каждого 288 GB SKU ровно 18 GB всегда зарезервированы.
Для общей методики расчета весов, KV-cache и рабочих буферов используйте отдельное руководство по объему VRAM для AI, LLM и обучения.
Что изменилось в архитектуре Blackwell Ultra
Blackwell Ultra не является полностью новой архитектурой после Blackwell. Это развитие платформы, в котором NVIDIA увеличила емкость памяти и усилила те части GPU, которые особенно важны для современных трансформеров.
Больше памяти для модели, KV-cache и batch
B200 предоставляет 180 GB HBM3e на GPU. Для B300 актуальные документы приводят 288 GB у SXM6-AC и DGX B300, а общая HGX-спецификация использует 270 GB. В обоих вариантах емкость заметно выше B200. Это позволяет:
разместить более крупные weights на меньшем числе GPU;
оставить больше пространства под KV-cache;
увеличить batch или число одновременных последовательностей;
сократить часть меж-GPU обменов при удачном placement;
запускать больше независимых реплик, если модель невелика.
Дополнительная память не гарантирует пропорционального роста throughput. Если workload ограничена вычислениями, сетью, CPU, storage или scheduler, свободная HBM3e сама по себе не ускорит запрос.
FP4 для обучения и инференса
Tensor Cores Blackwell Ultra поддерживают низкоточные форматы, включая NVFP4. Четырехбитное представление уменьшает объем данных и повышает потенциальную производительность матричных операций. Но FP4 нельзя воспринимать как бесплатное ускорение.
Для корректного результата нужны:
модель и слои, которые допускают выбранную схему precision;
recipe масштабирования и квантизации;
контроль качества относительно BF16 или FP8 baseline;
runtime с поддержкой нужного execution path;
kernels, подходящие размерам матриц;
измерение end-to-end workload, а не только одного GEMM.
Ускорение attention
NVIDIA указывает двукратное увеличение attention performance Blackwell Ultra относительно Blackwell. Эта возможность особенно интересна для длинного контекста, reasoning и агентных систем, где обработка входа и промежуточных шагов занимает значительную долю времени.
Но фраза «в два раза быстрее attention» не означает, что вся LLM станет в два раза быстрее. End-to-end результат включает embedding, GEMM, коммуникации, KV-cache, sampling, сеть и scheduler. На decode с маленьким batch ограничителем может остаться память, а на multi-node workload заметную роль играют collectives.
Compute capability 10.3
NVIDIA B300 и GB300 имеют compute capability 10.3. Драйвер может видеть GPU, но этого недостаточно для полной совместимости. Framework, container, сторонние CUDA extensions и собственные kernels должны содержать подходящий GPU-код или корректный PTX fallback.
Для проверки уровней совместимости полезно использовать руководство что такое CUDA и какие GPU она поддерживает. Перед вводом B300 в production фиксируются точные версии driver, CUDA runtime, framework, inference engine, NCCL и firmware.
Как устроен сервер NVIDIA HGX B300
HGX B300 является платформой для OEM-серверов. Ее основа состоит из восьми B300 SXM, соединенных через NVLink пятого поколения и NVSwitch. Производитель сервера добавляет CPU, системную память, локальные накопители, сетевые адаптеры, BMC, блоки питания, охлаждение и корпус.
Упрощенная схема выглядит так:
B300 GPU 0 ─┐
B300 GPU 1 ─┤
B300 GPU 2 ─┤
B300 GPU 3 ─┼─ NVLink 5 / NVSwitch fabric ─ HGX B300 baseboard
B300 GPU 4 ─┤
B300 GPU 5 ─┤
B300 GPU 6 ─┤
B300 GPU 7 ─┘
                │
                ├─ host CPU и RAM
                ├─ NVMe / external storage
                └─ ConnectX-8 / cluster fabric
NVLink отвечает за высокоскоростной обмен GPU-to-GPU внутри узла. PCIe остается частью связи с host и другими устройствами. Поэтому утверждение «в HGX вместо PCIe используется NVLink» неверно: интерфейсы выполняют разные функции.
Что означает NVL8 и NVL16
В поиске встречается nvidia hgx b300 nvl8, а в материалах производителя можно увидеть HGX B300 NVL16. Эти обозначения нельзя автоматически использовать как доказательство числа физических модулей или конкретной topology. Текущая спецификация HGX B300 описывает baseboard с восемью B300. В коммерческом предложении безопаснее фиксировать понятные параметры:
восемь физических B300 GPU;
точный accelerator SKU;
установленная и доступная HBM3e;
NVLink и NVSwitch generation;
GPU topology, которую видят NVIDIA tools;
серверный SKU и OEM bill of materials.
Одного слова NVL8 или NVL16 недостаточно для приемки оборудования.
Существует ли NVIDIA B300 PCIe как отдельная карта
Поиск содержит формулировки nvidia b300 pci и nvidia b300 pcie. Для текущих серверных предложений B300 правильной точкой отсчета является SXM и совместимая HGX или DGX платформа. Не следует планировать модернизацию обычного PCIe-сервера путем замены установленной карты на B300.
Даже наличие свободного PCIe x16 не решает вопросы:
механической установки;
GPU baseboard;
питания на уровне платформы;
жидкостного или воздушного охлаждения;
NVLink и NVSwitch topology;
firmware и BMC;
поддержки со стороны OEM.
Чем HGX B300 отличается от DGX B300
HGX и DGX решают задачи на разных уровнях.
HGX B300 представляет GPU-платформу, которую используют Dell, ASUS, GIGABYTE, ASRock Rack, Supermicro и другие производители. Покупатель может выбирать CPU, RAM, storage, NIC, корпус и тип охлаждения в пределах поддерживаемых OEM-конфигураций.
DGX B300 представляет законченную систему NVIDIA. В актуальном руководстве для нее указаны:
8 GPU B300 Blackwell Ultra;
8 x 288 GB, суммарно 2,3 TB установленной GPU memory;
2 процессора Intel Xeon Platinum 6776P;
2 TB системной памяти в базовой конфигурации, расширение до 4 TB;
8 NVMe E1.S по 3,84 TB для cache storage;
2 NVMe M.2 по 1,92 TB для ОС;
8 интерфейсов ConnectX-8 до 800 Gb/s для cluster network;
2 двухпортовых BlueField-3 DPU до 400 Gb/s для storage и management networks;
форм-фактор 10U;
максимальное потребление около 14,5 kW для конкретной AC-системы.
Эти параметры относятся к DGX B300, а не к любому серверу с B300. OEM-система может иметь другой CPU, объем RAM, набор NVMe, число сетевых портов, размер корпуса и power envelope.
Критерий | HGX B300 в OEM-сервере | NVIDIA DGX B300 |
|---|---|---|
Уровень продукта | базовая GPU-платформа внутри сервера | готовая система NVIDIA |
Выбор производителя | несколько OEM | NVIDIA |
Гибкость CPU, RAM и storage | зависит от линейки OEM, обычно выше | заранее определенная архитектура и поддерживаемые опции |
Программная поставка | зависит от интегратора и OEM | DGX OS и экосистема DGX |
Поддержка | OEM, поставщик, интегратор, NVIDIA software entitlement | модель поддержки DGX |
Применение | кастомная инфраструктура и стандартизация под парк серверов | унифицированная платформа с фиксированным baseline |
Для каких задач применяют NVIDIA B300
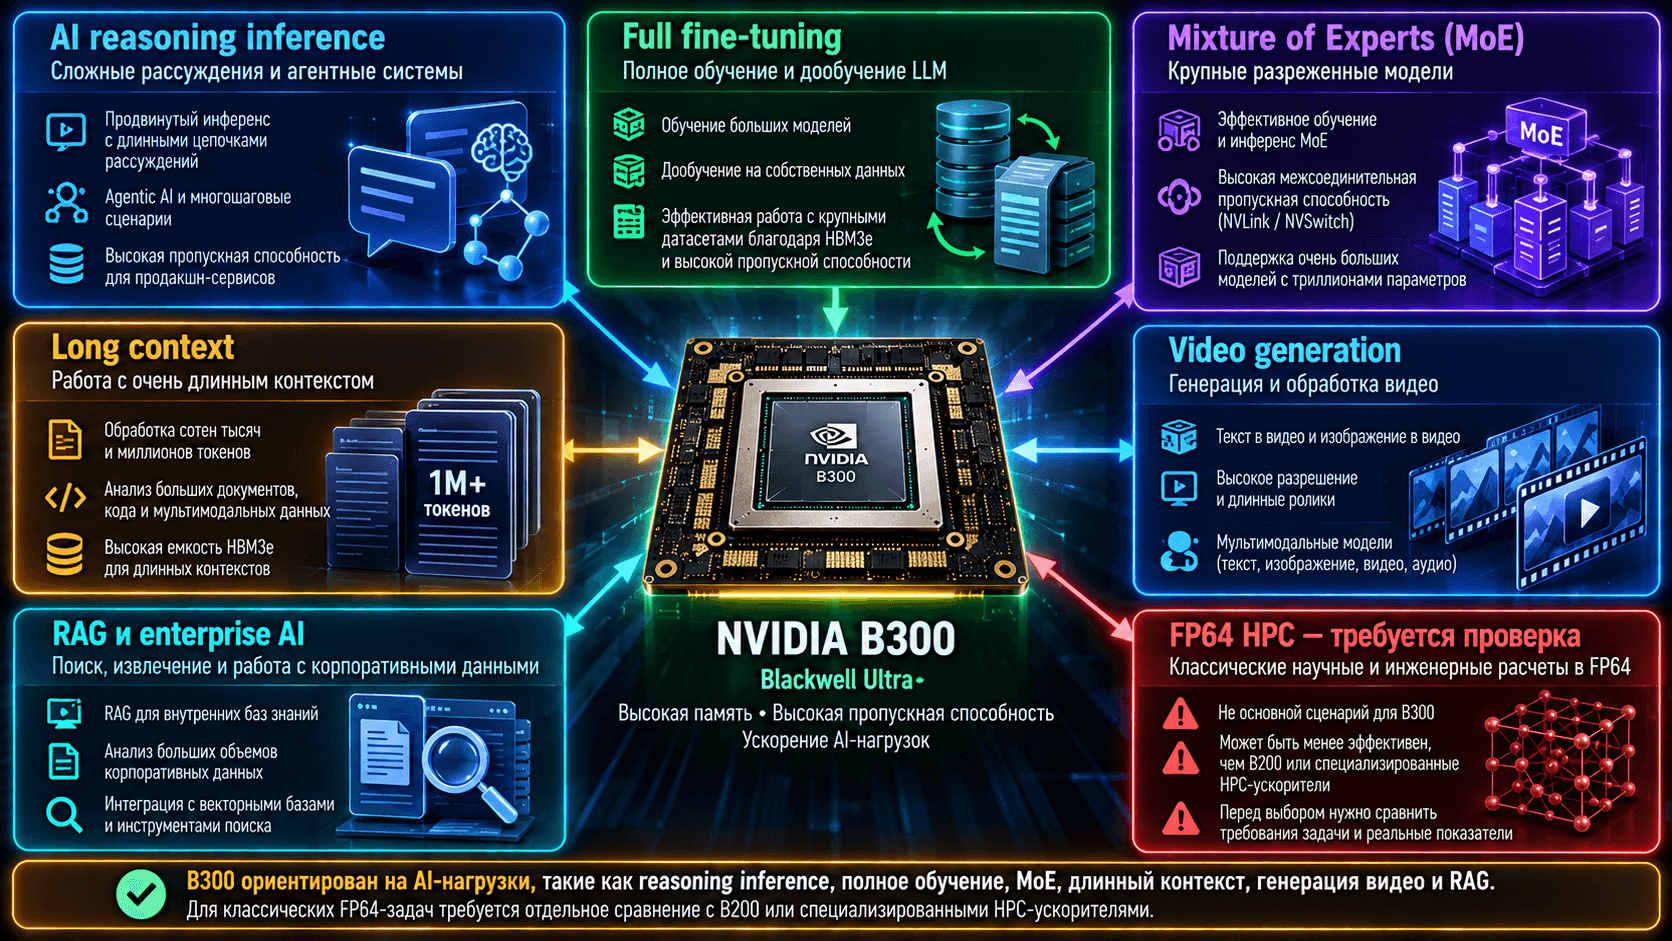
B300 раскрывается там, где одновременно нужны высокая вычислительная плотность, большая HBM3e и быстрый обмен между GPU. Сценарий должен оправдывать не только ускоритель, но и всю инфраструктуру вокруг него.
Инференс reasoning-моделей
Reasoning-модели расходуют больше вычислений во время ответа, генерируют длинные цепочки и могут предъявлять высокие требования к attention и KV-cache. Большая память B300 позволяет разместить больше весов и cache на одном GPU или уменьшить степень tensor parallelism.
Для production-сервиса оцениваются:
time to first token;
inter-token latency;
output и total token throughput;
одновременные запросы;
длина входа и ответа;
goodput при заданном SLO;
стоимость токена на целевой нагрузке.
Максимальный offline throughput не отвечает на вопрос о latency для одного пользователя. B300 нужно тестировать в том режиме, в котором будет работать сервис.
Обучение и post-training LLM
В полном обучении память расходуется на веса, gradients, optimizer states, activations, communication buffers и temporary workspace. Увеличение HBM3e снижает давление на sharding и offload, но не отменяет распределенные коммуникации.
Для post-training B300 подходит к задачам:
supervised fine-tuning;
reinforcement learning workloads;
distillation;
full fine-tuning;
low-precision training через Transformer Engine;
синтетическая генерация данных и оценка моделей.
Если используется LoRA небольшой модели и задание укладывается в 48-96 GB, покупка восьми B300 может быть неоправданной. Сначала рассчитывается workload, затем выбирается минимальная конфигурация, которая выполняет SLA.
Mixture-of-Experts
MoE хранит большое число параметров, но активирует только часть experts для каждого token. Это уменьшает вычисления относительно dense-модели того же общего размера, но не устраняет хранение весов. Expert parallelism создает интенсивный all-to-all traffic, поэтому topology и сеть становятся частью результата.
Длинный контекст и большой KV-cache
При LLM-инференсе память под KV-cache растет с длиной последовательности, batch, concurrency, числом layers, количеством KV heads и precision cache. Дополнительные 90 GB относительно B200 могут быть направлены на:
больший context;
больше одновременных sequences;
несколько реплик;
менее агрессивную квантизацию cache;
запас для runtime и communication buffers.
Выбирать B300 только по заявленной максимальной длине контекста модели нельзя. Нужен memory budget для фактического распределения запросов и заданного SLO.
RAG и корпоративный AI
В RAG-платформе B300 обычно ускоряет генерацию, reranking, embedding или мультимодальные модели. Поиск документов, vector database, ingestion, OCR и storage могут находиться на других узлах.
Покупка B300 не исправит:
медленную индексацию;
неудачный chunking;
низкое качество retrieval;
задержки внешней базы;
перегруженный API gateway;
ошибки оценки качества ответа.
GPU выбирают после разделения компонентов RAG и измерения той части, которая действительно ограничивает сервис.
Генерация видео, мультимодальные модели и physical AI
Высокая вычислительная плотность, NVFP4 и увеличенная HBM3e делают Blackwell Ultra кандидатом для video generation, vision-language models, world models и synthetic data generation. Эти workloads часто требуют больших входов, объемных latent representations и нескольких stages.
Для них, кроме GPU, критичны:
скорость подготовки и декодирования данных;
local cache;
bandwidth СХД;
CPU preprocessing;
media engines и поддержка codec path;
reproducible pipeline от dataset до результата.
HPC с ограничением
B300 нельзя считать универсальной заменой B200 для любой HPC-задачи. Текущая таблица NVIDIA HGX указывает для HGX B300 значительно меньшую native FP64 / FP64 Tensor Core производительность, чем для HGX B200. Blackwell Ultra оптимизирована прежде всего под AI, особенно FP4, FP8, BF16 и attention.
Если приложение зависит от FP64, до закупки нужны:
профиль операций реального кода;
точность, которую нельзя снизить;
поддержка библиотек и kernels;
измерение времени решения, а не AI FLOPS;
сравнение с B200, H200 и другими HPC-ускорителями.
Сколько моделей помещается в память B300
Нижняя оценка размера весов рассчитывается по формуле:
память весов = число параметров x число бит / 8
Она не учитывает scale metadata, KV-cache, activations, buffers, CUDA context и память runtime. Поэтому результат показывает только начало расчета.
Модель по числу параметров | BF16, только сырые веса | FP8, только сырые веса | 4 бита, только сырые веса | Практический вывод для B300 |
|---|---|---|---|---|
70 млрд | около 140 GB | около 70 GB | около 35 GB | weights помещаются на одном B300, но доступная память под cache и batch зависит от runtime |
405 млрд | около 810 GB | около 405 GB | около 203 GB | BF16 требует нескольких GPU; четыре B300 дают разумнее пространство, чем арифметический минимум |
671 млрд | около 1 342 GB | около 671 GB | около 336 GB | для BF16 нужен multi-GPU sharding; восемь B300 дают запас для служебных данных, но результат проверяется на точной модели |
1 трлн | около 2 000 GB | около 1 000 GB | около 500 GB | BF16 почти заполняет доступную память всего HGX-узла только весами и непрактичен без дополнительного запаса |
У восьми B300 нет автоматически общей памяти объемом 2,1 или 2,3 TB. Каждый процесс и rank работает с локальной HBM3e своего GPU. Tensor parallelism, pipeline parallelism, expert parallelism или другой sharding распределяют tensors, а обмен идет через NVLink и NVSwitch.
Увеличение числа GPU также не гарантирует линейного ускорения. Для отдельного расчета используйте руководство сколько GPU нужно для LLM и как выбрать сервер на 2, 4 или 8 ускорителей.
NVIDIA B300, B200 и H200: ключевые различия
Эта таблица не заменяет benchmark. Она показывает архитектурные различия, влияющие на shortlist.
Параметр | NVIDIA H200 | NVIDIA B200 | NVIDIA B300 |
|---|---|---|---|
Архитектура | Hopper | Blackwell | Blackwell Ultra |
Compute capability | 9.0 | 10.0 | 10.3 |
HBM на GPU | 141 GB HBM3e | 180 GB HBM3e | 288 GB для SXM6-AC и DGX B300; 270 GB в HGX datasheet |
Memory bandwidth | 4,8 TB/s | до 8 TB/s | около 7,7-8 TB/s в зависимости от спецификации |
Native NVFP4 Tensor Core path | нет | есть | есть |
NVLink на GPU в HGX | более раннее поколение | пятое поколение, до 1,8 TB/s | пятое поколение, до 1,8 TB/s |
Главный смысл выбора | зрелая Hopper-платформа с большой HBM | Blackwell для обучения и инференса | больше памяти и attention performance для reasoning и крупных workload |
FP64 HPC | проверяется под код | сильная сторона относительно B300 | не считать универсальным HPC upgrade без теста |
Практическая развилка:
H200 остается кандидатом, если workload хорошо работает на Hopper, 141 GB достаточно, а стоимость миграции на новый stack не окупается;
B200 подходит, когда нужны Blackwell и FP64 важнее дополнительной памяти B300;
B300 интересен, когда B200 ограничен capacity, attention или reasoning throughput, а программный стек готов к compute capability 10.3;
окончательный выбор делается по одинаковой модели, precision, workload, software и SLO.
Как спроектировать сервер с NVIDIA B300
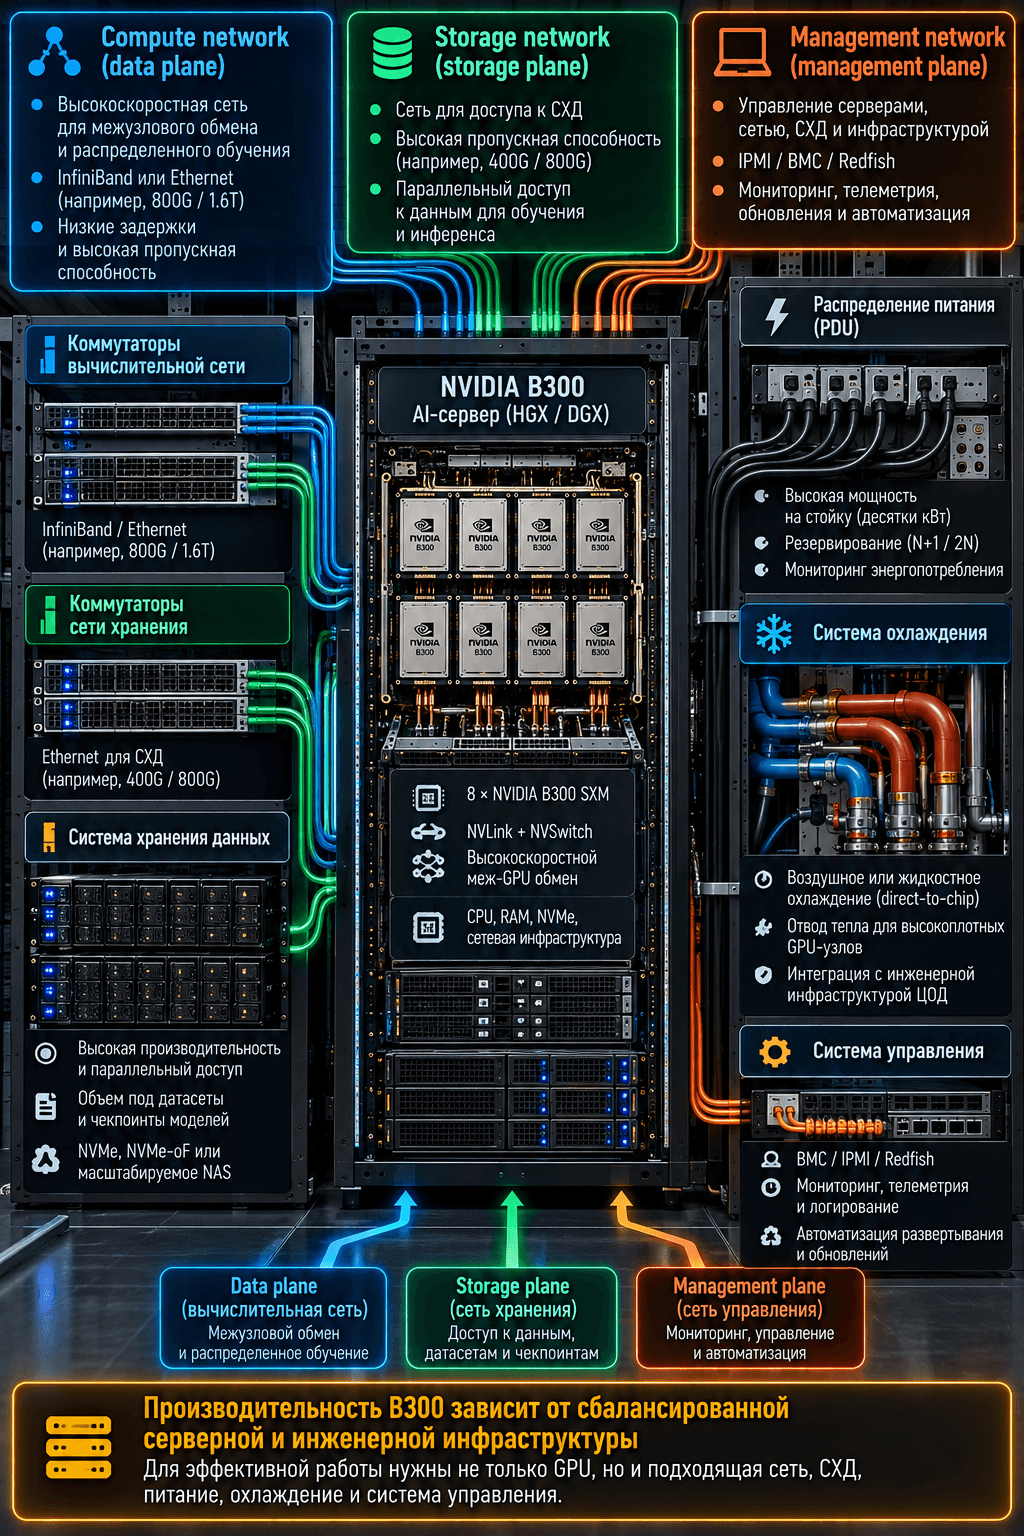
Восьми-GPU baseboard является только вычислительным ядром. Производительность и надежность готовой системы зависят от host, storage, сети и инженерной инфраструктуры.
CPU и системная память
CPU участвует в tokenization, data loading, preprocessing, network stack, storage I/O, orchestration и части runtime. Нужное число cores и memory channels определяется профилем нагрузки, а не стоимостью GPU.
Системная RAM используется для:
dataset cache;
preprocessing;
CPU offload;
memory-mapped checkpoints;
page cache;
контейнеров и служебных процессов;
подготовки batches;
orchestration и monitoring.
DGX B300 использует 2 TB RAM по умолчанию с возможностью расширения до 4 TB. Это характеристика готовой системы, а не обязательное правило для каждого HGX B300. OEM-конфигурация рассчитывается по workload и поддерживаемой memory population.
Локальные NVMe и внешняя СХД
Локальные накопители могут хранить ОС, container images, model cache, staging data и горячий dataset. Для обучения нужно учитывать не только последовательное чтение, но и checkpoint writes, metadata operations, параллельный доступ и ресурс записи.
СХД должна подавать данные так, чтобы дорогие GPU не ждали I/O. Для расчета фиксируются:
размер dataset и checkpoints;
число одновременно работающих nodes;
read и write bandwidth;
IOPS и размер блока;
число файлов;
checkpoint interval;
время восстановления после сбоя;
сеть storage plane;
возможность GPUDirect Storage, если она нужна стеку.
Сеть между B300-серверами
Внутри одного HGX B300 основную GPU-to-GPU связь обеспечивает NVLink и NVSwitch. Между серверами используются InfiniBand или Ethernet с RDMA, а в reference architecture NVIDIA применяется ConnectX-8 до 800 Gb/s на GPU.
Это не означает, что каждому B300-проекту автоматически нужны восемь портов 800G. Конфигурация зависит от:
data, tensor, pipeline и expert parallelism;
critical collectives;
размера сообщений;
доли communication в training step;
числа nodes;
допустимой oversubscription;
storage traffic;
одновременных jobs.
Расчет link class, числа NIC и fabric topology вынесен в руководство как выбрать сеть 100, 200, 400 или 800 Гбит/с для GPU-кластера.
Питание и охлаждение
DGX B300 в официальном руководстве имеет форм-фактор 10U, максимальное потребление 14,5 kW, массу около 168 kg для AC-версии и воздушный поток до 1 500 CFM при указанном режиме вентиляторов. Для OEM-серверов параметры отличаются.
До заказа системы площадка должна подтвердить:
доступное питание на стойку и линию;
разъемы, PDU и схему резервирования;
пусковые и штатные режимы;
отвод тепла;
допустимую inlet temperature;
воздушное или жидкостное охлаждение конкретного SKU;
свободное место, глубину и грузоподъемность стойки;
путь заноса и сервисные зоны;
режим при отказе части cooling или power subsystem.
Нельзя переносить 14,5 kW DGX B300 на любой HGX B300-сервер. Точная мощность берется из OEM datasheet и согласованной спецификации.
Программный стек NVIDIA B300
Наличие CUDA support не означает, что любой старый container использует B300 корректно. У B300 compute capability 10.3, поэтому software baseline проверяют до закупки и повторно перед вводом в production.
Минимальный список:
Версия GPU driver и ее совместимость с CUDA runtime.
Framework и container с поддержкой B300.
Архитектурные targets для собственных CUDA extensions.
Версии NCCL, Transformer Engine, TensorRT-LLM, vLLM или другого runtime.
Поддержка NVFP4, FP8 и нужной quantization recipe.
Firmware GPU, NVSwitch, NIC, DPU и BMC.
Kubernetes GPU Operator, Slurm plugins или другой scheduler layer.
DCGM, telemetry, alerts и процедура active diagnostics.
MIG и разделение B300
B300 поддерживает Multi-Instance GPU. Актуальные профили HGX B300 включают варианты от небольших instances до полного профиля примерно 269-270 GB. MIG полезен, если одной задаче не нужен весь GPU и требуется аппаратная изоляция ресурсов.
MIG не подходит как универсальный способ объединить свободную память. Он делит один GPU на изолированные instances. Если модель требует больше памяти одной instance, нужен multi-GPU runtime или другой placement.
Перед использованием MIG проверяются:
поддержка нужного профиля в driver и GPU Operator;
совместимость inference engine;
media extensions, если они нужны;
мониторинг каждой instance;
scheduler и quota;
влияние partitioning на SLA.
Эксплуатация и телеметрия
Для B300 недостаточно графика GPU utilization. Нужны application SLI, runtime metrics, VRAM, clocks, power, temperature, NVLink и network counters, ECC, XID, NVSwitch health и история изменений.
Как правильно тестировать NVIDIA B300
Для B300 особенно легко получить большую, но бесполезную цифру. В спецификации присутствуют PFLOPS, в inference benchmark появляются tokens/s, а в training test используются samples/s или time-to-train. Эти показатели отвечают на разные вопросы.
Сначала зафиксируйте объект сравнения
Есть два корректных типа теста:
Hardware isolation. Одинаковые model, precision, workload, software и methodology. Меняется GPU или серверная платформа. Такой тест ближе к сравнению B300, B200 и H200.
Best-system comparison. Каждая система использует подходящий runtime, kernels и tuning. Тест отвечает на вопрос, какая готовая платформа лучше выполняет production workload, но не изолирует вклад silicon.
Что должно быть в протоколе
Группа | Что фиксировать |
|---|---|
Model | точный ID, revision, tokenizer |
Precision | BF16, FP8, NVFP4, quantization recipe и критерий качества |
Workload | input length, output length, их распределения, dataset |
Load | batch, request rate, concurrency, arrival pattern |
Cache | prefix cache и warm или cold state |
Metrics | throughput, TTFT, TPOT, ITL, goodput, job duration |
Hardware | точный GPU SKU, число GPU, server SKU, CPU, RAM, topology |
Software | driver, CUDA, framework, engine, container, kernels |
Fabric | NVLink state, NIC, rails, switches, oversubscription |
Power | лимит мощности и граница измерения |
В готовой форме эти правила собраны в статье как читать бенчмарки GPU для LLM.
Пиковый FLOPS не равен производительности LLM
Peak compute полезен как верхняя аппаратная характеристика. Между ним и application throughput находятся:
доля операций, использующих нужный precision;
эффективность kernels;
quantization overhead;
memory bandwidth;
communication;
scheduler;
CPU и storage;
размер batch;
latency constraint.
Какие серверы B300 доступны
Категория B300 на Start Server включает системы NVIDIA, Dell, ASUS, GIGABYTE и ASRock Rack. У всех может быть восемь B300 SXM, но готовые конфигурации различаются CPU, RAM, NVMe, NIC, корпусом, охлаждением и support model.
Примеры разных подходов:
NVIDIA DGX B300 как унифицированная система NVIDIA;
Dell PowerEdge XE9780 с B300 как OEM-платформа;
ASUS XA NB3I-E12 с B300 как альтернативная OEM-конфигурация.
Список моделей не является рейтингом. Сначала формируется specification envelope, затем внутри него сравниваются системы, которые официально поддерживают нужную комплектацию.
Критерии shortlist:
точный B300 SKU и доступная HBM3e;
поддерживаемые CPU и memory population;
локальные NVMe и возможность hot service;
NIC count, speed и GPU locality;
форма поставки и firmware baseline;
воздушное или жидкостное охлаждение;
требования к стойке и power feed;
гарантия, запчасти и support response;
возможность провести приемочный workload test.
Серверы разных производителей на базе HGX собраны в разделе NVIDIA HGX.
От чего зависит цена NVIDIA B300
Запросы nvidia b300 купить, сервер nvidia b300 и nvidia b300 цена относятся к коммерческому интенту. Статичная цена в технической статье быстро устаревает и не описывает полный проект.
Стоимость формируют:
восемь B300 и HGX baseboard;
серверный корпус и охлаждение;
CPU и RAM;
NVMe и storage adapters;
ConnectX, BlueField, optics и cables;
коммутаторы compute и storage fabric;
rack, PDU и инженерные работы;
программные лицензии и support;
логистика, страхование и ввод в эксплуатацию;
тестирование, документация и SLA.
Два коммерческих предложения с одинаковой строкой 8 x B300 могут отличаться по критичным компонентам. Сравнивать нужно BOM, exact part numbers, сеть, power, cooling, software entitlement, гарантию и программу приемки.
Когда NVIDIA B300 покупать не нужно
B300 может быть избыточным, если:
модель и KV-cache уверенно помещаются в более доступную GPU;
сервис имеет низкую concurrency;
workload ограничена CPU, storage или network;
обучение не используется, а небольшая quantized-модель запускается локально;
текущая H200 или B200 выполняет SLA с запасом;
software stack еще не готов к compute capability 10.3;
площадка не обеспечивает питание и охлаждение;
критическая HPC-нагрузка зависит от FP64;
нет плана загрузки восьми GPU;
проект находится на ранней стадии и сначала требует пилота меньшего масштаба.
Покупать дорогую платформу ради будущего роста без измеримого capacity plan рискованно. Точнее определить модель, SLO и горизонт масштабирования, затем сравнить B300 с альтернативами.
Чек-лист выбора B300-сервера
Перед запросом коммерческого предложения заполните следующие поля.
Workload
точная модель и revision;
обучение, fine-tuning или inference;
precision и критерий качества;
input и output length;
context distribution;
batch, concurrency и request rate;
целевые throughput, latency или time-to-train.
Memory
weights;
KV-cache;
activations;
gradients и optimizer states;
temporary workspace;
communication buffers;
необходимый запас на каждом rank.
Server
восемь B300 или другой вариант;
CPU cores, memory channels и PCIe topology;
объем RAM;
local NVMe;
NIC и DPU;
управление и telemetry;
воздушное или жидкостное охлаждение.
Infrastructure
число nodes;
topology compute fabric;
storage bandwidth;
rack power;
cooling capacity;
PDU и резервирование;
место и грузоподъемность;
план роста.
Acceptance
inventory и serial numbers;
firmware и software baseline;
DCGM diagnostics;
NVLink и NCCL tests;
network и storage tests;
thermal soak;
target workload benchmark;
критерии PASS, FAIL и remediation.
Частые вопросы о NVIDIA B300
Что такое NVIDIA B300?
NVIDIA B300 представляет датацентровый Tensor Core GPU архитектуры Blackwell Ultra. Он используется в специализированных SXM-системах для обучения, post-training и высоконагруженного AI inference.
Сколько памяти у NVIDIA B300?
Для SKU NVIDIA-B300-SXM6-AC и DGX B300 актуальные документы указывают до 288 GB HBM3e. Общая спецификация HGX B300 использует 270 GB, а полный MIG-профиль близок к 269 GB. Для расчета проверяют точный SKU и фактический объем, видимый runtime.
NVIDIA B300 является обычной видеокартой?
Нет. Слово «видеокарта» используется в поиске, но B300 относится к серверным SXM GPU. Его выбирают вместе с совместимой HGX или DGX платформой, питанием, охлаждением и NVLink fabric.
Существует ли NVIDIA B300 PCIe?
Текущие коммерческие системы B300 строятся вокруг SXM и HGX. Не следует рассчитывать на установку B300 как стандартной PCIe add-in карты в произвольный сервер. Точная совместимость определяется server SKU и OEM documentation.
Чем B300 отличается от B200?
B300 относится к Blackwell Ultra, имеет больше HBM3e и заявленное двукратное внимание performance относительно Blackwell. При этом B300 не является автоматическим upgrade для FP64 HPC. Выбор подтверждается одинаковым workload benchmark.
Чем HGX B300 отличается от DGX B300?
HGX B300 является восьми-GPU базовой платформой для OEM-серверов. DGX B300 является законченной системой NVIDIA с заданными CPU, RAM, storage, network и программным стеком.
Что означает NVIDIA HGX B300 NVL8?
Обозначение описывает вариант NVLink-связанной платформы, но его нельзя использовать вместо полной спецификации. Для закупки фиксируют восемь физических B300, точный GPU SKU, объем памяти, topology и server SKU.
Поддерживает ли B300 CUDA?
Да. NVIDIA B300 имеет compute capability 10.3 и поддерживается актуальным CUDA stack. Framework, container и собственные extensions должны содержать совместимый GPU-код.
Для каких LLM подходит B300?
Подходящая модель определяется не только числом параметров. Учитываются precision, weights, KV-cache, context, concurrency, runtime, parallelism и SLO. B300 особенно интересен для крупных моделей, reasoning, MoE, длинного контекста и full fine-tuning.
Сколько стоит NVIDIA B300?
Цена зависит от готового сервера, CPU, RAM, NVMe, сети, охлаждения, поддержки, логистики и инженерной инфраструктуры. Актуальную стоимость корректно запрашивать по полной спецификации, а не по названию GPU.
Можно ли использовать B300 для HPC?
Можно для тех HPC-нагрузок, которым подходят вычислительные форматы и библиотеки B300. Для кода, критичного к FP64, требуется отдельное сравнение, поскольку B300 ориентирован прежде всего на AI и не является универсальной заменой B200.
Подбор NVIDIA B300 под реальную нагрузку
Проект B300 начинается не со списка серверов, а с модели и измеримых требований. Для подбора нужны размер и revision модели, режим обучения или инференса, precision, context, concurrency, целевые latency и throughput, число узлов, требования к storage и параметры площадки.
Start Server подберет B300-сервер, рассчитает RAM, NVMe, compute fabric, СХД, питание и охлаждение, затем подготовит программу приемочных испытаний. Отправьте параметры workload через форму запроса в категории серверов с NVIDIA B300.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


