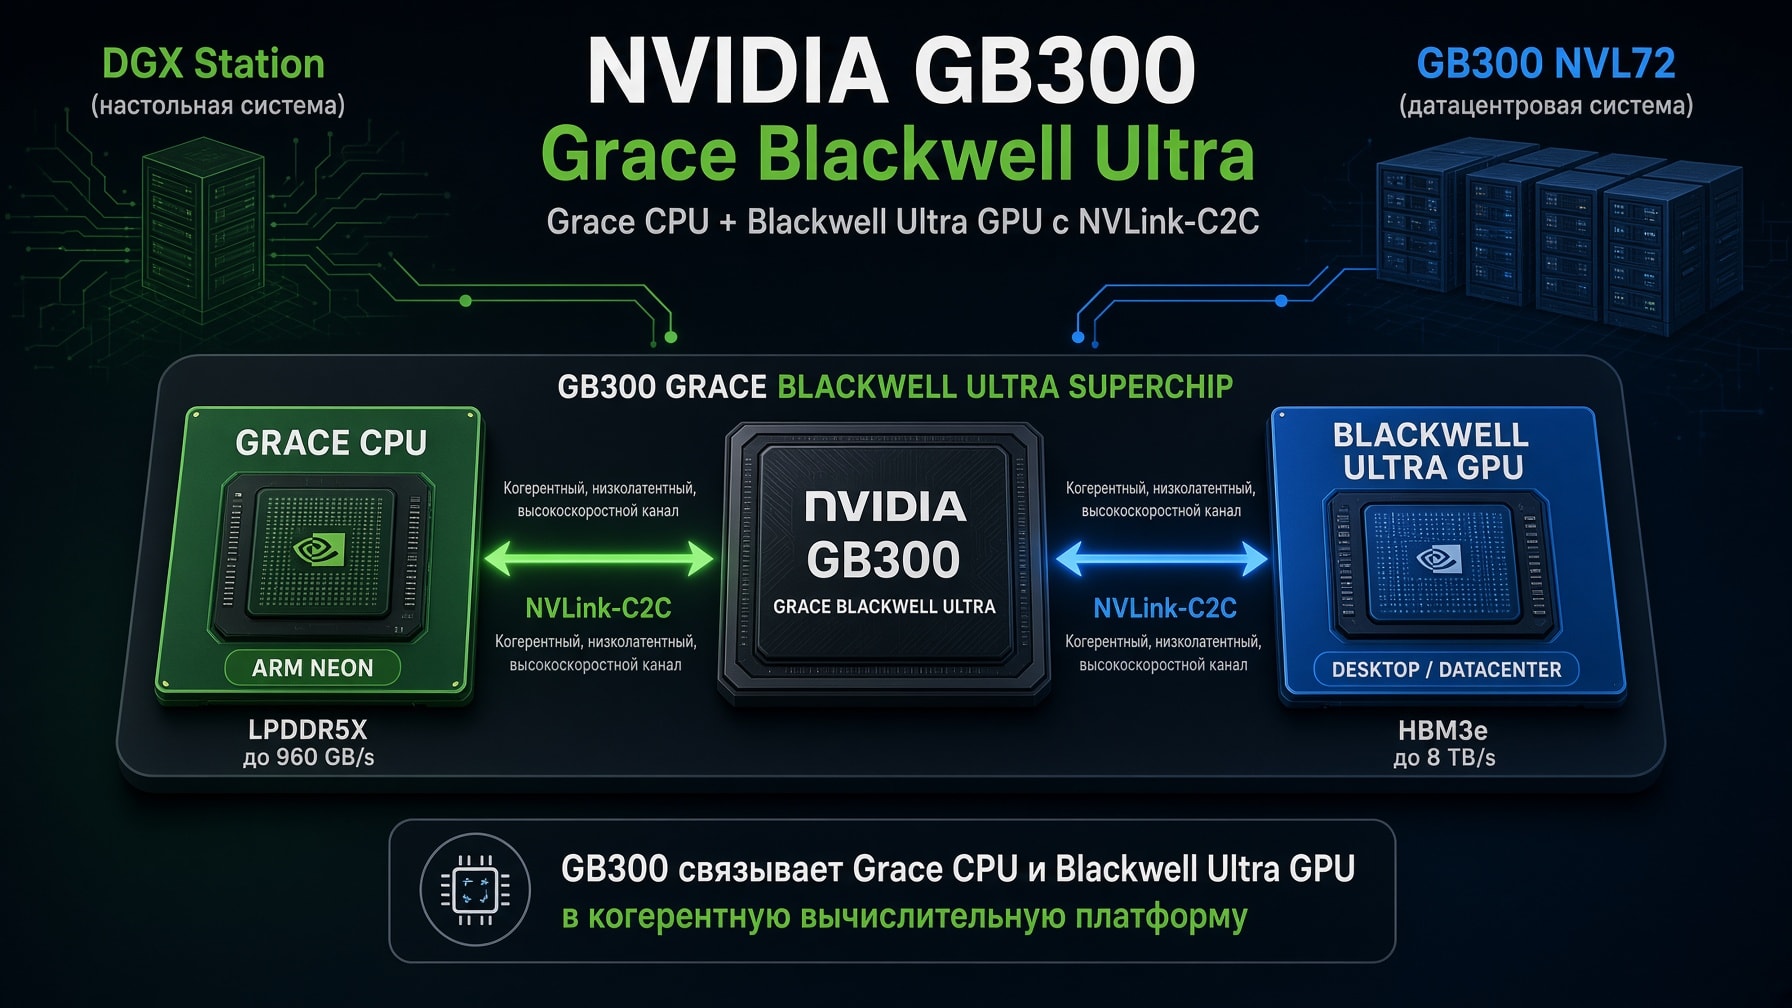
NVIDIA GB300 представляет собой вычислительную платформу Grace Blackwell Ultra, в которой Arm-процессор NVIDIA Grace и GPU поколения Blackwell Ultra связаны когерентным интерфейсом NVLink-C2C. Такая связка дает CPU и GPU согласованный доступ к физически разным пулам памяти, сокращает число лишних копирований данных и позволяет строить системы от настольной DGX Station до полной стойки GB300 NVL72.
Главная причина путаницы состоит в том, что обозначение GB300 встречается у разных конфигураций. Датацентровый суперчип объединяет один Grace CPU с двумя Blackwell Ultra GPU. В одной стойке GB300 NVL72 работают 36 Grace CPU и 72 GPU. Настольный GB300 Grace Blackwell Ultra Desktop Superchip использует один Grace CPU и один Blackwell Ultra GPU. Поэтому характеристика, указанная без названия конкретной системы, может оказаться верной для одного варианта и ошибочной для другого.
Что такое NVIDIA GB300
Полное имя датацентровой платформы звучит как NVIDIA Grace Blackwell Ultra Superchip. Буква G в GB300 указывает на связку с Grace CPU, а B300 относится к GPU Blackwell Ultra внутри этой платформы. Формулировки NVIDIA Blackwell GB300 и GPU NVIDIA GB300 встречаются в поиске, но технически полезнее разделять три уровня:
Уровень | Что это | Пример |
|---|---|---|
GPU | отдельный ускоритель Blackwell Ultra | NVIDIA B300 Tensor Core GPU |
Superchip | Grace CPU и один или два Blackwell Ultra GPU с NVLink-C2C | GB300 Grace Blackwell Ultra |
Готовая система | суперчипы, NVSwitch, сеть, накопители, питание, охлаждение и ПО | DGX Station GB300 или GB300 NVL72 |
У NVIDIA GB300 нет одной универсальной спецификации памяти или энергопотребления. Параметры зависят от реализации:
датацентровый GB300 Superchip содержит один Grace CPU и два Blackwell Ultra GPU;
GB300 NVL compute tray содержит два таких суперчипа, то есть два Grace CPU и четыре GPU;
стойка GB300 NVL72 состоит из 18 compute trays, суммарно 36 Grace CPU и 72 GPU;
настольный GB300 Desktop Superchip содержит один Grace CPU и один Blackwell Ultra GPU.
Из этого следует практическое правило: фразы NVIDIA GB300 характеристики, память GB300 или NVIDIA GB300 цена не имеют точного ответа без указания форм-фактора, производителя и SKU.
Как устроен Grace Blackwell Ultra Superchip
Архитектуру GB300 удобно читать как четыре тесно связанных слоя: CPU, GPU, локальная память каждого процессора и соединяющий их когерентный интерфейс.
Grace CPU
NVIDIA Grace является серверным процессором на архитектуре Arm. Один процессор содержит 72 ядра Arm Neoverse V2 и работает с энергоэффективной LPDDR5X-памятью. В GB300 NVL72 установлено 36 процессоров, поэтому вся стойка содержит 2 592 CPU-ядра.
Задача Grace не сводится к запуску операционной системы. CPU обслуживает подготовку данных, orchestration, сетевой и storage I/O, части inference pipeline, работу с CPU-resident данными и те операции, которые невыгодно выполнять на GPU. Высокая пропускная способность памяти и NVLink-C2C помогают уменьшить разрыв между host и accelerator.
Есть и ограничение: Grace использует Arm64, а не x86_64. Популярные Python-пакеты и контейнеры часто доступны для обеих архитектур, но собственные расширения, проприетарные библиотеки, агенты мониторинга и старое ПО могут требовать пересборки или замены. Проверка Arm64 должна входить в proof of concept до закупки.
Blackwell Ultra GPU
GPU внутри GB300 относится к поколению Blackwell Ultra. Это тот же класс ускорителя B300, который применяется отдельно в HGX B300, но в GB300 он соединен с Grace CPU через NVLink-C2C и входит в другую системную архитектуру.
Blackwell Ultra ориентирован на крупные трансформеры, reasoning inference, обучение, post-training и мультимодальные модели. Основные изменения относительно первого поколения Blackwell связаны с большей емкостью HBM3e, повышенной производительностью FP4 и ускорением attention. Для датацентрового варианта GB300 NVIDIA указывает 279 GB HBM3e и до 8 TB/s на один GPU. Пиковая производительность одного GPU достигает 20 PFLOPS sparse или 15 PFLOPS dense в FP4 при поддерживаемом execution path.
NVLink-C2C между CPU и GPU
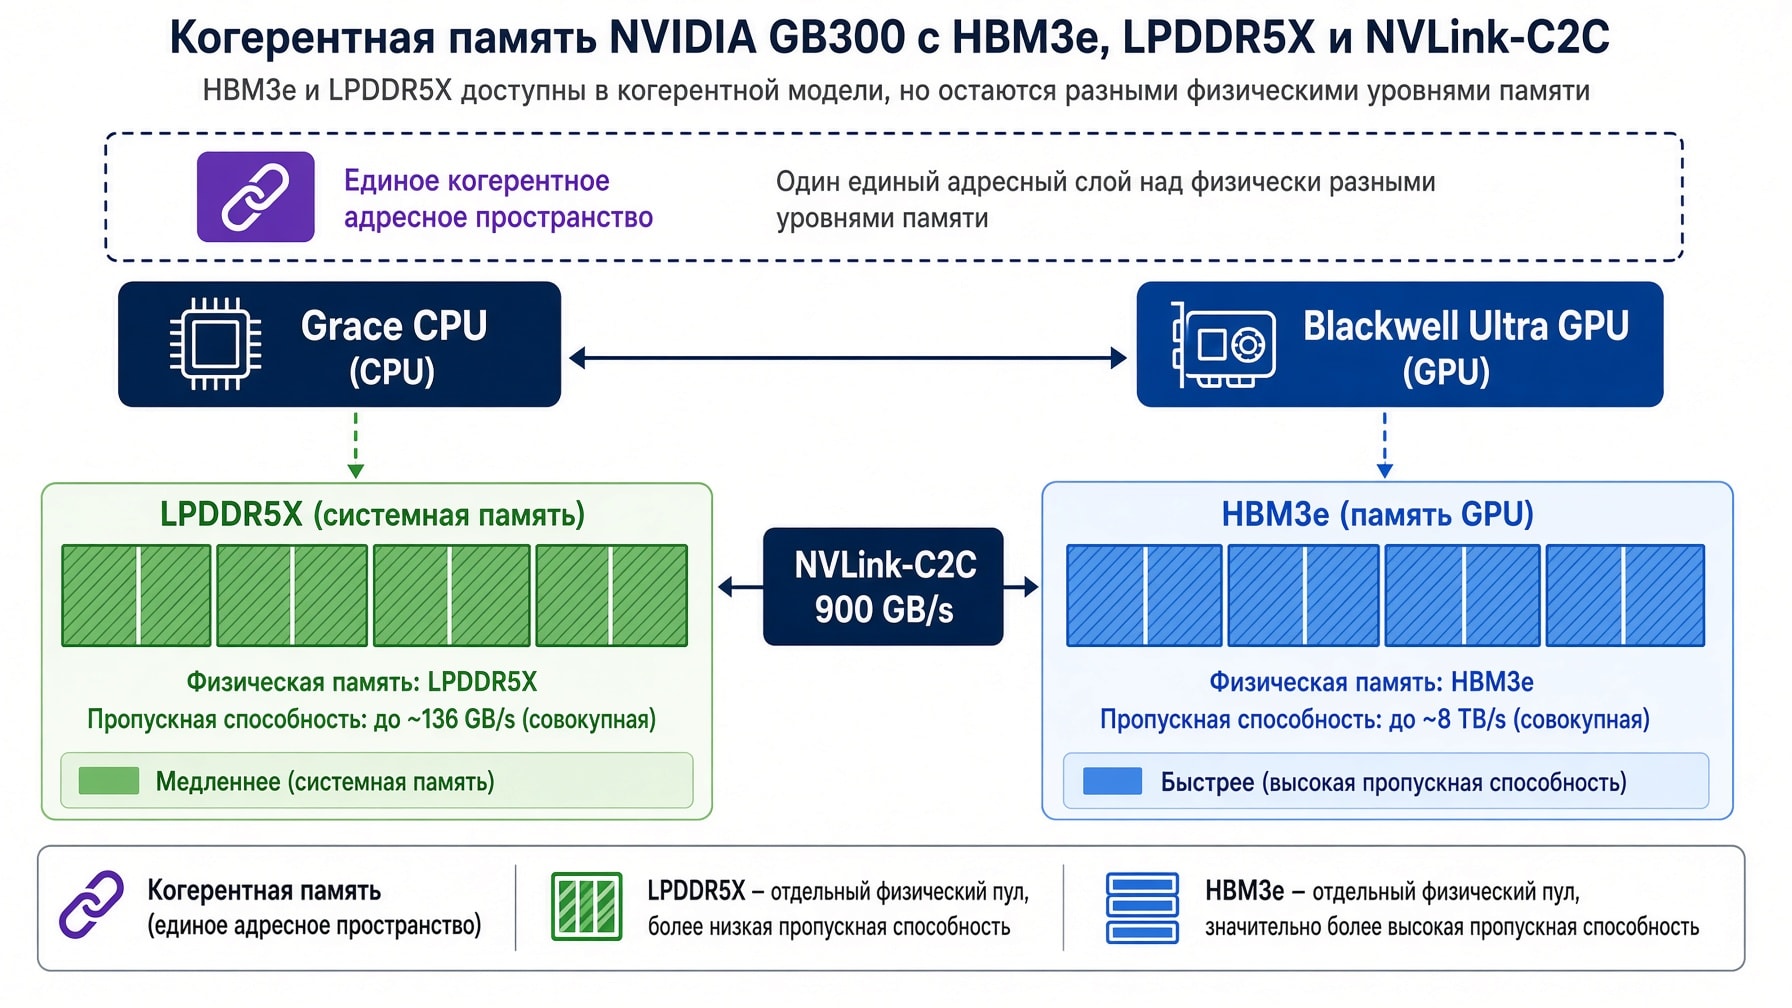
NVLink-C2C является chip-to-chip соединением Grace CPU и Blackwell Ultra GPU. Его двунаправленная пропускная способность достигает 900 GB/s. Интерфейс поддерживает аппаратную когерентность памяти, поэтому CPU и GPU могут работать с согласованным представлением данных без ручного управления кешем для поддерживаемых mappings.
Это существенно отличается от обычной схемы x86 CPU плюс PCIe GPU. В традиционной системе приложение часто создает копию данных в оперативной памяти, затем переносит ее в VRAM. В GB300 часть workflows может обращаться к CPU-памяти непосредственно из CUDA-кода или использовать общие структуры данных с меньшим числом явных копирований.
NVLink-C2C не отменяет законы производительности. Доступ GPU к локальной HBM3e быстрее доступа к LPDDR5X через межкристальный канал. Данные, которые постоянно участвуют в матричных вычислениях, лучше держать в HBM3e. CPU-память полезна для больших, менее интенсивно используемых рабочих наборов, offload, подготовки данных и сценариев, где емкость важнее максимальной полосы.
Что означает coherent memory в GB300
В описаниях NVIDIA встречаются термины coherent memory, unified memory и shared address space. Их нельзя понимать как обещание одинаковой скорости для всех байтов памяти.
У GB300 есть два физических пула:
HBM3e расположена рядом с GPU и обеспечивает максимальную полосу для weights, activations, KV-cache и рабочих буферов.
LPDDR5X подключена к Grace CPU. Она заметно емче обычной VRAM многих ускорителей, но медленнее HBM3e с точки зрения GPU.
Когерентность означает, что аппаратная платформа поддерживает согласованность данных и позволяет CPU и GPU адресовать память без привычной модели полностью изолированных пространств. Она упрощает программирование и дает дополнительные варианты размещения рабочих наборов.
Однако сумма HBM3e и LPDDR5X не равна объему высокоскоростной VRAM. Например, у DGX Station официально заявлено до 748 GB coherent memory: 252 GB HBM3e и 496 GB LPDDR5X. Модель может выйти за предел 252 GB HBM3e и использовать CPU-память, но скорость будет зависеть от шаблона доступа и ограничений NVLink-C2C. Для memory-bound workload это принципиально.
Практический sizing делается в два прохода:
сначала рассчитывают, что должно постоянно находиться в HBM3e для достижения целевой скорости;
затем определяют, какие данные допустимо держать в LPDDR5X и насколько offload влияет на latency и throughput.
Характеристики NVIDIA GB300 по вариантам системы
Одна таблица с единственной колонкой GB300 почти неизбежно смешивает несовместимые данные. Ниже параметры разделены по конкретным платформам. Значения относятся к актуальным официальным спецификациям NVIDIA на дату проверки.
Параметр | GB300 NVL72 | DGX Station GB300 |
|---|---|---|
Назначение | rack-scale AI factory | настольная AI-разработка и локальный инференс |
Grace CPU | 36 | 1 |
Blackwell Ultra GPU | 72 | 1 |
CPU-ядра | 2 592 Arm Neoverse V2 | 72 Arm Neoverse V2 |
GPU-память | 20 TB HBM3e суммарно | до 252 GB HBM3e |
Пропускная способность GPU-памяти | до 576 TB/s суммарно | до 7,1 TB/s |
CPU-память | 17 TB LPDDR5X суммарно | до 496 GB LPDDR5X |
Пропускная способность CPU-памяти | 14 TB/s суммарно | до 396 GB/s |
Быстрая память всего | 37 TB | до 748 GB coherent memory |
NVLink | 130 TB/s для 72-GPU домена | NVLink-C2C 900 GB/s между CPU и GPU |
FP4 Tensor Core | 1 440 PFLOPS sparse, 1 080 PFLOPS dense | 20 PFLOPS sparse, 15 PFLOPS dense |
Сеть | до 800 Gb/s на GPU через ConnectX-8 в reference design | ConnectX-8, до 800 Gb/s Ethernet |
Охлаждение | полностью жидкостное | системное решение настольного класса |
Compute capability | 10.3 | 10.3 |
Почему в источниках встречаются 279 GB и 252 GB? Для GPU в датацентровой GB300 NVL72 NVIDIA указывает 279 GB HBM3e и 8 TB/s. Текущая спецификация DGX Station использует до 252 GB и 7,1 TB/s. Это разные реализации Blackwell Ultra, а не две версии одной и той же строки. При покупке OEM-системы нужно проверять datasheet конкретной модели, а не переносить цифры из rack-scale продукта на desktop.
Как GB300 превращается в систему NVL72
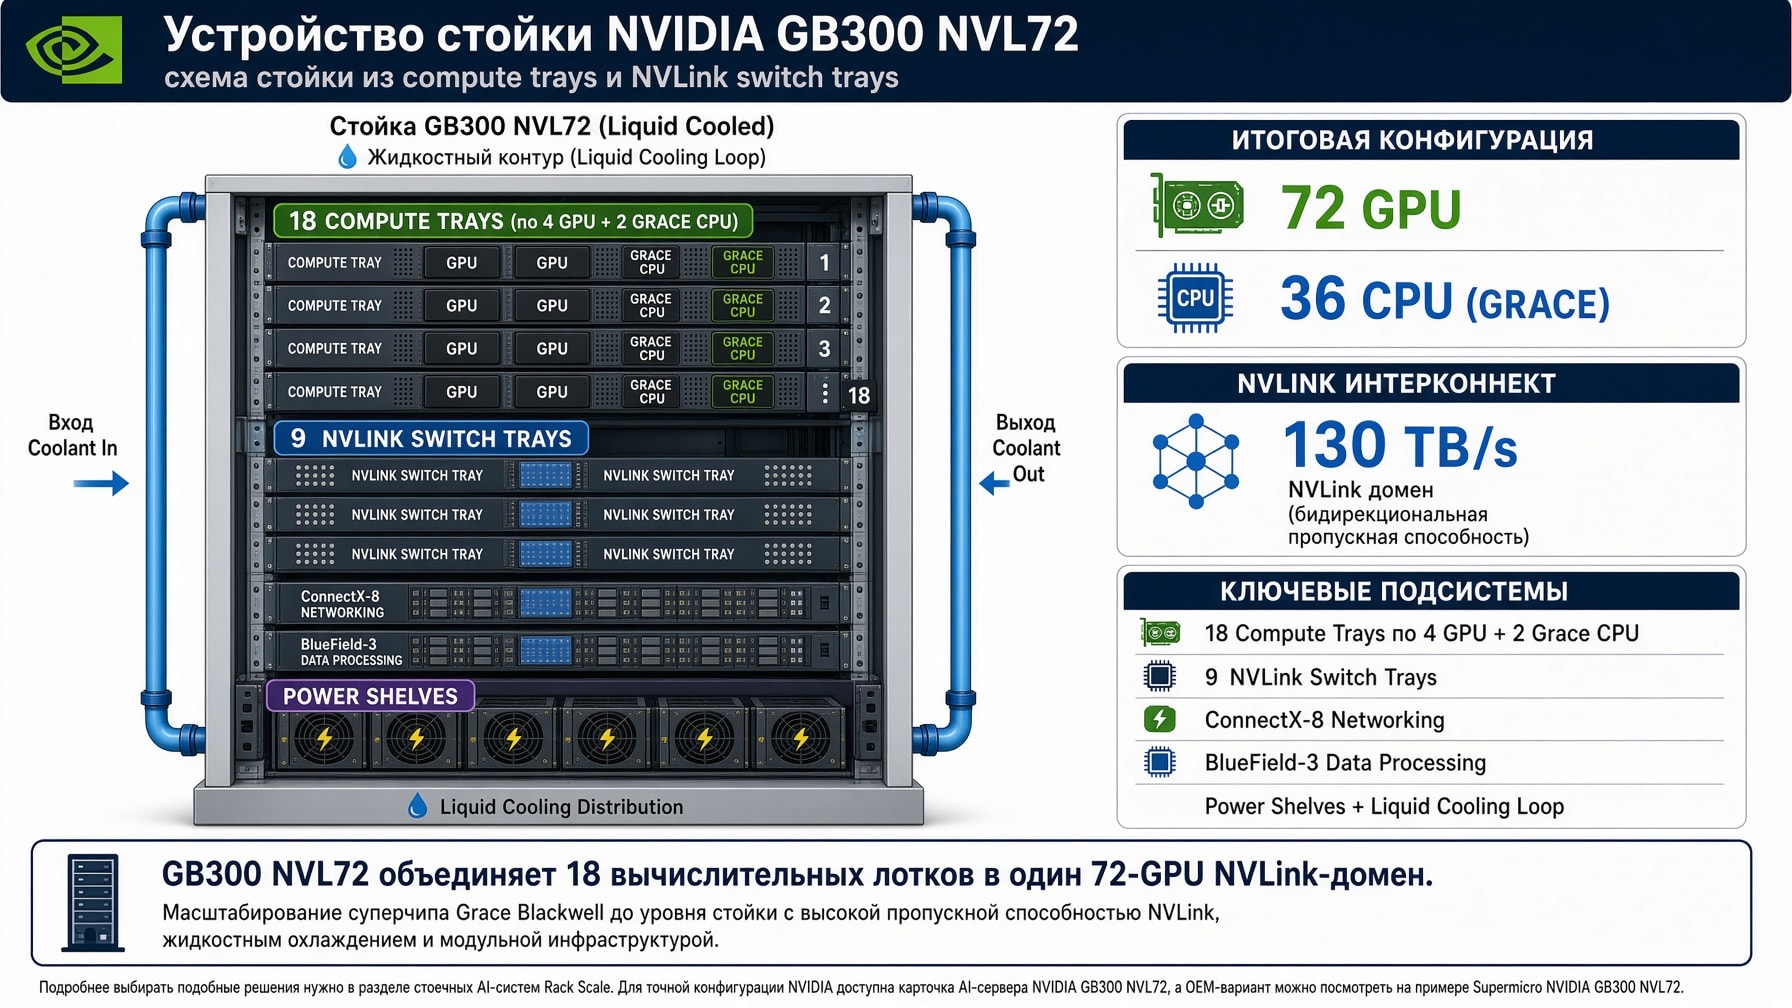
NVIDIA GB300 NVL72 является не одним сервером в привычном 4U или 8U корпусе, а полностью интегрированной стойкой. В ней вычисления, NVLink fabric, сеть, питание и жидкостное охлаждение проектируются как единая система.
Архитектура собирается иерархически:
Один датацентровый GB300 Superchip связывает один Grace CPU и два Blackwell Ultra GPU.
Один compute tray содержит два суперчипа, суммарно два Grace CPU и четыре GPU.
В стойке находится 18 compute trays, суммарно 36 CPU и 72 GPU.
Девять NVLink switch trays содержат NVSwitch ASIC и формируют единый 72-GPU NVLink-домен.
ConnectX-8 обслуживает compute fabric, а BlueField-3 DPU отделяет north-south трафик управления, storage и сервисов.
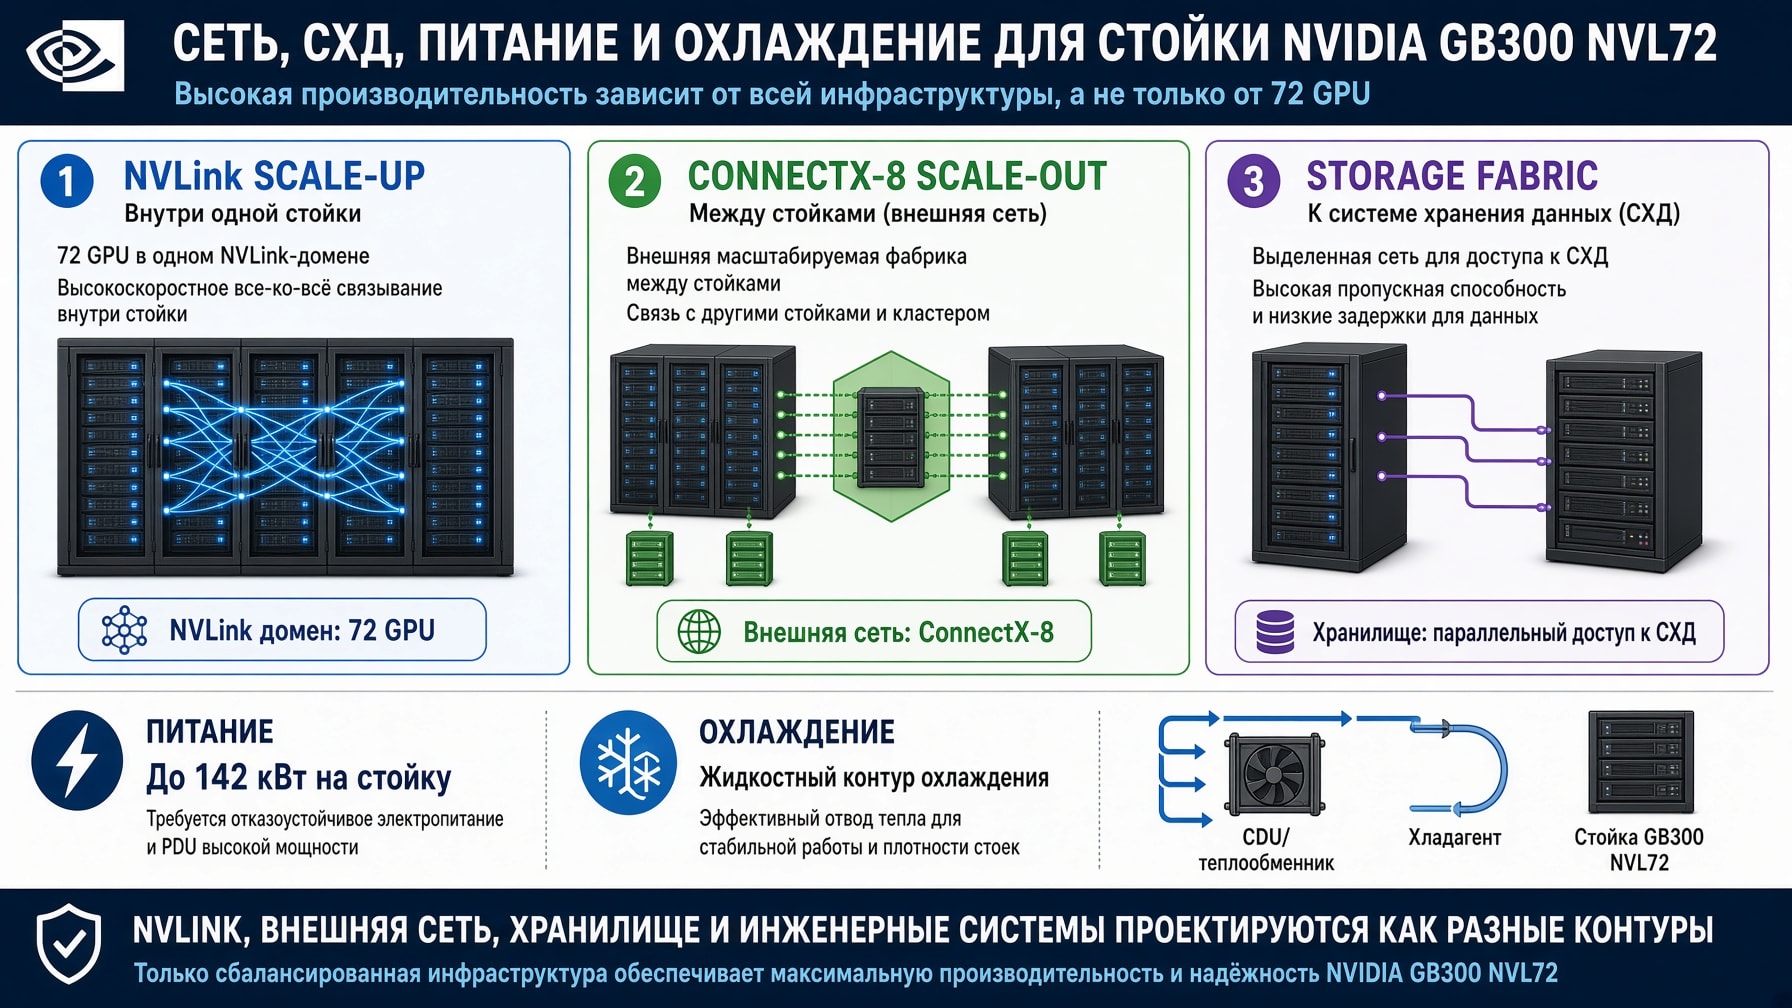
Каждый GPU подключен к 18 NVSwitch пятого поколения. Совокупная полоса NVLink fabric составляет 130 TB/s. Это scale-up контур внутри стойки, предназначенный для тесного взаимодействия GPU. При объединении нескольких стоек добавляется scale-out сеть на InfiniBand или Spectrum-X Ethernet.
Такое разделение важно при чтении спецификаций. 130 TB/s NVLink не является скоростью внешней сети или СХД. 800 Gb/s на GPU относится к сетевой архитектуре ConnectX-8. Storage pipeline имеет собственные ограничения, которые зависят от файловой системы, DPU, количества потоков, размера объектов и схемы кеширования.
Чем настольный GB300 отличается от rack-scale платформы
Запросы NVIDIA GB300 desktop, NVIDIA DGX Station GB300 и суперкомпьютер NVIDIA DGX Station GB300 относятся к другой реализации архитектуры. Это deskside система для исследователя, ML-команды или корпоративной лаборатории, а не уменьшенная стойка NVL72.
DGX Station использует:
один Grace CPU с 72 ядрами Arm Neoverse V2;
один Blackwell Ultra GPU;
до 252 GB HBM3e с полосой 7,1 TB/s;
до 496 GB LPDDR5X с полосой 396 GB/s;
до 748 GB когерентной памяти;
NVLink-C2C 900 GB/s;
ConnectX-8 с пиковой сетевой полосой до 800 Gb/s;
до семи MIG instances;
до 20 PFLOPS sparse FP4.
Настольный формат подходит для локального прототипирования, инференса больших моделей, части задач fine-tuning, data science и разработки приложений перед переносом в кластер. Он не заменяет NVL72, когда нужны десятки GPU, высокая массовая пропускная способность, обучение frontier-моделей или production inference для большого числа пользователей.
NVIDIA B300 и GB300: в чем разница
B300 и GB300 часто считают двумя видеокартами одного поколения. Это неверная модель сравнения. B300 является GPU Blackwell Ultra, а GB300 обозначает Grace Blackwell Ultra Superchip и системы на его основе.
Критерий | NVIDIA B300 | NVIDIA GB300 |
|---|---|---|
Уровень продукта | отдельный датацентровый GPU | интегрированная CPU-GPU платформа |
CPU | выбирается на уровне HGX или OEM-сервера, обычно x86 | NVIDIA Grace Arm входит в архитектуру |
Связь CPU-GPU | PCIe в серверной платформе | когерентный NVLink-C2C до 900 GB/s |
GPU-GPU связь | NVLink и NVSwitch внутри HGX B300 | NVLink и NVSwitch в GB300 NVL72 |
Типичная система | HGX B300 или DGX B300 с 8 GPU | DGX Station с 1 GPU или NVL72 с 72 GPU |
Совместимость host software | привычная x86 среда | требуется проверка Arm64 |
Масштабирование | серверы и кластеры на HGX | тесная CPU-GPU интеграция, rack-scale NVLink domain |
Если приложение жестко зависит от x86-библиотек, а основная работа целиком помещается в HBM, система на HGX B300 может оказаться проще. Если workload выигрывает от большой CPU-памяти, coherent access, host offload или масштабирования в 72-GPU домене, GB300 дает архитектурные преимущества.
GB300 и GB200: что изменилось
Обе платформы связывают Grace CPU и GPU Blackwell через NVLink-C2C. GB300 использует Blackwell Ultra, тогда как GB200 построен на первом поколении Blackwell. Главное изменение связано не с Grace, а с GPU-частью:
больше HBM3e на GPU;
выше FP4 compute для поддерживаемых низкоточных сценариев;
ускоренные attention operations;
более высокая емкость rack-scale памяти;
ориентация на reasoning inference, длинный контекст и рост test-time compute.
Переход с GB200 на GB300 имеет смысл, если workload ограничен памятью, attention или плотным FP4 и это подтверждено профилированием. Если система простаивает из-за data pipeline, сети, неэффективного batching или CPU-bound preprocessing, замена поколения GPU может не устранить узкое место.
Для каких задач подходит NVIDIA GB300
Инференс reasoning-моделей
Reasoning-модель генерирует больше промежуточных токенов и тратит больше вычислений на один пользовательский запрос. При росте output length стоимость attention и KV-cache увеличивается. Blackwell Ultra добавляет ресурсы именно в тех местах, которые важны для test-time scaling: FP4, HBM3e и обработка attention.
Результат зависит от software path. Чтобы получить преимущество, inference engine должен поддерживать нужный precision, kernels, parallelism и scheduling. Нельзя переносить цифру из демонстрации производителя на другую модель без одинаковых условий.
Обучение и post-training
GB300 NVL72 подходит для распределенного обучения, supervised fine-tuning, reinforcement learning и других post-training pipelines. Единый NVLink-домен уменьшает цену обменов для tensor, pipeline и expert parallelism внутри стойки. Межстоечное масштабирование по-прежнему зависит от scale-out fabric и качества коллективных операций.
Для небольшой модели полный rack-scale комплекс может быть экономически неоправдан. Восемь B300, более ранняя платформа или несколько профессиональных GPU могут дать достаточную скорость при меньших требованиях к ЦОД.
Mixture-of-Experts и большие модели
MoE использует только часть экспертов на токен, но weights и маршрутизация создают высокие требования к памяти и обменам. Большой NVLink-домен помогает распределять experts между GPU, однако All-to-All pattern остается чувствительным к топологии, placement и software implementation.
Генерация видео и physical AI
Диффузионные модели видео, world models, робототехническая симуляция и multimodal pipelines требуют одновременно высокой вычислительной мощности, памяти и быстрых декодеров. GB300 предназначен для таких нагрузок, но реальный pipeline может включать рендеринг, CPU preprocessing, сеть и хранилище. Эти компоненты надо тестировать вместе с GPU.
RAG и корпоративные AI-сервисы
GB300 способен обслуживать LLM и RAG, но retrieval сам по себе редко требует флагманской стойки. Нужно разделить:
embedding и построение индекса;
vector search;
reranking;
генерацию ответа;
хранение документов и метаданных.
NVL72 оправдана, когда генеративная часть крупная, трафик высокий или один кластер должен обслуживать несколько тяжелых моделей. Для большинства корпоративных баз знаний рациональнее начать с меньшего сервера и масштабировать после измерения нагрузки.
Если термины модели, токена и инференса пока не зафиксированы, сначала полезно прочитать как работает большая языковая модель.
Программный стек и совместимость GB300
Наличие подходящего CUDA-драйвера не гарантирует готовность приложения. NVIDIA GB300 имеет compute capability 10.3. CUDA Toolkit 13.0 официально поддерживает B300 и GB300, но вся цепочка должна быть совместима с GPU и Arm64 host.
Проверять нужно следующие уровни:
Firmware, BMC, NVSwitch и platform software от конкретного OEM.
NVIDIA driver и CUDA runtime из поддерживаемой матрицы.
NCCL, NVSHMEM, Fabric Manager и IMEX для multi-node NVLink.
Framework: PyTorch, JAX, TensorFlow или другой runtime.
Inference engine: TensorRT-LLM, NVIDIA Dynamo, vLLM, SGLang либо собственное решение.
CUDA extensions, custom kernels, quantization libraries и attention implementation.
Контейнеры и host-side зависимости для
linux/arm64.Monitoring, scheduler, secrets, backup и security agents.
В DGX Station NVIDIA описывает hardware-coherent доступ через ATS и режим управления coherent memory. При этом сама документация рекомендует сохранять performance-critical данные в GPU HBM и не использовать unified memory как универсальную замену осознанному размещению памяти.
Что проверить в proof of concept
Минимальный PoC должен повторять production workload, а не запускать один synthetic benchmark. Зафиксируйте:
точную модель и revision;
precision и quantization recipe;
входную и выходную длину;
batch size и число параллельных запросов;
размещение weights и KV-cache;
tensor, pipeline, data или expert parallelism;
версию driver, CUDA, framework, engine и container image;
latency по percentiles, throughput, ошибки и quality metric;
HBM utilization, CPU memory, NVLink, сеть, storage I/O, power и температуры.
Если тест проводится на одной DGX Station, его результат нельзя линейно умножать на 72 для прогноза NVL72. В большой системе появляются коллективные операции, scheduler, network contention, storage pressure и отказы отдельных компонентов.
Требования к сети, СХД и площадке
Scale-up и scale-out сеть
Внутри GB300 NVL72 GPU связаны NVLink и NVSwitch. Это scale-up fabric. Для обмена между стойками используется scale-out сеть, например Quantum-X800 InfiniBand или Spectrum-X Ethernet с RDMA. У каждого контура своя роль, и они не заменяют друг друга.
Для текущей Enterprise Reference Architecture каждый compute tray содержит четыре ConnectX-8 HCA и один BlueField-3 DPU. NVIDIA указывает до 800 Gb/s compute network connectivity на GPU. Проектирование такой сети включает rail topology, oversubscription, маршрутизацию, кабели, оптику, MTU, congestion control, telemetry и fault domains.
Методика выбора внешней сети разобрана в руководстве как выбрать сеть 100, 200 или 400 Гбит/с для GPU-кластера. Для GB300 NVL72 фактический проект может использовать 800 Gb/s adapters и несколько 400 Gb/s портов, поэтому номинал одного порта не описывает всю fabric.
Хранилище
СХД должна обеспечивать не только большую емкость, но и требуемые IOPS, последовательную полосу, metadata operations и parallel access. Training pipeline с миллионами мелких файлов, checkpointing и inference с локальным model cache создают разные профили.
В compute tray предусмотрены локальные NVMe для ОС и cache. Они не заменяют централизованное хранилище датасетов, checkpoints и артефактов. Архитектуру уровней хранения стоит проектировать вместе с системой хранения данных для AI и серверной инфраструктуры.
Электропитание и охлаждение
В актуальной NVIDIA Enterprise Reference Architecture полная стойка GB300 NVL72 требует до 142 kW и использует жидкостное охлаждение с контролем утечек. Это показатель конкретной reference configuration, а не универсальная цифра для любого OEM и режима нагрузки.
До заказа проверяют:
доступную мощность и резервирование на стойку;
busbar, PDU и схему распределения питания;
параметры теплоносителя и CDU;
температуру, давление, расход и качество воды;
возможность отвода тепла при отказе одного контура;
массу стойки, нагрузку на пол и габариты пути заноса;
пожарную безопасность и процедуру аварийного отключения;
мониторинг питания, жидкости, температур и NVLink fabric.
Как понять, нужен ли вам GB300
Начинать с названия ускорителя рискованно. Сначала фиксируют задачу и требования к сервису.
Шаг 1. Опишите workload
Нужны точные ответы:
обучение, fine-tuning или инференс;
название и размер модели;
dense или MoE;
precision и допустимая потеря качества;
контекст, средняя длина input и output;
число одновременных пользователей;
целевой tokens/s, latency и availability;
объем датасета, checkpoint и срок обучения.
Шаг 2. Рассчитайте память
Отдельно оцените weights, optimizer states, gradients, activations, KV-cache, framework overhead и резерв. Для coherent memory укажите, какая часть обязана находиться в HBM3e, а что допустимо вынести в LPDDR5X.
Шаг 3. Выберите масштаб
Условно выбор выглядит так:
Сценарий | Что рассматривать |
|---|---|
локальная разработка и крупный одиночный workload | DGX Station или OEM desktop на GB300 |
x86-совместимость и 8-GPU сервер | HGX B300 или DGX B300 |
тяжелый training или production inference в одном 72-GPU домене | GB300 NVL72 |
небольшая корпоративная LLM или RAG | более компактный GPU-сервер, если расчет не требует GB300 |
несколько стоек | GB300 NVL72 плюс отдельный проект scale-out сети, СХД и управления |
Шаг 4. Проверьте software stack
Соберите контейнер для Arm64, запустите custom extensions, проверьте model engine и выполните PoC. Ошибка no kernel image, отсутствие wheel для aarch64 или зависимость от x86-инструкций должны обнаружиться до поставки.
Шаг 5. Проверьте площадку и TCO
К стоимости системы добавляются сеть, СХД, кабели, оптика, CDU, электрораспределение, лицензии, монтаж, запасные части, сервис и эксплуатационная команда. Для NVL72 цена оборудования представляет только одну часть проекта.
Общий алгоритм подбора вычислительной платформы есть в материале как выбрать сервер для ИИ по GPU, VRAM, памяти и конфигурации.
Когда GB300 не нужен
Флагманская архитектура может быть технически интересной, но экономически неверной. Рассмотрите более компактную систему, если:
модель и KV-cache помещаются в одну или несколько доступных GPU;
нагрузка нерегулярна и не заполняет дорогую платформу;
latency определяется сетью приложения или внешней базой данных;
inference engine не использует FP4 и Blackwell Ultra kernels;
приложение требует x86-only библиотеку без Arm64 версии;
площадка не готова к жидкостному охлаждению и высокой мощности;
нужна одна рабочая станция, а не rack-scale кластер;
цель состоит в retrieval, классическом ML или preprocessing, а не в тяжелом LLM execution.
NVIDIA GB300: цена и покупка системы
У запроса NVIDIA GB300 цена нет стабильного числа. Под названием GB300 продаются разные классы оборудования, от deskside workstation до полной liquid-cooled стойки. Стоимость зависит от производителя, состава памяти и storage, сети, сервисного контракта, логистики, пусконаладки и инженерной готовности ЦОД.
Запрашивая предложение, укажите:
desktop GB300, compute tray, полную NVL72 или multi-rack комплекс;
OEM и точный SKU;
объем HBM3e и LPDDR5X по спецификации;
NIC, DPU, коммутаторы, кабели и оптику;
локальные NVMe и внешнюю СХД;
требования к CDU и электропитанию;
программный образ и состав acceptance tests;
гарантию, SLA, запасные части и монтаж.
Для сравнения производителей используйте единую ведомость параметров. Цена одной стойки без сети и ввода в эксплуатацию не сопоставима с предложением, где включены fabric, cooling, монтаж и тестирование.
Типичные ошибки при выборе GB300
Считать GB300 одной видеокартой
Система не устанавливается в случайный PCIe-слот. Даже desktop GB300 представляет законченную CPU-GPU платформу. Датацентровый вариант проектируется на уровне compute tray и rack.
Складывать HBM3e и LPDDR5X как одинаковую VRAM
Coherent address space упрощает доступ к данным, но HBM3e и CPU memory имеют разную полосу и задержку. Для performance-critical части модели важен именно HBM budget.
Переносить характеристики NVL72 на DGX Station
У rack-scale GPU заявлено 279 GB HBM3e, у актуальной DGX Station до 252 GB. Количество GPU, память, power и networking у этих вариантов различаются.
Игнорировать Arm64
Framework может запускаться, а одна критичная библиотека или extension оставаться x86-only. Нужен полный application test, включая monitoring и эксплуатационные агенты.
Приравнивать PFLOPS к tokens/s
FP4 peak не учитывает memory traffic, communication, quantization overhead, scheduler и особенности модели. Требуется benchmark на реальном workload.
Заказывать rack до обследования ЦОД
Питание до 142 kW и liquid cooling нельзя добавить после поставки как мелкую опцию. Инженерная часть входит в архитектуру решения.
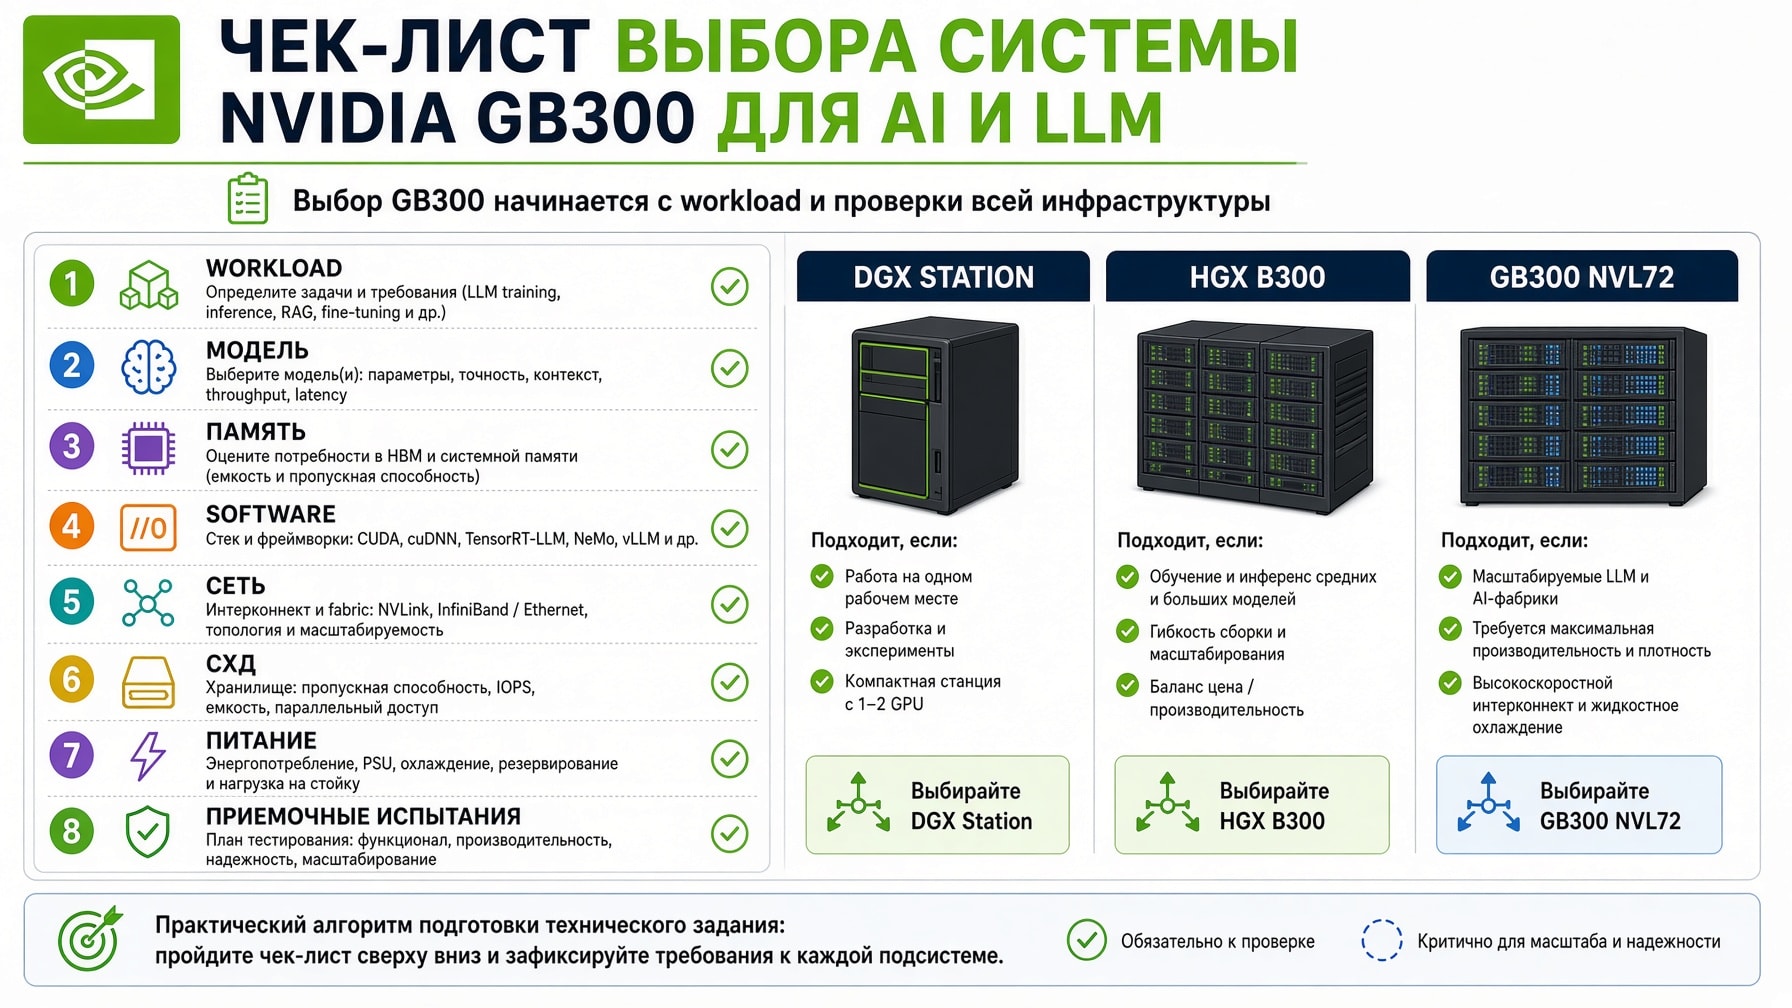
Чек-лист технического задания на GB300
Перед запросом коммерческого предложения подготовьте документ из восьми блоков:
Модели и datasets с источниками и лицензиями.
Режимы обучения, fine-tuning и inference.
Precision, качество, latency, throughput и availability.
Расчет HBM3e, LPDDR5X и локального cache.
Топология GPU, параллелизм и число стоек.
Compute, storage, management и external network.
Электропитание, cooling, размещение и сервис.
Acceptance tests с критериями успешной приемки.
Частые вопросы о NVIDIA GB300
Что такое NVIDIA GB300 простыми словами?
NVIDIA GB300 представляет платформу Grace Blackwell Ultra, где серверный Arm-процессор Grace и GPU Blackwell Ultra связаны быстрым когерентным NVLink-C2C. На этой архитектуре строятся настольная DGX Station и rack-scale система GB300 NVL72.
GB300 является GPU или суперчипом?
В датацентровой терминологии GB300 относится к Grace Blackwell Ultra Superchip, который объединяет один Grace CPU и два B300 GPU. В DGX Station используется desktop-вариант с одним Grace CPU и одним Blackwell Ultra GPU. Поэтому корректнее называть GB300 платформой или суперчипом, а не отдельной видеокартой.
Чем NVIDIA B300 отличается от GB300?
B300 является отдельным GPU Blackwell Ultra. GB300 добавляет Grace CPU, NVLink-C2C и coherent memory architecture. Готовые системы также различаются: B300 применяется в HGX и DGX B300, а GB300 в DGX Station и NVL72.
Сколько памяти у NVIDIA GB300?
Ответ зависит от системы. В GB300 NVL72 NVIDIA указывает 20 TB HBM3e и 17 TB LPDDR5X на всю стойку. У актуальной DGX Station заявлено до 252 GB HBM3e и 496 GB LPDDR5X, суммарно до 748 GB coherent memory.
Можно ли считать coherent memory обычной VRAM?
Нет. HBM3e и LPDDR5X физически разделены и имеют разную пропускную способность. GPU может когерентно обращаться к CPU memory, но самые чувствительные к полосе данные лучше размещать в HBM3e.
Что такое NVIDIA GB300 NVL72?
Это liquid-cooled rack-scale система с 72 Blackwell Ultra GPU и 36 Grace CPU. В стойке 18 compute trays и 9 NVLink switch trays, а все GPU образуют единый NVLink-домен с совокупной полосой 130 TB/s.
Что такое NVIDIA DGX Station GB300?
Это настольный AI-суперкомпьютер на GB300 Desktop Superchip с одним Grace CPU, одним Blackwell Ultra GPU и до 748 GB coherent memory. Он предназначен для локальной разработки, инференса, fine-tuning и data science.
Какая CUDA нужна для GB300?
GB300 имеет compute capability 10.3. CUDA Toolkit 13.0 официально поддерживает B300 и GB300. Для production нужно выбирать согласованную версию driver, runtime, framework, libraries и container, а не обновлять CUDA изолированно.
Сколько стоит NVIDIA GB300?
Цена зависит от класса системы и состава проекта. DGX Station или OEM workstation, отдельный compute tray и полная NVL72 отличаются на порядок по масштабу. Коммерческое предложение должно учитывать сеть, СХД, cooling, электропитание, ПО, монтаж и сервис.
Можно ли купить GB300 и установить в существующий сервер?
Как обычную PCIe-видеокарту, нет. GB300 поставляется в составе интегрированной платформы. Для существующего ЦОД сначала проверяют совместимость стойки, питания, охлаждения, сети и программного стека.
Как выбрать конфигурацию NVIDIA GB300
Для локальной разработки и работы одной команды обычно рассматривают DGX Station или OEM-систему класса desktop GB300. Для 72-GPU scale-up домена, тяжелого обучения и массового reasoning inference выбирают GB300 NVL72. Между ними находится класс x86 серверов HGX B300, который может быть рациональнее при жесткой зависимости от x86 software или меньшем масштабе.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


