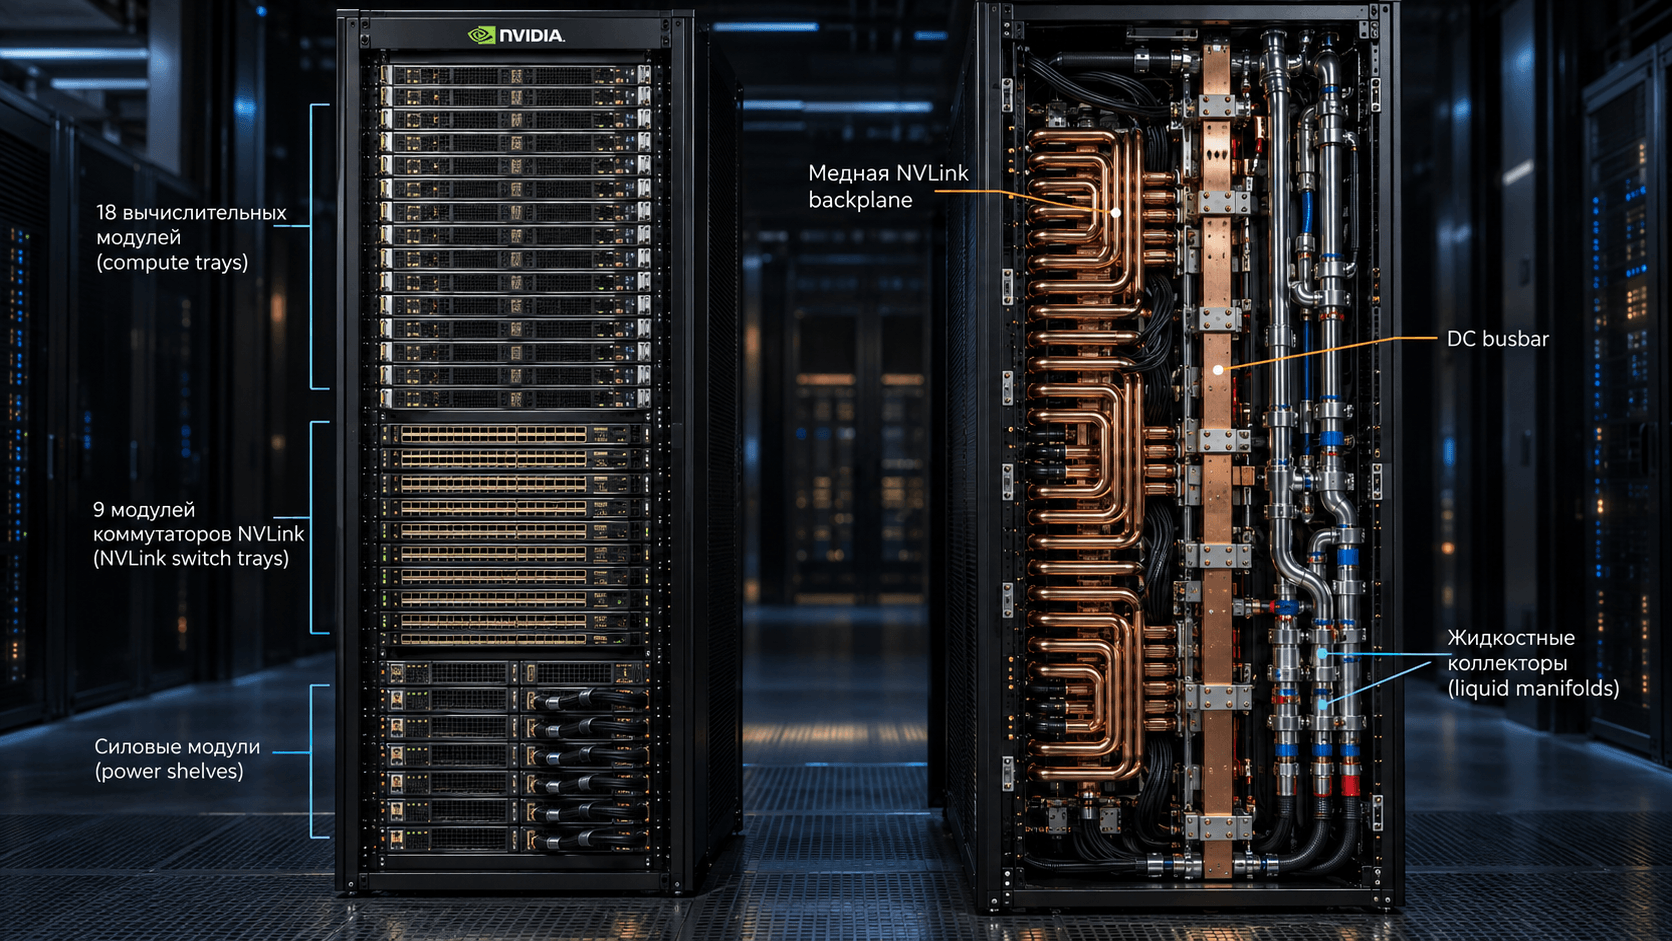
NVIDIA GB300 NVL72 представляет собой rack-scale AI-систему, которая объединяет 72 GPU Blackwell Ultra и 36 Arm-процессоров Grace в одном NVLink-домене. В стойке установлены 18 вычислительных лотков, 9 NVLink switch trays, power shelves, DC busbar, управляющая сеть и коллекторы жидкостного охлаждения. NVIDIA указывает 20 TB HBM3e, 17 TB LPDDR5X, 130 TB/s совокупной полосы NVLink и до 142 kW для полной стойки в актуальной Enterprise Reference Architecture.
Это не обычный сервер, увеличенный до 48U. Каждый compute tray является отдельным узлом с собственной операционной системой, а NVLink и NVSwitch соединяют GPU из 18 узлов в общий 72-GPU scale-up domain. Внешние ConnectX-8, BlueField-3, shared storage, management plane, питание и cooling facilities остаются самостоятельными контурами.
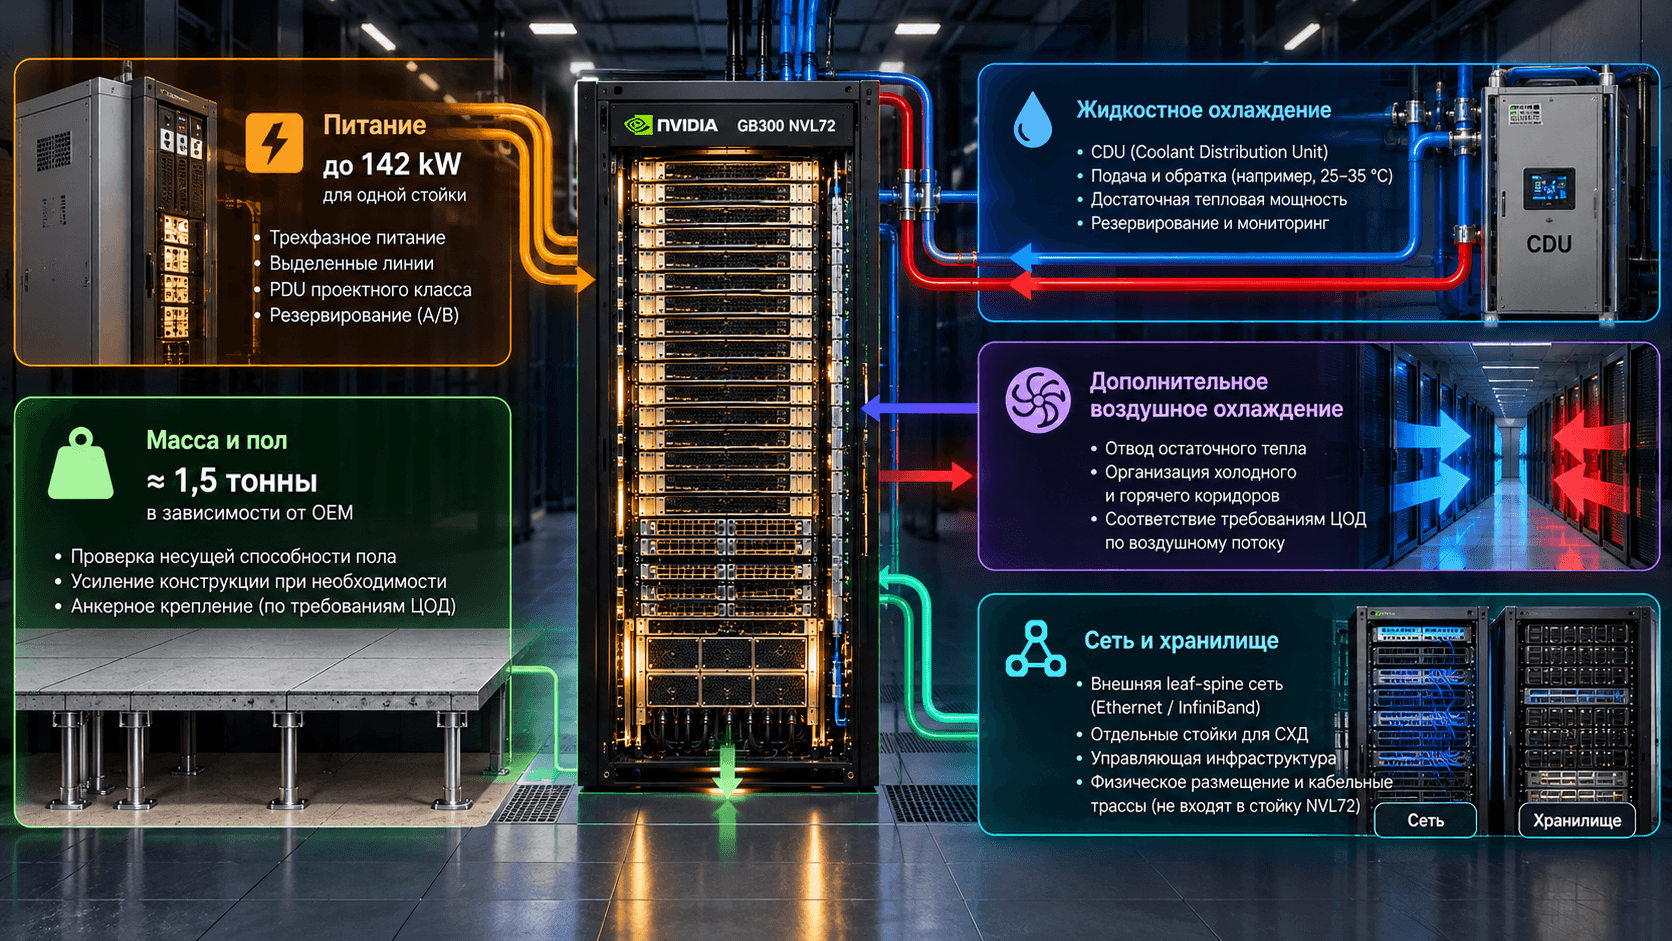
Поэтому вопрос о покупке GB300 NVL72 начинается с ЦОД. Площадка должна принять стойку массой около полутора тонн в зависимости от OEM, подвести трехфазное питание проектного класса, отвести более 100 kW тепла, обеспечить жидкостный контур, разместить внешнюю leaf-spine сеть, СХД и управляющие серверы. Если хотя бы один контур не готов, вычислительные характеристики системы не имеют практического значения.
Что такое NVIDIA GB300 NVL72
Название описывает три уровня архитектуры:
GB300обозначает Grace Blackwell Ultra, связку Grace CPU и Blackwell Ultra GPU через NVLink-C2C;NVL72обозначает 72 GPU, объединенные NVLink и NVSwitch в один rack-scale домен;NVIDIA DGX GB300 NVL72и OEM-исполнения обозначают законченные стойки с compute, switching, power, cooling и software components.
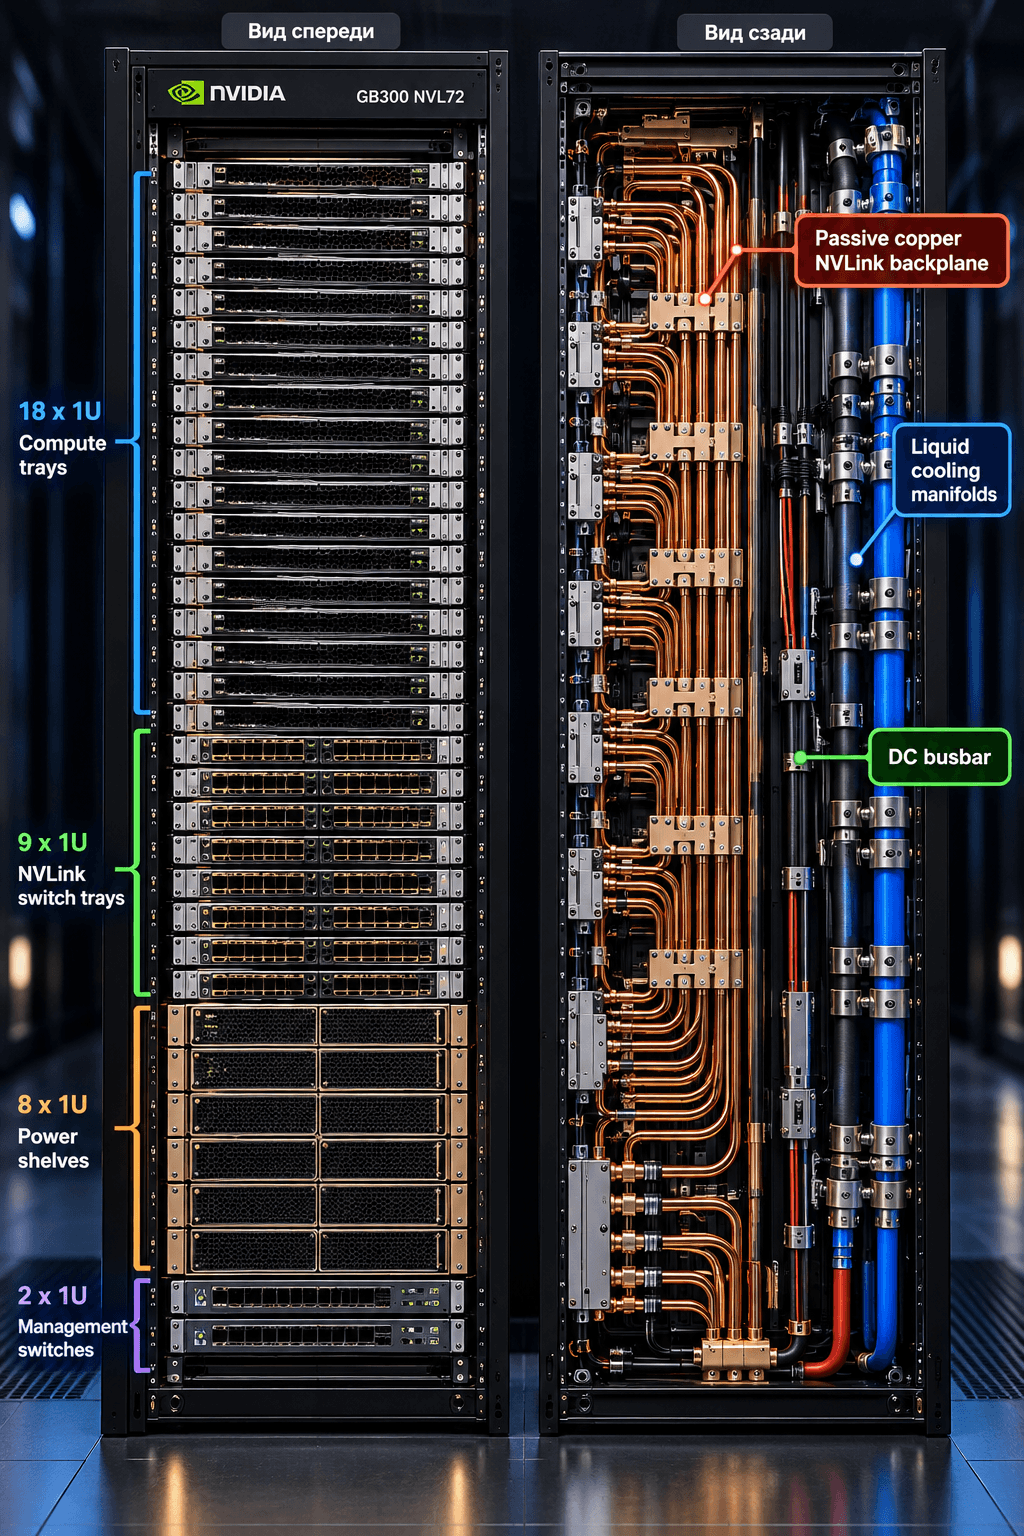
В одной стойке размещены 36 Grace CPU и 72 Blackwell Ultra GPU. Каждый вычислительный лоток содержит два Grace CPU и четыре GPU. Всего используется 18 compute trays. Еще 9 лотков содержат NVSwitch, по два switch ASIC в каждом.
Почему NVL72 нельзя называть сервером в обычном смысле
Обычный GPU-сервер представляет один host с одной ОС и несколькими ускорителями. В GB300 NVL72 находятся 18 compute nodes, каждый со своей ОС. Общий NVLink fabric пересекает границы узлов. Для доступа к памяти между OS instances используются multi-node CUDA, IMEX, Fabric Manager, NVLink Subnet Manager и другие компоненты rack-scale stack.
Система одновременно является:
физической стойкой;
кластером из 18 compute nodes;
единым 72-GPU NVLink domain;
набором отдельных CPU и GPU memory pools;
частью более крупного AI factory, если несколько стоек соединены scale-out fabric.
Такое определение важно для лицензирования, scheduler, мониторинга, отказоустойчивости и приемочных тестов. Проверка одного compute tray не подтверждает готовность всей стойки.
Характеристики NVIDIA GB300 NVL72
Параметр | Спецификация | Что означает на практике |
|---|---|---|
GPU | 72 x NVIDIA Blackwell Ultra | 72 ускорителя в одном rack-scale NVLink-домене |
CPU | 36 x NVIDIA Grace | Arm-процессоры, software stack должен поддерживать Arm64 |
CPU cores | 2 592 Arm Neoverse V2 | 72 ядра на Grace CPU по системной спецификации NVIDIA |
Compute trays | 18 x 1U | каждый tray содержит 2 Grace CPU и 4 Blackwell Ultra GPU |
NVLink switch trays | 9 x 1U | по 2 NVSwitch ASIC, всего 18 NVSwitch |
GPU memory | 20 TB HBM3e суммарно | 279 GB на GPU по Blackwell Ultra datasheet, округленное системное значение 20 TB |
CPU memory | 17 TB LPDDR5X суммарно | физически отдельна от HBM3e, связана с GPU через coherent architecture |
Fast memory | 37 TB | сумма GPU и CPU memory, а не единый массив с одинаковой latency |
GPU memory bandwidth | до 576 TB/s суммарно | паспортная сумма для 72 GPU, не storage throughput |
CPU memory bandwidth | 14 TB/s суммарно | системное значение для 36 Grace CPU |
NVLink bandwidth | 130 TB/s aggregate | scale-up fabric внутри стойки |
NVLink на GPU | до 1,8 TB/s bidirectional | внутренняя GPU-to-GPU связь, не скорость внешнего Ethernet |
FP4 Tensor Core | 1 440 PFLOPS с sparsity, 1 080 PFLOPS без sparsity | форматная peak performance, не tokens/s конкретной модели |
FP8 и FP6 Tensor Core | 720 PFLOPS с sparsity | применимость зависит от training или inference stack |
FP16 и BF16 Tensor Core | 360 PFLOPS с sparsity | паспортный показатель поддерживаемых Tensor Core операций |
Compute network | ConnectX-8, до 800 Gb/s connectivity на GPU | используется для scale-out и внешнего compute fabric |
Storage и converged network | BlueField-3 DPU | точное количество и topology фиксируются по OEM BOM |
Локальное storage | M.2 boot и E1.S NVMe cache на compute trays | исполнение различается между DGX guide, Enterprise RA и OEM |
Питание | 8 power shelves по 33 kW в reference rack | каждый shelf содержит 6 PSU по 5,5 kW и питает DC busbar |
Потребление стойки | около 120 kW в rack guide, до 142 kW в Enterprise RA | facility design использует верхнюю границу exact OEM specification |
Охлаждение | direct liquid cooling для CPU и GPU плюс воздушное охлаждение остальных компонентов | требуется liquid loop и остаточная воздушная cooling capacity |
Управление | Mission Control, BCM, BMC, NVOS, FM, NVLSM, DCGM | стойка управляется как система, а не как 18 независимых серверов |
Что в NVL72 фиксировано, а что зависит от OEM
У названия NVIDIA GB300 NVL72 есть платформенные инварианты и переменные параметры реализации.
Фиксировано архитектурой NVL72 | Проверяется в exact OEM BOM |
|---|---|
72 Blackwell Ultra GPU | manufacturer part number и hardware revision |
36 Grace CPU | точная rack height, depth и масса |
18 compute trays по 4 GPU | число и емкость E1.S на tray |
9 NVLink switch trays | число BlueField-3 на tray |
один 72-GPU NVLink domain | power input variant, whips и connectors |
130 TB/s aggregate NVLink | CDU model, coolant specification и facility connection |
20 TB HBM3e и 17 TB LPDDR5X на стойку | external switches, optics, cables и support nodes |
Текущие официальные документы показывают, почему это разделение необходимо. DGX rack guide перечисляет четыре E1.S по 3,84 TB на compute tray, а приложение к Enterprise Reference Architecture указывает восемь накопителей по 4 TB. Для BlueField-3 также встречаются конфигурации с одним и двумя DPU на tray. Эти строки нельзя смешивать в универсальную спецификацию.
Правильный источник для закупки: согласованный BOM конкретного NVIDIA-Certified или OEM-решения, его configuration guide и приемочная матрица.
Как устроена стойка GB300 NVL72
18 вычислительных лотков
Compute tray является минимальным вычислительным узлом стойки. В нем находятся:
2 NVIDIA Grace CPU;
4 Blackwell Ultra GPU;
NVLink-C2C между CPU и GPU;
интерфейсы к медной NVLink backplane;
ConnectX-8 для compute network;
BlueField-3 для storage, customer или in-band network в зависимости от реализации;
M.2 для загрузки ОС;
E1.S NVMe для локального cache;
BMC и управляющие контроллеры;
cold plates для CPU и GPU;
вентиляторы для компонентов, которые не подключены к жидкостному контуру.
9 NVLink switch trays
Каждый switch tray содержит два NVSwitch ASIC, по 72 NVLink ports на ASIC, NVOS, BMC, Fabric Manager, NVLink Subnet Manager и security components. Девять trays дают 18 NVSwitch.
NVLink switch layer выполняет три задачи:
обнаруживает topology и формирует fabric;
программирует маршруты между GPU и NVSwitch ports;
контролирует состояние ссылок и ошибки.
Для штатного включения сначала запускают и конфигурируют switch trays, затем compute trays. Если compute nodes стартуют раньше готового fabric, может потребоваться их перезапуск. Порядок power-on является частью operational runbook.
Медная NVLink backplane
Compute trays подключаются к switch trays через passive copper cable cartridge backplane. Внутристоечный scale-up traffic не проходит через внешние Ethernet либо InfiniBand switches. Это уменьшает число optical links для NVLink domain и дает 1,8 TB/s bidirectional bandwidth на GPU.
Backplane одновременно усложняет физическую эксплуатацию. Нельзя считать trays полностью независимыми hot-swap серверами без учета состояния fabric, cable cartridges, partitions и процедуры возврата компонента в домен.
Power shelves и DC busbar
Reference rack содержит восемь power shelves. В каждом установлено шесть воздушно охлаждаемых PSU по 5,5 kW, shelf способен выдавать до 33 kW. Power whips подают AC с удаленной панели, shelves преобразуют его в 50-51 V DC, после чего энергия распределяется через busbar.
Номинальная сумма возможностей shelves не равна потреблению стойки. Дополнительная мощность нужна для резервирования и работы power architecture. В проекте сравнивают:
operating power при реальной workload;
rack design power;
electrical design peak;
доступную мощность A и B feeds;
ограничения каждого whip, breaker, busway и panel;
поведение при потере одного элемента power path.
Память и NVLink: что означают 37 TB
Система имеет 20 TB HBM3e у GPU и 17 TB LPDDR5X у Grace CPU. NVIDIA называет сумму 37 TB fast memory. Это полезная системная характеристика, но не обещание одного плоского пула с одинаковой полосой и задержкой.
HBM3e
HBM3e находится рядом с GPU и используется для weights, activations, gradients, optimizer states, KV-cache и рабочих буферов. Blackwell Ultra datasheet указывает 279 GB HBM3e и 8 TB/s на GPU для варианта GB300 NVL72.
Суммарные 20 TB не означают, что один CUDA process автоматически видит всю память как local VRAM. Framework распределяет tensors между 72 GPU и управляет parallelism. Фактическая доступная емкость меньше номинальной из-за runtime workspace, communication buffers, CUDA graphs, фрагментации и резерва.
LPDDR5X Grace
17 TB CPU memory используются для host-side datasets, preprocessing, staging, CPU-resident data structures, storage buffers и других частей pipeline. Coherent connection через NVLink-C2C упрощает доступ между CPU и GPU memory, но физическая локальность продолжает влиять на performance.
Перенос working set из HBM в CPU memory может позволить выполнить задачу, но не гарантирует скорость HBM. Поэтому sizing должен разделять:
объем, который обязан постоянно находиться в HBM;
данные, допустимые в Grace memory;
local NVMe cache;
shared storage;
checkpoint и recovery path.
130 TB/s NVLink
Совокупная полоса NVLink на стойку составляет 130 TB/s. Каждый GPU имеет 18 links и подключается к 18 NVSwitch через backplane. Система формирует non-blocking connectivity для 72 GPU.
NVLink помогает workloads с интенсивным обменом:
tensor parallelism;
expert parallelism и all-to-all;
pipeline parallelism;
large-scale attention;
GPU-initiated memory exchange;
fine-grained communication через NVSHMEM.
Четыре сетевых контура GB300 NVL72
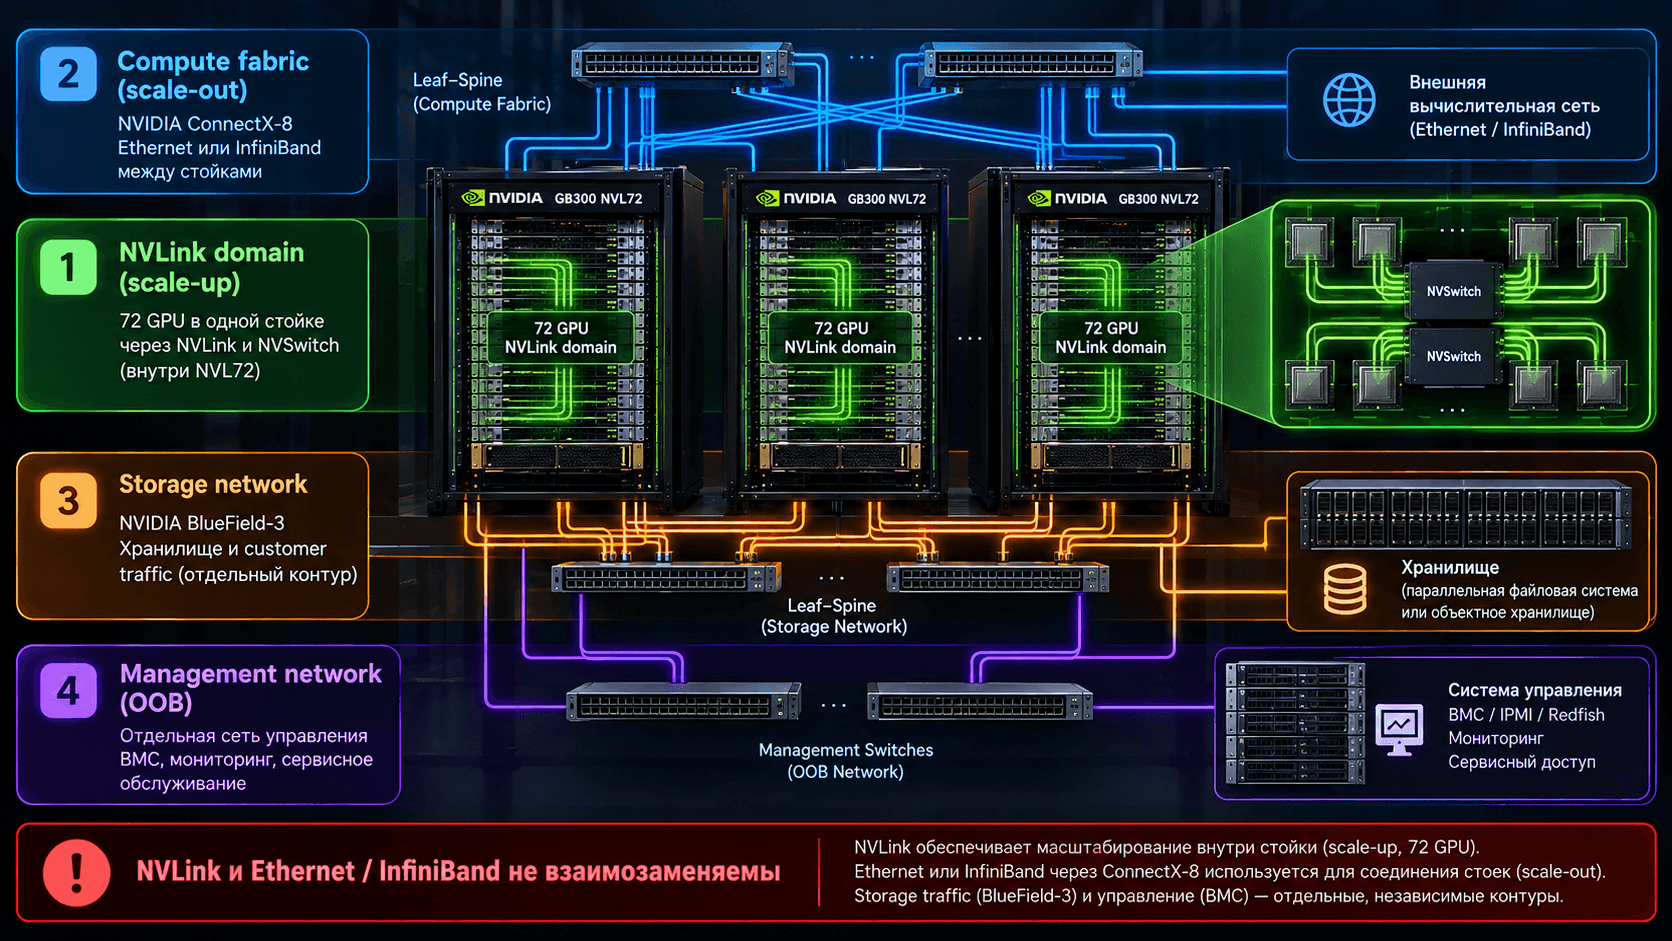
Проект сети нельзя выразить одной строкой 800G. В системе есть минимум четыре fabric roles.
Контур | Основная технология | Назначение |
|---|---|---|
NVLink scale-up | NVLink 5 и NVSwitch | GPU-to-GPU traffic между 72 GPU внутри стойки |
GPU compute East/West | ConnectX-8, Spectrum-X Ethernet или Quantum-X800 InfiniBand | scale-out между стойками и distributed compute traffic |
Converged, storage и customer North/South | BlueField-3 и high-speed Ethernet или InfiniBand | СХД, сервисы, пользователи, orchestration и external data |
OOB management | BMC и management switches | provisioning, health, power, firmware и recovery |
NVLink не заменяет внешнюю сеть
Одна стойка получает большой внутренний 72-GPU домен. При масштабировании на две или больше стоек NVLink не объединяет их автоматически в один L1 domain. Межстоечный traffic проходит через ConnectX-8 и внешнюю leaf-spine fabric.
Даже в single-rack проекте external network нужна для storage, control plane, users, services и future expansion. Ее пропускная способность рассчитывается по workload, а не по числу GPU.
ConnectX-8 и 800G на GPU
Каждый compute tray имеет четыре ConnectX-8 в reference architecture, один путь на каждый GPU. Для tray это до 3,2 Tb/s nominal endpoint connectivity, для 18 trays получается 72 adapters.
Эти значения не являются application throughput. Нужно зафиксировать:
один 800G interface или breakout 2 x 400G;
число planes и rails;
GPU-to-NIC mapping;
leaf и spine models;
oversubscription в штатном и degraded mode;
optics, cables, FEC и reach;
RoCE congestion control либо InfiniBand management;
GPUDirect RDMA path;
NCCL topology и collective tests.
Методика выбора технологии разобрана в статье InfiniBand или RoCE для GPU-кластера. Номинальную скорость и число links следует дополнительно проверять по руководству как выбрать сеть для GPU-кластера, где 800G рассматривается как отдельный класс современной fabric.
BlueField-3 и North/South traffic
BlueField-3 обслуживает storage, customer, in-band management и infrastructure services в зависимости от design. В Enterprise RA используется dual-port B3240 с двумя 400G ports, но aggregate throughput карты меньше арифметической суммы line rates. Поэтому 2 x 400G нельзя автоматически превращать в 800G полезной полосы DPU.
Storage для GB300 NVL72
Локальные E1.S используются как cache, а M.2 загружает ОС compute tray. В DGX rack guide указаны четыре E1.S по 3,84 TB и один M.2 по 1,92 TB на tray. Для 18 trays это 276,48 TB raw cache и 34,56 TB суммарной raw boot capacity. Это арифметика конкретной конфигурации, а не универсальная спецификация каждого OEM.
Cache drives собраны в software RAID 0. Такой массив ускоряет повторное чтение dataset, но не является надежным местом для единственной копии данных. Потеря одного drive может потребовать перестроить cache.
Рабочая иерархия выглядит так:
shared high-performance storage хранит исходные datasets, primary checkpoints и общие artifacts;
storage network подает данные compute trays;
E1.S cache удерживает повторно используемые файлы и временные checkpoints;
Grace memory готовит и буферизует данные;
HBM3e обслуживает активный GPU working set.
Для sizing СХД нужны aggregate read throughput, checkpoint burst, metadata profile, file count, число одновременных jobs, recovery time и рост datasets. Объем в petabytes без I/O profile не позволяет выбрать архитектуру. Базовые различия block, file и object storage разобраны в статье система хранения данных: виды и архитектура СХД.
Требования GB300 NVL72 к дата-центру
Габариты, масса и маршрут доставки
Точные размеры определяет OEM. Например, документация Lenovo указывает для rack solution ширину 600 mm, глубину 1 068 mm с расширением до 1 200 mm и массу около 1 580 kg. HPE публикует близкую ширину и глубину, но другую высоту и массу около 1 500 kg. Эти цифры показывают класс нагрузки, но не заменяют shipping drawing заказанного SKU.
До поставки проверяют:
doorways, коридоры, повороты и freight elevator;
допустимую точечную, распределенную и динамическую нагрузку пола;
raised floor и support frame, если они используются;
разгрузочную площадку и оборудование для перемещения;
высоту потолка и overhead utilities;
front, rear и side service clearances;
возможность безопасно извлекать trays;
расположение CDU, manifolds, valves и hoses;
cable trays для compute, storage, OOB и power.
Электропитание
NVIDIA rack guide приводит около 120 kW потребления, Enterprise RA требует до 142 kW на полную стойку. Разница объясняет, почему нельзя проектировать power path по одной маркетинговой цифре.
При непрерывной нагрузке 120 kW стойка потребляет 2,88 MWh за сутки до учета PUE и вспомогательной инфраструктуры. Это не прогноз фактического счета, а проверка порядка величины:
120 kW x 24 h = 2 880 kWh
Electrical design должен включать:
exact input voltage и three-phase configuration OEM;
power whips и connectors;
remote power panels, busway и breaker coordination;
A и B feeds;
N+N behavior power shelves;
fault current, grounding и protective devices;
capacity при отказе feed, shelf или PSU;
metering по rack и subsystem;
emergency power-off procedure;
UPS или другую ride-through strategy, если она требуется бизнесом;
работу генераторов и переходные режимы;
power caps и согласование с workload scheduler.
Нельзя подключить такую стойку к существующей PDU только потому, что в ней есть свободные розетки. GB300 NVL72 использует power shelves, busbar и проектные whips.
Жидкостное и воздушное охлаждение
NVIDIA называет платформу liquid-cooled. Технически cooling hybrid: cold plates отводят тепло CPU и GPU, а network, storage, power и другие компоненты продолжают использовать воздух. Значит, ЦОД должен одновременно обеспечить liquid loop и residual air cooling.
Для upper design value 142 kW полный тепловой эквивалент составляет примерно 484 500 BTU/h:
142 kW x 3 412 BTU/h на kW = 484 504 BTU/h
Это оценка общего тепла, которое в итоге должен отвести facility. Доля liquid и air определяется exact OEM design и условиями эксплуатации.
В проект cooling входят:
CDU architecture: in-rack, in-row, facility-connected или liquid-to-air вариант, если он поддержан OEM;
facility water system и technology cooling system;
supply и return temperatures;
flow и differential pressure;
coolant chemistry, filtration и water quality;
dew point и защита от condensation;
pumps, heat exchangers и redundancy;
isolation valves, quick disconnects и service procedure;
leak detection на tray и rack level;
drainage и emergency response;
остаточная воздушная нагрузка и hot aisle management;
telemetry в BMS и Mission Control.
Универсальные значения температуры воды или flow rate в статье опасны. Они зависят от OEM rack, CDU, coolant и revision. В ТЗ указывают exact vendor limits, а на приемке измеряют supply, return, flow, pressure, leak alarms и performance под устойчивой нагрузкой.
Внешняя сеть и кабельная инфраструктура
Compute rack не содержит полный multi-rack leaf-spine fabric. Внешние switches, optics и cables занимают дополнительные стойки и потребляют отдельную мощность. Для одной scalable unit reference architecture предусматривает 72 ConnectX-8 endpoints. Dual-plane design может использовать breakout на 400G и большое число физических соединений.
До заказа нужно завершить:
high-level и low-level network design;
rack elevations compute и network racks;
port mapping до каждого tray и rail;
расчет leaf, spine, oversubscription и failure domains;
точный BOM switches, optics, DAC или AOC;
fiber type, polarity, length и loss budget;
cable routing без нарушения bend radius и service access;
IP plan для BMC, host, DPU, switch management и services;
firmware и NOS compatibility matrix;
telemetry, time synchronization и log collection.
Сетевой BOM часто оказывается крупнее, чем предполагает строка 800 Gb/s per GPU. Считать нужно физические ports и links, а не только логические adapters.
Управляющие и сервисные узлы
NVIDIA Mission Control требуется для installation и management GB200 и GB300 NVL72. Management plane не следует размещать как случайные виртуальные машины без учета availability, network isolation и recovery.
Нужны:
Base Command Manager head nodes;
provisioning network;
DNS, DHCP или утвержденная static addressing policy;
NTP или PTP по требованиям системы;
internal registries и package repositories;
authentication и secrets management;
Slurm либо Kubernetes integration;
logging, metrics и alert routing;
backup управляющих конфигураций;
break-glass access;
support connectivity или air-gapped update workflow.
Arm64 и программная совместимость
Grace использует Arm Neoverse V2. Перед закупкой проверяют:
container images для
linux/arm64;CUDA и framework version;
TensorRT-LLM, vLLM, Triton или другой inference stack;
PyTorch extensions и custom CUDA kernels;
MPI, NCCL, NVSHMEM и UCX;
storage clients и kernel modules;
security, backup и monitoring agents;
коммерческие лицензии с привязкой к architecture;
build pipeline и private package repository.
Образ, который запускается на x86 DGX B300, не обязан запускаться на Grace без изменений. Multi-architecture image manifest тоже не гарантирует, что внутри есть все нужные native dependencies.
Программный стек rack-scale системы
Управление NVL72 распределено между compute nodes, switch nodes, power shelves и management plane. Обновлять только GPU driver недостаточно.
Mission Control
Mission Control связывает inventory, provisioning, topology-aware scheduling, health checks, power profiles, job recovery и facilities telemetry. Для GB300 NVL72 оно также координирует power и cooling events, включая leak detection.
Система нужна не только для красивого dashboard. Она хранит модель rack topology и помогает управлять отказами на уровне trays, NVLink fabric и workloads.
Fabric Manager и NVLink Subnet Manager
Fabric Manager программирует NVSwitch memory fabric, координируется с GPU driver и отслеживает ошибки links. NVLSM обнаруживает NVLink topology, назначает identifiers и программирует forwarding tables.
Эти компоненты должны соответствовать firmware, NVOS и GPU driver. Firmware recipes применяются как согласованный набор. Выборочно обновлять один ASIC или daemon без release procedure рискованно.
IMEX и multi-node CUDA
IMEX позволяет безопасно экспортировать и импортировать GPU memory через NVLink между OS instances. Это важная часть 72-GPU domain, поскольку compute trays остаются отдельными nodes.
IMEX не объединяет память безусловно для любого приложения. Processes получают доступ через channels и driver mechanisms, а framework должен поддерживать нужную модель исполнения.
NCCL, NVSHMEM, UCX и DCGM
NCCL реализует collective и point-to-point operations. NVSHMEM предоставляет GPU-initiated communication и partitioned global address space. UCX дает transport APIs. DCGM контролирует GPU и NVSwitch health, diagnostics, alerts, power и clocks.
Для каких задач нужен GB300 NVL72
Training и post-training крупных моделей
Один 72-GPU NVLink domain полезен, когда модель и training state требуют масштабирования значительно шире восьми GPU, а communication находится в critical path. Типичные candidates:
large-scale pretraining;
supervised fine-tuning крупных foundation models;
reinforcement learning и связанные post-training pipelines;
mixture-of-experts с интенсивным all-to-all;
multimodal models с большим working set;
workloads, которым нужен крупный scale-up domain.
Польза NVL72 определяется измеряемым сокращением step time или time-to-train. Количество параметров само по себе не доказывает необходимость 72 GPU.
Reasoning и high-throughput inference
GB300 NVL72 позиционируется для test-time scaling и AI reasoning. Большая HBM3e помогает размещать крупные weights и KV-cache, а FP4 повышает потенциальную inference throughput.
Проект все равно должен задать:
exact model и revision;
precision и quantization method;
context length distribution;
concurrent sequences;
TTFT и inter-token latency;
throughput target;
tensor, pipeline и expert parallelism;
batching и routing policy;
model replicas и failure behavior.
Иногда одна workload требует весь NVLink domain. В другом проекте выгоднее запустить несколько replicas на partitions или отдельных ресурсных группах. Выбор подтверждается benchmark и scheduler design.
Когда NVL72 избыточна
Стойка, скорее всего, не нужна, если:
workload уверенно помещается на одном 8-GPU сервере;
модель плохо масштабируется дальше одного node;
сервис ограничен базой данных, CPU preprocessing или external API;
целевой traffic мал и GPU будут простаивать;
организация не готова поддерживать Arm64 stack;
площадка не имеет liquid cooling и power density;
нет команды для эксплуатации fabric, storage и Mission Control;
задача лучше решается несколькими независимыми inference nodes;
нужен пилот, а не production-scale capacity.
GB300 NVL72, DGX B300 или несколько HGX B300
Критерий | GB300 NVL72 | NVIDIA DGX B300 | OEM HGX B300 servers |
|---|---|---|---|
Масштаб | 72 GPU в одной стойке | 8 GPU в одном 10U узле | 8 GPU на сервер, число узлов выбирается проектом |
CPU architecture | Grace Arm64 | Intel Xeon x86_64 | Intel или AMD x86_64 по OEM |
Scale-up domain | 72 GPU через NVLink switch fabric | 8 GPU через NVLink и NVSwitch | 8 GPU на узел |
Cooling | direct liquid для CPU и GPU плюс air | воздушное | воздушное или жидкостное по модели |
Мощность | до 142 kW для rack reference design | до 15 kW на систему | зависит от OEM server |
Кастомизация | ограничена rack architecture и OEM options | ограничена фиксированной DGX configuration | выше на уровне CPU, RAM, storage и chassis |
Порог ЦОД | очень высокий | высокий | зависит от выбранных узлов и плотности |
Основной сценарий | крупный 72-GPU scale-up workload | унифицированный восьми-GPU node | гибкий кластер из OEM nodes |
Девять DGX B300 тоже дают 72 GPU, но не являются эквивалентом NVL72. Каждый DGX имеет собственный восьми-GPU NVLink domain, а обмен между серверами проходит по external fabric. В GB300 NVL72 все 72 GPU находятся в одном внутристоечном NVLink domain.
Обратное тоже верно: NVL72 не всегда лучше девяти независимых узлов. Для многих inference services failure isolation, независимое обслуживание и гибкое распределение replicas могут быть важнее большого scale-up domain.
OEM-исполнения и выбор поставщика
На рынке доступны решения NVIDIA и партнеров. В каталоге Start Server представлены референсная NVIDIA GB300 NVL72 и Supermicro NVIDIA GB300 NVL72. Брендовый запрос Supermicro присутствует в Wordstat отдельно, но выбирать OEM только по названию нельзя.
Сравнивают:
exact system SKU и revision;
rack dimensions и operating weight;
installed compute, switch и power trays;
локальное storage каждого tray;
BlueField-3 count и port map;
electrical input options;
CDU options и facility requirements;
external network BOM;
control plane и support servers;
included software entitlements;
installation scope;
warranty, support, spare strategy и response time;
acceptance tests и performance baseline.
NVIDIA GB300 NVL72: цена и состав проекта
Запросы NVIDIA GB300 NVL72 цена и NVIDIA GB300 NVL72 купить нельзя закрыть одной цифрой без даты и scope. Цена стойки является только частью бюджета.
В полный проект входят:
compute rack и hardware support;
внешняя compute fabric;
converged, storage и management network;
optics, cables и cable management;
shared storage;
CDU и facility water integration либо поддерживаемый alternative cooling design;
power panels, busway, whips и metering;
network и control plane racks;
management servers и Mission Control;
доставка, страхование, разгрузка и перемещение;
монтаж, flushing, pressure test и commissioning cooling loop;
software integration и security hardening;
acceptance tests;
spares, training и эксплуатационная документация.
Коммерческие предложения полезно сравнивать после приведения к единому requirement revision и responsibility matrix. Подробный шаблон дан в статье как сравнить коммерческие предложения на GPU-сервер.
Минимальный запрос поставщику
Передайте:
model и workload profile;
требуемое число racks сейчас и в следующей фазе;
точный OEM либо требование сравнить несколько вариантов;
facility power topology;
cooling architecture и параметры facility water;
floor loading и logistics survey;
InfiniBand или Spectrum-X Ethernet preference;
storage capacity и I/O profile;
security и air-gap requirements;
scheduler, orchestration и tenancy model;
support level;
границы installation и acceptance.
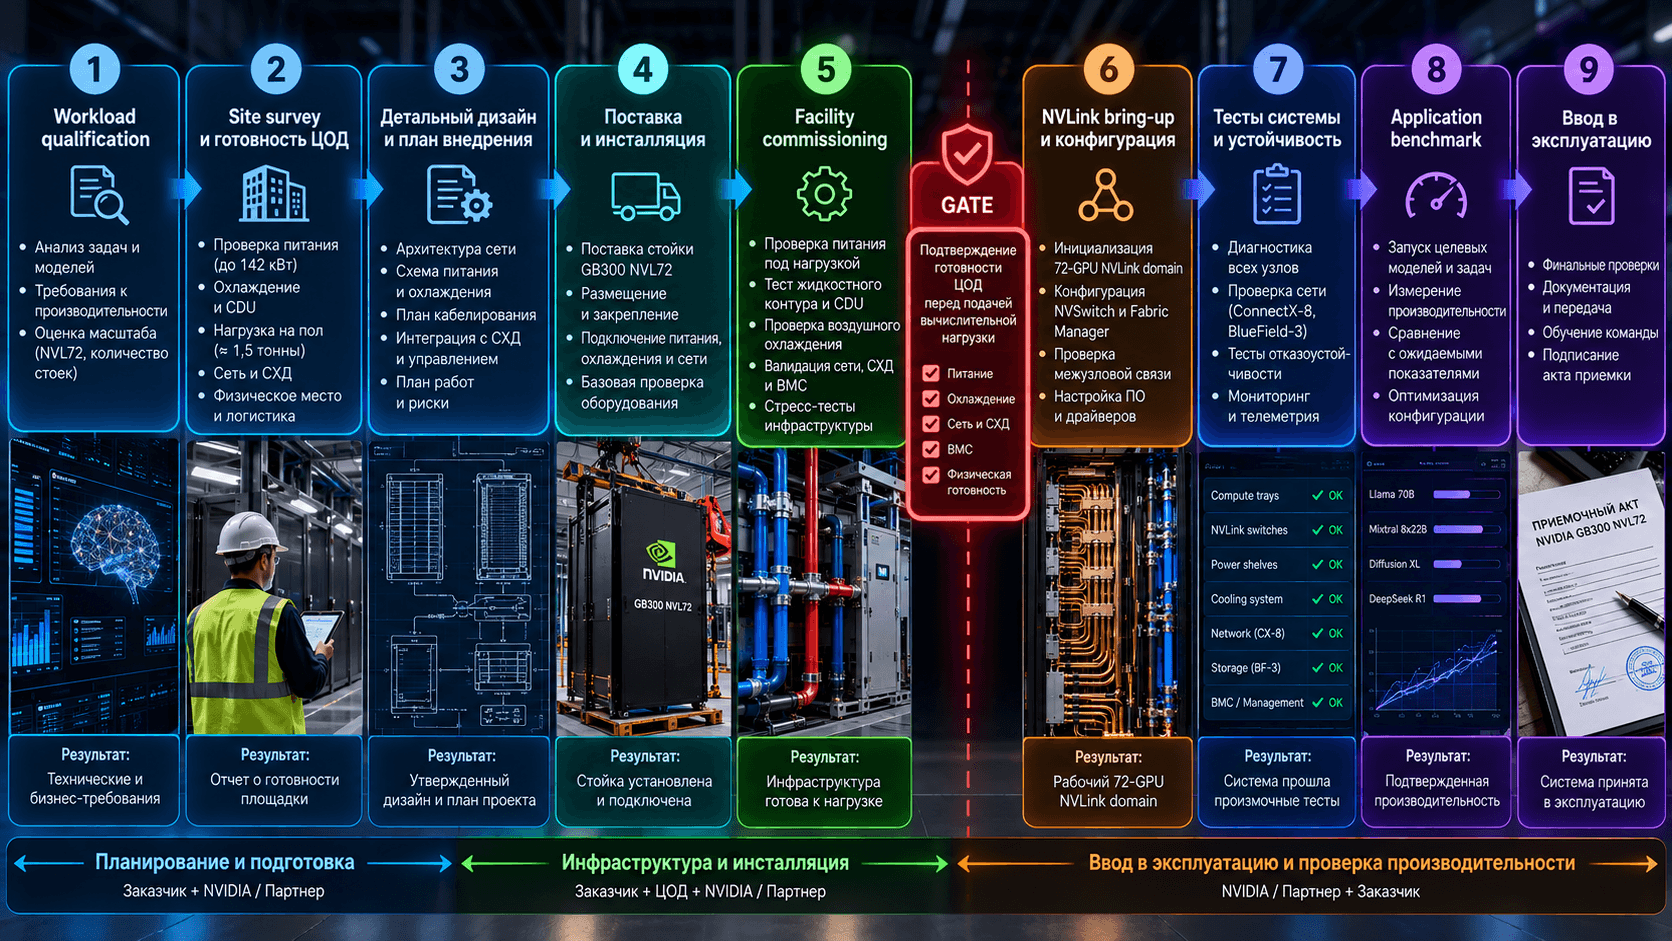
Порядок внедрения GB300 NVL72
Этап 1. Workload qualification
Сначала измеряют текущий baseline, memory footprint и communication profile. На этом этапе доказывают, что нужен 72-GPU scale-up domain, а не меньший кластер.
Этап 2. Site readiness
Проводят обследование электрики, cooling, пола, логистики, пространства, сети, СХД и management plane. Результат оформляют как checklist с владельцем и датой закрытия каждого пункта.
Этап 3. Low-level design
Фиксируют BOM, port map, IP plan, rack elevations, power schedule, coolant diagram, cable matrix, software versions, security zones и monitoring integration.
Этап 4. Factory и pre-delivery validation
Проверяют inventory, firmware recipe, tray health, NVLink components, power shelves, leak sensors и комплектность. Доказательства сохраняют до отправки.
Этап 5. Доставка и механический монтаж
Используют утвержденный route, lifting procedure и trained personnel. После размещения проверяют геометрию, фиксацию, grounding, busbar, hoses и cables.
Этап 6. Power и cooling commissioning
Проверяют feeds, фазировку, breakers, shelves, busbar, CDU, pumps, flow, pressure, temperatures, water quality, leak detection и аварийные сценарии. Compute не нагружают до подтверждения facility readiness.
Этап 7. Network и control plane bring-up
Запускают OOB, provisioning, switch management, storage и compute fabrics. Проверяют firmware, link state, FEC, errors, routing, congestion control и time synchronization.
Этап 8. NVLink fabric bring-up
Сначала включают NVLink switch trays, затем compute trays. Проверяют 72-GPU domain, Fabric Manager, NVLSM, IMEX, partitions и topology.
Этап 9. Приемочные испытания
Программа должна включать:
inventory всех 72 GPU и 36 CPU;
HBM3e и LPDDR5X capacity;
health каждого compute и switch tray;
NVLink topology и errors;
multi-node bandwidth и NCCL collectives;
ConnectX-8 и BlueField-3 links;
shared storage throughput и metadata tests;
local cache behavior;
sustained power и cooling run;
leak detection alarms;
power failure и degraded-mode процедуры в безопасной согласованной форме;
application benchmark;
checkpoint, restart и job recovery;
monitoring, alert delivery и evidence retention.
Частые вопросы о NVIDIA GB300 NVL72
Что такое NVIDIA GB300 NVL72?
Это rack-scale AI-система с 72 GPU Blackwell Ultra и 36 Grace CPU, объединенными NVLink и NVSwitch. Стойка включает 18 compute trays, 9 switch trays, power shelves, liquid cooling manifolds и управляющую инфраструктуру.
Сколько памяти в GB300 NVL72?
NVIDIA указывает 37 TB fast memory: 20 TB HBM3e у GPU и 17 TB LPDDR5X у Grace CPU. Это два физических уровня памяти с разными свойствами, а не один плоский пул одинаковой скорости.
Какая пропускная способность NVLink у GB300 NVL72?
Совокупная NVLink bandwidth составляет 130 TB/s. Каждый Blackwell Ultra GPU поддерживает до 1,8 TB/s bidirectional NVLink. Эти значения описывают scale-up fabric внутри стойки.
Сколько потребляет NVIDIA GB300 NVL72?
DGX rack guide приводит около 120 kW, а актуальная Enterprise Reference Architecture указывает до 142 kW для полной стойки. Электропитание проектируют по exact OEM limits, режиму резервирования и требованиям площадки.
Нужно ли GB300 NVL72 жидкостное охлаждение?
Да. CPU и GPU охлаждаются жидкостью через cold plates. Остальные компоненты частично охлаждаются воздухом, поэтому требуется и residual air cooling. Конкретные CDU, flow, temperatures, pressure и coolant quality определяет OEM design.
Можно ли поставить GB300 NVL72 в обычный ЦОД?
Только после site readiness assessment. Нужно подтвердить power capacity до верхней границы конкретного OEM design, liquid cooling, floor loading, маршрут доставки, 48U rack geometry, внешнюю сеть, СХД и management plane. Наличие свободного места в зале не подтверждает готовность всех этих контуров.
Чем GB300 NVL72 отличается от DGX B300?
DGX B300 является отдельным 10U x86-сервером на восьми B300 с воздушным охлаждением. GB300 NVL72 является полной жидкостно охлаждаемой стойкой с 72 GPU, 36 Grace CPU и единым rack-scale NVLink domain.
Нужна ли внешняя сеть, если внутри есть NVLink?
Да. NVLink связывает GPU внутри стойки. ConnectX-8 нужен для scale-out между стойками и compute traffic, BlueField-3 для storage и North/South traffic, отдельный OOB network для управления.
Что входит в локальное storage GB300 NVL72?
В DGX rack guide каждый compute tray имеет M.2 boot drive и четыре E1.S cache drives. OEM-исполнение может отличаться. Локальный RAID 0 cache не заменяет shared high-performance storage для primary datasets и checkpoints.
Какая ОС нужна для GB300 NVL72?
Compute trays работают на Arm64 software stack для Grace. Управление выполняют Mission Control и BCM, NVLink switch trays используют NVOS, а fabric обслуживают Fabric Manager и NVLSM. Exact release matrix фиксируется для конкретной поставки.
Сколько стоит NVIDIA GB300 NVL72?
Цена меняется вместе с OEM, revision, support и составом проекта. К compute rack добавляются network fabric, СХД, CDU, электрика, optics, control plane, доставка, монтаж и приемка. Сравнивать нужно одинаковый scope.
Где купить NVIDIA GB300 NVL72?
Выбирать следует не только по наличию стойки, но и по способности поставщика выполнить site survey, спроектировать power, cooling, network и storage, организовать внедрение и подтвердить работу всей системы приемочными тестами.
Как подготовить проект GB300 NVL72
Start Server поставляет и интегрирует rack-scale AI-системы вместе с сетью, СХД, стойками, электропитанием, охлаждением, монтажом и испытаниями. Для предварительного расчета нужны workload, memory и communication profile, число стоек, параметры ЦОД и требования к срокам восстановления.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


