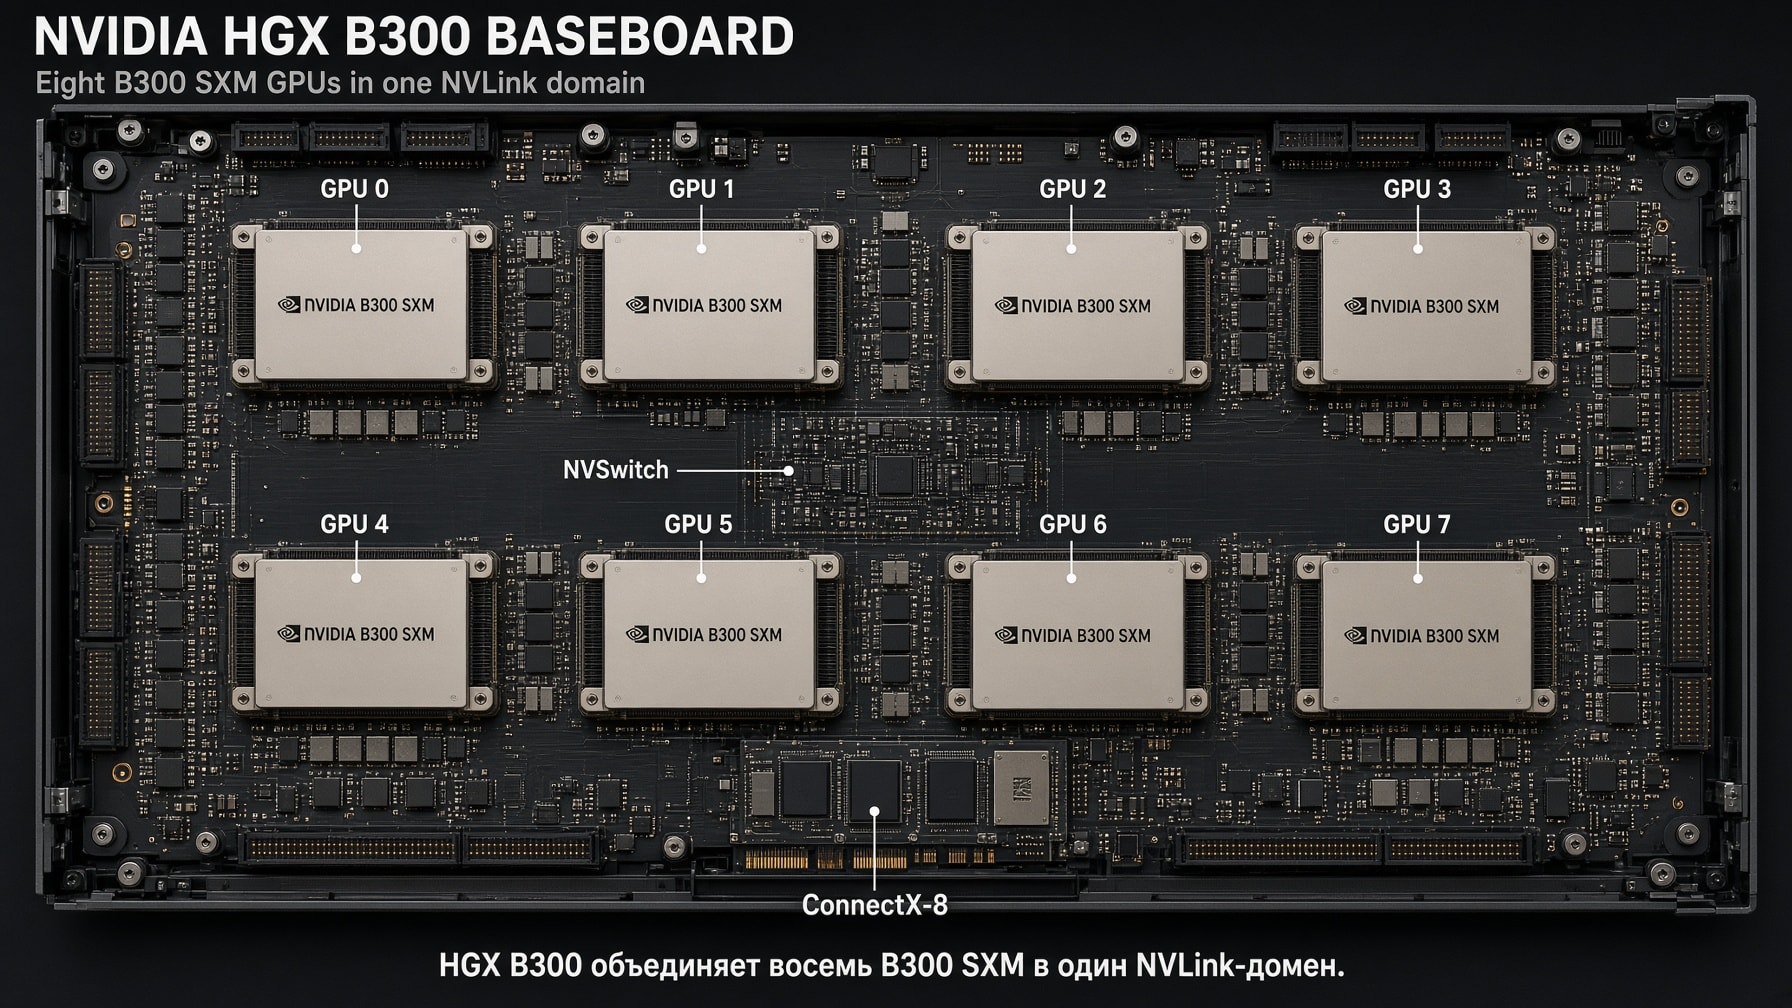
NVIDIA HGX B300 представляет собой базовую вычислительную платформу с восемью GPU Blackwell Ultra в форм-факторе SXM. Все восемь ускорителей объединены NVLink пятого поколения и NVSwitch в один высокоскоростной GPU-домен. На основе этого baseboard производители строят законченные серверы с x86 CPU, оперативной памятью, NVMe, сетевыми адаптерами, блоками питания, BMC и системой охлаждения.
HGX B300 нельзя считать обычным восьмикартовым PCIe-сервером. GPU устанавливаются на специализированный baseboard, а обмен между ними идет через NVLink с пропускной способностью до 1,8 TB/s на GPU. Совокупная полоса NVLink для платформы составляет 14,4 TB/s. Это позволяет распределять крупную модель между восемью ускорителями без зависимости от одного PCIe fabric.
В официальных источниках встречаются две спецификации памяти. Общая страница HGX и Blackwell Ultra datasheet указывают 270 GB HBM3e на GPU и 2,1 TB на платформу. Актуальная NVIDIA Enterprise Reference Architecture и DGX B300 используют 288 GB на GPU и 2,30 TB на узел. Для закупки нужно фиксировать точный SKU и фактическую память, а не выбирать удобную цифру из разных документов.
Что такое NVIDIA HGX B300
HGX является платформой NVIDIA для построения плотных multi-GPU серверов. В случае HGX B300 основной модуль включает восемь GPU B300 Blackwell Ultra, NVLink, NVSwitch и интерфейсы для подключения к хостовой части и сети. Сам по себе baseboard не является готовым сервером.
Производитель системы добавляет:
два x86-процессора и CPU baseboard;
DDR5 ECC RAM;
локальные NVMe для ОС, cache и checkpoints;
сетевые порты и DPU;
BMC и удаленное управление;
блоки питания и распределение мощности;
воздушное или жидкостное охлаждение;
корпус, обычно высокой плотности для серверной стойки;
firmware, validation и сервисную модель.
Что означает HGX B300 NVL8
В поиске и части программной документации встречается название NVIDIA HGX B300 NVL8. Оно обозначает восьми-GPU scale-up domain, где B300 связаны через NVLink и NVSwitch. В основной таблице продуктов NVIDIA платформа чаще называется просто HGX B300.
В коммерческой спецификации одного слова NVL8 недостаточно. Следует указать:
восемь NVIDIA B300 SXM;
точную емкость HBM3e каждого GPU;
NVLink пятого поколения;
NVSwitch fabric;
bandwidth GPU-to-GPU и всей платформы;
host PCIe topology;
модель и количество ConnectX-8;
firmware и поддерживаемый software stack.
Такой список исключает ситуацию, когда одинаковое маркетинговое обозначение скрывает разные сетевые или host-конфигурации.
Как устроена платформа HGX B300 на 8 GPU
Восемь B300 SXM
В HGX B300 используются восемь датацентровых GPU Blackwell Ultra в форм-факторе SXM. Это не сменные PCIe-карты с собственным кулером. SXM-модули рассчитаны на монтаж на специальный baseboard, высокую мощность и прямое соединение с NVSwitch.
Для общей HGX-спецификации NVIDIA указывает до 1 100 W TDP на один B300. Восемь GPU могут потреблять до 8,8 kW только на ускорители. Процессоры, RAM, NVSwitch, NIC, накопители, вентиляторы и потери блоков питания увеличивают потребление законченного сервера.
NVLink пятого поколения и NVSwitch
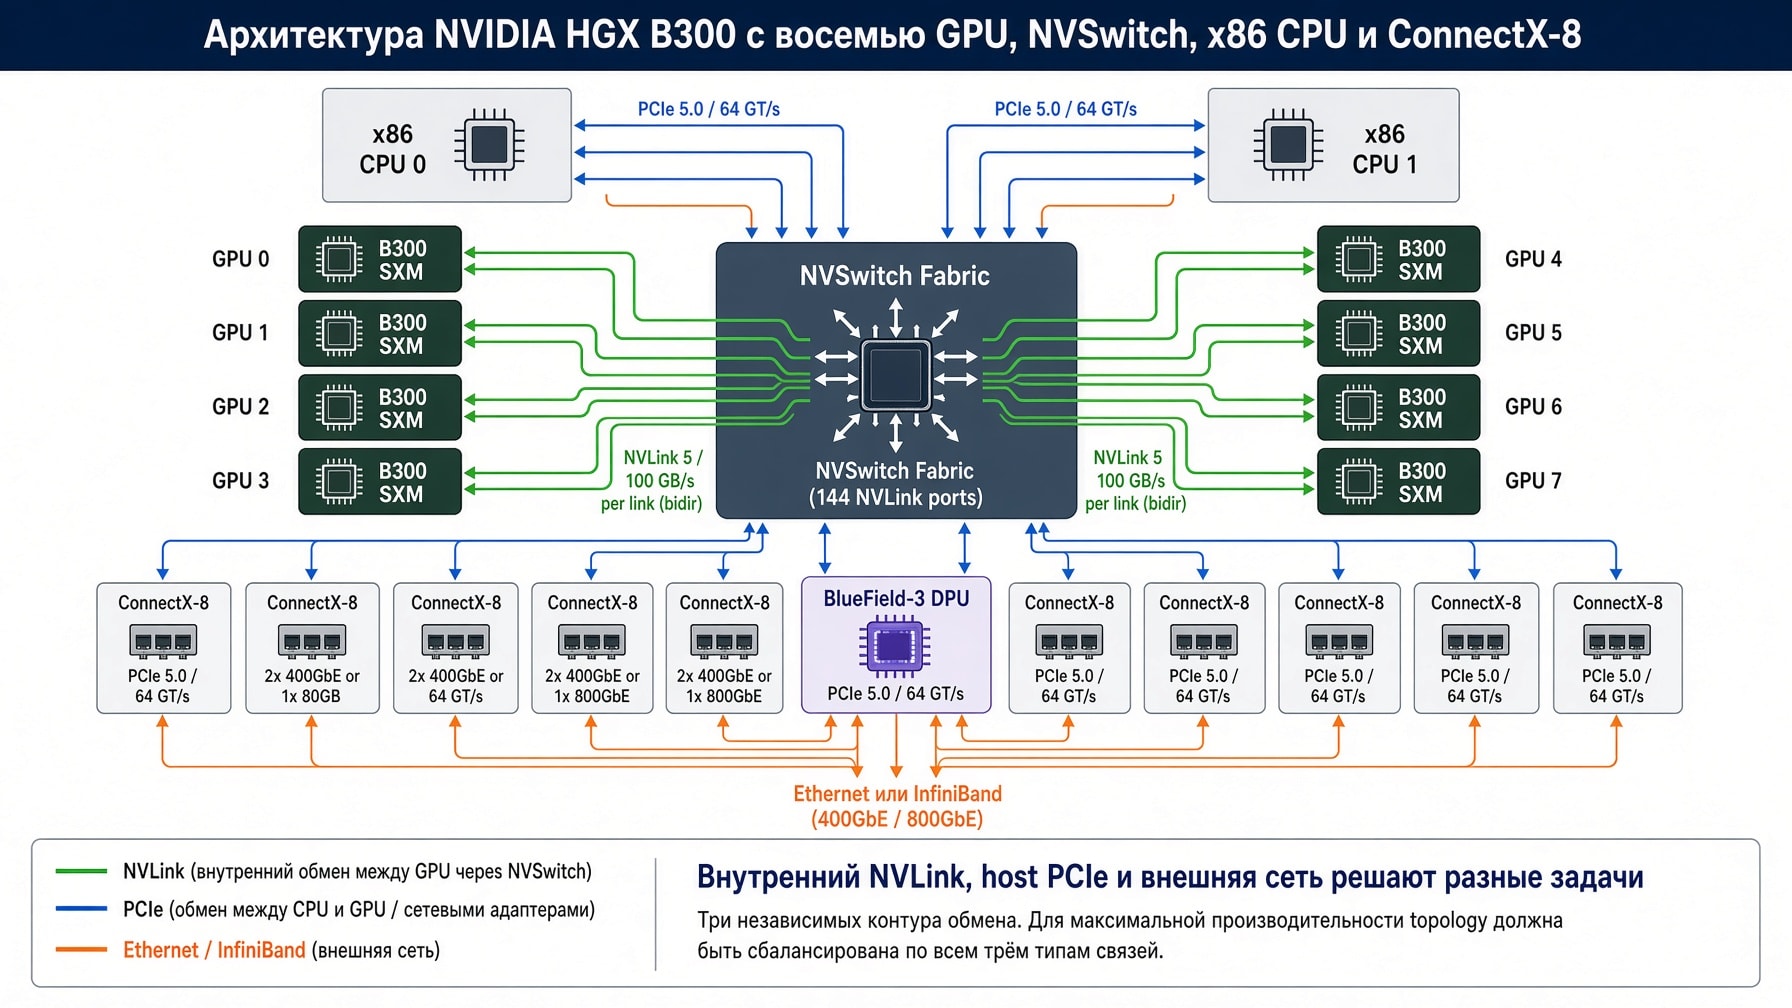
Каждый B300 поддерживает до 1,8 TB/s двунаправленной GPU-to-GPU полосы через NVLink. NVSwitch объединяет восемь ускорителей в общий высокоскоростной домен. NVIDIA указывает 14,4 TB/s совокупной NVLink bandwidth для HGX B300.
NVLink не объединяет восемь HBM в один автоматически прозрачный массив. Framework должен распределить weights, activations, optimizer states и KV-cache между GPU. Tensor parallelism, pipeline parallelism, expert parallelism и data parallelism создают разные patterns обмена.
Преимущество HGX проявляется, когда workload действительно использует связь GPU-to-GPU. Если восемь независимых моделей запускаются по одной на каждом GPU, важнее локальная HBM, scheduling и внешняя сеть. Если одна модель разделена на весь узел, критичны NVLink, collectives и placement.
Связь с хостовыми CPU
HGX B300 является x86-платформой. В NVIDIA Enterprise Reference Architecture узел имеет два CPU. Поддерживаются серверные семейства AMD EPYC и Intel Xeon, а точную модель определяет OEM.
Текущая reference architecture требует не менее 48 физических CPU-ядер на сокет и рекомендует 56. Для системной памяти указан минимум 2 TB и не менее 500 GB/s совокупной полосы. DIMM следует симметрично распределять по сокетам и каналам, иначе preprocessing, dataloader и host-to-device pipeline могут потерять производительность.
PCIe topology
Reference design указывает восемь PCIe Gen5 x16 host links и один Gen4 x2 link на HGX B300 baseboard. При этом индивидуальный Blackwell Ultra GPU поддерживает PCIe Gen6. Эти два утверждения не противоречат друг другу: capability чипа нельзя автоматически считать интерфейсом, который реализован в каждом OEM-сервере.
Для приемки важна фактическая topology:
к какому CPU root complex подключен каждый GPU и NIC;
есть ли симметрия между двумя сокетами;
какой NUMA node обслуживает сетевой адаптер;
поддерживаются ли GPUDirect RDMA и GPUDirect Storage;
нет ли лишнего PCIe switch или oversubscription на критическом пути.
Характеристики NVIDIA HGX B300
Ниже приведены характеристики уровня HGX. Значения с пометкой до являются пиковыми спецификациями, а не результатом прикладного benchmark.
Характеристика | NVIDIA HGX B300 | Практическое значение |
|---|---|---|
GPU | 8 x NVIDIA B300 Blackwell Ultra SXM | один плотный восьми-GPU узел |
GPU compute capability | 10.3 | нужны совместимые driver, CUDA и kernels |
HBM3e по общему datasheet | 270 GB на GPU, 2,1 TB суммарно | базовая спецификация HGX B300 |
HBM3e по Enterprise RA и DGX B300 | 288 GB на GPU, 2,30 TB суммарно | относится к конкретной актуальной конфигурации |
Полоса HBM3e | 7,7 или до 8 TB/s на GPU | зависит от опубликованной спецификации SKU |
Совокупная полоса HBM3e | 62 или до 64 TB/s | арифметика всей восьми-GPU платформы |
NVLink | пятое поколение | scale-up связь внутри узла |
NVLink на GPU | до 1,8 TB/s | двунаправленная GPU-to-GPU полоса |
NVLink всей платформы | 14,4 TB/s | сумма по восьми GPU |
FP4 Tensor Core | 144 PFLOPS sparse, 108 PFLOPS dense | пик при поддерживаемом FP4 execution path |
FP8 и FP6 Tensor Core | 72 PFLOPS sparse | training и inference низкой точности |
FP16 и BF16 Tensor Core | 36 PFLOPS sparse | распространенный режим обучения и fine-tuning |
TF32 Tensor Core | 18 PFLOPS sparse | ускоренный путь для части FP32 workloads |
FP32 | 600 TFLOPS | совокупный теоретический пик |
FP64 и FP64 Tensor Core | 10 TFLOPS | ограничение для части HPC workloads |
MIG | до 7 instances на GPU | изоляция и совместное использование ресурсов |
TDP одного GPU | настраиваемый, до 1 100 W | не равно мощности всего сервера |
Сеть в максимальном reference design | 8 x ConnectX-8, до 800 Gb/s на GPU | dual-plane compute fabric |
DPU | 1 x BlueField-3 в Enterprise RA | storage, customer и management traffic |
Почему встречаются 270 GB и 288 GB
Общая страница HGX и Blackwell Ultra datasheet описывают вариант HGX B300 с 270 GB HBM3e на GPU, 2,1 TB на восемь GPU и полосой 7,7 TB/s на ускоритель. NVIDIA Enterprise Reference Architecture и руководство DGX B300 приводят 288 GB, 2 304 GB на узел и до 8 TB/s.
Официальная документация не дает универсального правила, позволяющего автоматически пересчитать одно значение в другое. Возможны разные SKU и ревизии платформы, но додумывать точную причину для конкретного сервера нельзя.
В техническом задании нужно зафиксировать:
Полный part number GPU и HGX baseboard.
Заявленный физический объем HBM3e.
Объем, доступный CUDA runtime и
nvidia-smi.MIG profiles, если платформа будет разделяться.
Версии firmware, driver и platform software.
Минимально допустимый memory budget для целевой модели.
NVIDIA HGX B300, OEM-сервер и DGX B300: в чем разница
Три названия описывают разные уровни продукта.
Уровень | Что входит | Кто определяет конфигурацию |
|---|---|---|
B300 GPU | один ускоритель Blackwell Ultra SXM | NVIDIA и конкретный GPU SKU |
HGX B300 | восемь B300, NVLink, NVSwitch и baseboard | NVIDIA |
OEM-сервер HGX B300 | HGX, CPU, RAM, NVMe, NIC, BMC, питание, cooling и корпус | Dell, ASUS, GIGABYTE, ASRock Rack, Supermicro и другие |
DGX B300 | законченная референсная система NVIDIA с аппаратным и программным стеком | NVIDIA |
DGX B300 является одним из готовых способов реализовать восьми-GPU B300 node. В актуальном руководстве он имеет восемь B300 по 288 GB, два Intel Xeon Platinum 6776P, 2 TB RAM с расширением до 4 TB, восемь E1.S NVMe для cache, два M.2 для загрузки, восемь ConnectX-8 и два BlueField-3 DPU.
OEM-система дает больше свободы. Можно выбрать Intel или AMD, объем RAM, storage, форм-фактор, воздушное или жидкостное охлаждение и сервисную модель. Цена свободы состоит в необходимости самостоятельно проверить всю совместимость и зафиксировать состав поставки.
Готовая карточка NVIDIA DGX B300 с восемью B300 SXM полезна как референс комплектации. Для сравнения OEM-платформ используйте категорию GPU-серверов NVIDIA HGX.
Сеть HGX B300: NVLink внутри, ConnectX-8 между узлами
В архитектуре есть два разных пути обмена.
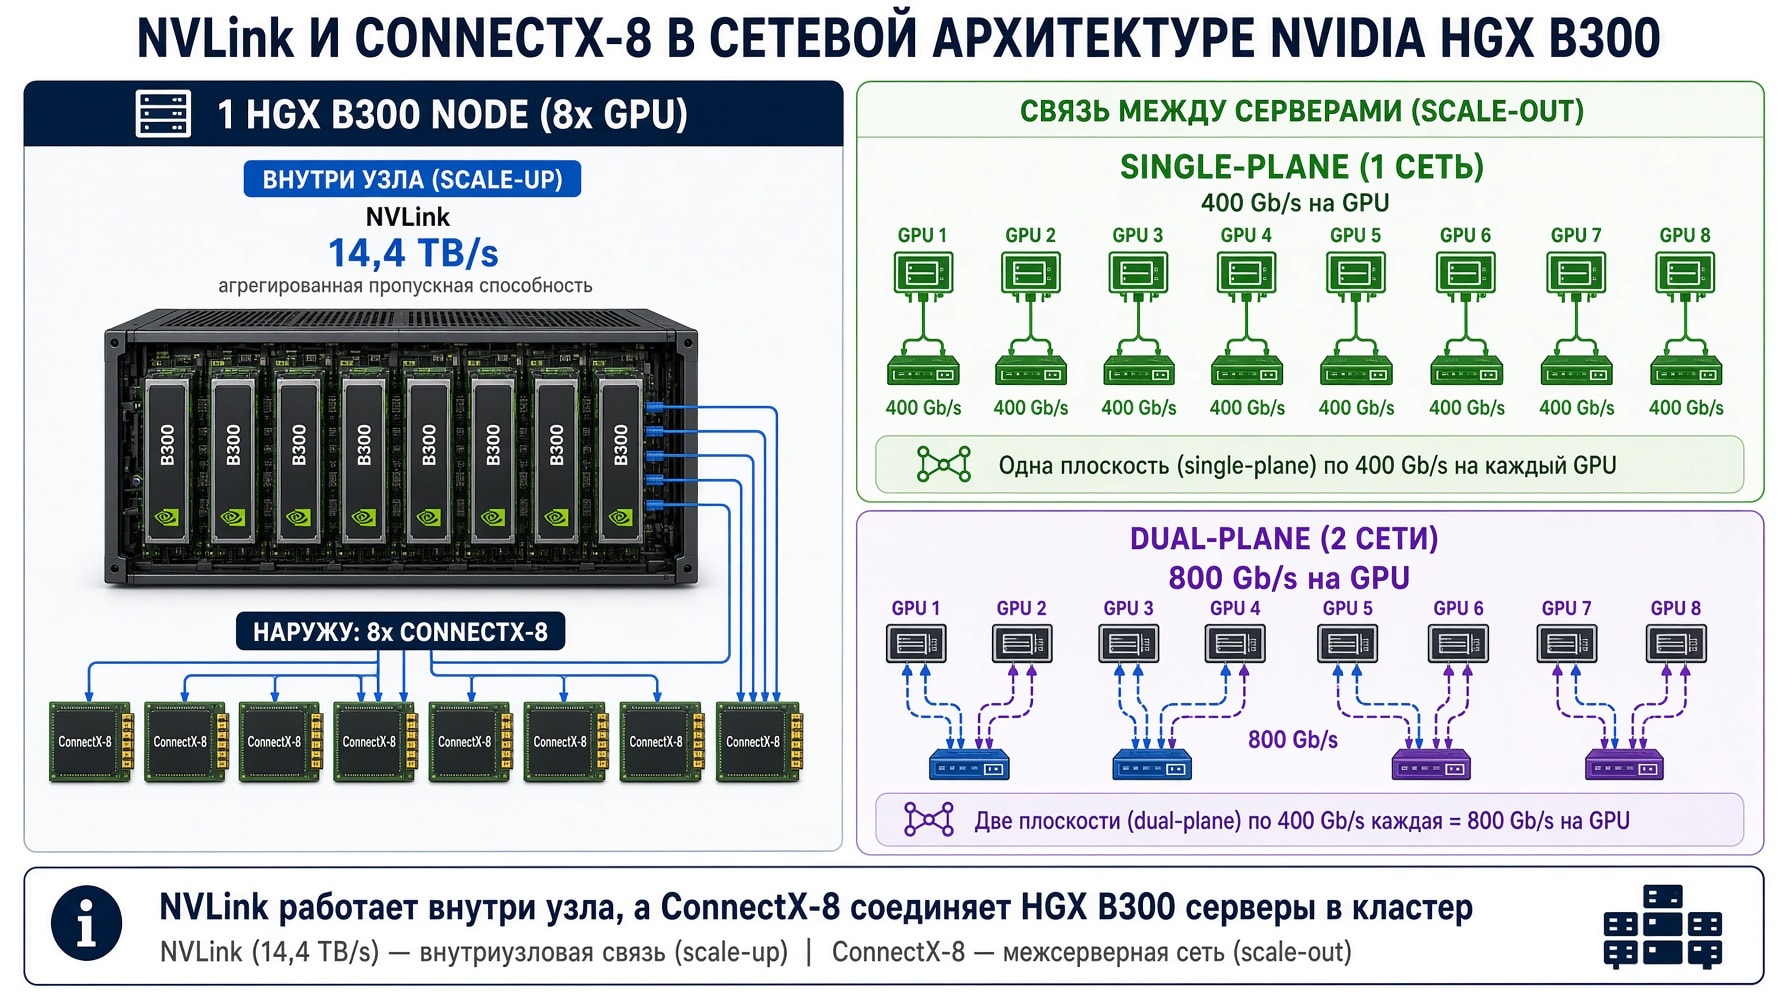
NVLink и NVSwitch связывают восемь GPU внутри одного сервера. Этот контур используется для tensor parallelism, коллективных операций и обмена данными между ускорителями одного узла.
ConnectX-8 связывает HGX-серверы между собой. В максимальной reference configuration у каждого GPU есть свой SuperNIC с двумя портами по 400 Gb/s, суммарно до 800 Gb/s. Восемь адаптеров дают до 6,4 Tb/s внешней compute bandwidth на узел при dual-plane topology.
Для менее требовательного single-plane варианта можно использовать один порт 400 Gb/s на GPU. Тогда совокупная сеть узла составляет 3,2 Tb/s. Это снижает стоимость коммутаторов, оптики и кабелей, но уменьшает полосу и резервирование.
Обозначение 2-8-9-800 в NVIDIA Enterprise Reference Architecture читается так:
2 CPU;
8 GPU;
9 сетевых adapters, включая восемь ConnectX-8 и один BlueField-3;
до 800 Gb/s east-west connectivity на GPU в dual-plane схеме.
Сеть не выбирают только по номиналу порта. Нужны rail-optimized topology, non-blocking leaf-spine, RDMA, корректный RoCE congestion control или InfiniBand fabric, одинаковые MTU, telemetry и проверка NCCL на целевом количестве узлов.
CPU, RAM и NVMe для сервера HGX B300
Как выбрать CPU
GPU выполняют основную матричную работу, но CPU влияет на загрузку данных, токенизацию, preprocessing, network stack, storage stack и orchestration. Два слабых или несбалансированных процессора способны оставить B300 без данных.
Оценивайте не только число ядер:
memory bandwidth и количество каналов RAM;
PCIe lanes и распределение root complexes;
NUMA topology;
производительность одного ядра для serial stages;
поддержку выбранного NIC и DPU;
TDP процессоров и общий thermal budget.
Сколько нужно оперативной памяти
NVIDIA Enterprise RA задает минимум 2 TB RAM. Это стартовая reference value, а не универсальная формула. Для training с большими dataloaders, CPU offload или крупным page cache может потребоваться больше. Для чистого inference с моделями в HBM и подготовленными данными избыток RAM не даст прироста.
Память должна быть равномерно установлена по двум сокетам и всем каналам. Конфигурация с большим объемом, но неполной population, иногда проигрывает меньшему симметричному варианту по полосе.
Локальные накопители
Reference architecture рекомендует:
минимум 1 TB NVMe на CPU socket для inference;
минимум 2 TB NVMe на CPU socket для training и deep learning;
минимум 1 TB NVMe на CPU socket для HPC;
отдельный NVMe объемом 1 TB для загрузки.
Это минимумы reference design. Реальному узлу могут потребоваться десятки терабайт cache для datasets, models и checkpoints. Локальные NVMe не заменяют общую СХД, если cluster должен параллельно читать один dataset и сохранять checkpoints.
Для каких задач подходит HGX B300
Обучение и fine-tuning крупных моделей
Восемь B300 и NVSwitch позволяют разместить одну модель на всем узле и выполнять быстрые коллективные операции. Для multi-node training внешняя сеть становится продолжением вычислительной topology. Если fabric медленная или перегружена, дополнительные узлы увеличат стоимость сильнее, чем производительность.
Reasoning inference и длинный контекст
Blackwell Ultra увеличивает dense FP4 compute и ускоряет attention относительно B200. Большая HBM3e дает больше места для weights, KV-cache и batch. Это полезно для reasoning, где модель генерирует длинные ответы и тратит больше compute на запрос.
Преимущество проявится только при поддержке FP4 или другого выбранного режима со стороны модели, TensorRT-LLM, NVIDIA Dynamo, vLLM, SGLang или собственного engine. Нельзя подставлять пиковые 144 PFLOPS вместо измеренного tokens/s.
Mixture-of-Experts
MoE требует разумного размещения experts и быстрых All-to-All exchanges. Внутри восьми-GPU NVLink domain обмен быстрее, чем через внешнюю сеть. На нескольких узлах результат зависит от expert parallelism, routing skew и fabric.
Data analytics и мультимодальные pipelines
HGX B300 подходит для GPU-ускоренной аналитики, генерации видео, computer vision и обработки больших массивов данных. Но end-to-end скорость может ограничить decoder, CPU preprocessing, storage или network ingestion. Benchmark должен включать весь pipeline.
HPC с ограничениями
HGX B300 ориентирован прежде всего на AI. Текущая страница NVIDIA указывает 10 TFLOPS FP64 или FP64 Tensor Core для всей платформы, тогда как у HGX B200 опубликовано 296 TFLOPS. Для workloads, чувствительных к native FP64, B300 нельзя считать автоматическим обновлением B200.
Сколько моделей помещается в 8 GPU
Грубая оценка только для weights выглядит так:
память weights = число параметров x байт на параметр
Ориентиры без учета служебных данных:
Формат weights | Примерный объем на 100 млрд параметров |
|---|---|
BF16 или FP16 | около 200 GB |
FP8 или INT8 | около 100 GB |
4-bit | около 50 GB |
В реальной системе добавляются metadata, scales, activations, CUDA graphs, communication buffers, temporary workspace и KV-cache. Для обучения также нужны gradients, optimizer states и master weights. Поэтому делить 2,1 или 2,3 TB на размер checkpoint недостаточно.
HBM восьми GPU физически разделена. Модель больше памяти одного B300 требует parallelism или offload. Даже когда weights помещаются, неправильный sharding может создать горячие links, несбалансированную память или лишние collectives.
Для production inference иногда выгоднее запустить несколько независимых replicas, чем растянуть одну модель на все восемь GPU. Выбор зависит от размера модели, context length, concurrency и latency target.
HGX B300 и HGX B200: что меняется
Параметр | HGX B300 | HGX B200 |
|---|---|---|
GPU | 8 x Blackwell Ultra | 8 x Blackwell |
Общая HBM | 2,1 TB в продуктовой таблице | 1,4 TB |
FP4 sparse | 144 PFLOPS | 144 PFLOPS |
FP4 dense | 108 PFLOPS | 72 PFLOPS |
FP8 и FP6 sparse | 72 PFLOPS | 72 PFLOPS |
NVLink | 5 поколение | 5 поколение |
Общая NVLink bandwidth | 14,4 TB/s | 14,4 TB/s |
Attention performance | 2x относительно B200 | baseline |
FP64 и FP64 Tensor Core | 10 TFLOPS | 296 TFLOPS |
B300 дает больше памяти, более высокий dense FP4 и ускорение attention. Он не быстрее B200 по каждому типу вычислений. Для классического HPC с FP64 B200 может быть заметно сильнее, а для reasoning inference и больших memory footprint B300 выглядит предпочтительнее.
Как выбрать OEM-сервер NVIDIA HGX B300
Каталог серверов с GPU NVIDIA B300 включает системы разных производителей. Сравнивать их нужно не по логотипу, а по полной ведомости параметров.
Процессорная платформа
Intel Xeon и AMD EPYC могут обеспечивать подходящую topology, но различаются по числу ядер, memory channels, PCIe lanes и профилю software compatibility. Для CPU-heavy preprocessing полезно провести отдельный host benchmark.
Пример Intel-конфигурации: ASRock Rack 8U16X-GNR2 B300. Вариант на AMD можно рассмотреть на примере ASRock Rack 8U16X-TURIN2 B300.
Форм-фактор и охлаждение
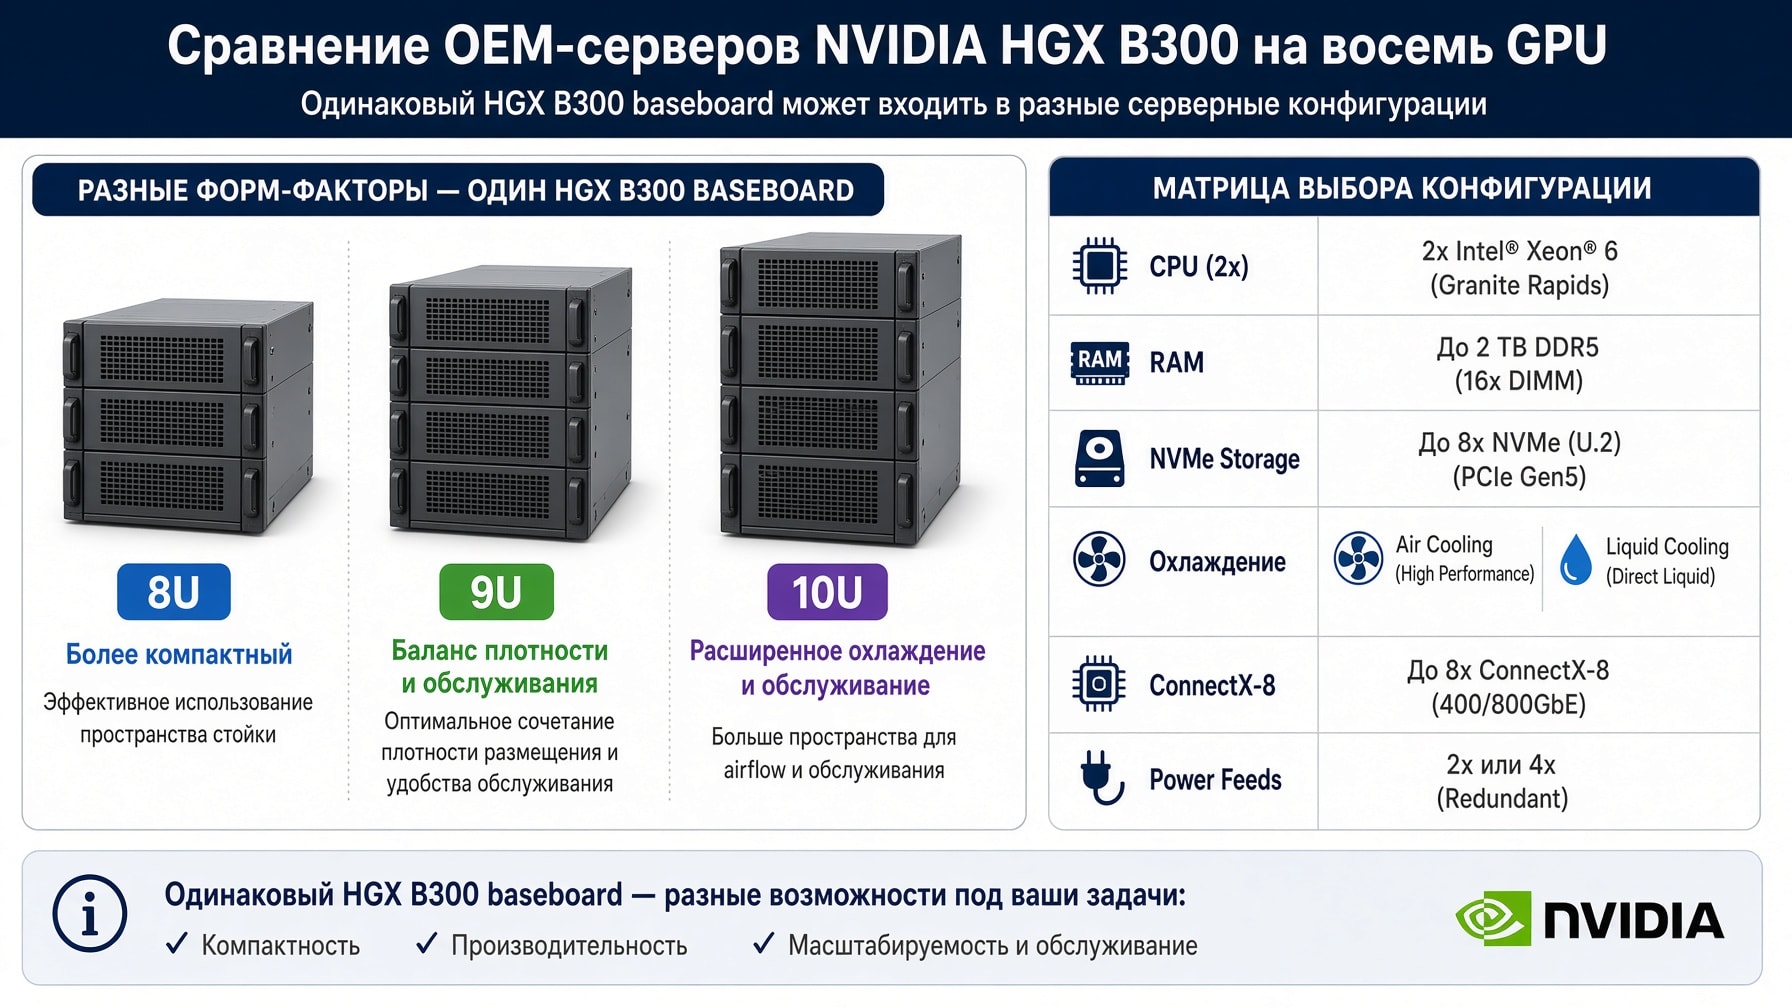
На рынке встречаются 8U, 9U и 10U системы. Меньшая высота не всегда лучше: важны допустимая inlet temperature, fan power, acoustic profile, сервисный доступ, масса и количество серверов на стойку.
Жидкостное охлаждение повышает плотность, но требует CDU, распределительного контура, контроля утечек и подготовленной эксплуатации. Воздушная система проще для части ЦОД, однако создает высокий airflow и тепловую нагрузку.
Питание
Восемь GPU с TDP до 1 100 W дают до 8,8 kW. Для сравнения законченная DGX B300 имеет опубликованное потребление до 14,5 kW. Эту цифру нельзя переносить на любой OEM-сервер, но она показывает класс инженерной нагрузки.
Проверьте:
допустимую мощность на стойку;
напряжение и тип разъемов;
число независимых вводов;
режим резервирования PSU;
дерейтинг при отказе одного блока;
тепловыделение и airflow;
поведение power cap под длительной нагрузкой.
Сеть и storage
Уточните, входят ли восемь ConnectX-8 в поставку, какие transceivers и cables включены, используется ли single-plane или dual-plane topology. Отдельно зафиксируйте BlueField-3, storage network, management ports и лицензии.
По дисковой подсистеме сравнивайте количество E1.S или U.2 bays, hot-swap, PCIe generation, software RAID для boot, cache policy и возможность замены без остановки GPU tray.
Сертификация и сервис
NVIDIA-Certified Systems проходят валидацию платформы, networking и management. Сертификация не заменяет acceptance tests конкретного экземпляра, но уменьшает риск несовместимой topology или firmware.
Программный стек HGX B300
B300 имеет compute capability 10.3. CUDA Toolkit 13.0 официально поддерживает B300 и GB300. Для production важна совместимость всей цепочки:
BMC и firmware OEM-сервера.
GPU firmware и NVSwitch firmware.
NVIDIA driver и CUDA runtime.
Fabric Manager для NVSwitch domain.
NCCL и communication plugins.
Framework и inference engine.
Custom CUDA extensions и compiled kernels.
GPU Operator, Network Operator, DCGM и monitoring.
Драйвер может увидеть все восемь GPU, но приложение не обязано получить оптимальную производительность. Расширение без кода для sm_103, неподходящий NCCL topology file или несовместимый container способны привести к fallback, ошибке запуска или низкой полосе.
Проверка базовых понятий и совместимости есть в статье CUDA: что это и какие GPU поддерживает.
MIG и совместное использование узла
B300 поддерживает до семи MIG instances на GPU. MIG полезен для изоляции небольших workloads и разных команд. Он не объединяет память нескольких GPU и не является заменой scheduler.
Перед включением MIG проверьте доступные profiles конкретного SKU, поддержку со стороны Kubernetes или Slurm, observability и procedure возврата GPU в полный режим. Для большой модели, использующей весь NVL8 domain, MIG обычно не применяется.
Как тестировать и принимать HGX B300
Приемка должна подтвердить не наличие восьми устройств в nvidia-smi, а работоспособность всей системы.
Аппаратная проверка
part numbers GPU и baseboard;
объем HBM3e каждого GPU;
health NVLink и NVSwitch;
PCIe width, speed и NUMA affinity;
ConnectX-8 и BlueField-3 firmware;
RAM population и memory bandwidth;
NVMe health и sustained throughput;
PSU redundancy, temperatures и fan behavior.
Тесты fabric
Запустите NVLink bandwidth tests, NCCL AllReduce, AllGather, ReduceScatter и All-to-All. Для multi-node системы измерьте single-plane или dual-plane network в заявленной topology. Ошибки исправления, retraining links и нестабильная полоса должны попадать в протокол.
Прикладной benchmark
Зафиксируйте модель, revision, precision, quantization, input length, output length, batch size, concurrency, parallelism, engine и software versions. Для inference измеряйте tokens/s, time to first token, inter-token latency и p95 или p99. Для training важны samples или tokens per second, scaling efficiency и время checkpoint.
Длительная нагрузка
Короткий тест не выявляет thermal throttling, power cap и плавающие ошибки. Нужен устойчивый прогон с записью clocks, temperatures, power, ECC, NVLink errors, network counters и storage latency.
Когда HGX B300 не нужен
Восьми-GPU платформа оправдана не для каждой AI-задачи. Рассмотрите меньший сервер, если:
модель и KV-cache помещаются в один или два GPU;
workload не масштабируется на восемь ускорителей;
сервис имеет низкую concurrency;
задача ограничена storage или CPU preprocessing;
software не использует Blackwell Ultra kernels;
основная нагрузка требует высокой native FP64 performance;
площадка не поддерживает мощность и охлаждение такого класса;
облачная аренда на период проекта дешевле постоянного on-prem узла.
Для небольшой корпоративной LLM, RAG или computer vision иногда эффективнее несколько независимых PCIe GPU. HGX B300 выбирают, когда измерения показывают пользу большой HBM, тесного восьми-GPU domain или высокой плотности training и inference.
NVIDIA HGX B300: цена и состав предложения
Запрос NVIDIA HGX B300 купить относится к готовому серверу, а не к абстрактной таблице baseboard. Итоговая стоимость зависит от OEM, CPU, RAM, NVMe, NIC, DPU, cooling, service и сетевой инфраструктуры.
В коммерческом предложении должны быть указаны:
производитель и точная модель сервера;
part number HGX B300 и восьми GPU;
HBM3e на GPU и на узел;
CPU и RAM population;
локальные накопители;
ConnectX-8, BlueField-3, transceivers и cables;
blocks питания, power cords и резервирование;
air или liquid cooling;
firmware и software image;
acceptance tests;
гарантия, SLA, поставка и монтаж.
Цена без сетевых коммутаторов, оптики и подготовки площадки не описывает TCO кластера. Для multi-node проекта отдельно рассчитываются compute fabric, storage, management network, racks, PDU и cooling.
Частые вопросы о NVIDIA HGX B300
Что такое NVIDIA HGX B300?
Это базовая восьми-GPU платформа NVIDIA с ускорителями B300 Blackwell Ultra в форм-факторе SXM. GPU объединены NVLink пятого поколения и NVSwitch. OEM-производитель добавляет CPU, RAM, storage, сеть, питание, охлаждение и корпус.
Сколько GPU в HGX B300?
В платформе восемь NVIDIA B300 SXM. Поэтому в поиске используются формулировки HGX B300 8 GPU и HGX B300 NVL8.
Что означает HGX B300 NVL8?
NVL8 указывает на восемь B300 в одном NVLink scale-up domain. Для закупки нужно дополнительно проверить память, NVSwitch, сетевую конфигурацию и точный server SKU.
Сколько памяти у NVIDIA HGX B300?
Общий datasheet указывает 270 GB HBM3e на GPU и 2,1 TB на платформу. Enterprise Reference Architecture и DGX B300 приводят 288 GB на GPU и 2,30 TB на узел. Точное значение определяется заказанным SKU.
Является ли HGX B300 готовым сервером?
Нет. HGX B300 является baseboard и GPU-платформой. Законченный сервер выпускает NVIDIA как DGX B300 или OEM-производитель, например Dell, ASUS, GIGABYTE, ASRock Rack либо Supermicro.
Чем HGX B300 отличается от DGX B300?
HGX задает GPU baseboard и interconnect. DGX B300 является готовой системой NVIDIA с фиксированными CPU, RAM, NVMe, network, chassis и software stack.
Какая пропускная способность NVLink у HGX B300?
До 1,8 TB/s двунаправленной полосы на GPU и 14,4 TB/s совокупно для восьми-GPU платформы. Это внутренний interconnect, а не скорость внешней сети.
Какие CPU используются с HGX B300?
Готовые серверы используют два x86-процессора Intel Xeon или AMD EPYC. Точная модель зависит от OEM. Reference architecture рекомендует минимум 48 физических ядер на сокет и не менее 2 TB системной RAM.
Какую сеть использовать между HGX B300 серверами?
Для максимальной reference configuration применяются восемь ConnectX-8 с dual-plane полосой до 800 Gb/s на GPU. Возможна более экономичная single-plane схема по 400 Gb/s на GPU. Выбор зависит от training, inference и масштабирования.
Подходит ли HGX B300 для HPC?
Подходит для GPU-ускоренных workloads, но не является универсально лучшим вариантом для FP64. По опубликованной спецификации FP64 у HGX B300 значительно ниже HGX B200, поэтому нужен benchmark конкретного научного кода.
Сколько потребляет сервер HGX B300?
Один GPU имеет настраиваемый TDP до 1 100 W, поэтому восемь GPU дают до 8,8 kW без учета остальных компонентов. Готовая DGX B300 потребляет до 14,5 kW. Точная мощность OEM-сервера берется из его datasheet.
Как подобрать сервер HGX B300
Начните с модели и workload: training, fine-tuning или inference. Рассчитайте HBM для weights, activations и KV-cache, зафиксируйте precision, context length, concurrency и SLA. Затем выберите CPU, RAM, storage, single-plane или dual-plane network, тип cooling и допустимую мощность стойки.
Start Server может подобрать OEM-систему, проверить topology, рассчитать сеть и СХД, подготовить приемочные тесты и организовать ввод в эксплуатацию. Для расчета используйте раздел серверов с NVIDIA B300 и приложите описание workload, software stack и параметры площадки.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


