NVIDIA NVLink представляет высокоскоростное межсоединение для прямого обмена данными между совместимыми GPU, а в некоторых архитектурах также между CPU и GPU. NVSwitch является коммутатором, который объединяет несколько NVLink и создает all-to-all fabric между большим числом ускорителей.
NVLink не объединяет память видеокарт автоматически и не ускоряет программу без multi-GPU support. Его польза зависит от объема обмена, topology, NCCL или другого communication runtime и выбранного parallelism. Для независимого инференса на каждой GPU скоростной link может почти не влиять на результат.
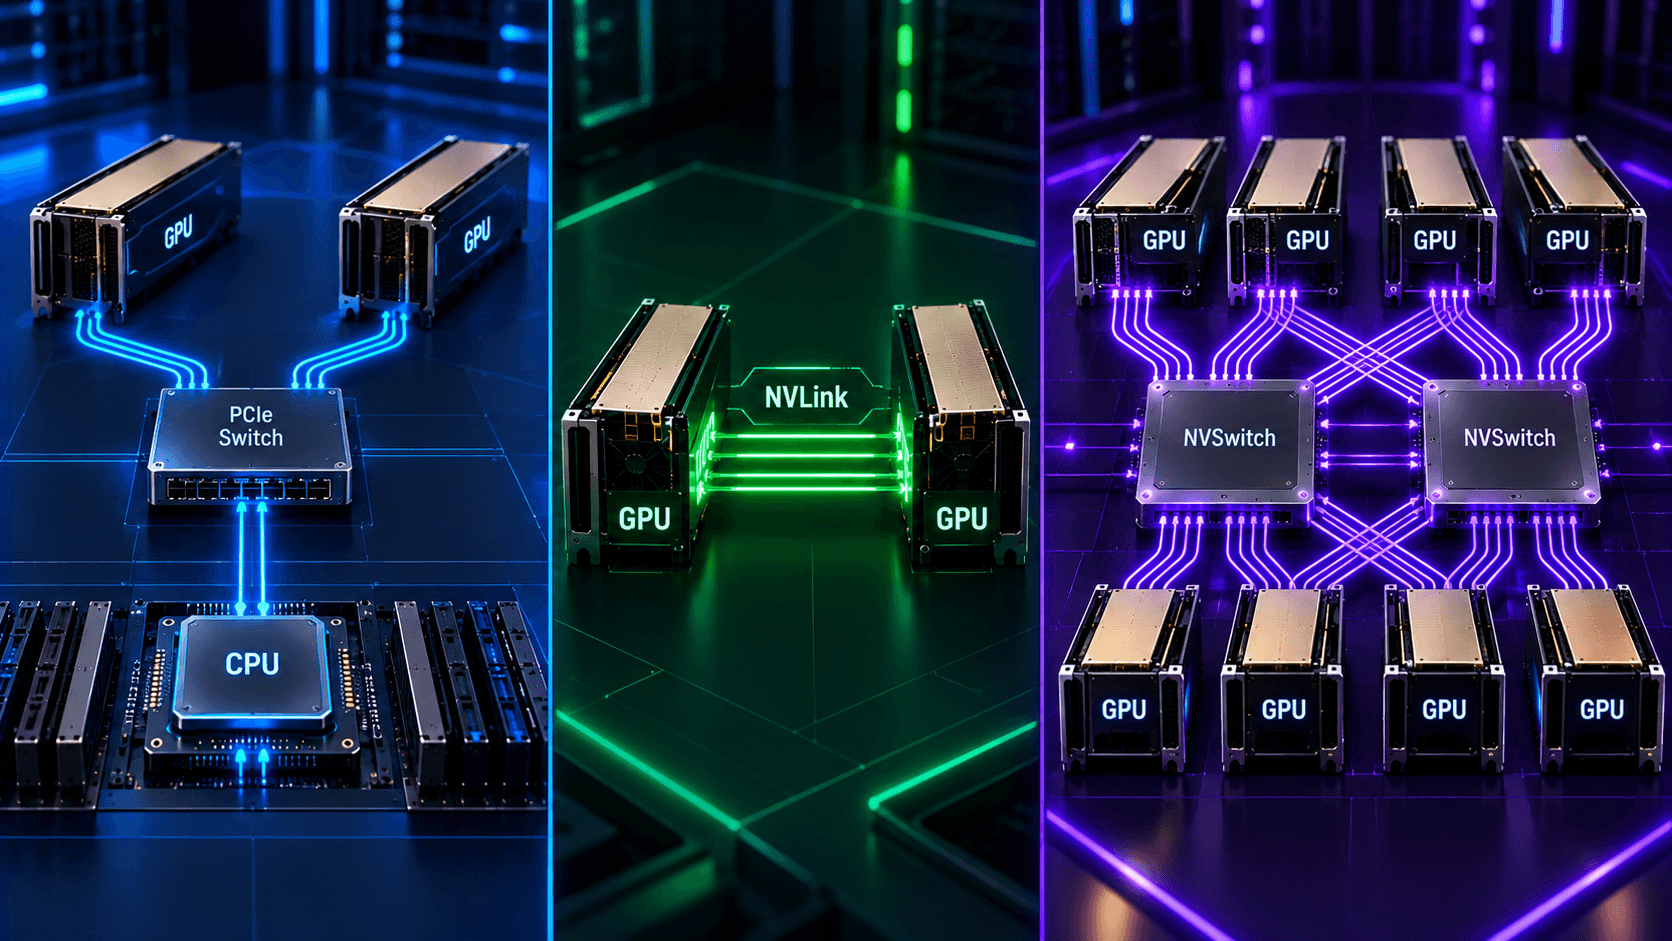
Что такое NVLink
NVLink состоит из физических links, controller logic и software support. Один GPU может иметь несколько link endpoints. Они соединяются непосредственно с другим GPU, CPU или портом NVSwitch в зависимости от платформы.
CUDA может использовать peer-to-peer memory access и transfers, если driver подтверждает доступ между конкретной парой устройств. Более высокоуровневые библиотеки, например NCCL, выбирают подходящий transport для collective operations.
Что такое NVSwitch
NVSwitch представляет специализированный switch chip для NVLink fabric. Он соединяет GPU так, чтобы несколько устройств могли обмениваться данными одновременно без ограничений простой цепочки или пары direct links.
В 8-GPU DGX и HGX системы NVSwitch обеспечивает all-to-all connectivity внутри узла. В rack-scale платформах NVLink Switch trays расширяют domain за границы одного compute tray и объединяют десятки GPU.
NVLink и NVSwitch: в чем разница
Технология | Роль | Масштаб | Пример |
|---|---|---|---|
PCIe | универсальная host и device bus | карта, сервер | GPU подключена к CPU и PCIe switch |
NVLink | point-to-point high-speed link | пара endpoints | GPU с GPU или GPU с switch |
NVSwitch | коммутатор NVLink | multi-GPU node или rack | all-to-all fabric восьми или 72 GPU |
InfiniBand или Ethernet | cluster network | между узлами и стойками | distributed training и storage traffic |
Полное сравнение PCIe версий и линий приведено в статье PCI Express: как работает, версии и скорость.
Как данные проходят между GPU
Через host memory
Приложение копирует данные с одной GPU в RAM, затем на другую GPU. Такой путь добавляет CPU и memory subsystem в маршрут и обычно дает лишнюю latency.
PCIe peer-to-peer
Совместимые GPU могут обмениваться напрямую через PCIe P2P без промежуточной копии в host memory. Результат зависит от root complex, PCIe switches, ACS, IOMMU, driver и ОС.
Direct NVLink
Две GPU соединены одним или несколькими NVLink. Driver и runtime используют link для P2P transfer и load or store, если platform support это допускает.
NVSwitch fabric
GPU подключены к switches, которые маршрутизируют traffic между endpoints. Это дает более равномерную full-topology для коллективных операций, чем неоднородный набор прямых связей.
Для каких задач NVLink дает пользу
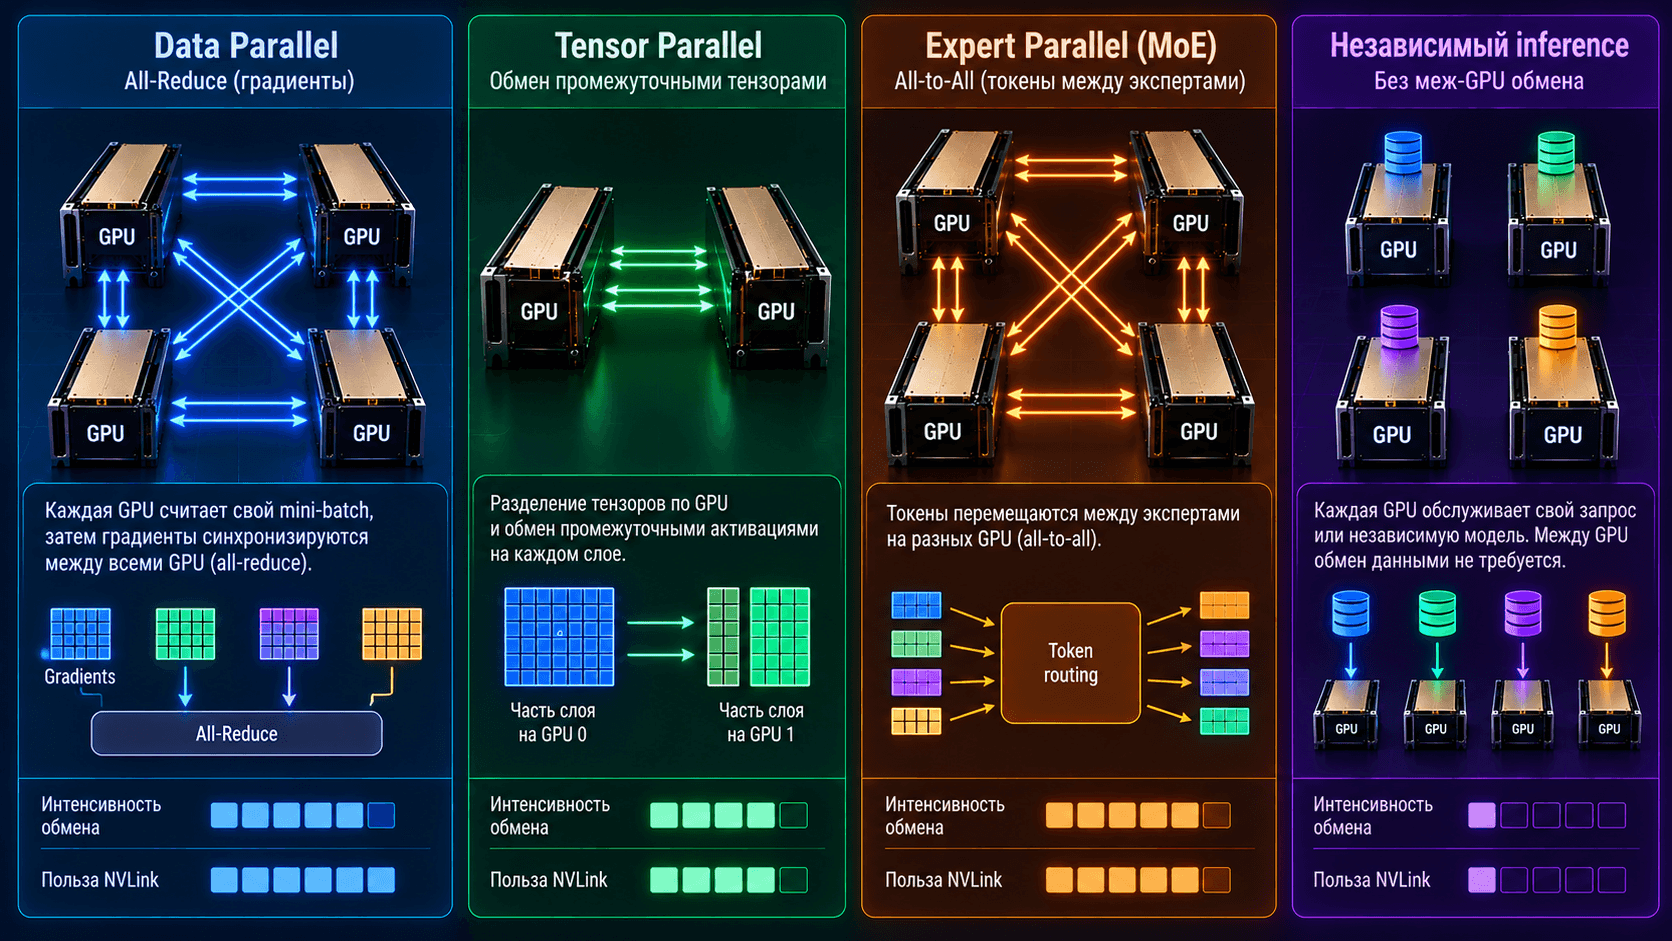
Model parallelism
Если слои или tensors одной модели разделены между GPU, на каждом шаге передаются activations и результаты collective operations. Bandwidth и latency interconnect способны напрямую влиять на скорость.
Data parallel training
Каждая GPU обрабатывает свой mini-batch, затем gradients синхронизируются. При больших моделях all-reduce создает значительный traffic.
Expert parallelism
Mixture-of-Experts перемещает tokens между experts на разных GPU. All-to-all traffic требует сбалансированной fabric.
Multi-GPU inference
Крупная LLM может быть разделена через tensor или pipeline parallelism. При жестком latency-budget коммуникация определяет, сколько времени accelerator ждет данные.
HPC
Domain decomposition и distributed solvers обмениваются boundaries, vectors и reductions. Эффект зависит от communication-to-compute ratio приложения.
NVLink почти не нужен, если каждая GPU выполняет независимое задание, а данные и модель помещаются локально. В таком сценарии важнее PCIe для загрузки, CPU, storage и scheduler.
Поколения и скорость NVLink
Bandwidth следует читать внимательно. Производители могут указывать значение в одном направлении, bidirectional на GPU, суммарное по нескольким links или aggregate для всей системы.
Поколение | Архитектура или платформа | Bidirectional bandwidth на GPU по текущей таблице NVIDIA |
|---|---|---|
NVLink 4 | Hopper, H100 и H200 | 900 ГБ/с |
NVLink 5 | Blackwell, B200, B300, GB200 и GB300 | 1 800 ГБ/с |
NVLink 6 | Vera Rubin | 3 000 ГБ/с, предварительная спецификация |
Для legacy-поколений NVIDIA указывает до 600 ГБ/с на A100 с NVLink 3 и до 300 ГБ/с для V100-класса с NVLink 2 в соответствующих системах. Точная скорость зависит от SKU, числа links и topology.
V100, SXM2 и NVLink 2.0
Tesla V100 использовалась в PCIe и SXM2 вариантах. SXM2-модули устанавливались на специализированные baseboards, где NVLink links разводились через backplane и, в DGX-2-class системах, NVSwitch.
Запрос SXM2 NVLink не означает отдельный removable bridge. SXM-module и baseboard проектируются как единая platform topology. Покупка одного V100 SXM2 без совместимой платы, питания и охлаждения не создает рабочий GPU-сервер.
A100 NVLink
A100 поколения Ampere использует NVLink 3. В SXM4 8-GPU системах NVSwitch строит all-to-all fabric. Существовали также PCIe и специальные bridge-capable варианты, но совместимость определяется точным SKU и платформой.
Для сервера на A100 нужно проверить не только GPU name, но form factor, NVLink endpoints, baseboard, NVSwitch generation и поддерживаемый firmware.
H100 и H200 NVLink
H100 и H200 SXM используют NVLink 4 до 900 ГБ/с bidirectional на GPU в HGX или DGX. Восьмипроцессорные системы применяют NVSwitch.
H200 NVL является PCIe-картой и в квалифицированных конфигурациях поддерживает 2-way или 4-way NVLink bridge с заявленной bandwidth до 900 ГБ/с на GPU. Мост, slot spacing и system support должны совпадать.
Blackwell и NVLink 5
B200 и B300 увеличивают NVLink bandwidth до 1,8 ТБ/с на GPU. В 8-GPU HGX или DGX NVSwitch создает связанный domain внутри сервера. В GB200 NVL72 и GB300 NVL72 switch trays объединяют 72 Blackwell GPU в rack-scale fabric.
NVL72 предъявляет требования к liquid cooling, power и сетям ЦОД. Это готовая архитектура стойки, а не набор NVLink bridges между обычными видеокартами. Устройство раскрыто в статье NVIDIA GB300 NVL72: архитектура и требования к ЦОД.
Что такое NVLink Bridge
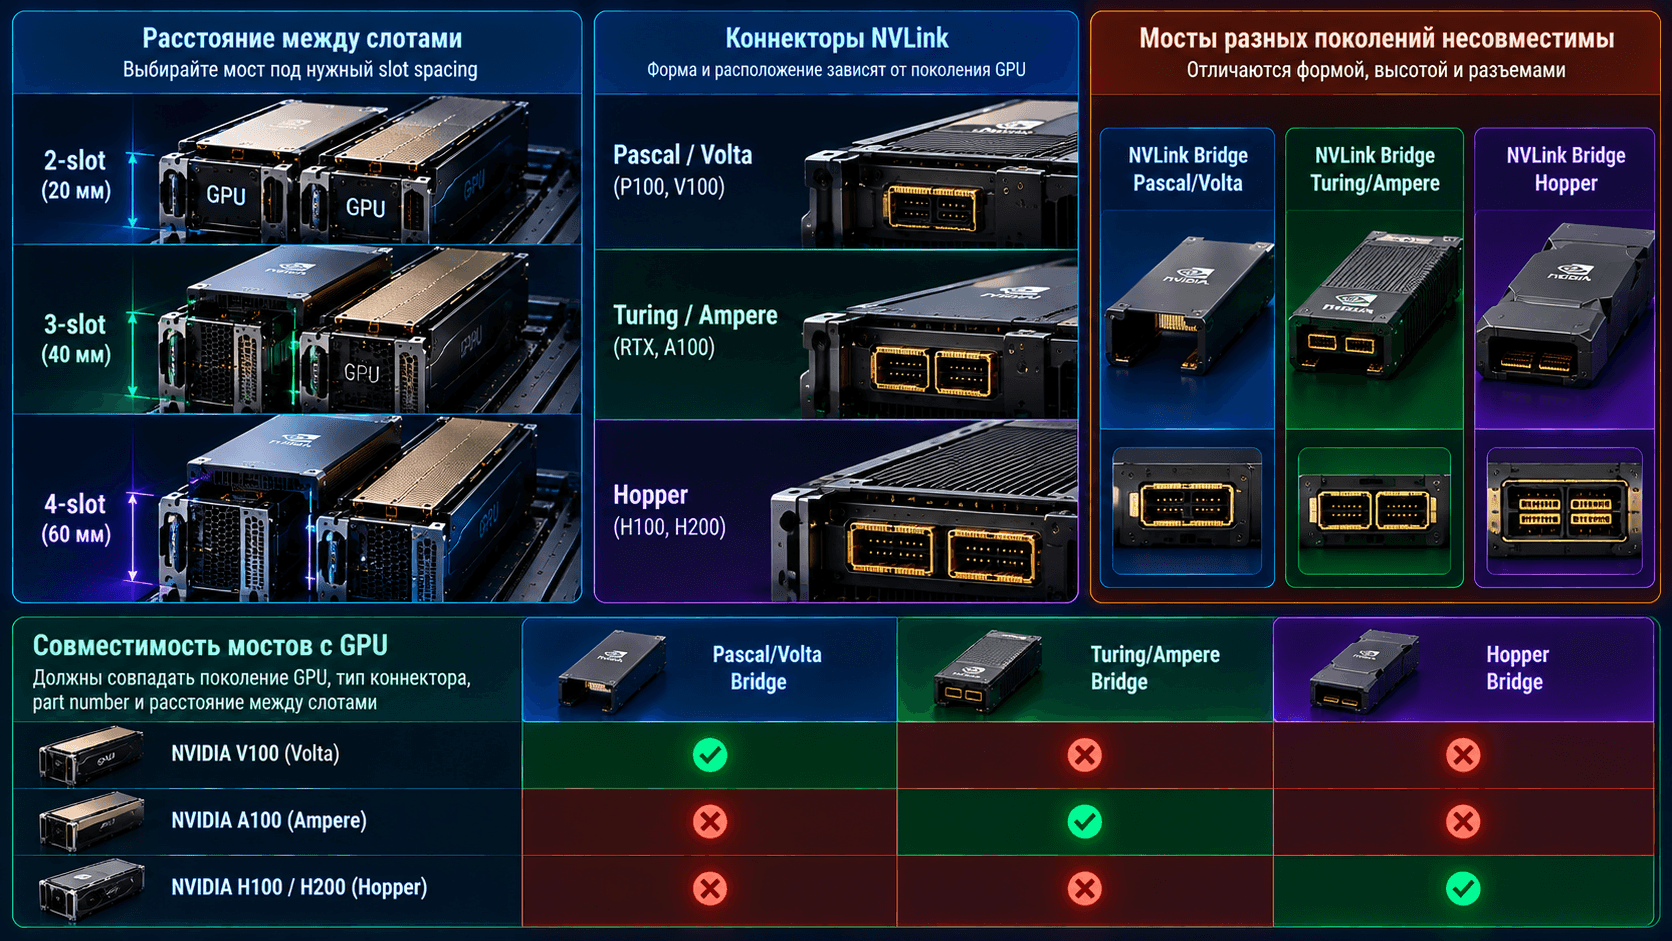
NVLink bridge представляет физический мост для совместимых PCIe workstation, professional или отдельных data center GPU. Он соединяет коннекторы двух или нескольких карт с определенным расстоянием между slots.
Bridge выбирают по четырем параметрам:
Точная модель и поколение обеих GPU.
Число NVLink connectors на карте.
Расстояние между slots, например 2, 3 или 4 slot.
Part number моста и official compatibility list.
Мост не является универсальным. Внешне похожий connector не гарантирует электрическую, mechanical или firmware compatibility.
RTX 3090 и NVLink
GeForce RTX 3090 поддерживает 2-way NVLink через bridge для RTX 30 Series. Приложение должно поддерживать multi-GPU. Для CUDA memory pooling также требуется программное распределение данных, а не один автоматический объем VRAM.
RTX 4090 и NVLink
Официальная спецификация RTX 4090 указывает NVIDIA NVLink (SLI-Ready): No. Установить bridge и добавить поддержку программно нельзя, поскольку отсутствует соответствующий hardware interface.
Professional RTX и Quadro
Официальная таблица bridges включает, среди прочего, RTX A6000, A5500, A5000, A4500, Quadro RTX 8000, 6000, 5000 и Quadro GV100. Совместимость зависит от точной модели и spacing.
Название RTX 6000 неоднозначно: существуют Quadro RTX 6000, RTX A6000, RTX 6000 Ada и RTX PRO 6000 Blackwell. Нельзя переносить поддержку bridge между поколениями по похожему имени.
NVLink и SLI
SLI является graphics rendering technology, а NVLink представляет interconnect. Некоторые GeForce generation использовали NVLink bridge для SLI, из-за чего термины смешиваются. В AI и HPC приложение работает через CUDA, NCCL и framework, а не через игровой SLI profile.
Наличие bridge не означает, что две карты будут выглядеть как одна для любой программы. PyTorch, TensorFlow, render engine или solver должны распределять workload явно.
Как проверить, какие видеокарты поддерживают NVLink
Найдите полный SKU, а не только семейство.
Откройте official product page или datasheet.
Проверьте строку NVLink и form factor.
Для bridge найдите official compatibility table и part number.
Сверьте physical slot spacing в server manual.
Проверьте qualified system list.
После сборки выполните
nvidia-smi topo -m.Проверьте P2P через CUDA sample или framework test.
Запустите NCCL tests для collective bandwidth.
Измерьте целевое приложение.
Как проверить NVLink в GPU-сервере
Topology
nvidia-smi topo -m показывает путь между GPU и CPU or NIC affinity. Обозначения NV# указывают число NVLink connections на пути, а SYS, NODE, PHB и PIX описывают PCIe route.
Link status и counters
DCGM и nvidia-smi позволяют проверять состояние links, ошибки и traffic counters. В NVSwitch system Fabric Manager должен корректно зарегистрировать GPU в fabric.
P2P
CUDA API cudaDeviceCanAccessPeer() проверяет доступ между конкретной парой GPU. Одного успешного ответа недостаточно для оценки bandwidth, поэтому запускают transfer tests.
Collective operations
NCCL tests измеряют all-reduce, all-gather, reduce-scatter и другие collectives. Результат сравнивают с topology и ожидаемой efficiency, а не только с теоретической суммой links.
Application benchmark
Финальный тест запускает модель или solver. Если GPU простаивают на compute, ускорение interconnect не решит проблему. Если профиль показывает communication bottleneck, topology становится кандидатом на оптимизацию.
Как выбрать multi-GPU платформу
PCIe-сервер подходит для независимых задач, гибкого числа карт и workloads с умеренным обменом. Direct NVLink bridge полезен для поддерживаемых 2 или 4 GPU. NVSwitch-system выбирают для плотного all-to-all traffic внутри 8-GPU узла. NVL72 нужен для rack-scale model parallelism.
Проверка проходит в таком порядке:
объем модели и данных на GPU;
parallelism strategy;
communication volume на iteration или token;
число GPU в одном failure domain;
требуемая bandwidth и latency;
scale-up против scale-out;
software и virtualization support;
power, cooling и стоимость результата.
Типичные ошибки
Считать NVLink общей памятью без участия приложения.
Путать NVLink link и NVSwitch chip.
Называть NVLink заменой InfiniBand или Ethernet.
Сравнивать one-way, bidirectional и aggregate bandwidth.
Покупать bridge только по числу slots.
Переносить совместимость между похожими RTX names.
Искать NVLink на RTX 4090 вопреки official specification.
Считать SLI обязательным для CUDA multi-GPU.
Не проверять P2P и topology после сборки.
Ожидать ускорения независимого inference.
Игнорировать NCCL, framework и virtualization limitations.
Выбирать NVSwitch-system без workload benchmark.
FAQ
Что такое NVLink простыми словами?
Это high-speed connection для обмена данными между совместимыми NVIDIA processors. Он дополняет PCIe и используется программным стеком multi-GPU.
Что такое NVSwitch?
Это switch, который соединяет множество NVLink и создает all-to-all fabric между GPU в сервере или rack-scale системе.
Чем NVLink отличается от NVSwitch?
NVLink является физическим каналом между endpoints. NVSwitch маршрутизирует traffic между множеством таких каналов.
Объединяет ли NVLink память двух видеокарт?
Не автоматически. Приложение должно распределять model, tensors или data. Даже при peer access память остается физически расположенной на отдельных GPU.
Какая скорость NVLink?
Она зависит от поколения, SKU, числа links и способа подсчета. H100 и H200 дают до 900 ГБ/с bidirectional на GPU, Blackwell до 1,8 ТБ/с, Vera Rubin заявлен до 3 ТБ/с.
Поддерживает ли RTX 3090 NVLink?
Да, официальная документация описывает 2-way configuration с GeForce RTX NVLink Bridge для 30 Series. Нужен совместимый bridge и software support.
Поддерживает ли RTX 4090 NVLink?
Нет. Официальная спецификация RTX 4090 указывает отсутствие NVLink и SLI readiness.
Какие видеокарты поддерживают NVLink?
Поддержка есть у конкретных data center и professional GPU разных поколений, а также у RTX 3090. Нужна проверка точного SKU, form factor и official bridge table.
Нужен ли NVLink для обучения нейросети?
Не всегда. Он полезен при интенсивном обмене между GPU. Data parallel и model parallel workload следует измерить на целевой topology.
Можно ли купить любой NVLink bridge?
Нет. Мост должен совпадать с поколением GPU, connectors, part number и физическим расстоянием slots.
Что передать для подбора multi-GPU системы
Укажите модель, parallelism strategy, размер tensors, число GPU, precision, batch, communication profile, software stack и требования к scale-out. Start Server поможет сравнить PCIe, direct NVLink, NVSwitch и rack-scale варианты и проверить topology на тесте. Передать вводные можно через контакты Start Server.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


