Один GPU-сервер можно использовать и для обучения, и для production inference. Но свободную capacity нельзя определять по средней загрузке GPU.
Например:
GPU utilization = 45%
не означает:
55% GPU можно безопасно отдать training
Inference может уже находиться около допустимого предела по TTFT, p95/p99 latency или очереди. Training при этом способен создавать кратковременную конкуренцию за compute, memory bandwidth, CPU, RAM, storage и network.
Поэтому решение о совместном использовании строится вокруг двух независимых целей:
INFERENCE
latency / queue / throughput SLA
+
TRAINING
step time / throughput / deadline
↓
COEXISTENCE TEST
↓
ONE SERVER
PASS / CONDITIONAL / FAIL
Один сервер проходит проверку только если одновременно выполняются:
Inference SLA = PASS
Training objective = PASS
Resource isolation = acceptable
Preemption / transition cost = acceptable
Common failure domain = acceptable
Почему GPU utilization не показывает свободную capacity
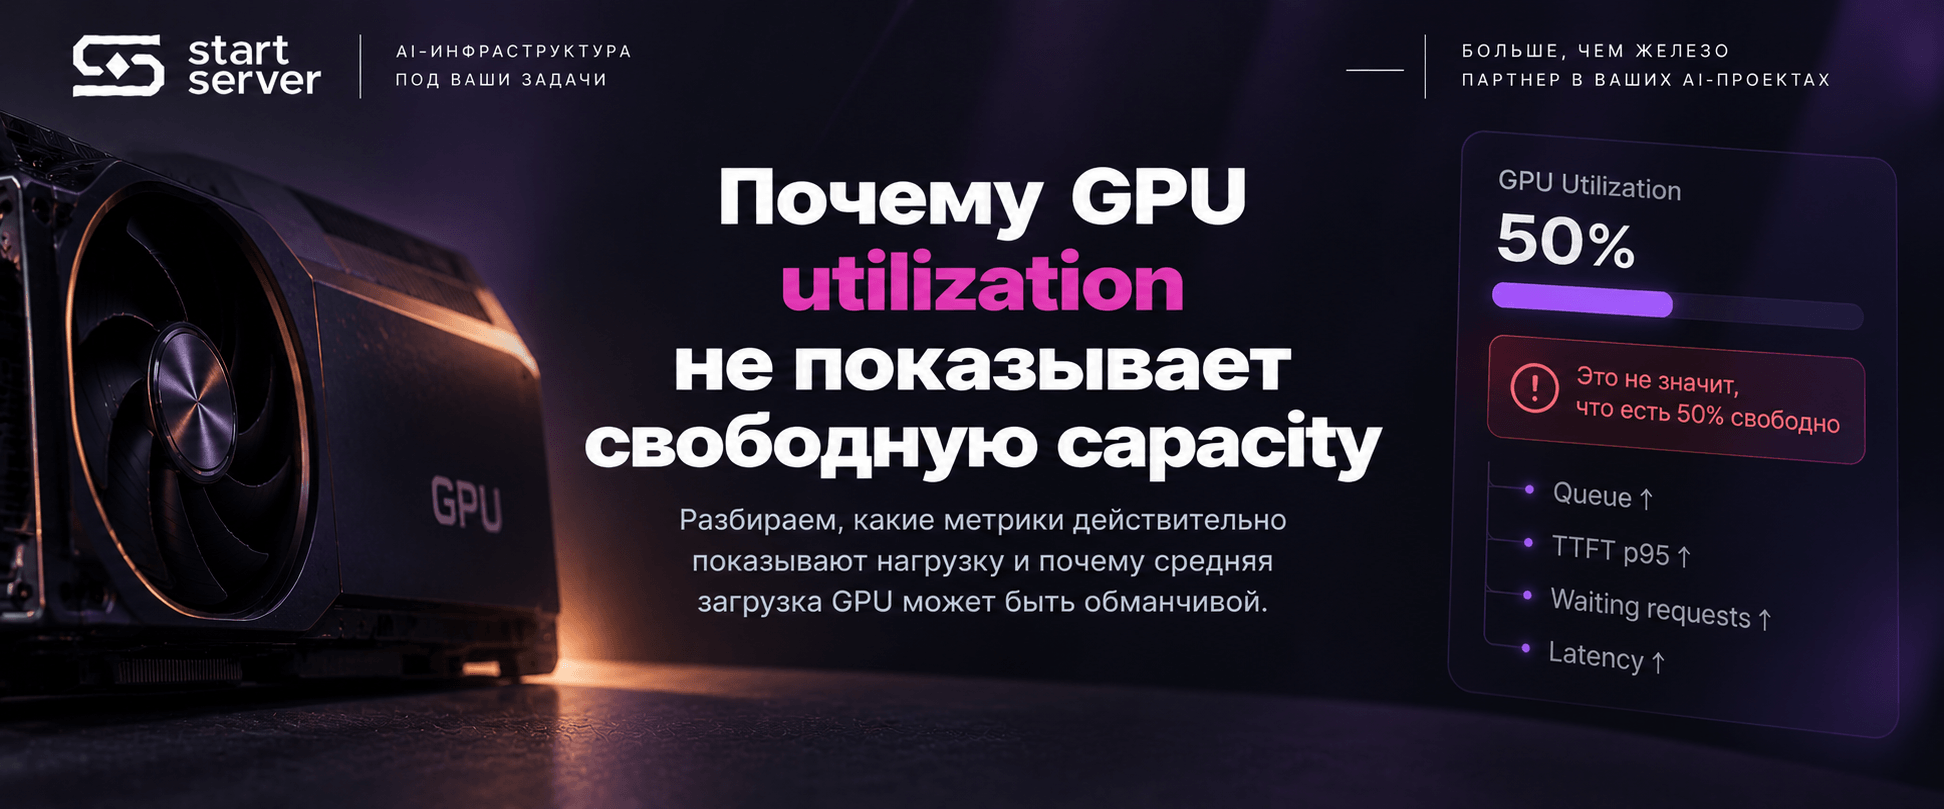
Для production inference полезнее смотреть на service metrics.
Актуальный vLLM предоставляет, среди прочего, num_requests_running, num_requests_waiting, queue time, TTFT, inter-token latency и end-to-end request latency. Его benchmark tooling также отдельно определяет TTFT, ITL и TPOT.
Triton Inference Server отдельно измеряет pending requests, queue duration, request duration и compute time. Pending request count отражает запросы, которые сервер уже принял, но backend ещё не начал исполнять.
Поэтому ситуация:
GPU utilization = 50%
но:
queue ↑
TTFT p95 ↑
waiting requests ↑
означает, что GPU нельзя считать наполовину свободной.
Главный вопрос:
а не:
Насколько сейчас загружена GPU в среднем?
Сначала определите SLA для inference
До любого sharing нужно зафиксировать production requirement.
Минимальный record:
INFERENCE
Model:
Serving runtime:
Request rate by time:
Peak request rate:
Concurrency:
Prompt tokens p50/p95:
Output tokens p50/p95:
TTFT p95 target:
ITL / TPOT target:
E2E p95 target:
Maximum queue:
Maximum queue time:
Availability target:
Для generative serving TTFT и inter-token latency имеет смысл хранить раздельно: они отражают разные участки пользовательской задержки. vLLM экспортирует их как отдельные production metrics.
Если используется другой inference stack, набор названий меняется, но принцип остаётся:
Сначала измеримый production objective, затем sharing.
У training тоже есть objective
Training обычно не оценивается по пользовательской latency, зато имеет:
step time
samples/s или tokens/s
job duration
deadline
GPU-hours
checkpoint interval
Минимальный record:
TRAINING
Model:
Training type:
Parallelism:
Normal GPU allocation:
Minimum useful allocation:
Step time:
Throughput:
Typical job duration:
Deadline:
Checkpoint interval:
Checkpoint duration:
Resume duration:
Preemption allowed:
Shared server не проходит проверку, если production inference стабилен, но training jobs систематически не успевают завершиться.
Inference SLA = PASS
Важен temporal overlap
Средний объём GPU-hours не показывает, насколько workloads конфликтуют во времени.
Вариант A
Inference peak: 09:00–18:00
Training: 22:00–07:00 допустимо
Здесь temporal overlap небольшой.
Вариант B
Inference:
непредсказуемая 24×7 нагрузка
Training:
постоянная очередь jobs
Здесь обе задачи регулярно требуют GPU одновременно.
Поэтому первым самостоятельным инструментом статьи должен быть календарь.
Shared GPU Capacity Calendar
SYSTEM
Server:
GPU exact SKU:
GPU count:
Driver:
CUDA:
NCCL:
Scheduler:
Serving runtime:
Training stack:
INFERENCE
Model:
QPS by time:
Concurrency by time:
Prompt tokens p50:
Prompt tokens p95:
Output tokens p50:
Output tokens p95:
TTFT p95 target:
ITL / TPOT target:
E2E p95 target:
Maximum queue:
Availability target:
Minimum reserved resource:
Burst reserve:
TRAINING
Model:
Training type:
Parallelism:
Normal GPU requirement:
Minimum useful GPU allocation:
Step time alone:
Throughput alone:
Typical job duration:
Jobs/week:
Deadline:
Checkpoint interval:
Checkpoint duration:
Resume duration:
Preemption supported:
Lost-work model:
CALENDAR
Time window:
Inference demand:
Inference reserved:
Burst reserve:
Training demand:
Training allowed:
Reconfiguration:
Maintenance:
SHARING MODE
Whole GPU / MIG / MPS / time-slicing:
Exact configuration:
Exact versions:
RESULT
Inference SLA: PASS / FAIL
Training deadline: PASS / FAIL
Isolation: PASS / FAIL
Availability: ACCEPT / REJECT
ONE SERVER: PASS / CONDITIONAL / FAIL
Начните с whole-GPU reservation
До MIG и MPS полезно проверить наиболее простой baseline:
4 GPU server
GPU 0–1 → inference
GPU 2–3 → training
Здесь есть понятные границы:
exclusive GPU ownership
predictable VRAM
no same-GPU compute contention
Остаются два вопроса:
Хватает ли 2 GPU inference на peak?
Хватает ли 2 GPU training для deadline?
И затем третий:
Можно ли в часы низкого inference безопасно передавать training дополнительные GPU?
Если whole-GPU allocation уже выполняет objectives, более сложный sharing может оказаться необязательным.
Когда рассматривать MIG
MIG физически разделяет поддерживаемую GPU на отдельные instances с выделенными compute и memory resources. NVIDIA описывает MIG как механизм с fault isolation и определённым QoS между workload.
Упрощённо:
PHYSICAL GPU
┌───────────────┐
│ MIG instance │ → production inference
├───────────────┤
│ MIG instance │ → workload B
├───────────────┤
│ MIG instance │ → workload C
└───────────────┘
MIG особенно интересен, когда whole GPU слишком крупная единица allocation.
Но geometry зависит от exact GPU. По актуальному списку NVIDIA максимальное число instances, например, равно 7 для H100/H200/B200/A100, 4 для RTX PRO 6000 Blackwell и 2 для RTX PRO 5000 Blackwell. Это максимальные возможности SKU, а не рекомендация использовать столько partitions.
Поэтому нельзя писать:
MIG = всегда семь частей
Нужно фиксировать exact GPU и exact profiles.
MIG не гарантирует inference SLA
После создания partition всё ещё нужно доказать:
model fits VRAM?
compute capacity enough?
memory bandwidth enough?
peak QPS passes?
TTFT passes?
queue remains bounded?
Правильная последовательность:
choose MIG profile
↓
deploy exact model
↓
replay production-relevant peak
↓
measure latency + queue
↓
PASS / FAIL
MIG даёт resource boundary.
MIG и distributed training: проверяйте версию NCCL
Это один из самых быстро меняющихся участков темы.
Текущий MIG User Guide всё ещё указывает, что NCCL с MIG не поддерживается и описывает ограничения P2P между MIG devices.
Но NCCL 2.31.2 документирует experimental support нескольких MIG instances начиная с NCCL 2.31. Условия включают отдельную MIG instance для каждого rank и CUDA driver 13.0+; MNNVL нужно отключить, NVLS с MIG не используется. NVIDIA отдельно предупреждает, что large-scale validation пока ограничена.
Поэтому неверны обе универсальные формулы:
MIG + NCCL = невозможно
и:
MIG + NCCL = обычная production-конфигурация
Корректнее:
Distributed training на MIG зависит от exact GPU, CUDA/driver, NCCL version и parallelism конкретного training job. В NCCL 2.31 эта возможность остаётся experimental.
Перед выбором MIG для training фиксируют:
single-GPU / multi-GPU
DP
FSDP
TP
PP
EP
NCCL version
collectives
P2P requirements
Что даёт MPS
CUDA Multi-Process Service позволяет нескольким CUDA processes конкурентно использовать одну GPU и может быть полезен, когда отдельный процесс сам не насыщает accelerator.
process A ─┐
├→ shared GPU
process B ─┘
Но MPS не является эквивалентом MIG.
В NVIDIA MIG Concepts MPS описывается как logical partitioning: memory protection присутствует, но memory bandwidth QoS отсутствует, memory/cache capacity остаются shared, а hardware scheduling остаётся общей системой. MIG является physical partitioning и предоставляет более сильную resource isolation.
MPS percentage не обязательно является reservation
Если MPS client ограничен, например:
30% execution resources
это нельзя автоматически читать как:
30% GPU гарантированно
зарезервированы только ему
Документация MPS прямо говорит: обычный provisioning limit ограничивает объём ресурсов, который client может использовать, но не резервирует dedicated resources; kernels разных clients могут исполняться на одних SM.
На современных Ampere+ GPU MPS также поддерживает static SM partitioning с более детерминированным распределением SM. Поэтому конфигурация должна фиксировать exact MPS mode и driver generation.
Следовательно:
Time-slicing — не фиксированная доля GPU
NVIDIA GPU Operator позволяет объявлять несколько time-sliced replicas одной physical GPU.
Но NVIDIA прямо указывает, что между такими replicas нет memory или fault isolation. Также запрос большего числа shared replicas не гарантирует пропорционально больший объём compute.
То есть:
replicas = 4
не означает:
каждый workload
получает гарантированные 25%
Time-slicing лучше рассматривать как utilization mechanism, а не как самостоятельное доказательство выполнения production SLA.
Для latency-sensitive inference:
time-slicing → coexistence benchmark mandatory
Scheduler allocation не равно performance guarantee
Slurm умеет планировать whole GPU, MPS и MIG resources. MIG instances могут представляться scheduler как отдельные GPU с cgroup isolation и task binding.
Но:
resource allocated
не означает:
application SLA passed
Также Slurm ожидает, что MIG partitioning уже выполнен заранее, и сам dynamic MIG partitioning не выполняет.
У observability есть дополнительное ограничение: Slurm не предоставляет gpumem/gpuutil accounting для MIG devices, поскольку NVML не предоставляет соответствующие utilization metrics в требуемом формате.
Поэтому scheduler history не всегда достаточна для capacity planning.
Dynamic MIG reconfiguration имеет operational cost
Схема:
day → inference geometry
night → training geometry
может быть полезной, но переключение не является мгновенным.
В NVIDIA GPU Operator MIG Manager при изменении конфигурации останавливает GPU-related pods/clients, применяет новую MIG geometry и затем перезапускает компоненты. В некоторых сценариях для включения MIG mode может потребоваться reboot узла.
Поэтому полезное окно training:
Useful_training_window = Calendar_window - T_transition_to_training - T_transition_back
где transition может включать:
drain
checkpoint
MIG reconfiguration
possible reboot
service restart
model reload
warm-up
resume
Preemption training тоже имеет цену
Возможная политика:
inference burst
↓
training checkpoint
↓
release GPU
↓
serve burst
↓
resume training
работает только при известной стоимости checkpoint/resume.
NeMo AutoModel умеет обрабатывать preemption signal, сохранить checkpoint на следующей границе training step и затем продолжить работу после повторного запуска.
Но:
checkpoint supported ≠ preemption is free
Полезная модель:
T_preemption =
T_signal
+
T_until_step_boundary
+
T_checkpoint
+
T_drain
+
T_resume
+
T_warmup
+
T_lost_work
Все параметры измеряются на exact training stack.
Async checkpoint переносит часть работы, но не устраняет её
PyTorch Distributed Checkpoint поддерживает asynchronous saving.
При этом async checkpointing сначала копирует состояние в CPU buffers, что увеличивает требования к CPU memory; документация также предупреждает о дополнительной concurrency/memory нагрузке. В PyTorch 2.9 появился механизм fully asynchronous staging, который переносит GPU→CPU staging в background thread, но этот thread тоже использует CPU resources.
Поэтому даже при раздельных GPU training способен конкурировать с inference за:
CPU
DRAM
storage I/O
PCIe
network
Shared-node benchmark должен смотреть шире GPU utilization.
Разные GPU ещё не гарантируют отсутствие interference
Пусть:
GPU 0–1 → inference
GPU 2–3 → training
Accelerator allocation независима.
Но training одновременно может:
загружать dataset
писать checkpoint
использовать CPU
потреблять RAM
нагружать NVMe
использовать NIC
Если inference зависит от тех же ресурсов, tail latency может измениться даже без same-GPU sharing.
Следовательно, при необходимости наблюдаем:
GPU compute
GPU memory
CPU load
RAM pressure
storage I/O
network
Как доказать возможность coexistence
Нужны три теста.
Test A — inference only
Model:
Runtime:
Traffic profile:
QPS:
Concurrency:
Prompt distribution:
Output distribution:
TTFT p50/p95/p99:
ITL:
E2E:
Queue:
Throughput:
Errors:
Test B — training only
Model:
Training type:
Parallelism:
GPU count:
Step time:
Throughput:
Checkpoint time:
Estimated completion:
Test C — together
Используются та же inference-нагрузка и та же training-конфигурация.
INFERENCE
TTFT:
ITL:
E2E:
Queue:
Throughput:
Errors:
TRAINING
Step time:
Throughput:
Checkpoint:
Estimated completion:
Главное правило:
Это соответствует внутреннему правилу Start Server: у сравнения должны совпадать методика и нагрузка.
Как измерить interference
Для inference:
Inference_latency_amplification = p95_shared / p95_inference_alone
Учебный пример:
p95 alone = 500 ms
p95 shared = 650 ms
650 / 500 = 1.30
Это означает только, что p95 в условном примере вырос в 1,3 раза.
Это не допустимый норматив.
PASS определяется production SLA.
Для training:
Training_slowdown = step_time_shared / step_time_alone
или:
Throughput_retention = throughput_shared / throughput_alone
Например, учебно:
step alone = 2.0 s
step shared = 2.6 s
slowdown = 1.30
Опять же, вопрос не в числе 1.30 как таковом.
Вопрос:
После этого job всё ещё проходит deadline?
GPU-hours помогают считать календарь, но не scaling
Для training:
GPU_hours = GPU_count × hours
Например:
4 GPU × 6 h = 24 GPU-hours
Для whole-GPU calendar:
Available_training_GPU_hours = Σ (training-eligible GPU count × window duration)
Это полезно для первого capacity budget.
Но нельзя автоматически сказать:
4 GPU × 6 h = 2 GPU × 12 h
с точки зрения времени обучения.
Training scaling может быть нелинейным, а изменение GPU count — менять parallelism и communication profile.
GPU-hours — accounting unit, а не performance model.
Burst reserve inference определяется из нагрузки, а не магического процента
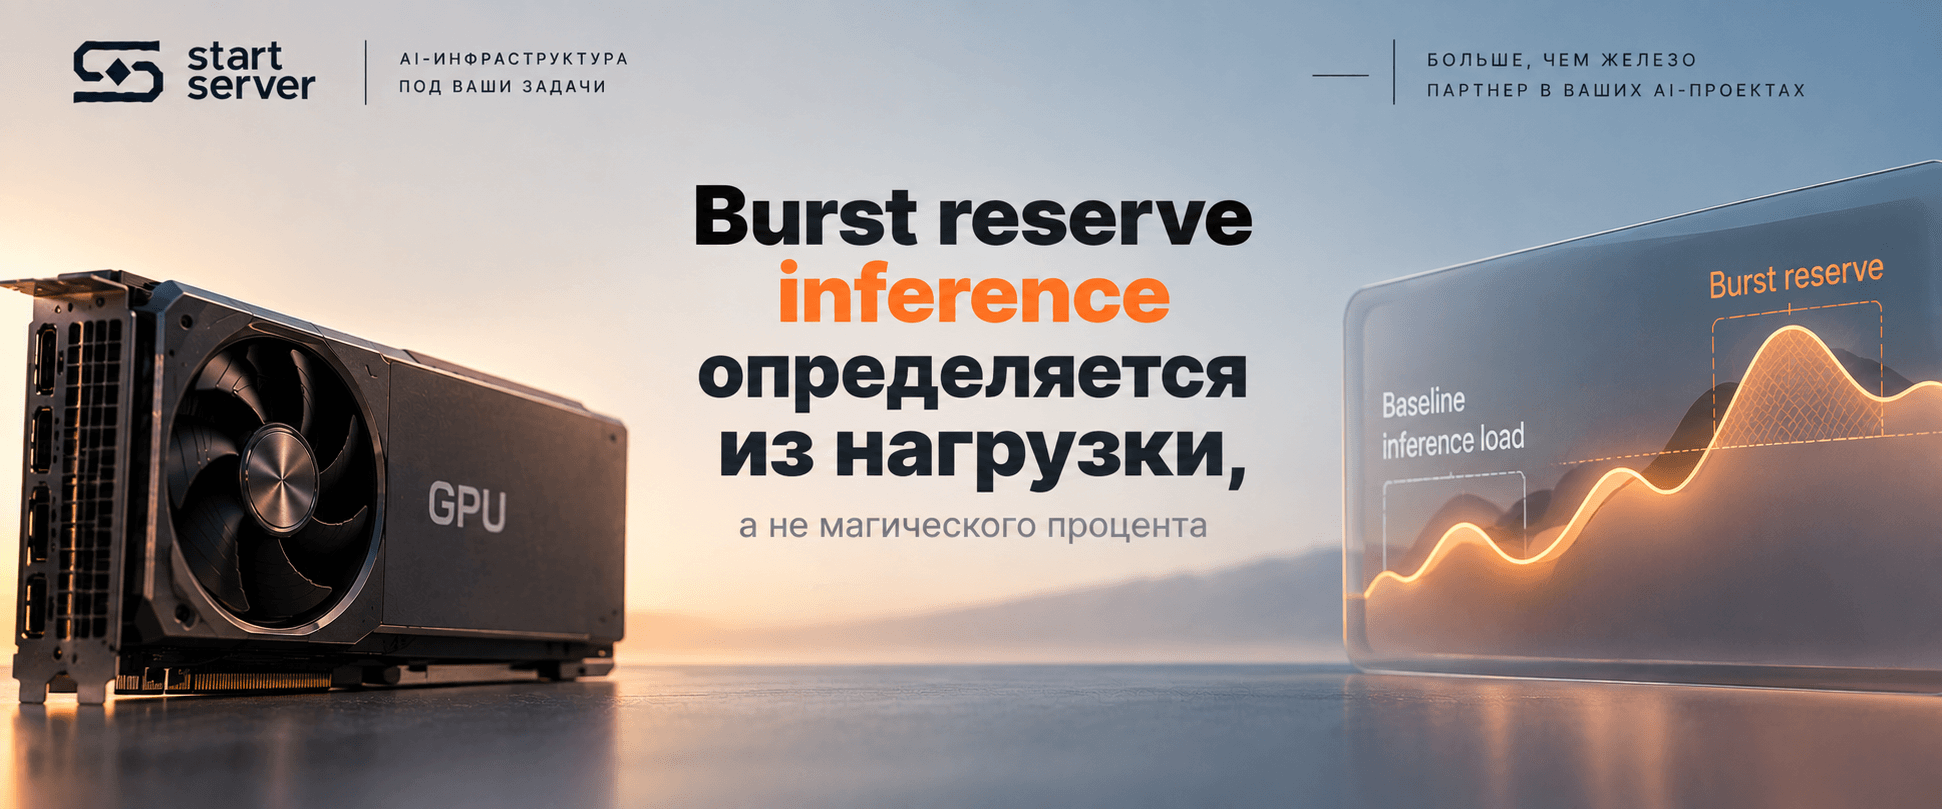
Capacity можно концептуально разделить:
total capacity = minimum inference reservation + burst reserve + training-eligible capacity
Но нет универсального:
reserve 20%
или:
оставьте 30% headroom
Reserve определяется через:
historical peaks
forecast peaks
burst duration
latency SLA
reconfiguration time
risk tolerance
Если burst длится несколько секунд, допустим один operating model.
Когда проще разделить нагрузки во времени
Самый простой shared design иногда вообще не требует simultaneous GPU sharing:
08:00–20:00 inference priority
22:00–06:00 training window
Но даже здесь есть transition cost:
checkpoint
resource release
model unload/load
MIG reconfiguration if needed
data staging
warm-up
Поэтому:
«Днём inference, ночью training»
— только scheduling hypothesis.
Её всё равно нужно проверить календарём.
Maintenance lifecycle может оказаться важнее performance
Training environment может регулярно требовать:
новый framework
новый CUDA
новый NCCL
экспериментальный driver
reboot
Production inference, наоборот, часто требует стабильного tested stack и контролируемого maintenance window.
На одном server это один driver/kernel lifecycle.
Поэтому задайте отдельный вопрос:
Могут ли training и inference безопасно жить с одним change-management cycle?
Если нет, разделение физических контуров может потребоваться даже при хорошем benchmark.
Один сервер остаётся одним failure domain
MIG разделяет GPU resources.
MPS разделяет execution.
Whole-GPU reservation убирает same-GPU contention.
Но физический node остаётся общим:
motherboard
CPU
RAM
power domain
storage
NIC
OS/kernel
GPU driver
maintenance/reboot
Поэтому:
capacity PASS + performance PASS
ещё не равно:
architecture PASS
Когда один сервер подходит
Shared node остаётся сильным кандидатом, если одновременно:
Inference SLA
PASS
Training deadline
PASS
Isolation
ACCEPTABLE
Preemption / transition
ACCEPTABLE
Maintenance lifecycle
COMPATIBLE
Common failure domain
ACCEPTABLE
Особенно хорошо shared model подходит, когда пики workloads мало пересекаются и training допускает гибкое расписание.
Но это всегда вывод из конкретного календаря, а не правило по числу GPU.
Когда разделять training и inference на два контура
Не используйте правило:
GPU utilization > 70%
→ второй server
Универсального threshold нет.
Используйте objectives:
Проверка | Один сервер остаётся кандидатом | Разделение становится сильным кандидатом |
Temporal overlap | пики редко совпадают | обе нагрузки постоянно активны |
Inference SLA | latency и queue PASS | p95/p99 или queue FAIL |
Training | deadline PASS | jobs формируют backlog |
Isolation | sharing mode достаточен | требуемая isolation не обеспечивается |
Preemption | редкая и предсказуемая | checkpoint/resume слишком дорог |
Reconfiguration | мала относительно окна | переходы съедают значимую capacity |
Scaling | workloads растут совместно | их нужно масштабировать независимо |
Maintenance | единый stack приемлем | change cycles конфликтуют |
Failure domain | общий node допустим | production требует независимости |
Ключевой принцип:
Итоговый алгоритм
1. Определить inference SLA
↓
2. Построить inference profile по времени
↓
3. Определить training objective / deadline
↓
4. Построить training profile
↓
5. Найти temporal overlap
↓
6. Начать с whole-GPU baseline
↓
7. Рассматривать MIG / MPS / time-slicing,
только если они дают практическую пользу
↓
8. Зафиксировать exact software versions
↓
9. Benchmark inference alone
↓
10. Benchmark training alone
↓
11. Benchmark coexistence
↓
12. Измерить checkpoint / preemption
↓
13. Измерить reconfiguration
↓
14. Проверить CPU / RAM / storage / network contention
↓
15. Проверить maintenance lifecycle
↓
16. Проверить failure domain
↓
17. ONE SERVER:
PASS / CONDITIONAL / FAIL
Что передать для проверки схемы?
SERVER
GPU exact SKU:
GPU count:
Driver:
CUDA:
NCCL:
Scheduler:
INFERENCE
Model:
Serving runtime:
QPS/time profile:
Concurrency:
Prompt/output distribution:
TTFT target:
p95 target:
Queue tolerance:
TRAINING
Model:
Training type:
Parallelism:
GPU requirement:
Step time:
Job duration:
Deadline:
Checkpoint interval:
Checkpoint time:
Resume time:
OPERATIONS
Planned sharing mode:
Maintenance constraints:
Availability target:
Acceptable failure domain:
По этим данным можно построить Shared GPU Capacity Calendar и определить, остаётся ли один сервер рациональной архитектурой или workloads уже требуют независимого scaling.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


