PCIe и SXM часто сравнивают одной фразой: PCIe гибче, SXM быстрее.
Для выбора реального GPU-сервера этого недостаточно.
У PCIe-системы действительно проще увидеть отдельные accelerator cards, risers и свободные слоты. Но наличие PCIe x16 ещё не означает, что через два года в этот слот получится поставить любую новую GPU.
У SXM всё выглядит более интегрированно: ускорители устанавливаются на специализированный GPU baseboard и в современных HGX-системах объединяются NVLink/NVSwitch fabric. Но и отсюда нельзя делать противоположный вывод — будто при отказе одной SXM GPU обязательно меняется весь восьмиускорительный baseboard.
При закупке полезнее смотреть не на разъём, а на весь жизненный цикл системы:
Именно на этих вопросах PCIe и SXM начинают отличаться по-настоящему.
PCIe или SXM: короткий ответ
Если для проекта особенно важно | Куда смотреть в первую очередь |
Гибко комплектовать сервер отдельными GPU | PCIe |
Обслуживать отдельные accelerator cards | чаще PCIe |
Добавлять GPU постепенно | PCIe, если расширение предусмотрено OEM |
Тесно связать несколько GPU внутри одного узла | SXM/HGX |
Получить NVSwitch fabric на 8 GPU | SXM/HGX |
Запустить большую модель через интенсивный tensor parallelism | SXM/HGX часто получает сильный аргумент |
Размещать независимые inference workers на отдельных GPU | PCIe может быть рациональнее |
В будущем перейти на другую модель GPU | проверять exact server SKU независимо от форм-фактора |
Минимизировать последствия отказа GPU | смотреть service procedure конкретного сервера |
Эта таблица — не набор универсальных правил.
Финальное решение определяется конкретной моделью сервера, конкретными GPU и workload.
PCIe и SXM отличаются глубже, чем разъёмом
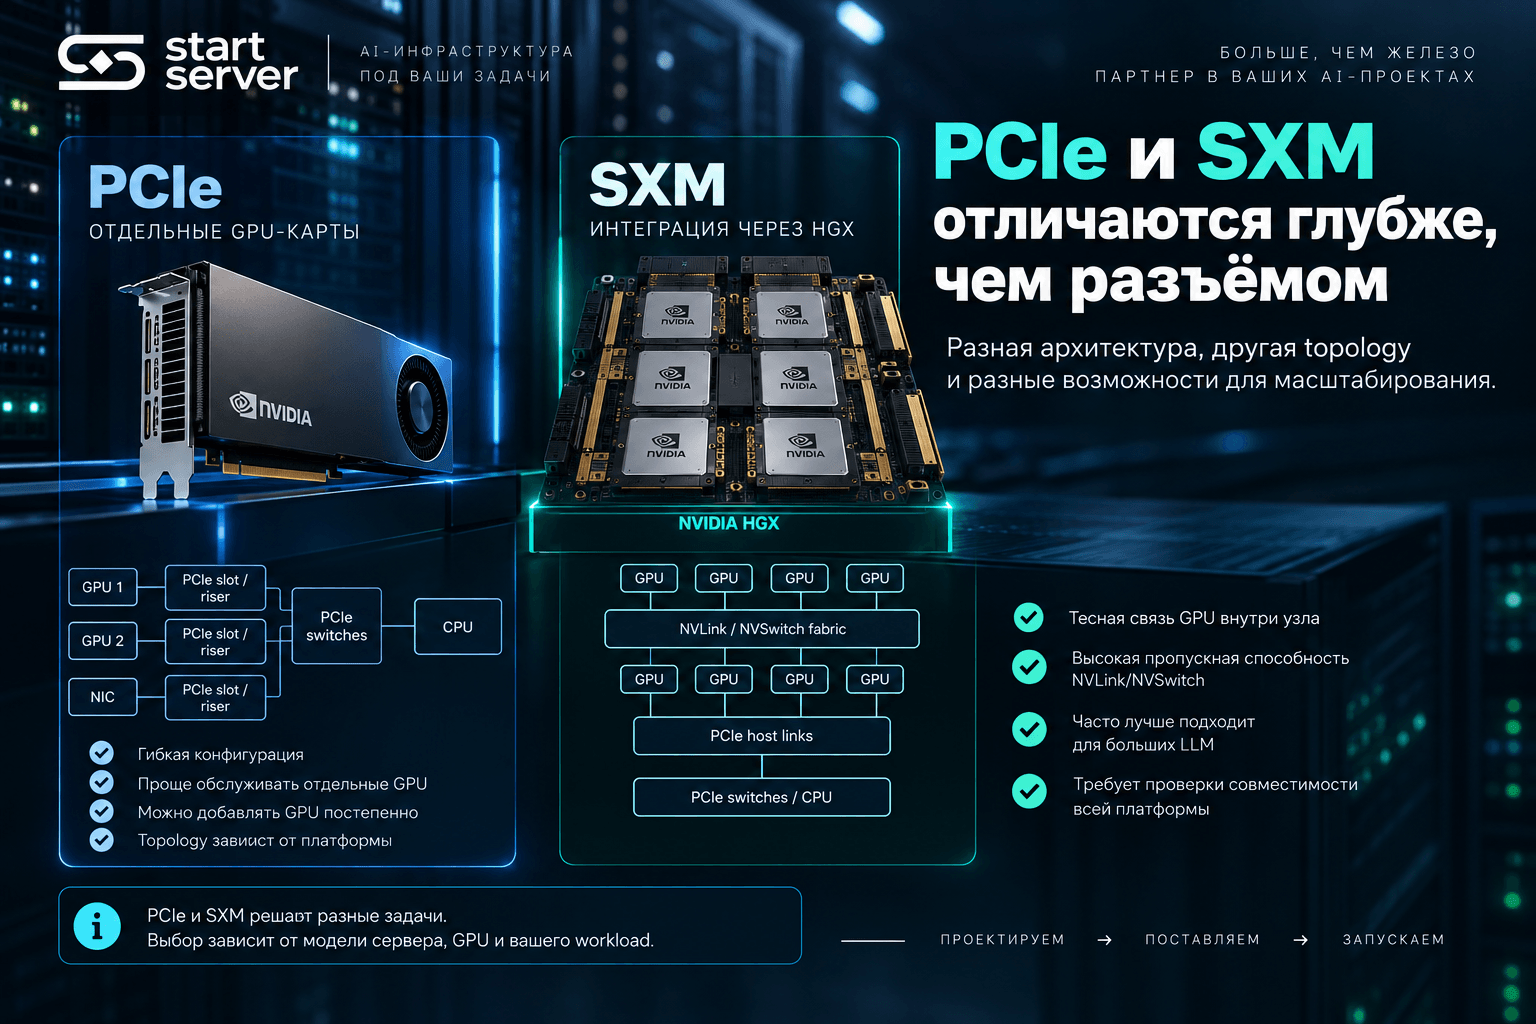
В типичном PCIe GPU-сервере ускоритель является отдельной add-in картой.
Упрощённо:
GPU 1 ─ PCIe slot / riser ─┐
GPU 2 ─ PCIe slot / riser ─┼─ PCIe root / switches ─ CPU
GPU 3 ─ PCIe slot / riser ─┤
NIC ─ PCIe slot / riser ─┘
Конкретная topology зависит от платформы: GPU могут подключаться к разным CPU root complexes или через PCIe switches.
В SXM/HGX архитектура другая:
SXM GPU ─┐
SXM GPU ─┤
SXM GPU ─┼─ NVLink / NVSwitch fabric
... │
SXM GPU ─┘
│
GPU baseboard
│
PCIe host links
│
PCIe switches / CPU
Например, NVIDIA описывает HGX H100/H200 8-GPU как baseboard с восемью accelerator GPU, fourth-generation NVLink и third-generation NVSwitch. При этом соединение GPU subsystem с host всё равно использует восемь PCIe Gen5 x16 links.
Отсюда важное уточнение:
PCIe и NVLink в такой системе решают разные задачи.
PCIe связывает accelerator subsystem с host и другими компонентами.
NVLink/NVSwitch формирует высокоскоростную GPU-to-GPU fabric.
Почему нельзя сказать просто «SXM быстрее PCIe»
Для этого пришлось бы сравнить две совершенно одинаковые GPU, работающие в одинаковых условиях и отличающиеся только интерфейсом.
Реальные accelerator SKU так устроены редко.
Возьмём A100 80 GB.
Параметр | A100 80 GB PCIe | A100 80 GB SXM |
GPU memory | 80 GB HBM2e | 80 GB HBM2e |
Memory bandwidth | 1 935 GB/s | 2 039 GB/s |
Max TDP | 300 W | 400 W standard |
Form factor | PCIe | SXM |
PCIe | Gen4 | Gen4 |
NVLink | bridge до 2 GPU | через HGX |
NVIDIA отдельно указывает 600 GB/s NVLink и для SXM4 через HGX A100, и для PCIe A100 при использовании NVLink Bridge до двух GPU.
У SXM-варианта A100 действительно выше power envelope и немного выше memory bandwidth.
Но это свойства конкретных A100 исполнений.
Из них нельзя получить универсальное правило:
SXM всегда быстрее PCIe на X процентов.
Тем более нельзя переносить такой коэффициент на H100, H200 или следующее поколение GPU.
H200 хорошо показывает, почему нужно указывать точное исполнение
У NVIDIA H200 есть как минимум два важных для этой темы варианта — H200 SXM и H200 NVL в PCIe form factor.
Параметр | H200 SXM | H200 NVL |
GPU memory | 141 GB | 141 GB |
Memory bandwidth | 4,8 TB/s | 4,8 TB/s |
BF16 Tensor Core* | 1 979 TFLOPS | 1 671 TFLOPS |
FP8 Tensor Core* | 3 958 TFLOPS | 3 341 TFLOPS |
Max TDP | до 700 W | до 600 W |
Form factor | SXM | PCIe |
Interconnect | NVLink 900 GB/s | 2-/4-way NVLink bridge, до 900 GB/s на GPU |
PCIe | Gen5 | Gen5 |
* Значения NVIDIA с sparsity.
Здесь объём HBM и memory bandwidth одинаковы.
А compute specification, power envelope, form factor и способ построения multi-GPU topology различаются.
Поэтому запись:
сервер на H200
для серьёзного технического задания недостаточна.
Нужно понимать:
PCIe не означает «GPU общаются только через PCIe»
Это ещё одна ошибка, которая часто появляется в упрощённых сравнениях.
PCIe и NVLink — не взаимоисключающие характеристики.
У A100 PCIe NVIDIA предусмотрела NVLink Bridge для пары GPU. H200 NVL использует PCIe form factor и при этом поддерживает до четырёх GPU через NVLink. Для четырёх H200 NVL NVIDIA указывает до 1,8 TB/s interconnect bandwidth и суммарные 564 GB HBM3e.
При этом это всё равно не то же самое, что HGX.
В HGX H100/H200 восемь GPU объединены NVSwitch fabric. NVIDIA указывает 900 GB/s GPU-to-GPU bandwidth и 7,2 TB/s aggregate NVLink bandwidth для 8-GPU baseboard.
Поэтому вопрос:
Есть ли NVLink?
сам по себе мало что говорит.
Нужен другой:
Как связаны все GPU в конкретной конфигурации и соответствует ли эта topology нашему workload?
Когда topology становится действительно важной
Представим два сервера по восемь GPU.
В первом каждая GPU обслуживает собственный inference worker.
GPU почти не зависят друг от друга.
Во втором одна большая модель разбита на восемь ускорителей через tensor parallelism.
Теперь GPU приходится постоянно обмениваться данными.
Физически в обоих случаях написано:
8 × GPU.
Архитектурно это две очень разные задачи.
Во втором случае производительность уже зависит от collective communication и GPU-to-GPU fabric. Именно здесь архитектура HGX с NVLink/NVSwitch получает сильный аргумент.
Поэтому правило:
inference = PCIe, training = SXM
слишком грубое.
Большая LLM на inference может интенсивно использовать все восемь GPU.
А часть training workloads вполне выполняется на PCIe-платформах.
Гораздо полезнее спросить:
Насколько тесно GPU должны взаимодействовать в нашей задаче?
PCIe даёт модульность, но не универсальную совместимость
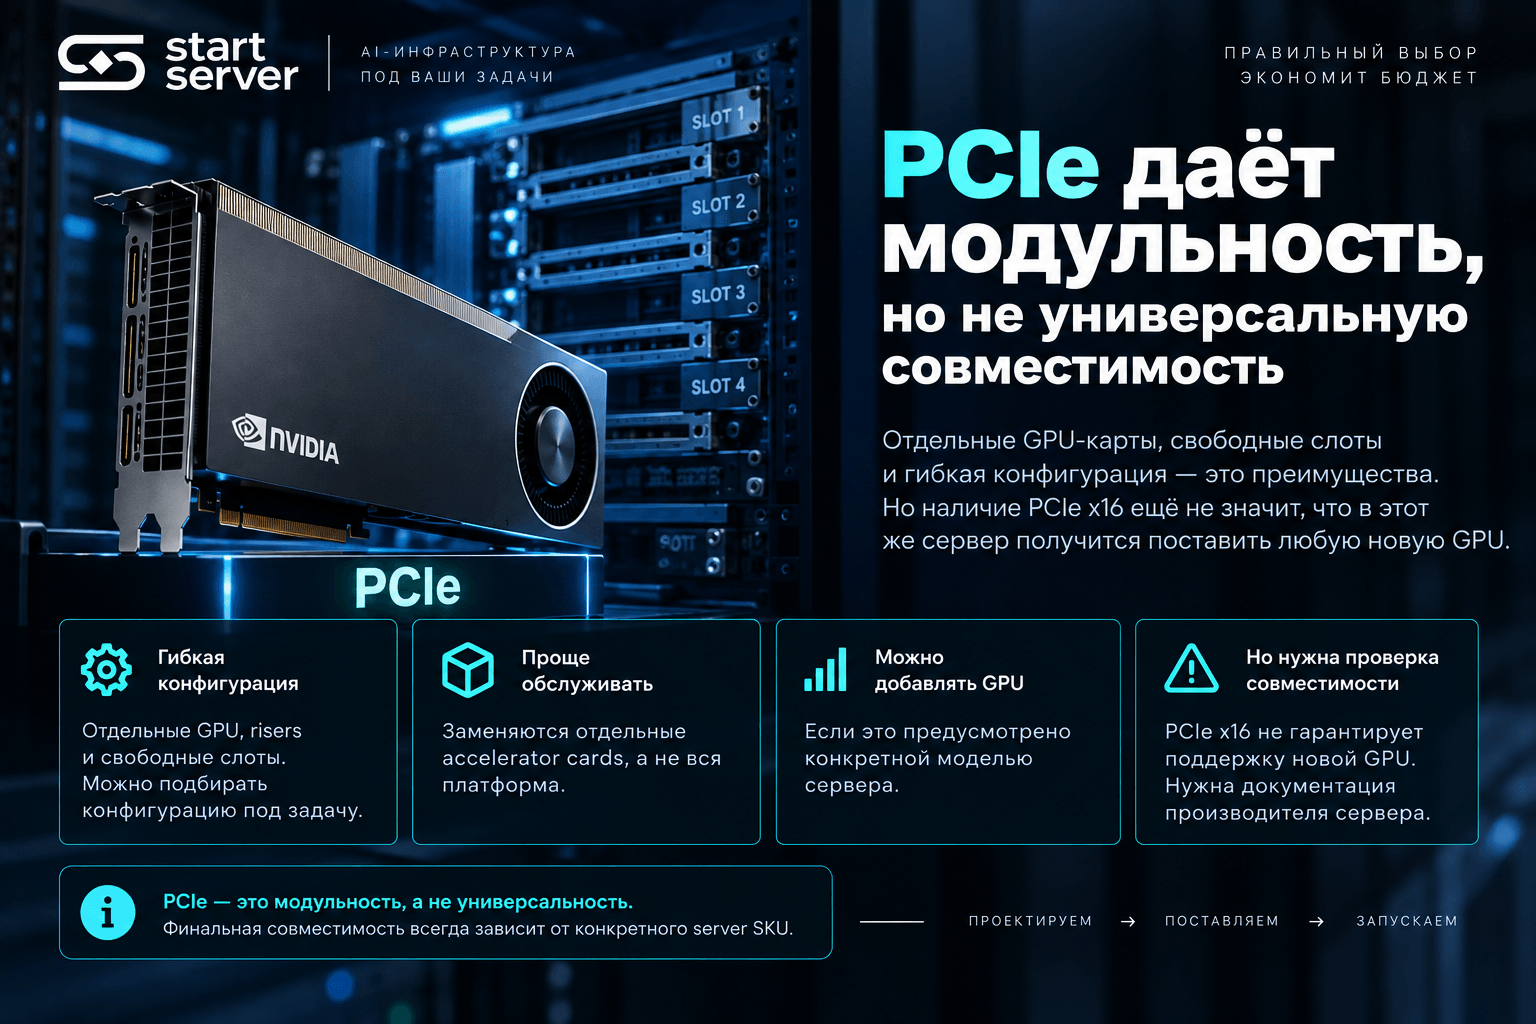
Теперь другой сценарий.
В сервере есть PCIe x16.
Новая GPU тоже PCIe.
Физически размеры подходят.
Можно ставить?
Не обязательно.
Для GPU-сервера нужно проверить как минимум точный accelerator SKU, server SKU, riser configuration, power delivery, cooling, firmware и официальный OEM support.
Реальный Dell PowerEdge R760xa хорошо показывает, почему.
В его installation guide среди полноразмерных accelerator cards присутствуют H100/H100 NVL, A100 и другие GPU, но OEM одновременно задаёт конкретный порядок слотов и максимальное число таких карт — четыре для этой конфигурации. Dell отдельно указывает, что expansion-card slots не являются hot-swappable.
То есть даже в сервере, специально рассчитанном на GPU:
Даже A100 PCIe и H100 PCIe могут потребовать разные компоненты сервера
В том же Dell R760xa различается штатное питание GPU.
Для A100 Dell указывает CPU-type 8-position power cable.
Для H100 — уже 12VH cable с 12-position + sideband connection.
Это хороший практический пример.
Обе GPU относятся к PCIe.
Обе могут фигурировать в документации одного сервера.
Но переход:
A100 PCIe → H100 PCIe
всё равно не сводится к правилу:
вынуть старую карту → поставить новую.
Может потребоваться другая штатная power infrastructure.
Поэтому:
PCIe даёт модульность. PCIe не гарантирует drop-in replacement.
Можно ли купить четыре GPU сейчас, а ещё четыре потом
Такой план лучше проверить в момент первоначального заказа.
Сам факт наличия свободного места в корпусе ещё ничего не гарантирует.
Для дополнительных GPU могут понадобиться другие risers, кабели питания, вентиляторы, PSU configuration или определённое распределение PCIe lanes.
Может существовать и жёсткое ограничение OEM на GPU count.
Поэтому перед закупкой стоит различать две вещи:
сколько GPU сейчас установлено и сколько GPU эта exact configuration официально поддерживает.
Это особенно важно для серверов, где визуально есть дополнительные слоты, но нужная GPU-конфигурация разрешена только в определённых позициях или при определённом составе risers.
Свободный слот — не то же самое, что свободное место в поддерживаемой GPU-конфигурации.
Как выглядит обслуживание PCIe GPU
У PCIe-систем преимущество модульности видно довольно хорошо.
В Dell PowerEdge R760xa отдельная GPU действительно извлекается как самостоятельная карта: снимается соответствующий riser, отсоединяется GPU power cable, после чего карта выводится из riser.
Но слово «отдельная» не нужно путать со словом «горячая».
Dell прямо отмечает:
expansion-card slots не hot-swappable.
То есть замена отдельной PCIe GPU всё равно предполагает сервисную процедуру и остановку системы.
Тем не менее архитектурная граница понятна: GPU остаётся отдельной add-in card.
Нужно ли при отказе SXM GPU менять весь baseboard
Нет, такое правило тоже было бы неправильным.
На Dell PowerEdge XE9680 есть официальная процедура замены отдельного NVIDIA H100 GPU and Heatsink Module.
При этом добраться до него существенно сложнее, чем до обычной PCIe-карты. По процедуре Dell требуется снять GPU fans, fan cage, извлечь GPU tray, снять его верхнюю крышку и только после этого демонтировать конкретный H100 module с GPU baseboard.
Это очень показательный пример.
С одной стороны:
одна неисправная H100 не означает автоматическую замену всего baseboard.
С другой:
SXM module не обслуживается как обычная PCIe card.
Он является частью более глубоко интегрированной GPU subsystem.
Именно поэтому сервисную модель нельзя определять только по слову SXM.
Для другого OEM или другой server generation процедура может отличаться.
Что такое FRU и почему это важно при закупке
В документации серверов часто встречается термин FRU — Field Replaceable Unit, то есть компонент, который предусмотрен как отдельная сервисная единица.
Для GPU-сервера полезно выяснить заранее, чем являются FRU:
сама GPU;
GPU + heatsink;
riser;
GPU tray;
baseboard;
NVSwitch-related components;
блоки питания и охлаждения.
Это влияет не на benchmark, а на последствия реального отказа.
Предположим, через два года выходит из строя одна GPU.
Для эксплуатации гораздо важнее знать:
чем знать ещё один показатель TFLOPS.
Модернизация SXM сильнее связана с поколением платформы
Интеграция SXM/HGX даёт преимущества для scale-up, но имеет обратную сторону: GPU сильнее связаны с поколением baseboard и interconnect fabric.
Хорошо видно это на развитии HGX.
Для HGX H100/H200 NVIDIA указывает fourth-generation NVLink и third-generation NVSwitch с 900 GB/s GPU-to-GPU bandwidth.
У HGX B200 уже fifth-generation NVLink и fourth-generation NVSwitch, а GPU-to-GPU bandwidth увеличивается до 1,8 TB/s.
Это уже изменение платформенной архитектуры, а не просто установка «чуть более новой карты».
Но здесь важно не сделать противоположную ошибку:
любая новая SXM GPU всегда требует новый сервер.
Тоже нет.
H100 и H200 находятся внутри одной HGX H100/H200 архитектурной группы и используют одинаковое поколение NVLink/NVSwitch fabric.
Поэтому upgrade нужно проверять не по названию следующей GPU, а по вопросу:
поддерживается ли она существующим GPU baseboard, fabric и конкретным OEM server SKU?
PCIe всегда проще модернизировать?
У PCIe потенциальная свобода выше.
Стандартизированная add-in card архитектура позволяет OEM поддерживать несколько accelerator SKU в одном сервере и иногда добавлять новые GPU в уже существующую платформу.
Но именно OEM поддерживать.
Не пользователь автоматически решает, что новая карта совместима.
R760xa снова даёт хороший пример: A100 и H100 относятся к PCIe accelerator cards, но для них уже отличаются штатные power cables.
С другой GPU могут измениться ещё и:
power envelope;
airflow;
physical dimensions;
slot requirements;
firmware;
CPU restrictions.
Поэтому формулировка:
PCIe обычно даёт более гибкую основу для модернизации
корректна.
А:
PCIe позволяет потом поставить любую новую GPU
— нет.
Даже название модели сервера не всегда описывает GPU subsystem
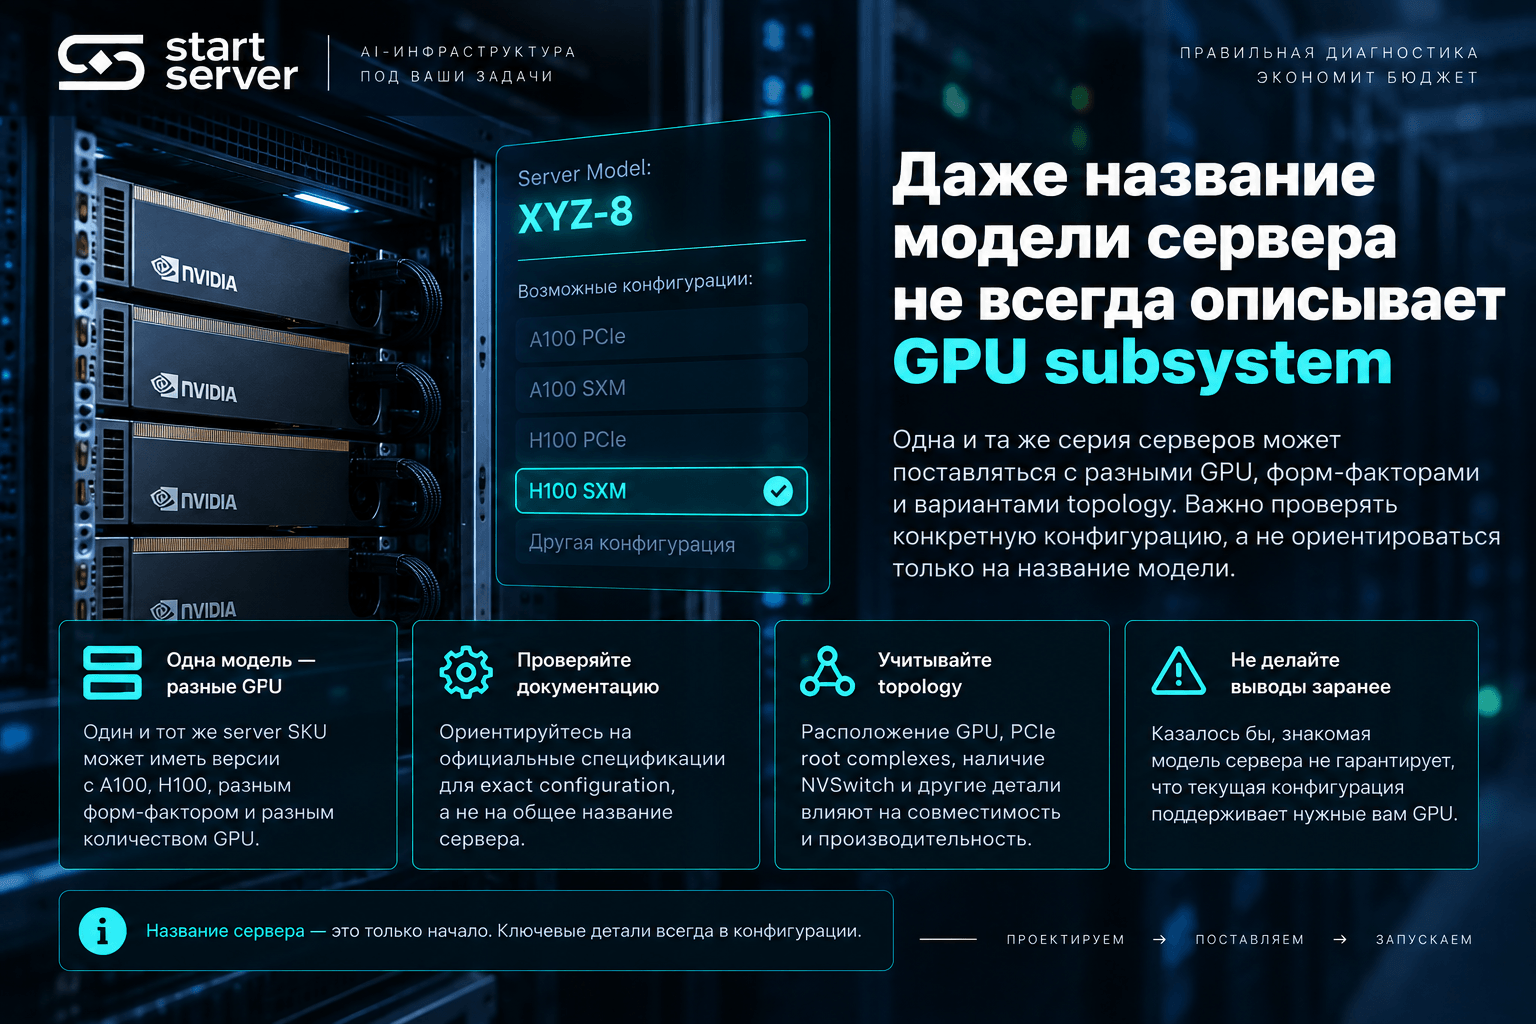
Есть ещё одна ловушка.
Покупатель знает:
У нас Dell XE9680.
Этого может быть недостаточно.
Для XE9680 Dell публикует отдельные процедуры обслуживания A100 и H100 GPU subsystems. Например, для A100 описывается собственная GPU module procedure, а H100 снимается вместе с heatsink module с соответствующего GPU baseboard.
Из этого нельзя сделать вывод, что A100-конфигурацию XE9680 можно field-upgrade до H100 простой заменой модулей.
Напротив.
Полезный вывод такой:
Поэтому при закупке, сервисе или модернизации нужно фиксировать не просто название сервера, а exact GPU configuration/baseboard generation.
PCIe и SXM через весь жизненный цикл сервера
Теперь сравнение становится гораздо полезнее.
Вопрос | PCIe | SXM/HGX |
Может ли одна GPU заменяться отдельно | Обычно да в OEM-supported системе | Может быть да; зависит от конструкции сервера |
Как осуществляется доступ | Card/riser subsystem | Часто GPU tray/baseboard subsystem |
Можно ли поставить другой GPU SKU | Только если сервер его поддерживает | Только при совместимости GPU platform и OEM |
Можно ли добавлять GPU по одной | Иногда | Сильнее зависит от конструкции baseboard |
Может ли быть NVLink | Да, у определённых GPU/configurations | Да, центральная часть современных HGX |
NVSwitch fabric | Не является свойством PCIe как интерфейса | Ключевой элемент современных HGX scale-up систем |
Upgrade между поколениями | Потенциально гибче | Сильнее зависит от поколения GPU platform/fabric |
Tightly coupled multi-GPU workload | Зависит от topology | Один из основных сценариев HGX |
Достаточно знать форм-фактор | Нет | Нет |
В этой таблице специально нет строки:
«ремонтопригодность: хорошая / плохая».
Потому что ремонтопригодность определяется готовым сервером и его service model, а не интерфейсом в вакууме.
Девять вопросов поставщику до заказа GPU-сервера
При покупке системы на несколько лет эта часть технического задания может оказаться полезнее ещё одной таблицы GPU peak performance.
Какие exact GPU SKU официально поддерживает выбранная конфигурация сервера? Не только семейство ускорителя, а конкретное исполнение.
Какое максимальное количество каждой GPU разрешено? Количество физических слотов не использовать как ответ.
Что потребуется, если увеличить GPU count позже? Нужны ли другие risers, cables, PSU, fans или иные компоненты.
Как устроена GPU-to-GPU topology? Особенно если модель будет распределяться между несколькими ускорителями.
Что является отдельной сервисной единицей при отказе одной GPU? Карта, GPU + heatsink, tray или более крупный узел.
Какие GPU subsystem components доступны как запасные части? Это непосредственно влияет на downtime.
Требуется ли остановка сервера для замены GPU и насколько глубоко разбирается accelerator subsystem?
Какие будущие GPU SKU официально поддерживает эта platform generation?
Что потребуется заменить при переходе на следующую интересующую GPU generation?
Если поставщик не может дать ответы хотя бы на первые пять вопросов, представления о жизненном цикле сервера пока недостаточно.
Когда PCIe выглядит логичнее
PCIe особенно стоит рассматривать, когда accelerator cards используются относительно независимо и высокоскоростная all-to-all GPU fabric не является центральным требованием.
Например, несколько GPU могут обслуживать отдельные inference replicas.
В такой архитектуре важнее могут оказаться:
гибкая комплектация;
возможность использовать меньшее число GPU;
постепенное расширение;
обслуживание отдельных карт;
совместимость с разными accelerator SKU.
Но последнее ограничено OEM support.
То есть преимущество PCIe формулируется не как:
Можно поставить что угодно.
А как:
Когда SXM/HGX получает более сильный аргумент
SXM/HGX имеет смысл особенно внимательно рассматривать, когда несколько GPU должны работать как одна тесно связанная вычислительная подсистема.
Это возникает, например, когда:
одна большая модель распределена между GPU;
используется интенсивный tensor/model parallelism;
training job активно выполняет collective operations;
performance зависит от GPU-to-GPU communication;
нужен плотный 8-GPU scale-up node.
В HGX H100/H200 восемь GPU получают NVSwitch-based fabric с 900 GB/s GPU-to-GPU bandwidth.
Здесь ценность системы уже не в том, что GPU вставлена в SXM socket.
Ценность — в архитектуре всего accelerator subsystem.
Если одновременно важны производительность и обслуживание
Это не означает, что обязательно придётся жертвовать одним ради другого.
SXM-система может иметь продуманную замену отдельных GPU — Dell XE9680 это демонстрирует непосредственно в сервисной документации.
Но процедуру нужно проверить до покупки.
Если отказ одной GPU является критичным риском, запросите:
какая FRU меняется → что нужно разобрать → можно ли держать spare → какая процедура восстановления → что происходит с оставшимися GPU во время ремонта.
То же самое относится и к PCIe.
Отдельная карта выглядит модульнее, но отсутствие hot-swap означает остановку сервера. А отсутствие нужного spare SKU может сделать физическую простоту демонтажа почти неважной.
PCIe или SXM: что выбрать
Если GPU в основном выполняют независимые задачи, важна гибкость конфигурации и предполагается менять или постепенно добавлять accelerator cards в течение срока эксплуатации, PCIe обычно является логичным первым кандидатом.
Но только в границах поддержки конкретной серверной платформы. PCIe x16 сам по себе не гарантирует совместимость, power delivery, cooling или возможность установить нужное число карт.
Если несколько GPU должны работать как единая scale-up система и workload действительно чувствителен к GPU-to-GPU communication, SXM/HGX получает сильный архитектурный аргумент благодаря специализированной NVLink/NVSwitch fabric.
При этом SXM не означает автоматически плохой сервис: на некоторых платформах отдельная GPU штатно заменяется. И наоборот, PCIe не означает автоматическую простоту апгрейда.
Поэтому при выборе стоит ответить не на один вопрос:
PCIe или SXM?
А сразу на четыре:
Какая topology нужна workload?
Какие exact GPU поддерживает сервер?
Что можно заменить отдельно при отказе?
Какой upgrade path останется через несколько лет?
После этого форм-фактор перестаёт быть маркетинговой характеристикой и становится частью нормального инженерного решения.
Подобрать совместимую GPU-платформу
Для выбора сервера полезно определить рабочую нагрузку, точную модель и планируемое количество GPU, насколько интенсивно ускорители должны обмениваться данными, будет ли конфигурация расширяться и какие требования предъявляются к ремонту и будущей модернизации.
По этим параметрам уже можно сравнивать конкретные PCIe- и SXM/HGX-серверы: их GPU topology, поддерживаемые accelerator SKU, допустимое количество карт и service model.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


