Один успешный запрос к vLLM ещё не означает, что новый GPU-сервер полностью готов к production.
Для воспроизводимой проверки нужно знать:
какие GPU фактически установлены;
какой driver и accelerator backend используются;
получает ли container доступ к GPU;
какая версия vLLM действительно запущена;
какая revision модели загружена;
какую multi-GPU configuration использует engine;
проходит ли реальный inference request.
Поэтому первый запуск лучше оформлять как последовательность независимых проверок:
Первый неуспешный этап показывает, с какого слоя начинать диагностику.
Что именно доказывает первый запуск
Цель такого runbook узкая:
подтвердить, что согласованное hardware/software environment способно выполнить базовый end-to-end inference через vLLM.
Он не заменяет:
performance benchmark;
измерение TTFT и throughput;
поиск максимального concurrency;
длительный stability test;
HA/failover qualification;
production security hardening.
Это функциональная проверка окружения.
Шаг 1. Зафиксируйте Environment Manifest
До запуска запишите, что именно проверяется.
Поле | Значение |
Server/platform | |
GPU SKU × количество | |
OS | |
GPU driver | |
Backend | CUDA / ROCm |
Container runtime | |
vLLM image/version | |
Image digest, если используется | |
Model ID/path | |
Model revision | |
Tokenizer/code revision, если фиксируются отдельно | |
Served model name | |
Precision/quantization | |
Tensor parallel | |
Pipeline parallel | |
Startup config |
Главный принцип:
Если изменились driver, image, model revision или parallel configuration, проверку нужно считать новой.
Почему latest неудобен для приёмки
Rolling tag удобен для быстрого знакомства с продуктом, но хуже подходит для повторяемого acceptance.
Через некоторое время под тем же tag может находиться другой build.
Для воспроизводимого теста полезно фиксировать:
конкретную version/tag;
при необходимости image digest.
Это не означает, что latest нельзя использовать. Просто результат такого запуска сложнее точно воспроизвести позже.
Шаг 2. Проверьте GPU на host
Первый технический gate:
операционная система и driver видят ожидаемые accelerators.
NVIDIA
Базовая проверка:
nvidia-smi
Сопоставьте:
количество GPU;
модели;
driver;
ожидаемый hardware inventory.
AMD ROCm
Используется соответствующий ROCm tooling, например:
amd-smi list
или rocminfo.
PASS означает только:
GPU доступны на host.
Это ещё не подтверждает container runtime и работу vLLM.
Не путайте CUDA Version в nvidia-smi с установленным Toolkit
Поле CUDA Version в nvidia-smi показывает уровень CUDA compatibility, который поддерживает установленный driver.
Оно не обязано совпадать с версией CUDA Toolkit, установленной в host environment или внутри container.
Поэтому при диагностике compatibility нужно смотреть на фактическую комбинацию:
driver → container/runtime → application build.
Шаг 3. Отдельно проверьте GPU внутри container
Это самостоятельный PASS-гейт.
Ситуация:
GPU видна через nvidia-smi на host
не доказывает:
GPU доступна внутри Docker container.
Для NVIDIA полезно сначала выполнить независимый runtime canary — простую container-проверку GPU без vLLM и target model.
Смысл теста:
запустить известный простой container;
передать ему GPU;
убедиться, что внутри виден ожидаемый accelerator inventory.
Если этот тест не проходит, пока нет смысла разбирать:
vLLM;
model configuration;
quantization.
Начинать нужно с:
container runtime;
NVIDIA Container Toolkit;
permissions;
device mapping.
Главная граница:
Почему runtime canary лучше проверки сразу на vLLM image
Если сразу использовать target application image, появляются дополнительные возможные причины ошибки:
entrypoint;
image dependencies;
backend compatibility;
отсутствующая utility внутри image.
Runtime canary отвечает на более простой вопрос:
container infrastructure вообще получает GPU?
И только после него проверяется vLLM environment.
Для ROCm используется отдельный container path
CUDA и ROCm не следует смешивать в один универсальный launch command.
В ROCm environment container должен получать необходимые accelerator devices, включая соответствующие /dev/kfd и /dev/dri resources.
Конкретные render devices зависят от системы, поэтому не стоит фиксировать один номер вроде renderD128 как универсальный.
Правильная логика та же:
Host ROCm PASS → Container ROCm PASS → vLLM ROCm environment.
Шаг 4. Запустите именно согласованный vLLM environment
После проверки container infrastructure начинается application layer.
Здесь есть два разных сценария.
Вариант 1. vLLM уже установлен в environment
Canonical CLI выглядит так:
vllm serve <MODEL_ID>
При необходимости добавляются согласованные параметры:
revision;
quantization;
tensor parallel;
другие обязательные settings.
Вариант 2. Используется официальный vLLM container
В этом случае запускается зафиксированный официальный image, например ветка:
vllm/vllm-openai
для CUDA или соответствующий ROCm image для AMD.
Server arguments передаются способом, предусмотренным выбранным image/version.
Для acceptance важно не запомнить одну универсальную Docker-команду, а сохранить:
exact image;
exact version;
actual startup arguments.
Синтаксис контейнерного запуска чувствителен к версии, поэтому в рабочем протоколе нужно ориентироваться на документацию именно зафиксированного build.
Шаг 5. Проверьте Target Model
Рабочая GPU ещё не означает, что нужная модель поддерживается выбранным vLLM environment.
Отдельно могут влиять:
model architecture;
model revision;
tokenizer;
quantization;
доступ к repository;
authentication;
memory fit;
model-specific code.
Поэтому:
GPU PASS ≠ Target Model PASS.
Фиксируйте model revision
Для воспроизводимой проверки одного model ID недостаточно.
Сильнее:
Если tokenizer или remote code имеют отдельные revisions и это важно для проекта, сохраните их тоже.
Ошибка загрузки модели — не обязательно проблема GPU
Например, причиной могут быть:
отсутствие доступа к repository;
неправильный token;
unsupported architecture;
incompatible quantization;
нехватка памяти.
Поэтому после Model FAIL не следует сразу менять driver или container runtime, если нижние gates уже прошли.
Не используйте trust_remote_code как универсальный fix
Если target model требует remote model code, это должно быть осознанной частью согласованного environment.
Не стоит при любой ошибке загрузки автоматически включать соответствующий режим доверия remote code.
Это меняет security boundary и не является универсальным способом исправления compatibility.
Шаг 6. Зафиксируйте multi-GPU configuration
Если serving использует несколько GPU, в manifest нужно сохранить:
tensor parallel size;
pipeline parallel size, если применяется.
Количество физических GPU само по себе не определяет правильную схему parallelism.
Например:
восемь GPU в сервере
не означает автоматически:
TP должен быть равен восьми.
Для приёмки важно другое:
проверена именно та configuration, которая согласована для проекта.
Шаг 7. Проверьте health
После запуска server выполните health check.
Например:
curl http://127.0.0.1:8000/health
Это отдельный server-health gate.
В обычном engine-backed deployment такой endpoint позволяет проверить состояние engine/server.
Но:
Health PASS ≠ Request PASS.
Успешный health check ещё не означает, что нужная модель корректно обслуживает реальный запрос.
Шаг 8. Зафиксируйте фактическую версию vLLM
Проверка:
curl http://127.0.0.1:8000/version
Сохраните фактически работающую версию в Acceptance Card.
Это позволяет обнаружить расхождение:
ожидался один build, но реально запущен другой.
Шаг 9. Проверьте model identity
Получите список served models:
curl http://127.0.0.1:8000/v1/models
Проверьте, что в API присутствует ожидаемая модель.
Это отдельный gate:
Model Listing PASS.
Он всё ещё не заменяет реальный inference request.
Source model и API name могут различаться
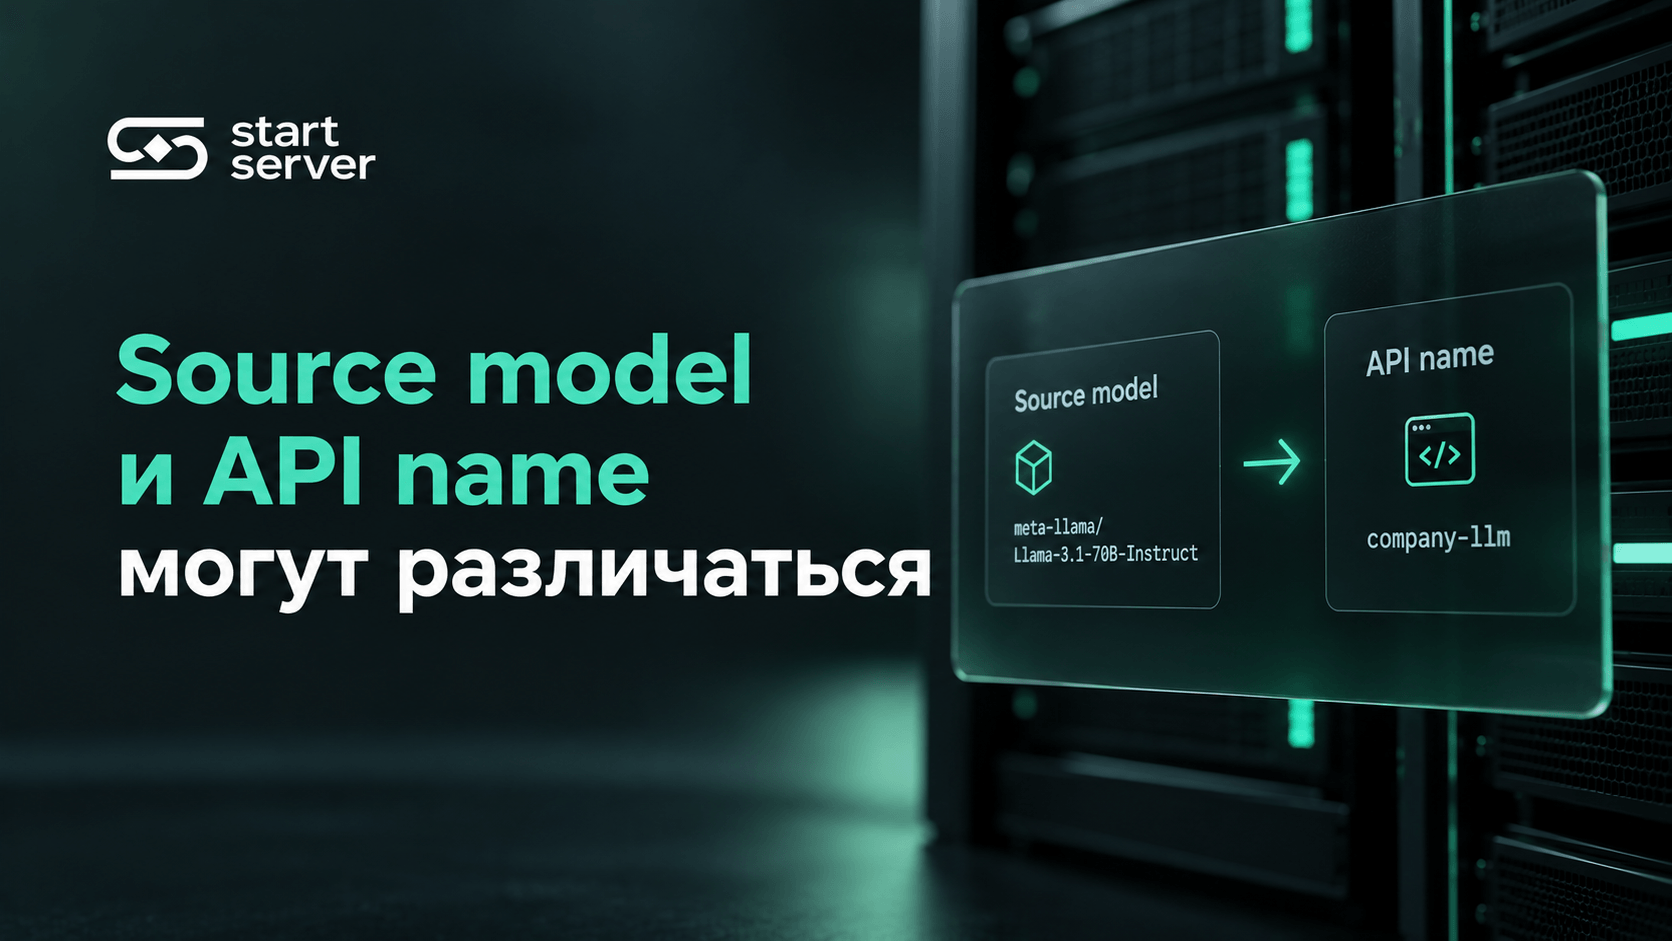
vLLM позволяет задать отдельный served model name.
Поэтому полезно хранить два значения:
Source model
Откуда загружаются weights/config.
Served model name
Как модель называется для API client.
Если они различаются, контрольный request должен использовать именно ожидаемый API name.
Шаг 10. Выполните реальный control request
Теперь можно проверить полный inference path.
Для chat-compatible модели пример может выглядеть так:
curl http://127.0.0.1:8000/v1/chat/completions \
-H "Content-Type: application/json" \
-d '{
"model": "<SERVED_MODEL_NAME>",
"messages": [
{"role": "user", "content": "Ответь одним словом: тест"}
],
"max_tokens": 8
}'
Это именно пример структуры smoke request.
Для acceptance конкретный endpoint должен соответствовать типу target model и application.
PASS означает:
request принят;
inference выполнен;
корректный response вернулся клиенту.
Chat Completions подходит не каждой модели
Не каждая text-generation model имеет подходящую chat semantics/template.
Поэтому /v1/chat/completions нельзя считать универсальным smoke endpoint.
Для другой модели может использоваться другой поддерживаемый API path.
Главный принцип:
контрольный request должен соответствовать реальному model interface.
Шаг 11. Streaming проверяйте отдельно
Если production application использует streaming, non-streaming request недостаточен.
Добавьте отдельный gate:
Streaming PASS.
Проверьте:
stream открывается;
chunks поступают;
generation завершается корректно.
Если streaming в проекте не используется:
N/A.
Отдельно:
Non-streaming PASS ≠ Streaming PASS.
Шаг 12. Проверьте минимальную observability
Для первого запуска достаточно убедиться, что можно получить:
startup logs;
runtime errors;
metrics, если они входят в требования.
Не используйте startup estimates как benchmark
Во время запуска inference engine может сообщать:
параметры KV cache;
estimated concurrency;
effective configuration.
Эта информация полезна для диагностики.
Но она не доказывает:
сервер выдерживает столько же production requests при реальном request mix.
Такой вывод требует отдельного нагрузочного теста.
Что делать при первом FAIL
Главная ошибка — сразу менять несколько вещей:
driver;
container image;
model;
quantization;
parallelism.
Так исходная причина быстро теряется.
Сначала сохраните:
Поле | Значение |
Failed gate | |
Expected result | |
Actual result | |
Command/request | |
Error/log excerpt | |
Environment Manifest | |
Timestamp |
После этого диагностируйте первый failed layer.
Диагностическая матрица
Симптом | С какого слоя начинать проверку |
GPU не видна на host | hardware / driver |
GPU inventory отличается | device / driver / inventory |
Host видит GPU, container нет | container runtime / device access |
Runtime canary PASS, vLLM image не стартует | image / backend / dependencies |
vLLM стартует, target model не загружается | model / revision / auth / memory |
Model загрузилась, health не проходит | server / engine |
Health PASS, model нет в /v1/models | serving configuration |
Model опубликована, request падает | API / model / request parameters |
Chat endpoint падает | model / chat-template compatibility |
Non-streaming PASS, streaming FAIL | streaming/client path |
Всё функционально PASS, latency не устраивает | performance benchmark |
Это не таблица гарантированных root causes.
Она показывает:
Runtime Canary и Target Model отвечают на разные вопросы
Иногда полезно использовать два уровня model test.
Runtime Canary
Небольшая заведомо совместимая модель.
Она отвечает:
base runtime path работает?
Target Model
Модель и revision из требований проекта.
Она отвечает:
работает ли именно production environment?
Поэтому:
Runtime Canary PASS ≠ Target Model PASS.
Canary особенно полезна, если target model:
большая;
закрытая;
требует отдельного доступа;
использует дополнительные model-specific features.
vLLM First-Run Acceptance Card
Environment Manifest
Поле | Значение |
Server/platform | |
GPU SKU × quantity | |
OS | |
Driver | |
Backend | CUDA / ROCm |
Container runtime | |
vLLM image/version | |
Image digest | |
vLLM runtime version | |
Model ID | |
Model revision | |
Tokenizer/code revision | |
Served model name | |
Precision/quantization | |
Tensor parallel | |
Pipeline parallel | |
Startup config |
Acceptance Gates
ID | Gate | Result |
ENV-01 | Manifest recorded | PASS / FAIL |
GPU-01 | Host GPU | PASS / FAIL |
CT-01 | Container runtime canary | PASS / FAIL |
VLLM-01 | Target vLLM environment | PASS / FAIL |
MODEL-01 | Target model | PASS / FAIL |
API-01 | Health | PASS / FAIL |
ID-01 | Version | PASS / FAIL |
ID-02 | Served model identity | PASS / FAIL |
REQ-01 | Control inference | PASS / FAIL |
STR-01 | Streaming | PASS / FAIL / N/A |
OBS-01 | Logs/metrics | PASS / FAIL / N/A |
REC-01 | Results stored | PASS / FAIL |
Failure Record
Поле | Значение |
Failed gate | |
Expected | |
Actual | |
Command/request | |
Error excerpt | |
Environment Manifest | |
Next diagnostic layer |
Когда первый запуск можно считать успешно пройденным
Manifest PASS
Зафиксировано, что именно тестировалось.
Host GPU PASS
Host видит ожидаемые accelerators.
Container Runtime PASS
Container infrastructure получает доступ к ним.
vLLM Environment PASS
Согласованный application image/build запускается.
Target Model PASS
Нужная model/revision загружается.
Health PASS
Server проходит свой health gate.
Identity PASS
Version и served model соответствуют ожиданиям.
Request PASS
Контрольный inference завершается.
Streaming PASS
Только если streaming требуется приложению.
Record PASS
Результат сохранён и может быть повторён.
Что полный PASS не доказывает
Даже полностью зелёная Acceptance Card не означает:
GPU-сервер полностью квалифицирован для production.
First-run runbook не измеряет автоматически:
production throughput;
p95 TTFT;
p95 inter-token latency;
maximum sustainable concurrency;
long-context performance;
многочасовую стабильность;
overload behaviour;
failover;
security hardening.
Это отдельные виды qualification.
API key не равен production security
Встроенная authentication vLLM может защищать часть API, но не должна восприниматься как полная security architecture всего HTTP service.
Production environment может дополнительно требовать:
network isolation;
reverse proxy;
TLS;
access control;
защиту operational endpoints.
Поэтому первый запуск лучше выполнять в контролируемой среде.
Какие результаты сохранить
После успешного теста полезно оставить:
Environment Manifest;
startup configuration;
vLLM version;
image tag/digest;
model revision;
served model name;
PASS/FAIL matrix;
relevant logs;
дату проверки.
После изменения:
driver;
image;
model revision;
hardware;
parallel configuration
тот же runbook можно выполнить повторно.
В этом и состоит его практическая ценность.
Какие данные передать при подборе GPU-сервера
Если платформа ещё только выбирается, для согласования окружения полезно подготовить:
Блок | Данные |
Model | ID/version/revision |
Workload | Inference profile |
Precision | Required mode |
Context | Требуемый диапазон |
Concurrency | Целевой профиль |
Serving stack | vLLM/version constraints |
Backend | CUDA / ROCm |
Multi-GPU | Требуемая configuration, если известна |
Container | Runtime requirements |
Acceptance | Какая target model должна пройти first-run test |
Главное
Первый запуск vLLM на новом GPU-сервере — это не одна Docker-команда и не один curl.
Сначала фиксируется:
Environment Manifest.
После этого последовательно проверяются:
Host GPU
→ Container Runtime
→ Target vLLM Environment
→ Target Model
→ Health
→ Version / Model Identity
→ Control Request
→ Streaming, если требуется
→ Acceptance Record.
При этом:
Host GPU PASS ≠ Container Runtime PASS.
Container Runtime PASS ≠ vLLM Environment PASS.
GPU PASS ≠ Target Model PASS.
Health PASS ≠ Request PASS.
Model Listing PASS ≠ Request PASS.
Non-streaming PASS ≠ Streaming PASS.
Metrics PASS ≠ Performance PASS.
Runtime Canary PASS ≠ Target Model PASS.
First-run PASS ≠ Production Readiness.
Полный PASS означает ровно одно:
зафиксированное hardware/software environment функционально способно выполнить согласованный inference path через vLLM.
Для первого воспроизводимого запуска это и есть правильный критерий.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


