GPU-сервер можно правильно подобрать по процессорам, ускорителям и памяти — и всё равно не суметь установить его на площадке без переделки инфраструктуры.
Свободных U в стойке недостаточно. До поставки нужно проверить физическую глубину и массу системы, rails, PDU, электрические цепи, схему резервирования, тепловую нагрузку, airflow или liquid cooling, сервисный доступ и маршрут доставки.
Поэтому подготовку стоит начинать не с вопроса:
«Есть ли в стойке место?»
а с другого:
Какие требования предъявляет конкретная конфигурация сервера и способна ли конкретная площадка их выполнить?
Рабочая последовательность:
Exact Server SKU → Manufacturer Requirements → Site Measurements → PASS / UNKNOWN / BLOCKER → Resolve Gaps → Placement Approval.
Главный принцип:
Сначала зафиксируйте точную конфигурацию сервера
Формулировок вроде:
«8× H100»;
«сервер на восемь GPU»;
«10-киловаттный AI-сервер»
для подготовки площадки недостаточно.
Нужны:
производитель и точная модель;
SKU или исполнение;
GPU configuration;
CPU и память;
установленные сетевые адаптеры;
конфигурация PSU;
тип охлаждения;
количество поставляемых узлов.
Даже системы одного класса могут существенно различаться.
Например, NVIDIA DGX H100 — это 8U-система глубиной до 897,1 мм, массой до 130,45 кг и с максимальной заявленной мощностью 10,2 кВт. Система содержит шесть PSU по 3,3 кВт.
У DGX B200 уже 10U, масса до 142,4 кг, максимальная мощность 14,3 кВт и шесть PSU по 3,3 кВт.
Dell для PowerEdge XE9680 отдельно предупреждает о потреблении 12,5 кВт, увеличенной длине корпуса и требовании 1200 CFM rack outlet airflow на систему.
А rack-scale система NVIDIA DGX GB — уже другой класс инфраструктуры: производитель указывает приблизительно 120 кВт на rack и использует power shelves, bus bar и liquid cooling infrastructure.
Поэтому требования нельзя переносить с одного GPU-сервера на другой только потому, что в них установлены ускорители одного поколения.
Где брать требования к GPU-серверу
Основной источник — документация производителя именно для выбранной платформы и исполнения.
Ищите:
Installation Guide;
Site Planning Guide;
User Guide;
Technical Guide;
Rack Installation Instructions;
Power and Cooling Guide.
Для Site Survey нужно выписать как минимум:
Параметр | Что проверить |
Form factor | количество U |
Dimensions | ширина, высота, глубина |
Rails | допустимый диапазон установки |
Weight | масса сервера |
Rack requirements | требования к шкафу |
Power | напряжение и максимальная/проектная нагрузка |
PSU | количество, номинал и documented redundancy |
Connections | силовые connectors |
Cooling | air или liquid |
Heat load | расчётная тепловая нагрузка |
Airflow | опубликованное vendor requirement |
Environment | допустимые inlet conditions |
Service | front/rear clearance |
GPU Server Site Survey: PASS, UNKNOWN или BLOCKER
Для каждого критического параметра удобно использовать три статуса.
PASS
Требование сервера известно.
Параметр площадки подтверждён.
Совместимость доказана.
UNKNOWN
Не хватает данных.
Например:
неизвестна текущая загрузка PDU;
нет схемы электропитания;
не измерена полезная глубина стойки;
неизвестен exact SKU;
нет данных по cooling capacity.
UNKNOWN нельзя считать успешной проверкой.
BLOCKER
Подтверждено несовпадение.
Например:
недостаточно глубины;
rails несовместимы;
превышена допустимая масса;
нет требуемого connector;
недостаточна электрическая мощность;
нельзя обеспечить нужный airflow;
liquid-cooled система выбрана для площадки без необходимой жидкостной инфраструктуры.
Главное правило:
GPU Server Site Survey Worksheet
До заказа или отгрузки оборудования можно заполнить такую таблицу.
Проверка | Требование сервера | Факт площадки | Evidence | Статус |
Rack units | datasheet / осмотр | PASS / UNKNOWN / BLOCKER | ||
Chassis depth | измерение | |||
Rail compatibility | installation guide | |||
System weight | datasheet | |||
Remaining rack load | паспорт стойки | |||
Floor / point load | проект площадки | |||
Rear clearance | измерение | |||
Service clearance | осмотр | |||
Input voltage | электрическая схема | |||
System power requirement | vendor guide | |||
Power connectors | vendor guide / PDU | |||
PDU outlets | осмотр | |||
Circuit capacity | electrical design | |||
Current circuit/PDU load | измерение | |||
Power redundancy | схема | |||
Cooling capacity | проект HVAC | |||
Required airflow | vendor guide | |||
Airflow direction | vendor guide | |||
Inlet conditions | измерение | |||
Cooling type | air / liquid | документация | ||
CDU / facility water | если применимо | |||
Delivery route | осмотр | |||
Lifting equipment | осмотр | |||
Network interfaces | спецификация | |||
Cable route | проект |
Самая важная колонка — Evidence.
PASS должен означать:
требование подтверждено документацией, а параметр площадки — документом, схемой или измерением.
Не:
«должно поместиться».
Шаг 1. Проверьте физическое размещение
Свободные rack units подтверждают только высоту оборудования.
Они не говорят ничего о:
глубине;
rail compatibility;
PDU;
кабелях;
массе;
сервисном доступе.
Поэтому:
Глубина сервера — не требуемая глубина стойки
Если chassis имеет глубину 900 мм, это не означает автоматически, что шкаф глубиной 1000 мм подходит.
За сервером остаются:
PSU;
locking power cords;
сетевые кабели;
transceivers;
cable-management elements;
вертикальные rPDU;
пространство для обслуживания.
Для DGX SuperPOD NVIDIA рекомендует шкафы глубиной 1200 мм именно с учётом cable management, rPDU, airflow и service clearance.
Поэтому проверять нужно реальную рабочую геометрию:
Front rails → Chassis → Rear connections → Cables/PDU → Rear door.
Главный принцип:
Chassis Depth ≠ Required Rack Depth.
Проверьте rails отдельно
19-дюймовая стойка сама по себе не гарантирует, что rail kit конкретного сервера подойдёт.
Нужно проверить:
расстояние между front и rear mounting posts;
тип mounting holes;
допустимый extension range rails;
требования к установке производителя.
Vertical PDU может мешать установке
0U rPDU экономит U, но занимает пространство за оборудованием.
Он может конфликтовать с:
корпусом сервера;
rail kit;
PSU;
силовыми кабелями;
трансиверами;
service access.
NVIDIA отдельно требует учитывать rPDU placement и заднее пространство шкафа при проектировании DGX-инфраструктуры.
Поэтому проверяется не только модель rack, но и его фактическая внутренняя компоновка.
Шаг 2. Проверьте массу сервера и стойки
Высокоплотный GPU-сервер может весить значительно больше обычного 1U/2U оборудования.
DGX H100 имеет максимальную массу 130,45 кг.
DGX B200 — до 142,4 кг.
Возникают сразу три отдельные проверки.
Rack load
Выдерживает ли шкаф общую массу оборудования после установки нового сервера?
Floor load
Выдерживает ли пол, raised floor или slab итоговую нагрузку?
Это не то же самое, что грузоподъёмность самой стойки.
Installation method
Можно ли физически поднять сервер на нужную высоту?
Для тяжёлых систем требуется планировать server lift или другое подходящее подъёмное оборудование. NVIDIA также рекомендует устанавливать тяжёлые серверы ближе к нижней части rack.
Практический вопрос:
Шаг 3. Проверьте весь маршрут доставки
Проблема с размещением может возникнуть ещё до машинного зала.
Пройдите весь маршрут:
Loading area → Doors → Corridor → Elevator → Raised floor/Ramp → Row → Rack → Mounting position.
Проверяются:
дверные проёмы;
повороты;
грузоподъёмность лифта;
ограничения пола;
пандусы и пороги;
место распаковки;
staging area;
возможность использовать подъёмное оборудование.
Для крупных GPU-систем нужно учитывать размеры и массу не только самого сервера, но и транспортировочной упаковки.
Шаг 4. Определите реальное требование по электропитанию
Нельзя рассчитывать площадку по формуле:
GPU TDP × количество GPU.
Она не учитывает:
CPU;
память;
NIC;
накопители;
вентиляторы;
преобразование питания;
другие компоненты системы.
PSU rating не равен потреблению сервера
Ещё одна ошибка:
«6 PSU × 3,3 кВт = сервер потребляет 19,8 кВт».
Нет.
Номиналы блоков питания связаны не только с потреблением, но и с:
распределением нагрузки;
peak capacity;
redundancy;
поведением при отказах.
Например, DGX H100 имеет шесть PSU по 3,3 кВт, но максимальная мощность самой системы указана как 10,2 кВт.
DGX B200 также использует шесть PSU по 3,3 кВт при максимальной мощности системы 14,3 кВт.
Следовательно:
Σ PSU Ratings ≠ System Power Consumption.
Проверяйте всю power path
Свободный outlet в PDU ещё не означает, что мощности достаточно.
Нужно проверить всю цепочку:
Facility source
→ UPS / Distribution
→ Circuit / Breaker
→ Rack PDU
→ Outlet
→ Power cord
→ PSU
→ GPU server
Для каждого уровня фиксируются:
voltage;
capacity;
connector;
текущая нагрузка;
redundancy source.
Свободный outlet не означает свободную мощность
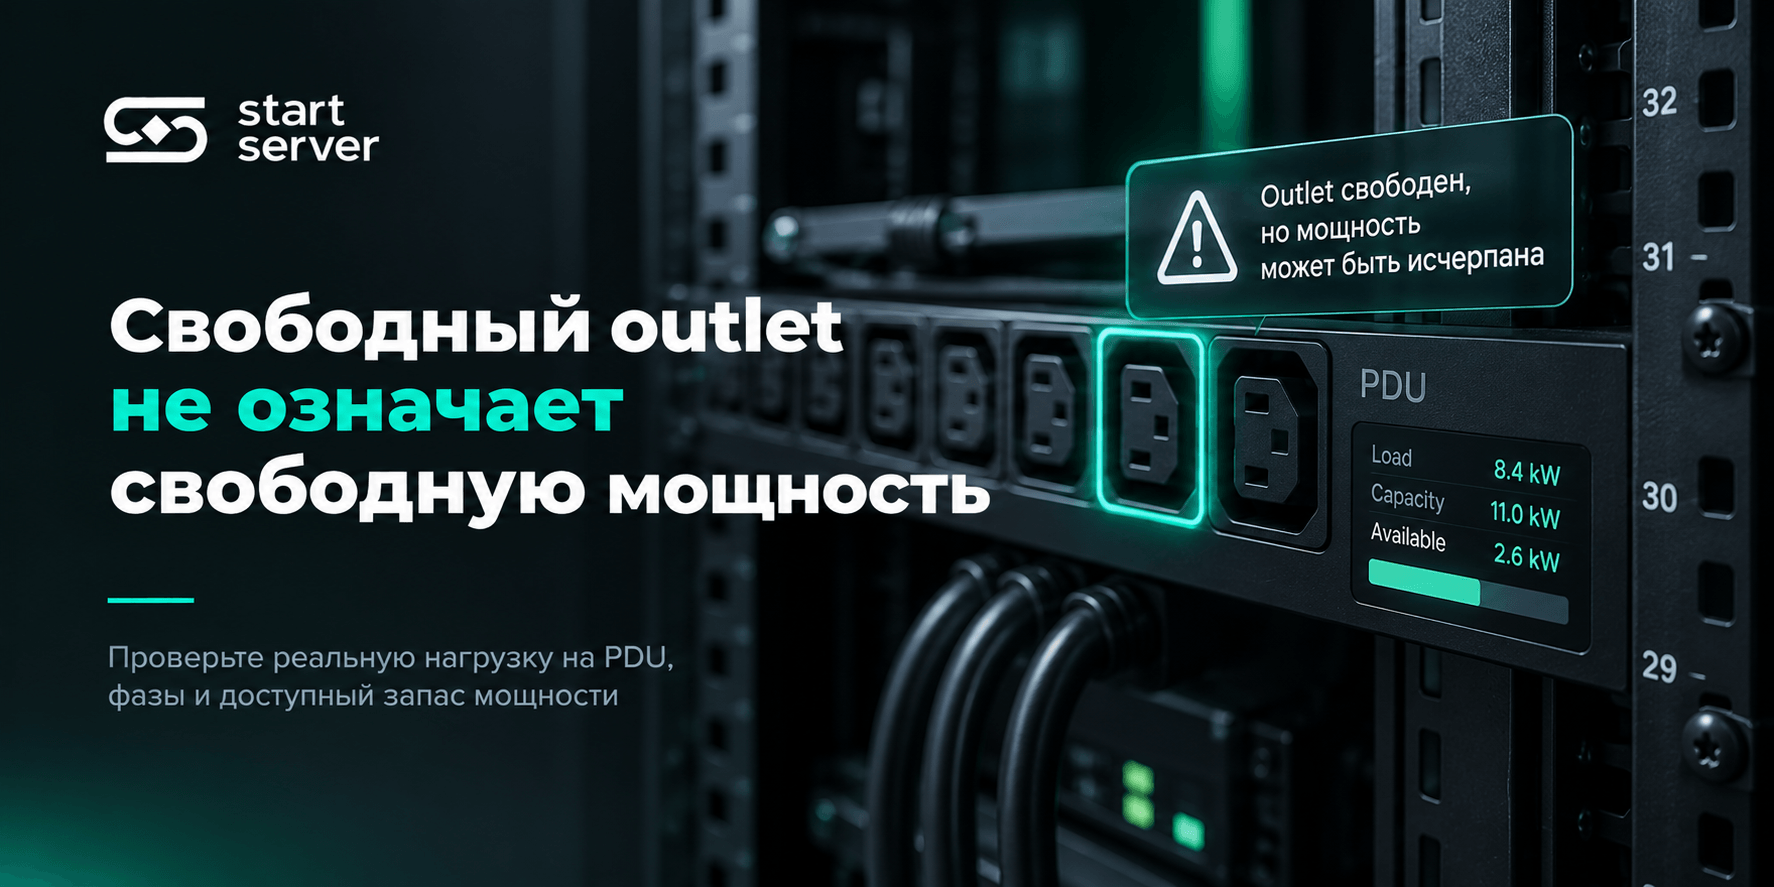
В PDU могут оставаться физически свободные разъёмы, хотя circuit уже близок к проектному пределу.
Поэтому нужно знать:
модель PDU;
параметры входа;
допустимую нагрузку;
используемые outlets;
текущую нагрузку;
upstream circuit.
Правило:
Проверяйте power redundancy отдельно от количества PSU
Есть два разных уровня:
Redundancy внутри сервера
Как ведут себя его PSU при отказе?
Например, актуальный DGX H100/H200 User Guide описывает шесть PSU в конфигурации 4+2. При потере питания на трёх PSU система способна продолжить работу с уменьшенной производительностью; нормальное system-level поведение определяется документацией производителя.
Redundancy площадки
Как питаются эти PSU через:
rPDU;
circuits;
UPS;
upstream distribution?
Для DGX H100 SuperPOD NVIDIA использует более строгий facility-design подход: несколько независимых power sources должны обеспечивать требуемое число активных PSU после отказа одного пути.
Это не противоречие.
Это два разных вопроса:
Что технически способен пережить сервер?
и
Какой режим отказа должна гарантировать площадка?
Не следует использовать degraded-operation capability сервера как целевой режим проектирования инфраструктуры.
Не используйте универсальный процент запаса
Фразы вроде:
«всегда оставляйте 20%»
или:
«PDU всегда можно загружать максимум на 80%»
не являются универсальными правилами для любой площадки.
Допустимая нагрузка зависит от:
схемы;
voltage;
circuit rating;
характера нагрузки;
оборудования;
applicable electrical requirements;
внутренних стандартов ЦОДа.
Шаг 5. Оцените тепловую нагрузку
Для первичного Site Survey electrical power IT-оборудования можно использовать как приблизительную основу sensible heat load внутри машинного зала.
Для пересчёта:
1 W ≈ 3,412 BTU/h.
Например:
10 000 W × 3,412 ≈ 34 120 BTU/h.
Это именно conversion для предварительной оценки, а не самостоятельный проект HVAC.
У DGX H100 максимальная мощность 10,2 кВт, поэтому порядок величины peak heat load составляет около 34,8 тыс. BTU/h.
Cooling capacity и airflow — разные проверки
Предположим, система охлаждения способна удалить 10 кВт тепла.
Это ещё не доказывает, что конкретный 10-киловаттный GPU-сервер будет нормально охлаждаться.
Нужно одновременно доставить требуемый поток холодного воздуха на intake и удалить горячий exhaust.
То есть:
Cooling Capacity PASS ≠ Airflow PASS.
Площадка может иметь достаточную суммарную холодопроизводительность и при этом страдать от:
недостаточного rack airflow;
recirculation;
hotspots;
плохого containment;
неправильного распределения холодного воздуха.
Используйте airflow производителя
Не следует придумывать универсальное правило:
«на один киловатт GPU-серверу требуется X CFM».
Airflow зависит от конструкции конкретного оборудования.
Если производитель публикует собственное значение, Site Survey должен использовать его в той же формулировке и точке измерения.
Например, Dell указывает для PowerEdge XE9680 Rack Outlet Air Flow: 1200 CFM/Unit.
Это не следует автоматически переписывать как:
«серверу всегда требуется 1200 CFM на intake».
Нужно сохранять условия vendor specification.
Проверяйте температуру на входе сервера
Показание:
«в серверной 22 °C»
недостаточно.
Сервер работает с воздухом непосредственно на intake.
На одной площадке температура может различаться между:
room sensor;
cold aisle;
нижней частью rack;
верхней частью rack;
конкретным server inlet.
Причины:
recirculation;
недостаточный airflow;
соседнее оборудование;
плохой containment;
отсутствие blanking panels;
неправильная ориентация airflow.
NVIDIA в design guide DGX SuperPOD предусматривает температурные sensors непосредственно у передней части rack на разных высотах.
Поэтому:
Проверьте направление воздуха через стойку
Для типичной air-cooled платформы:
Cold aisle
→ Server inlet
→ Chassis
→ Hot exhaust
→ Hot aisle
→ Heat removal
Нужно исключить:
возврат exhaust на intake;
оборудование с конфликтующим направлением airflow;
препятствия перед intake;
кабельные жгуты, мешающие exhaust;
нештатные rack doors.
Проверяется весь air path, а не только мощность кондиционирования.
Air cooling и liquid cooling — разные ветки Site Survey
Для air-cooled платформы основными параметрами будут:
heat load;
cooling capacity;
airflow;
inlet conditions;
exhaust;
rack layout.
Для liquid-cooled GPU-системы этого недостаточно.
Что проверить для liquid-cooled GPU-системы
В зависимости от exact platform могут потребоваться:
CDU;
facility water;
supply temperature;
return temperature;
flow;
pressure;
water quality requirements;
manifold connections;
redundancy;
leak detection;
остаточное air cooling.
Точные значения нельзя переносить между платформами.
Для DGX GB rack system NVIDIA описывает liquid cooling infrastructure, manifolds и многоуровневый leak detection; rack power consumption заявлен приблизительно на уровне 120 кВт.
Главный stop condition:
Нужен отдельный facility design.
И наоборот, нельзя вводить универсальный порог:
«после X кВт обязательно жидкостное охлаждение».
Решение определяется конкретной системой и возможностями площадки.
Шаг 6. Проверьте serviceability
Сервер может:
физически поместиться;
получить питание;
нормально охлаждаться;
и при этом оказаться практически необслуживаемым.
До установки нужно проверить доступ к:
PSU;
сетевым adapters;
transceivers;
management ports;
cables;
service panels;
заменяемым компонентам.
Ключевой вопрос:
Можно ли обслужить или демонтировать сервер без разборки соседней инфраструктуры?
Именно здесь часто обнаруживается, что формально достаточная глубина шкафа фактически недостаточна.
Шаг 7. Проверьте минимальную сетевую готовность
Полную архитектуру InfiniBand или Ethernet fabric в эту проверку включать не нужно.
Для Site Readiness достаточно подтвердить:
нужное количество switch ports;
media type;
transceivers;
management network;
количество кабелей;
физический cable route.
Placement Approval Gate
До поставки у каждого блока должен появиться формальный статус.
Блок | Статус |
Exact configuration | PASS / UNKNOWN / BLOCKER |
Rack fit | PASS / UNKNOWN / BLOCKER |
Rack/floor loading | PASS / UNKNOWN / BLOCKER |
Delivery route | PASS / UNKNOWN / BLOCKER |
Power capacity | PASS / UNKNOWN / BLOCKER |
Power connectors | PASS / UNKNOWN / BLOCKER |
Power redundancy | PASS / UNKNOWN / BLOCKER |
Cooling capacity | PASS / UNKNOWN / BLOCKER |
Airflow / liquid infrastructure | PASS / UNKNOWN / BLOCKER |
Inlet/environment | PASS / UNKNOWN / BLOCKER |
Serviceability | PASS / UNKNOWN / BLOCKER |
Network interfaces | PASS / UNKNOWN / BLOCKER |
Все критические пункты PASS
SITE READY
Площадка проверена для указанной конфигурации.
Есть UNKNOWN
SITE NOT VERIFIED
Сначала нужны данные или измерения.
Есть BLOCKER
REMEDIATION REQUIRED
До поставки нужно изменить инфраструктуру или конфигурацию оборудования.
Почему одного числа мощности недостаточно
Предположим, для выбранной платформы указана проектная максимальная мощность 10 кВт.
Первичная оценка:
Electrical load ≈ 10 kW
↓
Heat load ≈ 10 kW
↓
≈34 120 BTU/h
Но площадка ещё не получила статус PASS.
Остаются вопросы.
Power
какое напряжение требуется;
какие connectors;
сколько feeds;
какая реальная нагрузка PDU;
что произойдёт при отказе одного power path.
Cooling
какой airflow требуется;
получает ли сервер этот airflow;
какая inlet temperature;
куда уходит exhaust.
Mechanical
сколько нужно U;
подходят ли rails;
хватает ли рабочей глубины;
выдерживает ли rack массу;
не мешает ли PDU.
Поэтому:
Что нельзя определить по количеству GPU
Из информации:
«8× GPU»
нельзя универсально вычислить:
U;
chassis depth;
массу;
total system power;
число силовых подключений;
PDU requirement;
airflow;
rack requirement;
тип охлаждения.
Площадка подбирается под серверную платформу, а не только под ускорители внутри неё.
Не смешивайте installed и maximum configuration
Одна платформа может поддерживать несколько:
GPU configurations;
NIC;
накопителей;
PSU modes;
power limits.
Поэтому нужно отдельно понимать:
Что установлено сейчас
Фактическая поставляемая конфигурация.
Что максимально поддерживается платформой
Предел возможностей chassis.
Эти величины нельзя подменять друг другом.
Если проект предполагает будущий upgrade, максимальная configuration может быть полезна для capacity planning.
Но её характеристики нельзя выдавать за текущее потребление установленного сервера.
При увеличении числа GPU-серверов Site Survey нужно повторять
Площадка, которая выдерживает один GPU-сервер, не обязательно выдержит четыре.
При масштабировании меняются:
total rack power;
PDU load;
cooling density;
airflow;
масса;
кабельная инфраструктура.
Поэтому следующий сервер нельзя добавлять только на основании того, что первый работает нормально.
Нужно пересчитать итоговое состояние стойки.
Короткий pre-delivery checklist
Перед отгрузкой ответьте на семь вопросов.
1. Exact SKU подтверждён?
Не только модель GPU.
2. Сервер физически помещается?
U, rails, working depth, PDU, cables.
3. Rack и floor выдерживают его?
С учётом существующей нагрузки.
4. Power path подтверждён?
Circuit, PDU, connectors, normal и fault conditions.
5. Cooling path подтверждён?
Heat load плюс airflow либо liquid requirements.
6. Оборудование можно доставить и установить?
Route, staging, elevator, lift.
7. Оборудование можно обслуживать после монтажа?
Front/rear access и cable management.
Если на критический вопрос ответ:
«пока неизвестно»,
площадка ещё не прошла Site Survey.
Какие данные подготовить для согласования GPU-сервера
Чтобы проверить совместимость сервера и площадки до поставки, соберите следующие данные.
Сервер
exact model;
configuration;
количество узлов.
Стойка
производитель и модель;
свободные U;
расстояние между mounting posts;
полезная глубина;
PDU placement;
текущая загрузка;
допустимая масса;
фото front/rear.
Питание
voltage;
circuits;
breakers;
PDU models;
outlets;
текущая нагрузка;
UPS;
требуемая redundancy.
Охлаждение
тип системы охлаждения;
cooling capacity;
rack-density constraints;
inlet temperature;
hot/cold aisle layout.
Liquid cooling, если применяется
CDU;
facility water;
существующая distribution;
параметры контура относительно требований конкретной платформы.
Доставка
размеры дверей;
грузовой лифт;
маршрут;
ограничения пола;
lifting equipment.
Что делать, если найден BLOCKER
BLOCKER не обязательно означает, что сервер выбран неправильно.
Есть два основных пути.
Изменить инфраструктуру
Например:
заменить PDU;
добавить circuit;
использовать другую стойку;
перераспределить оборудование;
улучшить airflow;
подготовить liquid infrastructure.
Изменить конфигурацию
Если модернизация площадки слишком сложна, можно рассмотреть другую платформу или исполнение с совместимыми требованиями.
Это инженерное сравнение:
Решение принимается по требованиям проекта, стоимости, срокам и допустимым компромиссам.
Когда площадка действительно готова
Подготовка стойки к GPU-серверу — это не проверка одной цифры.
Нужно последовательно подтвердить:
Exact Server SKU
→ Mechanical Fit
→ Rack & Floor Load
→ Delivery
→ Power Path
→ Redundancy
→ Cooling Capacity
→ Airflow or Liquid Infrastructure
→ Inlet Conditions
→ Serviceability
→ Placement Approval.
Четыре правила особенно полезно сохранить:
Purchase Approved ≠ Site Ready.
Chassis Depth ≠ Required Rack Depth.
Cooling Capacity PASS ≠ Airflow PASS.
UNKNOWN ≠ PASS.
Площадка считается проверенной только тогда, когда требования конкретной серверной платформы сопоставлены с реальными параметрами стойки и инженерной инфраструктуры, а критические пункты получили подтверждённый PASS.
Если планируется поставка GPU-сервера или rack-scale AI-системы Start Server, перед заказом можно передать выбранную конфигурацию, данные стойки, питания и охлаждения для предварительного согласования требований к площадке.
CTA: Согласовать требования к площадке перед поставкой.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


