Для полного дообучения LLM недостаточно знать количество параметров модели. Во время обучения видеопамять расходуется не только на саму модель, но и на градиенты, работу оптимизатора, промежуточные результаты прямого и обратного проходов и временные данные отдельных операций. Поэтому модель может успешно загрузиться в GPU, а нехватка памяти появится уже на первом полном шаге обучения.
Если одной GPU недостаточно, задачу распределяют между несколькими ускорителями. Но, например, восемь GPU по 80 ГБ не образуют автоматически единый массив памяти на 640 ГБ: результат зависит от того, какие данные копируются на каждое устройство, а какие распределяются между ними.
Когда ресурсов одного сервера становится мало, в расчёт добавляется межсерверная сеть. А для долгого обучения необходимо ещё проверить, как быстро система способна сохранять и восстанавливать контрольные точки.
Поэтому инфраструктуру для Full Fine-Tuning разумно рассчитывать в таком порядке:
Почему размер модели — только начало расчёта
Параметры модели действительно занимают значительную часть GPU-памяти, но для полного дообучения это далеко не весь расход.
Что занимает память | Почему это нужно |
Параметры модели | непосредственно обучаемая модель |
Градиенты | используются для изменения параметров |
Состояния оптимизатора | нужны алгоритму обновления параметров |
Активации | сохраняются для обратного прохода |
Временные данные | создаются отдельными операциями во время вычислений |
В актуальной документации Transformers эти категории рассматриваются отдельно. Там же отмечается, что размер активаций зависит от пакета, длины последовательности, глубины и скрытой размерности модели, а кратковременный пик временных тензоров тоже способен вызвать OOM.
Из этого следует важный вывод: размер файла модели нельзя использовать как готовое требование к VRAM для полного обучения.
Сколько памяти нужно на один параметр
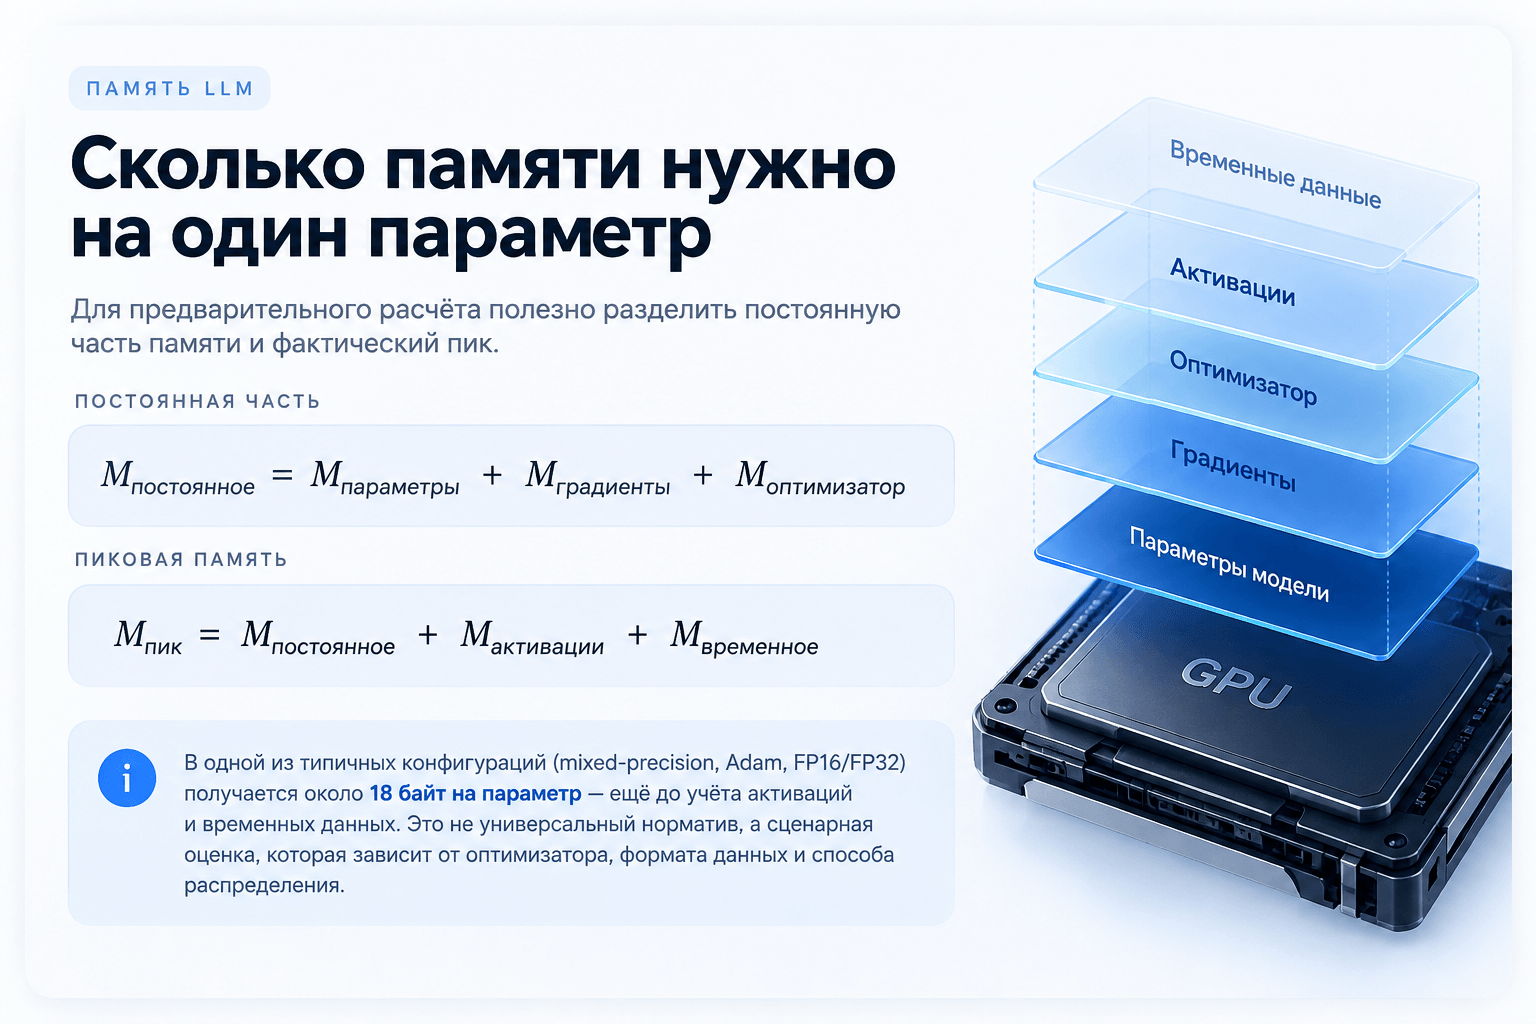
Для предварительного расчёта полезно разделить постоянную часть памяти и фактический пик.
Постоянную часть можно представить так:
Mпостоянное=Mпараметры+Mградиенты+MоптимизаторM_{\text{постоянное}} = M_{\text{параметры}} + M_{\text{градиенты}} + M_{\text{оптимизатор}}
А пиковую:
Mпик=Mпостоянное+Mактивации+MвременноеM_{\text{пик}} = M_{\text{постоянное}} + M_{\text{активации}} + M_{\text{временное}}
Иногда для быстрой оценки используют количество байт на параметр. Например, в описанной Transformers схеме mixed-precision обучения одновременно используются FP16- и FP32-представления параметров, FP32-градиенты и два FP32-состояния Adam. В такой конкретной конфигурации получается около 18 байт на параметр ещё до учёта активаций и временных данных.
Но правило:
«Full Fine-Tuning всегда требует 18 байт на параметр»
неверно.
Другой оптимизатор, формат данных, способ распределения или перенос части состояния в оперативную память изменят результат. Поэтому байты на параметр — это сценарная оценка для известной конфигурации, а не универсальный норматив для выбора сервера.
Почему одна и та же модель может требовать разный объём VRAM
На пиковую память существенно влияет сама нагрузка обучения.
Особенно важны:
длина последовательности;
пакет, одновременно обрабатываемый одной GPU;
способ сохранения активаций для обратного прохода;
реализация attention и используемые ядра.
Transformers прямо связывает объём активаций с размером пакета и длиной последовательности. Для обычного attention крупные промежуточные матрицы могут стать заметной статьёй памяти, тогда как современные реализации способны менять этот профиль.
Поэтому две команды могут обучать одну и ту же модель с одинаковым оптимизатором, но получить разный пик VRAM из-за разных последовательностей и пакетов.
Пакет на GPU и gradient accumulation — не одно и то же
Это важное различие для расчёта сервера.
Gradient accumulation позволяет выполнить несколько меньших пакетов последовательно, накопить градиенты и только после этого обновить параметры. Большой эффективный пакет поэтому не означает, что все входящие в него примеры одновременно находятся в памяти GPU.
Почему загрузки модели недостаточно для проверки
Успешная загрузка весов отвечает только на вопрос:
помещается ли базовое состояние модели?
Она не проверяет пик обучения.
После загрузки появляются активации прямого прохода, градиенты, состояния оптимизатора и временные выделения памяти. Именно поэтому Transformers отдельно предупреждает, что активации и кратковременные тензоры могут вызвать OOM, даже если сама модель уже помещается.
Для реальной проверки нужен как минимум полный шаг:
прямой проход → вычисление ошибки → обратный проход → шаг оптимизатора.
Измерять следует ту же конфигурацию, которую планируется использовать в работе: ту же модель, длину последовательности, пакет, оптимизатор и настройки экономии памяти.
Почему несколько GPU не превращаются в один большой объём памяти
Предположим, сервер оснащён восемью GPU по 80 ГБ.
Суммарно установлено 640 ГБ VRAM, но это не единое адресное пространство, в которое можно произвольно поместить обучение объёмом 600 ГБ.
Результат зависит от выбранного способа распределения:
часть данных может находиться на каждой GPU целиком;
часть может быть разделена между устройствами;
отдельные данные могут временно собираться обратно во время вычислений.
Поэтому для sizing важнее пиковая память на одной GPU в конкретной схеме распределения, а не только сумма паспортной VRAM всех ускорителей.
Когда DDP помогает, а когда нет
DDP — DistributedDataParallel — используется для параллельного обучения на нескольких процессах/GPU. Каждый процесс работает со своей репликой модели, а градиенты между репликами синхронизируются. PyTorch указывает, что DDP выполняет all-reduce для градиентов и предполагает одинаковое обновление параметров во всех процессах.
Практический вывод простой:
если необходимое состояние обучения не помещается на одну GPU, добавление GPU только через DDP само по себе проблему памяти не решает.
DDP особенно полезен, когда модель уже помещается на каждом ускорителе, а дополнительные GPU нужны для увеличения производительности.
Когда проблема именно в размере состояния модели, применяют шардирование.
Как FSDP и ZeRO уменьшают требования к памяти
FSDP2 распределяет между GPU параметры модели, градиенты и состояния оптимизатора. Перед вычислением необходимые параметры собираются, а затем могут снова распределяться. Это позволяет работать с моделями, которые не помещаются целиком на одну GPU, но увеличивает объём коммуникаций по сравнению с обычным DDP.
ZeRO использует похожую идею поэтапно. На первом уровне распределяются состояния оптимизатора, на втором дополнительно градиенты, на третьем — параметры модели.
Для выбора инфраструктуры достаточно следующей картины:
Подход | Что распределяется | Когда особенно полезен |
DDP | модель в основном реплицируется | модель уже помещается на одну GPU |
ZeRO-1 | состояния оптимизатора | нужно уменьшить память оптимизатора |
ZeRO-2 | оптимизатор и градиенты | нужна дополнительная экономия |
ZeRO-3 | также параметры модели | состояние слишком велико для репликации |
FSDP | параметры, градиенты и оптимизатор | требуется полное шардирование |
Почему шардирование нельзя считать простым делением памяти
Возникает соблазн взять расчёт для одной GPU и разделить его на число ускорителей.
Для FSDP такая арифметика недостаточна.
Перед вычислением каждый процесс получает необходимые параметры из других shards. Кроме того, настройка reshard_after_forward непосредственно меняет компромисс между памятью и коммуникациями: параметры можно снова распределить после прямого прохода для экономии VRAM либо оставить собранными до обратного прохода, увеличив пик памяти, но избежав повторного обмена.
Следовательно:
пиковая память при FSDP определяется не только числом GPU, но и тем, как модель разделена на блоки и когда данные собираются и снова распределяются.
То же общее ограничение относится к другим схемам шардирования: итоговый расход памяти нужно проверять на реальной конфигурации.
Почему экономия памяти увеличивает роль сети
Полное шардирование уменьшает количество данных, постоянно находящихся на каждой GPU, но необходимые для вычислений части приходится передавать между устройствами.
Получается компромисс:
Решение | Память на GPU | Обмен данными |
Больше состояния держится локально | выше | меньше |
Состояние распределяется агрессивнее | ниже | больше |
Hugging Face прямо отмечает для FSDP увеличение коммуникационной нагрузки относительно DDP и связывает параметр reshard_after_forward с выбором между меньшим потреблением памяти и меньшим числом повторных обменов.
Поэтому оптимизировать сервер только по минимальной VRAM на GPU неправильно.
Конфигурация должна одновременно:
помещаться в память;
обеспечивать приемлемое время шага обучения.
Когда достаточно одного сервера
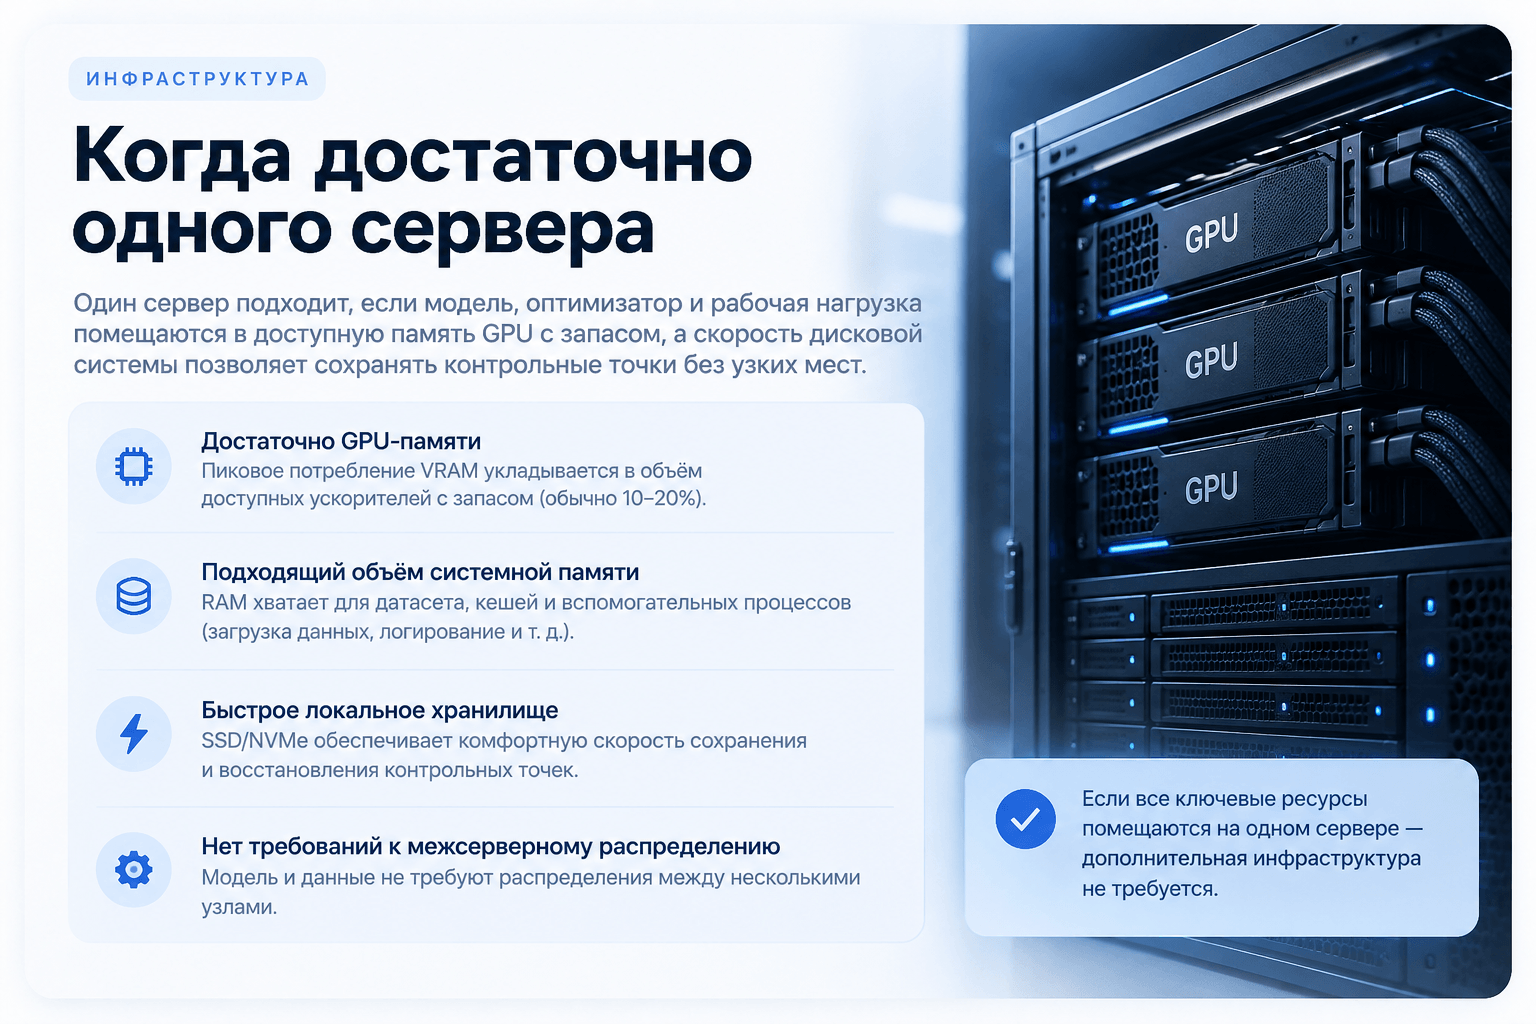
Нет универсального размера модели, после которого обязательно нужен кластер.
Один сервер остаётся кандидатом, пока выполняются два условия:
памяти достаточно — полный шаг обучения помещается при выбранной схеме распределения;
производительность достаточна — ожидаемое время эксперимента устраивает проект.
Если внутри сервера памяти недостаточно даже после допустимого шардирования, появляется техническая причина добавить вычислительные узлы.
Второй сценарий — память есть, но эксперимент слишком долгий. Тогда несколько серверов рассматриваются уже ради производительности.
Удобная последовательность решения:
Ситуация | Что проверять |
Шаг обучения помещается на одну GPU | измерить производительность одной GPU |
Одной GPU мало по памяти | проверить распределение внутри сервера |
На сервере всё помещается | измерить время шага |
Памяти сервера не хватает | рассматривать несколько серверов |
Сервер слишком медленный | проверить масштабирование на дополнительные GPU/узлы |
Добавление серверов даёт слабый прирост | анализировать межузловой обмен |
Сохранение состояния мешает работе | проверять RAM и хранилище |
Что происходит с сетью при переходе на несколько серверов
Когда обучение распределяется между физическими узлами, часть коммуникаций выходит за пределы внутрисерверных соединений GPU.
Требования к сети зависят от выбранного способа распределения. В DDP синхронизируются градиенты. При полном шардировании дополнительно возникает получение необходимых параметров и распределение результатов между процессами. FSDP поэтому требует больше коммуникаций, чем обычный DDP.
Отсюда следует важное правило:
скорость сети нельзя выбирать только по размеру LLM или числу серверов.
Сначала нужно определить схему распределения и измерить, какую долю шага занимают коммуникации. После этого уже рассчитывается необходимая пропускная способность.
Для подробного расчёта здесь уместна внутренняя ссылка с естественным анкором «как рассчитать скорость сети для распределённого обучения».
Почему контрольная точка может быть больше итоговой модели
У долгого обучения должна быть возможность продолжить работу после сбоя.
Для этого недостаточно просто сохранить итоговые параметры модели. Для полноценного возобновления могут потребоваться также состояния оптимизатора и другие данные процесса обучения.
При распределённой работе задача дополнительно усложняется тем, что состояние само может быть разделено между несколькими процессами.
PyTorch Distributed Checkpoint позволяет нескольким процессам параллельно сохранять и загружать распределённое состояние и поддерживает перераспределение при загрузке в другую топологию кластера. Он также создаёт несколько файлов — как минимум по одному на rank.
Поэтому:
размер файла итоговой модели нельзя автоматически использовать как размер контрольной точки для продолжения обучения.
Фактический объём нужно измерять на выбранном framework и формате сохранения.
Полная или распределённая контрольная точка
Для FSDP доступны разные варианты сохранения. Полный формат создаёт единое совместимое состояние модели, тогда как шардированный вариант сохраняет данные по процессам и может быть быстрее для крупных промежуточных контрольных точек.
Практически это позволяет разделить два сценария:
промежуточные сохранения — нужны прежде всего для быстрого восстановления training job;
финальный экспорт — нужен для дальнейшего использования модели вне текущей схемы распределения.
Они не обязаны иметь одинаковый формат.
Как рассчитать скорость записи контрольной точки
Пусть фактический размер контрольной точки равен S, а полностью сохранить её нужно не более чем за T.
Тогда минимальная средняя полезная скорость всей цепочки записи:
BWзаписи=STBW_{\text{записи}} = \frac{S}{T}
Например, контрольная точка размером 600 ГБ должна полностью сохраняться не более чем за 5 минут.
Пять минут — 300 секунд, поэтому:
600/300=2 ГБ/с600/300 = 2\ \text{ГБ/с}
Для такого сценария путь записи должен обеспечивать в среднем 2 ГБ/с полезной производительности.
Но это не означает, что накопитель с паспортной скоростью 2 ГБ/с автоматически выполнит требование. На фактический результат влияют формат checkpoint, параллельность записи, файловая система, сеть до хранилища и конкурирующая нагрузка.
Как выбрать частоту сохранений
Универсального правила вроде «делать checkpoint каждые 500 шагов» нет.
Полезнее начать с бизнес-вопроса:
сколько времени вычислений допустимо потерять при сбое?
Если проект готов потерять не более 30 минут работы, частота успешно завершённых контрольных точек должна обеспечивать этот предел.
Для оценки средней нагрузки на хранилище можно использовать:
BWсреднее=STинтервалBW_{\text{среднее}} = \frac{S} {T_{\text{интервал}}}
где S — размер одной контрольной точки, а Tинтервал — промежуток между сохранениями.
Этот показатель отличается от скорости отдельной записи. Например, checkpoint может записываться коротким интенсивным потоком, хотя средняя нагрузка за час значительно ниже.
Что даёт асинхронное сохранение
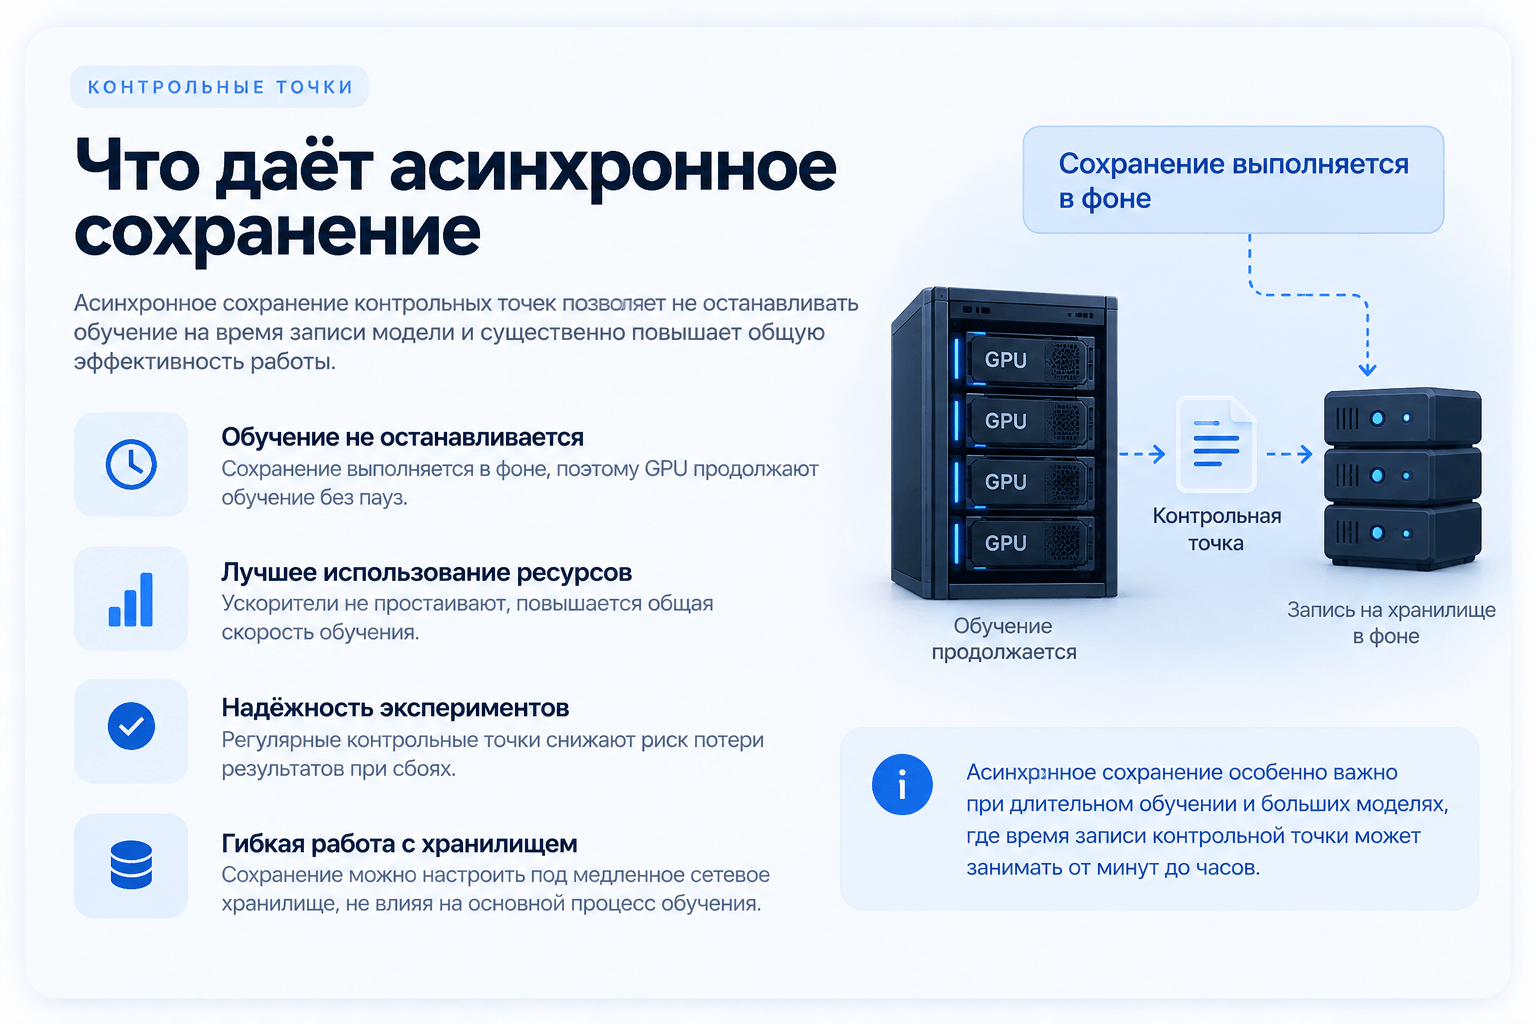
Синхронное сохранение способно приостанавливать полезные вычисления до завершения записи.
PyTorch Distributed Checkpoint поддерживает асинхронную модель. В зависимости от режима данные могут сначала быть подготовлены в оперативной памяти, после чего дальнейшая запись выполняется параллельно с обучением. В актуальном PyTorch отдельно рассматривается даже перенос подготовки данных и копирования GPU→CPU в фоновый поток.
Это уменьшает простой GPU, но не делает сохранение бесплатным.
Появляются требования к:
CPU;
оперативной памяти;
скорости передачи данных;
постоянному хранилищу.
Поэтому при проектировании крупного training-сервера важно смотреть не только на GPU и NVMe.
Почему сохранение нужно проверять вместе с восстановлением
Наличие файлов на диске ещё не доказывает, что аварийное восстановление работает.
Корректный приёмочный сценарий:
сохранить состояние → дождаться завершения записи → запустить новый процесс → загрузить состояние → продолжить обучение.
Distributed Checkpoint поддерживает загрузку распределённого состояния и его перераспределение при изменении топологии.
Для проекта полезно измерять отдельно:
Метрика | Что показывает |
Пауза обучения | сколько полезного GPU-времени потеряно |
Полное время сохранения | когда состояние действительно записано |
Время восстановления | сколько длится возврат к обучению |
Успешное продолжение | подтверждает работоспособность checkpoint |
Рабочий лист для расчёта инфраструктуры
Перед выбором конкретного сервера полезно заполнить один набор исходных данных.
Модель и режим обучения
Параметр | Значение |
Модель и версия | |
Число параметров | |
Точность | |
Длина последовательности | |
Пакет на одну GPU | |
Gradient accumulation | |
Gradient checkpointing | да / нет |
Оптимизатор |
Память
Компонент | Расчёт | Измерение |
Параметры модели | ||
Градиенты | ||
Состояния оптимизатора | ||
Активации | — | |
Пиковая память | — |
Распределение
Параметр | Значение |
Число GPU | |
GPU в одном сервере | |
Схема распределения | DDP / FSDP / ZeRO |
Пик памяти на GPU | |
Время шага | |
Число серверов | |
Время коммуникаций |
Контрольные точки
Параметр | Значение |
Что сохраняется | |
Формат | полный / распределённый |
Фактический размер | |
Интервал сохранения | |
Допустимая потеря прогресса | |
Пауза обучения | |
Полное время записи | |
Требуемая полезная скорость записи | |
Число хранимых версий | |
Время восстановления | |
Тест восстановления | PASS / FAIL |
После заполнения этой таблицы решение обычно относится к одному из четырёх вариантов:
Какие данные нужны для подбора сервера
Для расчёта инфраструктуры полного дообучения желательно подготовить точную модель и версию, число параметров, используемую точность, длину последовательности, пакет на одну GPU и оптимизатор.
Если пилот уже проводился, особенно полезны измеренный пик VRAM и время одного шага. Для распределённого обучения дополнительно нужны число GPU и серверов, используемая схема распределения и измеренная коммуникационная составляющая.
Для хранилища — фактический размер контрольной точки, требуемая частота сохранений и допустимое время восстановления.
Такой набор данных позволяет обсуждать не абстрактный «сервер для 70B», а инфраструктуру под конкретную задачу.
Один сервер или GPU-кластер: итоговое правило
Размер модели сам по себе не определяет архитектуру инфраструктуры.
Если полный шаг обучения помещается в пределах одного сервера и время эксперимента устраивает проект, несколько узлов не обязательны.
Если памяти внутри сервера не хватает, нужно увеличивать число доступных GPU или менять способ распределения. Если памяти достаточно, но обучение идёт слишком долго, дополнительные серверы можно использовать для ускорения — но только после проверки влияния межузловых коммуникаций.
И в обоих случаях инфраструктура не заканчивается ускорителями. Для долгих training jobs необходимо проверить, сможет ли система регулярно сохранять состояние и действительно восстанавливать его после сбоя.
Поэтому сервер для Full Fine-Tuning выбирают по результату всей системы: память полного шага обучения, эффективность распределения, время коммуникаций и работа подсистемы контрольных точек.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


