Рабочую станцию или стоечный GPU-сервер стоит выбирать не по количеству разработчиков и не по одному параметру вроде числа GPU. Сначала нужно определить, как команда будет использовать вычислительный ресурс: персонально или совместно, локально или удалённо, интерактивно или для длительных jobs, кто будет администрировать систему и какие требования есть к размещению, обслуживанию и дальнейшему росту.
Практическая последовательность выглядит так:
workload
↓
ownership
↓
personal / shared
↓
interactive / queued / service
↓
access + isolation
↓
placement
↓
power + cooling
↓
management
↓
serviceability + redundancy
↓
growth
↓
exact platform
Главный принцип:
Рабочая станция или GPU-сервер: короткий ответ
Workstation является естественным кандидатом, когда ресурс тесно связан с работой конкретного разработчика: важны локальная интерактивная сессия, IDE, Jupyter, визуализация и прямой доступ к машине.
GPU-server становится сильным кандидатом, когда GPU превращается в общий инфраструктурный ресурс: появляются централизованный доступ, длительные или фоновые jobs, требования к управлению hardware, размещению, обслуживанию и дальнейшему масштабированию.
Но между этими вариантами уже нет жёсткой границы.
Современная deskside-система может одновременно выполнять часть серверных функций. Например, актуальная документация NVIDIA прямо говорит, что DGX Station поддерживает и desktop-, и server-use cases. NVIDIA также позиционирует её как индивидуальный desktop или централизованный compute node для нескольких членов команды; MIG позволяет разделить GPU максимум на семь изолированных instances.
Поэтому такая таблица неверна:
1 пользователь → workstation
несколько человек → server
Важнее понять, что именно означает совместное использование ресурса.
Не выбирайте форм-фактор по количеству GPU
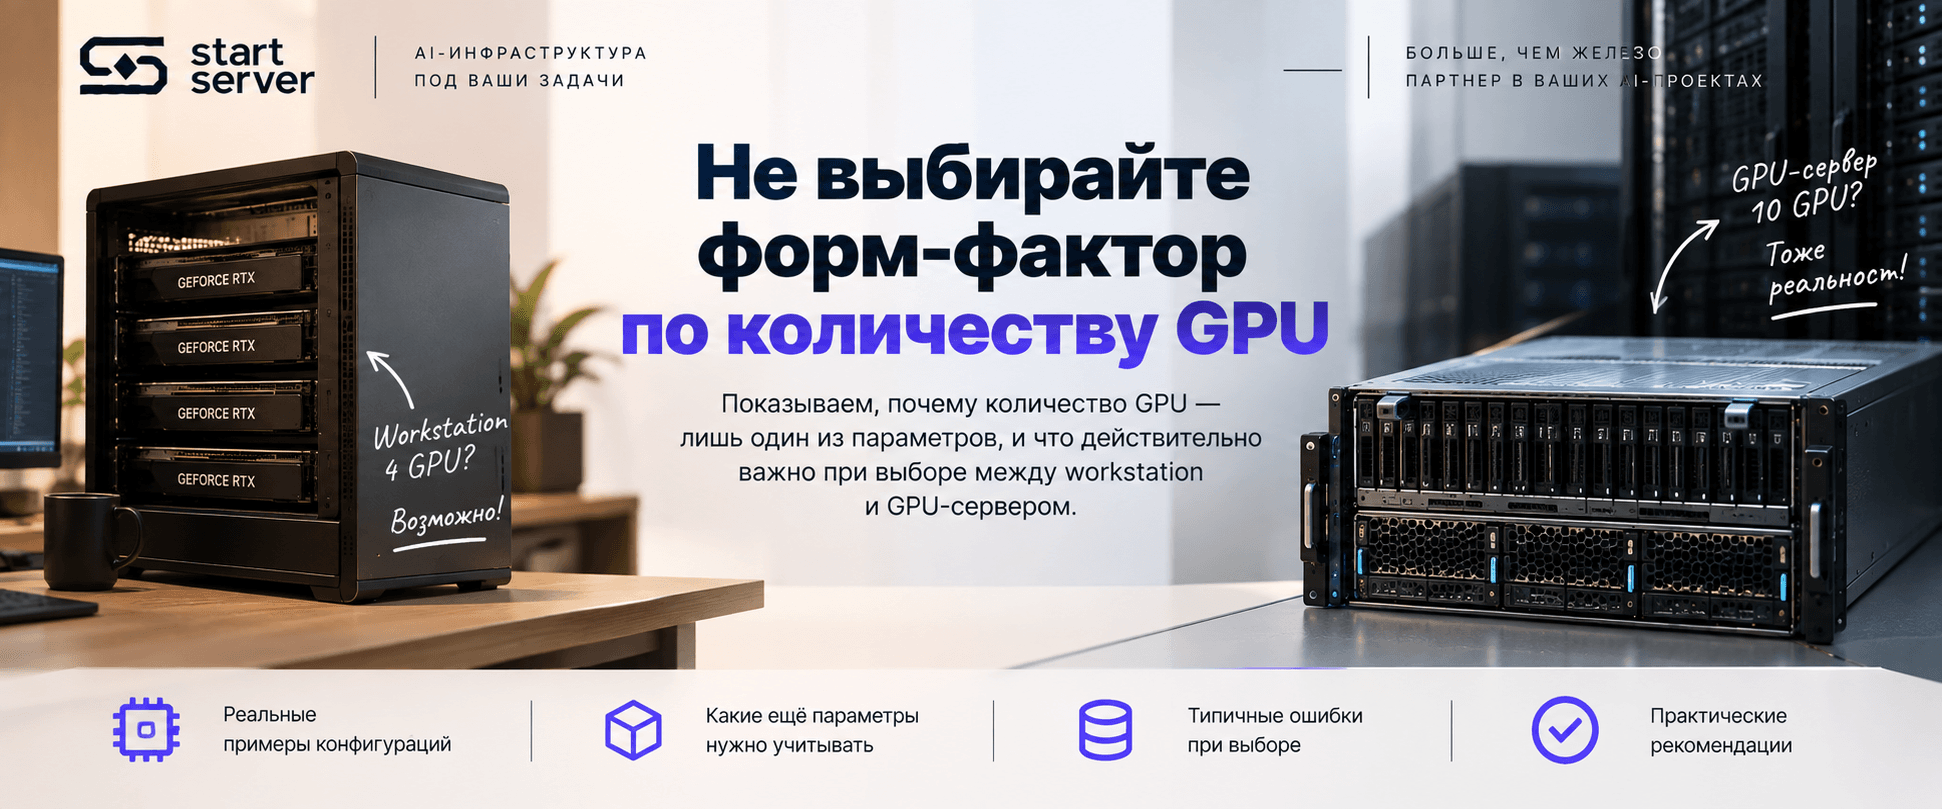
Правило:
1–2 GPU → workstation
4+ GPU → server
тоже не работает.
В актуальном конфигураторе Dell Precision 7960 Tower доступны варианты вплоть до четырёх NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition. То есть workstation в tower-формате вполне может быть четырёх-GPU системой.
При этом Supermicro SYS-421GE-TNRT — уже rack-mounted 4U GPU-server с поддержкой до десяти GPU.
Из этого нельзя вывести новую универсальную границу вроде:
до 4 GPU → workstation
от 5 GPU → server
Количество ускорителей — только один из входных параметров. Нужно учитывать также GPU form factor, power, cooling, topology, размещение и эксплуатационную модель.
Главная развилка — персональный ресурс или инфраструктура команды
Полезнее начать не с chassis, а с ownership.
Персональная модель обычно выглядит так:
developer
↓
OS / IDE / Jupyter / GUI
↓
local GPU resource
У системы есть основной пользователь, которому нужен короткий цикл разработки: изменить код, запустить эксперимент, посмотреть результат, отладить и повторить.
Shared compute выглядит иначе:
developer A ─┐
developer B ─┼→ shared GPU resource
developer C ─┘
Здесь появляются дополнительные вопросы:
кто получает ресурс
↓
как долго
↓
в каком software environment
↓
как изолируются пользователи
↓
как распределяются GPU
↓
кто следит за зависшими jobs
↓
кто обслуживает hardware
Interactive development и shared compute — разные operating models
В персональной среде часто важны:
IDE
Jupyter
debugger
local data
visualization
direct display
Для общего compute-resource чаще становятся значимыми:
remote sessions
containers
repeatable environments
GPU allocation
long-running jobs
monitoring
shared storage
Это не означает, что workstation нельзя использовать удалённо или что server нельзя использовать интерактивно.
Разница в том, вокруг какой модели строится эксплуатация.
Если несколько человек получили SSH-доступ к одной машине, общий GPU-resource ещё не спроектирован. Нужно определить isolation, software environments, resource allocation и ответственность за администрирование.
Shared access нужно проектировать вместе с hardware
Для общей системы до закупки полезно определить:
users
↓
authentication
↓
environment
↓
GPU allocation
↓
isolation
↓
job scheduling
↓
storage permissions
↓
monitoring
Механизм может быть разным: containers, scheduler, выделенный GPU, MIG или другая схема разделения ресурса.
SS-013 не должна превращаться в руководство по Kubernetes, Slurm или MIG. Здесь достаточно архитектурного правила:
DGX Station служит хорошим контрпримером простой дихотомии workstation/server: NVIDIA поддерживает для неё multi-user сценарий и разделение GPU до семи MIG instances.
Это свойство конкретной платформы, а не всех workstation.
Remote management не означает автоматически «server»
Старая схема:
workstation → управляется через ОС
server → имеет BMC
тоже слишком грубая.
DGX Station имеет отдельный BMC-интерфейс для out-of-band management. Актуальная документация NVIDIA описывает secure remote management через BMC web UI и Redfish, включая telemetry, firmware workflows и recovery.
Поэтому вместо вопроса:
Есть ли BMC?
нужно спрашивать:
Какие hardware-management функции нужны нашей эксплуатации и поддерживает ли их exact platform?
Для одной команды достаточно remote reboot и monitoring. Другой могут потребоваться remote console, virtual media, firmware automation, отдельная management network и интеграция с существующим tooling.
Наличие слова server в названии не заменяет проверку этих функций.
ECC тоже не является границей
Профессиональная workstation GPU вполне может иметь ECC.
Например, RTX PRO 6000 Blackwell Workstation Edition имеет 96 GB GDDR7 с ECC. Server Edition той же серии также имеет 96 GB GDDR7 ECC.
Гораздо интереснее различается integration model. NVIDIA указывает для Server Edition passive cooling, для Workstation Edition — double flow-through, а для Max-Q Workstation Edition — active cooling. Power envelope также различается.
Поэтому:
ECC
≠
server
А:
exact GPU execution
+
platform cooling
+
power
+
chassis compatibility
уже действительно влияют на выбор.
Когда workstation остаётся рациональным вариантом
Типичный operating model может выглядеть так:
один основной owner
+
interactive development
+
local workflow
+
нет обязательного rack placement
+
нет сложного shared scheduling
+
нужные GPU поддерживаются платформой
В этом случае workstation — сильный кандидат.
Но дальше всё равно нужно проверить exact configuration по GPU compatibility, power, cooling, физическим размерам, storage, networking и требованиям к рабочему помещению.
Мощная workstation не обязательно означает обычную офисную нагрузку по питанию. Например, Precision 7960 Tower имеет варианты PSU 1100/1400 W и 1500/2200 W; доступная выходная мощность зависит от входного напряжения. Для 1500/2200-W PSU Dell отдельно указывает C20 power cords и соответствующие требования к цепи питания.
Это не означает, что система постоянно потребляет 2200 W.
Зато означает:
Deskside form factor не освобождает от проверки electrical requirements.
Между workstation и rack server есть промежуточная модель
Иногда команда уже переросла чисто персональный компьютер:
несколько пользователей
+
remote access
+
shared data
+
long-running jobs
+
central administration
но ещё не имеет:
rack infrastructure
+
высокой node density
+
multi-node cluster
Это редакционная категория, а не стандартизованный класс оборудования.
DGX Station показывает, что такая operating model технически реальна: desktop-sized система поддерживает server-use cases, dedicated BMC management, контейнерный software stack и multi-user GPU partitioning.
Поэтому выбор больше не обязан выглядеть как:
tower под столом
VS
4U rack server
Когда rack GPU-server становится сильным кандидатом
Переход к rack-server имеет смысл выводить из требований:
rack placement
+
high GPU density
+
centralized operations
+
shared workloads
+
serviceability requirements
+
component redundancy requirements
+
growth to additional nodes
Например, Supermicro SYS-421GE-TNRT представляет именно такой тип платформы: 4U chassis, до 10 GPU, hot-swap drive bays, hot-swap fans и четыре 2700-W PSU в конфигурации 2+2 redundant. Для этих PSU производитель указывает 200–240 VAC input.
Но это свойства конкретного SYS-421GE-TNRT.
Нельзя написать:
любой GPU-server
=
10 GPU
+
hot-swap fans
+
2+2 PSU
Для другого SKU состав будет другим.
Следовательно:
Hot-swap, redundancy и availability — не одно и то же
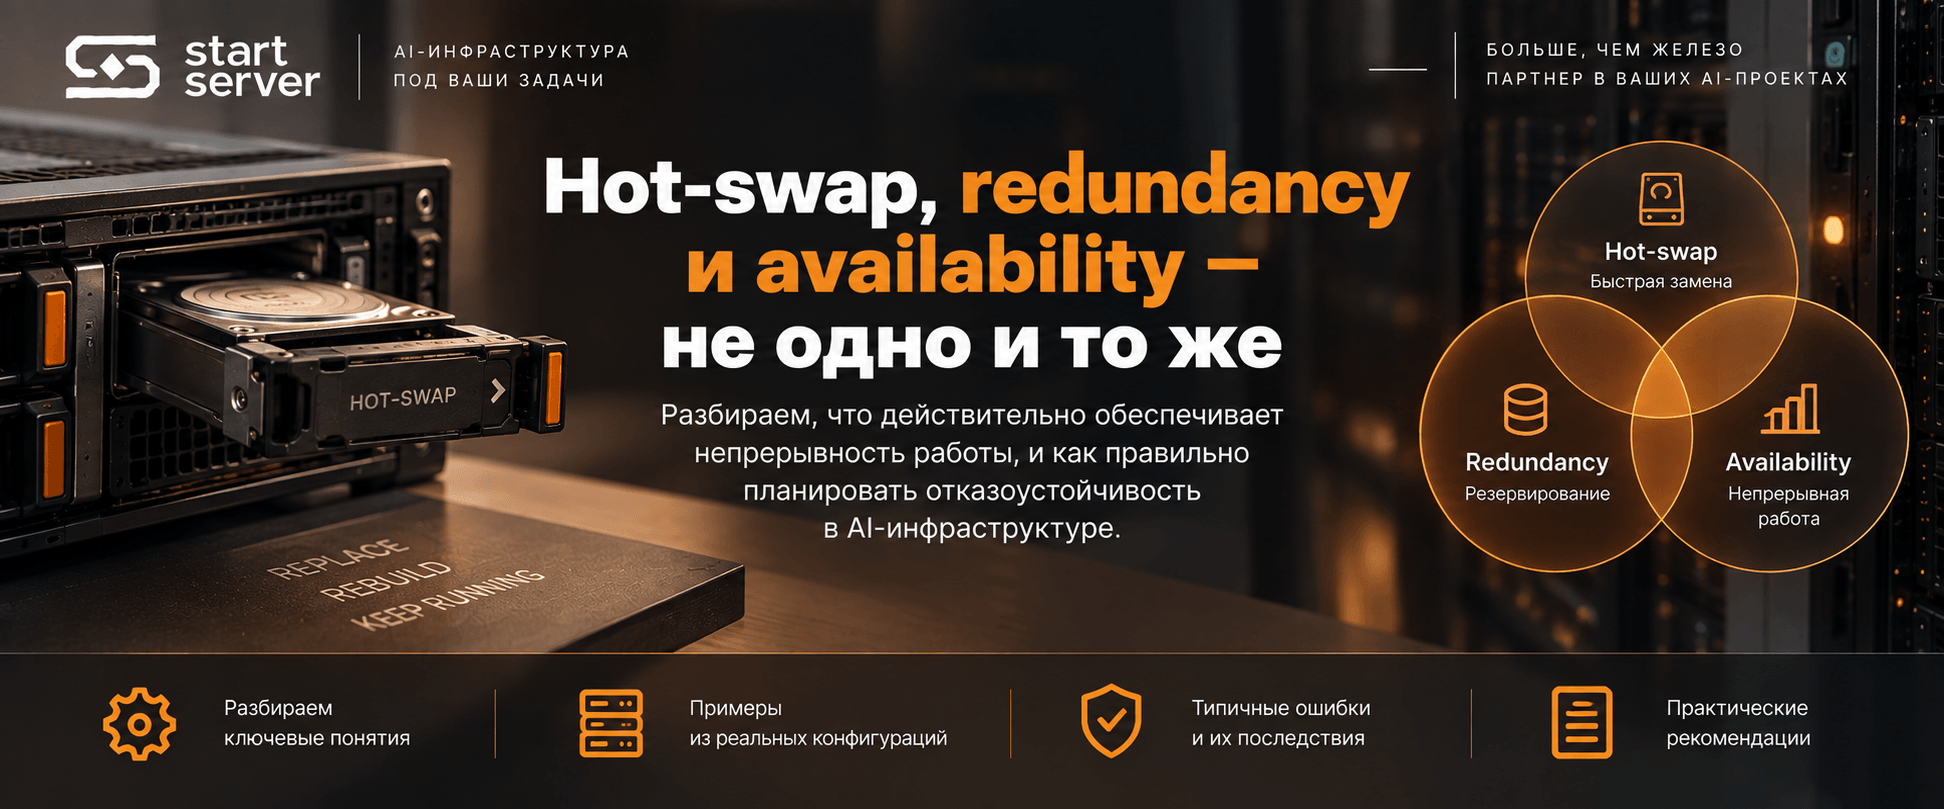
Эти три понятия особенно важно разделять:
hot-swap
≠
component redundancy
≠
application availability
Hot-swap говорит о возможности заменить определённый компонент предусмотренным способом.
Redundancy означает наличие резервного компонента или пути.
Application availability зависит уже от всей системы: hardware, OS, storage, network, application architecture, failover и процедур эксплуатации.
Поэтому даже наличие 2+2 PSU не позволяет написать:
сервер работает без простоев.
Правильный вопрос:
Какой отказ должен пережить workload и какое время восстановления допустимо?
Только после этого можно выбирать соответствующую platform capability.
24×7 тоже не определяет форм-фактор
Формула:
24×7
→
server
слишком упрощённая.
Продолжительная нагрузка означает, что нужно внимательнее проверить:
thermal regime
monitoring
power
maintenance
failure handling
platform limits
Workstation может выполнять длинные jobs. Server также не становится подходящим для любой непрерывной нагрузки только из-за названия.
24×7 — эксплуатационное требование, а не классификация chassis.
Размещение может исключить платформу до benchmark
До сравнения производительности нужно проверить, можно ли выбранную систему вообще нормально установить.
Область | Что нужно проверить |
Питание | input voltage, circuit/PDU, connector, требования PSU |
Охлаждение | airflow, ambient limits, тепловая нагрузка |
Физическое место | chassis dimensions, mass, rack depth, service clearance |
Сеть | NIC, switch ports, кабельная инфраструктура |
Акустика | данные exact configuration или собственный замер |
Обслуживание | физический доступ к системе и компонентам |
Здесь особенно важно не путать PSU rating с реальным потреблением.
2200 W PSU
≠
2200 W постоянного power draw
Точно так же четыре PSU в redundant server configuration нельзя просто сложить и назвать энергопотреблением workload.
Шум нужно проверять для конкретной конфигурации
Если GPU-система должна стоять рядом с людьми, акустика может стать hard requirement.
Но универсальная таблица:
workstation = X dBA
server = Y dBA
без сопоставимых измерений была бы недостоверной.
На шум влияют chassis, GPU, CPU, fan profile, ambient temperature, firmware и сама нагрузка.
Поэтому procurement rule простой:
Для office placement используйте acoustic specification exact configuration или измерение по заранее определённой методике.
Фразы «workstation тихая» и «server громкий» недостаточны для инженерного решения.
Display outputs тоже не дают надёжной классификации
Можно предположить:
workstation GPU → display
server GPU → headless
Но и это не универсально.
В актуальной RTX PRO 6000 Blackwell family и Workstation Edition, и Server Edition имеют четыре DisplayPort 2.1.
Поэтому нужно проверять не просто наличие коннектора, а реальное требование:
Storage architecture тоже влияет на выбор
Сравним три модели:
A
dataset
↓
local NVMe
↓
workstation GPU
B
shared storage
↓
network
↓
shared deskside node
C
shared storage
↓
network
↓
rack GPU server
При одинаковой GPU workload будет зависеть от разных infrastructure paths.
До выбора форм-фактора нужно знать, где находятся datasets, где записываются checkpoints, нужен ли shared storage и как несколько пользователей получают доступ к одним данным.
SS-013 не должна считать storage bandwidth — это отдельная тема. Здесь storage выступает как input requirement.
Нужно проектировать не только сегодняшнюю команду
Правило «купить server с запасом» почти так же бесполезно, как «взять workstation подешевле».
Лучше описать конкретный growth scenario:
users now
↓
users in 12–24 months
GPU now
↓
GPU later
single system
↓
multiple nodes
individual experiments
↓
shared inference / ML platform
Тогда становятся видны два разных риска.
Первый — overbuilding: команда сегодня оплачивает и администрирует инфраструктуру, которая не приносит практической пользы.
Второй — premature undersizing: покупается ещё одна персональная система, хотя реальная проблема уже заключается в sharing, data management и централизованной эксплуатации.
Как сравнивать TCO
До получения актуальных коммерческих данных не стоит писать:
workstation дешевле
server дороже
Для проекта полезнее структура:
purchase price
+
facility
+
network
+
storage
+
administration
+
maintenance
+
downtime exposure
+
migration
+
unused GPU capacity
Например, shared server может стоить дороже как hardware, но снизить дублирование дорогостоящих GPU между разработчиками.
И наоборот: инфраструктурная сложность server-platform может быть неоправданной, если resource нужен фактически одному специалисту и большую часть времени используется интерактивно.
Именно поэтому TCO считают после operating model.
Матрица выбора
Эта таблица описывает эксплуатационные сценарии, а не обязательные свойства каждого устройства.
Критерий | Personal workstation | Shared deskside node | Rack GPU-server |
Основной owner | конкретный специалист | команда | infrastructure/IT |
Local interactive workflow | часто основной | возможен | зависит от задачи |
Shared access | возможен | основной сценарий | основной сценарий |
Isolation | может быть простой | нужно проектировать | нужно проектировать |
Long-running jobs | возможны | типичны | типичны |
Scheduler | может не требоваться | может быть полезен | часто полезен |
OOB management | зависит от SKU | может быть важен | часто является требованием |
Rack infrastructure | не обязательна | не обязательна | зависит от выбранной платформы, обычно ожидается для rack SKU |
GPU density | зависит от SKU | зависит от SKU | зависит от SKU |
Serviceability | зависит от SKU | зависит от SKU | часто является одним из критериев выбора |
Scale to additional nodes | не основной сценарий | возможный следующий этап | естественный сценарий для части проектов |
В таблице намеренно нет строки:
максимум пользователей = N
Потому что такого универсального числа нет.
Hard Requirements Gate
Сначала исключите варианты, которые не проходят обязательные условия:
WORKLOAD
Required GPU:
Required GPU count:
Required GPU memory:
Required CPU/RAM:
Required local storage:
USAGE
Primary owner:
Concurrent users:
Interactive workload:
Queued jobs:
Persistent services:
Isolation required:
PLACEMENT
Office:
Server room:
Rack:
Colocation:
Rack mandatory:
Local console mandatory:
POWER
Available voltage:
Available circuit / PDU:
Exact platform requirement checked:
COOLING
Airflow requirement checked:
Environmental limits checked:
MANAGEMENT
OOB management required:
Remote console required:
Monitoring required:
SERVICEABILITY
Required redundant components:
Required hot-swap components:
Acceptable downtime:
RESULT
Rejected platforms:
Remaining candidates:
Если обязательное требование не выполняется:
hard requirement FAIL
→
platform eliminated
Цена или лишняя GPU memory не должны компенсировать отсутствие критически необходимой функции.
Team Deployment Matrix
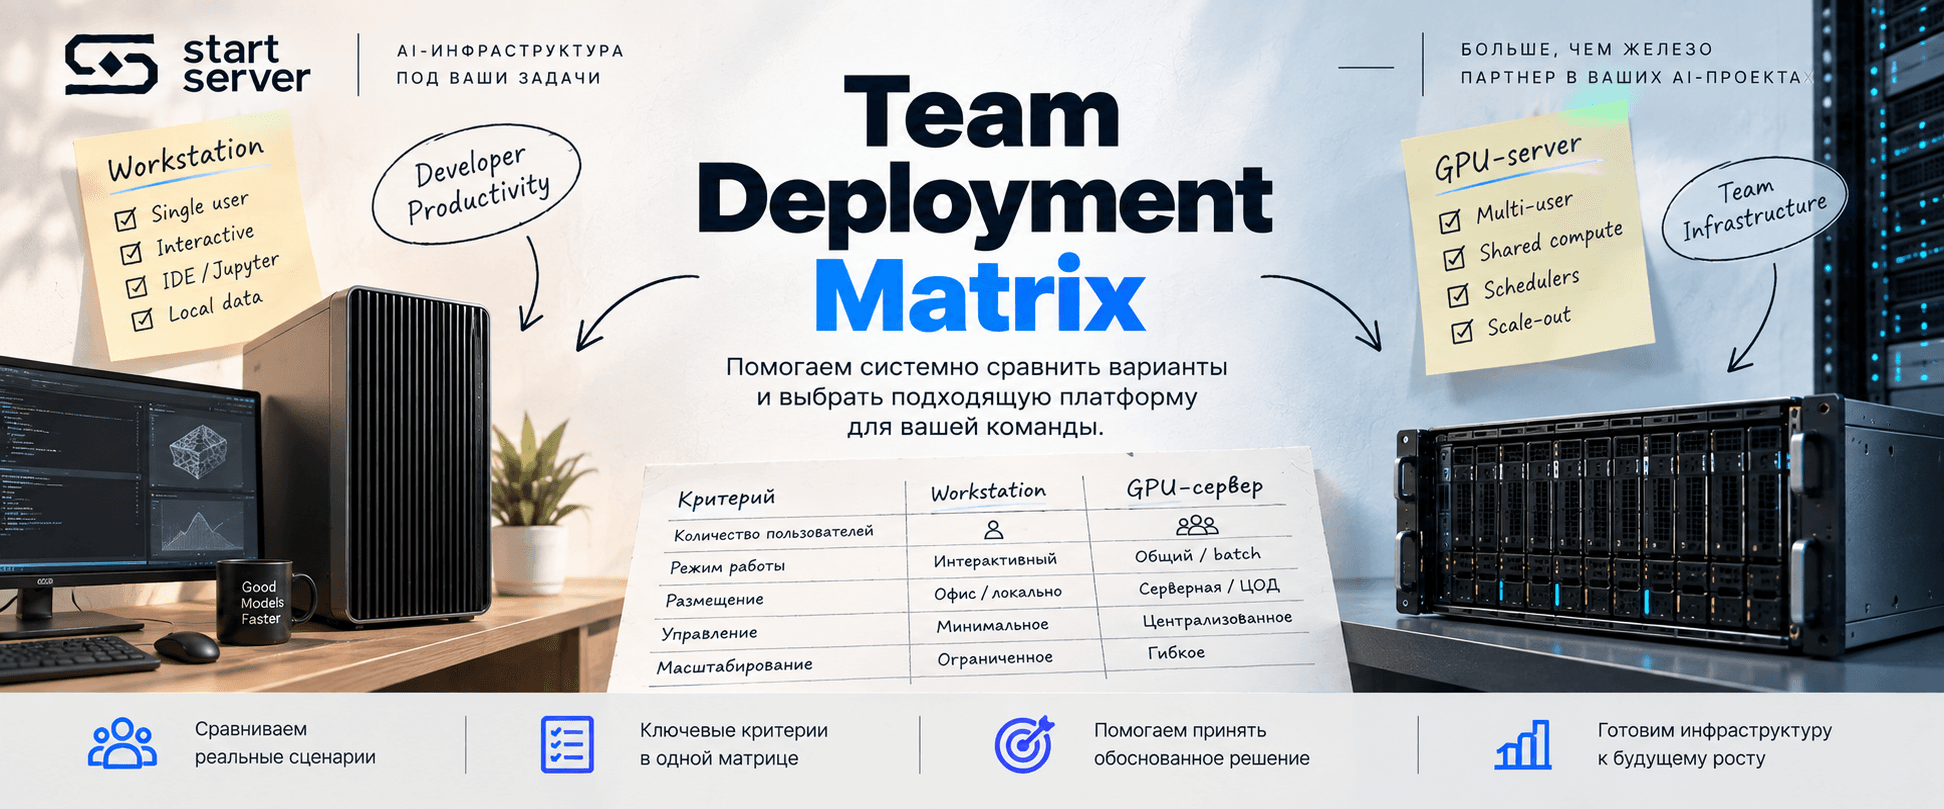
После hard blockers можно сравнивать оставшиеся варианты:
TEAM
Developers/users:
Concurrent users:
Resource owner:
Expected team growth:
WORKLOAD
Interactive development:
Training:
Fine-tuning:
Inference:
Visualization:
Typical job duration:
Night/weekend jobs:
Persistent services:
ACCESS
Local console:
SSH:
Remote desktop:
Notebook:
Containers:
Scheduler:
Multi-user isolation:
GPU
GPU requirement:
GPU count now:
GPU count in 12–24 months:
Local graphics required:
Shared GPU pool:
OPERATIONS
Expected duty cycle:
OS administrator:
Hardware administrator:
OOB management:
Monitoring:
Acceptable downtime:
Required redundancy:
PLACEMENT
Office:
Server room:
Rack:
Colocation:
Available power:
Available cooling:
Acoustic constraint:
DATA
Dataset location:
Local NVMe:
Shared storage:
Network dependency:
Access restrictions:
GROWTH
More users:
More GPUs:
More nodes:
Shared inference:
Central ML platform:
DECISION
Personal workstation candidate:
Shared deskside candidate:
Rack GPU-server candidate:
Hard blockers:
Open questions:
Exact SKUs to compare:
Это значительно полезнее запроса:
«У нас пять разработчиков.
Нам workstation или server?»
Три учебных сценария
Персональная разработка. Один специалист в основном работает локально с IDE и notebooks, GPU не является shared pool, rack не требуется. В таком случае workstation остаётся логичным кандидатом, если exact configuration проходит workload, power, cooling и growth requirements.
Общий deskside compute. Несколько разработчиков подключаются удалённо, используются containers и разделение GPU, но отдельной rack-инфраструктуры пока нет. Здесь имеет смысл сравнить deskside platform с небольшим server-class вариантом. Современная DGX Station показывает, что shared deskside operating model действительно существует.
Rack infrastructure. GPU — постоянный shared resource, система должна жить в стойке, требуется высокая density, централизованное обслуживание и определённая redundancy/serviceability. Здесь rack GPU-server становится сильным кандидатом.
Это примеры архитектур, а не правило:
1 пользователь → workstation
3 → shared node
5 → server
Такой формулы нет.
Итоговый алгоритм выбора
1. Определить workload
↓
2. Определить owner ресурса
↓
3. Personal или shared
↓
4. Interactive / queued / service
↓
5. Определить isolation и access model
↓
6. Проверить placement
↓
7. Проверить power и cooling
↓
8. Определить management requirements
↓
9. Определить serviceability / redundancy
↓
10. Описать growth на 12–24 месяца
↓
11. Исключить несовместимые платформы
↓
12. Сравнить exact SKUs
Только после этого имеет смысл окончательно выбирать:
workstation
или:
shared deskside compute node
или:
rack GPU-server
Что передать для подбора оборудования
Для сравнения конкретных платформ полезно подготовить данные о workload, требуемых GPU и их количестве, числе одновременных пользователей, interactive и background jobs, длительности задач, модели доступа, isolation, storage, месте установки, доступном питании, rack-инфраструктуре, требованиях к remote management и downtime, а также ожидаемом росте на 12–24 месяца.
По этим параметрам уже можно сравнивать exact workstation и GPU-server configurations без универсальных правил «команда = server».
Рабочий CTA: Подобрать формат оборудования для команды.
Пока его нельзя расширять обещаниями вроде бесплатного проектирования, определённого SLA ответа или конкретных условий сервиса: verified_services, verified_commercial_terms и approved_offers в паспорте проекта остаются незаполненными.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


