RAID-массив объединяет несколько HDD или SSD в один логический том. Данные распределяются между накопителями по правилам выбранного уровня RAID. Эти правила определяют полезную емкость, скорость, допустимое количество отказавших дисков и сложность восстановления массива.
RAID 0 повышает производительность и объединяет емкость, но не защищает данные. RAID 1 создает зеркало. RAID 5 использует один эквивалент диска под распределенную четность, RAID 6 использует два, а RAID 10 объединяет зеркалирование и чередование. Универсально лучшего уровня нет: выбор зависит от нагрузки, числа накопителей, допустимого простоя и наличия резервной копии.
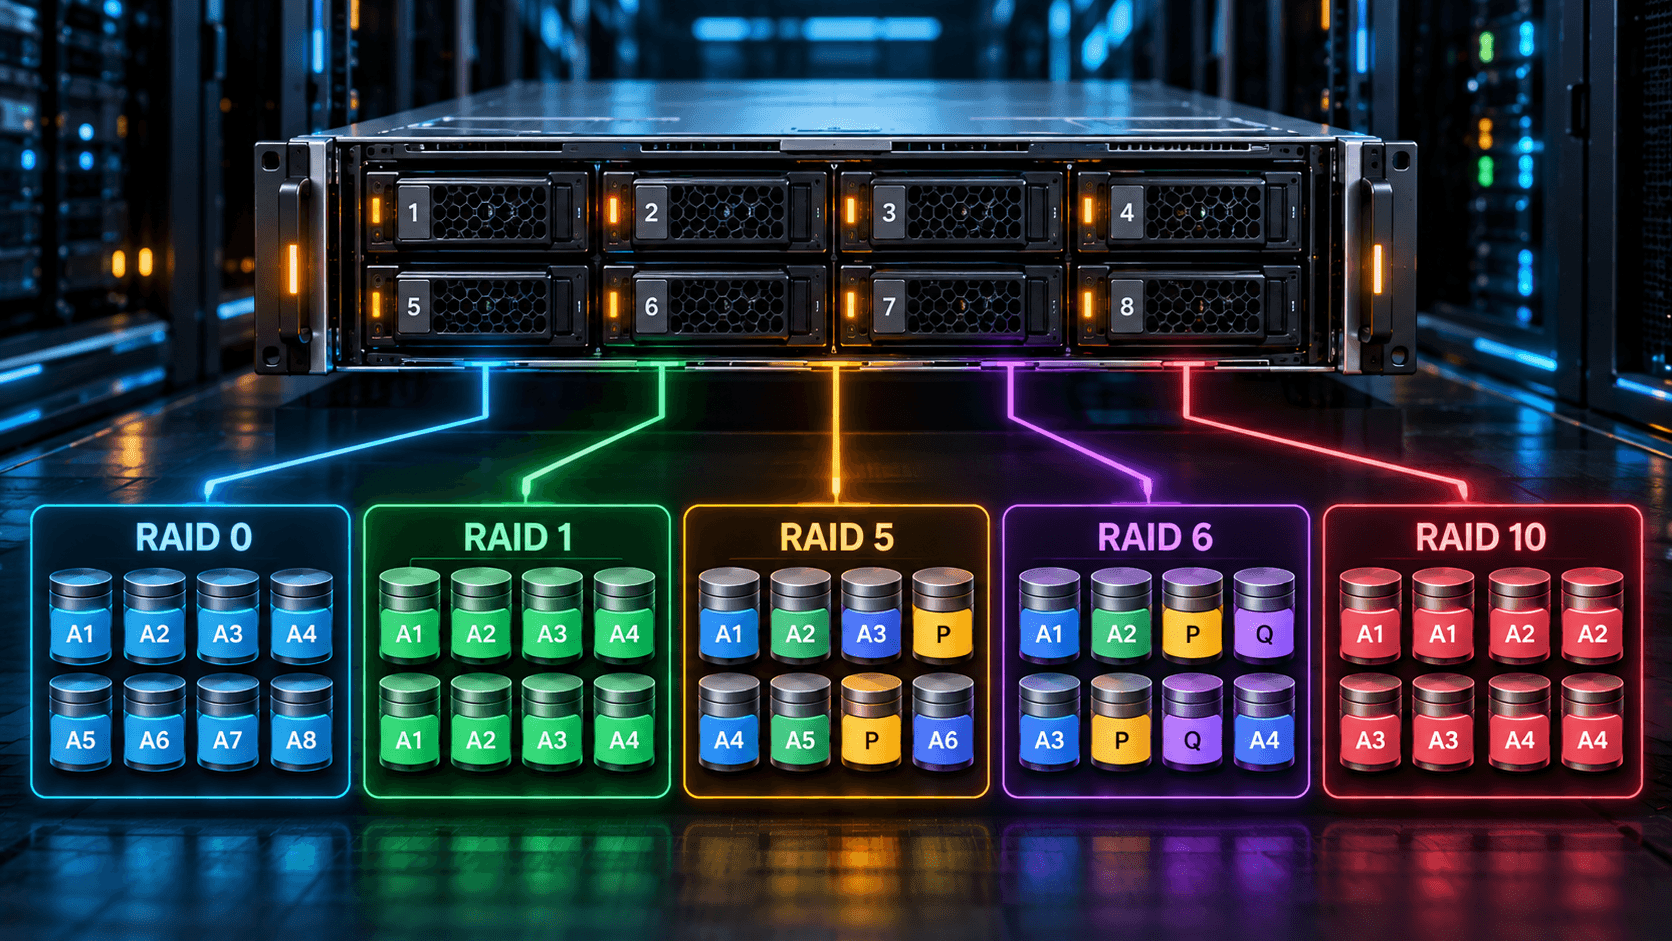
Что такое RAID-массив простыми словами
RAID расшифровывается как Redundant Array of Independent Disks, массив независимых дисков с избыточностью. Название требует оговорки: RAID 0 традиционно относится к семейству RAID, хотя избыточности у него нет.
Сервер, NAS или СХД видит группу физических накопителей и предоставляет операционной системе один или несколько логических томов. Управлять распределением данных может аппаратный RAID-контроллер, операционная система или программный слой хранилища.
RAID используют для четырех задач:
Объединить емкость нескольких накопителей.
Выполнять операции параллельно и повышать производительность.
Сохранить доступность при отказе одного или нескольких дисков.
Упростить замену накопителя и восстановление избыточности.
Как работает RAID
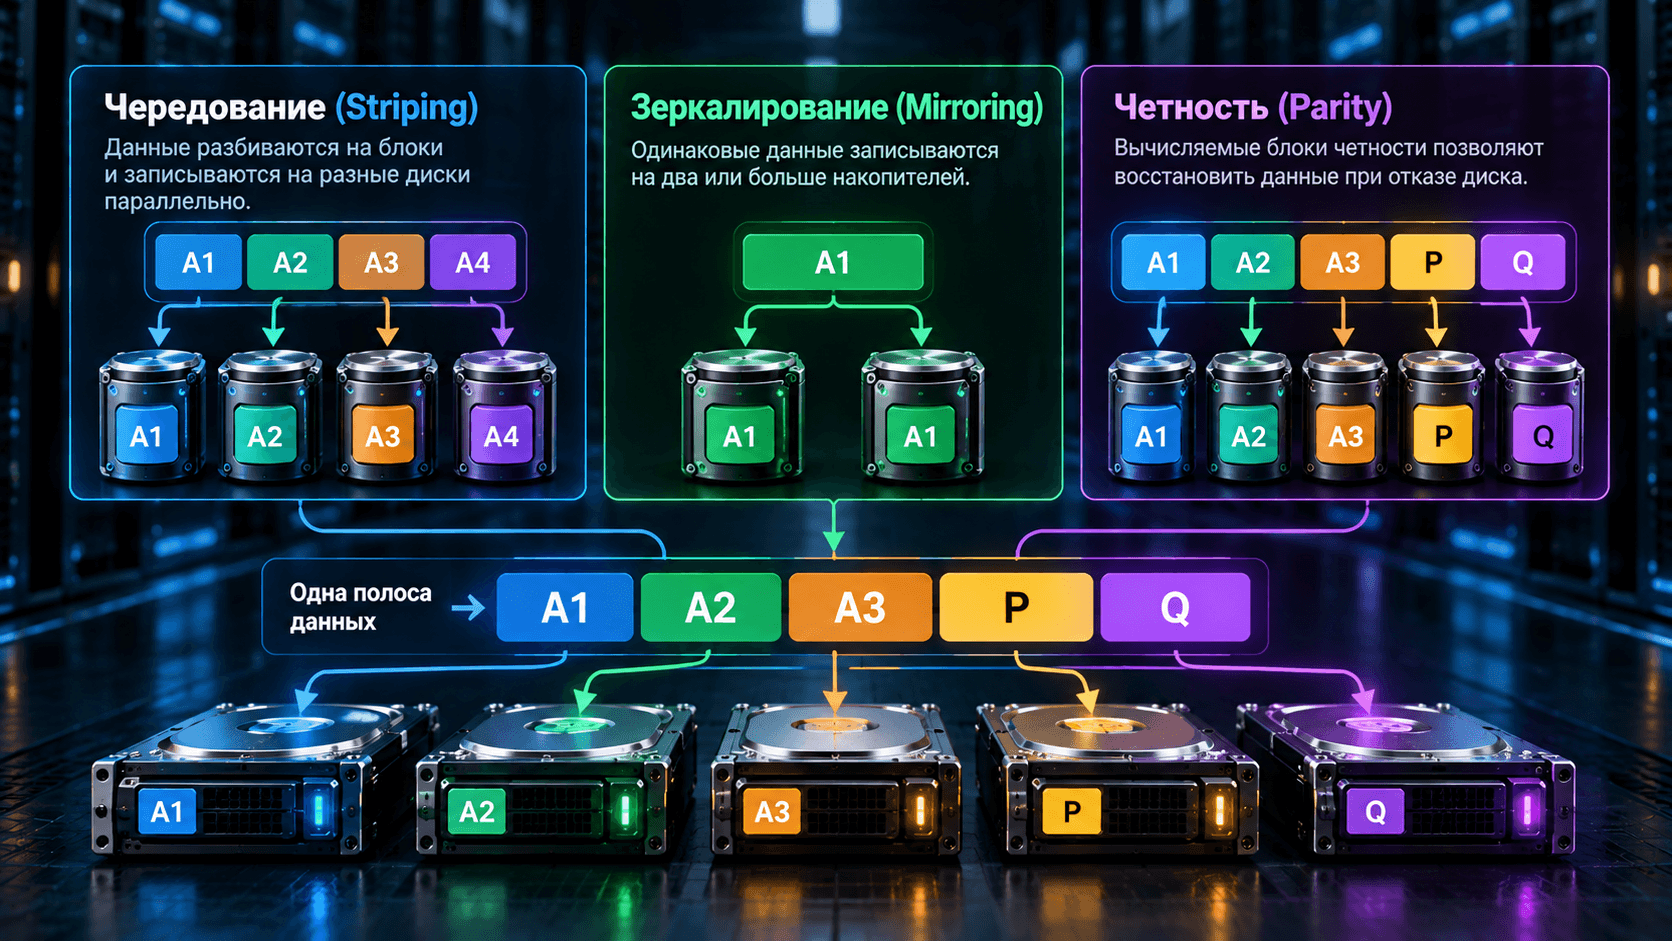
Контроллер или программный RAID делит поток данных на блоки и размещает их на физических накопителях. Основные механизмы называются striping, mirroring и parity.
Чередование данных
Striping, или чередование, распределяет соседние блоки по разным дискам. Несколько накопителей могут обслуживать запрос параллельно. На результат влияют размер полосы, глубина очереди, последовательный или случайный профиль и возможности контроллера.
Чередование не создает копию. Если оно используется без зеркала или четности, потеря одного диска делает часть блоков недоступной, а вместе с ними обычно и весь том.
Зеркалирование
Mirroring записывает одинаковые данные на два или больше накопителей. В классическом двухдисковом RAID 1 каждая запись попадает на оба диска. Чтение может распределяться между участниками, если реализация это поддерживает.
Цена зеркала состоит в емкости: два диска по 8 ТБ дают около 8 ТБ сырой логической емкости до форматирования, а не 16 ТБ.
Четность
Parity хранит вычисляемую информацию, с помощью которой можно восстановить потерянный блок. В RAID 5 данные и один блок четности распределяются по дискам. RAID 6 хранит два независимых набора четности и выдерживает отказ двух накопителей.
Четность не является отдельной резервной копией файлов. Она работает на уровне блоков внутри массива и нужна для реконструкции отсутствующих данных.
Сравнение RAID 0, 1, 5, 6 и 10
В таблице приведены классические схемы для одинаковых накопителей. Возможности конкретного контроллера, СХД или программной реализации могут отличаться.
Уровень | Минимум дисков | Полезная емкость | Гарантированно допустимые отказы | Запись | Типичный сценарий |
|---|---|---|---|---|---|
RAID 0 | 2 |
| 0 | быстрая, без избыточности | временный cache, scratch, воспроизводимые данные |
RAID 1 | 2 |
| 1 из 2 | каждая запись дублируется | загрузочный том, небольшой критичный набор данных |
RAID 5 | 3 |
| 1 | есть расчет и обновление четности | чтение преобладает, важна эффективность емкости |
RAID 6 | 4 |
| 2 | две четности, больше работы при записи | емкие массивы, архивы, файловые данные |
RAID 10 | 4, обычно четное число |
| минимум 1; больше, если отказы в разных зеркалах | данные записываются в зеркальные пары | БД, виртуализация, интенсивная случайная запись |
RAID 0: максимальная емкость без защиты
RAID 0 распределяет блоки по двум или более накопителям. Все диски участвуют в хранении пользовательских данных, поэтому теоретическая емкость равна их сумме.
Преимущества RAID 0:
используется почти вся сырая емкость;
операции могут выполняться параллельно;
нет вычисления четности и зеркальной записи.
Главный недостаток: отказ любого накопителя приводит к потере массива. RAID 0 нельзя использовать для единственной копии документов, базы данных, виртуальных машин или checkpoint модели.
RAID 0 уместен для временного набора данных, который можно автоматически восстановить из надежного источника. Например, локальный cache AI-сервера может ускорять повторное чтение датасета, если первичные данные и checkpoints находятся в отдельном защищенном хранилище. Проектирование такого контура разобрано в материале о хранении датасетов и checkpoint в AI-кластере.
RAID 1: зеркало на двух дисках
RAID 1 записывает копию каждого блока на два накопителя. При отказе одного диска второй продолжает обслуживать данные, а после замены начинается синхронизация зеркала.
Для двух дисков по 8 ТБ полезная сырая емкость составляет около 8 ТБ. RAID 1 расходует половину суммарной емкости, но остается простой и предсказуемой схемой.
RAID 1 часто выбирают для загрузочного тома сервера, системного раздела, журналов или небольшого критичного набора данных. Два M.2 SSD под операционную систему являются распространенным примером, если платформа поддерживает нужный режим.
Зеркало не защищает от логического повреждения. Если приложение перезаписало данные, изменение будет записано на оба диска. Если файл удален, удаление также отразится на обеих копиях.
RAID 5: один отказ и эффективное использование емкости
RAID 5 чередует данные и распределенную четность минимум по трем накопителям. Эквивалент емкости одного диска расходуется на защиту. Массив выдерживает отказ одного участника.
Шесть дисков по 8 ТБ дают теоретически (6 - 1) x 8 = 40 ТБ. После отказа одного диска массив работает в degraded mode. Недостающие блоки вычисляются из оставшихся данных и четности, поэтому задержка и нагрузка могут вырасти.
RAID 5 привлекателен хорошим отношением полезной емкости к сырой. Он подходит для нагрузок, где чтение заметно преобладает над записью и допустима защита только от одного одновременного отказа.
У RAID 5 нет универсального запрета и нет универсальной безопасности. Решение зависит от емкости и класса дисков, времени rebuild, нагрузки во время восстановления, качества контроллера, мониторинга и наличия проверенного backup. Для большого массива из емких HDD один допустимый отказ может оказаться недостаточным.
RAID 6: двойная четность
RAID 6 похож на RAID 5, но хранит два независимых набора четности. Для классической схемы нужно минимум четыре диска. Массив продолжает работать при отказе двух накопителей.
Шесть дисков по 8 ТБ дают теоретически (6 - 2) x 8 = 32 ТБ. В сравнении с RAID 5 теряется емкость еще одного диска, а запись требует дополнительной работы с четностью. Взамен массив сохраняет запас на второй отказ во время замены и восстановления первого диска.
RAID 6 часто рассматривают для емких HDD, файловых хранилищ, архивов и систем, где важнее защита и эффективность емкости, чем минимальная задержка случайной записи. Это ориентир, а не готовая спецификация: современная СХД может использовать собственную распределенную схему защиты вместо классического RAID 6.
RAID 10: чередование зеркальных пар
RAID 10, или RAID 1+0, сначала создает зеркальные пары, затем распределяет данные между ними. Классическая конфигурация начинается с четырех дисков и использует около половины суммарной емкости.
Восемь дисков по 8 ТБ дают теоретически (8 / 2) x 8 = 32 ТБ. Массив гарантированно переживает отказ одного накопителя. Он может пережить несколько отказов, если в каждой зеркальной паре останется хотя бы один рабочий диск. Два отказа внутри одной пары приводят к потере массива.
RAID 10 обычно выбирают для баз данных, виртуализации и нагрузки с большим числом случайных операций записи. В нем нет распределенной четности, а rebuild зеркала требует копирования данных с оставшегося участника пары. Но фактическое время и влияние восстановления зависят от объема, скорости дисков, контроллера и текущей нагрузки.
Как рассчитать полезную емкость RAID
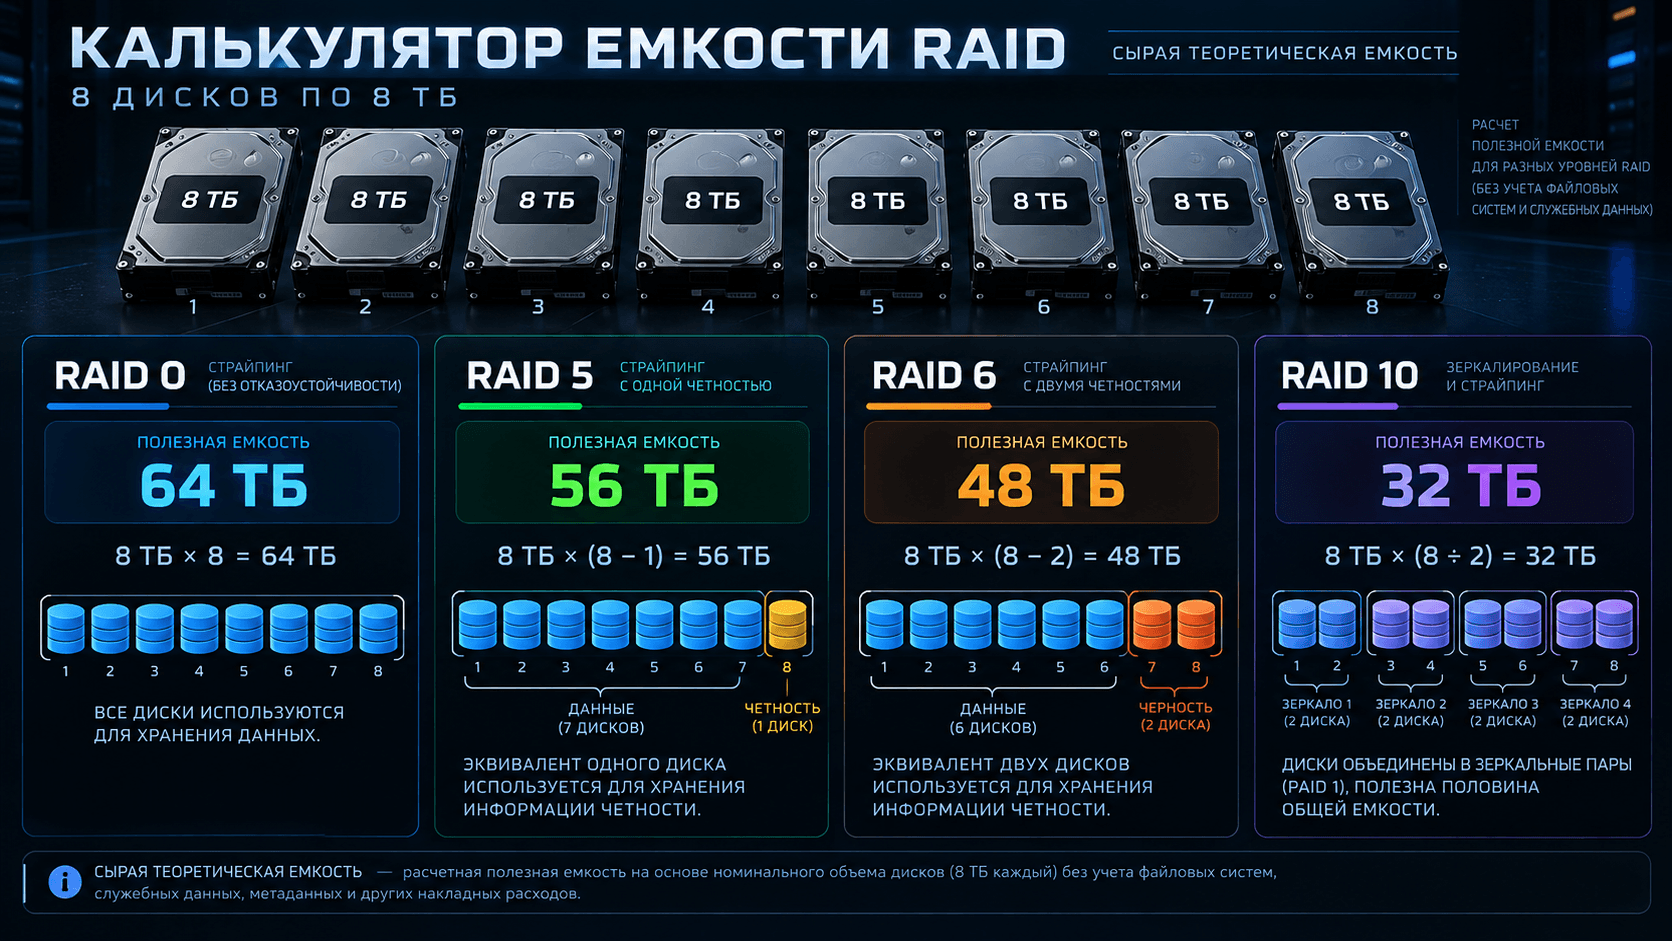
Для предварительного расчета нужны количество накопителей N и емкость самого маленького накопителя S.
RAID 0:  N x S
RAID 1:  S для обычного зеркала из двух дисков
RAID 5:  (N - 1) x S
RAID 6:  (N - 2) x S
RAID 10: (N / 2) x S
Пример для восьми одинаковых дисков по 8 ТБ:
Уровень | Расчет | Теоретическая сырая емкость |
|---|---|---|
RAID 0 |
| 64 ТБ |
RAID 5 |
| 56 ТБ |
RAID 6 |
| 48 ТБ |
RAID 10 |
| 32 ТБ |
Для RAID 1 корректнее считать конкретное зеркало. Два диска по 8 ТБ дают 8 ТБ сырой логической емкости.
Если смешать диски по 8 и 12 ТБ в одном классическом массиве, расчет обычно ограничивается емкостью меньшего участника. Лишнее пространство более крупного диска может остаться неиспользованным. Возможность иначе распределить емкость зависит от конкретной системы.
Калькулятор RAID не показывает полный доступный объем приложения. Из сырого результата нужно вычесть служебные области, spare capacity, файловую систему, резерв свободного места, snapshots и другие накладные расходы.
Как RAID влияет на производительность
Фраза «этот RAID быстрее» без профиля нагрузки почти бесполезна. Нужно разделять:
последовательное и случайное чтение;
последовательную и случайную запись;
размер блока;
глубину очереди;
полную и частичную запись полосы;
нормальный и degraded mode;
работу из кэша и устойчивую скорость накопителей;
обычную работу и rebuild.
Для малой случайной записи используют классическую модель write penalty. RAID 0 требует одну физическую запись. RAID 1 и RAID 10 записывают две копии. RAID 5 в сценарии read-modify-write может потребовать четыре операции: чтение старых данных и четности, затем запись новых данных и четности. Для RAID 6 классическая модель дает шесть операций.
RAID 5, RAID 6 или RAID 10: что выбрать
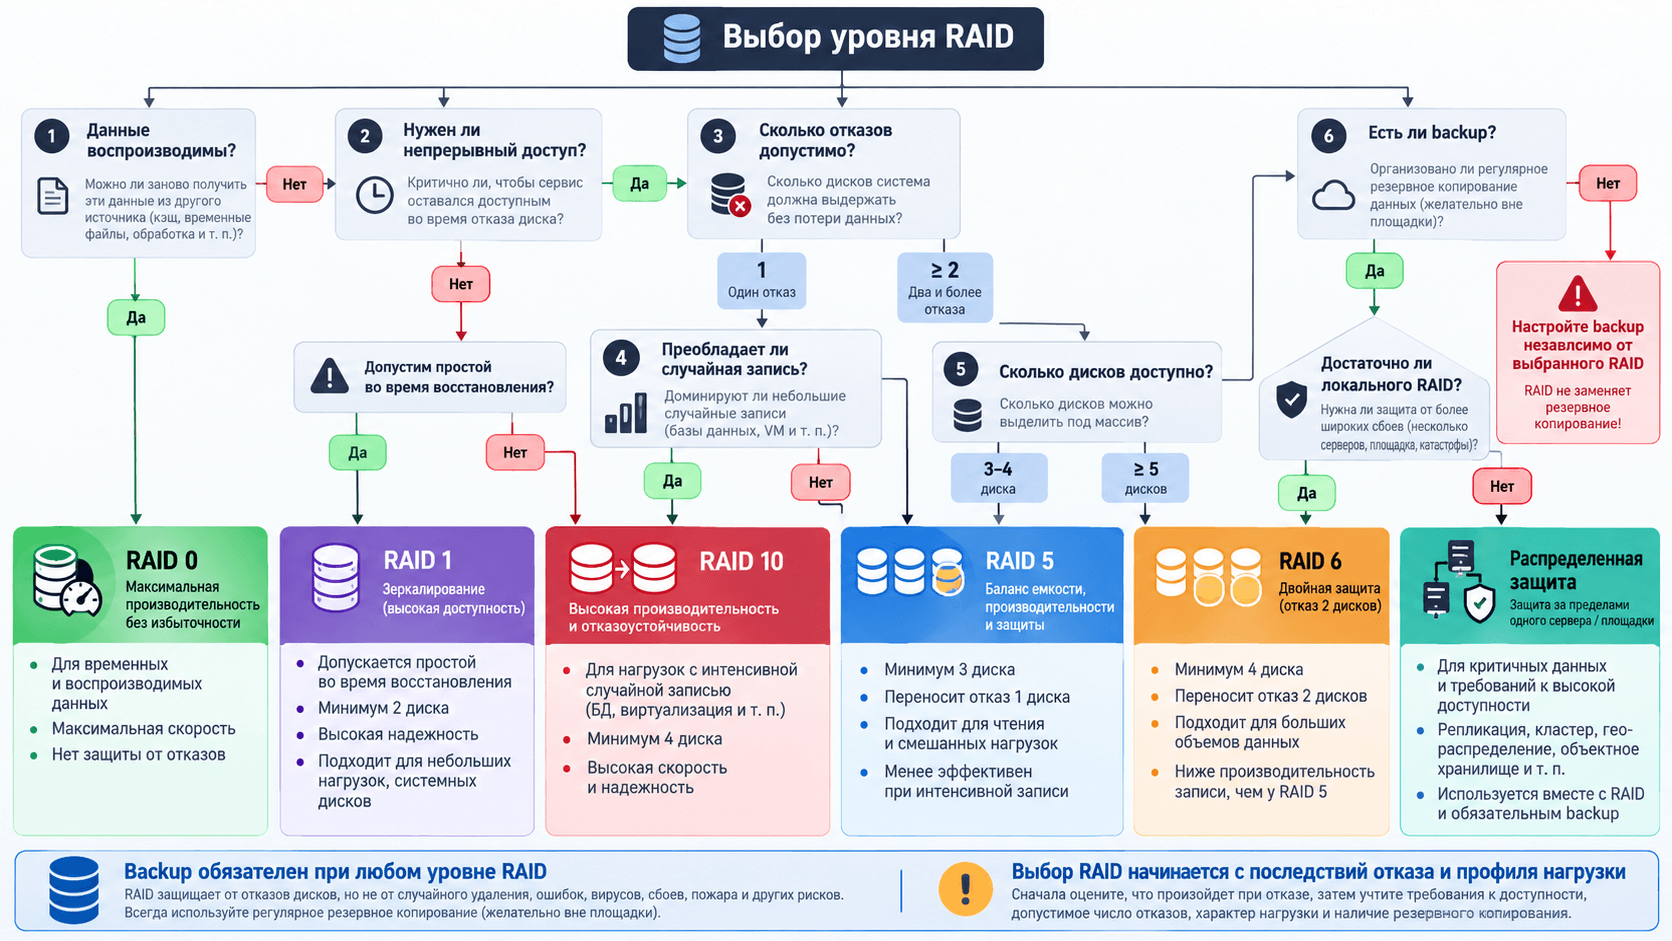
Выбор начинается не с количества доступных дисков, а с последствий отказа и профиля I/O.
Условие | Что рассмотреть | Почему |
|---|---|---|
Временные воспроизводимые данные | RAID 0 | максимальная емкость и параллелизм без защиты |
Загрузочный том из двух дисков | RAID 1 | простое зеркало и предсказуемое восстановление |
Небольшой массив, чтение преобладает, допустим один отказ | RAID 5 | эффективное использование емкости |
Емкие HDD и нужен запас на второй отказ | RAID 6 | двойная четность |
База данных, виртуализация, интенсивная случайная запись | RAID 10 | зеркала без паритетного read-modify-write |
Распределенное scale-out хранилище | репликация или erasure coding | защита проектируется на уровне узлов и доменов отказа |
RAID 5 и RAID 6 не становятся автоматически медленными, а RAID 10 не становится автоматически лучшим. Контроллер, кэш, накопители и характер запросов могут изменить картину. Сначала фиксируют требуемые IOPS, throughput и latency, затем проверяют конфигурацию тестом.
RAID на HDD, SSD и NVMe
Одинаковый уровень RAID ведет себя по-разному на HDD, SATA SSD и NVMe.
HDD
Для HDD важны скорость вращения, механические задержки, последовательность запросов и длительность rebuild. Емкие диски увеличивают объем данных, который нужно прочитать и записать при восстановлении. Во время rebuild рабочая нагрузка конкурирует с реконструкцией за ресурсы массива.
SATA и SAS SSD
SSD убирают механические задержки, но сохраняют ограничения контроллера, интерфейса, endurance и защиты от потери питания. Для паритетных уровней нужно учитывать дополнительную запись. Enterprise SSD с power loss protection и предсказуемым ресурсом отличаются от потребительской модели даже при одинаковой заявленной емкости.
Различия интерфейсов подробнее объясняет статья NVMe: что это и чем отличается от SATA SSD. При подборе конкретных накопителей также проверяют методику из материала как выбрать NVMe SSD для обучения моделей.
NVMe
NVMe подключается через PCIe и способен создавать значительно больше параллельных запросов, чем традиционный SATA-контур. Старый SAS RAID-контроллер нельзя считать универсальным средством для NVMe. Нужна платформа, которая поддерживает конкретную топологию, backplane, hot-plug, bifurcation и выбранный программный либо аппаратный RAID.
Перед закупкой проверяют, проходят ли через весь стек команды управления, telemetry, sanitize, обновление firmware и уведомления об ошибках. Категория серверных SSD-накопителей помогает сравнить форм-факторы и интерфейсы, но совместимость подтверждается по спецификации сервера и контроллера.
Аппаратный и программный RAID
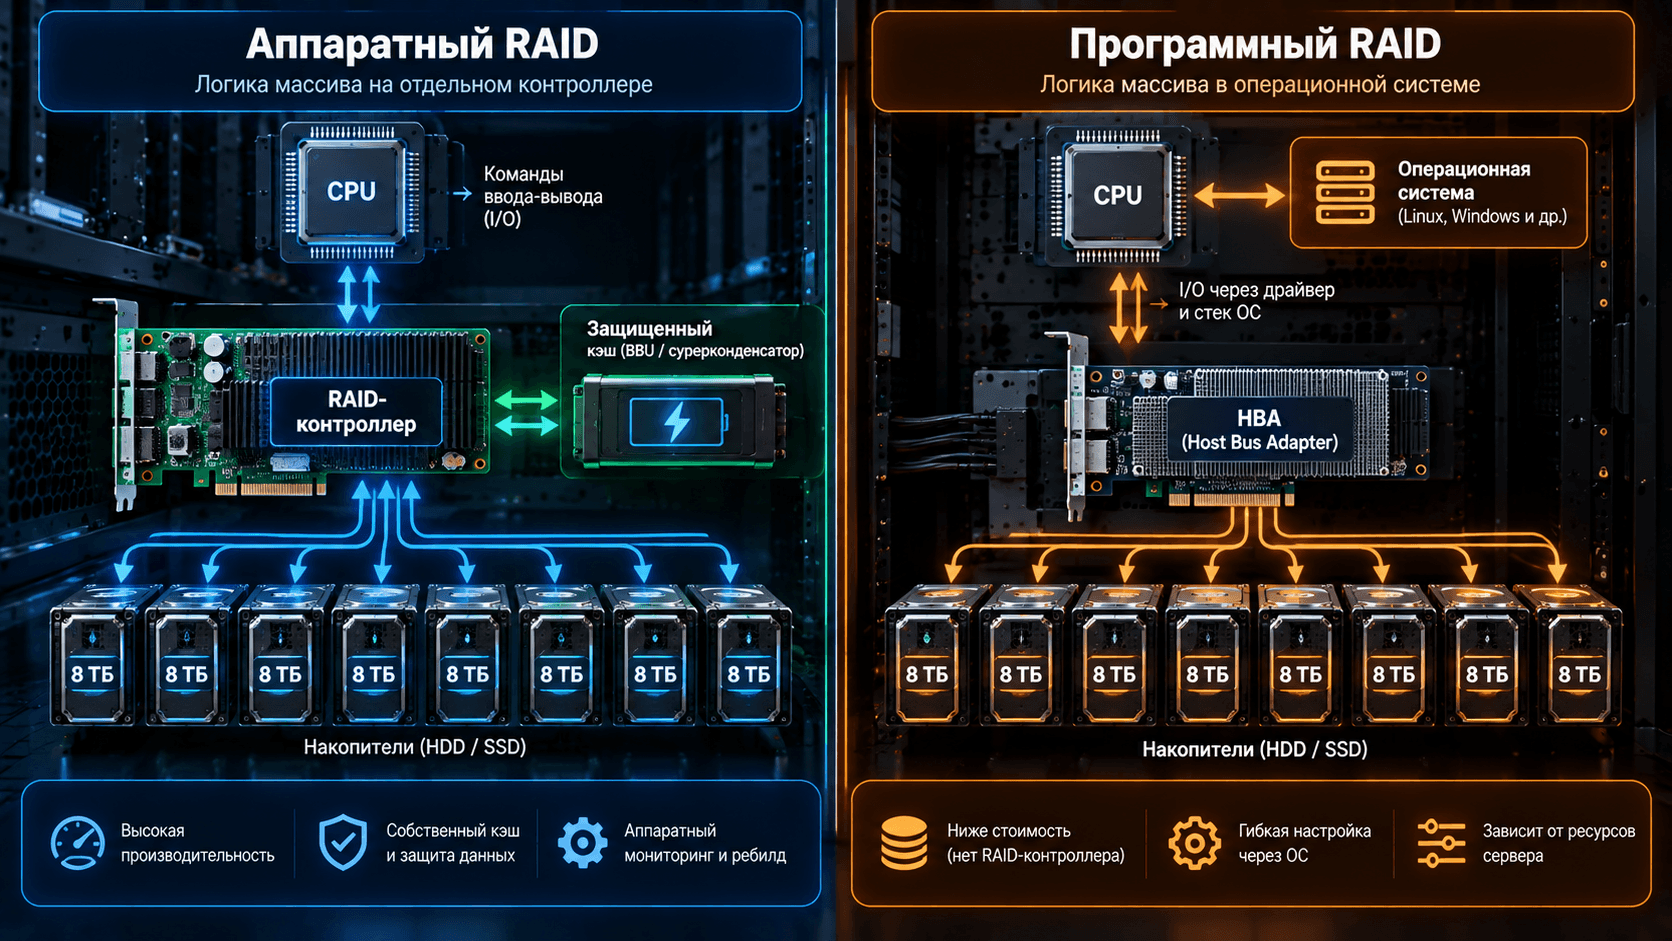
RAID может работать на отдельном контроллере или средствами операционной системы. Выбор архитектуры влияет на кэш, наблюдаемость, перенос массива и восстановление после отказа самого контроллера.
Аппаратный RAID
Аппаратный RAID-контроллер предоставляет серверу готовый виртуальный диск. Он может иметь собственный процессор, память и write-back cache. Кэш записи должен быть защищен батареей или энергонезависимым модулем. Иначе подтвержденные, но еще не записанные на накопители данные могут быть потеряны при отключении питания.
Преимущества зависят от модели контроллера:
независимая от ОС логика массива;
защищенный кэш;
централизованное управление дисками, rebuild и hot spare;
аппаратная поддержка нужных уровней.
Программный RAID
Программный RAID выполняется средствами ОС или storage stack. В Linux распространен MD RAID с управлением через mdadm; LVM также поддерживает RAID-тома. Такой вариант дает ОС прямую видимость устройств и не требует отдельного аппаратного контроллера.
Преимущества программного RAID:
меньше зависимости от конкретной карты;
доступ к telemetry отдельных накопителей;
гибкое управление средствами ОС;
удобство для архитектур, которым нужен HBA и прямой доступ к дискам.
Ограничения определяются реализацией: поддерживаемые уровни, загрузка с массива, поведение после сбоя питания, мониторинг, процедура переноса и нагрузка на CPU. Утверждение, что программный RAID всегда медленнее аппаратного, некорректно без теста.
RAID не заменяет резервное копирование
RAID поддерживает доступность при определенных аппаратных отказах. Backup хранит отдельную восстанавливаемую версию данных. Это разные функции.
RAID не защищает от:
удаления или перезаписи файла;
логического повреждения базы данных;
шифровальщика с доступом к тому;
ошибки администратора;
повреждения файловой системы;
кражи или физической потери сервера;
пожара, затопления или отказа площадки;
ошибки контроллера или firmware, затронувшей весь массив.
Snapshots ускоряют откат, но при хранении на том же массиве остаются в том же домене отказа. Репликация помогает пережить отказ системы или площадки, но может перенести логическое повреждение. Надежная схема сочетает RAID, независимые резервные копии, контроль RPO и RTO и регулярную проверку восстановления.
Что происходит при отказе диска
После отказа массив переходит в degraded mode. RAID 1 читает данные с оставшегося зеркала. RAID 5 и RAID 6 восстанавливают отсутствующие блоки из данных и четности. RAID 10 использует оставшийся диск зеркальной пары.
Когда устанавливают замену, начинается rebuild. Система читает оставшиеся данные и создает содержимое нового накопителя. В этот момент:
растет нагрузка на рабочие диски;
может увеличиться latency приложений;
снижается запас отказоустойчивости;
скрытые ошибки чтения становятся особенно опасными;
слишком агрессивная скорость rebuild может мешать production-нагрузке;
слишком медленный rebuild продлевает период риска.
Когда классический RAID не подходит
Классический RAID рассматривает накопители внутри одного массива. В распределенном хранилище защита может работать на уровне объектов, узлов, стоек и площадок.
Например, erasure coding делит объект на data chunks и coding chunks, размещает их на разных устройствах и восстанавливает данные из оставшихся частей. Репликация хранит несколько полных копий. Такие схемы учитывают домены отказа, которых обычный локальный RAID не видит.
Не следует создавать аппаратный RAID под программной системой, которая ожидает прямого управления дисками, без проверки официальной архитектуры. ZFS, Ceph и другие программно определяемые платформы предъявляют собственные требования к HBA, дискам, кэшу и защите записи.
RAID 50 и RAID 60 объединяют несколько групп RAID 5 или RAID 6 с чередованием. Они применяются в более крупных конфигурациях, но требуют отдельного расчета числа групп, емкости и отказов. Добавлять их в проект только ради большего номера нельзя.
Как создать RAID-массив без опасных упрощений
Конкретные действия зависят от контроллера, ОС и СХД, но порядок проектирования повторяется.
Определите данные и последствия простоя. Зафиксируйте RPO, RTO и допустимое время degraded mode.
Измерьте нагрузку: IOPS, throughput, latency, размер блока, долю чтения и записи, глубину очереди.
Рассчитайте рабочий набор, рост, snapshots, резерв свободной емкости и место под rebuild.
Выберите HDD, SSD или NVMe по интерфейсу, endurance, power loss protection и списку совместимости.
Выберите RAID-уровень по числу допустимых отказов, а не только по полезной емкости.
Проверьте контроллер, HBA, backplane, кабели, firmware и процедуру замены.
Настройте защищенный кэш, hot spare, уведомления и мониторинг.
Создайте независимый backup и проверьте восстановление.
Выполните приемочный тест в нормальном режиме, degraded mode и при rebuild.
Задокументируйте расположение дисков, серийные номера, порядок замены и контакты поддержки.
Команда создания массива сама по себе не завершает проект. Без alerting можно неделями не заметить degraded mode. Без теста восстановления нельзя считать backup рабочим. Без измерения latency во время rebuild нельзя оценить влияние отказа на приложения.
Мониторинг и обслуживание RAID
Состояние массива нужно контролировать постоянно. Нормальный статус логического тома еще не доказывает, что каждый накопитель исправен и резервная копия восстанавливается.
Минимальный набор контроля:
состояние массива и каждого участника;
SMART и vendor telemetry;
media errors, predictive failure и температурные события;
состояние батареи или CacheVault контроллера;
фактическая политика write cache;
наличие и готовность hot spare;
состояние patrol read, scrub или consistency check;
прогресс и скорость rebuild;
latency и очередь I/O;
свободная емкость и износ SSD;
версии firmware контроллера, backplane и накопителей;
доставка оповещений ответственным инженерам.
Типичные ошибки при выборе RAID
Выбирать только по полезной емкости
Формула не показывает latency, write penalty, время rebuild, ресурс SSD и работу в degraded mode. Два массива одинаковой емкости могут давать принципиально разное поведение.
Считать RAID резервной копией
Массив не хранит независимую историю и не изолирует данные от приложения. Backup проектируется отдельно.
Использовать RAID 0 для уникальных данных
RAID 0 допустим только там, где потеря всего тома предусмотрена архитектурой и данные можно восстановить из другого источника.
Включать write-back без защиты кэша
Если контроллер подтверждает запись до сохранения на диски, его кэш должен пережить потерю питания. Состояние BBU или энергонезависимого модуля входит в мониторинг.
Смешивать накопители без проверки
Разные емкости, интерфейсы, sector format, firmware и endurance усложняют массив. В классическом расчете емкость ограничивает самый маленький диск.
Не тестировать отказ и rebuild
Пиковый benchmark исправного массива не показывает работу после отказа. Приемка должна включать контролируемый degraded mode, восстановление, alerting и влияние на приложение.
Как подобрать RAID-контроллер, сервер или СХД
Для локальной дисковой подсистемы проверяют число портов и дисков, SAS, SATA или NVMe, поддерживаемые уровни, защищенный кэш, hot spare, hot-plug, максимальный размер массива, очередь команд и средства мониторинга. Общий состав платформы помогает проверить статья серверное оборудование: что входит и как выбрать.
Для внешнего хранилища одного RAID-уровня недостаточно. Нужны резервные контроллеры, multipathing, snapshots, репликация, сервисная поддержка и план расширения. В каталоге систем хранения данных представлены HDD, гибридные и All-Flash решения с разными архитектурами защиты.
FAQ
Какой RAID самый надежный?
Универсально самого надежного уровня нет. RAID 6 выдерживает любые два отказа дисков в группе. RAID 10 может пережить несколько отказов, если они приходятся на разные зеркальные пары, но теряет массив при отказе обоих участников одной пары. Надежность всей системы также зависит от backup, контроллеров, питания, firmware, мониторинга и процедуры восстановления.
Чем RAID 5 отличается от RAID 6?
RAID 5 хранит один набор распределенной четности и выдерживает отказ одного диска. RAID 6 хранит два набора четности и выдерживает отказ двух дисков. RAID 6 расходует больше емкости и выполняет больше операций при записи.
RAID 5 или RAID 10 лучше для сервера?
RAID 5 эффективнее использует емкость. RAID 10 обычно лучше подходит для интенсивной случайной записи и дает другую модель rebuild. Выбор делается по реальному профилю I/O, допустимым отказам и бюджету емкости.
Сколько дисков нужно для RAID 0, 1, 5, 6 и 10?
Классическому RAID 0 нужно минимум два диска, RAID 1: два, RAID 5: три, RAID 6: четыре, RAID 10: четыре. Реализация конкретного контроллера или программной системы может устанавливать дополнительные ограничения.
Можно ли собрать RAID из дисков разного объема?
Технически некоторые системы это позволяют, но классический массив обычно использует каждый диск в пределах емкости самого маленького участника. Разница может остаться неиспользованной. Также нужно проверить интерфейс, sector format, firmware, скорость и ресурс записи.
Заменяет ли RAID 1 резервную копию?
Нет. Зеркало одновременно повторяет изменения на обоих дисках. Оно не защищает от удаления, повреждения данных приложением, шифровальщика или потери всего сервера.
Что произойдет при отказе RAID-контроллера?
Диски могут остаться физически исправными, но доступ к массиву зависит от совместимости запасного контроллера и формата метаданных. Для критичной системы заранее документируют модель, firmware, процедуру импорта конфигурации и наличие замены.
Нужен ли hot spare?
Hot spare сокращает время до начала rebuild, если система автоматически использует резервный диск. Он не увеличивает полезную емкость и не заменяет backup. Для некоторых современных СХД вместо отдельного spare применяется распределенная резервная емкость.
Ускоряет ли RAID работу дисков?
Некоторые уровни используют параллелизм и могут повысить throughput или число операций. Итог зависит от уровня RAID, профиля запросов, накопителей, контроллера, кэша, интерфейса и режима массива. Ускорение нельзя обещать без измерения.
Рассчитать дисковую подсистему
Для расчета нужны рабочая и прогнозная емкость, IOPS, throughput, latency, размер блока, доля чтения и записи, допустимые отказы, RPO, RTO и план роста. Отдельно фиксируются тип накопителей, архитектура контроллера, backup и требования к работе во время rebuild.
Start Server подбирает серверы и СХД вместе с накопителями, RAID-контроллерами, сетью и средствами защиты данных. Передайте профиль нагрузки через контакты Start Server, чтобы получить конфигурацию и расчет полезной емкости без смешения raw capacity, RAID capacity и доступного приложению объема.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


