GPU-сервер для генерации изображений нельзя корректно подобрать только по названию модели, объёму VRAM или одной цифре seconds/image.
Один сервис генерирует небольшие превью. Другой использует FLUX, ControlNet, LoRA и upscale. Третий обслуживает несколько разных workflow и регулярно переключается между моделями.
Во всех случаях задача называется «генерация изображений», но требования к серверу и очереди будут разными.
Поэтому расчёт лучше строить так:
Главный вопрос не:
Какая GPU быстрее для Stable Diffusion или FLUX?
А:
Сколько времени занимает наш production-workflow, как часто приходят запросы и какую задержку сервис должен выдерживать?
Почему название модели не определяет сервер
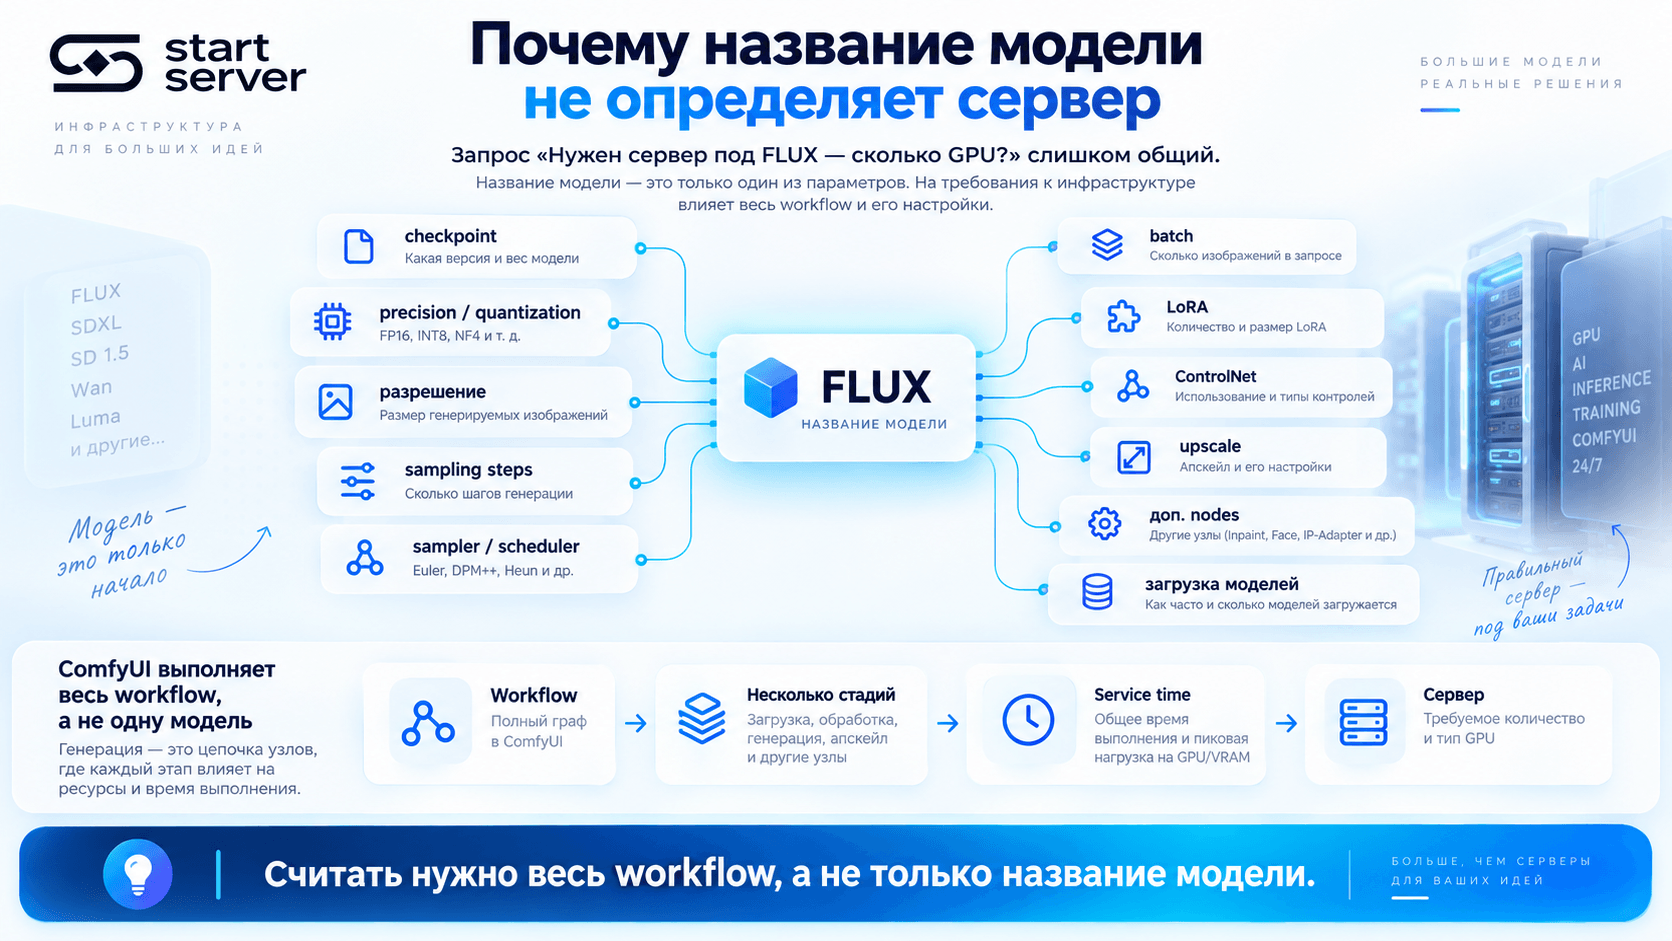
Запрос:
Нужен сервер под FLUX — сколько GPU?
слишком общий.
На время выполнения и потребление памяти могут влиять:
конкретный checkpoint;
precision или quantization;
разрешение;
число sampling steps;
sampler и scheduler;
batch;
LoRA;
ControlNet;
upscale;
дополнительные nodes;
загрузка и выгрузка моделей.
ComfyUI выполняет граф вычислений, поэтому один workflow может включать несколько моделей и стадий обработки.
Для воспроизводимого benchmark нужно фиксировать не только название основной модели, а весь исполняемый workflow.
Сначала зафиксируйте exact workflow
Перед тестом полезно заполнить карточку:
Параметр | Значение |
ComfyUI version / commit | |
Workflow ID / hash | |
Base model / checkpoint | |
Precision / quantization | |
Resolution | |
Steps | |
Sampler | |
Scheduler | |
Batch | |
LoRA | |
ControlNet | |
Upscale / post-processing | |
Custom nodes |
Если между двумя тестами одновременно поменять GPU, resolution и batch, разницу во времени уже нельзя приписать только ускорителю.
При сравнении hardware остальные существенные параметры должны оставаться одинаковыми.
Почему версия ComfyUI и custom nodes тоже важны
ComfyUI и его расширения развиваются независимо друг от друга.
Поэтому запись:
ComfyUI + FLUX
ещё не делает benchmark воспроизводимым.
Желательно сохранить:
версию ComfyUI;
PyTorch;
CUDA или ROCm;
GPU driver;
версии существенных custom nodes;
версии моделей.
Почему второй одинаковый запуск может дать неправильный warm benchmark
ComfyUI умеет кэшировать результаты графа и при повторном запуске переисполнять те части, которые считает неизменившимися.
Из-за этого схема:
запустили workflow дважды, второй результат считаем warm latency
может измерять кэш, а не новую генерацию.
Для корректного warm benchmark нужно гарантировать, что измеряемая generation path действительно выполняется повторно.
Например, в типичном diffusion workflow можно изменить seed, сохранив:
модель;
resolution;
steps;
sampler;
batch;
остальные вычислительные параметры.
Но seed — только пример. В конкретном workflow нужно убедиться, что изменённый input действительно инвалидирует измеряемую часть graph.
Cold, warm и model-switch — разные режимы
Для production sizing полезно измерять несколько состояний.
Cold
Worker заранее приведён в определённое исходное состояние, где необходимые модели ещё нужно загрузить или подготовить.
Важно описать это состояние точно: например, новый process или явно выгруженные модели.
Warm
Нужные модели уже находятся в предполагаемом steady-state, но сам generation path действительно пересчитывается.
Это основной режим для оценки постоянного потока однотипных запросов.
Model-switch
Worker до этого обслуживал другой набор моделей или workflow и переключается на новый.
Такой тест нужен только тогда, когда подобные переключения реально встречаются в production.
Почему model switching может быть важен
Сравним два сервиса.
Первый постоянно выполняет один workflow.
Второй переключается между:
Вторая система может тратить дополнительное время на управление размещением моделей между GPU и системной памятью.
Поэтому benchmark из ста одинаковых последовательных запросов хорошо описывает первый сценарий, но может плохо отражать второй.
Если production использует несколько model families, переключения нужно включить в workload profile.
Что измерять на одном workflow
Для каждого режима полезно сохранять:
Метрика | Значение |
Mean service time | |
p50 service time | |
p95 service time | |
Images/request | |
Peak VRAM | |
Peak RAM, если существенно | |
OOM / errors | |
State | cold / warm / switch |
Один успешный запуск недостаточен.
Mean нужен для расчёта среднего объёма нагрузки, а p50 и p95 помогают увидеть типичное время и медленный tail.
Количество повторов должно быть достаточным для устойчивой оценки выбранных percentile и одинаковым по методике для сравниваемых конфигураций.
Seconds per image и latency request — разные показатели
Предположим, один request создаёт четыре изображения.
Полный workflow выполняется за:
20 секунд.
Можно вычислить:
20 / 4 = 5 секунд на изображение.
Это полезная нормализованная throughput-метрика.
Но пользователь получил результат примерно через:
20 секунд execution, а не через пять.
Поэтому нужно хранить как минимум:
Throughput и latency отвечают на разные вопросы
Throughput
Сколько requests или изображений система завершает за единицу времени.
Worker service time
Сколько worker занят выполнением конкретного request после его получения из очереди.
Queue wait
Сколько request ждёт свободного worker.
End-to-end latency
Полное время от поступления запроса до момента, когда результат доступен пользователю или вызывающему сервису.
Высокий images/hour не гарантирует хорошую пользовательскую latency.
Как batch влияет на sizing
Для каждого candidate batch полезно одновременно измерять:
service time request;
images/request;
images/hour;
peak VRAM.
Большой batch может повысить throughput, но одновременно:
увеличить latency одного request;
занять больше VRAM;
ухудшить время ответа интерактивного сервиса.
Кроме того:
batch из четырёх изображений не равен четырём независимым пользователям.
Это один batched workload, а не четыре отдельных места в очереди.
VRAM — compatibility gate, а не capacity metric
Объём памяти отвечает на вопрос:
может ли workflow работать в выбранной конфигурации?
Но не отвечает:
сколько production-запросов сервер выдержит за час?
ComfyUI может использовать разные стратегии размещения моделей между GPU и RAM. Поэтому workflow иногда способен завершиться даже при активном offload.
Это позволяет разделить:
Memory PASS
Workflow выполняется без неприемлемого OOM или другого memory failure.
Performance PASS
Workflow выполняется с нужным service time.
Успешный запуск сам по себе ещё не означает, что GPU подходит по производительности.
Почему peak VRAM нужно смотреть вместе со временем
Две конфигурации могут обе выполнить один workflow.
Но одна держит нужные компоненты ближе к GPU и работает быстрее.
Другая активнее использует offload и также проходит Memory PASS, но имеет другую latency.
Поэтому benchmark должен сохранять вместе:
Первый грубый расчёт service capacity
Для одного последовательного worker с фиксированным warm workload можно получить первый ориентир.
Если среднее worker service time:
20 секунд/request
то приблизительная steady-state service capacity:
3600 / 20 = 180 requests/hour.
Если каждый request создаёт четыре изображения:
180 × 4 = 720 images/hour.
Это не характеристика самой GPU.
Это результат связки:
worker + workflow + software stack + hardware + benchmark settings.
И это ещё не расчёт пользовательской очереди.
Почему 3600 / seconds не определяет production SLA
Реальный сервис имеет:
burst traffic;
разные workflow;
cold и model-switch events;
вариативное service time;
ошибки и retry;
разные batch.
Поэтому:
Requests/hour ≈ 3600 / mean service time
полезно только как первый steady-state sanity check для одного serial worker.
Нельзя делать вывод:
входящий поток меньше этого числа — значит очереди не будет.
Как оценить средний service demand
Для одного класса:
Worker service-seconds/hour = requests/hour × mean worker service time
Например:
100 requests/hour × 20 sec = 2000 worker service-seconds/hour.
Один постоянно доступный serial worker теоретически располагает:
3600 service-seconds/hour.
Для нескольких классов:
Total service demand = Σ(request rate × mean service time)
Это показывает средний объём работы, который должны выполнить workers.
Но это не GPU utilisation: внутри service time могут присутствовать CPU stages, transfers и другие операции.
Как оценить среднюю занятость worker pool
Если в системе C одинаковых worker slots:
Если эта величина приближается к 100%, у системы остаётся всё меньше возможности поглощать локальные всплески.
Если она превышает 100%, в простой устойчивой модели incoming work в среднем приходит быстрее, чем workers способны его обработать.
Но даже значение значительно ниже 100% не гарантирует хороший p95 queue wait.
Для SLA нужно учитывать распределение запросов во времени.
Почему средняя нагрузка не определяет очередь
Допустим, два сервиса получают:
100 requests/hour.
В первом запросы приходят относительно равномерно.
Во втором большая часть поступает за несколько минут после запуска кампании или пакетного задания.
Средний объём одинаковый.
Очередь — разная.
Поэтому traffic profile должен сохранять:
average requests/hour;
peak rate на достаточно коротком интервале;
burst duration.
Конкретную гранулярность выбирают по характеру реального сервиса.
Почему нет универсальной «правильной» загрузки
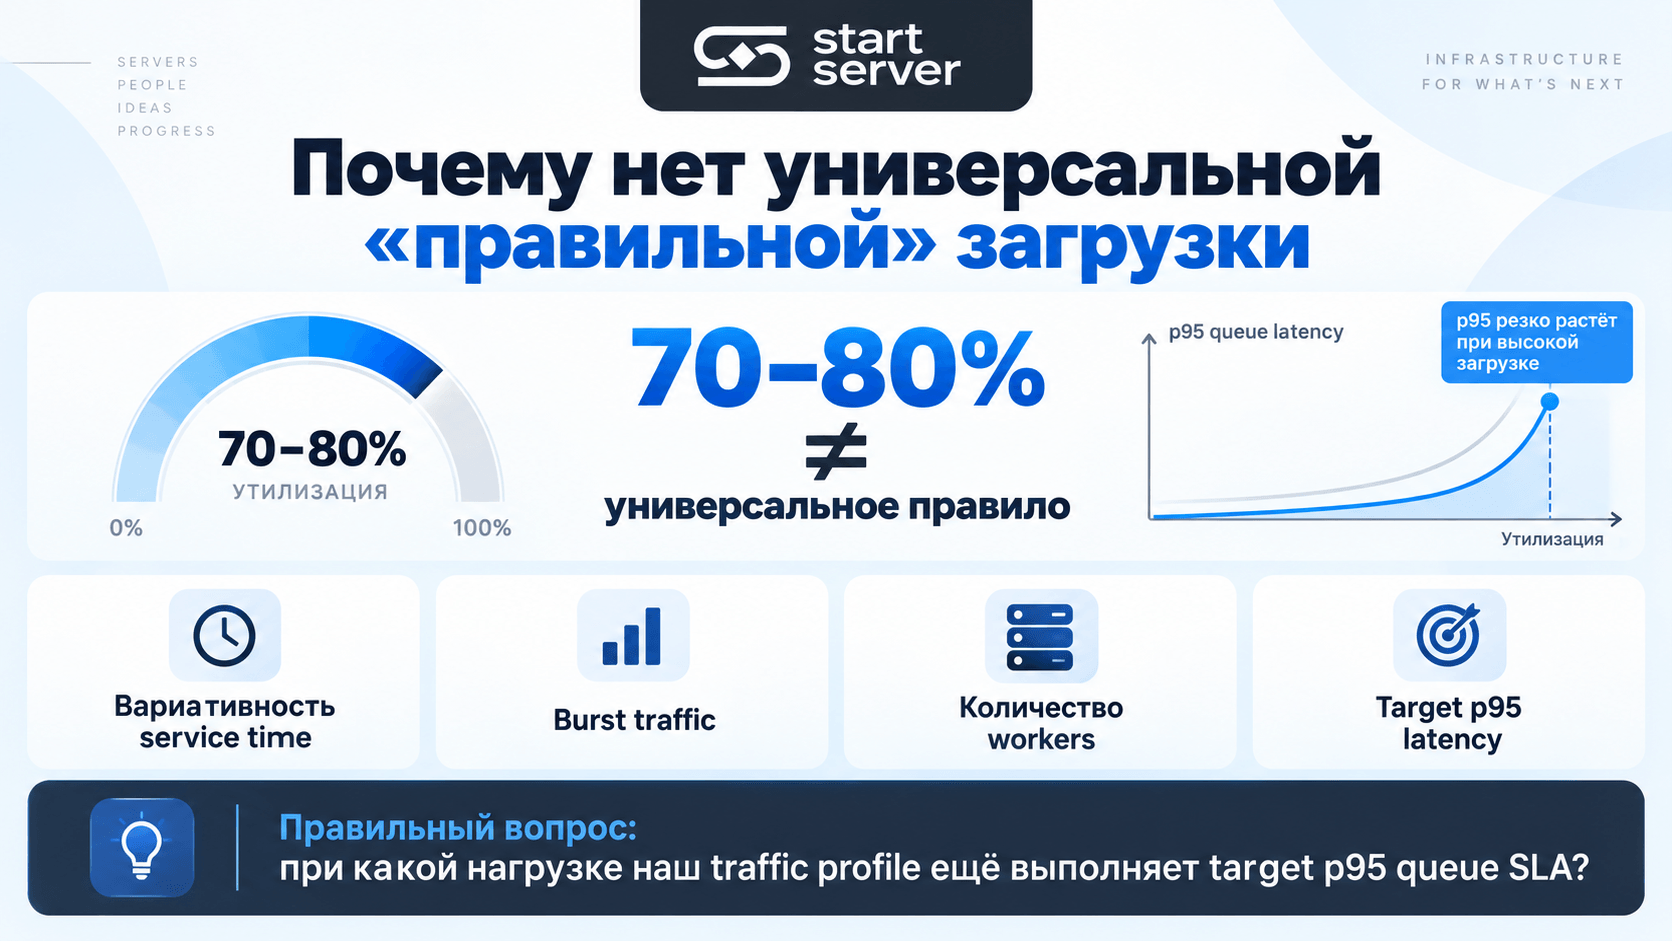
Иногда capacity рассчитывают по правилу:
держать workers загруженными не более чем на 70–80%.
Универсального числа здесь нет.
Допустимая средняя занятость зависит от:
вариативности service time;
burst traffic;
количества workers;
target p95 latency.
При одной нагрузке высокая средняя занятость может оставаться приемлемой.
При другой уже возникают длинные очереди.
Правильный вопрос:
при какой нагрузке наш конкретный traffic profile ещё выполняет target p95 queue SLA?
Это проверяется load test, trace replay или достаточно подробной queue simulation.
Workflow mix важнее одного «среднего workflow»
Production-сервис редко выполняет абсолютно одинаковые запросы.
Полезно выделить classes.
Например:
Класс | Доля запросов | Mean service | p50 | p95 | Peak VRAM |
Preview | |||||
Standard | |||||
High-resolution | |||||
Control-guided | |||||
Upscale |
Это только шаблон.
Реальные classes определяются production workload.
Почему p95 особенно важен
Представим workload:
большинство requests выполняется за 5 секунд;
небольшая часть — за 60 секунд.
Одно среднее значение скрывает эту разницу.
Если длинный request оказывается перед несколькими короткими в serial queue, они будут ждать его завершения.
Поэтому полезно измерять отдельно:
p50/p95 service time
и:
p50/p95 queue wait.
При этом p95 очереди нельзя получить просто из p95 execution. Для этого нужен arrival profile и load test или traffic replay.
Как ComfyUI использует очередь
ComfyUI позволяет асинхронно добавлять prompts в очередь.
Важно не путать:
асинхронную постановку requests
и:
Стандартный worker последовательно получает queued prompt, выполняет его и затем переходит к следующему.
Поэтому наличие четырёх GPU в сервере само по себе ещё не означает четыре одновременно обслуживаемых request.
GPU count и worker count — разные параметры
Production architecture должна отдельно определить:
число worker processes;
какие GPU доступны каждому worker;
какие модели размещены на каждом worker;
как requests маршрутизируются.
Следовательно:
GPU count ≠ worker count.
Для чистого hardware baseline удобно начать с:
1 worker → 1 GPU.
Это не обязательная production architecture, а понятная отправная точка для benchmark.
После неё уже можно отдельно тестировать:
несколько workers на GPU;
несколько worker pools;
routing;
model affinity.
Почему несколько workers на одной GPU нужно проверять нагрузочным тестом
На первый взгляд кажется:
два workers дадут вдвое больше throughput.
Но они могут конкурировать за:
VRAM;
compute;
memory bandwidth;
runtime resources.
В результате:
throughput может вырасти;
p95 latency может ухудшиться;
может появиться OOM;
выигрыш может быть минимальным.
Почему тяжёлый workflow задерживает короткий
Представим, что serial worker начал high-resolution job на 60 секунд.
За ним в очереди стоит preview, который сам выполняется пять секунд.
Execution preview действительно короткий, но пользователь сначала ждёт завершения предыдущего job.
Именно поэтому:
быстрый workflow ≠ быстрый сервис.
Если разные classes имеют очень разные SLA, можно проверить:
отдельные worker pools;
routing;
model affinity.
Но необходимость такой архитектуры должна подтверждаться workload и load test.
Когда стоит проверить model affinity
Если model-switch benchmark показывает заметный overhead, можно протестировать архитектуру, где определённые workers обслуживают фиксированные model families.
Это способно уменьшить частоту переключений.
Но model affinity — не универсальное правило.
Если switching почти ничего не стоит в конкретной конфигурации, дополнительное разделение pool может не дать выгоды.
Как измерять очередь
Для каждого request полезно сохранить четыре timestamp:
enqueue — запрос принят в очередь;
start — worker начал обработку;
end — worker завершил workflow;
ready — результат доступен потребителю.
Тогда:
Queue wait = start − enqueue
Worker service time = end − start
End-to-end latency = ready − enqueue
При необходимости:
Важно один раз определить, что именно означает ready для конкретного сервиса, и использовать эту границу во всех тестах.
Почему внутреннее время execution — не пользовательская latency
Если ComfyUI сообщает:
Prompt executed in 12 seconds,
это не означает, что пользователь получил результат через 12 секунд.
Request мог до этого провести, например, 40 секунд в очереди.
Поэтому production monitoring должен начинать измерение с enqueue, а не только с момента начала работы worker.
Image Generation Queue Capacity Calculator
1. Workflow
Параметр | Значение |
Workflow class | |
ComfyUI version | |
Model | |
Resolution | |
Steps | |
Batch | |
Images/request | |
Peak VRAM |
2. Benchmark
Параметр | Значение |
State | cold / warm / switch |
Mean service time | |
p50 service time | |
p95 service time | |
Errors/OOM |
3. Traffic
Параметр | Значение |
Average requests/hour | |
Peak request rate | |
Burst duration | |
Workflow mix | |
Retry rate, если существенен |
4. Architecture
Параметр | Значение |
GPU count | |
Worker count | |
Workers/GPU | |
Routing | |
Model affinity |
5. SLA
Параметр | Значение |
Target p50 queue wait | |
Target p95 queue wait | |
Target p95 service time | |
Target p95 E2E | |
Required images/hour |
6. Результат
Метрика | Значение |
Worker service-sec/hour demand | |
Average worker-time utilisation | |
p50 queue wait | |
p95 queue wait | |
p95 end-to-end latency | |
Requests/hour | |
Images/hour | |
Error rate | |
PASS / FAIL |
Как провести benchmark
Практический протокол:
Зафиксировать версию ComfyUI и runtime.
Зафиксировать custom nodes.
Сохранить workflow JSON или hash.
Зафиксировать модели и параметры generation.
Зафиксировать cache и memory/offload policy.
Проверить Memory PASS.
Воспроизводимо измерить cold state.
Измерить warm state с реальным recompute нужной generation path.
Измерить model-switch, если он присутствует в production.
При необходимости выполнить batch sweep.
Отдельно проверить несколько workers/GPU.
Взять реальные traffic timestamps или описанный проектный burst scenario.
Выполнить load test или trace replay.
Сохранить p50/p95 queue wait и end-to-end latency.
Почему benchmark GPU и load test — не одно и то же
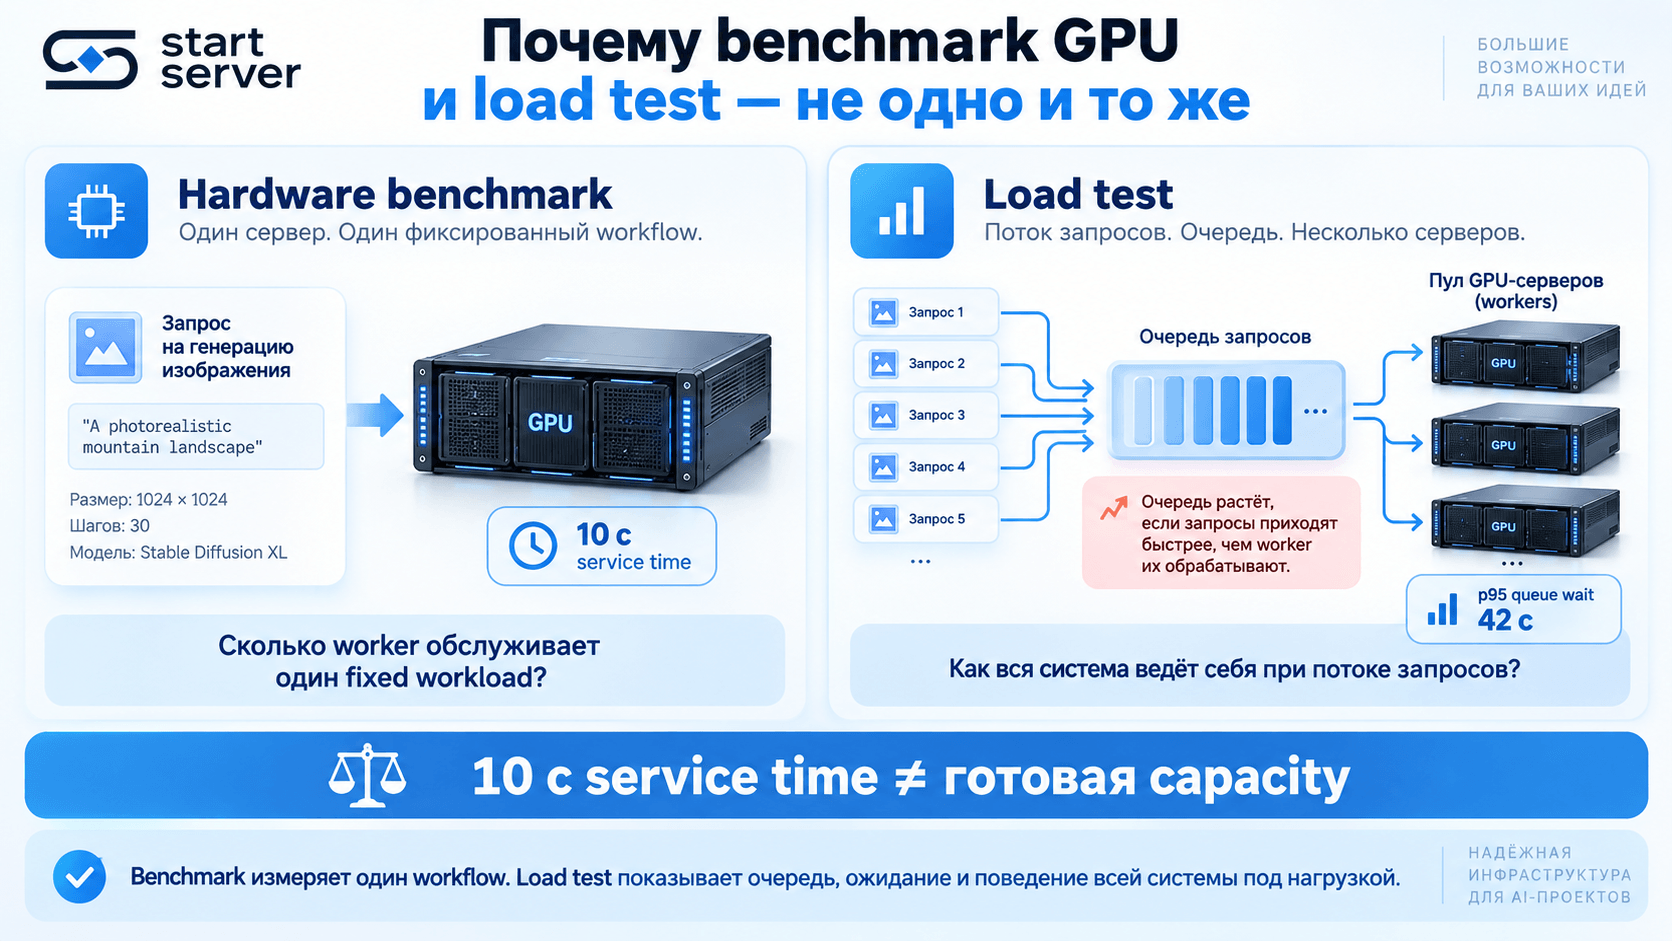
Hardware benchmark отвечает:
сколько worker обслуживает один fixed workload?
Load test отвечает:
как вся система ведёт себя при потоке запросов?
Можно измерить:
10 секунд service time
для одного workflow.
Но если новые requests приходят быстрее, чем worker pool их завершает, queue wait будет увеличиваться.
Поэтому server capacity нельзя квалифицировать только одиночным benchmark.
Когда действительно может не хватать capacity
На нехватку service capacity могут указывать ситуации, когда:
workers большую часть времени заняты;
очередь устойчиво увеличивается;
p95 queue wait выходит за target;
средний входящий service demand приближается к доступному worker-time или превышает его;
добавление worker/GPU capacity сокращает очередь при неизменном workload.
Но окончательный вывод лучше подтверждать нагрузочным тестом.
Высокая GPU utilisation сама по себе такого вывода не доказывает.
Когда проблема может быть не в количестве GPU
Симптом | Что проверить |
Cold значительно медленнее warm | загрузку моделей, RAM и storage |
Model switch медленный | residency и offload |
Warm workflow сам медленный | GPU или сложность workflow |
GPU свободны, а queue есть | worker mapping и routing |
p50 хороший, p95 плохой | bursts и heavy tail |
Batch повышает throughput, но SLA хуже | request latency |
Несколько workers/GPU хуже одного | contention |
Heavy workflow задерживает previews | общую serial queue |
Второй identical run почти мгновенный | graph caching |
Таблица показывает направление диагностики, а не автоматически доказывает bottleneck.
Что считать PASS
Одного:
workflow запустился
недостаточно.
Memory PASS
Representative workflow работает без неприемлемого OOM или memory degradation.
Service-time PASS
p95 worker service time соответствует target.
Queue PASS
p95 queue wait соответствует SLA.
End-to-end PASS
p95 полного пользовательского времени ответа укладывается в требования.
Throughput PASS
Система выдерживает необходимое количество requests или images на representative traffic.
Stability PASS
Под нагрузкой нет неприемлемого:
error rate;
OOM;
неконтролируемого роста backlog.
Какие данные нужны для подбора GPU-сервера
Перед переходом к конкретной аппаратной конфигурации полезно подготовить:
Данные проекта | Значение |
Workflow classes | |
Models / checkpoints | |
Resolution | |
Steps | |
Batch | |
Mean / p50 / p95 service time | |
Peak VRAM | |
Cold / model-switch overhead | |
Average requests/hour | |
Peak request rate | |
Burst duration | |
Workflow mix | |
Target p95 queue wait | |
Target p95 E2E | |
Required throughput | |
Planned worker/GPU mapping |
После этого вопрос:
Какой сервер нужен для FLUX или Stable Diffusion?
можно заменить на измеримое требование:
Нужно обслуживать такой набор workflows при таком traffic profile, сохраняя заданные p95 queue wait, end-to-end latency и throughput.
После этого можно переходить к подбору GPU-сервера для рендеринга и графических задач.
Главное
Сервер для генерации изображений рассчитывают не по названию модели, не по объёму VRAM и не по одной цифре seconds/image.
Сначала фиксируют exact workflow:
Затем отдельно измеряют:
cold → warm → model-switch, если он присутствует в production.
Warm benchmark должен действительно пересчитывать нужную generation path: полностью неизменённый ComfyUI graph может использовать cached results.
После этого measured worker service time соединяют с:
requests/hour → bursts → workflow mix → worker architecture.
Средний worker-time demand показывает только первый capacity gate.
Финальное количество GPU и workers подтверждают по:
p95 queue wait + p95 end-to-end latency + throughput + stability
на representative production load.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


