Для LoRA и QLoRA нельзя надёжно выбрать GPU только по числу параметров модели.
Запись:
модель: 14B
метод: QLoRA
ещё не определяет peak VRAM.
Во время training память расходуется как минимум на frozen base model, trainable adapters, gradients, optimizer state и activations. Кроме того, отдельные операции создают временные tensors, которые могут сформировать peak и вызвать OOM, хотя постоянные данные формально помещаются.
Поэтому сервер для LoRA или QLoRA нужно рассчитывать так:
exact model + revision
↓
exact LoRA / QLoRA recipe
↓
actual trainable parameters
↓
base storage / quantization
↓
adapter + gradient + optimizer state
↓
microbatch + sequence shapes
↓
activations
↓
temporary/runtime memory
↓
full training-step measurement
↓
validated VRAM requirement
Главное правило:
Из чего складывается VRAM при LoRA и QLoRA
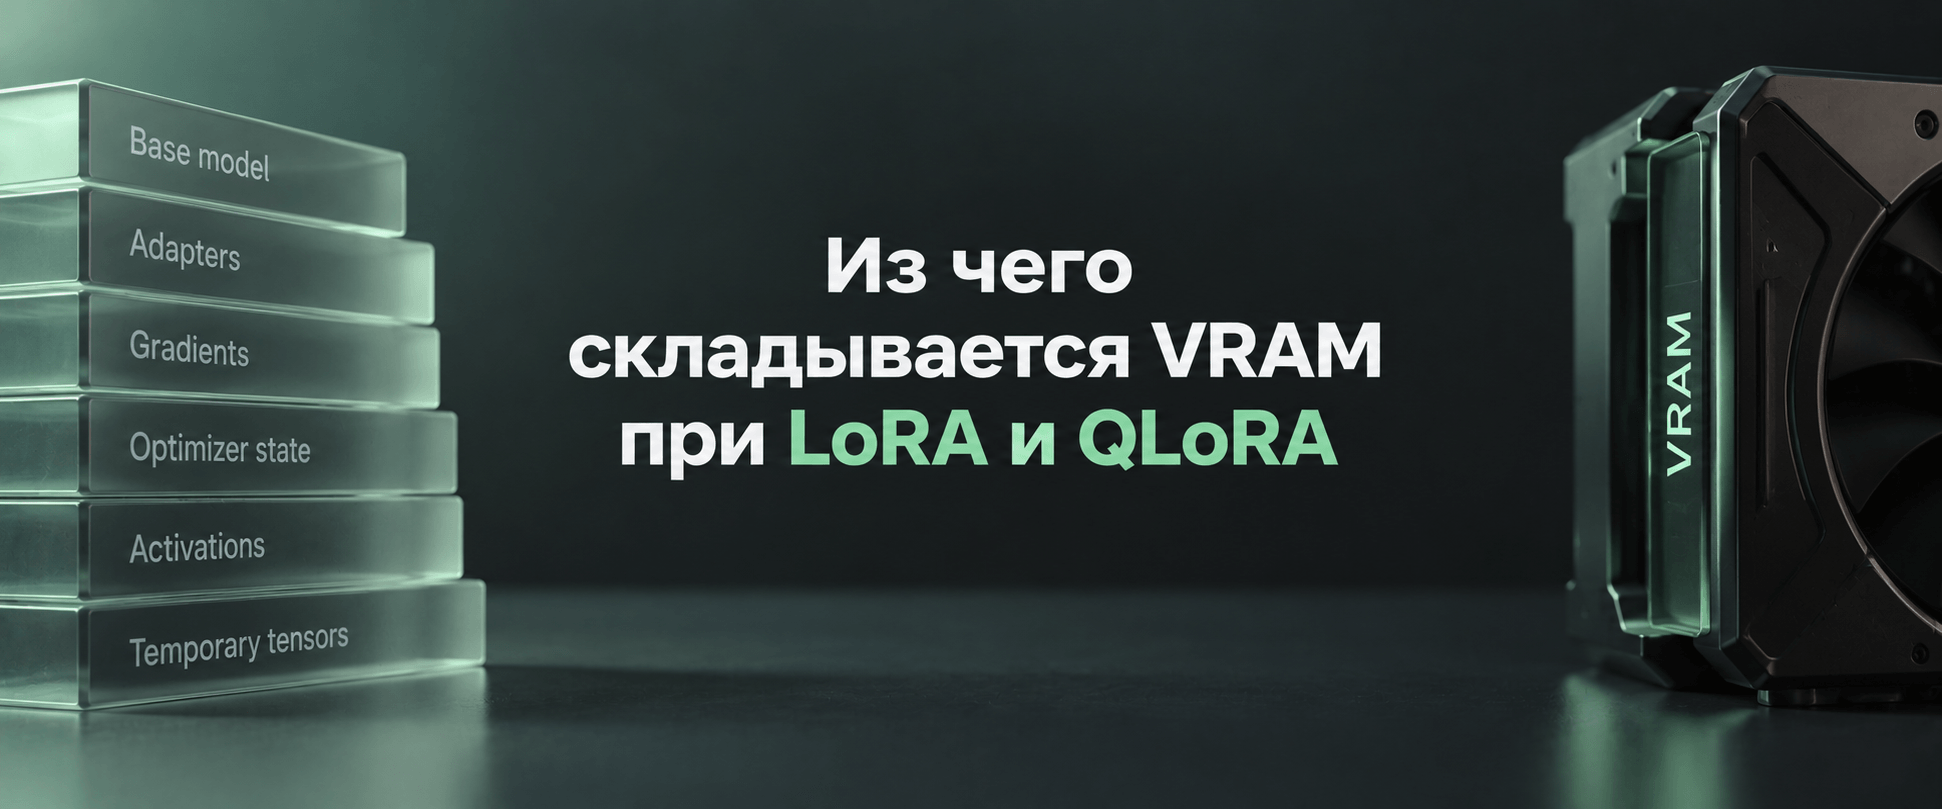
Для sizing удобно вести отдельный memory ledger:
Компонент | Что с ним делать |
Frozen base model | рассчитать/измерить resident footprint |
LoRA adapters | получить actual trainable params и dtype |
Gradients | считать по фактическим trainable tensors и dtype |
Optimizer state | считать по exact optimizer implementation |
Activations | измерять на representative training workload |
Temporary tensors | учитывать в measured peak |
Allocator/runtime | контролировать отдельными memory metrics |
Это важнее универсального показателя вроде:
VRAM = N bytes × model parameters
Такая формула может описывать конкретную часть training state, но не весь training peak.
Что именно меняет LoRA
При PEFT LoRA основная pretrained model остаётся frozen, а Trainer обновляет adapter parameters с requires_grad=True.
То есть вместо:
все параметры модели
→ gradients
→ optimizer state
получаем:
BASE MODEL
frozen
resident for computation
+
ADAPTER STATE
trainable parameters
gradients
optimizer state
Это и создаёт основной memory advantage LoRA относительно full-parameter fine-tuning.
Как рассчитать число LoRA parameters
Для обычного linear layer:
W∈Rdout×dinW \in \mathbb{R}^{d_{out}\times d_{in}}
standard LoRA добавляет две low-rank matrices. При rank r число trainable values:
PLoRA=r(din+dout)P_{LoRA}=r(d_{in}+d_{out})
Для нескольких standard linear targets:
PLoRA,total=∑jrj(din,j+dout,j)P_{LoRA,total} = \sum_j r_j(d_{in,j}+d_{out,j})
Это полезная и прозрачная формула.
Но только при условии, что мы действительно знаем exact target modules и их shapes.
PEFT прямо указывает, что число trainable LoRA parameters определяется rank и размером исходных matrices, а target_modules определяет, где adapters создаются.
Почему LoRA rank сам по себе ничего не гарантирует
Две конфигурации могут иметь одинаковое:
r = 16
но одна target'ит:
q_proj
v_proj
а другая:
all-linear
Количество adapter parameters будет различаться.
PEFT поддерживает target_modules="all-linear" для QLoRA-style configuration; современные версии также умеют target'ить непосредственно отдельные parameters, что особенно важно для некоторых MoE architectures.
Поэтому minimum configuration:
Rank:
Rank pattern:
Target modules:
Target parameters:
Bias:
Modules to save:
Actual trainable params:
Где заканчивается формула r(din+dout)
Она подходит для стандартной LoRA-пары обычного linear module.
Она не должна автоматически применяться к:
MoE expert tensors необычной формы
target_parameters
дополнительным modules_to_save
trainable biases
другим PEFT extensions
Если architecture нетипична, правильный workflow:
instantiate model
↓
inject exact adapter
↓
inspect actual trainable state
а не попытка восстановить всю configuration из marketing label модели.
lora_alpha не является множителем памяти
В PEFT r задаёт rank low-rank matrices, а lora_alpha — scaling update.
Поэтому формула:
memory ∝ rank × lora_alpha
некорректна.
Если targets не меняются, повышение lora_alpha само по себе не означает пропорционального роста числа LoRA parameters.
Как посчитать память adapter weights
Когда actual trainable parameter count известен:
AdapterBytes=Ptrain×BadapterAdapterBytes= P_{train}\times B_{adapter}
где B_adapter — фактическое число bytes одного adapter value.
То есть нужны две реальные величины:
Actual trainable params:
...
Actual adapter dtype:
...
Что именно делает QLoRA
PEFT описывает QLoRA как 4-bit quantized base model, поверх которой выполняется LoRA training. При этом конфигурация отдельно задаёт quantization type, double quantization и compute dtype. Например, 4-bit storage может сочетаться с BF16 computation.
Следовательно:
QLoRA
не означает:
base weights = 4-bit
adapters = 4-bit
gradients = 4-bit
optimizer = 4-bit
activations = 4-bit
Корректная конфигурация выглядит так:
Слой | Что фиксировать |
Base model | quantized storage |
Quantization | NF4 / FP4 / другое |
Compute | actual compute dtype |
Adapter | actual parameter dtype |
Gradients | actual runtime dtype |
Optimizer | state format |
Поэтому одного поля:
Precision: 4-bit
недостаточно.
Почему 0.5 byte × parameters не равно QLoRA VRAM
Арифметически:
4 bits=0.5 byte4\ bits = 0.5\ byte
Поэтому для P чистых packed 4-bit values:
Payload4bit=P×0.5Payload_{4bit}=P\times0.5
Но эта величина описывает только соответствующий слой представления base weights.
Она не включает:
LoRA adapters
gradients
optimizer state
activations
temporary tensors
runtime allocations
Поэтому нельзя получить полный QLoRA training requirement формулой:
model parameters × 0.5 byte
и закончить sizing на этом.
Gradients нужно считать отдельно
Для trainable parameters в backward появляются gradients.
Рабочая формула:
GradientBytes=Pgrad×BgradientGradientBytes = P_{grad}\times B_{gradient}
Но B_gradient должен быть подтверждён exact stack.
Transformers приводит 4 bytes/parameter для gradients в конкретной описанной mixed-precision training model, однако это не основание переносить такую константу на любой PEFT/runtime combination.
Поэтому ledger:
Parameters with gradients:
...
Gradient dtype:
VERIFIED / MEASURED
Gradient memory:
...
Если dtype ещё неизвестен:
CONFIGURATION-SPECIFIC
лучше ложной точности.
Как учитывать optimizer state
Для классического Adam характерны два moment tensors.
В типичном варианте с двумя FP32 states:
OptimizerMoments=Poptimized×2×4OptimizerMoments= P_{optimized}\times2\times4
то есть:
8 bytes/optimized parameter8\ bytes/optimized\ parameter
для этих двух состояний.
Transformers использует такую модель для standard Adam memory anatomy.
В статье всегда нужны:
Exact optimizer:
...
Optimized parameters:
...
State format:
...
Frozen base не должен автоматически получать optimizer state
В LoRA base weights frozen. Transformers Trainer с PEFT обновляет adapter parameters с requires_grad=True.
Поэтому перед memory calculation полезно проверить одновременно:
requires_grad
и
optimizer.param_groups
Если optimizer неожиданно получил дополнительные trainable tensors, memory ledger должен отражать фактическую configuration, а не ожидание автора.
Что даёт 8-bit optimizer
bitsandbytes хранит optimizer states в более компактном формате, но есть важные ограничения.
Во-первых, экономия относится к optimizer state, а не к activation memory. Сама bitsandbytes документация отдельно отмечает, что при workload, где memory в основном потребляют activations, 8-bit optimizer даёт гораздо меньший общий эффект.
Во-вторых, небольшие parameter tensors по умолчанию могут оставаться 32-bit; документация указывает порог 4096 элементов как default.
Поэтому нельзя написать:
Adam8bit =
ровно 25% памяти Adam
для любой LoRA configuration.
Microbatch, accumulation и global batch — разные величины
Для memory sizing особенно важно не смешивать:
PER-DEVICE MICROBATCH
GRADIENT ACCUMULATION
GLOBAL EFFECTIVE BATCH
Transformers описывает gradient accumulation как последовательное выполнение нескольких mini-batches с накоплением gradients до optimizer update.
Для обычной data-parallel scheme удобно использовать:
Bglobal=Bmicro×Gacc×NDPB_{global} = B_{micro} \times G_{acc} \times N_{DP}
где N_DP — число data-parallel replicas.
Но это формула для effective training batch, не для activation peak.
Почему accumulation не превращает microbatch 1 в activation batch 16
Пусть:
per-device microbatch = 1
gradient accumulation = 16
Это не означает:
activations in VRAM
=
microbatch 16
Trainer выполняет forward/backward следующего mini-batch после предыдущего, сохраняя накопленные gradients; именно за счёт такого последовательного выполнения gradient accumulation позволяет получить больший effective batch без true large-batch activation footprint.
Поэтому для VRAM first-class input:
Per-device microbatch:
а accumulation хранится отдельной строкой.
Почему sequence length так сильно влияет на память
Activations зависят от batch size, sequence length, depth и hidden size. Transformers также отмечает, что vanilla attention может материализовать крупные attention-score matrices, а современные attention backends меняют этот memory behavior.
Поэтому нельзя использовать универсальную формулу:
ActivationVRAM =
constant × sequence²
для любого stack.
Нужны:
Architecture:
Attention implementation:
Microbatch:
Actual sequence shapes:
Checkpointing:
и measured activation peak.
max_length — это ещё не workload
Например:
max_length = 4096
не означает автоматически, что каждый sample фактически занимает 4096 tokens.
TRL SFTTrainer поддерживает packing нескольких examples в fixed-length sequences, отдельные packing strategies и padding-free execution.
Поэтому training intake:
Configured max length:
Observed sequence p50:
Observed sequence p95:
Packing:
ON / OFF
Packing strategy:
Padding-free:
ON / OFF
сильнее одной строки context = 4096.
Gradient checkpointing уменьшает activations, но требует recomputation
При обычном forward intermediate activations сохраняются для backward.
Gradient checkpointing оставляет только часть из них, а остальные повторно вычисляет при backward. Это снижает activation memory ценой дополнительного compute.
То есть:
checkpointing ON
↓
stored activations ↓
recomputation ↑
Но статья не должна обещать:
VRAM −30%
или любой другой фиксированный процент.
Корректное сравнение:
Режим | Peak VRAM | Step time / throughput |
Checkpointing OFF | ||
Checkpointing ON |
на одном model, workload и software stack.
Activation offload тоже меняет смысл «помещается в GPU»
Современный Transformers checkpointing может размещать часть saved activations в host memory, освобождая device memory ценой host↔device transfers и более медленного step.
Поэтому при offload нужно фиксировать:
GPU peak:
...
Host RAM:
...
Offload mode:
...
Step time:
...
Иначе две configurations не являются прямым сравнением.
Почему успешная загрузка модели ещё ничего не доказывает
Training проходит несколько фаз:
load model
↓
inject adapters
↓
create optimizer
↓
forward
↓
loss
↓
backward
↓
optimizer step
Activations и temporary tensors появляются уже после загрузки weights, а optimizer state тоже может увеличивать memory footprint. Transformers прямо отмечает, что activation или temporary peak способен вызвать OOM, даже если model weights помещаются.
Поэтому критерий validation:
Почему рассчитанный subtotal может быть меньше peak
Допустим, мы рассчитали:
Frozen base
+
Adapter parameters
+
Gradients
+
Optimizer state
Это ещё не peak.
Short-lived tensors во время matrix multiplication, attention, softmax и других operations способны временно поднять memory consumption.
Поэтому не используем:
Subtotal × 1.10
как универсальный overhead.
Вместо этого:
Calculated subtotal:
...
Measured peak:
...
Difference:
...
Known explanation:
YES / NO
Как измерять peak GPU memory
Для PyTorch полезны как минимум две разные peak metrics.
torch.cuda.memory.max_memory_allocated() возвращает maximum GPU memory, занятую tensors.
torch.cuda.memory.max_memory_reserved() показывает peak memory, которой управлял caching allocator.
Поэтому:
Peak allocated:
...
Peak reserved:
...
не являются дубликатами.
Почему нужен ещё device-level observation
PyTorch memory profiler видит allocations, управляемые его allocator, но прямые allocations внешних CUDA libraries могут не попадать в этот профиль. PyTorch отдельно приводит NCCL как пример такой памяти.
Поэтому в validation report полезно хранить:
PyTorch peak allocated
PyTorch peak reserved
device/process memory
особенно при distributed training или сторонних kernels/libraries.
Measurement protocol
Не нужен огромный benchmark suite. Для SS-023 достаточно воспроизводимого memory protocol.
1. Зафиксировать exact configuration
2. Зафиксировать baseline после load
3. Добавить exact adapters
4. Создать optimizer
5. Выполнить representative forward
6. Выполнить loss + backward
7. Выполнить optimizer step
8. Повторить representative training
9. Снять allocated / reserved /
device-level peak
Какие версии нужно записать
Результат:
Peak VRAM = 42 GB
плохо переносим без configuration.
Минимальный record:
Model ID / revision
PyTorch
Transformers
PEFT
TRL
bitsandbytes
CUDA / ROCm
attention implementation
kernel backend
optimizer
quantization config
Изменение software stack может менять adapter handling, packing, kernels, allocator behavior и peak.
OOM phase помогает локализовать проблему
OOM возникает | Что проверять в первую очередь |
При model load | base representation, quantization, placement |
После adapter injection | targets, extra trainables, adapter dtype |
На forward | microbatch, sequence, activations, temporaries |
На backward | saved activations, gradients, checkpointing |
На optimizer step | optimizer state и step temporaries |
На eval | отдельную eval configuration |
После смены shapes/позже | allocation pattern и allocator state |
Это именно triage, а не доказательство причины.
Если проблема сложная, PyTorch предоставляет memory_snapshot() и memory history для анализа состояния allocator и allocation events.
OOM Triage Worksheet
OOM PHASE
[ ] load
[ ] adapter injection
[ ] forward
[ ] loss
[ ] backward
[ ] optimizer
[ ] evaluation
[ ] later iteration
CONFIG
Model/revision:
LoRA / QLoRA:
Rank:
Targets:
Sequence profile:
Microbatch:
Accumulation:
Optimizer:
Checkpointing:
Quantization:
MEMORY
Peak allocated:
Peak reserved:
Device/process peak:
CONTROLLED TESTS
Microbatch reduced:
PASS / FAIL
Sequence reduced:
PASS / FAIL
Checkpointing changed:
PASS / FAIL
Optimizer changed:
PASS / FAIL
HYPOTHESIS
Base residency:
Activations:
Gradients:
Optimizer:
Temporary/runtime:
Allocator:
UNKNOWN:
Memory Sensitivity Matrix
Изменение | Base | Adapter / optimizer | Activations | Побочный эффект |
Rank ↑ | — | ↑ | зависит от implementation | adapter compute ↑ |
Target modules ↑ | — | ↑ | может меняться | backward workload ↑ |
LoRA → QLoRA | base residency ↓ | отдельно | не исчезают | quant/dequant path |
Sequence ↑ | — | — | обычно ↑ | compute ↑ |
Microbatch ↑ | — | — | обычно ↑ | throughput меняется |
Accumulation ↑ | — | gradients сохраняются | не эквивалентно microbatch ↑ | global batch ↑ |
Checkpointing ON | — | — | ↓ | recomputation ↑ |
8-bit optimizer | — | state ↓ | — | implementation-specific |
Activation offload | — | — | GPU residency ↓ | host transfer ↑ |
FSDP | base/state shard'ятся | shard'ится | отдельно | communication ↑ |
Стрелки обозначают направление, а не универсальную величину изменения.
Что делать, если одной GPU недостаточно
Нельзя взять:
2 × 48 GB
и считать, что training получил:
96 GB единой памяти
При multi-GPU важен способ размещения tensors.
FSDP2, например, shard'ит model parameters, gradients и optimizer state по GPU. Перед computation необходимые parameters собираются, а политика reshard_after_forward меняет trade-off между memory и communication.
Поэтому multi-GPU intake:
GPU count:
Parallelism/sharding:
Parameter placement:
Gradient placement:
Optimizer placement:
CPU offload:
Reshard policy:
Per-rank measured peak:
а не только:
Total VRAM:
Почему single-GPU memory нельзя просто разделить на GPU count
Условное:
Memorysingle/NMemory_{single}/N
не является универсальной формулой FSDP.
Причина в том, что разные компоненты shard'ятся по-разному, а во время computation FSDP собирает необходимые parameters. Кроме того, reshard_after_forward=false сохраняет gathered parameters между forward и backward, повышая peak memory ради сокращения повторного communication.
Training Memory Ledger
Ниже — основной рабочий инструмент статьи.
IDENTITY
Model ID:
Revision:
Architecture:
Total parameters:
SOFTWARE
PyTorch:
Transformers:
PEFT:
TRL:
bitsandbytes:
CUDA / ROCm:
Attention/kernel backend:
METHOD
LoRA / QLoRA:
Rank:
Rank pattern:
Target modules:
Target parameters:
Bias:
Modules to save:
Actual trainable params:
MEASURED
BASE MODEL
Loaded representation:
Quantized:
YES / NO
Quantization type:
Quant storage:
Double quant:
YES / NO
Compute dtype:
ADAPTER
Actual adapter dtype:
Trainable params:
Adapter bytes:
TRAINING WORKLOAD
Configured max length:
Observed sequence p50:
Observed sequence p95:
Packing:
ON / OFF
Padding-free:
ON / OFF
Per-device microbatch:
Gradient accumulation:
DP world size:
Effective global batch:
GRADIENTS
Parameters with gradients:
Gradient dtype:
Gradient memory:
CALCULATED /
VERIFIED /
MEASURED
OPTIMIZER
Exact optimizer:
Optimized params:
State format:
Optimizer bits:
Paged:
YES / NO
Optimizer-state memory:
CALCULATED /
MEASURED
MEMORY OPTIONS
Gradient checkpointing:
ON / OFF
Activation offload:
ON / OFF
CPU offload:
ON / OFF
FSDP / ZeRO:
...
Sharding:
...
MEMORY LEDGER
Frozen base:
CALCULATED / MEASURED
Adapter:
CALCULATED
Gradients:
CALCULATED / MEASURED
Optimizer:
CALCULATED / MEASURED
Activations:
MEASURED
Temporary/runtime:
MEASURED
PHASE MEASUREMENTS
After model load:
After adapter injection:
After optimizer init:
Forward peak:
Backward peak:
Optimizer-step peak:
Representative steady-state peak:
MEMORY METRICS
Peak allocated:
Peak reserved:
Device/process peak:
RESULT
OOM:
YES / NO
OOM phase:
Candidate configuration:
Status:
CALCULATED /
CANDIDATE /
VALIDATED /
INSUFFICIENT DATA
Как интерпретировать результат
Четыре статуса достаточно.
Статус | Что означает |
CALCULATED | заполнены только детерминированные части ledger |
CANDIDATE | есть предварительная конфигурация, нужен training run |
VALIDATED | exact recipe прошёл representative training step |
INSUFFICIENT DATA | нет критических inputs для sizing |
Если известны только:
model = 14B
method = QLoRA
корректный статус:
INSUFFICIENT DATA
а не GPU SKU.
Что передать для подбора сервера
Для предварительного расчёта нужны:
MODEL
model ID
revision
METHOD
LoRA / QLoRA
rank
target modules
DTYPES
base/quantization
compute
adapter
TRAINING
sequence profile
packing
per-device microbatch
gradient accumulation
OPTIMIZER
exact optimizer
state format
paged / non-paged
MEMORY OPTIONS
checkpointing
offload
sharding
PILOT RESULTS
если есть
peak allocated
peak reserved
device/process peak
OOM phase
Если части данных нет, это отмечается как UNKNOWN или ASSUMPTION.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


