Сервер для OCR и обработки документов нельзя корректно подобрать только по количеству файлов. Два проекта с одинаковыми 50 000 документов в сутки могут создавать совершенно разную нагрузку: в одном это одностраничные печатные формы, в другом — многостраничные PDF с таблицами, формулами, плохими сканами и последующим извлечением данных.
Поэтому расчёт лучше вести по всей цепочке:
типы документов → страницы → требуемый результат → этапы обработки → очередь → производительность → качество.
Главный показатель — не скорость одной OCR-модели, а производительность полного рабочего конвейера от входного документа до результата, который нужен бизнесу.
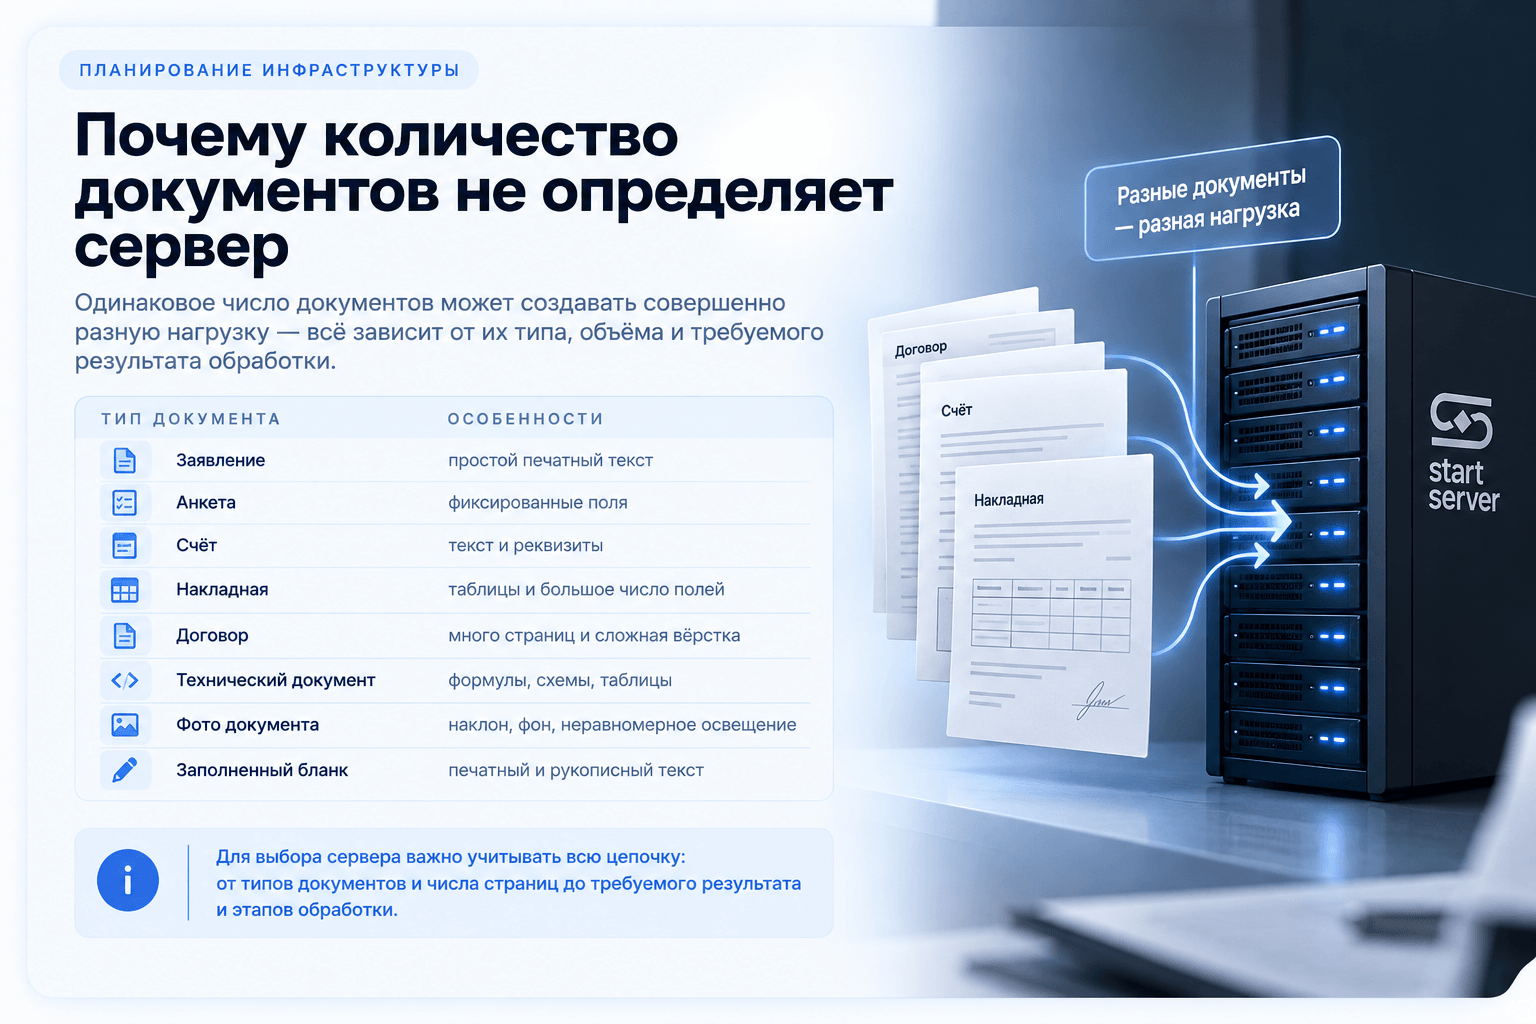
Почему количество документов не определяет сервер
Фраза:
«Нужно обрабатывать 20 000 документов в сутки»
недостаточна для выбора оборудования.
Один документ может состоять из одной страницы, другой — из пятидесяти. При этом сами страницы тоже могут заметно отличаться по сложности.
Например:
Тип документа | Особенности |
Заявление | простой печатный текст |
Анкета | фиксированные поля |
Счёт | текст и реквизиты |
Накладная | таблицы и большое число полей |
Договор | много страниц и сложная вёрстка |
Технический документ | формулы, схемы, таблицы |
Фото документа | наклон, фон, неравномерное освещение |
Заполненный бланк | печатный и рукописный текст |
Поэтому первый этап расчёта:
документы → страницы.
Если известны только средние значения:
Например:
20 000 документов × 4 страницы = 80 000 страниц.
Если фактическое число страниц известно, лучше использовать его вместо среднего.
Но даже 80 000 страниц ещё недостаточно для выбора сервера.
Сначала нужно определить, что именно должна сделать система с каждой страницей.
Что считать обработанным документом
В разных проектах слово «OCR» может обозначать разные результаты.
Нужен только текст
На входе — изображение, скан или PDF.
На выходе — распознанный текст.
Это классическая OCR-задача.
Нужна структура документа
Кроме текста требуется сохранить или определить:
заголовки;
абзацы;
таблицы;
формулы;
порядок чтения;
расположение блоков.
Результатом может быть Markdown, структурированный документ или другой формат с сохранённой логикой страницы.
Нужны бизнес-данные
Например, из накладной необходимо получить:
поставщика;
ИНН;
номер и дату документа;
позиции;
НДС;
итоговую сумму.
В такой системе распознавание текста — только один из этапов. После него ещё нужно извлечь необходимые поля и привести их к требуемой структуре.
Поэтому фраза:
«OCR обрабатывает 100 страниц в секунду»
не говорит о производительности бизнес-процесса, пока не определено, что именно считается завершением обработки.
Для расчёта сервера сначала фиксируют границу готового результата:
Разделите документы на классы
Все страницы не стоит объединять в одну среднюю нагрузку.
Для тестирования полезно разделить входящие документы на несколько классов.
Например:
Класс | Примеры | Что может усложнять обработку |
Простой текст | заявления, письма | качество скана |
Формы | анкеты, бланки | фиксированные поля |
Табличные | счета, накладные | структура таблицы |
Сложная вёрстка | договоры, отчёты | колонки, блоки |
Формулы | техническая документация | математические выражения |
Фото и плохие сканы | снимки документов | наклон, фон, размытие |
Рукописные | заполненные формы | рукописные элементы |
Это не универсальный стандарт Document AI, а рабочая группировка для конкретного проекта.
Её задача — не скрыть сложный класс документов хорошим средним результатом.
Например, 90% потока могут составлять простые счета, а 10% — накладные со сложными таблицами. Если тестировать только счета, итоговая скорость будет выглядеть хорошо, но реальная очередь может образоваться именно на накладных.
Поэтому производительность и качество проверяют на репрезентативном составе документов.
Из каких этапов состоит обработка документов
Современный Document AI редко сводится к одному вызову OCR.
Упрощённый путь может выглядеть так:
PDF или изображение → подготовка страницы → OCR / анализ структуры → дополнительные модели → извлечение данных → готовый результат.
В конкретном проекте часть этапов может отсутствовать.
Этап | Что может происходить |
Загрузка | чтение PDF, изображения или скана |
Рендер PDF | преобразование страницы в изображение |
Предобработка | ориентация, геометрия, подготовка изображения |
OCR | распознавание текста |
Анализ структуры | поиск блоков и порядка чтения |
Дополнительные модели | таблицы, формулы, изображения |
Extraction | получение нужных бизнес-полей |
Постобработка | нормализация и проверка |
Выход | текст, Markdown, таблица, JSON |
В image-based OCR исходный PDF может проходить отдельный этап рендера страниц в изображения. Если такой этап присутствует в рабочей системе, его время должно входить в итоговый тест.
Современные document-parsing решения также могут содержать несколько модельных стадий. Например, в PaddleOCR-VL полный конвейер включает анализ структуры страницы и последующее распознавание выделенных областей мультимодальной моделью. Запуск одного VLM-компонента отдельно не эквивалентен работе полного конвейера.
Для расчёта сервера отсюда следует главное:
OCR не всегда требует GPU
Запрос «GPU-сервер для OCR» не означает, что любое распознавание документов обязательно должно выполняться на видеокарте.
Существуют OCR-конвейеры, работающие на CPU.
В других системах GPU используется для:
распознавания;
анализа структуры;
мультимодальных моделей;
обработки таблиц и формул;
извлечения данных.
Поэтому правильный вопрос:
какие именно этапы выбранного конвейера требуют GPU и какую нагрузку они создают?
А не:
какая видеокарта нужна для OCR вообще?
В одном проекте ограничением может оказаться GPU-инференс. В другом — CPU, рендер PDF, память, хранилище или последующая обработка.
Это определяется измерением полного рабочего пути.
Как рассчитать поток страниц
После разделения документов на классы можно посчитать объём.
Например:
Документы | Количество | Среднее страниц | Всего страниц |
Счета | 10 000 | 2 | 20 000 |
Накладные | 5 000 | 5 | 25 000 |
Договоры | 2 000 | 18 | 36 000 |
Итого:
81 000 страниц.
Теперь нужно определить, за какое время они должны быть полностью обработаны.
Если 81 000 страниц необходимо завершить за 9 часов:
81 000 / 9 = 9000 страниц/час.
Получаем первое полезное требование:
полный рабочий конвейер должен устойчиво выдавать не менее 9000 готовых страниц в час.
Основная формула:
Required pages/hour = все страницы к заданному сроку / доступное окно обработки
Но речь идёт именно о готовых страницах на выходе согласованного конвейера.
Если бизнесу нужны структурированные поля, скорость одного OCR-движка нельзя напрямую сравнивать с требованием 9000 страниц в час.
Почему нужно учитывать очередь
Среднесуточный объём может скрывать реальную пиковую нагрузку.
Документы могут поступать:
равномерно весь день;
крупными пакетами вечером;
после закрытия операционного дня;
одновременно из нескольких филиалов;
во время миграции архива.
Допустим:
к началу окна накопилось 60 000 страниц;
за это же время поступит ещё 15 000;
весь объём должен быть готов за 5 часов.
Получаем:
60 000 + 15 000 = 75 000 страниц
и:
75 000 / 5 = 15 000 страниц/час.
Практическое правило:
Поэтому для sizing полезно знать:
средний входящий поток;
максимальную очередь;
новые документы внутри окна обработки;
допустимое время очистки очереди.
Скорость модели и скорость всей системы — не одно и то же
Это одна из главных ошибок при выборе сервера для OCR.
В документации модели можно увидеть:
время inference — 10 мс.
И попытаться посчитать:
1000 / 10 = 100 операций/с.
А затем сделать вывод:
значит система обрабатывает 100 страниц в секунду.
Такой расчёт может быть неверным.
Время отдельной модели может не включать:
чтение файла;
рендер PDF;
предобработку;
поиск областей;
работу других моделей;
постобработку;
извлечение полей;
формирование финального результата.
Поэтому нужно различать два типа измерений.
Параметр | Benchmark модели | Production benchmark |
Вход | подготовленное изображение | реальный PDF, скан или фото |
Подготовка | может не учитываться | учитывается |
OCR / VLM | да | да |
Дополнительные этапы | часто нет | как в рабочей системе |
Извлечение полей | обычно нет | если требуется |
Результат | скорость модели | готовая страница / документ |
Для sizing | ориентир | основной показатель |
Для выбора сервера главным является end-to-end benchmark.
Что такое end-to-end benchmark
Такой тест начинается там же, где начинается рабочая система, и заканчивается там, где появляется необходимый результат.
Например:
PDF → JSON с полями счёта
или:
скан → Markdown с таблицами.
В опубликованных тестах PaddleOCR-VL-1.5 есть пример end-to-end измерения, куда входили рендер PDF и генерация Markdown. Это хороший пример того, насколько такая метрика отличается от чистой скорости одной модели.
Но и end-to-end цифру производителя нельзя автоматически переносить на свой проект.
Нужно учитывать:
точную модель и её версию;
inference backend;
GPU;
пакетную обработку;
параллельность;
разрешение страниц;
классы документов;
включённые функции;
границу готового результата.
Почему одинаковые страницы могут создавать разную нагрузку
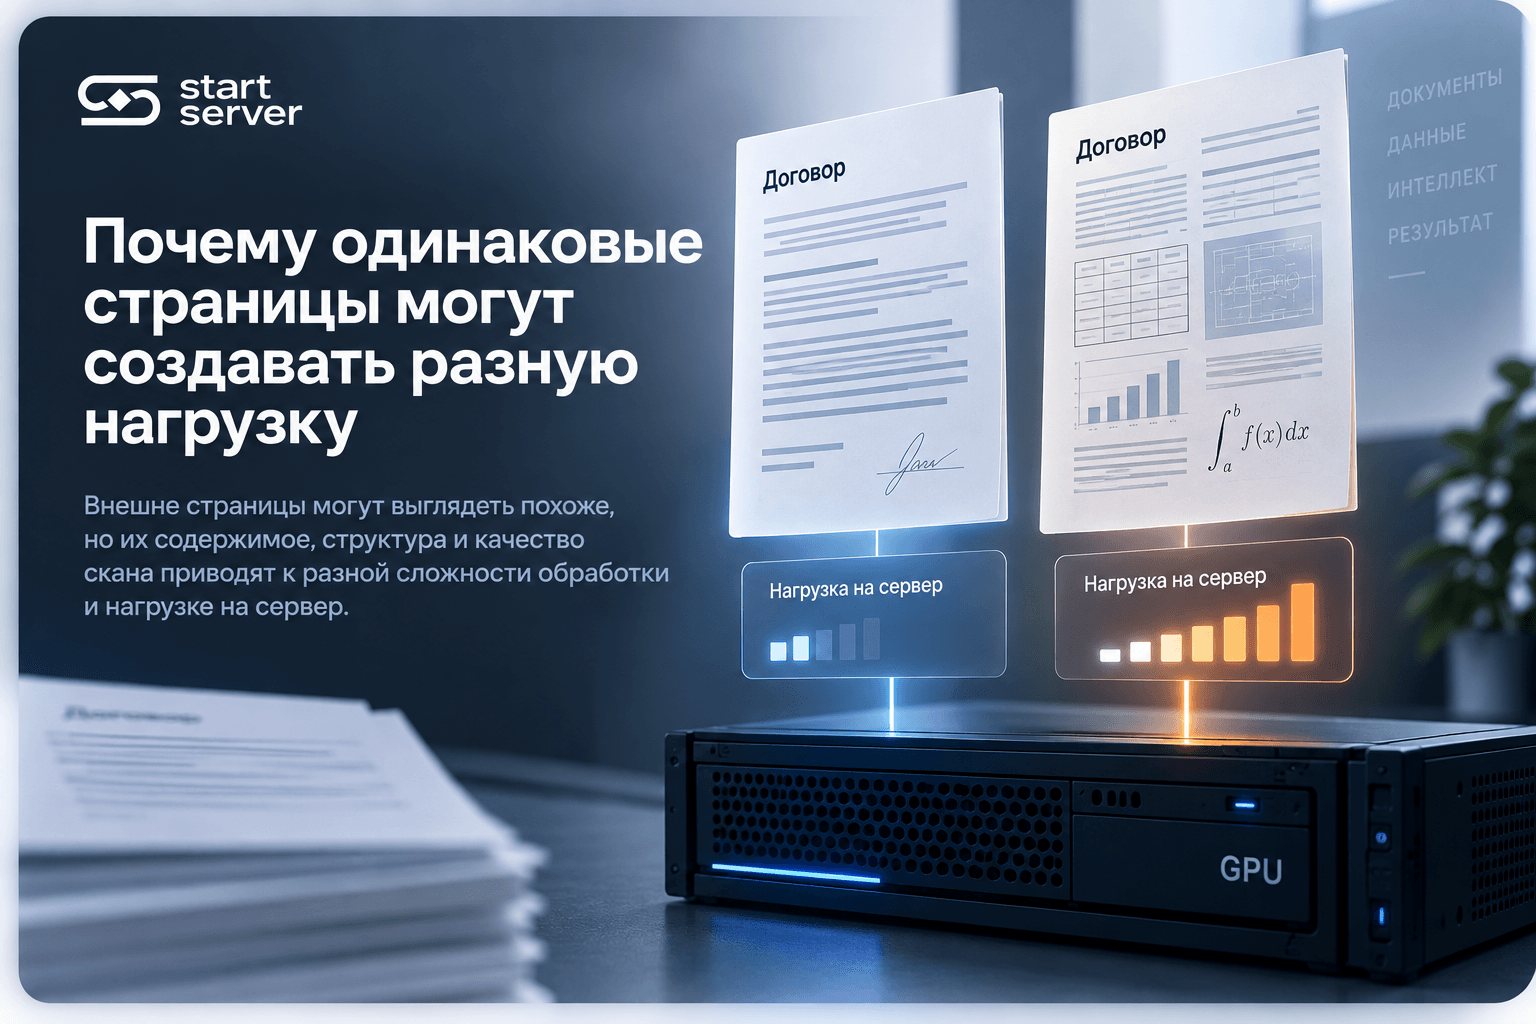
Представим две страницы одинакового разрешения.
Первая содержит несколько абзацев печатного текста.
Вторая — таблицу, несколько колонок, формулы и диаграмму.
Они могут пройти через разный набор этапов:
страница A → OCR
и:
страница B → анализ структуры → OCR → таблица → формулы → extraction.
Современные системы обработки документов позволяют включать дополнительные модули только там, где они необходимы.
Поэтому:
одна страница не является постоянной единицей вычислительной стоимости.
При этом pages/hour остаётся удобной эксплуатационной метрикой — если тест проводится на фиксированном и репрезентативном составе документов.
OCR и извлечение данных — разные нагрузки
Предположим, OCR уже получил текст счёта.
Но бизнес-процессу нужны конкретные данные:
invoice_number
date
supplier
inn
total
vat
Для их получения может понадобиться отдельный этап:
правила;
классификатор;
специализированная модель;
VLM;
LLM.
Поэтому:
Если конечным результатом должен быть JSON с полями, именно появление этого JSON является окончанием end-to-end benchmark.
Иначе можно получить ситуацию, когда распознавание текста работает быстро, а очередь растёт уже на этапе extraction.
Почему качество — обязательный критерий
Высокий pages/hour бесполезен, если система неправильно распознаёт критичные данные.
При этом одной универсальной «OCR accuracy» для сложных документов недостаточно.
Для разных задач могут быть важны разные критерии:
точность текста;
сохранение структуры таблицы;
правильность формул;
порядок чтения;
точность обязательных полей.
Например:
Класс | Что проверяем |
Счёт | номер, дата, сумма, ИНН |
Накладная | позиции и структура таблицы |
Договор | текст и порядок чтения |
Технический документ | формулы и структура |
Анкета | заполненные поля |
Для одного класса quality gate также может состоять сразу из нескольких условий.
Например, накладная считается обработанной корректно только если одновременно:
правильно определены реквизиты;
не потеряны строки таблицы;
корректно извлечена итоговая сумма.
Поэтому успешный результат benchmark:
производительность → PASS
и одновременно:
качество → PASS.
Почему среднее качество может вводить в заблуждение
Допустим, тестовый набор состоит из:
90% простых счетов;
10% сложных накладных.
Система почти без ошибок обрабатывает счета, но регулярно теряет строки в таблицах накладных.
Средний показатель может выглядеть высоким.
Но если накладные являются обязательной частью процесса, такую систему нельзя считать прошедшей проверку.
Поэтому quality gate лучше задавать по критичным классам документов, а не только по всей выборке.
Класс | Производительность | Качество | Статус |
Счета | PASS / FAIL | ||
Накладные | PASS / FAIL | ||
Договоры | PASS / FAIL |
Как определить узкое место обработки документов
Если требуемый pages/hour не достигается, нужно понять, на каком этапе начинает расти очередь.
Что происходит | Что проверить |
GPU загружена слабо, очередь растёт | загрузку, рендер, CPU и I/O |
Очередь растёт перед VLM | производительность VLM |
OCR работает быстро, готовый JSON появляется медленно | extraction и постобработку |
Простые страницы быстрые, табличные медленные | обработку таблиц |
Модель быстрая, весь pipeline медленный | подготовку и последующие этапы |
Средний pages/hour достаточный, большие PDF запаздывают | задержку многостраничных документов |
Скорость высокая, поля извлекаются плохо | критерии качества и модель |
Вторая GPU почти не дала прироста | bottleneck на другом этапе |
Эта таблица помогает выбрать направление диагностики, но не доказывает конкретную причину автоматически.
Для подтверждения нужны измерения этапов и очередей.
Калькулятор нагрузки OCR и Document AI
Для предварительного sizing можно использовать следующий рабочий лист.
Шаг 1. Разделите документы на классы
Параметр | Значение |
Класс документа | |
Документов за период | |
Всего страниц | |
Среднее страниц/документ | |
Максимальное страниц/документ | |
Формат | PDF / скан / фото |
Разрешение / DPI | |
Таблицы | да / нет |
Формулы | да / нет |
Рукописные элементы | да / нет |
Другие особенности |
Шаг 2. Определите готовый результат
Зафиксируйте фактическую границу:
распознанный текст;
текст и структура;
Markdown;
таблицы;
структурированные поля;
готовый JSON.
Именно до этой точки потом измеряется end-to-end производительность.
Шаг 3. Запишите этапы конвейера
Этап | Компонент |
PDF rendering | |
Предобработка | |
OCR / document parsing | |
Таблицы / формулы | |
Извлечение полей | |
Постобработка | |
Валидация результата |
Не все строки обязательны.
Шаг 4. Рассчитайте требуемую производительность
Показатель | Значение |
Очередь к началу окна | |
Новые страницы внутри окна | |
Всего страниц к deadline | |
Окно обработки | |
Required pages/hour | |
Measured end-to-end pages/hour | |
Результат | PASS / FAIL |
Формула:
Required pages/hour = все страницы к заданному сроку / окно обработки
Пример:
90 000 страниц нужно полностью обработать за 6 часов.
90 000 / 6 = 15 000 страниц/час.
Значит полный рабочий конвейер должен устойчиво выдавать не менее 15 000 готовых страниц в час.
Шаг 5. Добавьте quality gates
Класс | Что проверяем | Требование | Измерено | Статус |
Счёт | ключевые поля | PASS / FAIL | ||
Накладная | таблица и реквизиты | PASS / FAIL | ||
Договор | текст / структура | PASS / FAIL |
Итог:
throughput PASS + обязательные quality gates PASS.
Высокая скорость сама по себе не подтверждает пригодность сервера.
Нужна ли отдельная задержка документа
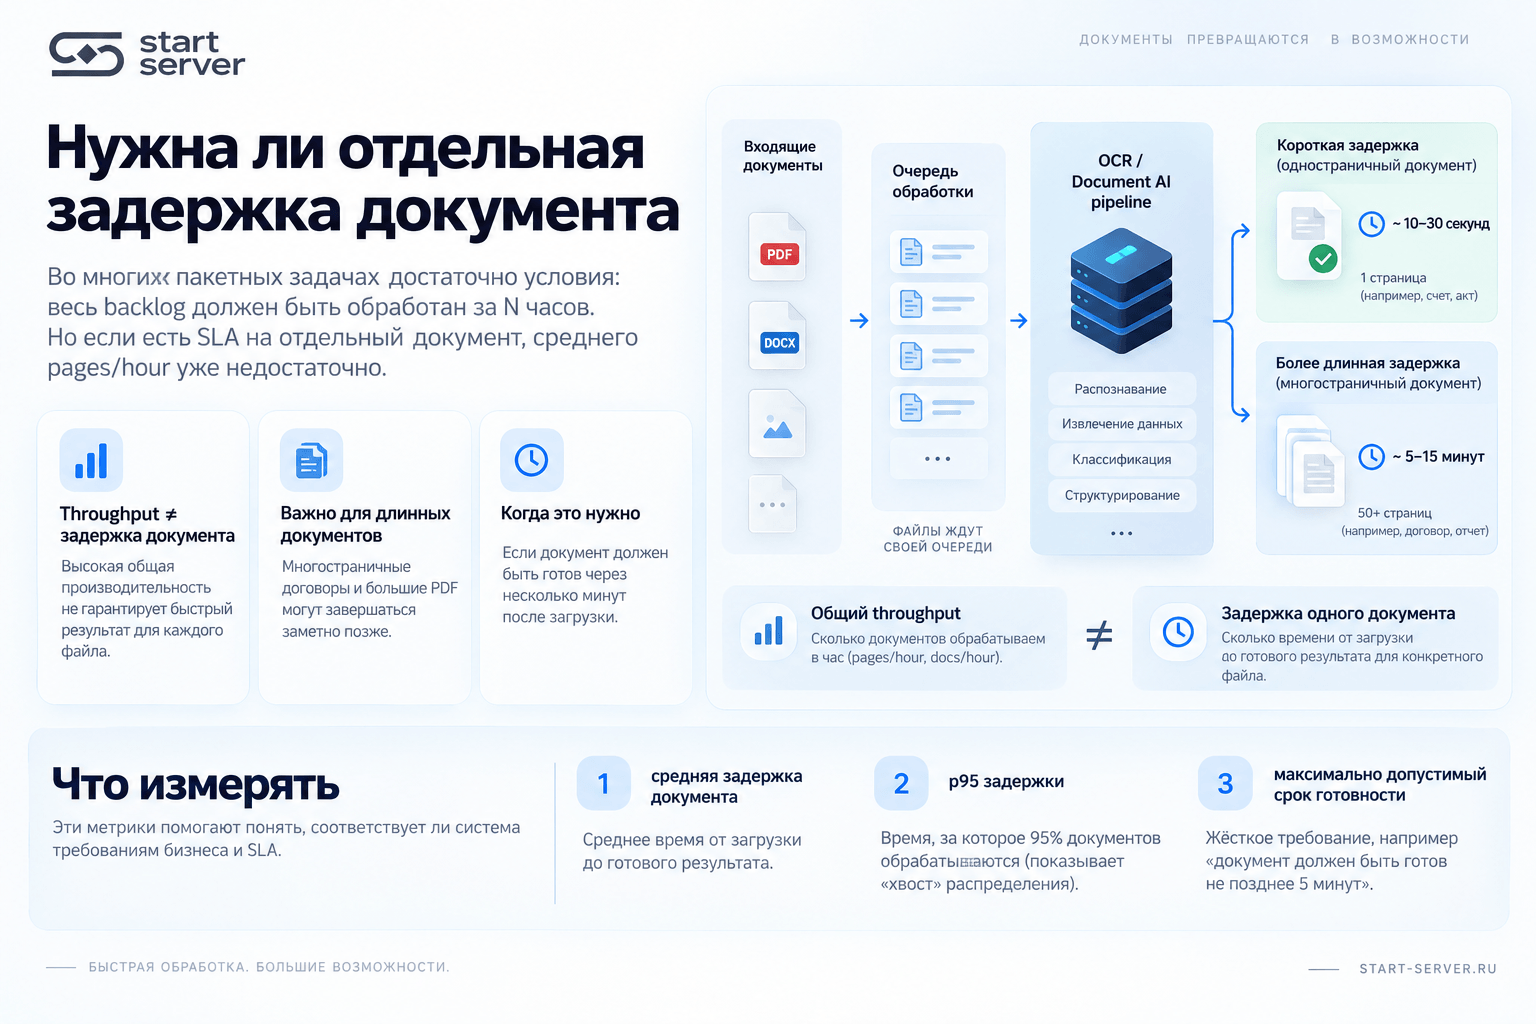
Во многих пакетных задачах достаточно условия:
весь backlog должен быть обработан за N часов.
Но иногда есть дополнительный SLA:
каждый документ должен быть готов не позднее чем через несколько минут после загрузки.
Тогда среднего pages/hour уже недостаточно.
Нужно отдельно измерять задержку документа.
Особенно это важно для многостраничных файлов.
Система может показывать хороший общий throughput на большом количестве одностраничных форм, но медленно завершать обработку длинных договоров.
В таком проекте в benchmark дополнительно включают:
среднюю задержку документа;
p95 задержки;
заданный максимальный срок.
Как провести benchmark сервера
Тестировать лучше на наборе документов, который отражает реальную нагрузку.
Документы
Нужно зафиксировать:
количество файлов;
количество страниц;
долю каждого класса;
число страниц на документ;
форматы;
разрешение или DPI;
языки;
таблицы;
формулы;
плохие сканы и фотографии;
другие критичные особенности.
Программный стек
Зафиксируйте:
полный pipeline;
точные модели;
версии моделей;
runtime;
inference backend;
режим вычислений;
размер пакета;
параллельность;
включённые дополнительные модули;
способ рендера PDF;
границу готового результата.
Одного названия OCR/VLM-модели недостаточно.
Оборудование
Как минимум:
GPU и их количество;
CPU;
RAM;
накопители, если они входят в измеряемый путь.
Результат
Полезно измерить:
сколько страниц обработано;
фактическое время теста;
устойчивый end-to-end pages/hour;
задержку документов, если она важна;
загрузку GPU и CPU;
использование памяти;
время отдельных стадий;
состояние очередей;
качество каждого критичного класса.
Конфигурация проходит проверку, если:
и одновременно выполнены все обязательные требования к качеству.
Если в проекте есть SLA по отдельному документу, дополнительно проверяется его задержка.
Даст ли вторая GPU вдвое больше страниц
Не обязательно.
Если главным ограничением является GPU-модель и приложение хорошо распределяет запросы, дополнительная карта может существенно увеличить производительность.
Но возможен другой сценарий:
VLM имеет запас;
рендер PDF не успевает;
CPU создаёт очередь;
extraction работает медленнее OCR.
Тогда добавление GPU даст гораздо меньший эффект.
Поэтому нельзя использовать универсальную формулу:
две GPU = вдвое больше страниц.
Конфигурацию с несколькими GPU нужно проверять тем же end-to-end benchmark.
Какие данные нужны для подбора сервера
Перед переходом к конкретной конфигурации полезно заполнить одну таблицу.
Данные проекта | Значение |
Типы документов | |
Документов за период | |
Страниц за период | |
Максимальная очередь | |
Новые страницы внутри окна | |
Окно обработки | |
Форматы | |
DPI / разрешение | |
Таблицы | |
Формулы | |
Другие сложные элементы | |
Требуемый результат | текст / структура / поля / JSON |
OCR/VLM-модель | |
Версия модели | |
Runtime / backend | |
Дополнительные этапы | |
Required pages/hour | |
Требования по качеству | |
SLA по задержке документа | если есть |
После заполнения вопрос:
Какая GPU нужна для 100 000 документов?
можно заменить на измеримое техническое требование:
Нужно обрабатывать X страниц в час на заданном составе документов от входного файла до готового результата и одновременно выполнять критерии качества.
Главное
Сервер для OCR и Document AI рассчитывают не по количеству файлов и не по одной цифре производительности нейросети.
Сначала нужно определить:
какие документы поступают;
сколько в них страниц;
какие классы создают разные сценарии обработки;
что считается готовым результатом;
какие этапы входят в рабочий конвейер;
сколько страниц должно быть готово к заданному сроку;
какое качество необходимо получить.
После этого рассчитывают:
Required pages/hour = страницы к deadline / окно обработки.
А затем тестируют полный рабочий путь:
PDF / изображение → подготовка → OCR / parsing → extraction → готовый результат.
Конфигурация считается подходящей только тогда, когда одновременно выполняются:
требуемая end-to-end производительность
и:
quality gates всех критичных классов документов.
Поэтому число страниц, которое способен обработать конкретный сервер, — не паспортная характеристика GPU, а результат измерения всего рабочего конвейера на репрезентативном наборе документов.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


