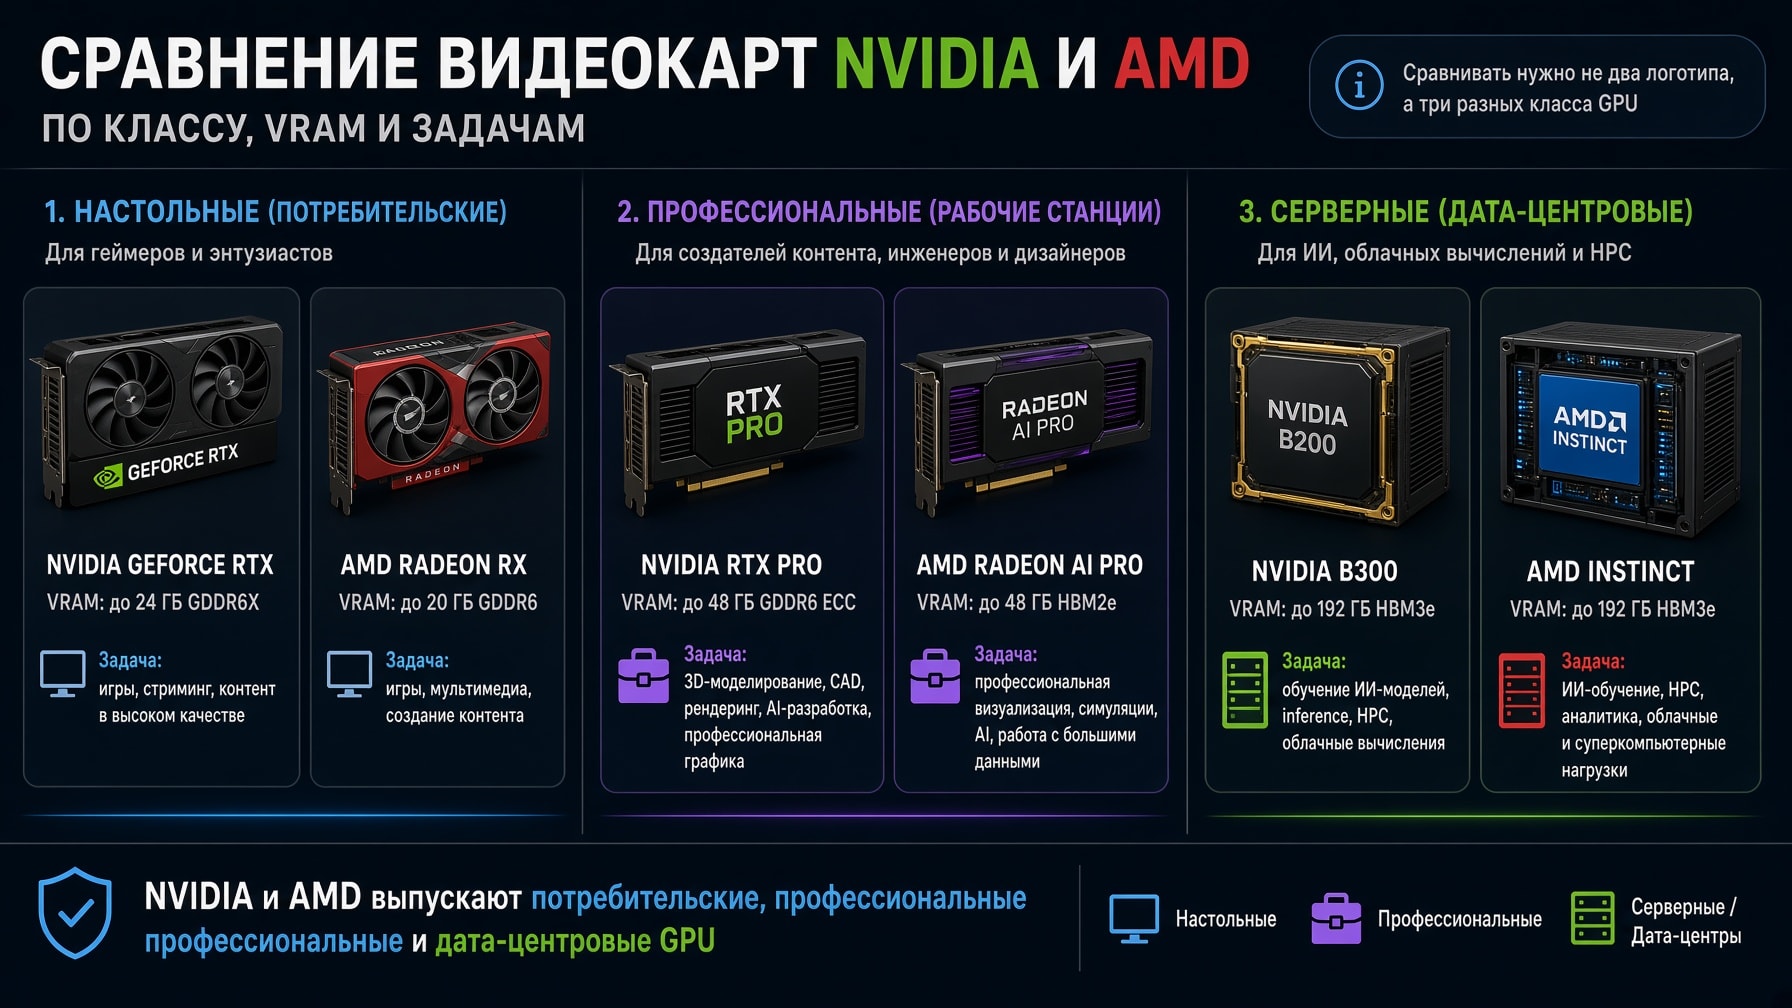
Сравнивать видеокарты NVIDIA и AMD корректно только внутри одного класса и одной задачи. Для игр важны FPS в конкретном разрешении, качество трассировки лучей и технологии масштабирования. Для 3D и монтажа решает поддержка приложения и кодеков. Для локального ИИ сначала проверяют VRAM и software stack. Для обучения LLM и HPC уже нужны HBM, быстрые связи между GPU, RAS, подходящий сервер и инфраструктура ЦОД.
Поэтому короткий ответ выглядит так:
GeForce RTX и Radeon RX предназначены прежде всего для настольных ПК, игр, творчества и локальных экспериментов;
RTX PRO и Radeon PRO или AI PRO рассчитаны на профессиональные рабочие процессы, но их конкретные исполнения и условия эксплуатации различаются;
NVIDIA H200, B300 и AMD Instinct MI300X, MI325X, MI355X относятся к дата-центровым ускорителям для AI и HPC;
NVIDIA чаще проще внедрить в CUDA-зависимый стек;
AMD нельзя исключать по названию бренда: Radeon и Instinct поддерживают ROCm, но точную модель, ОС, framework и приложение нужно сверять по актуальной матрице совместимости;
больший объем VRAM позволяет разместить более тяжелую нагрузку, но сам по себе не гарантирует более высокую скорость.
Содержание
Что именно сравнивать у NVIDIA и AMD
Таблица GeForce RTX и Radeon RX
Профессиональные видеокарты
Серверные NVIDIA и AMD
VRAM, bandwidth и вычислительная мощность
CUDA против ROCm
Выбор по задачам
Алгоритм проверки перед покупкой
Частые вопросы
NVIDIA или AMD: что лучше
Универсального победителя нет. Производитель становится частью ответа только после того, как описана нагрузка.
Если проект использует CUDA libraries, готовые CUDA extensions, TensorRT, NVIDIA NIM или приложение с сертификацией только под определенные NVIDIA GPU, миграция на AMD может потребовать изменений. В такой ситуации зрелая совместимость важнее разницы в одной паспортной характеристике.
Если нужный стек официально поддерживает ROCm, приложение проходит тест на конкретной AMD GPU, а конфигурация дает требуемые latency, throughput и качество, выбирать NVIDIA только по привычке тоже неправильно. У AMD есть Radeon для desktop и workstation, а также Instinct с большой HBM для AI и HPC.
Для игр ответ меняется еще раз. Сравнение видеокарт RX и RTX проводят по одинаковому набору игр, одному разрешению, графическому preset и отдельным режимам:
Нативный рендеринг без масштабирования и генерации кадров.
Нативный рендеринг с трассировкой лучей.
Апскейлинг при одинаковом целевом качестве изображения.
Генерация кадров, если она поддерживается обеими сравниваемыми конфигурациями.
Показатели 1% low и frame time, а не только средний FPS.
Какие классы видеокарт выпускают NVIDIA и AMD
Слово «видеокарта» объединяет устройства, которые нельзя считать прямыми конкурентами.
Класс | NVIDIA | AMD | Типичные задачи | Что особенно проверить |
|---|---|---|---|---|
Потребительский desktop | GeForce RTX | Radeon RX | игры, стриминг, творчество, локальный AI, разработка | VRAM, FPS, кодеки, размеры, питание, драйверы |
Профессиональная рабочая станция | RTX PRO | Radeon PRO, Radeon AI PRO | CAD, DCC, рендеринг, инженерные приложения, AI-разработка | сертификация ПО, ECC, VRAM, драйверный цикл |
Универсальный серверный GPU | RTX PRO Server, L-серия | отдельные server-qualified Radeon исполнения | inference, VDI, видео, графика, AI | пассивное или активное охлаждение, vGPU, RAS, QVL сервера |
Дата-центровый AI и HPC | H100, H200, B200, B300 | Instinct MI300X, MI325X, MI350X, MI355X | обучение, крупный inference, HPC, multi-GPU | HBM, interconnect, scale-up, сеть, питание, охлаждение |
GeForce RTX 5090 и Instinct MI355X обе выполняют вычисления на GPU, но предназначены для разных платформ. Первая является настольной картой с видеовыходами и активным охлаждением. Вторая представляет собой OAM-модуль для специализированного сервера. Сравнивать их одной колонкой «мощность» бессмысленно.
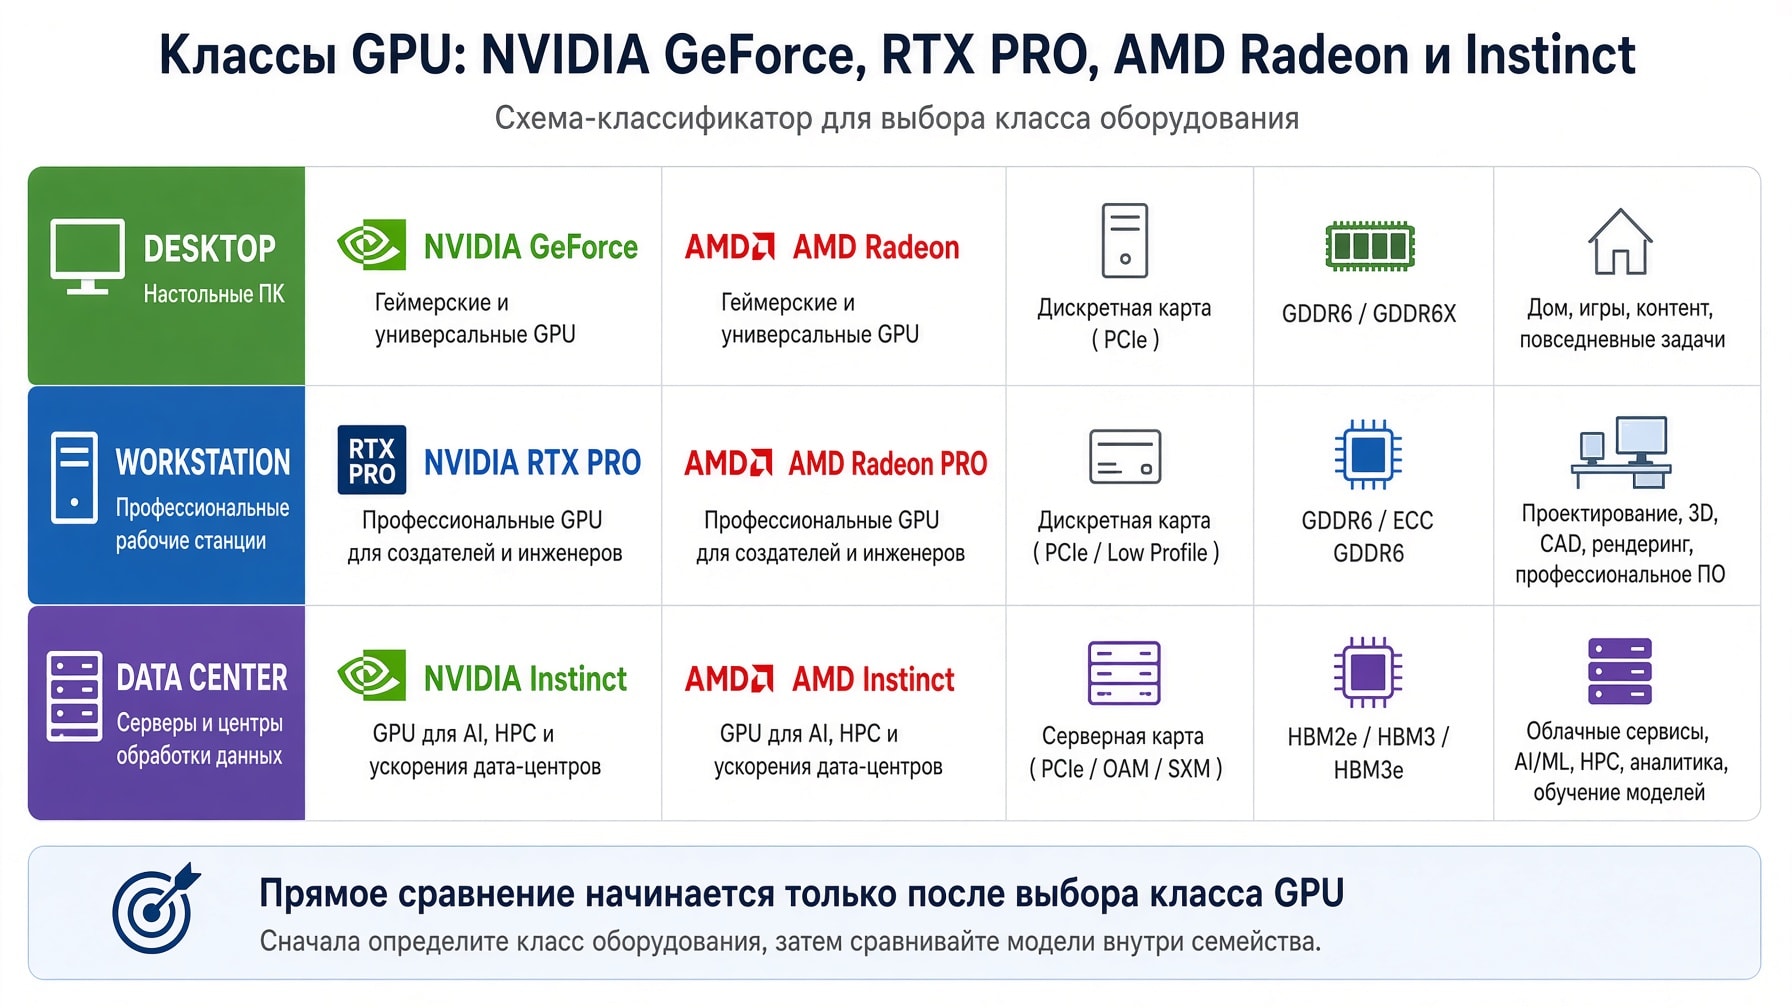
Таблица сравнения видеокарт GeForce RTX и Radeon RX
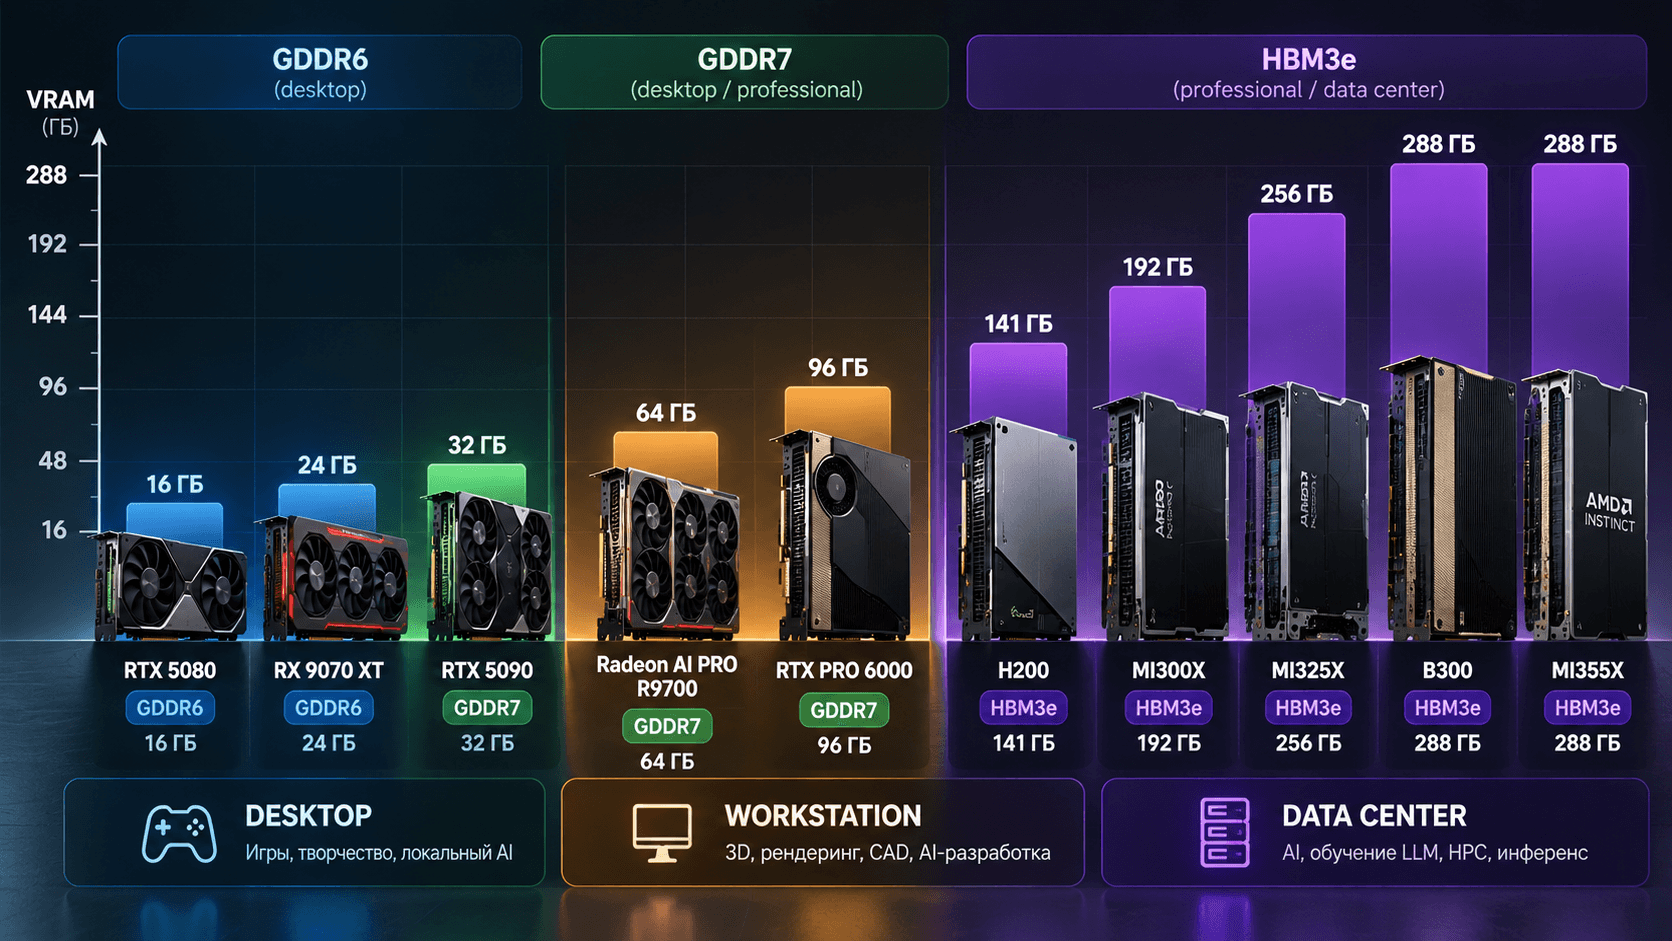
Ниже приведены репрезентативные актуальные desktop GPU. Это таблица характеристик видеокарт, а не рейтинг FPS. RTX 5090 не является ценовым аналогом RX 9070 XT, а RTX 5080 и RX 9070 XT нельзя объявить равными только из-за одинаковых 16 ГБ памяти.
Видеокарта | Архитектура | VRAM | Пропускная способность памяти | Паспортная мощность | Основные сценарии |
|---|---|---|---|---|---|
NVIDIA GeForce RTX 5090 | Blackwell | 32 ГБ GDDR7 | 1 792 ГБ/с | 575 Вт TGP | 4K-игры, локальный AI, 3D, монтаж, разработка |
NVIDIA GeForce RTX 5080 | Blackwell | 16 ГБ GDDR7 | 960 ГБ/с | 360 Вт TGP | 4K-игры, творчество, AI-прототипы при достаточных 16 ГБ |
AMD Radeon RX 9070 XT | RDNA 4 | 16 ГБ GDDR6 | до 640 ГБ/с | 304 Вт TBP | игры, графика, видео, поддерживаемый локальный AI |
AMD Radeon RX 9070 | RDNA 4 | 16 ГБ GDDR6 | до 640 ГБ/с | 220 Вт TBP | игры, создание контента, разработка и локальные вычисления |
Что показывает сравнение RTX 5090 и RTX 5080
RTX 5090 предоставляет 32 ГБ GDDR7, RTX 5080: 16 ГБ. Для игры этого сравнения недостаточно, потому что результат зависит от разрешения, движка, ray tracing и режима DLSS. Для локальной модели разница в емкости может быть принципиальной: нагрузка, которая занимает больше 16 ГБ, не помещается целиком в RTX 5080 независимо от ее вычислительной скорости.
У потребительских GeForce RTX 50 нет NVLink. Две карты не образуют один прозрачный пул памяти. Распределить модель можно только через поддерживаемый runtime и выбранный вид parallelism, при этом часть данных и служебных буферов может дублироваться.
Что показывает сравнение Radeon RX 9070 XT и RX 9070
Обе модели имеют 16 ГБ GDDR6 и заявленную пропускную способность до 640 ГБ/с, но различаются количеством вычислительных блоков, частотами и power envelope. Одинаковая VRAM отвечает на вопрос вместимости, но не означает одинаковую игровую или вычислительную производительность.
Для AI важен еще один фильтр: Radeon RX 9070 и RX 9070 XT присутствуют в актуальной документации ROCm, однако поддержка зависит от ОС, framework и их версий. Проверять нужно полную комбинацию, а не только название GPU.
RTX против RX в играх
Для игрового сравнения производительности видеокарт нужен свежий независимый benchmark. Записывайте вместе с результатом:
модель CPU и объем RAM;
разрешение и preset;
версию игры и драйвера;
нативный режим или тип апскейлинга;
включена ли генерация кадров;
средний FPS, 1% low и frame time;
потребление всей системы или только GPU;
температуру, частоты и возможный throttling.
Без этих условий фраза «карта быстрее на 20%» непроверяема. Официальные показатели производителей полезны для изучения возможностей, но для покупки игровой GPU их следует дополнять независимыми тестами на нужных играх.
Профессиональные NVIDIA RTX PRO и AMD Radeon AI PRO
Профессиональный класс выбирают не только по raw performance. Здесь важны объем памяти, ECC, сертифицированные приложения, драйверный цикл, виртуализация, режим круглосуточной нагрузки и совместимость с рабочей станцией или сервером.
Модель | Исполнение | VRAM | Bandwidth | Мощность | Где уместна |
|---|---|---|---|---|---|
NVIDIA RTX PRO 6000 Blackwell Server Edition | серверная PCIe, air dual-slot или liquid single-slot | 96 ГБ GDDR7 ECC | 1 597 ГБ/с | до 600 Вт, настраивается | enterprise AI, визуализация, VDI, рендеринг, видео, крупные однокарточные нагрузки |
AMD Radeon AI PRO R9700 | desktop/workstation, активное двухслотовое охлаждение | 32 ГБ GDDR6, ECC в Linux | 640 ГБ/с | 300 Вт TBP | локальный AI, разработка, графика, видео, multi-GPU workstation |
Эти модели не являются прямой ценовой или функциональной парой. Таблица показывает, насколько широким стало слово «профессиональная видеокарта».
RTX PRO 6000 Server Edition рассчитана на серверное окружение, поддерживает 96 ГБ GDDR7 ECC и MIG до четырех изолированных instances. Она интересна, когда 48 ГБ уже недостаточно, но HBM-класс H200 или B300 не нужен. Узкая граница между 48 и 96 ГБ разобрана в сравнении L40S и RTX PRO 6000 для LLM.
Сравнение серверных GPU NVIDIA и AMD
В дата-центре сравнивают уже не отдельную видеокарту, а платформу. Форм-фактор SXM или OAM, interconnect, число GPU, CPU, RAM, storage, сеть, PDU и охлаждение влияют на результат вместе.
Ускоритель | Архитектура и формат | Память на GPU | Bandwidth памяти | Power envelope | Типичные задачи |
|---|---|---|---|---|---|
NVIDIA H200 SXM | Hopper, SXM | 141 ГБ HBM3e | 4,8 ТБ/с | до 700 Вт | LLM inference и training, AI, HPC |
AMD Instinct MI300X | CDNA 3, OAM | 192 ГБ HBM3 | до 5,3 ТБ/с | 750 Вт peak | крупные LLM, training, inference, HPC |
AMD Instinct MI325X | CDNA 3, OAM | 256 ГБ HBM3e | 6 ТБ/с | 1 000 Вт peak | memory-intensive AI и HPC |
NVIDIA B300 | Blackwell Ultra, SXM | до 288 ГБ HBM3e для отдельных SKU, 270 ГБ в общей HGX-спецификации | около 7,7-8 ТБ/с | до 1 100 Вт для HGX B300 | AI reasoning, крупный inference и training |
AMD Instinct MI355X | CDNA 4, OAM | 288 ГБ HBM3e | 8 ТБ/с | 1 400 Вт TBP | плотный AI training, inference и HPC с direct liquid cooling |
Числа мощности являются верхними паспортными значениями конкретных исполнений, а не средним потреблением сервера. B300 требует уточнения SKU: в документации NVIDIA встречаются 288 ГБ для DGX B300 и отдельных SXM6-AC, а также 270 ГБ и 7,7 ТБ/с для общей HGX B300. Для sizing используют доступный runtime объем точной системы, а не одно значение из маркетинговой таблицы.
H200 против MI300X
У MI300X больше локальной памяти: 192 ГБ против 141 ГБ у H200. Это способно сократить число GPU для модели, увеличить KV-cache или дать больший запас под workload. Но решение остается неполным, пока не проверены checkpoint, quantization, runtime, kernels, multi-GPU и SLA. Практический протокол приведен в материале AMD MI300X или NVIDIA H200 для LLM.
B300 против MI355X
У обоих семейств очень большой объем HBM3e и пропускная способность около 8 ТБ/с на GPU. Этого недостаточно, чтобы объявить победителя.
Нужно сопоставить:
поддерживаемые форматы вычислений и фактический model path;
TensorRT-LLM, vLLM, SGLang, PyTorch или другой runtime;
NVLink и NVSwitch у NVIDIA либо Infinity Fabric у AMD;
performance collectives на реальном числе GPU;
энергопотребление узла и способ охлаждения;
масштабирование через InfiniBand или Ethernet;
доступность OEM-платформ, support и жизненный цикл;
стоимость системы, интеграции, миграции и эксплуатации.
Для B300 в каталоге представлены серверы на NVIDIA HGX B300 и готовая система NVIDIA DGX B300 с восемью GPU. Для AMD доступен класс серверов с Instinct MI300X и MI300A, включая ASRock Rack 6U8M с восемью MI300X.
Как сравнивать характеристики видеокарт
Сравнение характеристик видеокарт нужно вести по параметрам, которые влияют именно на выбранную нагрузку. Одна и та же цифра может быть жестким ограничением для LLM и почти ничего не говорить об игровом FPS.
Объем VRAM
VRAM определяет, какой рабочий набор помещается рядом с GPU. В игре это текстуры, geometry buffers, render targets и данные трассировки. В AI: веса, активации, KV-cache, batch и рабочие буферы. В 3D: сцена, геометрия и текстуры. В научном расчете: локальные массивы и промежуточные данные.
Если workload не помещается, более высокая вычислительная мощность не устраняет ограничение. Offload в системную RAM иногда позволяет продолжить работу, но меняет latency и throughput.
Подробный расчет вынесен в руководство сколько VRAM нужно для AI, LLM и обучения.
Тип памяти и bandwidth
GDDR6 и GDDR7 применяются в desktop, workstation и универсальных server GPU. HBM3 и HBM3e характерны для дата-центровых AI и HPC ускорителей. HBM дает очень широкий интерфейс и высокую пропускную способность, но интегрируется в специализированный модуль и платформу.
Memory bandwidth показывает теоретический объем данных, который память может передать за секунду. Метрика особенно важна для memory-bound workloads, но не является готовым прогнозом. Реальная скорость зависит от access pattern, cache, kernel, precision и утилизации.
Вычислительные блоки
CUDA cores у NVIDIA и stream processors у AMD нельзя сравнивать по количеству. Блоки относятся к разным архитектурам, работают на разных частотах и имеют разную организацию.
То же относится к Tensor Cores и Matrix Cores. Они ускоряют матричные операции, но итог определяется поддерживаемым форматом, библиотекой, kernel и размером задачи. Большее число блоков внутри одного datasheet не заменяет benchmark.
TFLOPS, TOPS и sparsity
Пиковые TFLOPS и TOPS можно сопоставлять только при одинаковых условиях:
один data type, например dense FP16 с dense FP16;
одинаковый учет sparsity;
одинаковое определение операции;
одна область, tensor или vector performance;
один scope, на GPU или на систему.
FP4 sparse и FP16 dense измеряют разные режимы. Нельзя делить одно число на другое и объявлять реальное ускорение LLM. Сначала модель и runtime должны использовать соответствующий формат без неприемлемой потери качества.
Питание и охлаждение
Паспортная мощность влияет на блок питания, кабели, PDU, тепловыделение и число GPU в корпусе. Настольная RTX 5090 имеет активную систему охлаждения и занимает несколько слотов. Пассивный server accelerator рассчитывает на направленный airflow шасси. Высокоплотные B300 и MI355X могут требовать инфраструктуры, которую нельзя добавить после поставки сервера без перепроектирования площадки.
Сравнение мощности видеокарт не сводится к TGP или TBP. Для экономики измеряют энергию на выполненную работу: запрос, кадр, batch, эпоху или расчет. Более мощный GPU может завершить задачу быстрее, а более экономичный по паспорту: дольше. Ответ дает измерение всей системы.
Форм-фактор и interconnect
PCIe-карта, SXM-модуль и OAM-модуль не являются взаимозаменяемыми. Даже одинаковый PCIe x16 не гарантирует совместимость по механике, power, охлаждению, BIOS и QVL.
ECC, RAS и виртуализация
Для production важны коррекция ошибок, page retirement, диагностика, health monitoring, SR-IOV, vGPU, MIG и поддержка vendor management tools. Наличие ECC само по себе не делает GPU серверной. Нужно проверить весь набор функций и ограничения конкретного SKU.
CUDA против ROCm
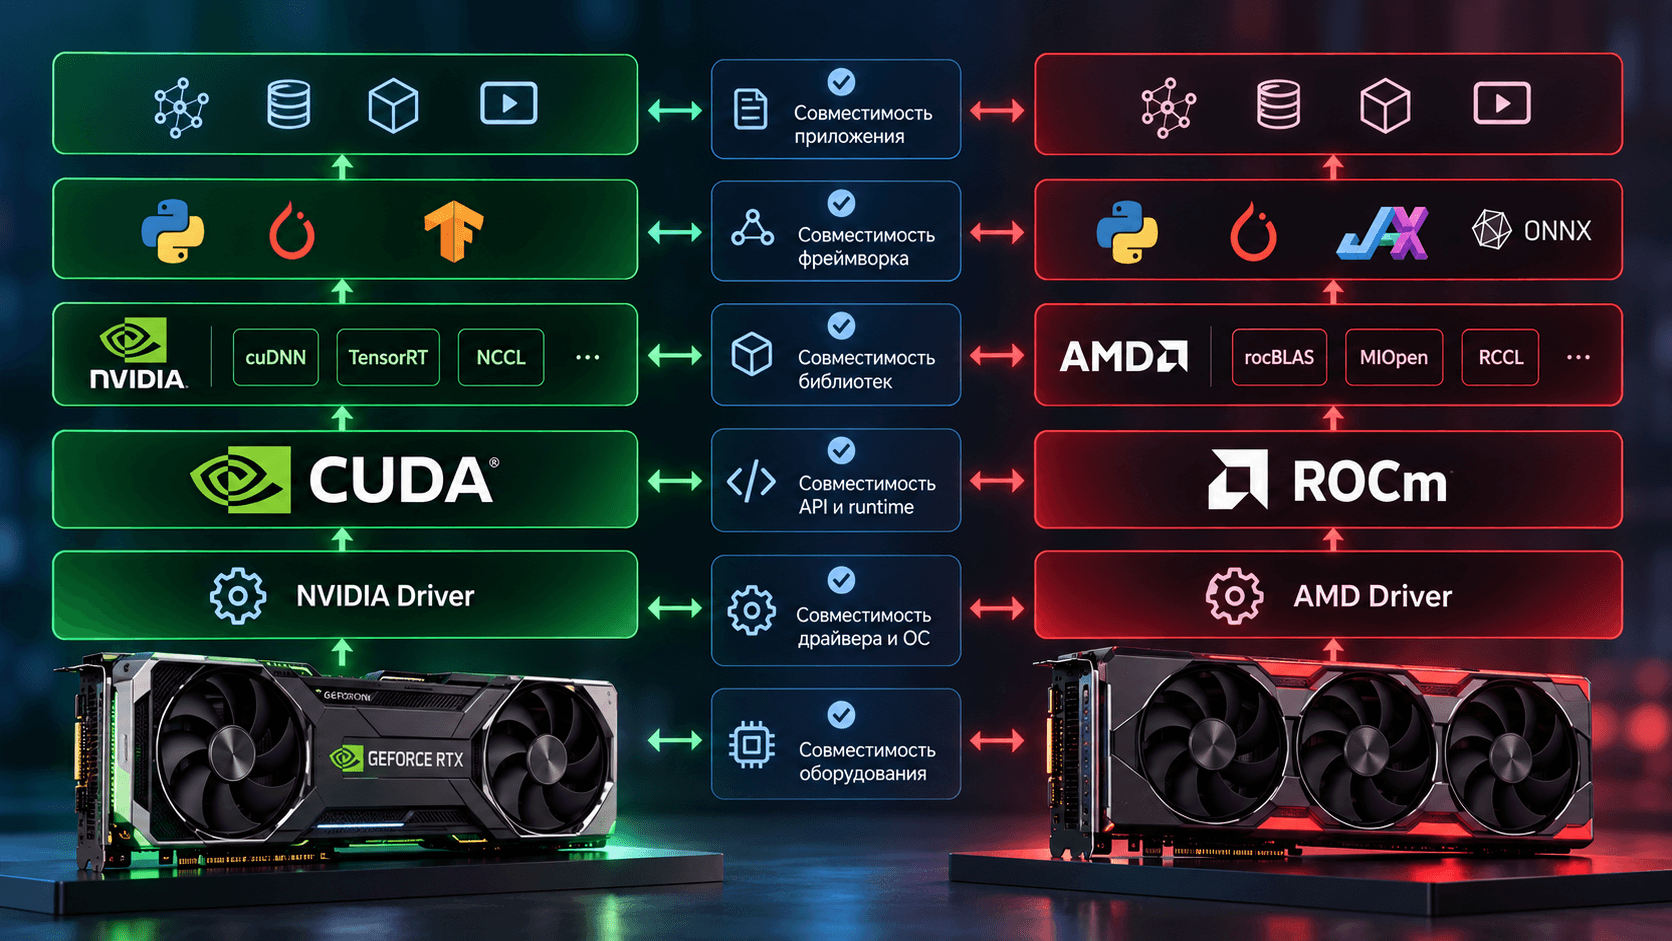
NVIDIA использует CUDA как основную платформу GPU computing. AMD развивает ROCm и HIP. Оба стека поддерживают современные AI и HPC сценарии, но совместимость нельзя оценивать одной строкой.
Проверка | NVIDIA | AMD |
|---|---|---|
Базовый compute stack | CUDA | ROCm и HIP |
Главная аппаратная область | поддерживаемые NVIDIA GPU | поддерживаемые AMD Instinct, Radeon PRO и Radeon |
Что сверить | GPU compute capability, driver, CUDA runtime, framework и kernels | точный GPU, ОС, ROCm, framework, runtime и kernels |
Типичный риск | старый driver или build без кода для новой архитектуры | неподдерживаемая комбинация GPU, ОС и framework, CUDA-only extension |
Что подтверждает выбор | запуск точного контейнера и workload | запуск точного контейнера и workload |
CUDA имеет очень широкую базу библиотек, контейнеров, готовых extensions и enterprise tools. Это практическое преимущество, если приложение уже зависит от них. Однако даже у NVIDIA нужно согласовать driver, CUDA runtime, framework build и compute capability. Полная схема разобрана в статье что такое CUDA и какие видеокарты ее поддерживают.
ROCm поддерживает актуальные Instinct и ряд Radeon. В документации AMD на дату проверки перечислены Radeon RX 9070, RX 9070 XT и Radeon AI PRO R9700. Но перечень зависит от версии и ОС. Например, набор поддерживаемых frameworks на Linux шире, чем в отдельных Windows-конфигурациях. Перед закупкой нужна актуальная compatibility matrix.
Если проект переносится с CUDA на ROCm, составьте список vendor-specific зависимостей:
custom CUDA extensions;
fused attention и quantization kernels;
TensorRT или TensorRT-LLM components;
NCCL-specific настройки;
контейнеры и monitoring agents;
модели с ограниченным backend support;
библиотеки рендеринга или инженерное ПО с vendor certification.
После этого перенос оценивают как инженерный проект, а не как замену названия в конфигурации.
NVIDIA или AMD для разных задач
Игры
Сначала выберите разрешение, монитор, целевой FPS и конкретные игры. Затем сравните Radeon RX и GeForce RTX по независимым тестам в нативном режиме, с ray tracing и с нужным upscaling. Отдельно проверьте VRAM, 1% low, frame time, шум, размеры карты и блок питания.
Не покупайте карту только по обещанию «запас на будущее». Задайте срок эксплуатации и посмотрите, хватает ли VRAM и производительности сегодня с разумным резервом.
Локальный ИИ и нейросети
Начните с точного checkpoint, quantization и runtime. Рассчитайте память весов, KV-cache, context, batch и buffers. После этого сравните поддерживаемые GPU.
NVIDIA часто снижает риск первого запуска для CUDA-ориентированного ПО. AMD Radeon и Radeon AI PRO становятся реальными кандидатами, если комбинация ROCm, framework и приложения официально поддержана и проходит тест. Пошаговая методика вынесена в материал как выбрать видеокарту для ИИ, нейросетей и LLM.
Корпоративный inference
Для API важны не только tokens per second. Фиксируют time to first token, inter-token latency, throughput, concurrency, длину входа и выхода, стабильность под нагрузкой и память KV-cache.
Небольшие независимые модели могут эффективнее работать на нескольких универсальных PCIe GPU. Одна крупная модель способна потребовать HBM и быстрого interconnect. Выбор между NVIDIA и AMD делают после benchmark одинакового checkpoint и SLA.
Обучение и fine-tuning
Для обучения к весам добавляются gradients, optimizer states, activations и communication buffers. Чем больше GPU, тем важнее topology и эффективность collective operations. Single-GPU тест не подтверждает готовность восьми-GPU узла.
Сравнивайте время шага или эпохи, достигнутое качество, стабильность и энергию на завершенное обучение. Пиковые FLOPS без model utilization не описывают результат.
Компьютерное зрение и видеоаналитика
Для inference проверяют model latency, batch throughput и доступную precision. Для видеопотоков добавляют число и возможности encode/decode engines, codec, разрешение, FPS и одновременные каналы. GPU с меньшей вычислительной мощностью может быть рациональнее, если pipeline ограничен декодированием или сетью.
Монтаж, стриминг и транскодирование
Сверьте поддержку H.264, HEVC, AV1, bit depth, chroma subsampling и приложение. Наличие AV1 в спецификации не гарантирует одинаковое качество, число потоков или поддержку точного режима. Тестировать нужно реальный preset и целевой bitrate.
3D, CAD и рендеринг
В рендеринге важна поддержка engine. В CAD и инженерном ПО: сертифицированный driver, корректность viewport, объем VRAM и vendor support. Игровая карта может запустить приложение, но это не равно официально поддерживаемой production-конфигурации.
HPC и научные расчеты
Проверьте FP64, библиотеки, compiler toolchain, MPI и GPU-aware communication, память, RAS и межузловую сеть. AI-ускоритель с высокой FP4 производительностью не обязательно будет лучшим для FP64 workload.
VDI и виртуальные рабочие станции
Здесь решают vGPU или SR-IOV, количество профилей, лицензирование, изоляция, display protocol и certified applications. Потребительская карта с высоким FPS не заменяет enterprise GPU, если проекту нужны управляемые виртуальные рабочие места.
Сравнение видеокарт по производительности: как провести тест
Универсального сайта или одного балла недостаточно. Сделайте короткий acceptance test.
Зафиксируйте workload, dataset или набор сцен.
Выберите одинаковое качество результата и precision.
Запишите версии ОС, driver, framework, runtime и приложения.
Используйте одинаковую CPU, RAM и storage конфигурацию, если сравниваются PCIe-карты.
Выполните прогрев.
Измерьте latency, throughput, peak VRAM, power и ошибки.
Повторите тест несколько раз и сохраните разброс.
Проверьте длительный run, а не только короткий peak.
Для multi-GPU повторите тест на фактической topology.
Посчитайте стоимость требуемого результата, а не цену одной карты.
Метрики по сценариям
Задача | Основная метрика | Дополнительные проверки |
|---|---|---|
Игры | FPS и frame time | 1% low, качество, ray tracing, latency |
LLM inference | throughput при целевом SLA | TTFT, ITL, concurrency, KV-cache, качество |
Обучение | время шага или эпохи | convergence, stability, energy, scale efficiency |
Computer Vision | images или frames в секунду | latency, batch, precision, decode |
Рендеринг | время одинакового кадра или сцены | качество, VRAM, plugin support |
Видео | скорость кодирования при одинаковом качестве | codec, bitrate, число потоков |
HPC | время решения и точность | FP64, scaling, network, reproducibility |
VDI | число сессий при заданном UX | профили, latency, лицензии, изоляция |
Как выбрать видеокарту NVIDIA или AMD
Используйте последовательность, в которой ранний фильтр может остановить дорогую ошибку.
Шаг 1. Опишите задачу
Запишите приложение, модель или игру, объем данных, режим использования, число пользователей и целевой результат. Формулировка «нужна мощная видеокарта» не является техническим заданием.
Шаг 2. Выберите класс GPU
Desktop подходит для личной рабочей станции, игр и прототипов. Professional GPU нужен для сертифицированных приложений, большой VRAM или специальных функций. Data center accelerator нужен для HBM, плотного multi-GPU, RAS и серверной эксплуатации.
Шаг 3. Проверьте VRAM
Убедитесь, что workload помещается с запасом. Не складывайте VRAM нескольких карт без подтвержденного sharding или parallelism.
Шаг 4. Проверьте software stack
Для NVIDIA сверяйте driver, CUDA, framework и compute capability. Для AMD: GPU, ROCm, ОС, framework и application support. Не ограничивайтесь фразой «PyTorch работает».
Шаг 5. Проверьте платформу
Сопоставьте GPU с motherboard или server QVL, PCIe lanes, slot spacing, power connectors, PSU, airflow, rack power и cooling. Для SXM и OAM выбирают готовую совместимую платформу.
Шаг 6. Проведите benchmark
Тестируйте одинаковый workload. Если оборудования еще нет, запросите у поставщика результаты на сопоставимой конфигурации и зафиксируйте методику приемки в спецификации.
Шаг 7. Посчитайте TCO
В расчет входят GPU, server, CPU, RAM, NVMe, NIC, лицензии, перенос кода, электроэнергия, охлаждение, стойка, support и время команды. Дешевая карта может оказаться дорогой, если software migration занимает месяцы.
Типичные ошибки сравнения NVIDIA и AMD
Сравнивать ядра по количеству
CUDA cores и stream processors не эквивалентны. Количество имеет смысл только внутри близкой архитектуры и все равно не заменяет тест.
Выбирать по одной цифре TFLOPS
Неизвестная precision, sparsity и тип блоков превращают сравнение в рекламу. Нужны одинаковые условия и workload.
Считать VRAM показателем скорости
VRAM отвечает за вместимость. Скорость определяют архитектура, bandwidth, kernels и программа. Карта с большей памятью может быть медленнее в задаче, которая легко помещается в меньший объем.
Сравнивать desktop и data center GPU
Форм-фактор, охлаждение, interconnect, RAS, управление и режим работы различаются. Нельзя заменить H200 на GeForce только потому, что обе поддерживают CUDA.
Игнорировать ПО
Поддержка бренда не означает поддержку точной модели и версии. Новый GPU со старым container image может не запуститься, а CUDA-only extension блокирует прямой перенос на ROCm.
Оценивать multi-GPU как сумму одиночных карт
Масштабирование ограничивают communication, topology, load balance и software. Удвоение числа GPU не гарантирует удвоение скорости.
Покупать карту отдельно от сервера
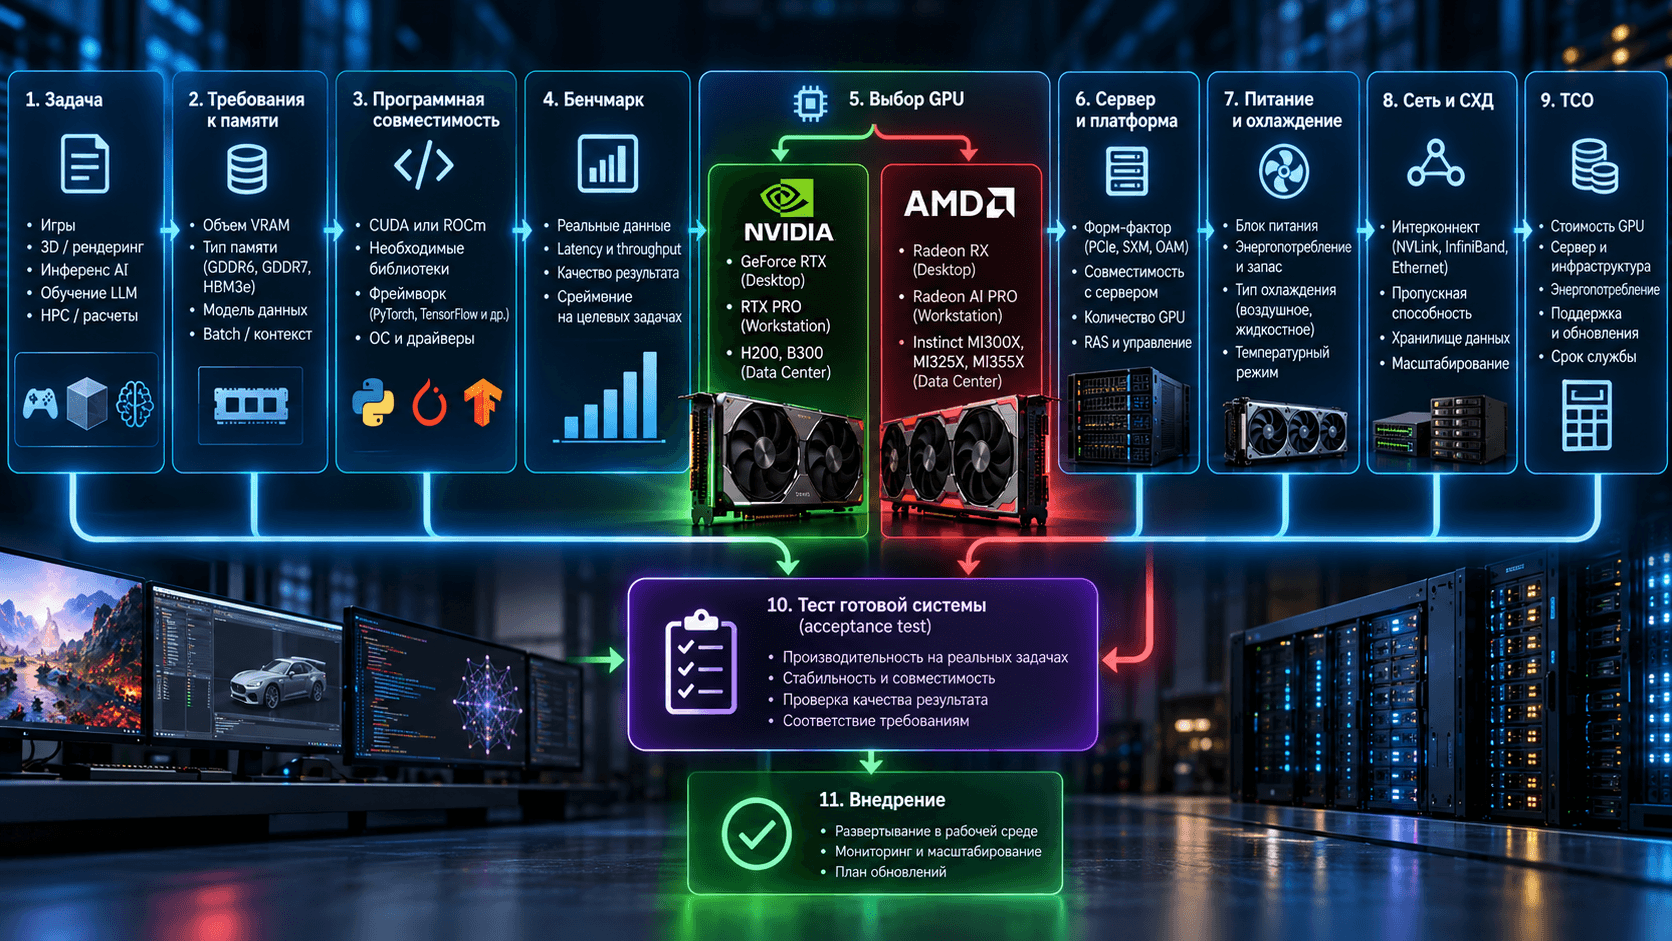
Когда нужен GPU-сервер, а не обычный ПК
Рабочая станция удобна для одного пользователя, разработки и локальных экспериментов. Сервер становится рациональнее, когда нужны:
общий доступ команды;
несколько GPU и предсказуемая topology;
круглосуточная production-нагрузка;
удаленное управление и мониторинг;
резервирование питания;
пассивные server accelerators;
большая RAM и NVMe subsystem;
высокоскоростная сеть;
vGPU, MIG или централизованная изоляция ресурсов;
размещение в стойке и масштабирование в кластер.
Сервер не исправляет неподдерживаемый software stack. Сначала workload должен пройти на выбранном GPU, затем система проверяется целиком.
Чек-лист перед заказом
Точная модель GPU и исполнение, а не только семейство.
Объем и тип VRAM, доступный приложению.
Framework, runtime, container и driver versions.
Precision, quantization и обязательные kernels.
Нужная latency, throughput или время расчета.
Одна, две, четыре или восемь GPU.
Тип межсоединения и реальная topology.
CPU, RAM и локальное NVMe-хранилище.
Сеть между узлами и доступ к СХД.
Power limit, PSU, PDU и cooling.
QVL сервера, firmware и support.
Acceptance test и критерии PASS или FAIL.
План роста нагрузки и TCO.
Частые вопросы
Какая видеокарта лучше: NVIDIA или AMD
Лучшая карта та, которая поддерживает нужное приложение, вмещает workload, выполняет SLA и подходит платформе по питанию и охлаждению. Для CUDA-зависимого проекта практичнее может быть NVIDIA. При подтвержденной поддержке ROCm и выгодной конфигурации полноценным кандидатом становится AMD.
Что лучше: GeForce RTX или Radeon RX
Для игр сравните точные модели в нужном разрешении, отдельно в нативном режиме, с ray tracing и апскейлингом. Для работы сначала проверьте приложение, VRAM, кодеки и driver support. Бренд без модели и задачи не дает ответа.
Как правильно сравнивать видеокарты по производительности
Используйте одинаковую систему, workload, качество результата, precision, версии ПО и длительность теста. Измеряйте не только среднюю скорость, но и latency, стабильность, peak VRAM, power и ошибки.
Что важнее: VRAM или мощность видеокарты
Сначала VRAM работает как фильтр вместимости. Если задача не помещается, вычислительная мощность не помогает. После этого сравнивают реальную скорость, bandwidth, software support и энергопотребление.
Можно ли сравнивать CUDA cores и stream processors
Нет, прямого коэффициента нет. Это блоки разных архитектур. Сравнивать нужно результат одного приложения или benchmark при одинаковых условиях.
Подходит ли AMD для искусственного интеллекта
Да, если точная GPU, ROCm, ОС, framework и приложение совместимы. AMD Instinct предназначена для AI и HPC, а поддерживаемые Radeon используются для локальной разработки и inference. Перед покупкой нужен тест полного стека.
Почему NVIDIA часто выбирают для AI
Многие frameworks, containers, libraries и custom extensions давно ориентированы на CUDA. Это снижает риск внедрения для CUDA-зависимого проекта. Преимущество относится к совместимости конкретного стека, а не доказывает превосходство любой NVIDIA над любой AMD.
Складывается ли VRAM двух видеокарт
Не автоматически. У каждой GPU остается локальная память. Одна модель использует несколько устройств только при поддержке sharding или parallelism, причем часть данных может дублироваться.
Можно ли поставить игровую видеокарту в сервер
Иногда физически можно, но этого недостаточно. Нужно проверить QVL, размеры, power, разъемы, airflow, BIOS, режим эксплуатации и support. Активное охлаждение desktop-карты может конфликтовать с воздушным потоком серверного шасси.
Чем серверная видеокарта отличается от игровой
Серверная GPU может иметь пассивное охлаждение, ECC и RAS, другой форм-фактор, virtualization, расширенный management и длительный lifecycle. Набор функций зависит от модели. Игровая карта ориентирована на desktop-среду и интерактивную графику.
Как сравнить цену и производительность NVIDIA и AMD
Сначала измерьте стоимость выполнения целевой работы: запроса, кадра, обучения или расчета. Добавьте сервер, лицензии, питание, охлаждение, миграцию и поддержку. Цена одной карты без TCO способна привести к неверному выбору.
Какая видеокарта нужна для LLM
Зафиксируйте checkpoint, precision, quantization, context и concurrency. Рассчитайте веса, KV-cache и overhead. Затем сравните GPU, на которых точный runtime поддерживается и workload помещается с запасом.
Итог
Сравнение видеокарт NVIDIA и AMD следует начинать не с бренда и не с числа ядер. Сначала выбирают класс GPU и описывают задачу. Затем проверяют VRAM, memory bandwidth, software stack, form factor, питание и охлаждение. Финальное решение подтверждает benchmark одинакового workload.
Если нужно подобрать NVIDIA или AMD под реальный проект, передайте Start Server название модели или приложения, режим работы, объем данных, целевой SLA, текущий software stack и условия размещения. Инженеры проверят совместимость, рассчитают VRAM, число GPU, сервер, сеть, питание и охлаждение, а затем сформируют конфигурацию и план приемочных тестов.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


